Você tem uma URL de pin do Pinterest e quer título, descrição e contagem de salvamentos. Você não precisa de um navegador para fazer scraping. Uma página de pin deslogada contém os três em um bloco JSON-LD, além do pinner e do link externo. Feeds RSS de perfil e board listam URLs de pins via HTTP simples.
Mas nada disso alcança a busca. O Pinterest constrói a grade de busca no navegador e coloca um modal de login sobre ela para visitantes deslogados. Os tiles que renderizam não têm títulos nem links.
Este guia explica como fazer corretamente o scraping do Pinterest e obter todos os dados públicos que você precisa.
TL;DR
Um pin público é parseado via HTTP simples, enquanto busca por palavra-chave e crawls completos de perfil precisam de uma API gerenciada.
- O bloqueio na busca lê o estado da conta, não um score de bot, então um navegador stealth não muda nada.
- Guias mais antigos falham por dois motivos:
pinWrappernão corresponde a nada, e o registro não está no Redux store. - Um IP de datacenter recebe a página do pin sem seu bloco JSON-LD, então execute a partir de um endereço residencial.
- Ambos os métodos gratuitos sobre os boards de uma conta alcançaram 435 pins únicos, de mais de 9.000 mantidos ali.
O que você pode extrair do Pinterest
Um registro de pin contém título, descrição, URLs de imagem ou vídeo, hashtags, uma categoria, uma contagem de comentários e a URL do perfil do pinner. Perfis listam contagem de seguidores, nomes de boards e os pins que um usuário publicou.
A dificuldade é o acesso, não o modelo de dados. As diretrizes de desenvolvedor do Pinterest proíbem “qualquer meio automatizado ou forma de scraping ou extração de dados para acessar informações do Pinterest”. O arquivo robots é uma lista de permissões, não uma lista de bloqueio: nomeia centenas de crawlers um por um e dá a User-agent: * um Disallow: /. Qualquer cliente que ele não nomeie não é permitido.
Então colete apenas dados públicos, mantenha as taxas de requisição baixas e não faça login com uma conta pessoal para automatizar. Nomes de pinners e URLs de perfil são dados pessoais sob o GDPR, e as mesmas diretrizes proíbem o uso de material do Pinterest para treinar modelos de IA. Para qualquer coisa além disso, consulte um profissional.
O que uma página de pin retorna via HTTP simples
Para uma URL de pin que você já tem, não precisa de um navegador. Uma página de pin deslogada embute um bloco JSON-LD SocialMediaPosting, e esse bloco é o registro.
Você precisa de Python 3 e nada mais para começar: json, re e urllib são todos da biblioteca padrão. O primeiro pip install vem depois, quando você transforma um perfil em feeds de board.
Faça o parse do bloco e você obtém os dados do pin em poucas linhas:
import json, re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
BOILERPLATE = "Discover (and save!) your own Pins"

def scrape_pin(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    resp = urllib.request.urlopen(req, timeout=30)
    html = resp.read().decode("utf-8", "ignore")
    block = re.search(
        r'<script[^>]*type="application/ld\+json"[^>]*>(.*?)</script>',
        html, re.S)
    if not block:            # pin removido: nenhum bloco JSON-LD na página
        return None
    data = json.loads(block.group(1))

    # Pins de receita usam name/description, os demais headline/articleBody
    description = data.get("articleBody") or data.get("description")
    if description and BOILERPLATE in description:
        description = None   # Texto genérico do Pinterest, não as palavras do próprio pin

    saves = next((s.get("userInteractionCount")
                  for s in data.get("interactionStatistic") or []), None)
    return {
        "schema": data.get("@type"),
        "title": data.get("headline") or data.get("name"),
        "description": description,
        "pinner": (data.get("author") or {}).get("name"),
        "image": data.get("image"),
        "date": data.get("datePublished"),
        "source_link": (data.get("sharedContent") or {}).get("url"),
        "saves": saves,
    }

if __name__ == "__main__":
    print(json.dumps(scrape_pin(
        "https://www.pinterest.com/pin/99360735523397542/"), indent=2))
Execute e um pin ativo retorna um registro completo:
{
  "schema": "SocialMediaPosting",
  "title": "12 Bombshell Hair Color Ideas To Try This Summer | Ecemella",
  "description": "A person with long, straight reddish-brown hair wearing a black leather jacket...",
  "pinner": "Sarah Komnick",
  "image": "https://i.pinimg.com/originals/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
  "date": "2023-05-24T22:32:51.000Z",
  "source_link": "https://www.ecemella.com/summer-hair-color-ideas/",
  "saves": 196
}
Tudo isso vem de uma requisição.
O registro está no bloco JSON-LD, não no Redux store da página. Um segundo script, __PWS_INITIAL_PROPS__, define initialReduxState.pins como um objeto vazio. Um scraper que lê o store não encontra nada. E um pin removido não tem nenhum bloco JSON-LD, então scrape_pin retorna None em vez de um registro parcial.
O Pinterest serve mais de um tipo de JSON-LD, e ignorar o schema quebra um scraper silenciosamente. Em 105 pins, 100 retornaram SocialMediaPosting e 5 retornaram Recipe, e todos incluíram um bloco JSON-LD.
Os 105 vieram de duas fontes: 90 dos feeds RSS de 10 contas, que não retornaram nenhum pin de vídeo. Os outros 15 vieram de uma busca por palavra-chave através da Scraper API, dos quais 10 eram vídeo. Pins de vídeo usam o mesmo schema SocialMediaPosting e fazem parse sem erro.
A divisão entre os dois schemas é total, não parcial, o que torna fácil de passar despercebido. Na amostra de 90 pins do feed, todos os 85 posts sociais incluíram headline, articleBody, datePublished e sharedContent, e nenhuma das 5 receitas incluiu qualquer um deles. Um pin de receita usa name e description em vez disso. Ler apenas headline não retorna nada para toda a categoria, e deixa você sem data e sem link externo.
Pins de vídeo têm um problema diferente. Seu image no JSON-LD é um frame estático .jpg, e o bloco não contém contentUrl, duration ou embedUrl.
O vídeo em si é um manifesto HLS, o formato de playlist HTTP Live Streaming, em v1.pinimg.com. Ele aparece no HTML da página em vez do bloco estruturado, então um pin de vídeo faz parse com sucesso e retorna uma miniatura. Registros da Scraper API incluem video_length e uma URL de mídia diretamente, o que identifica pins de vídeo sem uma segunda requisição.
A mistura depende da conta, e pode se inverter. Amostrado separadamente, o feed de uma conta de culinária retornou 19 de 25 pins como Recipe. Um parse apenas de headline teria retornado um título vazio para três quartos deles. Pins de receita adicionam recipeYield e aggregateRating, caso sejam úteis para você.
Em pins de receita, a description costuma ser um texto genérico do Pinterest em vez de algo escrito pelo pinner. O código retorna None em vez de tratá-lo como conteúdo.
O que realmente quebra em volume
O Pinterest coloca a Akamai na frente de suas páginas de pin, mas nada nas respostas sugere que o Bot Manager esteja ativo nelas. Doze requisições rápidas enviadas com o User-Agent padrão do urllib retornaram todas 200. As respostas definiram apenas csrftoken, _pinterest_sess, _auth e _routing_id. Nenhum cookie do Akamai Bot Manager apareceu, e nenhum payload de sensor foi servido, então não houve desafio TLS para resolver.
Em seis identidades de cliente, o mesmo pin serviu seu bloco JSON-LD todas as vezes. Isso incluiu um User-Agent Chrome, curl, Googlebot e uma string vazia. Então o parse não precisa de um User-Agent falso.
Isso é verdade a partir de um endereço residencial. Em cinco pins, uma busca residencial incluiu o bloco JSON-LD todas as vezes e uma busca de datacenter nunca incluiu. Ambas retornaram a página correta, o título correto e um número similar de scripts.
O Pinterest declara a diferença na própria página, sob o objeto context em __PWS_DATA__. is_hosting lia false no lado residencial e true no lado de hosting, com is_bot false em ambos. Então o teste é reputação de rede, não um score de bot.
Executar scrape_pin de uma VM em nuvem retornou None em todo pin testado, sem nada na página para dizer o motivo. Um cliente com fingerprinting não muda o endereço de onde você executa.
Sua escolha de cliente HTTP importa mais do que tudo isso quando você está pagando por tráfego. A biblioteca padrão urllib não envia cabeçalho Accept-Encoding, então o servidor responde sem compressão. O exemplo da stdlib baixa cerca de 1,13 MB por pin.
A biblioteca requests negocia gzip por padrão e transfere cerca de 183 KB. Um navegador oferecendo Brotli recebe cerca de 124 KB. É a mesma página e os mesmos dados, com uma diferença de 9x nos bytes transferidos decidida por qual cliente você escolheu.
Isso importa porque proxies cobram por bytes transferidos. Em 10.000 pins o exemplo da stdlib move 11,3 GB, comparado com 1,83 GB para o mesmo trabalho via requests. Na taxa residencial de tabela de $8/GB, isso é cerca de $90 em vez de $15. Use a versão stdlib para aprender como funciona, depois mude para requests ou curl_cffi para qualquer coisa que você realmente execute.
A reputação de IP piora em volume, não sua impressão digital TLS. Então rotacionar por endereços residenciais ajuda aqui, enquanto um cliente com fingerprinting principalmente não ajuda. Se mais tarde você encontrar uma página do Pinterest que verifica o handshake, curl_cffi (documentação da biblioteca) é o substituto padrão e deixa o parse intacto:
from curl_cffi import requests as cffi   # pip install curl_cffi

resp = cffi.get("https://www.pinterest.com/pin/99360735523397542/",
                impersonate="chrome", timeout=30)
html = resp.text                 # alimente isso no mesmo parse JSON-LD
Dois limites se aplicam. Não dá acesso aos endpoints internos do Pinterest. PinResource retornou 403 tanto para o urllib simples quanto para um cliente que imita o Chrome, então a impressão digital não é o problema ali. E não consegue responder a um desafio JavaScript se um for servido.
O endpoint oEmbed oficial
O Pinterest publica um endpoint oEmbed para pins públicos. É a consulta de pin único mais leve aqui, e responde com JSON em vez de uma página HTML. Esta chamada usa curl, incluído no macOS, Linux e Windows 10 e posteriores. Você também pode testar colando a URL direto em um navegador primeiro:
PIN="https://www.pinterest.com/pin/99360735523397542/"
curl "https://www.pinterest.com/oembed.json?url=$PIN"
Responde com atribuição, uma miniatura e um embed pronto:
{"version":"1.0","type":"rich","provider_name":"Pinterest","title":" ",
 "author_name":"Sarah Komnick",
 "author_url":"https://www.pinterest.com/sarahkomnick/",
 "thumbnail_url":"https://i.pinimg.com/236x/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
 "thumbnail_width":236,"thumbnail_height":314,
 "html":"<iframe src=\"https://assets.pinterest.com/ext/embed.html?id=99360735523397542\" ...></iframe>"}
Entre as rotas que você mesmo executa, esta tem a menor exposição. oEmbed é o formato padrão que sites publicam para que terceiros possam incorporar seu conteúdo. É uma interface publicada, não uma API interna.
Também aceita URLs de board e perfil, não apenas pins. Retornou um título real para ambos, onde a chamada de pin o deixou vazio. Uma descrição, uma contagem de salvamentos e um link de origem externo não estão na resposta.
O Pinterest retorna 404 suaves para suas páginas de pin. Um pin removido, um ID numérico inexistente e um slug malformado retornaram todos HTTP 200. O mesmo ocorreu com um ID truncado e um ID numérico não utilizado, todos com o bloco JSON-LD ausente. Qualquer verificação baseada em response.status não mede nada.
O endpoint oEmbed responde HTTP 400 em vez disso. Isso ocorreu em todos os 5 casos, enquanto um pin ativo retornou 200.
Transfere uma mediana de 583 bytes em 19 pins, comparado com cerca de 124 KB para a página. Isso o torna a forma barata de filtrar uma lista de URLs antes de fazer o parse de qualquer coisa. 80 chamadas consecutivas sem atraso retornaram todas 200, sem limitação de taxa e sem mudança de latência.
Descubra URLs de pins sem a grade de busca
Tanto o parse JSON-LD quanto o oEmbed precisam de uma URL de pin que você já tenha. Então de onde vêm as URLs?
Uma rota parece óbvia e não é. O arquivo robots do Pinterest declarava 50 URLs Sitemap: sob /v3_sitemaps/ quando verificado. Os nomes descrevem exatamente o que um coletor gostaria: image_pin_sitemap_recent_engagement_tier_1, video_product_pin_sitemap, vários níveis de sitemap de links de board. Todos os 50 retornaram HTTP 404.
Um sitemap declarado vale uma requisição antes de você confiar nele.
Para um perfil ou um board, as URLs vêm do RSS. O Pinterest ainda publica feeds não autenticados em /<username>/feed.rss e /<username>/<board-slug>.rss:
import re, urllib.request
import xml.etree.ElementTree as ET

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

def list_pins(feed_url):
    req = urllib.request.Request(feed_url, headers={"User-Agent": UA})
    xml = urllib.request.urlopen(req, timeout=30).read()
    pins = []
    for item in ET.fromstring(xml).findall(".//item"):
        desc = item.findtext("description") or ""
        thumb = re.search(r'src="([^"]+)"', desc)
        pins.append({
            "url": item.findtext("link"),
            "published": item.findtext("pubDate"),
            "thumbnail": thumb.group(1) if thumb else None,
        })
    return pins

if __name__ == "__main__":
    feed = list_pins("https://www.pinterest.com/boredpanda/animals.rss")
    print(f"found {len(feed)} pins")
    print(feed[0])
Um feed de board retornou uma lista utilizável de URLs de pins reais:
found 26 pins
{'url': 'https://www.pinterest.com/pin/150307706316766946/',
 'published': 'Thu, 23 Jul 2026 12:14:04 GMT',
 'thumbnail': 'https://i.pinimg.com/236x/18/a4/8b/18a48b04fbe868130b0a2ad14759fe87.jpg'}
Abra uma dessas URLs de feed em um navegador e a estrutura é fácil de ler. Cada <item> contém o link do pin, uma data de publicação e uma miniatura na descrição:
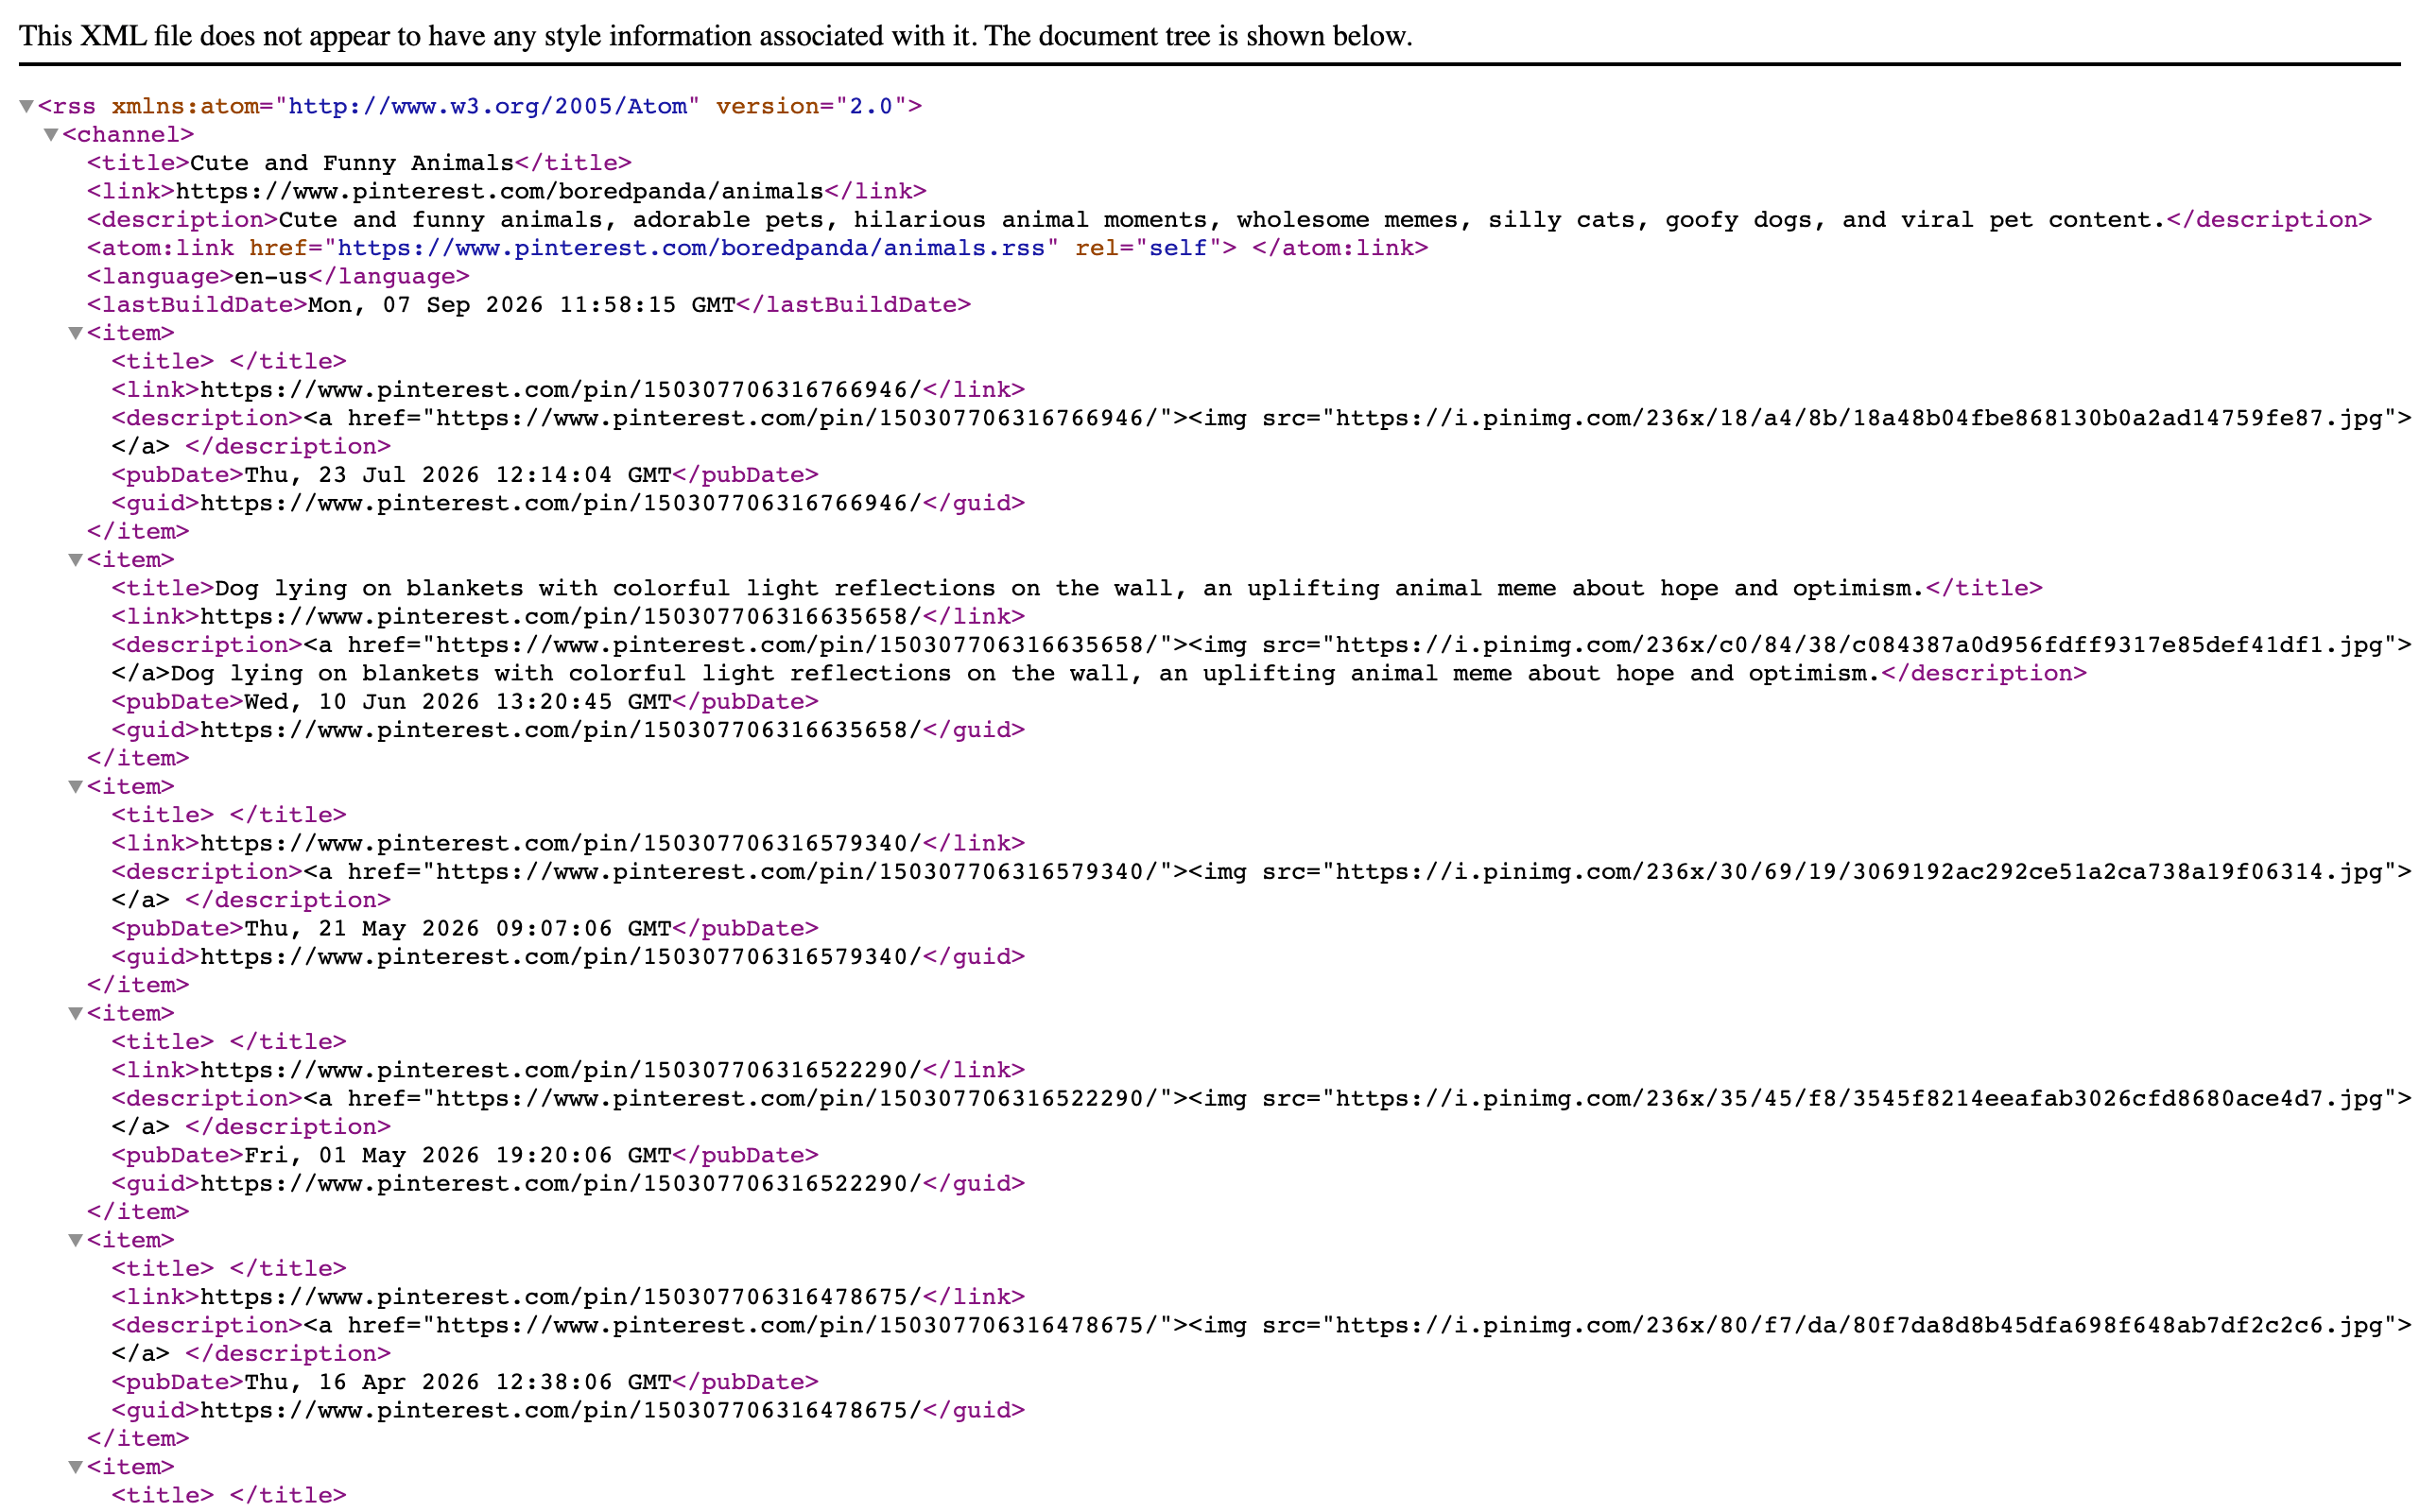
As tags <title> vazias são o motivo pelo qual o feed é uma fonte de URLs em vez de metadados. Um item neste feed tem um título real; o resto está em branco.
Encadear isso com o parse por pin te dá um pipeline completo que nunca carrega um navegador. Salve scrape_pin e list_pins juntos como pinterest.py, e isso os importa sem alteração:
import time, json
import xml.etree.ElementTree as ET
from pinterest import scrape_pin, list_pins   # de pinterest.py

def collect_feed(feed_url, delay=0.5):
    records = []
    try:
        pins = list_pins(feed_url)
    except (OSError, ET.ParseError) as err:   # pula um feed ruim, continua
        print(f"skipped feed {feed_url}: {err}")
        return records
    for pin in pins:
        time.sleep(delay)         # antes da requisição, para que os pulos também sejam educados
        try:
            record = scrape_pin(pin["url"])
        except (OSError, ValueError) as err:  # transitório: mantém o que você tem
            print(f"skipped {pin['url']}: {err}")
            continue
        if record is None:        # pin removido: a página retorna 200 soft-404
            continue
        record["url"] = pin["url"]
        record["feed_published"] = pin["published"]
        records.append(record)
    return records

rows = collect_feed("https://www.pinterest.com/foodnetwork/feed.rss")
print(f"{len(rows)} pins enriched")
with open("feed-pins.json", "w") as f:
    json.dump(rows, f, indent=2)
Em uma conta de culinária imprimiu 25 pins enriched em 46 segundos. Todos os 25 tinham um título, e a mistura de schema foi 19 receitas para 6 posts sociais. Feeds estavam disponíveis em todas as 12 contas testadas, de criadores individuais a grandes marcas. Feeds de perfil retornaram de 22 a 25 itens e feeds de board de 23 a 26.
O feed tem um limite fixo em vez de crescer com o board. Um board reportando perto de 6.000 pins retornou 24 itens, o mesmo que um board com 39. Abaixo desse limite você recebe perto do que existe: um board com 6 pins retornou 5.
Transforme um perfil em um conjunto de feeds de board
Uma conta tem mais de um feed, e a página de perfil os lista publicamente, com nomes e contagens de pins, sem login necessário:
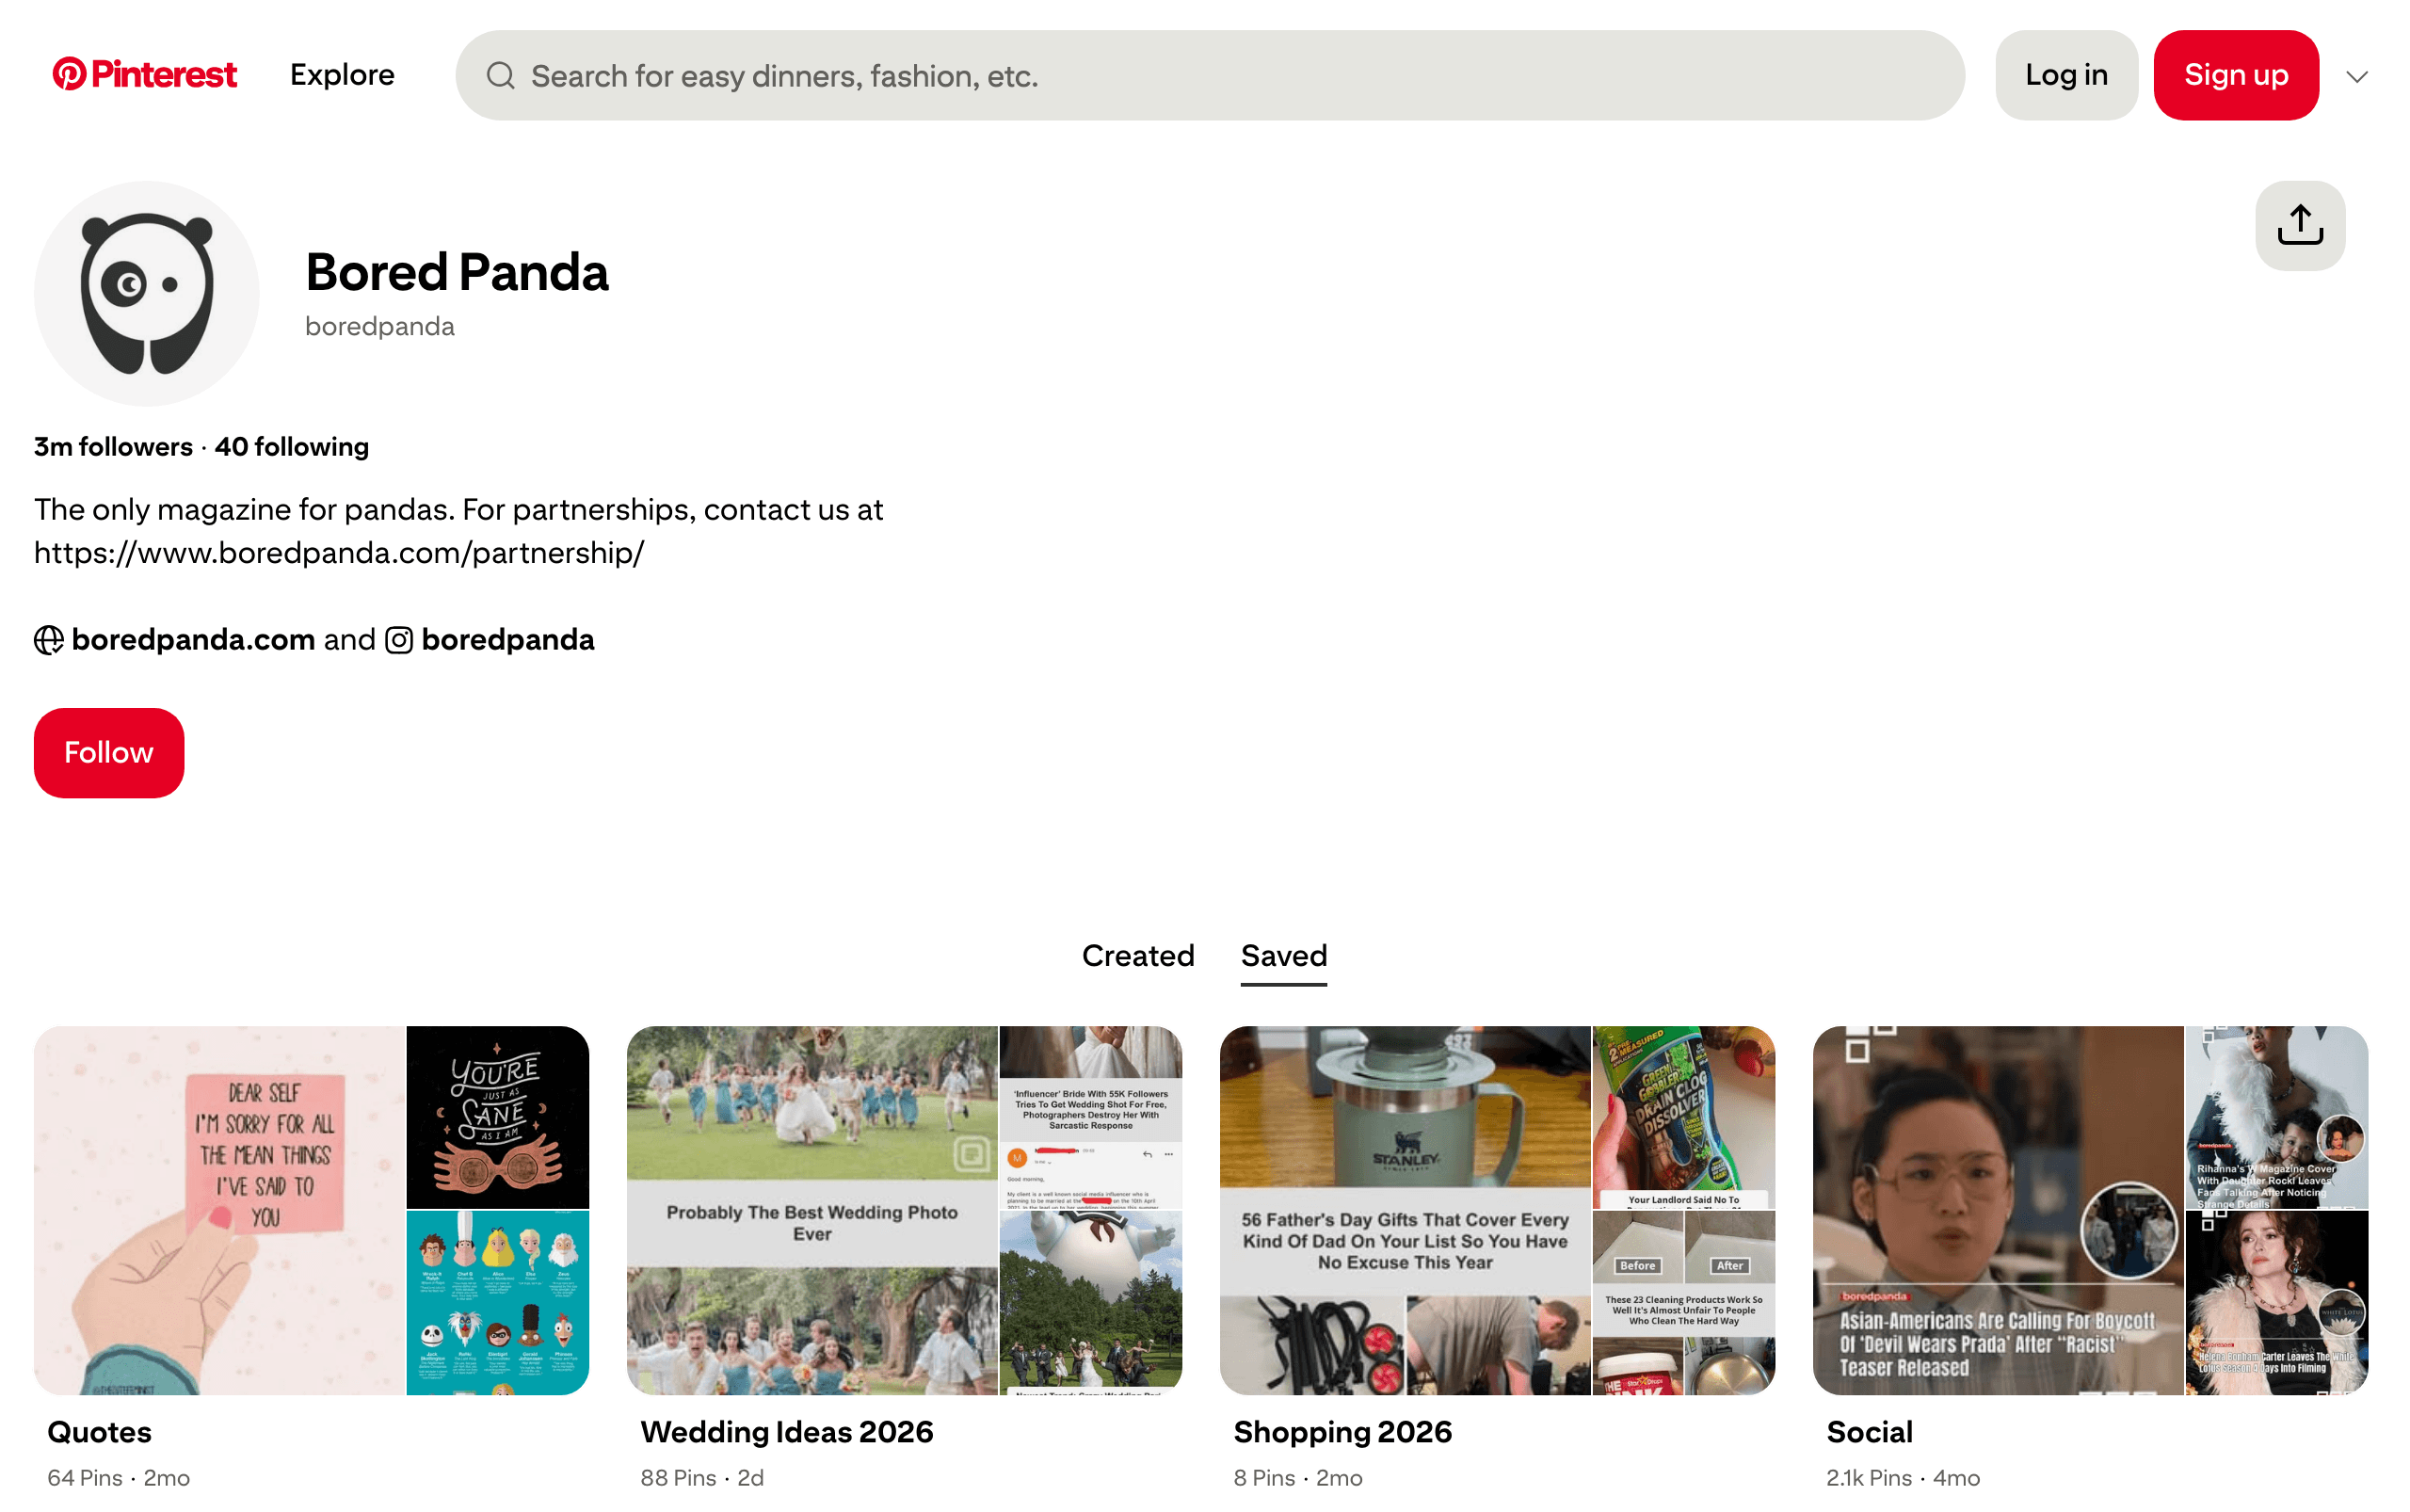
A busca recebe um modal de login; um perfil não. Esses nomes de board são os slugs que list_boards lê do HTML da página. As contagens de pins dizem quais boards atingirão o limite do feed e quais são pequenos o suficiente para que ele retorne a maioria deles.
Slugs de board geralmente aparecem no HTML do perfil via HTTP simples, então um regex transforma um nome de conta em um conjunto de URLs de feed:
import re, requests            # pip install requests

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
RESERVED = {"pins", "boards", "followers", "following"}   # rotas, não boards

def list_boards(handle):
    html = requests.get(f"https://www.pinterest.com/{handle}/",
                        headers={"User-Agent": UA}, timeout=30).text
    found = re.findall(rf'"/{handle}/([A-Za-z0-9][A-Za-z0-9_-]*)/"', html)
    slugs = set(found) - RESERVED
    base = f"https://www.pinterest.com/{handle}"
    return [f"{base}/{s}.rss" for s in sorted(slugs)]

feeds = list_boards("boredpanda")
print(f"{len(feeds)} board feeds")
print(feeds[0])
Uma conta retornou nove feeds de board:
9 board feeds
https://www.pinterest.com/boredpanda/animal-memes.rss
Junto com a lista de boards, o HTML de perfil deslogado embute um bloco JSON-LD ProfilePage. Fez parse em todas as 8 contas testadas.
Dá o nome de exibição, o handle, a bio, a URL do avatar e a data de criação da conta. Um array sameAs aponta para outros perfis do dono, que nessas contas significava Instagram e seu próprio domínio. Seis das 8 também incluíram uma contagem de seguidores sob interactionStatistic, a do Etsy lendo mais de 11 milhões. É o mesmo parse da página de pin, direcionado a uma URL diferente.
Executar os 9 feeds de board através de list_pins retornou 208 URLs de pin únicas de boredpanda, comparado com os 25 que um único feed dá. Nenhum pin apareceu em dois feeds de board. Toda conta testada listou seus boards dessa forma: 10 de 10, entre 8 e 10 slugs cada. O feed do primeiro board retornou itens em todas as 10.
Esses 9 são os boards que a página de perfil mostra, não o conjunto completo da conta. O registro de perfil da API reporta 51 para a mesma conta. HTTP simples alcança 9 desses 51, cada um através do mesmo limite de 25 itens.
O feed animals usado anteriormente é um que ele perde, então um board que você já conhece ainda vale a pena solicitar diretamente. Um perfil ativo também pode retornar nenhum slug. Trate uma lista vazia como um sinal para verificar o handle, não como prova de que a conta não tem boards.
Títulos de feed estavam vazios em todos exceto um item nos feeds testados. Deixe o parse por pin fornecer o resto.
Duas rotas além do limite do feed
O scraper de perfis na Scraper API alcança a lista de boards pela outra direção. boards_num reportou 51 boards para boredpanda, então você sabe o tamanho do conjunto antes de começar.
Toda entrada no seu array saved inclui um saved_collection_url, e essa URL mais .rss retornou um feed em todos os 6 boards testados. O próprio array retornou 10 desses 51, outra lista parcial.
Remova a barra final antes de anexar. saved_collection_url termina com uma, e o Pinterest trata as duas formas resultantes de maneira muito diferente. Terminando em quotes.rss retorna um feed de 13 KB.
Terminando em quotes/.rss retorna HTTP 200 e o aplicativo HTML em vez disso. Isso falha dentro do seu parser XML com um erro de token inválido apontando para uma linha de JavaScript. Construa a URL com saved_collection_url.rstrip("/") + ".rss" e essa forma não consegue chegar ao parser.
O backend de widget mais antigo em widgets.pinterest.com/v3/pidgets/ também responde a requisições não autenticadas, e na maioria dos boards retornou mais do que o RSS. Seu endpoint de board retornou 50 pins onde o feed do mesmo board retornou 26, cada um com uma descrição. Também reporta um pin_count no nível do board, então você tem uma noção do que está perdendo.
Cinquenta é um limite em vez de um tamanho de página. page, offset, limit, count e page_size foram todos ignorados, cada um retornando os mesmos 50. Em nove boards em boredpanda o backend de widget alcançou 362 pins únicos, comparado com 208 dos feeds de board. Os dois juntos alcançaram 435, de mais de 9.000 mantidos nesses boards.
Três coisas antes de você confiar nele. Seu repin_count não é a contagem de salvamentos do JSON-LD. Lido junto no pin usado ao longo deste guia, retornou 77 onde o JSON-LD retornou 196. Apenas o número do JSON-LD é o que o Pinterest rotula como Saves.
Links externos variam por board: 50 de 50 pins em um, 5 de 43 em outro. Descrições chegaram em quase todo pin. E nem sempre é melhor: em um board pequeno o RSS retornou 9 para seus 8. O endpoint não é documentado, não tem busca e não tem promessa de compatibilidade.
Além desse quinquagésimo pin, ou em uma agenda, o crawl de perfil na Scraper API executa por toda a conta como um trabalho em segundo plano. Retorna um registro estruturado para cada pin que encontra.
A descoberta na Scraper API funciona no nível do perfil, então passe a URL do perfil e filtre os registros para o board que você quer. Em dois boards testados, uma URL de board retornou o perfil em vez do board nomeado na requisição.
Por que os métodos gratuitos param na busca
Busque uma página de resultados de busca e o HTML tem zero blocos JSON-LD. A grade é construída por requisições posteriores do navegador, e essas são bloqueadas para sessões deslogadas. Em setembro de 2026, o bloco __PWS_DATA__ lista dez experimentos lop_unauth_lockdown_*, _main, _closeup e _search entre eles.
Dois dos dez nomeiam as rotas que este guia usa: lop_unauth_lockdown_profile e lop_unauth_lockdown_board. O bloqueio para deslogados é um experimento em andamento, não uma parte permanente do site. Então trate o acesso a perfil e board como algo a observar em vez de assumir.
O mesmo bloco mostra o que o bloqueio verifica, porque o Pinterest registra sua própria visão do seu cliente nele. Sob context, páginas de pin, busca e perfil incluem todos os mesmos 15 campos de classificação. Isso inclui is_bot, is_proxy, is_vpn, is_tor, is_hosting, is_unauth_botspam_asn e is_authenticated.
Requisitado de um endereço residencial comum, is_bot retornou "false" e cada flag de proxy e hosting retornou false. A grade de busca foi bloqueada mesmo assim. Os experimentos de bloqueio leem o estado deslogado, não um score de bot.
is_hosting separou as buscas que retornaram o JSON-LD de um pin das que chegaram sem ele. Então leia context da tag <script id="__PWS_DATA__"> em uma única página de pin. Essa é a forma mais barata de confirmar que o endereço de onde você coleta parece da forma que você espera. Faça isso antes de desperdiçar uma execução culpando um baixo número de registros no seu parser.
Não é documentado e é interno, não uma promessa que o Pinterest faz, então trate como uma verificação que você repete. O objeto também contém um unauth_id e o país e região do seu IP. Mascare-os antes que os dados saiam da sua máquina.
Essa verificação é o parse JSON-LD direcionado à outra tag script:
import json, re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
FLAGS = ("is_bot", "is_proxy", "is_vpn", "is_tor", "is_hosting",
         "is_unauth_botspam_asn", "is_authenticated")

def how_pinterest_sees_you(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    resp = urllib.request.urlopen(req, timeout=30)
    html = resp.read().decode("utf-8", "ignore")
    block = re.search(
        r'<script id="__PWS_DATA__" type="application/json">(.*?)</script>',
        html, re.S)
    if not block:
        return None
    ctx = json.loads(block.group(1)).get("context") or {}
    # esse objeto também contém unauth_id e a geo do seu IP: não retorne isso
    return {k: ctx.get(k) for k in FLAGS}

print(how_pinterest_sees_you(
    "https://www.pinterest.com/pin/99360735523397542/"))
Execute de uma conexão doméstica e de uma VM em nuvem e um campo muda:
# residencial
{'is_bot': 'false', 'is_proxy': False, 'is_vpn': False, 'is_tor': False,
 'is_hosting': False, 'is_unauth_botspam_asn': False, 'is_authenticated': False}

# mesmo pin, mesmo parse, faixa de hosting
{'is_bot': 'false', 'is_proxy': False, 'is_vpn': False, 'is_tor': False,
 'is_hosting': True, 'is_unauth_botspam_asn': False, 'is_authenticated': False}
is_bot chega como a string "false" enquanto as outras flags são booleanos reais, então compare como string. is_hosting é o campo que muda, e ele decide se a página do pin inclui um bloco JSON-LD.
Os endpoints JSON internos que guias mais antigos chamam estão fechados como uma classe, não um de cada vez. PinResource, BoardFeedResource, UserResource, BaseSearchResource e RelatedModulesResource todos retornaram HTTP 403 para requisições não autenticadas. Isso foi verdade com ou sem uma impressão digital TLS que corresponda a um navegador real.
Requisições passam pela Akamai como um CDN. A mesma verificação de cookie em páginas de busca e perfil não mostrou marcadores do Bot Manager ali também.
Por que a API oficial do Pinterest não é uma ferramenta de scraping
O Pinterest executa uma API REST, e é tentador tentá-la primeiro. Ela não coletará conteúdo público em nenhuma escala útil, e o motivo é escopo, não qualidade.
A API v5 é construída para gerenciar sua própria conta: seus boards, seus pins, seus anúncios, seu analytics. A categoria org_read se aplica a “Buscar contas de usuário, boards, seções de board ou Pins” para a conta autenticada. Além do beta de busca para parceiros, nenhum endpoint retorna um pin público que você não possui.
A única busca por palavra-chave é GET /v5/search/partner/pins, um beta “não disponível para todos os apps” que retorna os 10 principais pins. Os dados que a maioria dos projetos de scraping quer, pins e perfis públicos de outras pessoas, não são alcançáveis através da API.
Essa mesma página também publica os limites de taxa. Em setembro de 2026, o acesso de teste permitia 1.000 requisições por dia em todos os endpoints. O acesso padrão permitia 100 requisições por segundo por usuário por app. O Pinterest observa ali que todos eles estão “sujeitos a mudança sem aviso prévio”.
Para dados públicos de terceiros em escala, a API oficial é a ferramenta errada. Então a coleta além das rotas de HTTP simples precisa de automação de navegador ou de um scraper gerenciado.
Fazer scraping do Pinterest com Playwright
A busca é a única rota que precisa de um navegador para renderizar a página, e o Playwright conduz um a partir do Python. Se você nunca usou antes, o blog da Bright Data tem um tutorial mais longo do Playwright cuja API funciona da mesma forma.
Saiba o que essa rota retorna antes de instalá-la: URLs de imagem e nada mais, sem títulos, sem descrições e sem links de pins. Se isso não for suficiente para seu caso de uso, leia Onde a abordagem do navegador quebra e pule a instalação.
Instale a biblioteca e um navegador:
pip install playwright
playwright install chromium
Este script abre uma página de busca, rola a tela e lê os tiles de pin. Um detalhe importa primeiro: o seletor de tile mudou. Guias mais antigos miram div[data-test-id='pinWrapper'], que não corresponde a nada no site deslogado hoje. A grade deslogada atual usa gated-pin-rep para cada tile e gated-pin-image para sua imagem:
import asyncio, json
from playwright.async_api import async_playwright

BROWSER_UA = ("Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
              "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

async def scrape_pins(query, scrolls=6):
    url = f"https://www.pinterest.com/search/pins/?q={query}&rs=typed"
    seen = set()
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page(user_agent=BROWSER_UA,
                                      viewport={"width": 1280, "height": 900})
        await page.goto(url, wait_until="domcontentloaded")
        for _ in range(scrolls):
            await asyncio.sleep(1.5)
            images = await page.query_selector_all(
                "[data-test-id='gated-pin-image'] img")
            for img in images:
                src = await img.get_attribute("src")
                if src and "/236x/" in src:   # miniaturas de pin, não imagens de UI
                    seen.add(src)
            await page.mouse.wheel(0, 4000)
        await browser.close()
    return sorted(seen)

async def main():
    results = await scrape_pins("minimalist%20office")
    print(f"collected {len(results)} thumbnail URLs")
    with open("office-pins.json", "w") as f:
        json.dump(results, f, indent=2)

if __name__ == "__main__":
    asyncio.run(main())
Definir um User-Agent é o conselho mais repetido sobre scraping do Pinterest, e não faz o que as pessoas afirmam. Sem substituição, uma string atual do Chrome, uma string do Chrome de dois anos atrás, e um literal python-requests/2.32.3 retornam todos HTTP 200 e a mesma contagem de tiles. Cada um retornou nenhum link de pin e o mesmo modal de login. Mantenha um sensato mesmo assim, já que não custa nada e identifica seu tráfego honestamente.
O conjunto importa porque o Pinterest reutiliza nós de tile enquanto você rola. Execute e uma sessão deslogada imprime:
collected 16 thumbnail URLsEntão o Playwright retorna URLs de miniatura da busca, e nada além disso.
Obtenha a imagem em tamanho completo de uma miniatura do Pinterest
As miniaturas que essas execuções retornam têm 236 pixels de largura. Se você já tem o JSON-LD do pin ou um registro da API, a URL em tamanho completo está nele e nenhuma reescrita é necessária. Trabalhando a partir de uma miniatura, o arquivo em tamanho completo está no mesmo caminho com o segmento de tamanho substituído. Essa troca costuma ser escrita como uma substituição de string de uma linha, e isso sozinho principalmente falha.
Em 40 miniaturas de feeds ativos, substituir /236x/ por /originals/ e manter a extensão .jpg funcionou 5 vezes. Retornou HTTP 403 as outras 35. O Pinterest recodifica: a miniatura é servida como .jpg enquanto o original armazenado costuma ser .png. Tentar as extensões uma após outra funcionou para todas as 40.
O arquivo que você baixa é a fotografia de outra pessoa, então o que você faz com ele é uma questão de licenciamento, não de scraping:
import re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

def full_size(thumb_url):
    """O Pinterest recodifica, então a extensão do original costuma diferir."""
    base = re.sub(r"/\d+x\d*/", "/originals/", thumb_url).rsplit(".", 1)[0]
    for ext in ("jpg", "png", "webp", "gif"):
        candidate = f"{base}.{ext}"
        req = urllib.request.Request(candidate, method="HEAD",
                                     headers={"User-Agent": UA})
        try:
            if urllib.request.urlopen(req, timeout=15).status == 200:
                return candidate
        except Exception:
            continue
    return None
Não mude a ordem, porém, porque qual extensão funciona varia por conta. Uma amostra de 40 retornou .png 35 vezes e .jpg 5. Uma amostra posterior de 40 em quatro contas retornou .webp 19, .jpg 15 e .png 6. Dentro disso, uma conta era inteiramente .jpg, outra inteiramente .webp, e uma terceira principalmente .png.
Planeje cerca de duas requisições HEAD por imagem: nessa amostra de quatro contas o loop fez em média 2,1 buscas antes de encontrar o arquivo.
Onde a abordagem do navegador quebra
O Playwright perde o resto do registro. O texto alt de todo tile é a string literal Pin, então os tiles não têm títulos. Nenhum deles envolve um link /pin/ também, então a grade não te dá nada para seguir.
Você recebe uma lista curta de URLs de imagem e nada mais: sem descrições, sem pinner, sem salvamentos, sem hashtags. Carregar a mesma busca em um navegador normal deslogado mostra o porquê:
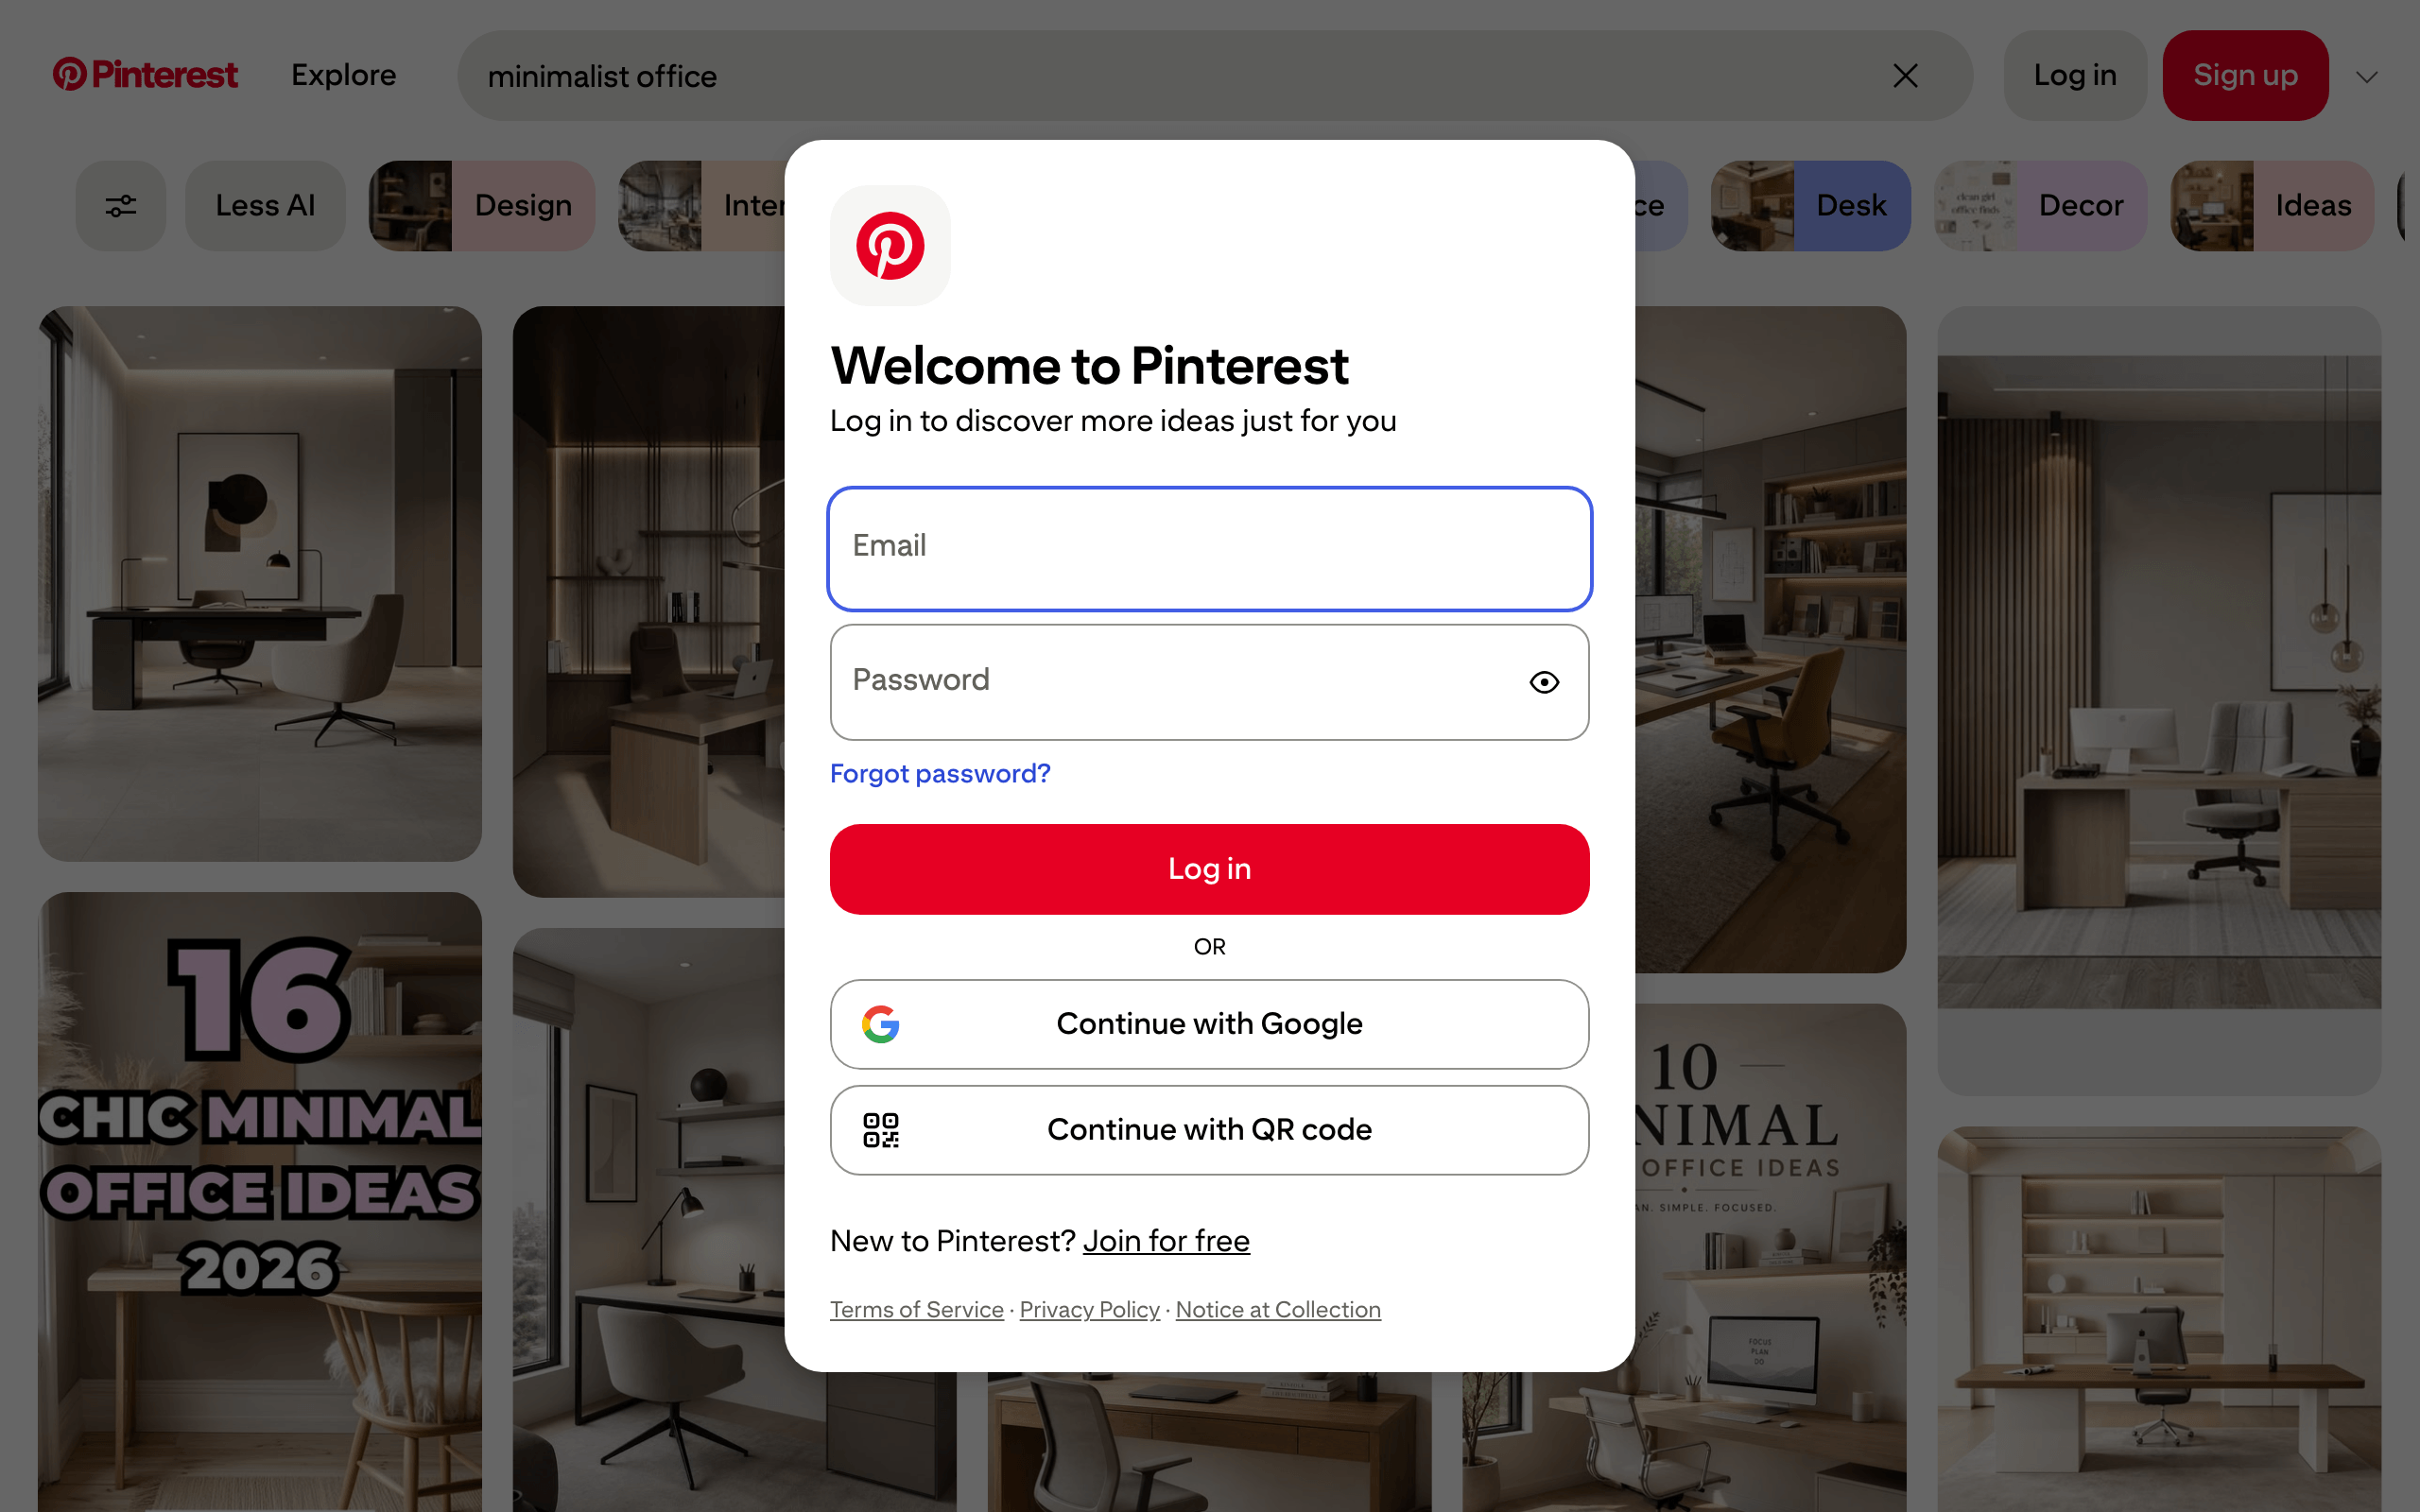
Os tiles ao redor do modal são os mesmos elementos gated-pin-rep que o script lê. Cada um contém uma imagem e nada mais, por isso a execução retorna URLs e nenhum título.
Rolar mais não muda nada. A grade mantém a mesma contagem depois de 3 rolagens e depois de 25, e o conjunto de URLs de miniatura nunca cresce além dele.
Essa contagem é estável dentro de uma sessão e varia entre elas. Execuções repetidas em uma sessão retornaram 17 toda vez para minimalist office e 15 toda vez para fall fashion. Sessões separadas nessas mesmas duas consultas retornaram 16, 17 e 18.
Espere uma contagem fixa em algum lugar na faixa média a alta das dezenas. Trate o número exato como específico da sessão, não como um número para confiar. Um modal de login cobre o feed e bloqueia a rolagem infinita que uma sessão logada recebe, com um campo de senha real bem ali no DOM.
Por que um navegador stealth não corrige isso
O próximo movimento natural é um navegador stealth, e é o diagnóstico errado para uma grade bloqueada. O Playwright não modificado mostra sinais de automação no nível de protocolo, mais visivelmente a chamada Runtime.enable no Chrome DevTools Protocol, e versões corrigidas ocultam isso. Patchright é um substituto direto para o pacote Playwright, e é construído para ocultar esses sinais sem tocar no seu script. Camoufox é uma compilação separada do Firefox em vez de um patch para o Playwright.
Direcionado à mesma consulta com um navegador de renderização e seu próprio pool de proxies, um desbloqueador comercial retornou a página deslogada por completo. Isso significava os prompts de cadastro, os botões de categoria, a barra de filtro, e nenhum título de pin ou link /pin/.
Execute o Patchright lado a lado com o Playwright não modificado nas mesmas duas consultas em uma sessão e nada muda. Ambos retornaram 16 tiles para minimalist office e 15 para fall fashion. Ambos retornaram zero links /pin/, Pin como o texto alt de todo tile, e o mesmo campo de senha no DOM.
Um bloqueio de estado de conta limita o feed deslogado, não um score de bot. Nenhum cookie do Bot Manager aparece em páginas de busca ou perfil. Os dez experimentos lop_unauth_lockdown estão ativos em __PWS_DATA__ em setembro de 2026, e a contagem de tiles é inalterada em quatro User-Agents.
O que é preciso para ir além
Para alcançar descrições, links e engajamento em uma busca com seu próprio navegador, você precisa de uma sessão que o Pinterest trate como um usuário real logado. Isso significa fazer login e manter cookies. Automatizar um login pessoal quebra os termos da plataforma, que proíbem acessar dados do Pinterest “usando meios automatizados (sem nossa permissão prévia expressa)”.
Volume é a outra restrição, e nesse alvo é reputação de IP em vez de fingerprinting. Cerca de 250 requisições de um endereço não produziram limitação de taxa nem desafio, então o limite é mais alto do que uma primeira tentativa sugere. Executar continuamente de um único endereço muda isso, e é o primeiro de três problemas que um scraper durável precisa lidar.
O que um scraper durável precisa
Obter uma tela de miniaturas é uma demonstração. Coletar milhares de registros de pin completos em uma agenda é um problema de infraestrutura.
- Diversidade de IP. Proxies residenciais espalham o mesmo trabalho por muitos IPs de consumidor em vez de um único endereço de datacenter. Dos três, a evidência aqui torna esse o que vale a pena pagar, e não apenas em escala. Um endereço classificado como hosting recebe páginas de pin sem o bloco JSON-LD, então o parse só funciona a partir de IPs de consumidor. A rotação importa além disso, uma vez que um único endereço executa continuamente.
- Tratamento de impressão digital e desafios. Um navegador gerenciado como a Browser API é construído para apresentar uma impressão digital real consistente. Também responde aos desafios que o Chromium headless simples deixa sem resposta, o que um pipeline precisa no momento em que se direciona a um site que aplica um. As páginas públicas do Pinterest são o caso fácil: sem cookies do Bot Manager, sem payload de sensor, e sem desafio em seis identidades de cliente.
- Manutenção. Seletores e bloqueios mudam sem aviso, como a mudança de
pinWrapperparagated-pin-repe o experimento de bloqueio mostram. Scrapling é construído para encontrar elementos novamente por similaridade quando nomes de classe mudam com frequência, o que ajuda com a metade de parsing do problema.
Você pode construir tudo isso, e os padrões gerais para manter um scraper de ser bloqueado se aplicam aqui da mesma forma que em qualquer outro lugar.
A contrapartida é que isso se torna um trabalho de engenharia contínuo, não um script que você escreve uma vez. Quando os custos de manutenção superam o valor de possuir o pipeline, você pode movê-lo para uma API de scraper gerenciada.
Fazer scraping do Pinterest com a Scraper API da Bright Data
A Pinterest Scraper API da Bright Data move a camada de navegador, proxy e desbloqueio para um serviço gerenciado. Você envia uma URL de pin, uma palavra-chave ou uma URL de perfil, e ela retorna um registro estruturado. Faz parte da Web Scraper API, com uma cota gratuita mensal e depois pagamento por uso por registro entregue. Todo exemplo de Scraper API neste guia foi executado dentro dessa cota.
Use o scraper do Pinterest aqui em vez de um desbloqueador de propósito geral: ele retorna registros parseados em vez de HTML bruto. Modos de acesso de propósito geral são uma rota separada para qualquer URL entre sites. Qual deles está disponível varia por conta. Também varia por zona, a configuração nomeada que você cria para cada produto.
A Bright Data aplica a lista de permissões do robots descrita anteriormente neste guia nessa camada. Um desses modos recusou uma requisição ao Pinterest de imediato exatamente nessa base.
A configuração é em duas etapas. A conta Bright Data abre sem cartão, e você mesmo cria a chave de API nas suas configurações de conta. Uma conta nova não tem chaves ainda, então a tabela de chaves de API começa vazia:
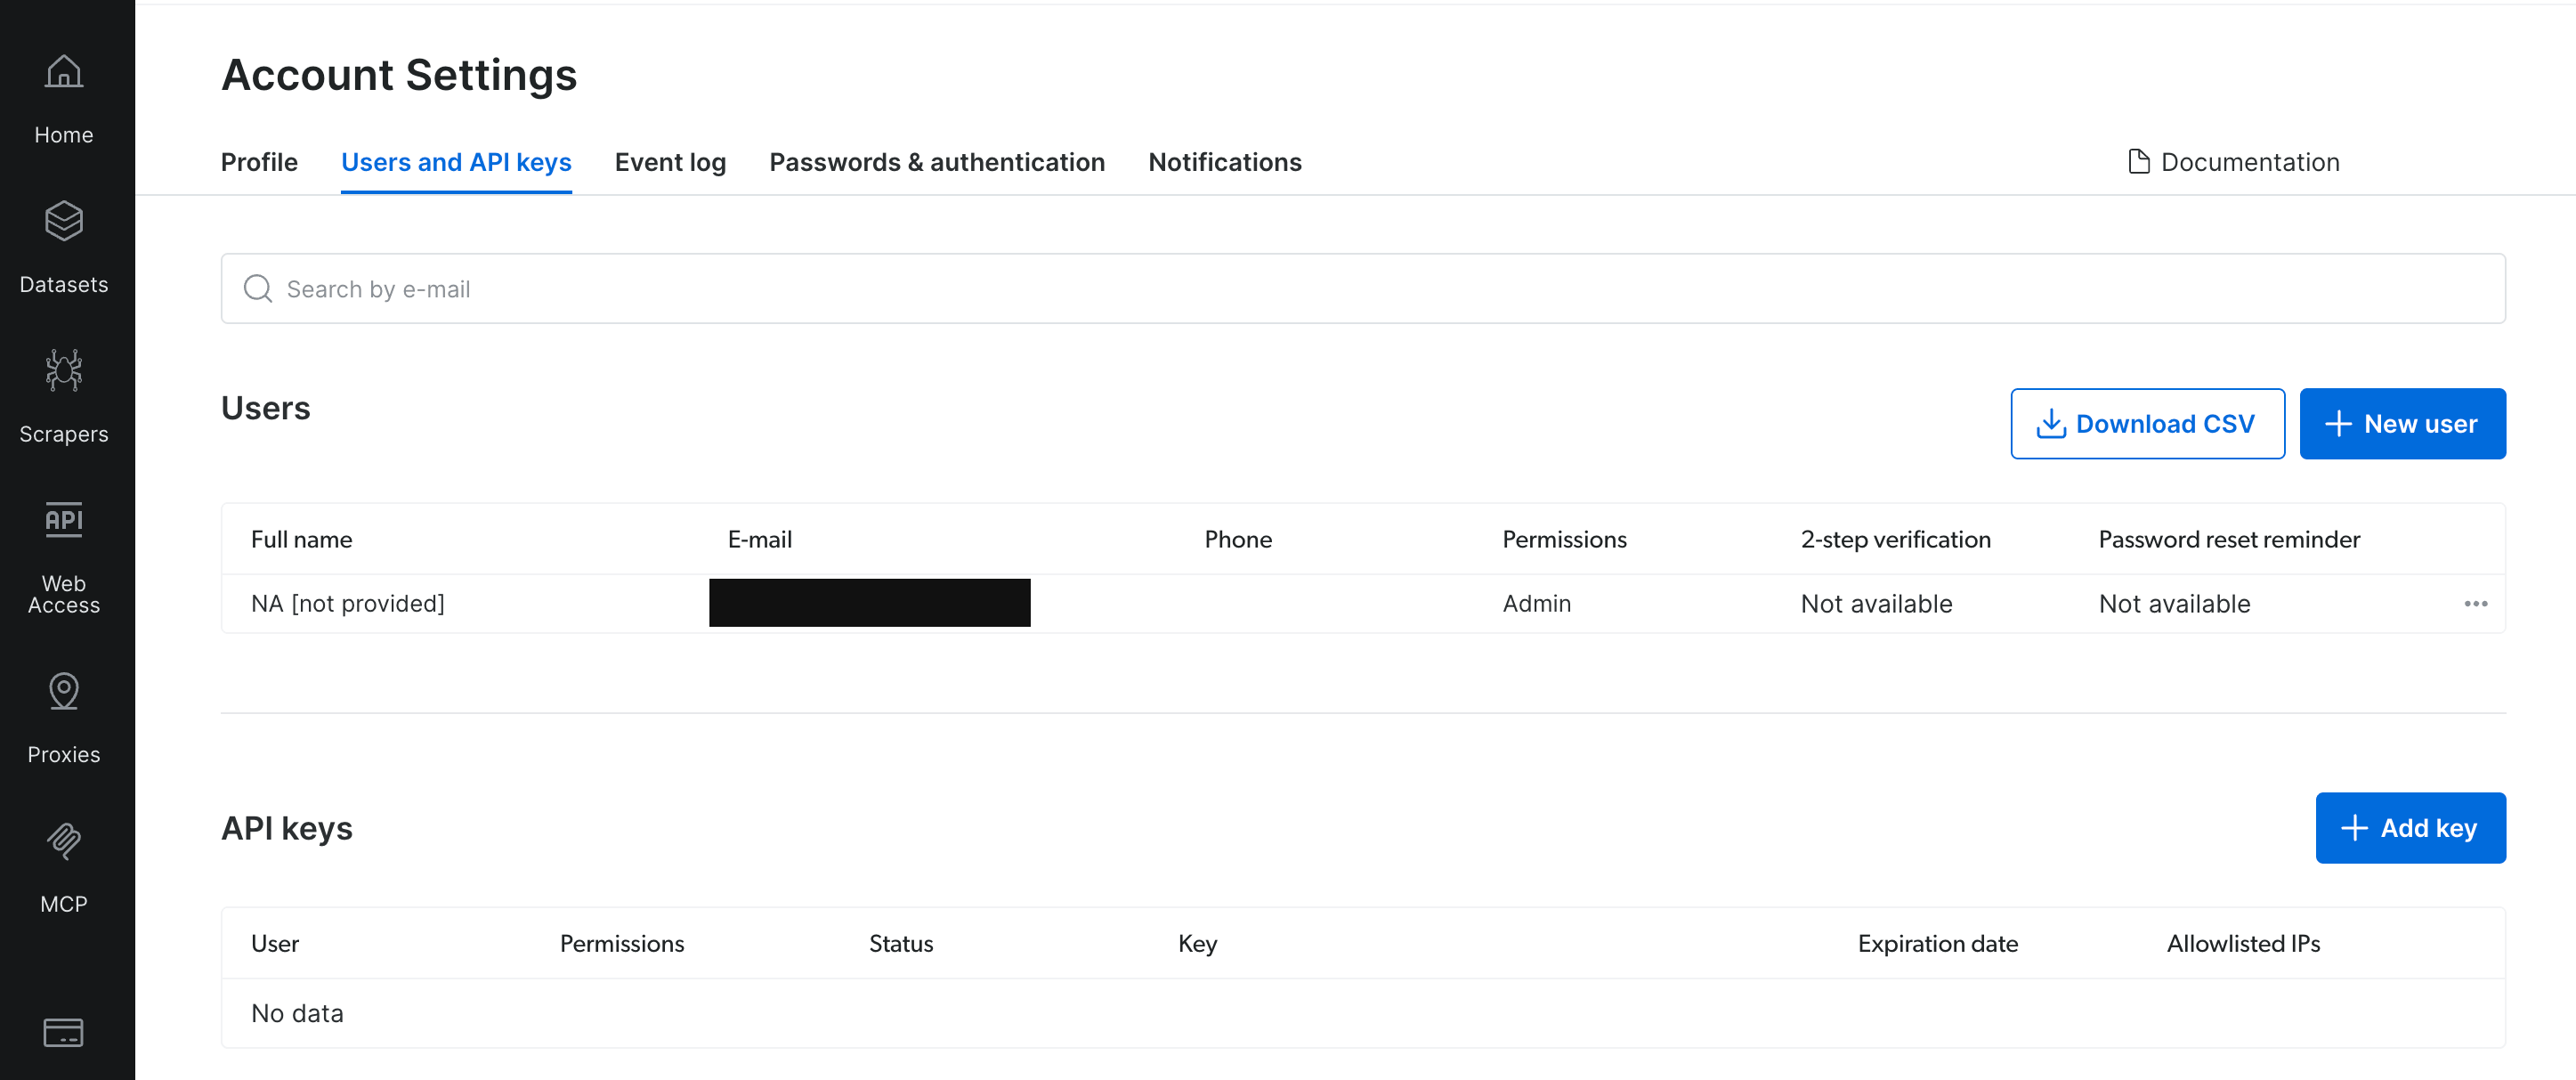
Adicione uma chave e o diálogo pede um usuário, um nível de permissão e uma expiração.
Escolha o nível de permissão destinado ao acesso à API em vez de faturamento ou administração. A documentação de autenticação da Bright Data o descreve como o que “permite o uso da API no nível de proxy/API”. Para a expiração, escolha uma data posterior ao fim do seu projeto para que a chave não expire no meio da execução.
Os exemplos usam o pacote requests, o mesmo usado anteriormente para os feeds de board:
pip install requestsEsse único pacote é toda a lista de dependências. Cada modo de coleta compartilha essa configuração, e o console os lista juntos para que você veja o que cada um faz antes de escrever qualquer coisa:
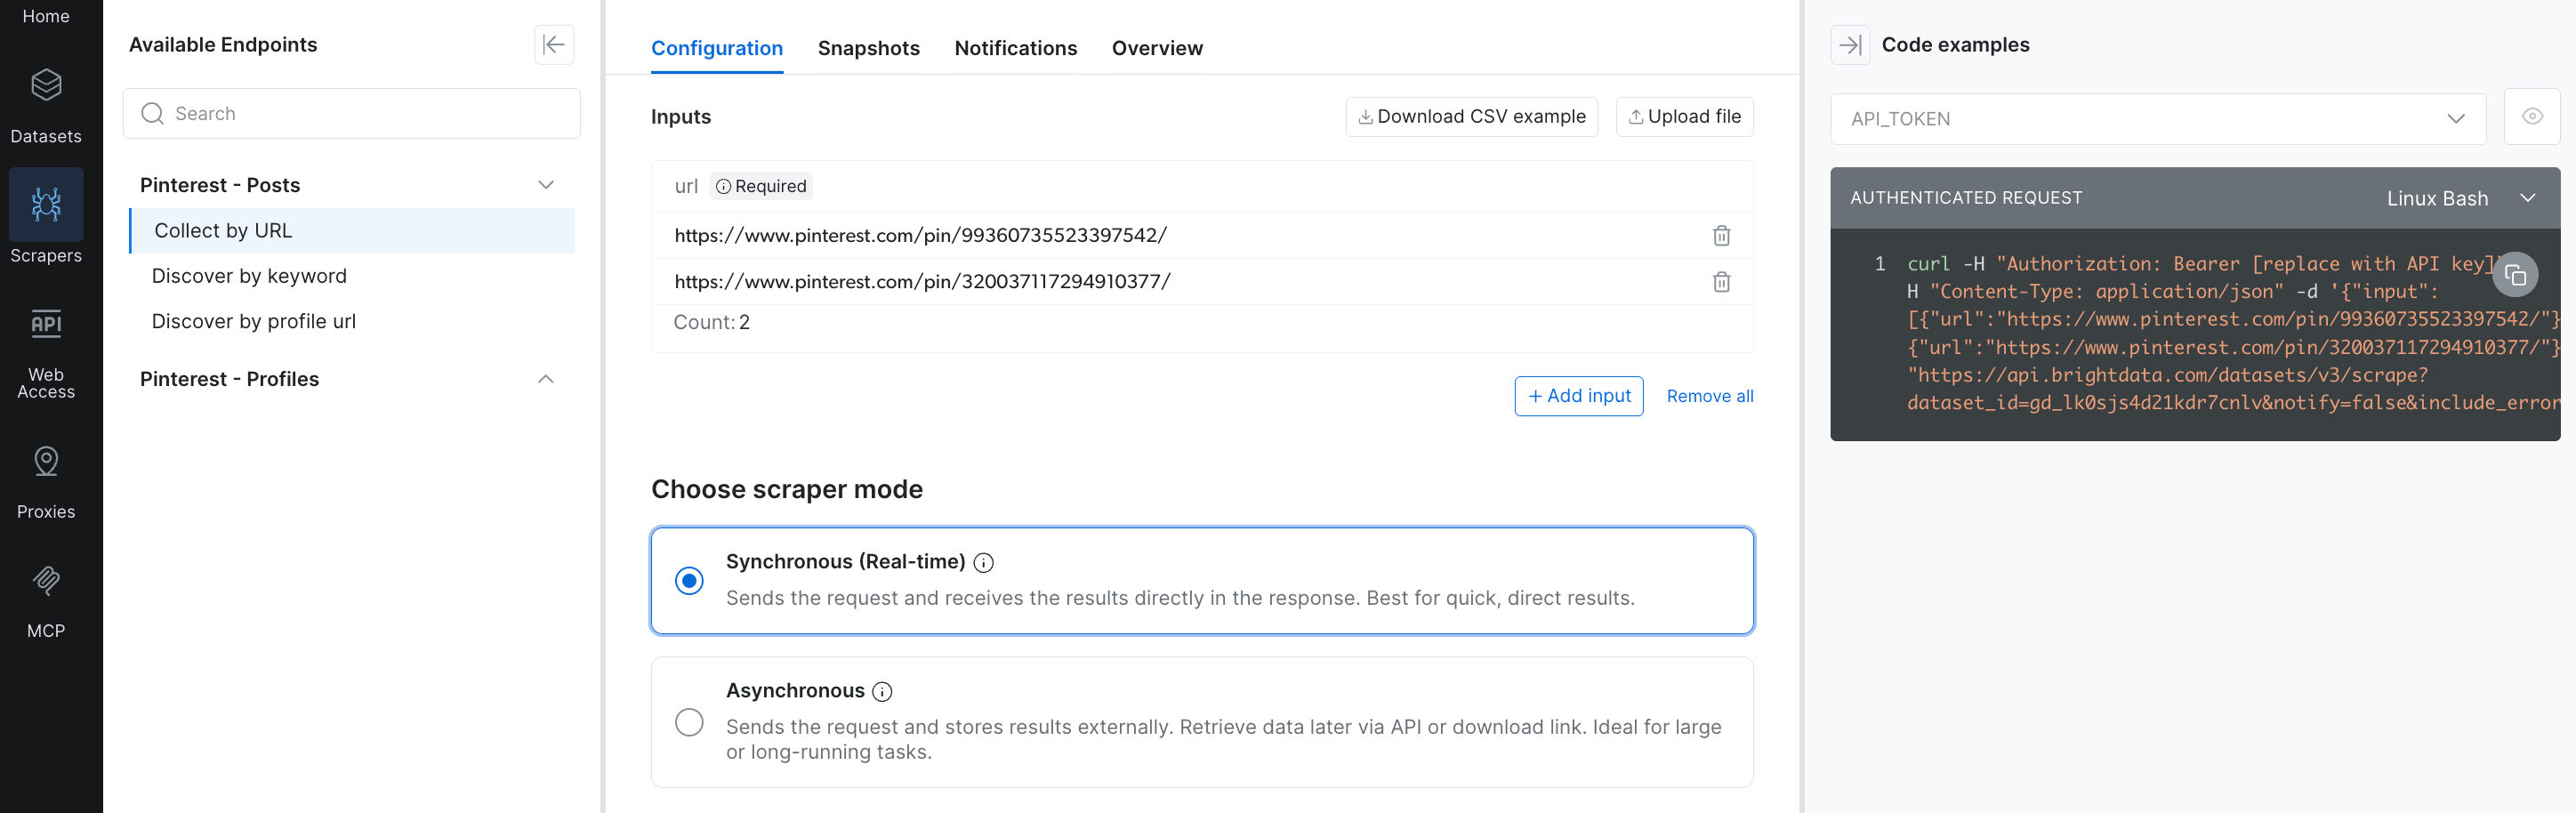
O painel lista os endpoints desse scraper. Os três usados aqui são coletar por URL, descobrir por palavra-chave e descobrir por perfil.
Coletar pins por URL
Envie uma ou mais URLs de pin e leia os registros da resposta. A flag include_errors=true faz a API reportar entradas com falha em vez de removê-las. Você filtra os erros você mesmo, e em troca vê o resultado de cada entrada:
import requests

API_KEY = "YOUR_API_KEY"  # crie isso nas configurações da sua conta Bright Data
# copie o ID do dataset atual da página do scraper
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"

resp = requests.post(
    "https://api.brightdata.com/datasets/v3/scrape",
    headers={"Authorization": f"Bearer {API_KEY}",
             "Content-Type": "application/json"},
    params={"dataset_id": DATASET_ID, "include_errors": "true"},
    json={"input": [
        {"url": "https://www.pinterest.com/pin/99360735523397542/"},
        {"url": "https://www.pinterest.com/pin/3166662230556591/"},
    ]},
    timeout=60,
)

# um erro HTTP levanta aqui, então resp contém registros
resp.raise_for_status()
for line in resp.text.strip().splitlines():
    print(line)
A resposta é JSON delimitado por quebra de linha, um objeto por entrada. A URL ativa retornou um registro com cerca de vinte campos, encurtado aqui aos relevantes. O pin removido retornou um erro:
{"url": "https://www.pinterest.com/pin/99360735523397542/", "post_id":
"99360735523397542", "title": "12 Bombshell Hair Color Ideas To Try This
Summer | Ecemella", "content": "Copper Red",
"date_posted": "2023-05-24T22:32:51.000Z", "user_name": "ecemella",
"user_url": "https://www.pinterest.com/ecemella", "likes": 2,
"categories": ["Beauty", "Hair"], "hashtags": ["Casual Fall Outfit
Inspiration", "Fall Fashion Outfit Ideas"], "image_video_url":
"https://i.pinimg.com/originals/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
"video_length": 0, "post_type": "image", "comments_num": 0}
{"input": {"url": "https://www.pinterest.com/pin/3166662230556591/"},
"error": "Bad input. Page does not exist.", "error_code": "dead_page"}
O registro corresponde ao parse JSON-LD em título, data e imagem, e adiciona o handle do pinner, categorias e hashtags em uma chamada. A contagem de salvamentos e o link de origem externo vêm do JSON-LD da página do pin em vez disso.
A URL com falha é um ID de pin real que o Pinterest removeu desde então. A API retorna um erro dead_page para ela em vez de uma falha, então você pode registrá-lo e continuar. A Bright Data precifica a Scraper API por registro entregue com sucesso, então nessa base um pin morto não deveria somar à fatura.
Pins são removidos com frequência, então planeje esse erro em qualquer lote. Combine respostas com entradas pelo próprio campo url ou input de cada objeto em vez de por posição. Em três execuções idênticas, a linha de erro chegou primeiro duas vezes e segunda uma vez.
O endpoint scrape geralmente responde inline. Quando um trabalho precisa de mais tempo, retorna um snapshot_id e uma mensagem de ainda em andamento, com os registros aguardando sob esse ID. Verifique um snapshot_id antes de fazer parse da resposta como registros, seja qual modo você tenha solicitado.
Descobrir pins por palavra-chave
O modo de descoberta é a rota para busca por palavra-chave, a única área que o bloqueio de login fecha para HTTP simples. Esse é o modo a usar quando você tem um tópico em vez de uma lista de URLs. Adicione type=discover_new e discover_by=keyword, e limite o volume por palavra-chave com limit_per_input:
import requests

API_KEY = "YOUR_API_KEY"
# copie o ID do dataset atual da página do scraper
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"

resp = requests.post(
    "https://api.brightdata.com/datasets/v3/scrape",
    headers={"Authorization": f"Bearer {API_KEY}",
             "Content-Type": "application/json"},
    params={"dataset_id": DATASET_ID, "include_errors": "true",
            "type": "discover_new", "discover_by": "keyword"},
    json={"input": [{"keyword": "minimalist office"},
                    {"keyword": "fall fashion"}],
          "limit_per_input": 4},
    timeout=180,
)
# um erro HTTP levanta aqui, então resp contém registros
resp.raise_for_status()
print(resp.text)
Cada palavra-chave retorna até o limite que você define. Cada registro adiciona um campo discovery_input nomeando a palavra-chave que o encontrou. Onde o pin tem uma descrição, um campo content contém o texto completo. Um registro da execução de minimalist office, com a descrição reduzida:
{"url": "https://www.pinterest.com/pin/320037117294910377", "title":
"Minimal Cream Office With Ultrawide Monitor, Wood Desk and Natural Window
Light", "content": "A pale wood desk sits beside a bright window with an
ultrawide monitor... #MinimalCreamOffice #PaleWoodWorkspace",
"user_name": "theSetupDistrict", "categories": ["Home Decor"],
"date_posted": "2026-08-25T15:59:51.000Z",
"discovery_input": {"keyword": "minimalist office"}}
Então uma única palavra-chave é suficiente para obter registros de pin estruturados. A maioria inclui uma descrição e categorias, nenhuma das quais aparece na grade de busca deslogada.
Fazer crawl de um perfil inteiro com a API assíncrona
Fazer crawl de todo pin em um perfil é mais do que uma única resposta pode conter, então a API o executa como um trabalho em segundo plano. Você inicia o trabalho, recebe um ID e coleta os registros quando ele termina. Trocar o modo no console mostra a diferença na própria requisição:
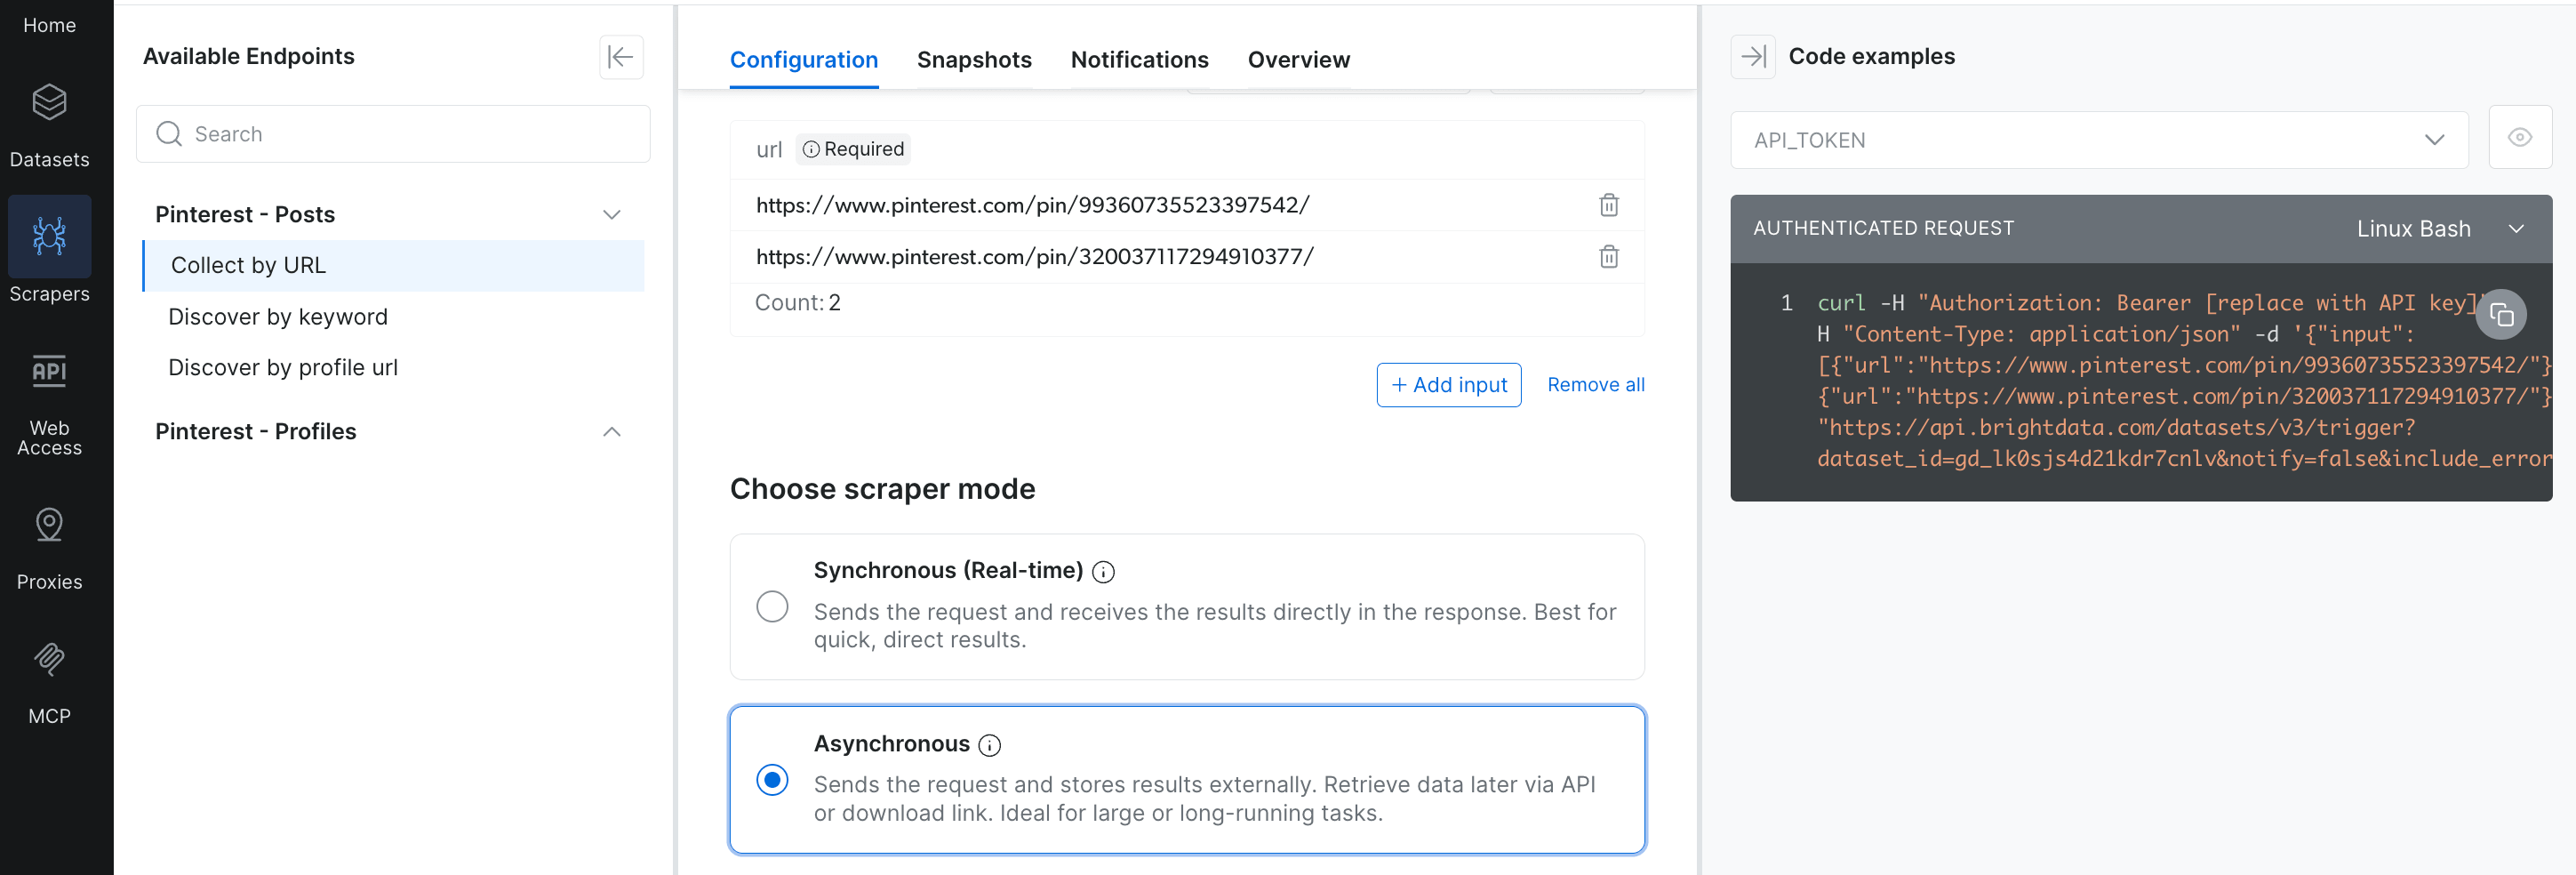
Selecionar o modo assíncrono reescreve o caminho para você: o endpoint scrape se torna trigger. A execução então retorna um snapshot_id para consultar, em vez de manter uma conexão aberta.
Use o endpoint trigger, que retorna um snapshot_id imediatamente:
import requests

API_KEY = "YOUR_API_KEY"
# copie o ID do dataset atual da página do scraper
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"
HEADERS = {"Authorization": f"Bearer {API_KEY}",
           "Content-Type": "application/json"}

start = requests.post(
    "https://api.brightdata.com/datasets/v3/trigger",
    headers=HEADERS,
    params={"dataset_id": DATASET_ID, "include_errors": "true",
            "type": "discover_new", "discover_by": "profile_url"},
    json={"input": [{"url": "https://www.pinterest.com/boredpanda/",
                     "start_date": "", "end_date": ""}],
          "limit_per_input": 4},
    timeout=60,
)
# um erro HTTP levanta aqui, então start.json() contém um snapshot_id real
start.raise_for_status()
snapshot_id = start.json()["snapshot_id"]
print("snapshot:", snapshot_id)
O start_date e end_date vazios são opcionais, e deixá-los em branco coleta sem filtro de data. Então consulte o endpoint de progresso até que o trabalho esteja pronto e baixe o snapshot. A resposta de progresso reporta contagens e quaisquer códigos de erro, então você sabe o que está recebendo antes de buscá-lo:
import requests, time

API_KEY = "YOUR_API_KEY"
HEADERS = {"Authorization": f"Bearer {API_KEY}",
           "Content-Type": "application/json"}
# impresso pelo bloco trigger; mantenha para rebaixar uma execução que falhou
snapshot_id = "sd_..."

progress_url = f"https://api.brightdata.com/datasets/v3/progress/{snapshot_id}"
while True:
    poll = requests.get(progress_url, headers=HEADERS, timeout=30)
    # um erro HTTP levanta aqui, então poll.json() é um objeto de progresso real
    poll.raise_for_status()
    progress = poll.json()
    if progress["status"] in ("ready", "failed"):
        break
    time.sleep(10)

# records e error_codes dizem o que a execução produziu; status só diz que ela parou
codes = progress.get("error_codes") or {}
if progress["status"] == "failed" or not progress.get("records"):
    raise RuntimeError(
        f"{snapshot_id} finished with no records to download: "
        f"{progress['status']}, {codes}")

data = requests.get(
    f"https://api.brightdata.com/datasets/v3/snapshot/{snapshot_id}",
    headers=HEADERS, params={"format": "json"}, timeout=120,
).json()

# include_errors=true reporta entradas com falha como linhas, então filtre antes de contar
records = [row for row in data if not row.get("error_code")]
if codes:
    print(f"skipped {sum(codes.values())} failed inputs: {codes}")
print(f"downloaded {len(records)} records")
Esse loop cuida da mecânica. O que a resposta diz sobre a execução precisa de mais atenção.
Leia a resposta de progresso antes de baixar
A resposta de progresso inclui errors e error_codes junto com status, e todos os três importam. ready sozinho significa que o trabalho parou, não que toda entrada teve sucesso. Uma execução pode terminar ready com records: 0 e uma contagem de errors diferente de zero.
Um loop que testa apenas status imprimirá downloaded 0 records e continuará como se tivesse tido sucesso. Levantar erro em uma execução com zero registros é o padrão correto. Levantar erro apenas em erros não é: um crawl que pula alguns pins removidos e ainda retorna registros está funcionando exatamente como pretendido.
O download precisa do mesmo cuidado, porque include_errors=true coloca entradas com falha no snapshot como linhas ao lado de registros reais. A contagem bruta de linhas pode, portanto, ser maior do que os registros que você mantém. Uma execução reportando um registro pode retornar três linhas: duas entradas dead_page sem url, e um pin completo. Filtre em error_code antes de contar ou armazenar qualquer coisa.
Uma execução de perfil em boredpanda retorna em cerca de 21 segundos com os 4 registros que o limite permitiu, cada um marcado com seu discovery_input. Crawls de perfil executam de forma assíncrona por design, mesmo quando você chama o endpoint síncrono scrape.
Um crawl de palavra-chave ou perfil também reporta pins mortos como entradas dead_page nos error_codes de progresso. Uma execução que retorna menos registros válidos do que seu limite geralmente encontrou pins removidos, não um bug no seu código.
Verifique uma execução e colete o registro de perfil
Toda execução é registrada no console, então você tem um histórico de execuções sem precisar construir um:
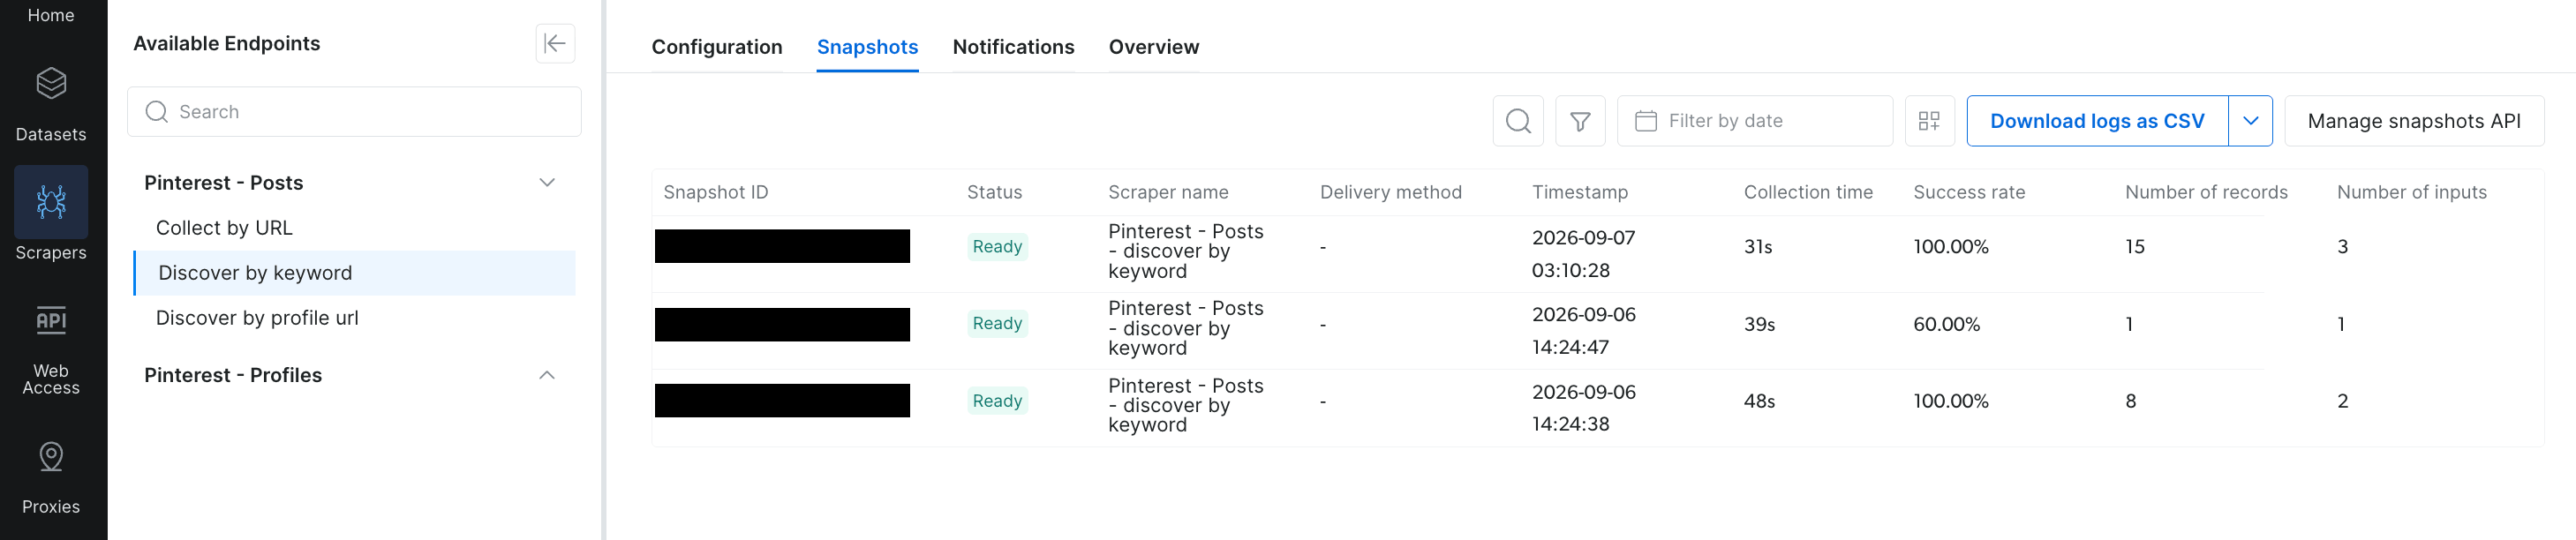
Uma execução cujo ID você nunca registrou ainda está aqui para rebaixar. Duas dessas executaram sem erros a 100%; a terceira lê 60%, com dois pins removidos registrados na sua coluna de erro.
Essa execução do meio retornou um único registro porque dois dos pins que encontrou haviam sido removidos. O console registra isso como dead_page: 2 sob uma coluna de erro que este recorte não alcança. Verifique essa coluna nas suas próprias execuções antes de tratar alguns registros como uma requisição quebrada. A taxa de sucesso é o próprio número do console para as páginas que um crawl visitou, então leia-a junto com as contagens de registros e erros.
Um segundo scraper retorna o próprio registro de perfil, junto com os pins que o crawl de perfil coleta. Troque o ID do dataset para o da página do scraper de perfis do Pinterest, e envie a URL do perfil sem discover_by. Para a mesma conta ele retornou um follower_count de cerca de 3 milhões e um boards_num de 51 no momento do teste. Também retornou um array saved de boards com suas contagens de pins, 10 dos 51.
Esse scraper retorna um snapshot_id em vez de registros inline, então consulte-o da mesma forma. Levou pouco menos de quatro minutos no teste, comparado com os cerca de vinte segundos do crawl de pin, então defina o intervalo de consulta em minutos.
O que os registros contêm
Dez campos apareceram em todos os 30 registros testados: url, post_id, date_posted, user_name, user_url, post_type, image_video_url, video_length, likes e comments_num. Esses eram o núcleo estável no momento. Quatro mais são comuns em vez de garantidos: title em 27 dos 30, categories em 24, content em 22, e hashtags em 16. Leia esse segundo grupo com .get() em vez de indexação direta.
Contagens de salvamentos são o número de engajamento que a maioria das análises do Pinterest quer, e você as obtém de uma junção de duas fontes em post_id. A API fornece descoberta e o registro estruturado. O JSON-LD da página do pin fornece a contagem de salvamentos, que retornou em 5 dos 6 pins verificados.
Verifique os números reais antes de construir uma métrica sobre eles. Amostrar oito pins recentes de cada uma de três contas retornou medianas de 1, 1 e 2, enquanto pins individuais alcançaram centenas. Então o contador é por pin em vez de por imagem. likes retornou 0 em 5 desses mesmos 6, o que corresponde ao Pinterest ter removido curtidas como métrica pública anos atrás.
Nos mesmos 6 pins, títulos concordaram entre as duas fontes todas as vezes, e datas em 3 de 6. Nomes de pinner geralmente também concordam, mas é o campo em que não confiar. O pin usado ao longo deste guia é um caso em que diferem: sua resposta oEmbed e seu registro de API nomeiam pessoas diferentes.
O registro da API nomeia a conta por trás do site que o pin vincula, enquanto o JSON-LD e o oEmbed nomeiam o indivíduo que o salvou. Quando um pin é ressalvo de outra conta, as duas fontes podem nomear pessoas diferentes. Junte os dois conjuntos de dados na URL do pin ou post_id, nunca no pinner.
Onde as datas diferiam, o date_posted da API estava no dia ou perto do dia em que o pin apareceu no feed. O datePublished do JSON-LD era mais antigo, em um caso por vários anos. Decida qual definição sua análise precisa antes de misturar os dois.
Qual método de scraping do Pinterest você deve usar?
A escolha depende de onde você está partindo e quanto do registro você precisa:
| Fator | HTTP simples (JSON-LD, oEmbed, RSS) | Playwright (DIY) | Bright Data Scraper API |
|---|---|---|---|
| Configuração | requests e a biblioteca padrão |
Instalar Playwright e um navegador | Chave de API mais requests |
| Dados retornados | Registro completo para um pin conhecido, além de um registro de perfil estruturado | Apenas URLs de imagem da busca ou de um perfil | Título, descrição, pinner, hashtags, categorias, mídia; salvamentos vêm da página do pin, unidos em post_id |
| Descoberta | Feeds de board e o backend de widget, sem busca | Tiles bloqueados em uma busca | Pins por URL, palavra-chave ou perfil completo |
| Bloqueio | Seus próprios IPs, nenhum desafio TLS observado | Você gerencia proxies e manutenção | Camada de proxy e desbloqueio gerenciada |
| Manutenção | Sua, quando um feed ou o bloco JSON-LD muda | Sua, quando o Pinterest muda marcação ou bloqueios | Do provedor, através das mesmas mudanças de marcação e bloqueio |
| Custo | Gratuito de um IP, 1,24 GB em 10.000 páginas de pin e muito menos via oEmbed | Gratuito, mais 43,5 GB de tráfego de proxy em 10.000 pins | Uma cota gratuita mensal, depois precificado por registro entregue com sucesso |
O HTTP simples alcança mais do que a maioria dos guias sugere. Retorna qualquer pin ativo que você nomear, um registro de perfil estruturado e pins recentes de todo board que uma conta mostra. Executar ambos os métodos gratuitos sobre todo board em uma conta retornou 435 pins únicos.
A restrição é quanto você consegue alcançar, e é mais estreita do que parece. Esses 435 são de mais de 9.000 pins mantidos nos nove boards de onde vieram, menos de 5%. Nenhum método gratuito alcança busca por palavra-chave, e o Playwright adiciona apenas miniaturas bloqueadas. A Scraper API é para descoberta por palavra-chave, crawls completos de perfil e coleta recorrente.
Quanto cada método custa em 10.000 pins
O tamanho do payload define a conta, medido pelos bytes realmente transferidos. A tabela assume um cliente que negocia compressão. Uma página de pin medindo cerca de 1,13 MB descomprimido transfere cerca de 124 KB com Brotli, ou 183 KB com o cabeçalho gzip que o requests envia. Execute o exemplo da stdlib em vez disso e todo número na linha de HTML da página do pin multiplica por aproximadamente 9.
Os bytes são medidos aqui; as taxas não são. Duas taxas definem cada valor em dólar na tabela. Ambas são preços de tabela da Bright Data de setembro de 2026, então as linhas de largura de banda e a linha de registro usam uma única base:
- Largura de banda residencial, $8/GB. A taxa de tabela de pagamento por uso na página de preços da rede de proxies, que cai no maior plano de compromisso publicado.
- Scraper API, $1,50 por 1.000 registros entregues. A taxa de tabela de pagamento por uso na página de preços da Web Scraper API, que cai com o volume nos planos publicados mais altos. A mesma página lista uma cota gratuita mensal; a tabela usa o preço de tabela para cada registro.
Ambas as páginas também mostram promoções, e ambas mudam sem que este post mude. Leia as taxas atuais nessas duas páginas antes de estimar custos. Coloque o que te foi cotado na multiplicação na última coluna.
| Método | Medido em | Bytes transferidos por pin | Volume para 10.000 | Custo nessas taxas |
|---|---|---|---|---|
| Feed RSS, por pin listado | largura de banda | 147 B | 0,0015 GB | × $8/GB = $0,01 |
| JSON oEmbed | largura de banda | 583 B | 0,006 GB | × $8/GB = $0,05 |
| HTML da página do pin | largura de banda | 124 KB | 1,24 GB | × $8/GB = $9,92 |
| Scraper API | registros entregues | mesmo em qualquer tamanho de página | 10.000 registros | × $1,50/1k = $15,00 |
| Página do pin via Playwright | largura de banda | 4,35 MB | 43,5 GB | × $8/GB = $348,00 |
As linhas diferem no que uma falha custa. Um pin removido ainda responde HTTP 200 com uma página completa, então as linhas de largura de banda pagam por seus bytes. A linha de registro é precificada por registro entregue.
O que os valores em dólar não mostram
Carregar o mesmo pin em Chromium headless baixa 4,35 MB em cerca de 180 respostas. Isso é aproximadamente 35 vezes o que uma busca simples move para o mesmo registro.
Cerca de 3,1 MB disso é JavaScript, por isso a forma usual de economizar bytes mal ajuda. Bloquear imagens, fontes e folhas de estilo reduz para 3,8 MB e nada mais baixo, porque a página ainda precisa de seus scripts para renderizar.
Tempo é o outro custo. Uma busca de página de pin rodou com mediana de 0,8 a 1,0 segundo em duas execuções de 15 requisições de uma única máquina. Execuções completas terminam mais devagar do que essa mediana sugere.
Três passagens sobre um feed de 25 pins com um atraso de meio segundo terminaram entre 21 e 33 pins por minuto. Executando um de cada vez, isso é de 5 a 8 horas para 10.000 pins. Executá-los em paralelo encurta isso e concentra sua taxa de requisição em um endereço ao mesmo tempo.
O que os valores de custo realmente comparam
O oEmbed move 583 bytes comparado com os 124 KB da página do pin. Buscar uma página inteira para ler um nome de autor é desperdício.
Uma API gerenciada compra duas coisas: alcance, e alguém mais fazendo a manutenção. Ela alcança os tipos de página além do HTTP simples, busca por palavra-chave e crawls completos de perfil. A economia vem disso, não de bytes transferidos.
Na mesma base, a linha de página do pin e a linha da Scraper API estão próximas, dentro de cerca de 1,5x. Ambos os lados têm promoções que as reduzem ainda mais. Qual é mais barata depende de taxas que nem este post nem você controlam.
A comparação com um navegador headless não é próxima. Em toda taxa publicada na mesma página de preços de proxy, 43,5 GB de tráfego custa um múltiplo do que 10.000 registros custam.
Os dois números não medem a mesma coisa, então leia o que cada um inclui. A linha de tráfego é largura de banda e nada mais. Exclui mínimos de plano de proxy e as horas gastas construindo e mantendo o pipeline. Também assume que você já tem 10.000 URLs de pin, o que nenhum método gratuito fornece nessa escala.
O número de registro é mais amplo: inclui a descoberta que produziu a lista de URLs, e sua taxa melhora com volume. Mínimos de plano se aplicam em ambos os lados, então confirme-os para um trabalho grande da mesma forma que você verificaria uma cotação de proxy.
Próximos passos
Comece com a ferramenta mais leve para os dados de que você precisa. Se você tem as URLs de pin, o parse JSON-LD retorna registros completos via HTTP simples, e o oEmbed sozinho dá atribuição. Se você está acompanhando um criador ou um board, encadeie o feed RSS a esse parse e nunca carregue um navegador.
Busca por palavra-chave e crawls completos de perfil são os casos além dessas rotas. A Pinterest Scraper API aceita uma palavra-chave ou uma URL de perfil e retorna registros estruturados, com uma cota gratuita mensal para testar.
Para qualquer coisa que você planeje manter rodando, defina três padrões desde o início:
- Trate pins removidos em todo lote. Isso significa um
Nonedo parse JSON-LD, ou uma entradadead_pageda API. - Mantenha cerca de meio segundo entre requisições. Esse ritmo rodou entre 21 e 33 pins por minuto em execuções completas, e não produziu limitação de taxa em cerca de 250 requisições.
- Registre o
snapshot_idpara trabalhos assíncronos. Uma execução que falhou pode então ser baixada novamente.
Para ir além de um único endereço, direcione através de proxies residenciais e mantenha o parsing que você já tem. Se preferir comprar os dados a coletá-los, o conjunto de dados do Pinterest já está pronto para download
Perguntas frequentes
É possível fazer scraping do Pinterest?
Sim. Uma URL de pin geralmente retorna título, descrição, contagem de salvamentos, pinner e link externo de um bloco JSON-LD via HTTP simples, sem necessidade de navegador. Feeds RSS de perfil e board listam URLs de pins recentes. Busca por palavra-chave é a exceção e precisa de uma API de scraper.
O Pinterest bloqueia scrapers?
Não, não em páginas de pin públicas a partir de um endereço residencial. Doze requisições com o User-Agent padrão do urllib retornaram todas HTTP 200, sem cookies do Akamai Bot Manager. Um IP de datacenter é a exceção: a página ainda retorna 200, mas sem seu bloco JSON-LD.
Por que meu scraper do Pinterest não está funcionando?
O registro está em um bloco JSON-LD, não no Redux store, então initialReduxState.pins lê vazio. Em grades de busca o antigo seletor pinWrapper não corresponde a nada, já que tiles deslogados agora usam gated-pin-rep. Um pin removido ainda responde HTTP 200 sem nenhum bloco JSON-LD.
O Pinterest tem uma API pública?
Sim, mas é limitada à sua própria conta. A API v5 do Pinterest gerencia seus boards, pins e anúncios, não pins públicos de outros usuários. O acesso de teste tem um limite diário de requisições. A única busca por palavra-chave é um beta não disponível para todos os apps, limitado aos 10 principais resultados.
O Pinterest tem um feed RSS?
Sim. O Pinterest publica feeds não autenticados em /<username>/feed.rss e /<username>/<board-slug>.rss. Em 12 contas eles retornaram de 22 a 26 itens recentes, com URLs de pins, carimbos de data/hora e miniaturas, mas quase nenhum título. Feeds listam apenas pins novos, sem busca por palavra-chave e sem profundidade histórica.
Como eu baixo imagens em tamanho completo do Pinterest?
Substitua o segmento de tamanho na URL da miniatura por originals, depois tente .jpg, .png, .webp e .gif em sequência. Manter o próprio .jpg da miniatura retornou 403 em 35 de 40 pins, porque o Pinterest recodifica. Planeje cerca de duas requisições HEAD por imagem.
Como eu faço scraping de um board do Pinterest?
Remova qualquer barra final da URL do board e adicione .rss. Uma barra final retorna a página HTML em vez do feed. O feed para perto de 25 itens, não importa o tamanho do board. O backend de widget em widgets.pinterest.com/v3/pidgets/ retorna até 50, e além disso você faz crawl do perfil inteiro.