Na nova era da engenharia agêntica, “contexto” não é mais apenas dado; é o combustível para cada decisão que seu agente toma. Ainda assim, a maioria das equipes trata o contexto como uma entrada estática, e não como um desafio dinâmico de engenharia. O verdadeiro gargalo não é apenas o acesso aos dados – é a capacidade de moldar esses dados em um estado que seja atualizado, verificado e eficiente em tokens o suficiente para um raciocínio confiável.
Context-as-a-Service surgiu como uma solução fundamental para fornecer aos agentes o melhor contexto possível. O CaaS oferece a infraestrutura para transformar esses enormes dados web não estruturados em uma base de conhecimento pronta para agentes. Eles investem tempo na engenharia do contexto e das fontes das quais os agentes recebem suas informações finais conectadas e estruturadas.
O CaaS conecta a base de conhecimento bruta que os humanos passaram uma vida construindo (dados da web) e a execução inteligente, oferecendo suas camadas de dados específicas de domínio; garantindo que os agentes não estejam buscando informações, mas sim alimentados por contexto enriquecido e verificado, adaptado para raciocínio automatizado e tomada de decisões.
No entanto, isso tem um custo: você está constantemente alugando o contexto engenheirado de outra pessoa para alimentar seus agentes.
O Custo Oculto de Alugar Contexto
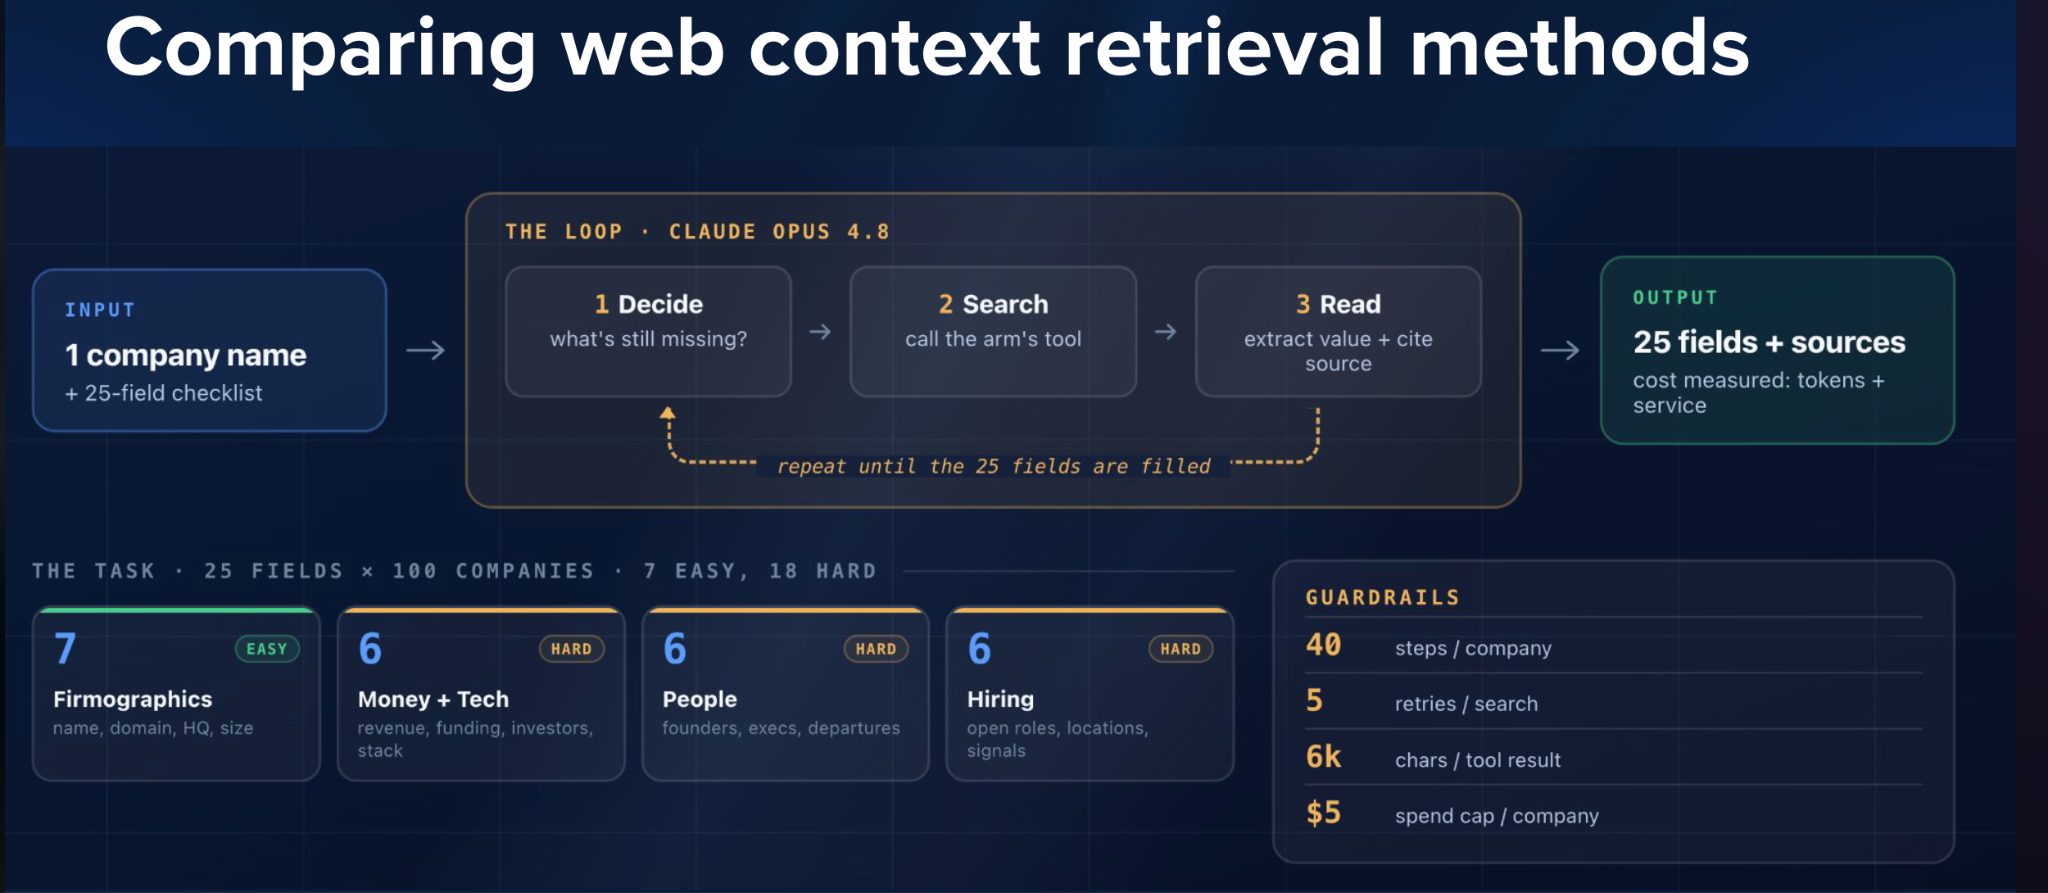
Para entender as trocas econômicas dessa infraestrutura, pedimos a um agente de IA que enriquecesse 100 empresas com 25 campos de dados usando vários métodos de recuperação. Os campos incluíam firmográficos fáceis de obter (sede, número de funcionários, domínio) e outros mais difíceis, como receita, dados financeiros, stack tecnológico, pessoas e sinais de contratação.
A ferramenta de recuperação à qual a IA tinha acesso era a única variável que mudava.
Harness shape
Methods compared
| Nome público | O que representa |
|---|---|
| Search 1 / Search 2 / Search 3 | Ferramentas de busca de IA projetadas para alimentar uma janela de contexto em vez de uma aba do navegador. |
| Native | Busca nativa do modelo dentro do ambiente do modelo. |
| CaaS 1 / CaaS 2 / CaaS 3 | Serviços de contexto e provedores verticais. |
| Unlocker + SERP | Agente em infraestrutura web bruta: resultados de busca mais páginas desbloqueadas. |
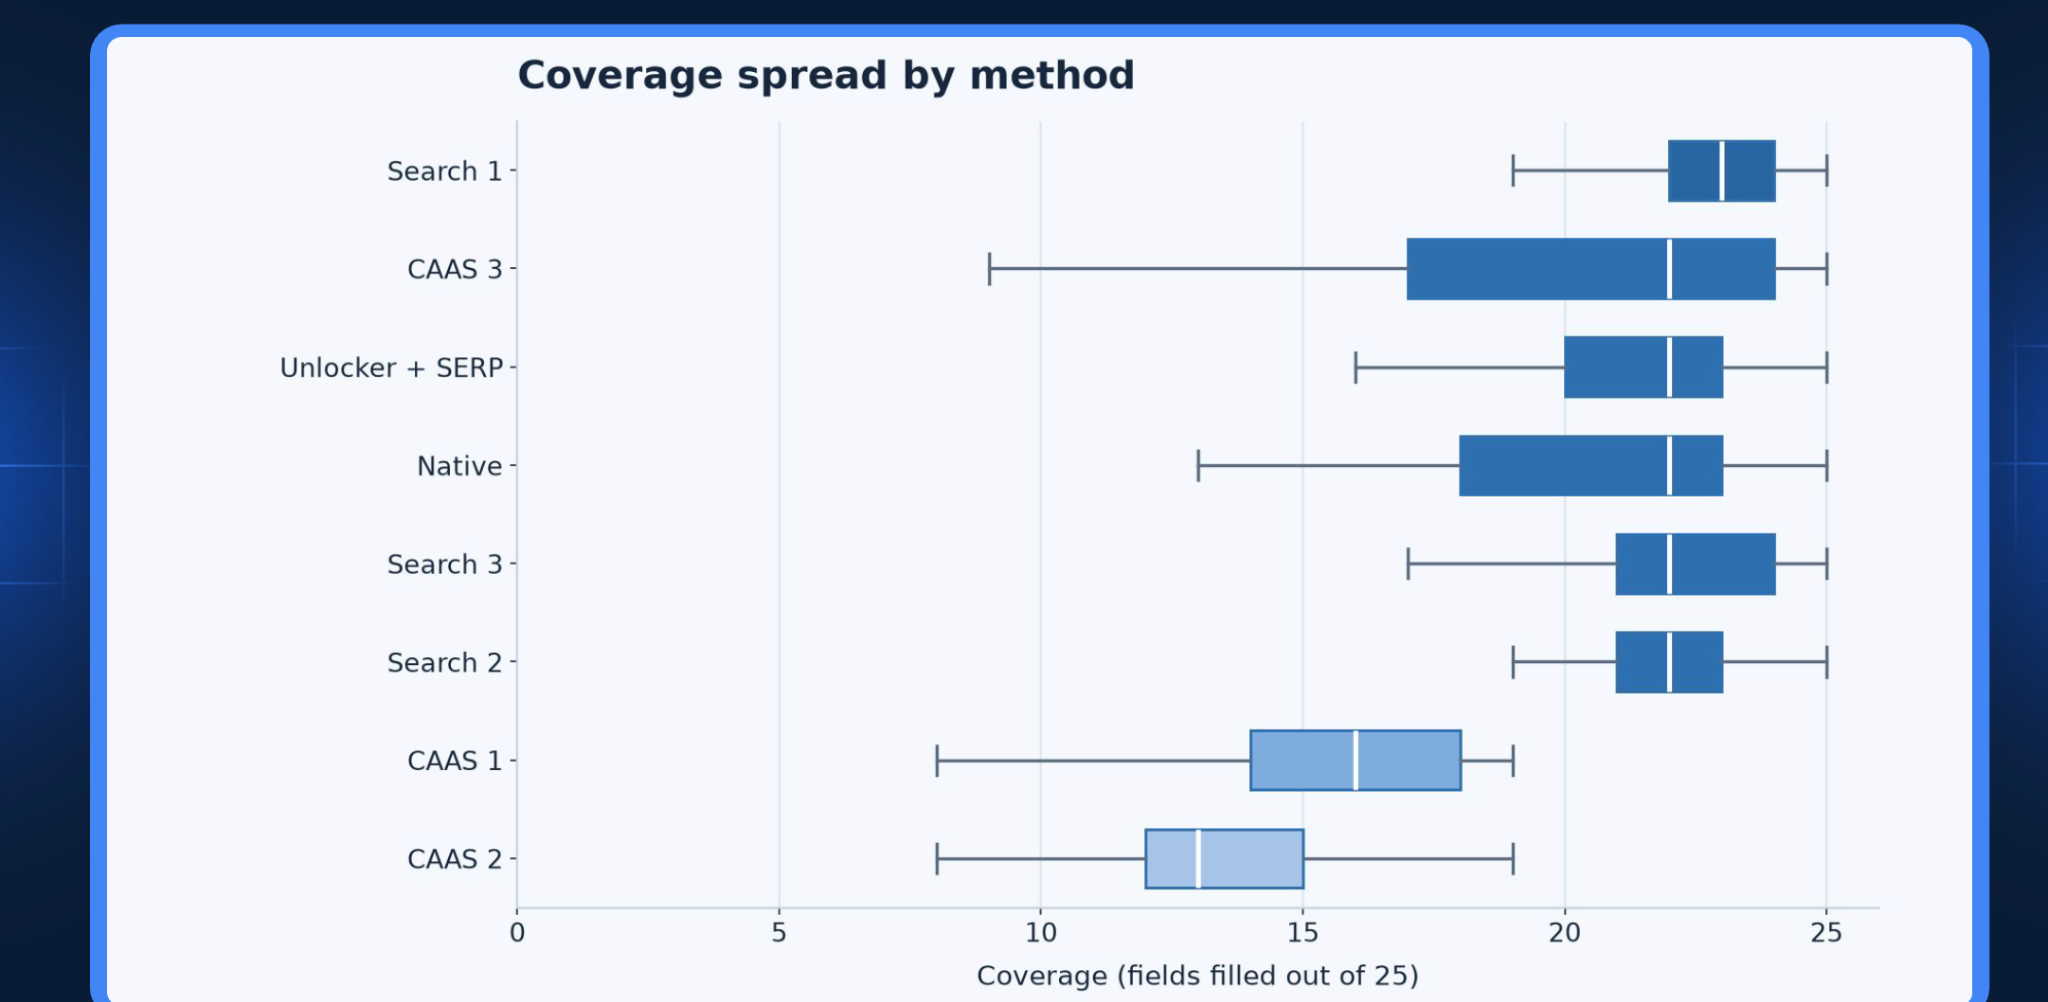
Cobertura é o quanto de dados cada método conseguiu preencher…
O custo se divide em duas partes: o preço do próprio serviço e os tokens que a IA gasta absorvendo e estruturando os dados.
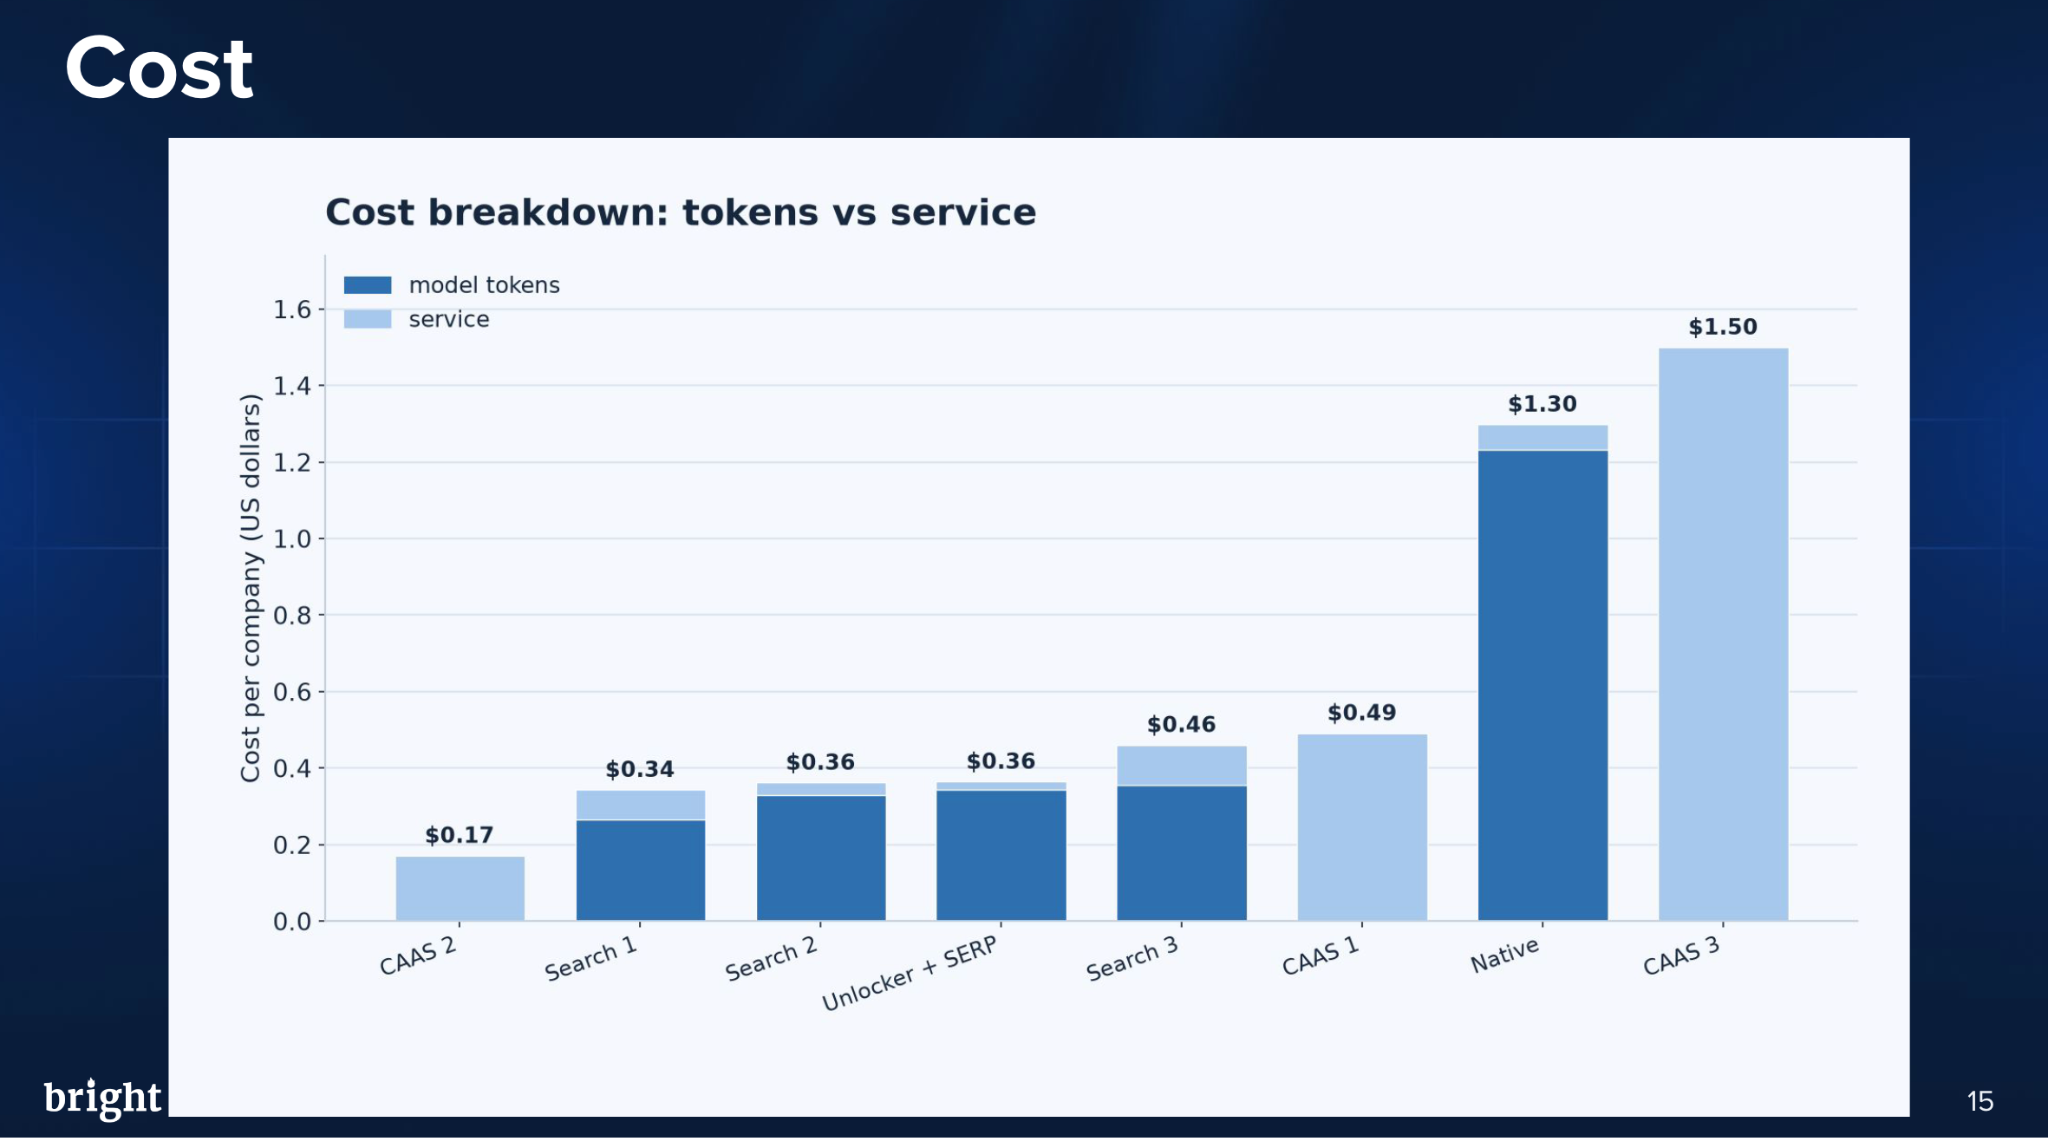
Buscas e CaaSes são ótimos para esse caso de uso – quando você quer alguns dados básicos rapidamente, exatamente como um carro alugado.
Mas isso escala?
Há um padrão básico aqui: você paga novamente toda vez que solicita contexto. Seja para 100 empresas, 1k, 100k ou milhões de empresas ou dados, você ainda está “alugando” seus dados.
- Cada entidade repetida custa o mesmo que a primeira
- Ruído e falsos positivos que você não consegue filtrar
- Os custos de tokens não se comprimem com o volume
- As equipes começam a cortar atalhos para gerenciar a conta
Em escala, é bastante óbvio que é melhor ter o carro do que alugá-lo todos os dias para ir ao mesmo lugar.
Então como você faz isso? Como você tem sua própria ferramenta de busca de IA ou CaaS?
Engenharia de contexto web
Engenharia de contexto web significa arquitetar as diversas fontes que você tem em um pipeline específico que pode ser reutilizado e escalado, trazendo as informações da melhor forma possível para a IA.
Em vez de pedir a um agente que pesquise a web ao vivo para cada empresa, construímos um pipeline repetível com suporte de Scraper.
Usamos o Scraper Studio da Bright Data, além de alguns Scrapers existentes da Bright Data, para coletar as fontes que sabíamos que importavam e, em seguida, mapeamos esses registros nos mesmos 25 campos.
O agente não está mais fazendo todo o trabalho de recuperação ao vivo. A camada de contexto está fazendo mais do trabalho antes mesmo de o modelo vê-lo.
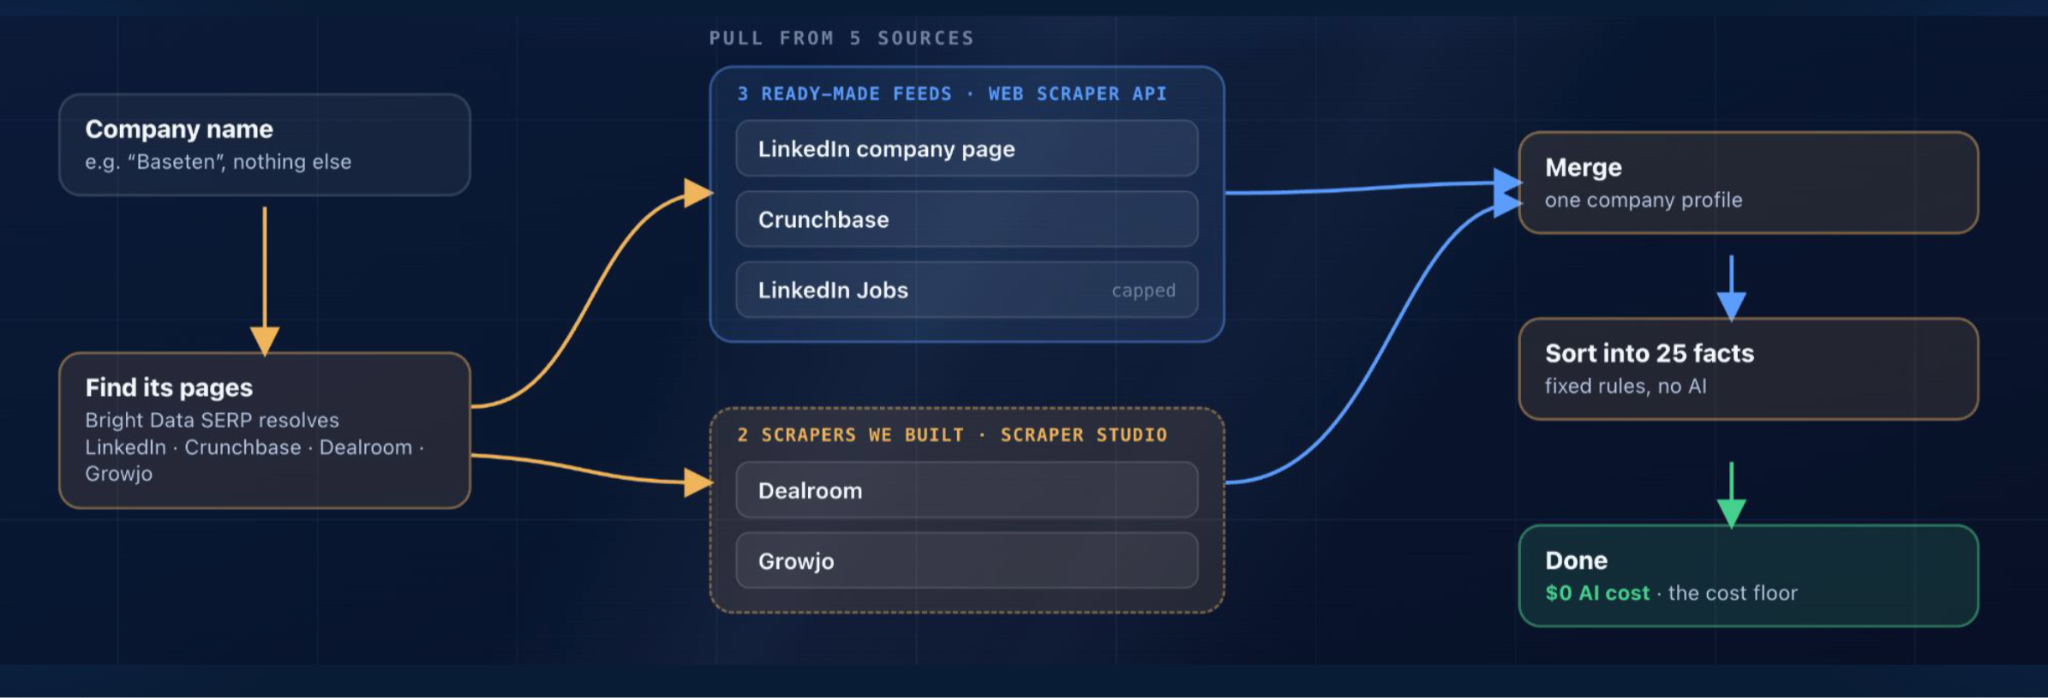
Figura: pipeline de contexto próprio
Plot twist: setup cost
Para tornar a comparação justa, também atribuímos ao pipeline próprio um custo real de configuração.
Imagine que contratei a pessoa mais inteligente que conheço para construir esse Scraper e paguei um exagerado valor de $5k para pesquisar e planejar quais fontes puxar dados, o que na verdade levou cerca de três horas conversando com o Claude.
E chamamos esse método de DIY, que significa “Faça (ou construa) você mesmo.”
Depois disso, o número importante é o custo marginal cada vez que enriquecemos outra empresa.
A Vantagem do DIY: Construindo para Escala
A cobertura é praticamente a mesma; embora seja ligeiramente menor, não há uma grande diferença.
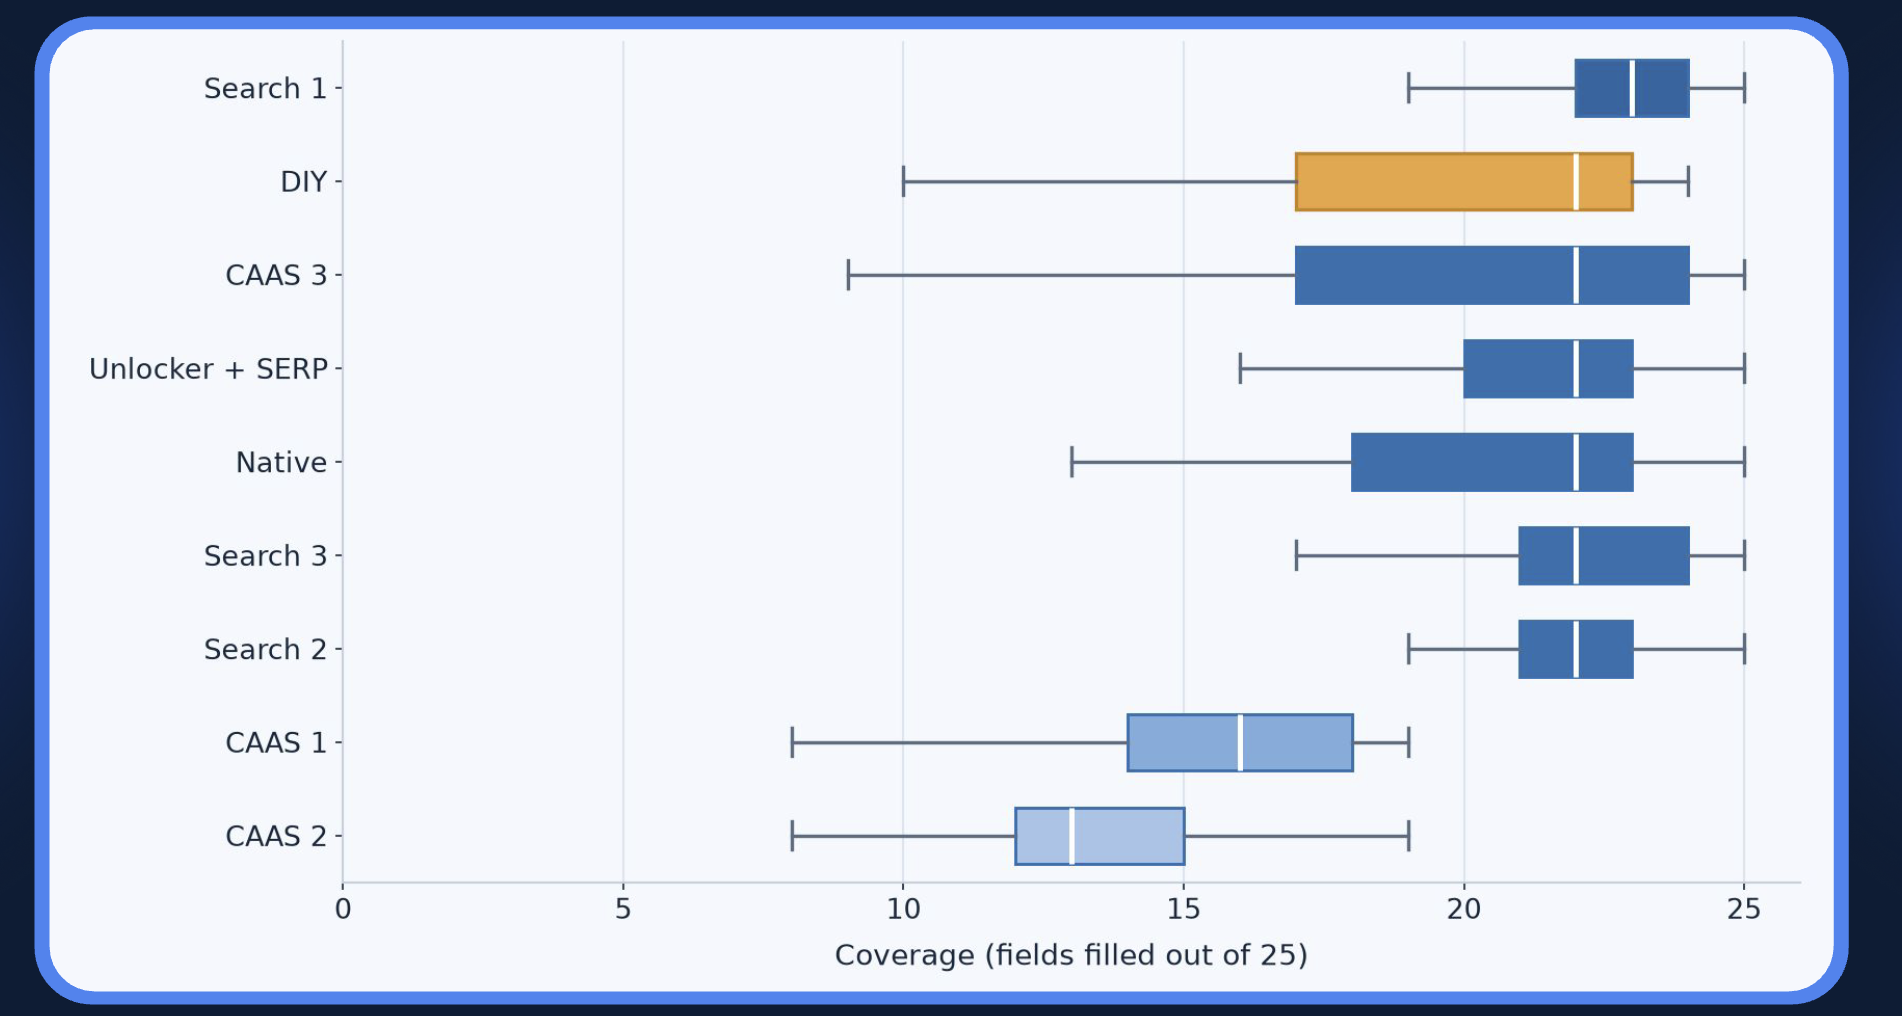
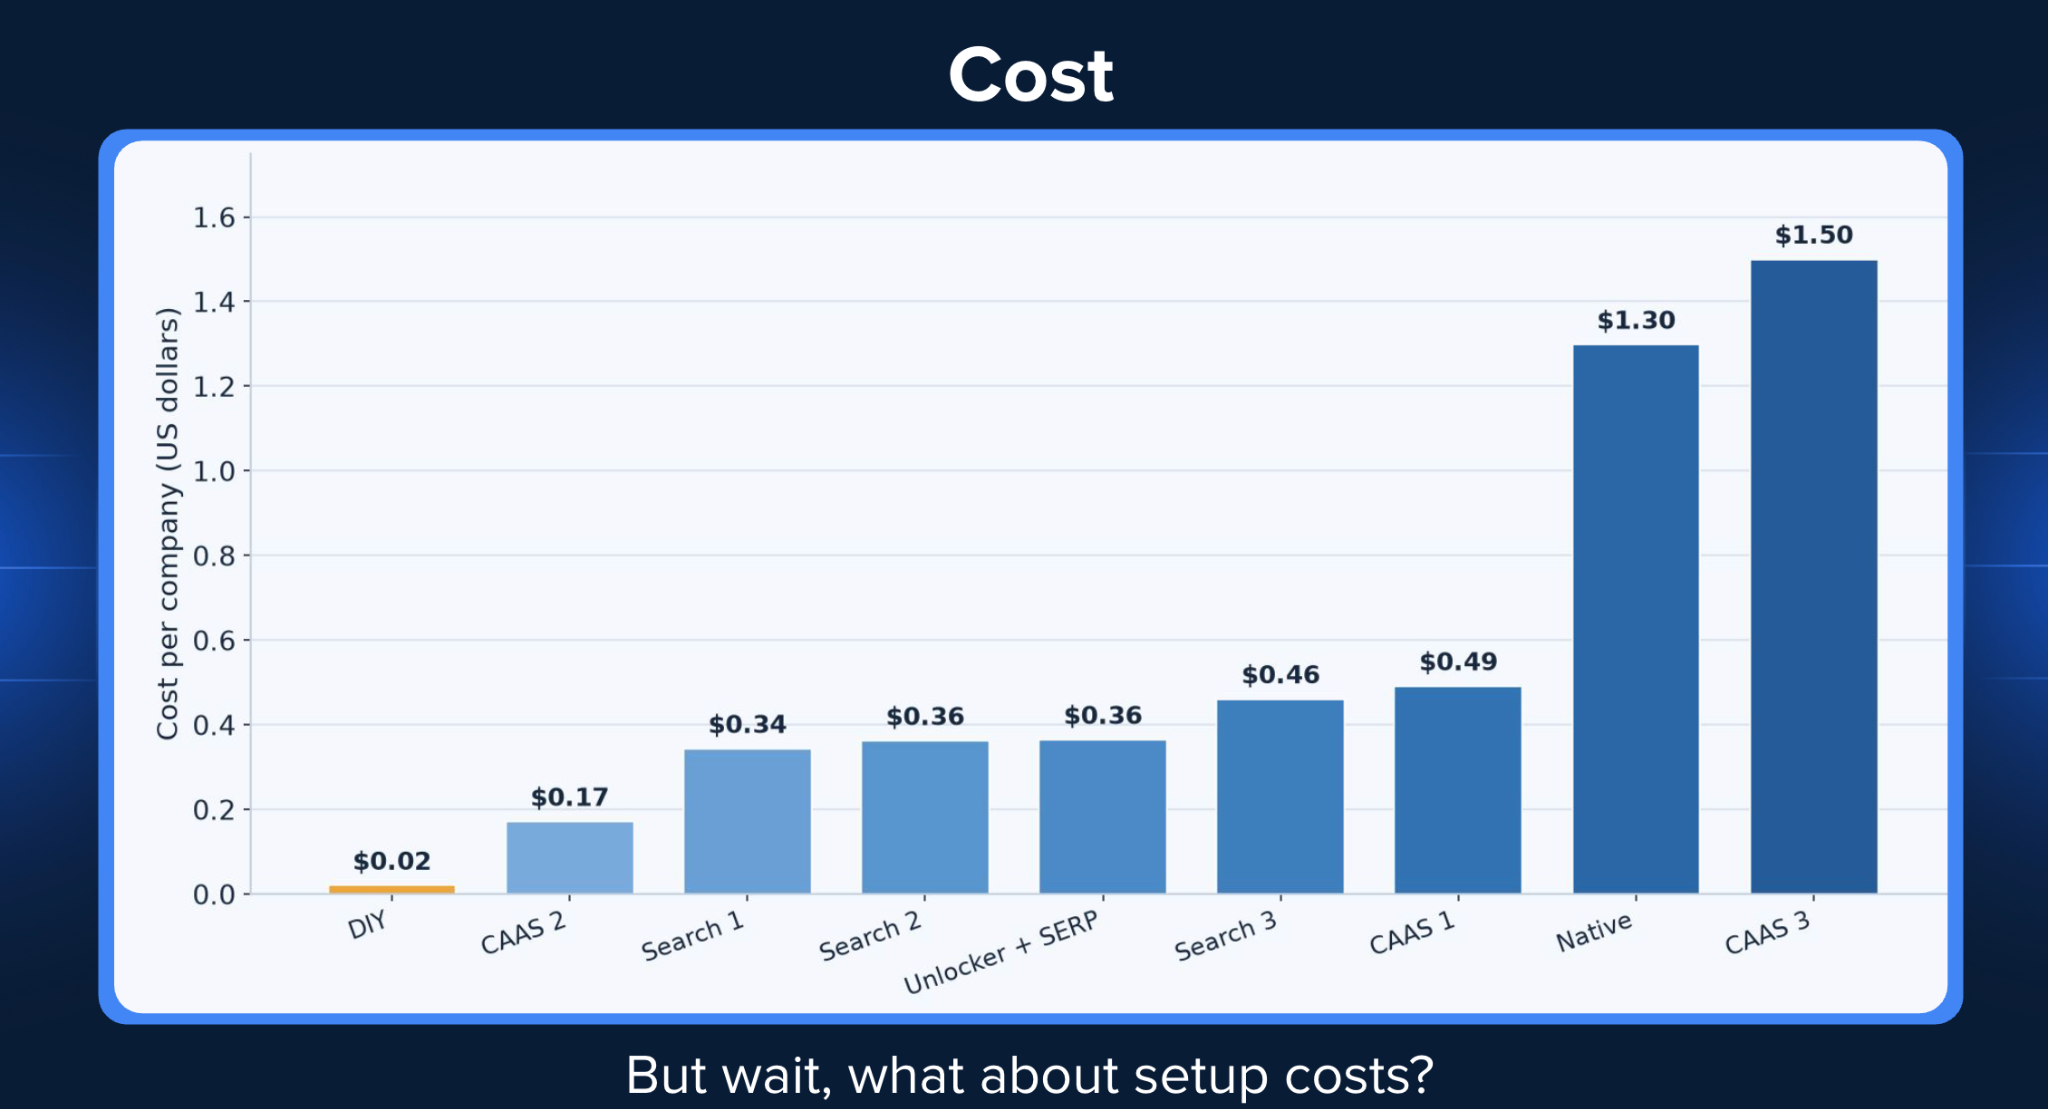
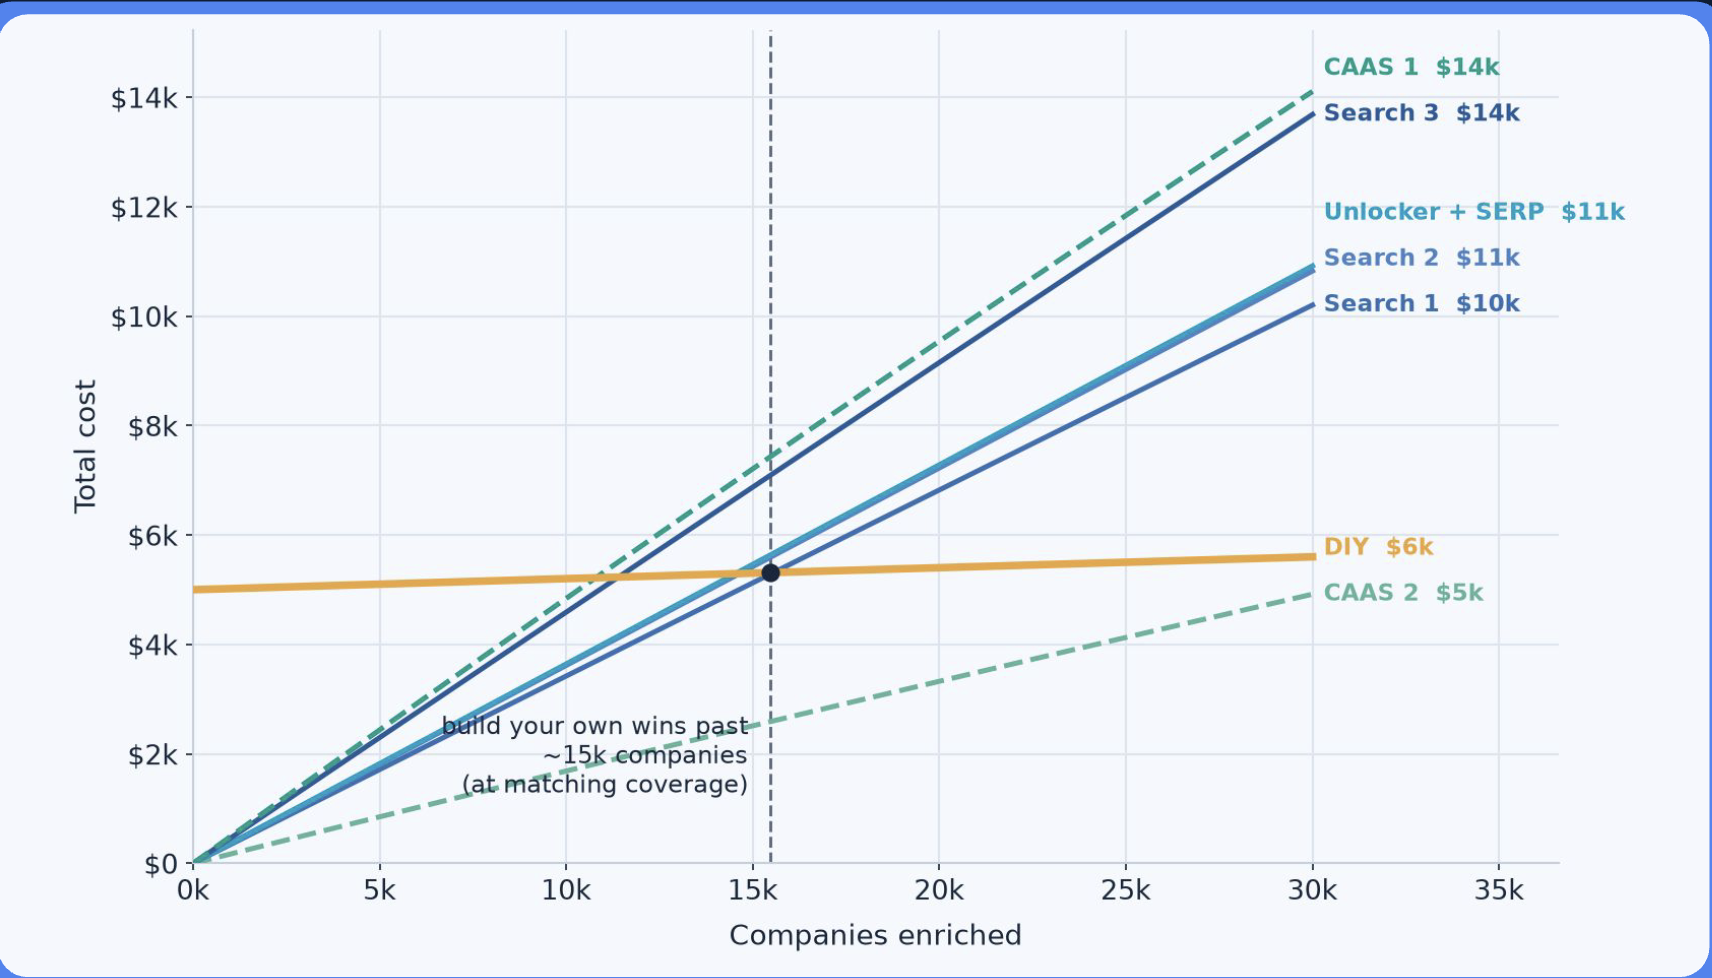
Figura: ponto de virada entre construir e alugar
Em pequena escala, alugar ainda pode ser a escolha óbvia. Em maior escala, o custo único de construção é distribuído por cada vez mais enriquecimentos.
O ponto de virada nos diz que, além de uma determinada escala, ter seu próprio pipeline se torna muito mais eficiente.
A Economia da Engenharia de Contexto Web
Como os dados mostram, o modelo de aluguel tem um limite. Em um determinado volume, o custo desses serviços supera o investimento inicial de construir sua própria infraestrutura. Vamos ampliar a visão para uma escala maior…
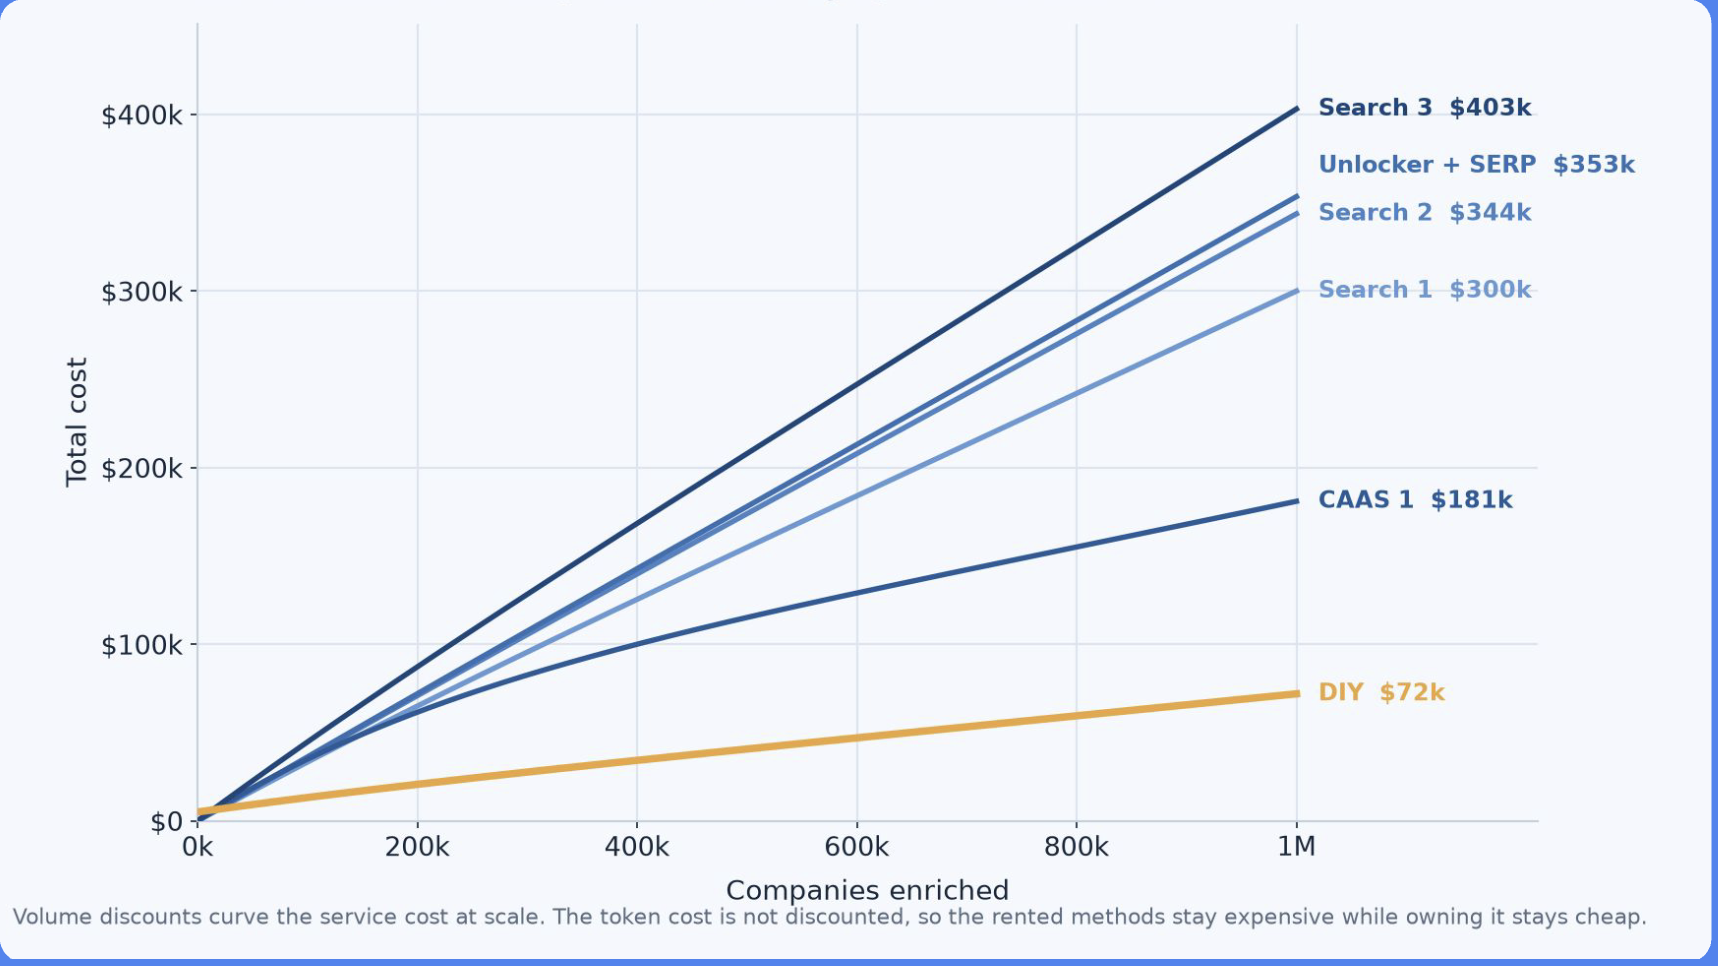
O caso está estabelecido:
- Alugue quando suas necessidades de conhecimento são pequenas e diversas.
- Use busca quando a tarefa é pontual e aberta.
- Use CaaS quando o domínio é recorrente e especializado, e você quer contexto estruturado, verificado e pronto para agentes.
Construa quando o fluxo de trabalho se repete, as mesmas entidades recorrem, a atualidade importa e você precisa de controle sobre a lógica de negócios.
É aí que a Engenharia de Contexto Web se torna uma vantagem operacional real.
E se você é um desenvolvedor, esta também é a oportunidade.
CaaS não é apenas uma categoria de fornecedor. É um sinal de que os agentes precisam de uma camada de contexto governada:
- Entidades controladas
- Schemas controlados
- Regras de atualização
- Verificação de fontes
- Ontologias específicas de domínio
- Pipelines de contexto reutilizáveis
A era dos agentes transforma dados web em infraestrutura. Os vencedores são as equipes que conseguem transformar dados web bagunçados e em constante mudança em contexto confiável, estruturado e reutilizável.
Vá construir o seu!