Neste guia, você verá:
- O que é Containers as a Service e o que ele gerencia para você.
- Como o CaaS funciona e a importância da orquestração de containers nesse modelo.
- As principais vantagens e desvantagens dessa abordagem de serviço em nuvem.
- Por que o CaaS é bem adequado para cargas de trabalho de recuperação de dados web.
- Como construir um pipeline de dados web escalável com CaaS e Bright Data.
Vamos começar!
CaaS (Containers as a Service) Explicado
Antes de ver como o CaaS pode suportar pipelines de dados web e agentes de IA, você precisa entender o que é e o que ele realmente gerencia.
O Que É CaaS?
CaaS, abreviação de Containers as a Service, é um modelo de serviço em nuvem que fornece um ambiente gerenciado para implantar, executar e escalar aplicações em containers. Ele se posiciona entre os serviços de infraestrutura e os de nível de aplicação.
Para entender onde o CaaS se encaixa, considere o que acontece quando você cria um container. Uma imagem de container representa uma unidade portátil da sua aplicação que pode ser executada de forma consistente em diferentes ambientes.
A imagem é então usada para criar containers em execução. Operar esses containers de forma confiável em produção requer infraestrutura para implantação, rede, escalabilidade, monitoramento e gerenciamento de ciclo de vida.
O CaaS preenche a lacuna entre uma imagem de container finalizada e um ambiente de execução pronto para produção. Em vez de configurar servidores manualmente e gerenciar containers individualmente, você pode implantar suas imagens em uma plataforma CaaS, que define como eles devem ser executados e os orquestra.
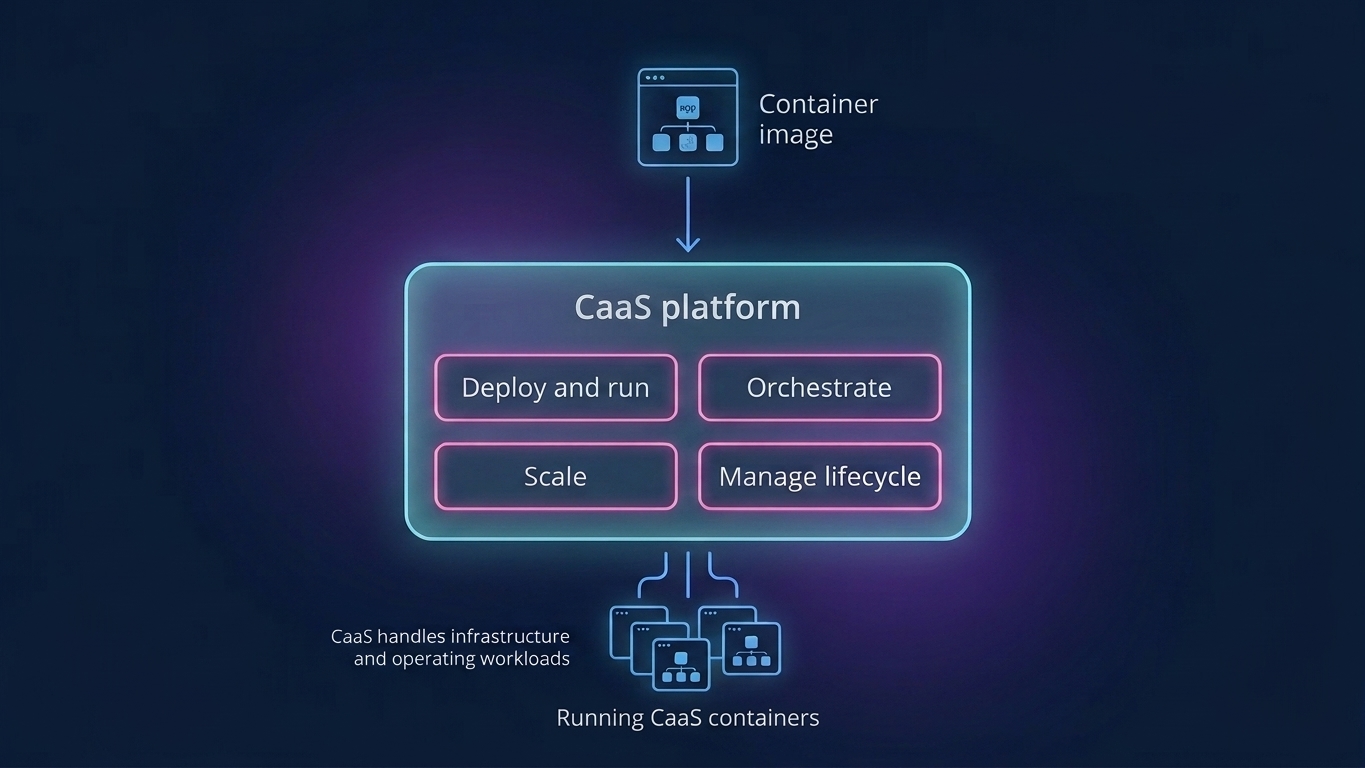
Em outras palavras, esse modelo vai além de simplesmente executar o Docker em uma máquina virtual. Com o Docker sozinho, você ainda precisa gerenciar a infraestrutura subjacente e coordenar os containers por conta própria. Uma solução CaaS oferece os recursos adicionais necessários para operar cargas de trabalho em containers em escala.
O Que o CaaS Gerencia?
Uma plataforma CaaS normalmente gerencia a implantação de containers, orquestração, escalabilidade, rede, descoberta de serviços, verificações de integridade e operações de ciclo de vida.
Na prática, você define a carga de trabalho desejada, como quantas instâncias de containers devem ser executadas e quais recursos elas precisam. Em seguida, a plataforma cuida de grande parte da execução por você.
Essa abordagem reduz a sobrecarga operacional e facilita a execução confiável de aplicações distribuídas, especialmente quando as cargas de trabalho precisam escalar ou mudar com frequência.
Como Funciona o CaaS?
Agora que você sabe o que é CaaS, é hora de entender como ele funciona.
Da Imagem de Container à Carga de Trabalho em Produção
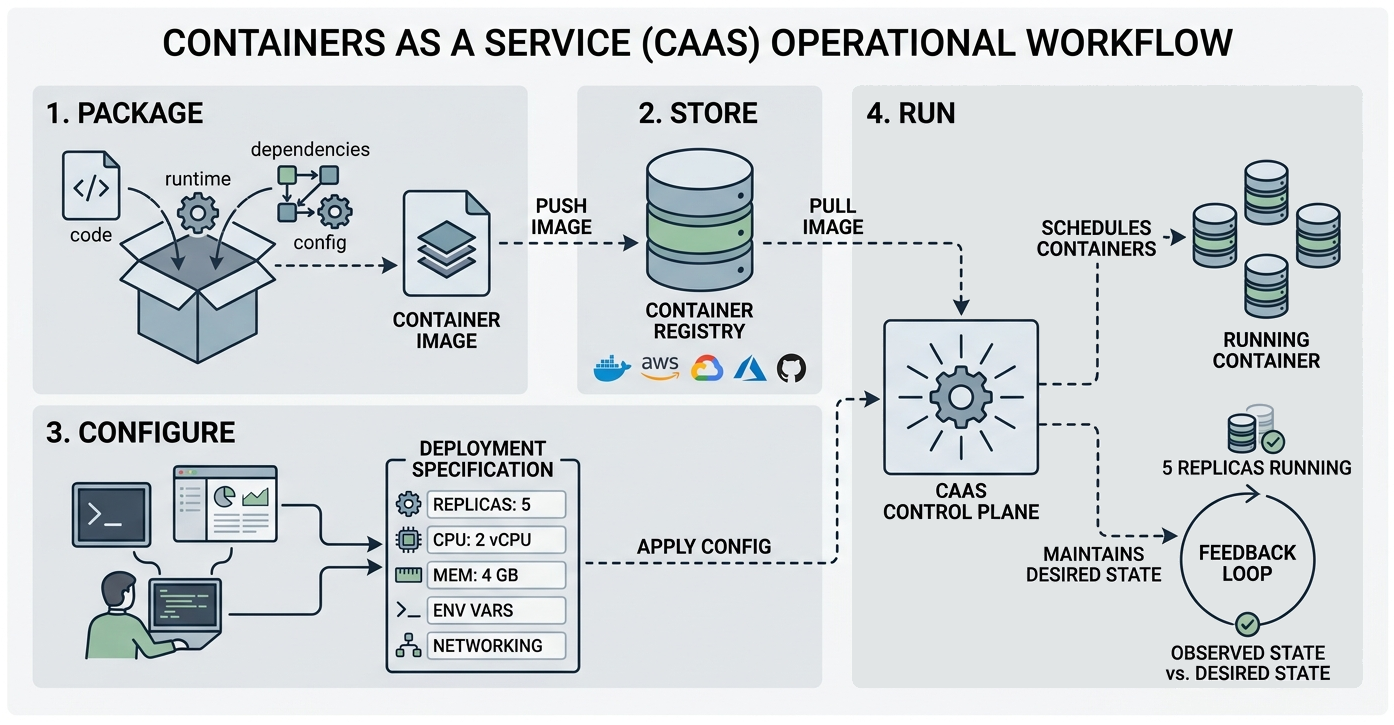
O primeiro passo para implantar uma aplicação com CaaS é empacotar a aplicação e tudo o que ela precisa para executar em uma imagem de container. Isso inclui o código da aplicação, dependências, runtime, configuração e outros componentes necessários.
A imagem geralmente é armazenada em um registro de containers, como o Docker Hub, Amazon ECR, Google Artifact Registry, Azure Container Registry ou GitHub Container Registry. Um registro funciona como um sistema centralizado para armazenar, gerenciar e distribuir imagens de containers. Ao implantar uma aplicação, a imagem necessária é recuperada do registro e usada para criar containers.
Em seguida, você especifica como a aplicação deve ser executada. Dependendo da solução CaaS, isso pode incluir o número de instâncias de containers, requisitos de CPU e memória, regras de rede, variáveis de ambiente e outras configurações. Esses parâmetros geralmente podem ser fornecidos por meio de uma interface web, ferramenta de linha de comando, arquivo de configuração ou API.
O serviço CaaS transforma essa configuração em uma carga de trabalho em execução. Ele agenda containers na infraestrutura subjacente disponível e trabalha continuamente para manter o estado desejado.
O Papel da Orquestração de Containers
Executar um único container é relativamente simples. No entanto, à medida que uma aplicação cresce, você pode precisar executar dezenas ou até centenas de containers. Na maioria dos casos, esses containers precisam se comunicar entre si, escalar com base na demanda ou se recuperar automaticamente quando algo dá errado. Gerenciar tudo isso manualmente rapidamente se torna um desafio.
É aqui que entra a orquestração de containers. A orquestração automatiza as tarefas necessárias para executar e coordenar múltiplos containers. Ela pode adicionar ou remover containers automaticamente conforme a demanda muda, verificar se estão íntegros, substituir instâncias com falha e permitir que os serviços se encontrem e se comuniquem.
O Kubernetes é a tecnologia mais amplamente reconhecida para orquestração de containers e é comumente usado como base para soluções CaaS modernas. Ele expõe os mecanismos necessários para implantar, agendar, escalar e manter cargas de trabalho em containers em um cluster de máquinas.
Ainda assim, tenha em mente que CaaS e Kubernetes não são a mesma coisa. O Kubernetes é a tecnologia principal para orquestrar containers, enquanto o CaaS oferece uma forma gerenciada de usar infraestrutura de containers sem precisar operar tudo por conta própria.
Benefícios e Desafios do CaaS
O modelo Containers as a Service pode simplificar a implantação e operação de aplicações em containers, mas também introduz novas considerações.
Principais benefícios:
- As aplicações são executadas de forma idêntica em ambientes de desenvolvimento, teste e multi-cloud, evitando bugs de implantação causados por incompatibilidades de configuração.
- O escalonamento horizontal automatizado ajusta instantaneamente a quantidade de containers para corresponder a picos de Tráfego, otimizando o consumo de recursos do servidor.
- Delegar o gerenciamento de clusters e o provisionamento do SO host elimina os encargos de manutenção de infraestrutura para as equipes de engenharia internas.
- O isolamento granular de componentes permite implantação, escalonamento e recuperação de falhas independentes para arquiteturas modulares baseadas em microsserviços.
- A integração nativa com pipelines de implantação contínua acelera os ciclos de lançamento automatizando testes e criação de containers.
Principais desafios:
- A arquitetura de kernel compartilhado do SO introduz vulnerabilidades de escape de containers, ampliando a superfície de ataque geral em comparação com máquinas virtuais.
- Configurações complexas de rede, armazenamento e orquestração criam curvas de aprendizado íngremes e exigem expertise operacional especializada.
- APIs específicas de fornecedores e ferramentas de orquestração proprietárias complicam a migração de cargas de trabalho entre diferentes provedores de serviços em nuvem.
CaaS para Dados Web e Fluxos de Trabalho de IA
Saiba por que o Containers as a Service é particularmente adequado para coleta de dados web e fluxos de trabalho que preparam dados frescos para aplicações de IA.
Aplicações Comuns
Um dos cenários mais populares para CaaS é a execução de microsserviços. Cada serviço pode ser executado em seu próprio container, permitindo implantar, atualizar e escalar componentes individuais separadamente.
O modelo também é útil para modernização de aplicações, implantação contínua, infraestrutura híbrida e cargas de trabalho com requisitos de recursos variáveis. Os containers fornecem ambientes de execução consistentes, enquanto a camada CaaS fornece a infraestrutura necessária para executá-los e escalá-los.
Outro encaixe natural é qualquer carga de trabalho envolvendo tarefas repetidas ou paralelas. Em vez de processar tudo uma tarefa por vez, você pode distribuir trabalhos individuais entre múltiplos workers em containers. Essa abordagem funciona particularmente bem para pipelines de dados, onde os workers podem recuperar, transformar, validar, enriquecer ou processar dados de forma independente.
CaaS para Coleta de Dados Web
O scraping de dados é um bom exemplo de carga de trabalho que pode se beneficiar da execução em containers. Imagine que você precisa recuperar dados de milhares de URLs. Em vez de processá-los sequencialmente em uma única aplicação, você pode distribuir as URLs entre múltiplos workers em containers.
Cada worker pode processar suas tarefas atribuídas de forma autônoma, permitindo aumentar a capacidade de coleta executando mais containers. Uma fila de tarefas pode melhorar ainda mais essa arquitetura distribuindo trabalhos dinamicamente à medida que os workers ficam disponíveis.
CaaS para Fluxos de Trabalho de Processamento de Dados de IA
A arquitetura mencionada pode se estender além da coleta de dados. Workers em containers podem recuperar dados web frescos, processá-los e enriquecê-los, e encaminhar as informações resultantes para sistemas de analytics, bancos de dados, pipelines RAG ou aplicações de IA.
Em detalhes, uma fila poderia distribuir milhares de tarefas de coleta de dados entre workers. Uma vez coletados, outro conjunto de workers poderia limpar e estruturar os resultados antes de passá-los para um agente de IA ou LLM.
Escalando a Coleta de Dados Web com CaaS e Bright Data
O CaaS fornece a infraestrutura de execução para workers de scraping em containers, mas não resolve os desafios de acessar sites em escala. Automação de navegador, gerenciamento de Proxy, rotação de IP, bloqueio de sites e mecanismos anti-bot exigem infraestrutura adicional.
É aqui que a Bright Data se encaixa na arquitetura. Sua infraestrutura de dados web fornece acesso a uma grande rede de proxies e APIs gerenciadas para acesso à web, pesquisa, automação de navegador e extração de dados estruturados.
A Bright Data é respaldada por uma rede de proxies residenciais com mais de 400 milhões de IPs, concorrência ilimitada, 99,99% de uptime e uma taxa de sucesso de 99,95% em toda a sua rede.
A ideia é separar as duas camadas:
- O CaaS fornece computação escalável para sua aplicação.
- A Bright Data traz a infraestrutura necessária para acessar e coletar dados web.
Saiba mais sobre como combinar CaaS e Bright Data para construir pipelines de dados prontos para produção e fluxos de trabalho de IA!
Passo #1: Escolha a API Bright Data Certa
O primeiro passo é escolher os produtos da Bright Data que correspondem ao tipo de dados que você precisa coletar. Eles incluem:
- API de Scraping de Dados: Extraia dados estruturados de mais de 800 domínios suportados usando mais de 1.500 scrapers pré-construídos.
- API Web Unlocker: Recupere conteúdo de páginas web lidando com muitos desafios de acesso, incluindo proxies, bloqueios e CAPTCHAs.
- API SERP: Recupere resultados de pesquisa estruturados de mecanismos como Google, Bing, Yandex e outros.
- API de Navegador: Execute sessões de navegador gerenciadas para sites que requerem execução de JavaScript, cliques, rolagem ou outra automação de navegador.
Nota: Todos eles estão incluídos no nível gratuito recorrente mensal da Bright Data, portanto você pode usá-los gratuitamente.
Passo #2: Construa um Worker de Scraping em Container
Após selecionar a API de dados web apropriada, você pode empacotar sua aplicação como um container. Ele só precisa enviar requisições para as APIs Bright Data escolhidas e, opcionalmente, processar os dados retornados.
Por exemplo, um worker Python pode usar a API Web Unlocker para recuperar conteúdo Markdown pronto para LLM de uma página web:
# worker.py

import os
import requests

def fetch_page(url):
    response = requests.post(
        "https://api.brightdata.com/request",
        headers={
            "Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}",
            "Content-Type": "application/json",
        },
        json={
            "zone": os.environ["BRIGHTDATA_WEB_UNLOCKER_API"], # Substitua pelo nome da sua API Web Unlocker da Bright Data
            "url": url,
            "format": "raw",
            "data_format": "markdown",
        },
    )

    response.raise_for_status()

    return response.text
Para mais orientações sobre a integração, consulte a documentação do Web Unlocker da Bright Data.
Observe que não há nada específico do Docker nessa requisição. A aplicação usa uma requisição HTTP padrão por meio da biblioteca requests do Python. Assim, o mesmo código pode ser executado localmente, em uma máquina virtual ou dentro de um container gerenciado por um serviço CaaS.
Em seguida, você pode listar as dependências necessárias em um arquivo requirements.txt. Este conterá:
requests==2.34.2Para containerizar o worker, você pode então escrever um Dockerfile simples:
FROM python:3.14-slim

WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY . .

CMD ["python", "worker.py"]
Você também precisa fornecer a chave de API da Bright Data e o nome da API Web Unlocker separadamente do código da sua aplicação. Durante o desenvolvimento local, você pode usar um arquivo .env:
BRIGHTDATA_API_KEY=<BRIGHTDATA_API_KEY>
BRIGHTDATA_WEB_UNLOCKER_ZONE=<BRIGHTDATA_WEB_UNLOCKER_API>
Para implantações em produção, você deve usar a funcionalidade de gerenciamento de segredos do seu provedor CaaS para injetar a chave de API no container.
Muito bem! Da mesma forma, você pode containerizar aplicações que chamam outros produtos baseados em API da Bright Data.
Passo #3: Distribua o Trabalho Entre Containers
Depois que o worker de scraping estiver funcionando corretamente, a arquitetura pode escalar o número de instâncias de workers de acordo com a carga de trabalho.
Agora, imagine uma fila de scraping contendo 100.000 URLs. O serviço CaaS pode executar múltiplas instâncias do worker e distribuir as tarefas entre elas. À medida que a carga de trabalho cresce, mais workers serão adicionados para processar as requisições simultaneamente. Isso é muito melhor do que processá-las sequencialmente em uma única aplicação.
Lembre-se de que a API Web Unlocker, assim como qualquer outro produto da Bright Data, foi projetada para coleta de dados em grande escala. Isso significa que você pode escalar o número de workers em containers sem se preocupar com problemas de concorrência.
Passo #4: Processe e Use os Dados Retornados
A arquitetura final se parece com isso:
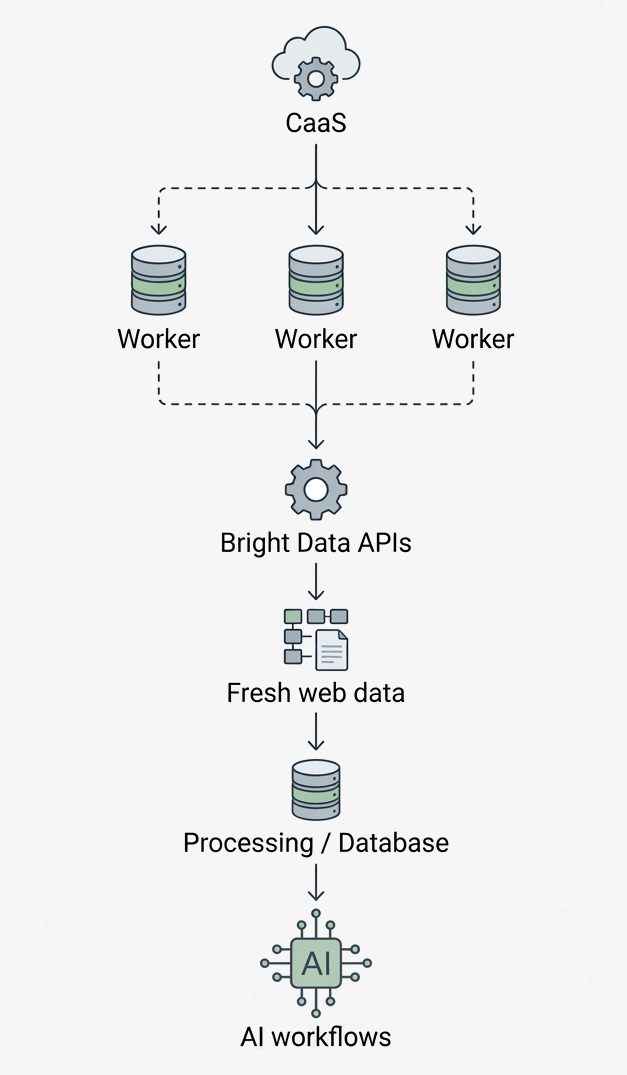
Uma fila de tarefas pode ficar entre a aplicação e os workers, permitindo que os trabalhos sejam distribuídos dinamicamente à medida que os containers ficam disponíveis. Se a carga de trabalho aumentar, você pode executar mais workers. Quando a demanda diminuir, você pode reduzi-los.
Isso cria uma separação clara de responsabilidades:
- CaaS: Fornece o ambiente de computação e escala os workers em containers.
- Docker: Empacota a aplicação e suas dependências em um runtime portátil.
- Bright Data: Fornece a infraestrutura especializada para acessar e coletar dados web em escala.
- Sua aplicação: Processa os dados retornados e os envia para bancos de dados, sistemas baseados em ML ou agentes de IA.
Observe que o CaaS não facilita a recuperação web por si só. Ele torna as aplicações de scraping de dados mais fáceis de implantar e escalar. Combinado com infraestrutura gerenciada de dados web como a Bright Data, permite que você construa pipelines de dados web escaláveis para analytics e IA sem gerenciar cada camada da pilha de acesso web por conta própria. Incrível!
Conclusão
Neste artigo, você aprendeu como usar o Containers as a Service (CaaS) para construir pipelines de dados web escaláveis e fluxos de trabalho de IA. Como mostrado aqui, combinar CaaS com Bright Data permite escalar tanto as camadas de computação quanto de dados web da sua arquitetura.
Essa integração permite distribuir a coleta de dados entre workers em containers, recuperar dados web frescos por meio das APIs da Bright Data e enviar os resultados para componentes downstream.
Crie uma nova conta na Bright Data e comece a usar nossas APIs para construir pipelines escaláveis de processamento de dados e IA!
FAQ
Qual é a diferença entre CaaS e uma infraestrutura de containers DIY?
Com o CaaS, o provedor de nuvem gerencia grande parte da infraestrutura subjacente e das operações de containers. Com uma abordagem DIY, você é responsável por configurar, manter, escalar e proteger o ambiente de containers.
| CaaS | DIY | |
|---|---|---|
| Infraestrutura | Gerenciada pelo provedor | Gerenciada pela sua equipe |
| Orquestração | Gerenciada ou integrada | Configurada e mantida pela sua equipe |
| Escalabilidade | Automação integrada | Configure e mantenha você mesmo |
| Manutenção | Menor | Maior |
| Controle | Menos controle em nível de infraestrutura | Maior controle |
| Expertise | Menos necessária | Mais necessária |
Em resumo, o CaaS reduz a sobrecarga operacional, enquanto o DIY oferece maior controle e personalização. Descubra mais sobre o debate entre gerenciado e DIY.
CaaS vs IaaS vs PaaS vs FaaS vs SaaS: Qual é a diferença?
Os modelos de serviço em nuvem diferem principalmente em quanto de infraestrutura e gerenciamento de aplicações eles deixam para o usuário:
| Modelo | O que fornece | Você gerencia | Provedor gerencia | Uso típico |
|---|---|---|---|---|
| IaaS (Infrastructure as a Service) | Computação virtualizada, armazenamento e rede | SO, middleware, runtime, aplicações e dados | Infraestrutura física e virtualização | Infraestrutura e aplicações personalizadas |
| CaaS (Containers as a Service) | Ambiente gerenciado para aplicações em containers | Imagens de containers, aplicações e configurações | Infraestrutura, orquestração de containers e escalabilidade | Aplicações em containers e microsserviços |
| PaaS (Platform as a Service) | Plataforma de aplicação e runtime gerenciados | Código da aplicação e dados | Infraestrutura, SO, runtime e plataforma | Desenvolvimento e implantação de aplicações |
| FaaS (Function as a Service) | Execução de funções serverless orientadas a eventos | Funções individuais e seu código | Servidores, runtime, escalabilidade e infraestrutura | Tarefas de curta duração orientadas a eventos |
| SaaS (Software as a Service) | Software completo e pronto para uso | Configuração e dados | Toda a pilha de aplicações e infraestrutura | Aplicações para usuários finais |
O CaaS se posiciona entre IaaS e PaaS, dando a você controle sobre aplicações em containers enquanto o provedor gerencia grande parte da infraestrutura subjacente e da orquestração.
A Bright Data suporta o modelo de serviço em nuvem CaaS?
A Bright Data complementa o CaaS fornecendo a infraestrutura de dados web necessária para coleta de dados em grande escala, enquanto o CaaS fornece a infraestrutura de computação para executar e escalar seus workers em containers.