Neste post do blog, você vai descobrir:
- O que é o scraping de áudio e como realizá-lo.
- Os principais desafios envolvidos no scraping de áudio da web e sua preparação para processamento.
- Como fazer scraping de áudio em escala.
- Como converter áudio extraído para o formato WAV para processamento baseado em IA.
- Como gerar transcrições com marcação de tempo a partir de áudio usando modelos de IA de fala para texto.
- Casos de uso relevantes para dados de áudio extraídos.
Vamos começar!
Como Funciona o Web Scraping de Áudio
O web scraping de áudio se refere ao download automático de conteúdo de áudio de websites. O áudio pode vir de um arquivo independente ou estar incorporado em um vídeo.
Baixar o áudio geralmente é apenas o primeiro passo. Em aplicações reais, o objetivo é usar o áudio extraído para análise automatizada, detecção de texto ou treinamento de modelos de IA. Para realizar essas tarefas, você normalmente também precisa do texto contido no áudio.
É aqui que a transcrição de áudio se torna importante. Ao converter o áudio extraído em texto, você torna o conteúdo falado pesquisável. Adicionar marcações de tempo a cada segmento da transcrição também permite vincular trechos específicos de texto aos pontos correspondentes na forma de onda original do áudio.
Em outras palavras, o scraping dá a você acesso ao áudio bruto. Em seguida, a transcrição transforma esse áudio em texto estruturado e legível por máquina, que pode ser usado em uma ampla gama de tarefas de IA e processamento de dados.
Neste tutorial, você será guiado pelo processo completo. Você aprenderá como fazer scraping e baixar áudio da web, convertê-lo para um formato adequado e processá-lo com modelos de IA para gerar uma transcrição.
Desafios do Scraping de Áudio e Soluções
Fazer scraping de áudio da web pode parecer simples, mas construir um pipeline confiável de processamento de áudio envolve muitos obstáculos.
Primeiro, você precisa encontrar uma fonte de áudio acessível, depois superar possíveis restrições ao recuperá-la e, finalmente, converter o áudio em texto utilizável. Felizmente, cada um desses desafios pode ser resolvido com as ferramentas e o fluxo de trabalho certos!
Encontrando Fontes de Áudio na Web
O primeiro desafio é encontrar uma fonte de áudio adequada para fazer scraping. Diferentemente das páginas web, o áudio nem sempre está disponível por meio de uma URL de download direta e óbvia.
Por exemplo, o áudio de interesse pode vir de um vídeo hospedado em plataformas como YouTube, Vimeo ou Bilibili. Uma solução é fazer scraping desses vídeos e extrair suas trilhas de áudio, dando a você acesso a um conjunto muito maior de conteúdo de áudio.
Se você quiser pular completamente o web scraping de áudio, considere usar os conjuntos de dados de áudio prontos para IA da Bright Data. Eles já estão coletados e preparados para fluxos de trabalho de IA e machine learning.
Superando Desafios de Acesso Web e Anti-Bot
Encontrar uma fonte de áudio é apenas parte do problema. Depois de identificar o conteúdo que deseja coletar, o website alvo pode aplicar técnicas anti-scraping. Isso inclui verificações de reputação de IP, limites de taxa, CAPTCHAs, desafios JavaScript e outros mecanismos anti-bot.
É aí que a Bright Data pode ajudar. A Bright Data fornece infraestrutura de acesso web projetada para ajudá-lo a coletar dados públicos da web em escala empresarial. Seu portfólio de produtos inclui soluções como API Web Unlocker, API Browser e serviços de proxy.
A rede da Bright Data inclui mais de 400 milhões de IPs em 195 países. Essa infraestrutura suporta concorrência ilimitada, com taxa de sucesso de 99,95% e uptime de 99,99%.
Em breve, você verá como usar a API Web Unlocker para acessar recursos de áudio de qualquer site. Isso nos permite focar no fluxo de processamento de áudio em vez de construir sua própria camada de acesso web.
Convertendo Áudio em Texto Utilizável
A questão final é transformar o áudio extraído em texto. Isso nem sempre é simples, especialmente quando as gravações contêm ruído de fundo, múltiplos falantes ou fala pouco clara. No entanto, os modelos modernos de transcrição com IA conseguem lidar com a maioria dessas situações. Adicionar marcações de tempo torna a transcrição ainda mais útil, conectando cada trecho de texto à sua posição na gravação.
Passo #1: Faça Scraping do Recurso de Áudio da Web
O web scraping de áudio começa com a construção de um sistema automatizado para coletar conteúdo de áudio da web. Isso pode envolver visar diretamente arquivos de áudio, como arquivos MP3, ou, mais comumente, baixar vídeos e extrair a trilha de áudio deles.
Para ajudar a superar restrições que os websites podem aplicar a bots de scraping, você encaminhará suas solicitações automatizadas pela API Web Unlocker da Bright Data. Dessa forma, você pode esquecer CAPTCHAs, limites de taxa e outras restrições de acesso.
Siga as instruções abaixo!
Pré-requisitos
Antes de começar, certifique-se de ter o seguinte:
- Python 3.11+ instalado localmente.
- Um ambiente de desenvolvimento Python, incluindo um projeto Python e uma IDE Python.
- Uma conta Bright Data com:
– Uma chave de API configurada.
– Uma API Web Unlocker configurada.
Siga os links abaixo para orientações adicionais:
Vamos assumir que sua API Web Unlocker se chama “web_unlocker”:
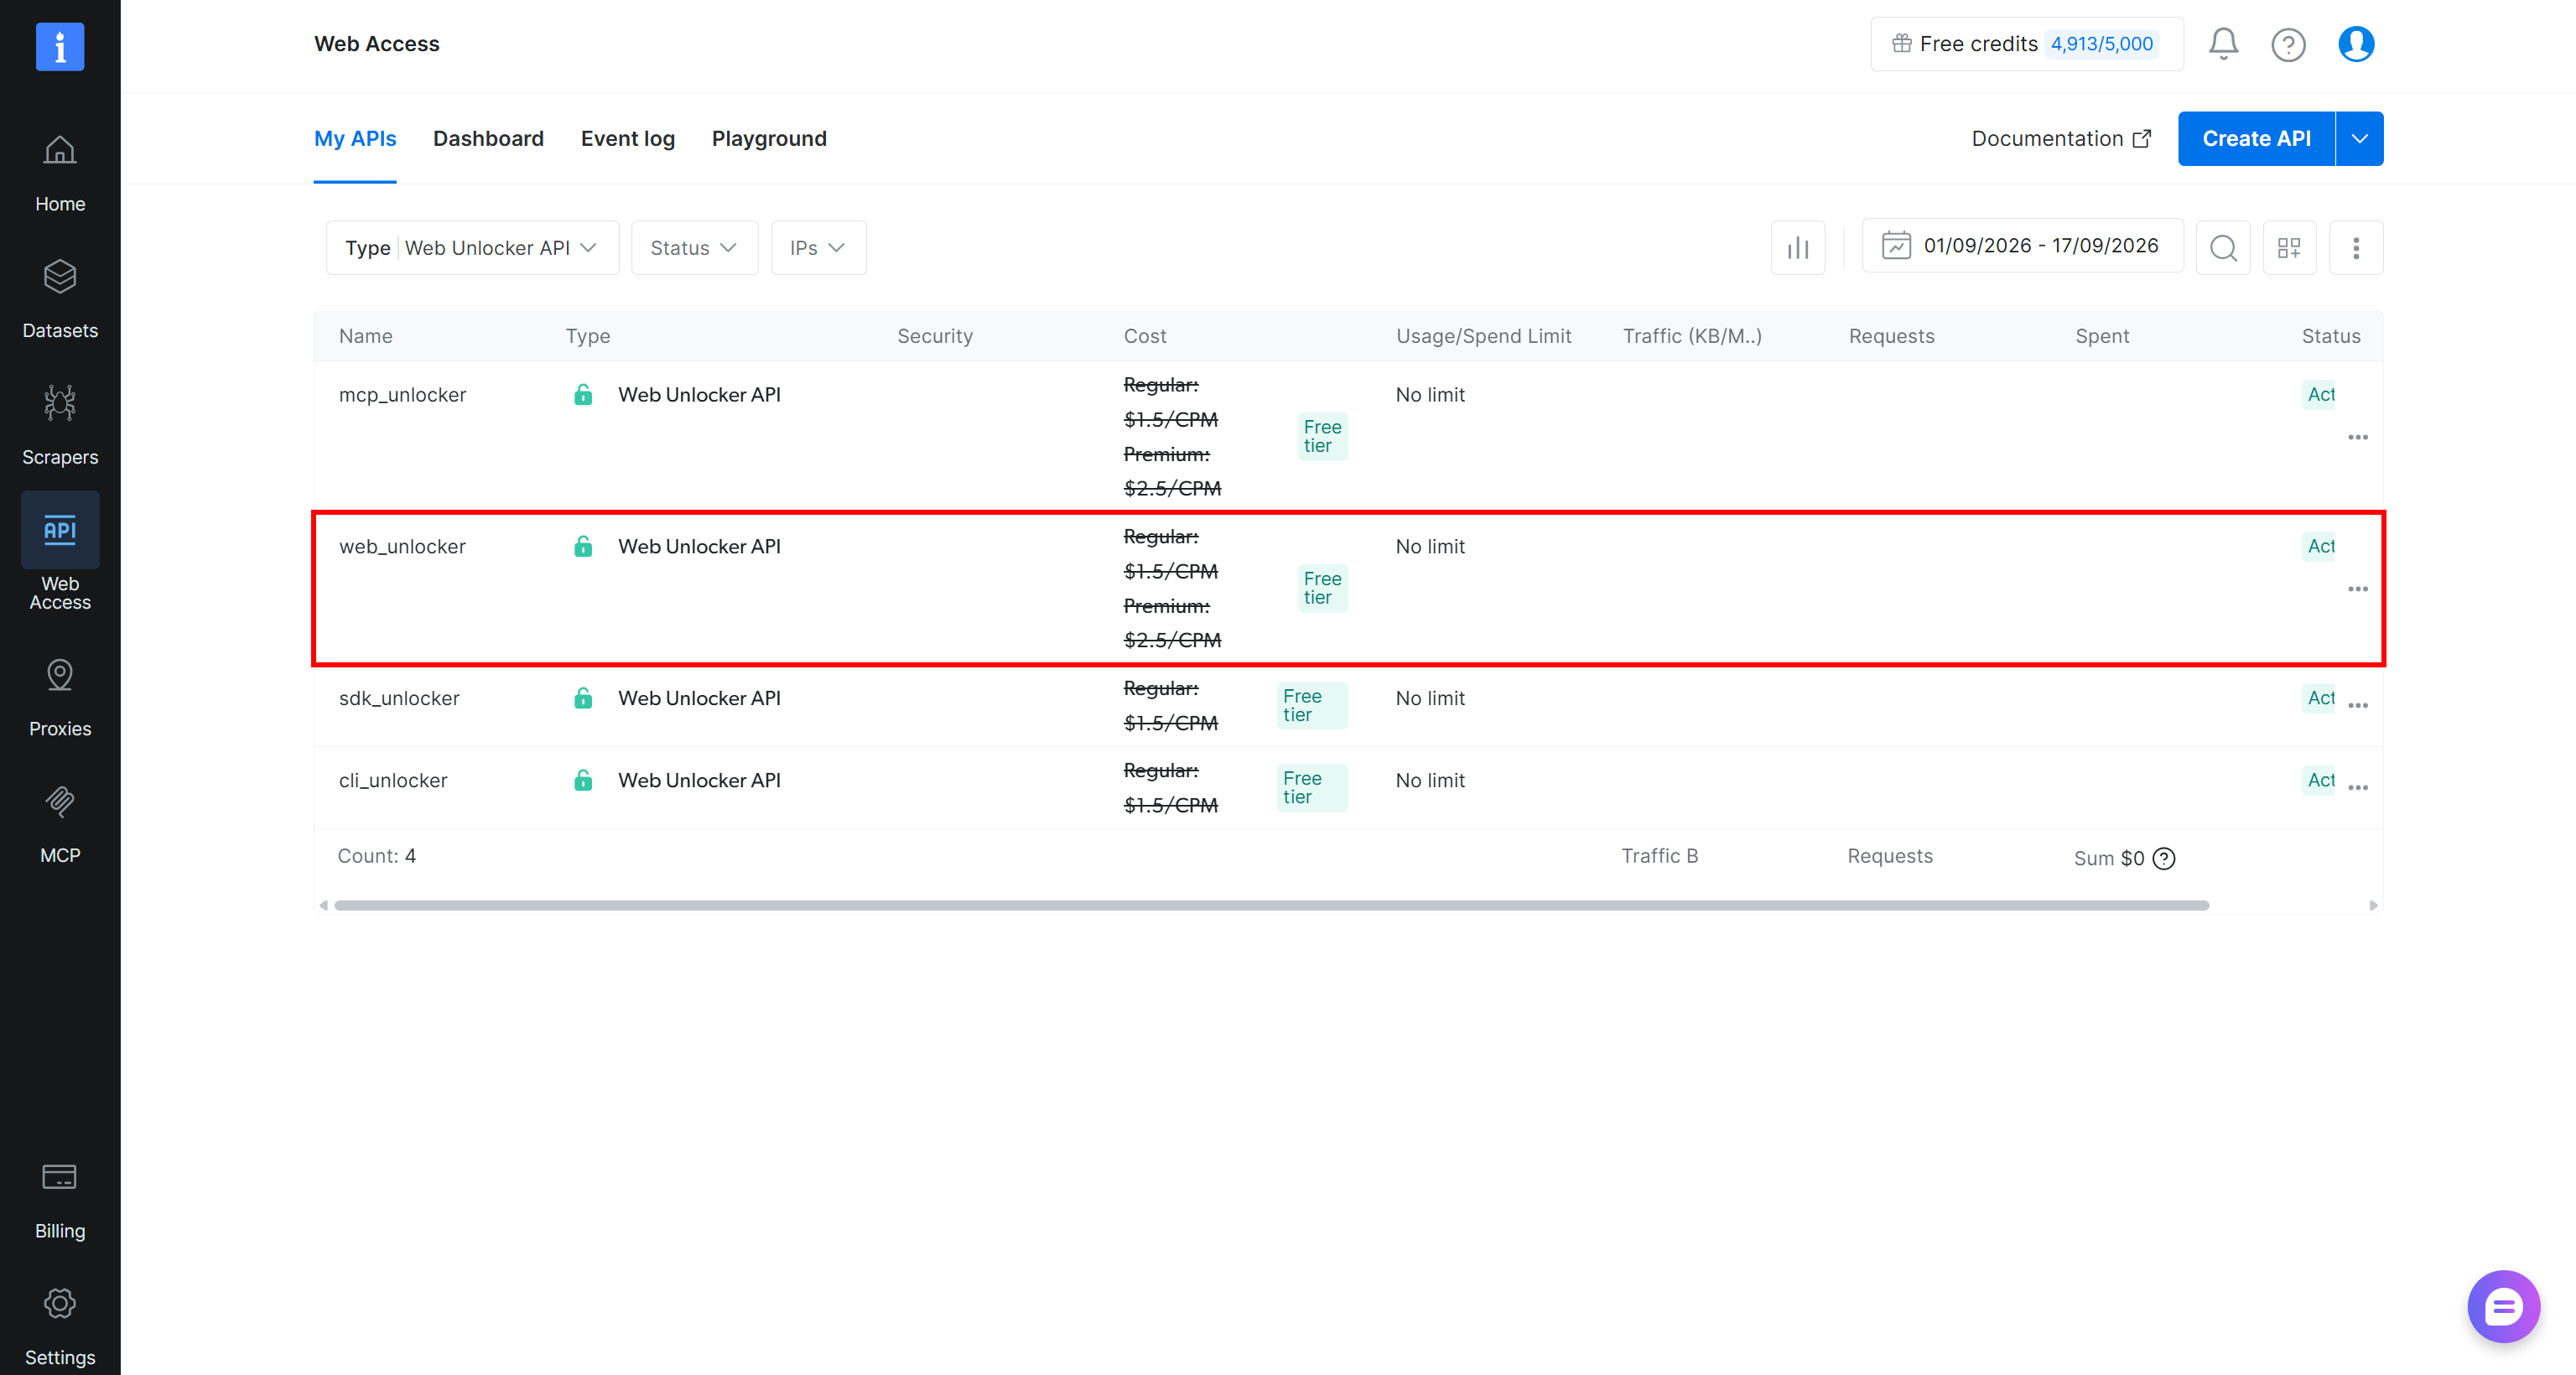
Importante: Certifique-se de adaptar os exemplos de código nesta etapa para corresponder ao nome real da sua API Web Unlocker.
Além disso, você pode encontrar as credenciais para o modo proxy diretamente na página da sua API Web Unlocker:
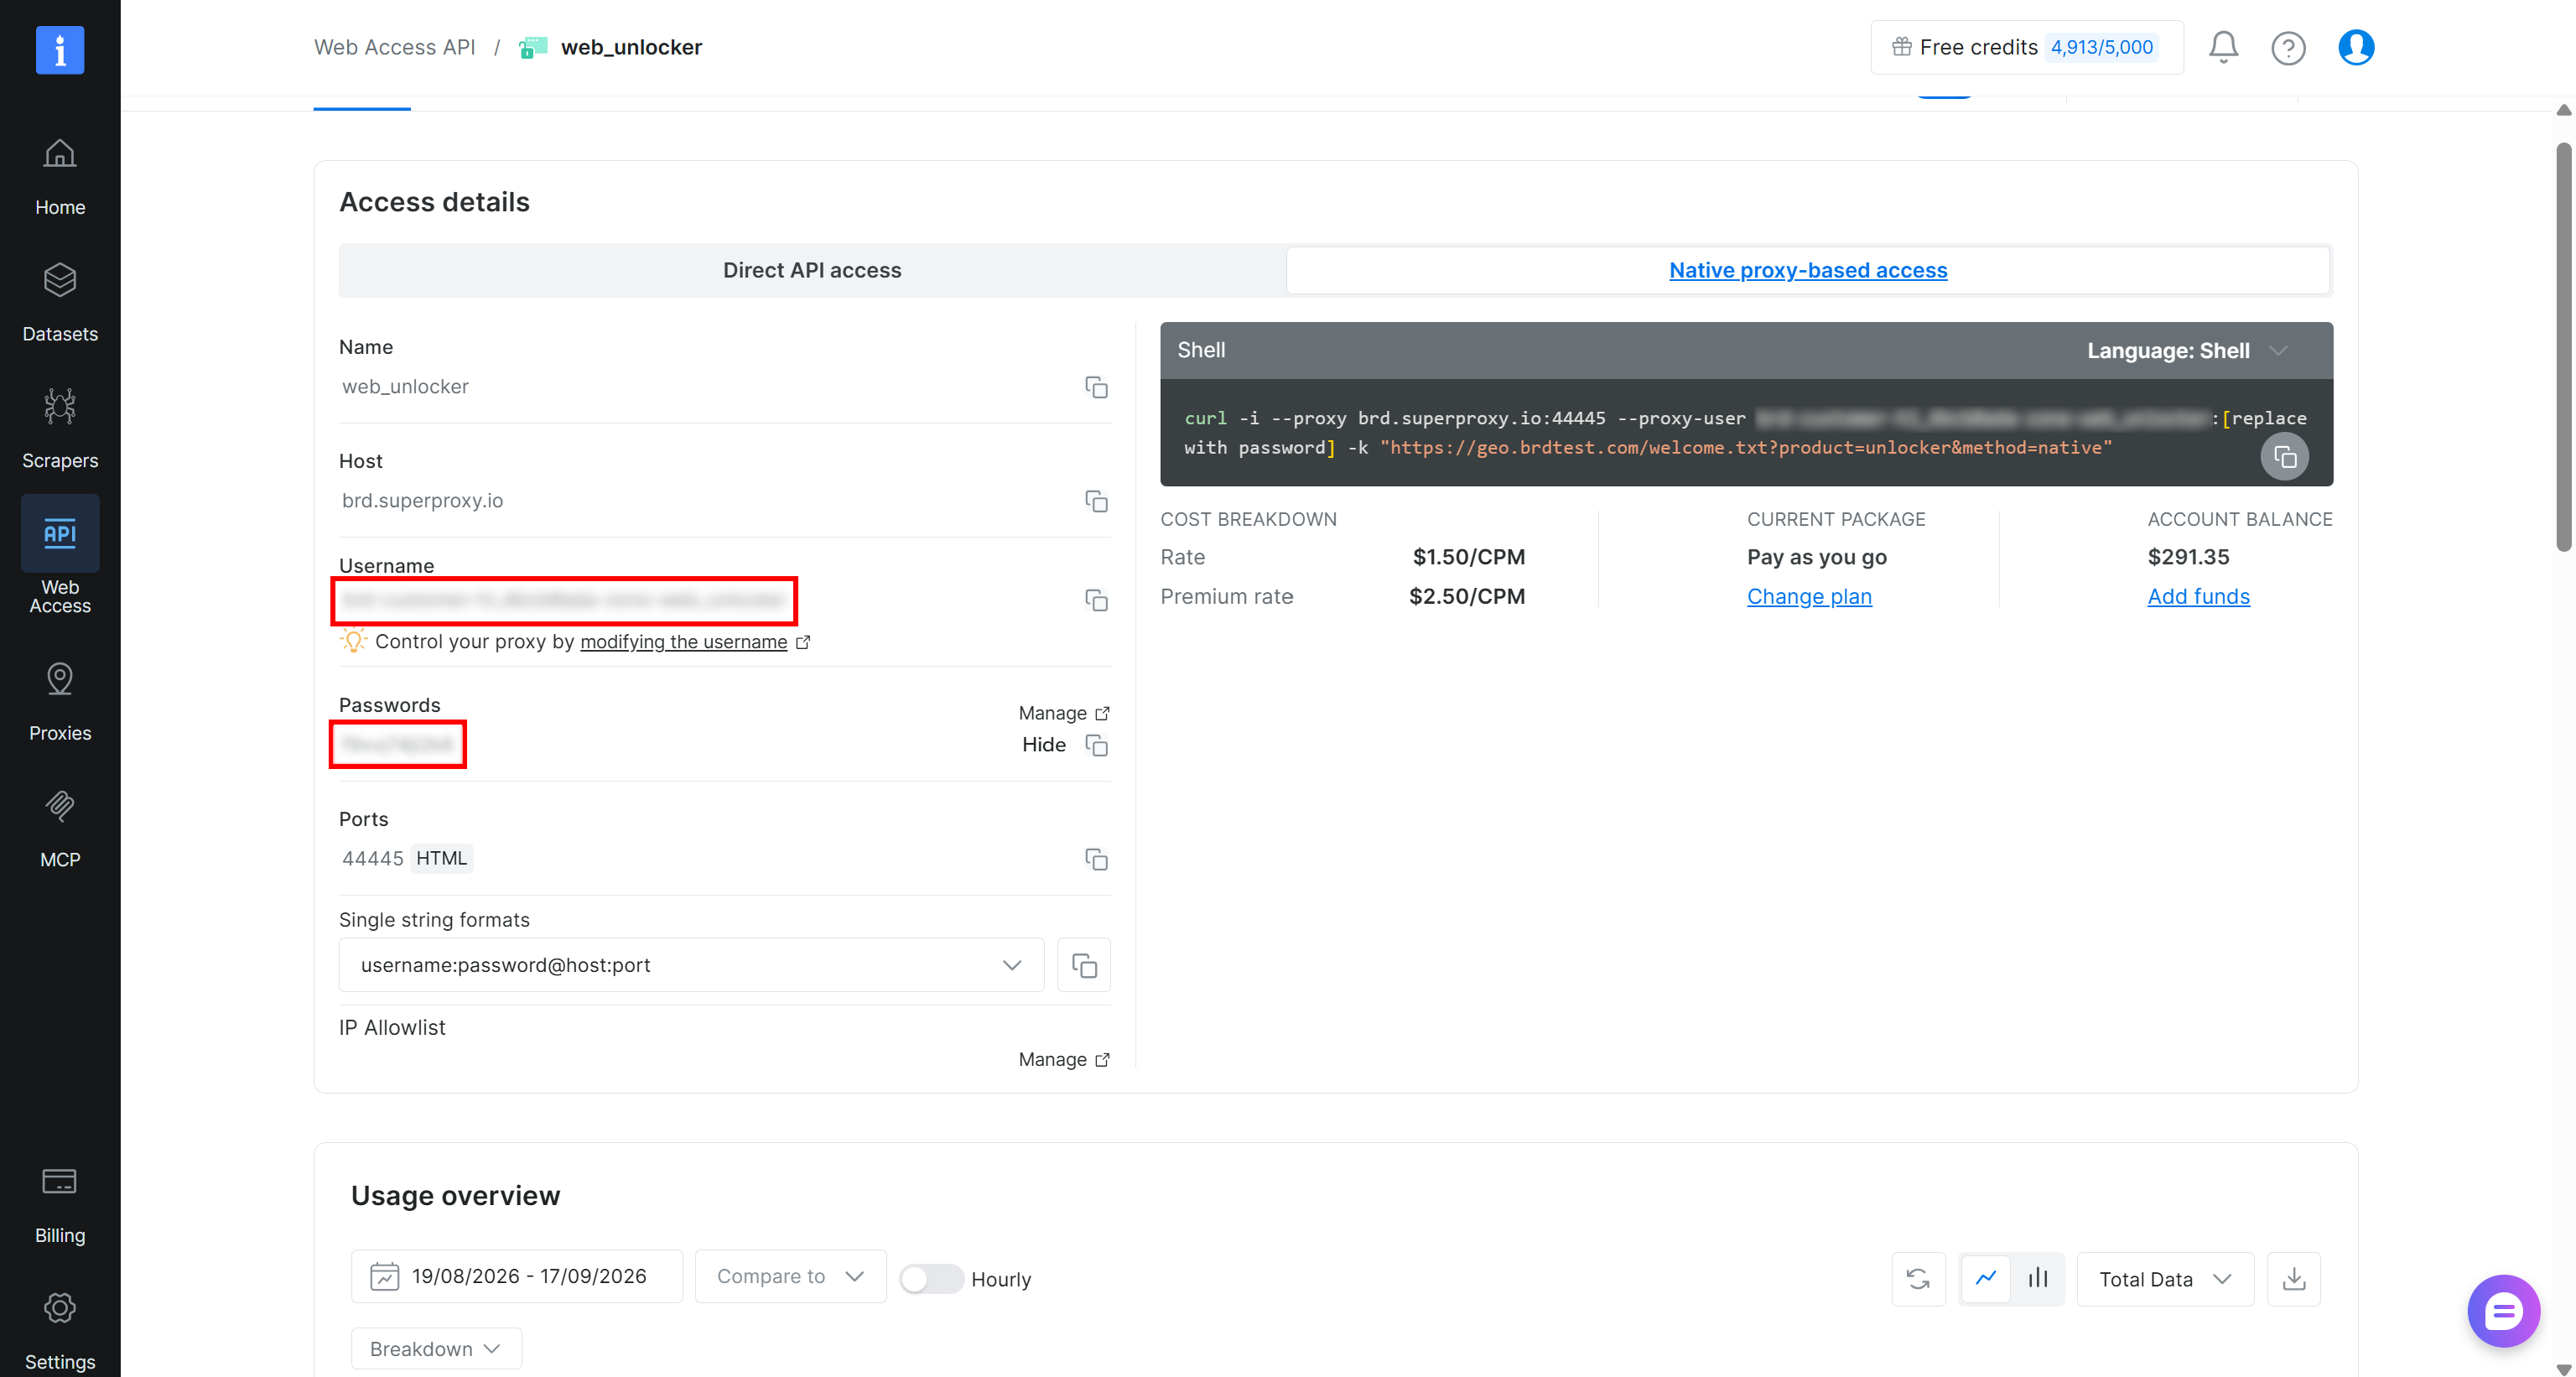
Vá até a aba “Native proxy-based access” e clique em “Show” ao lado da senha. Digite o código de verificação enviado ao seu e-mail.
Depois de obter seu nome de usuário, senha e porta da API Web Unlocker, você pode construir a URL do proxy usando o seguinte formato:
http://<WEB_UNLOCKER_API_USERNAME>:<WEB_UNLOCKER_API_PASSWORD>@brd.superproxy.io:<WEB_UNLOCKER_API_PORT>Ao configurar esse proxy em seu cliente HTTP Python, suas solicitações HTTP serão encaminhadas pela sua API Web Unlocker para contornar mecanismos anti-bot.
Observação: Para evitar problemas de verificação de certificado SSL ao usar a API Web Unlocker em modo proxy, baixe e instale o certificado SSL da Bright Data na sua máquina local.
Baixe um Vídeo Online
Suponha que sua fonte de áudio seja um vídeo do YouTube sem transcrição, como o seguinte:
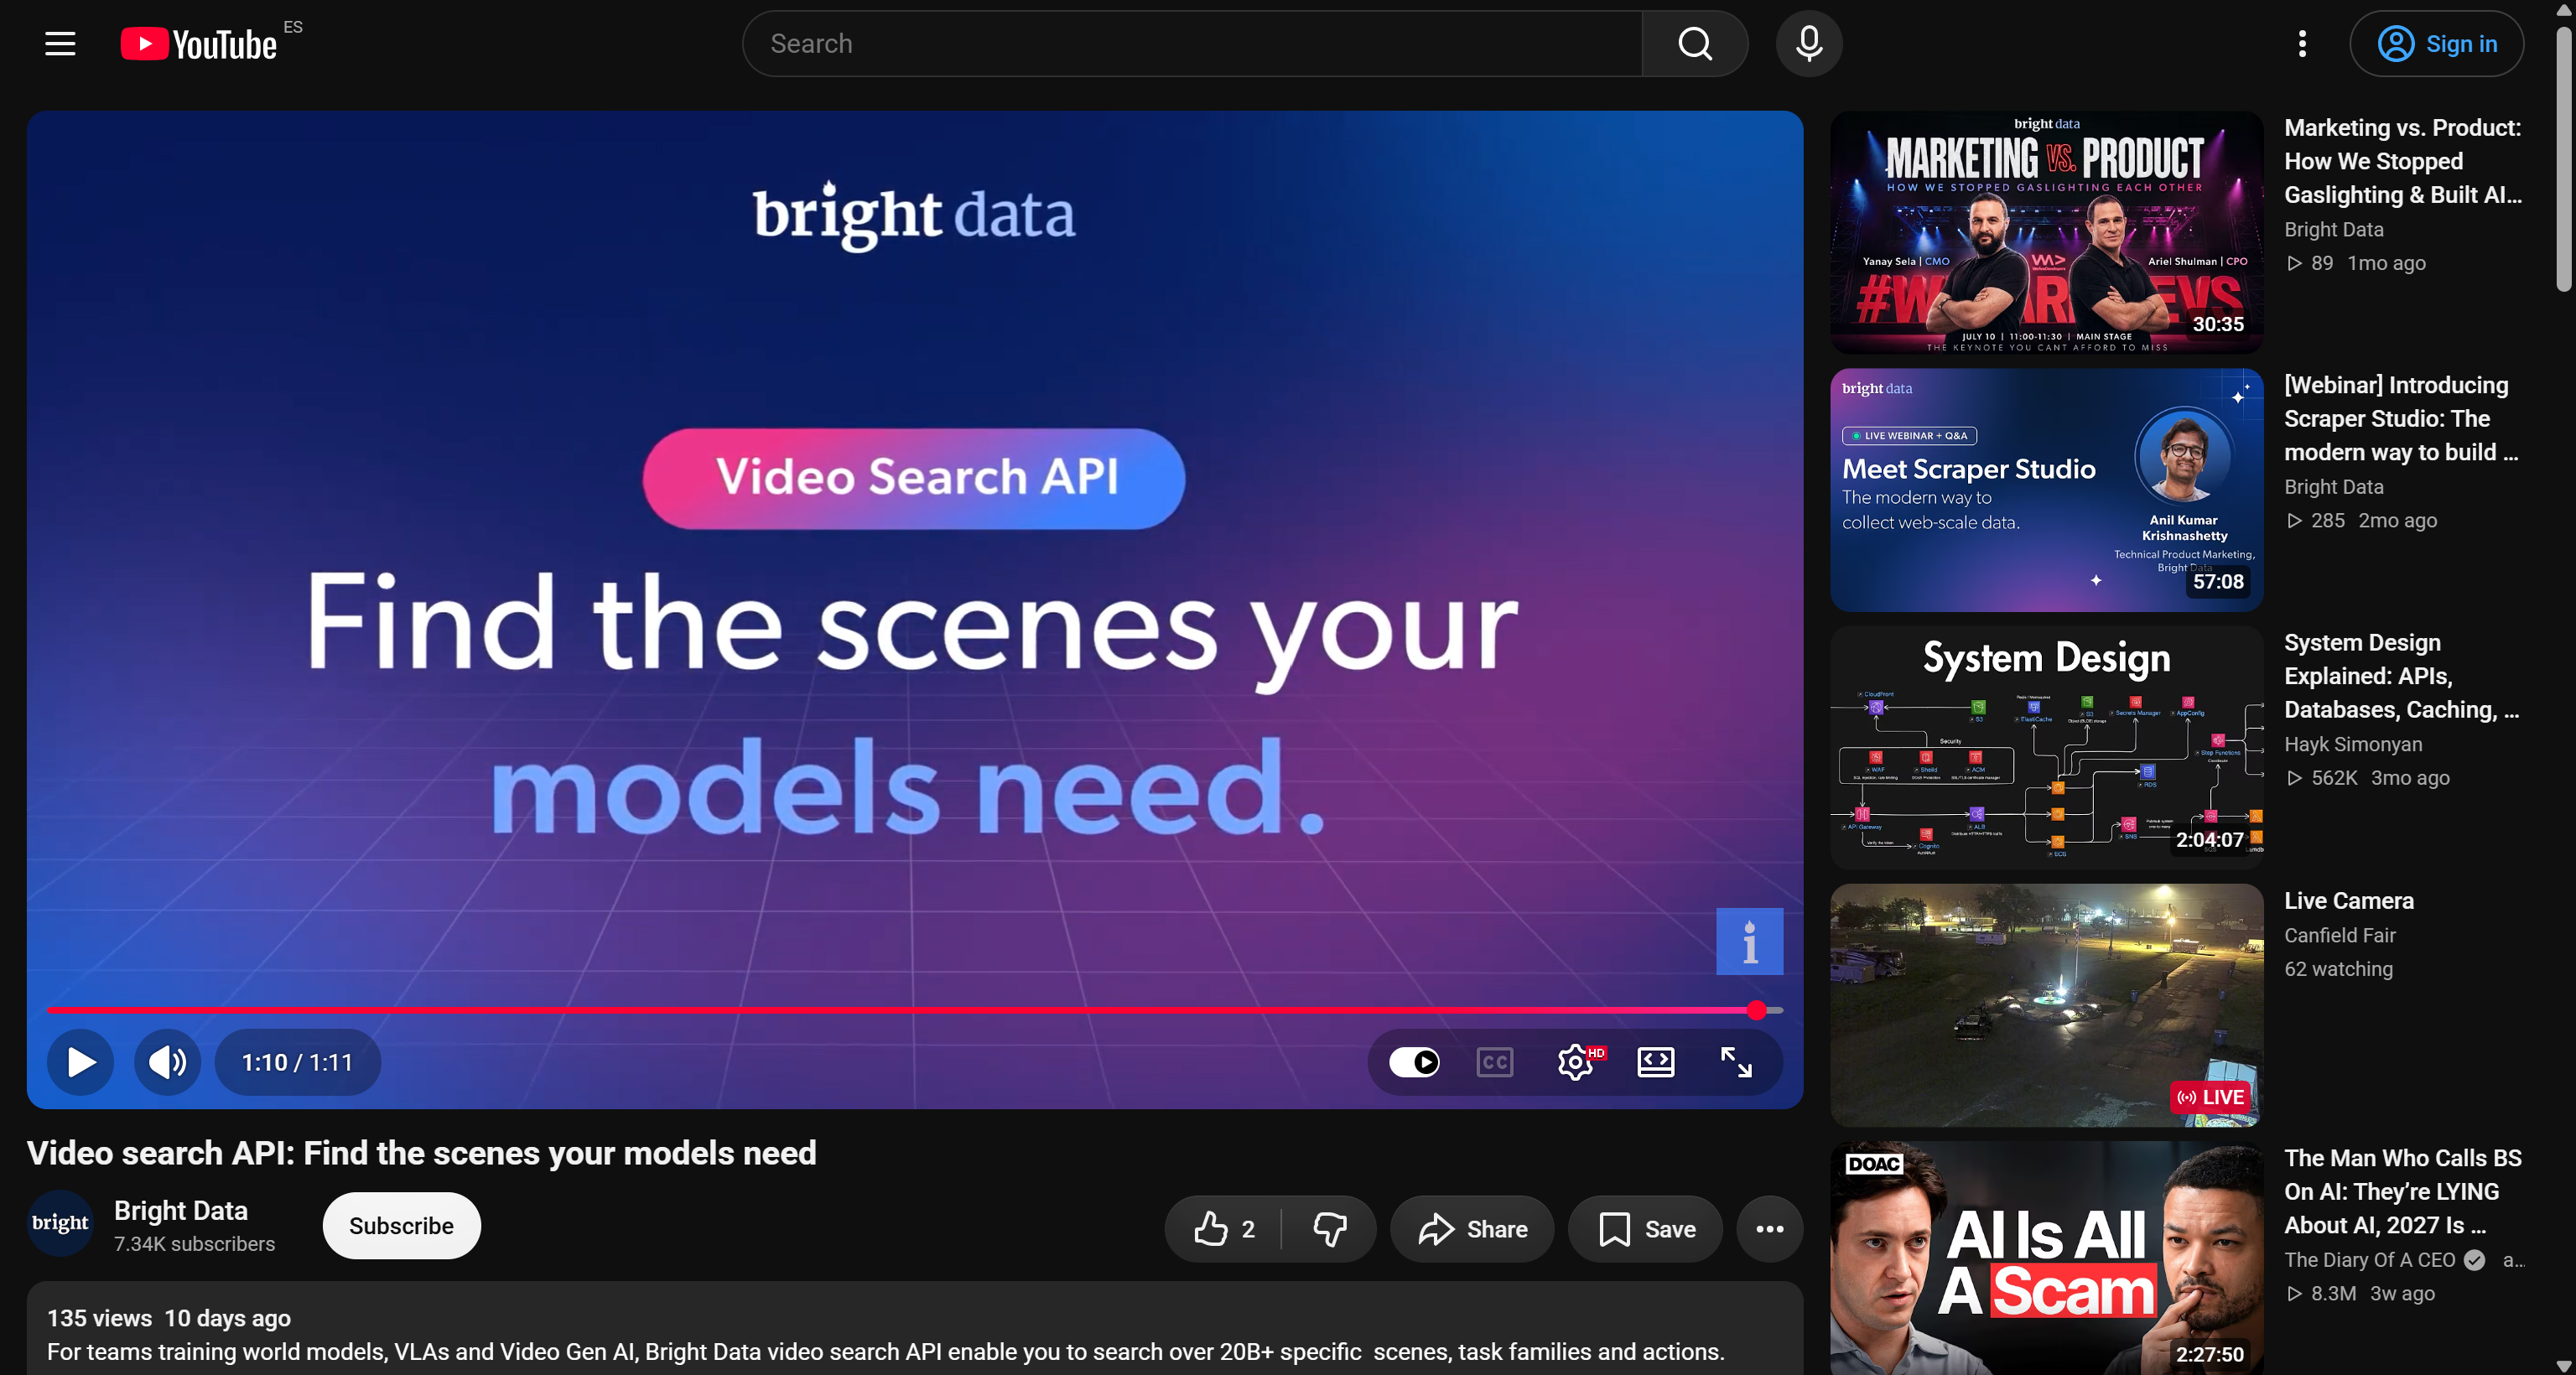
Como você pode ver, a opção “Legendas” está desabilitada.
Nesse caso, o áudio está contido em um vídeo, em vez de ser fornecido como um arquivo de áudio independente. Para baixar o vídeo, você pode usar o yt-dlp, uma das ferramentas e bibliotecas de linha de comando mais populares para baixar conteúdo de vídeo e áudio.
Tenha em mente que fazer scraping de vídeos do YouTube e plataformas similares pode rapidamente resultar no bloqueio de suas solicitações, especialmente ao operar em escala. Para evitar esses problemas, você precisa de rotação de IP confiável e mecanismos para lidar com proteções anti-bot.
A Bright Data suporta o yt-dlp, permitindo que você encaminhe suas solicitações pela sua API Web Unlocker. O resultado é acesso ilimitado a dados de vídeo.
Comece instalando o yt-dlp com pip:
python -m pip install -U "yt-dlp[default]"Em seguida, execute:
yt-dlp --proxy 'http://<WEB_UNLOCKER_API_USERNAME>:<WEB_UNLOCKER_API_PASSWORD>@brd.superproxy.io:<WEB_UNLOCKER_API_PORT>' '<YOUTUBE_VIDEO_URL>' --output output.mp4Lembre-se de substituir os marcadores pelas suas credenciais da API Web Unlocker e pela URL do seu vídeo alvo do YouTube.
O comando acima baixa o vídeo especificado do YouTube enquanto encaminha a solicitação pela sua API Web Unlocker da Bright Data para evitar bloqueios. O vídeo baixado é então salvo como output.mp4 no diretório do seu projeto:
Ótimo! Agora você fez o scraping com sucesso do vídeo que contém seu áudio alvo.
Se você quiser fazer scraping de vídeos de outras fontes, consulte os seguintes guias:
Baixe um Arquivo de Áudio Diretamente
Considere um cenário em que o recurso de áudio de seu interesse já está disponível online como um arquivo independente.
Por exemplo, você pode querer recuperar uma gravação específica hospedada no Internet Archive ou outro website. Aqui, a página já fornece um link de download direto para o arquivo de áudio:
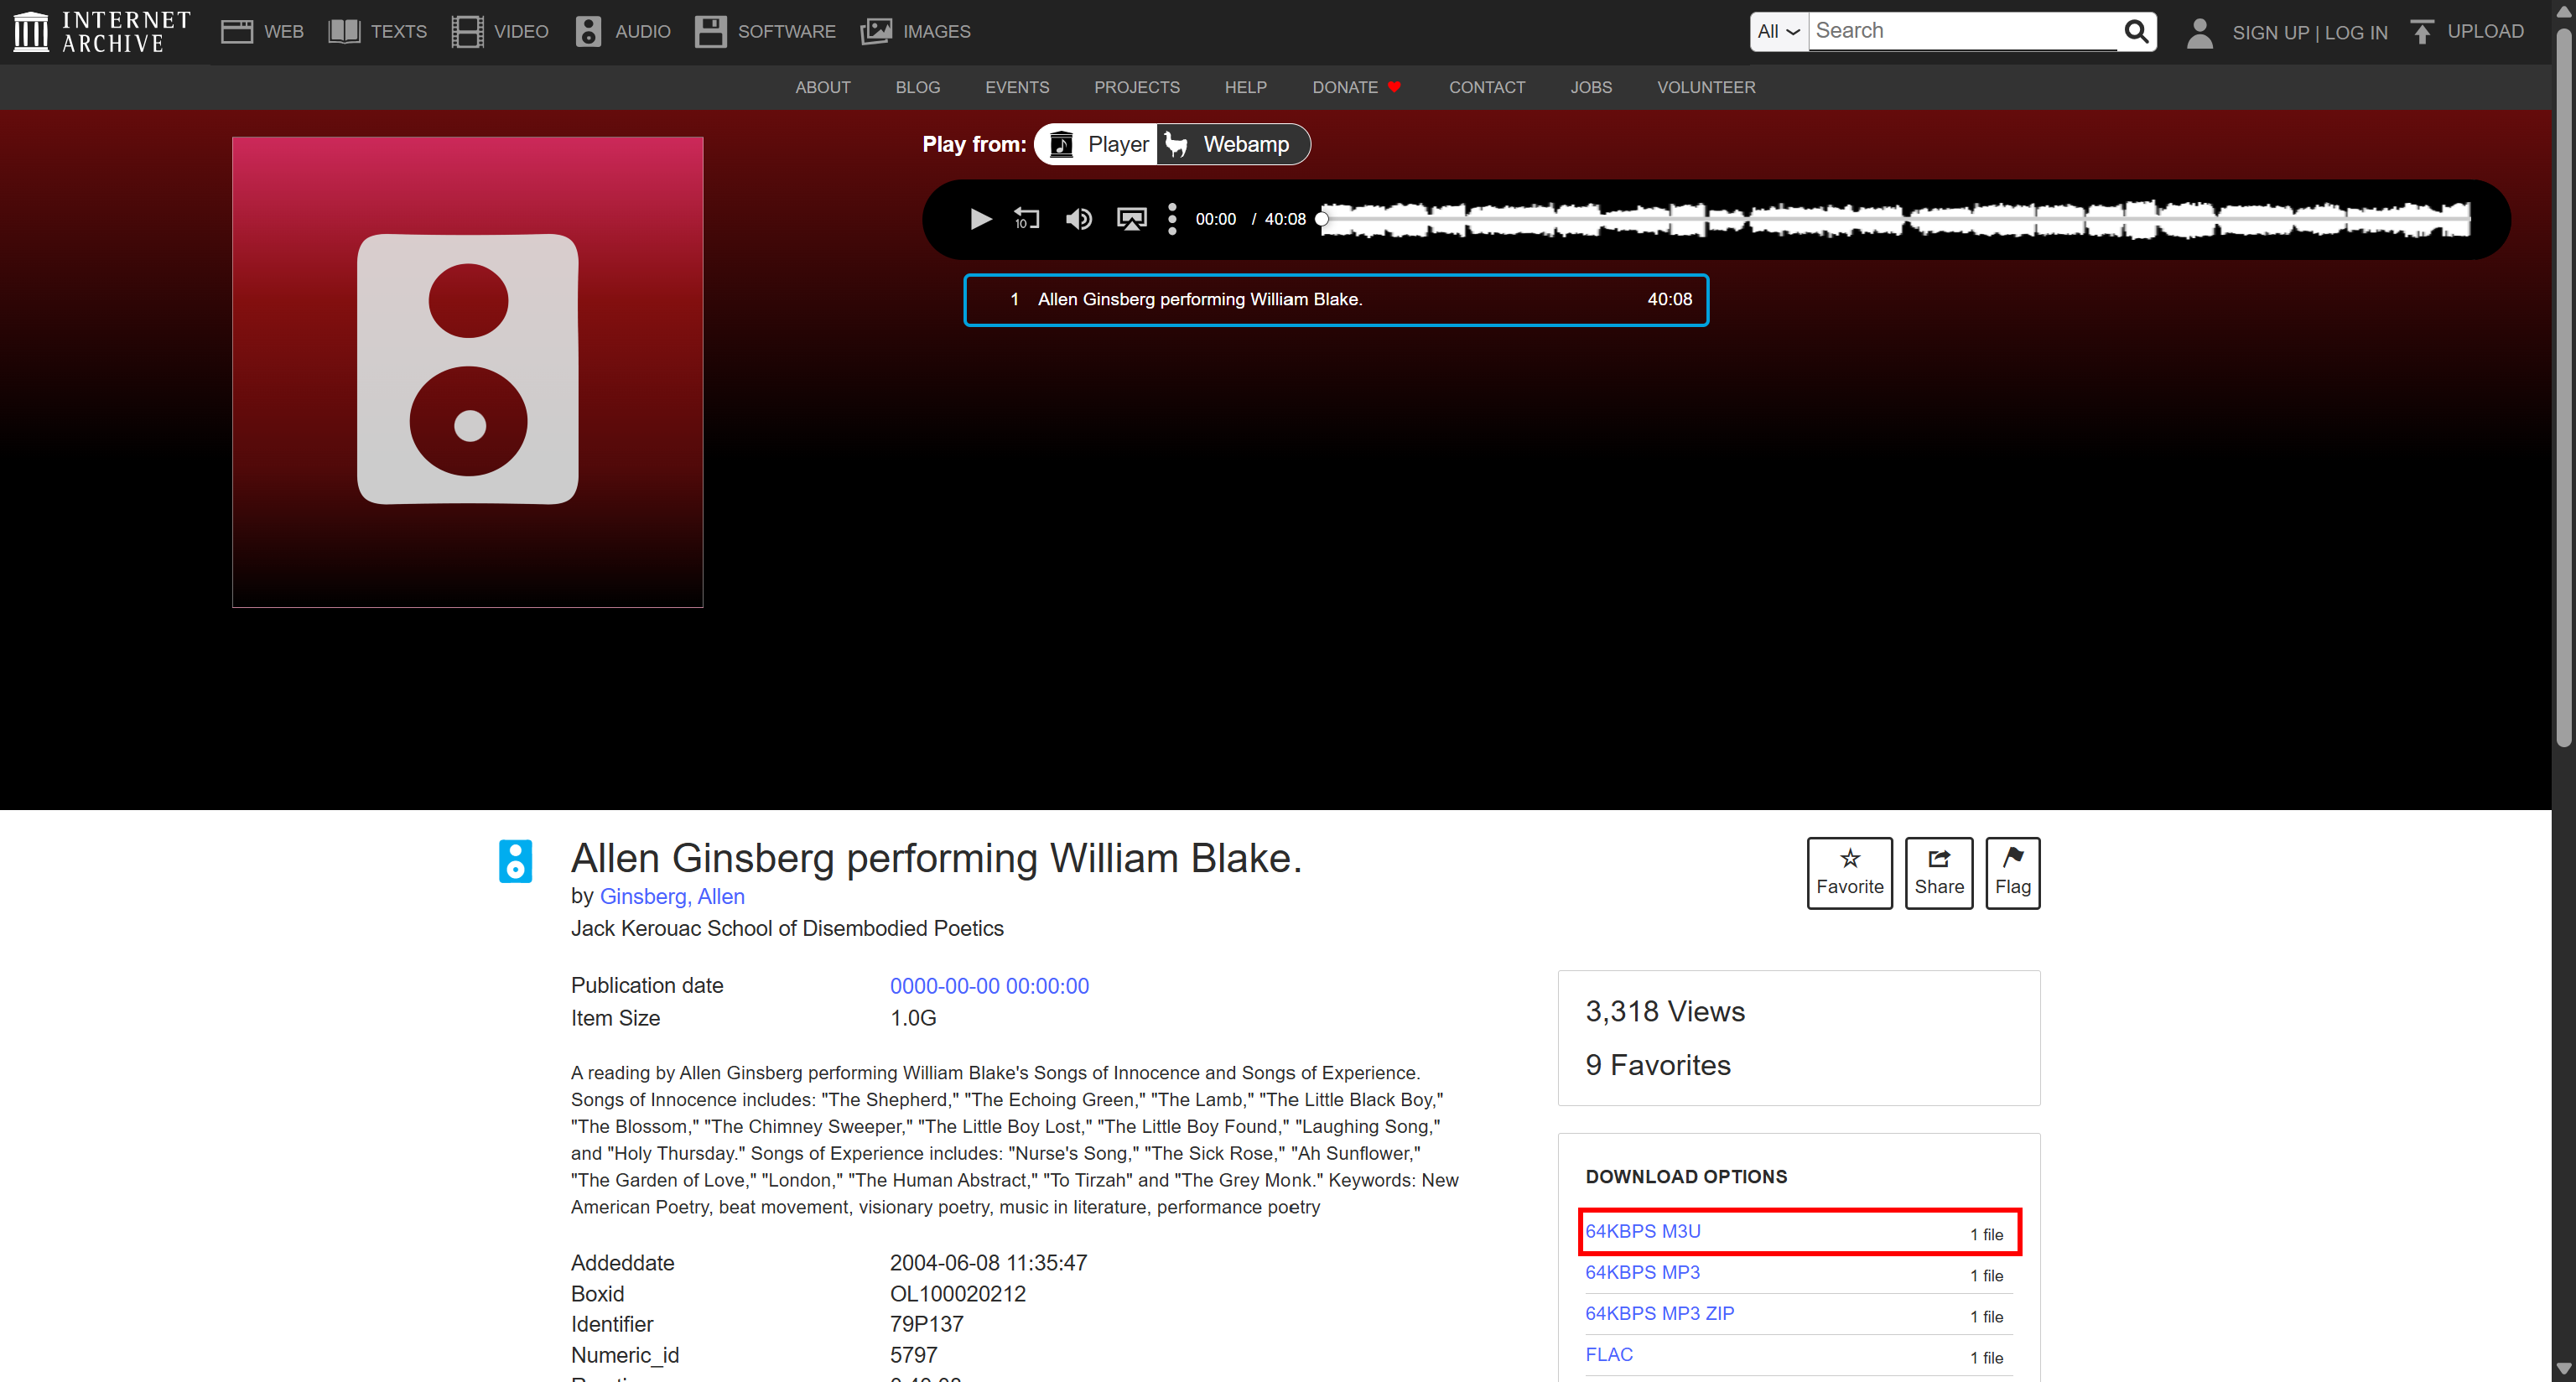
Para automatizar o processo e ajudar a lidar com possíveis restrições de acesso, você pode construir uma lógica de automação de navegador para navegar até a página de interesse e descobrir a URL do recurso de áudio subjacente. Para isso, você pode usar a API Browser da Bright Data.
Especificamente, desta vez, a URL direta do arquivo MP3 é:
https://archive.org/download/79P137/79P137_64kb.mp3Depois de ter a URL alvo, você pode enviá-la para a API Web Unlocker da Bright Data por meio de uma solicitação POST. O Web Unlocker então recuperará o recurso para você, contornando medidas anti-bot ou outras restrições de acesso.
Comece instalando a biblioteca HTTP Requests:
pip install requestsEm seguida, crie um script Python com o seguinte código:
import requests

# Substitua pela sua chave de API da Bright Data
BRIGHT_DATA_API_KEY = "<YOUR_BRIGHT_DATA_API_KEY>"

target_audio_source = "https://archive.org/download/79P137/79P137_64kb.mp3"

# Acesse o recurso de áudio pela API Web Unlocker da Bright Data
response = requests.post(
    "https://api.brightdata.com/request",
    headers={
        "Authorization": f"Bearer {BRIGHT_DATA_API_KEY}",
        "Content-Type": "application/json",
    },
    json={
        "zone": "web_unlocker", # Substitua pelo nome real da sua API Web Unlocker
        "url": target_audio_source,
        "format": "raw",
        "country": "us"
    },
)
response.raise_for_status()

# Exporte o conteúdo de áudio para um arquivo MP3
with open("output.mp3", "wb") as f:
    f.write(response.content)
Este script envia a URL do arquivo de áudio para a API Web Unlocker, recupera o recurso e salva o conteúdo retornado na sua máquina local como output.mp3.
Observação: Em um script de produção, armazene sua chave de API da Bright Data e o nome da sua API Web Unlocker em variáveis de ambiente, em vez de codificá-los diretamente no código-fonte.
Execute o script Python, e o arquivo de áudio recuperado aparecerá no diretório do seu projeto como output.mp3:
Passo #2: Converta o Arquivo de Áudio Extraído para WAV
Quando se trata de processamento de áudio, muitos modelos de IA multimodais suportam arquivos WAV como entrada. Mesmo quando vários formatos são suportados, é útil padronizar seus dados de áudio extraídos convertendo-os para um único formato.
Neste capítulo, você aprenderá como converter seus arquivos de áudio e vídeo de origem para WAV. Dessa forma, eles podem ser usados consistentemente nas etapas subsequentes de processamento de IA.
Pré-requisitos
Antes de prosseguir, certifique-se de que o FFmpeg esteja instalado localmente. O FFmpeg é uma ferramenta de linha de comando usada para converter e processar arquivos de áudio e vídeo.
Baixe o FFmpeg no site oficial e siga as instruções de instalação para o seu sistema operacional.
Do Arquivo de Vídeo/Áudio de Entrada para WAV
Converta o arquivo de vídeo do YouTube extraído em um arquivo de áudio WAV usando este comando:
ffmpeg -i output.mp4 -vn -acodec pcm_s16le -ar 16000 -ac 1 video_output.wavVeja o que cada argumento faz:
-i output.mp4: Especificaoutput.mp4como o arquivo de entrada.-vn: Desabilita o processamento de vídeo, de modo que apenas o fluxo de áudio é extraído.-acodec pcm_s16le: Converte o áudio para PCM não comprimido usando codificação little-endian de 16 bits com sinal, um formato comum para arquivos WAV.-ar 16000: Define a taxa de amostragem do áudio para 16.000 Hz (16 kHz).-ac 1: Converte o áudio para um único canal (mono).video_output.wav: Especifica o nome do arquivo WAV de saída.
A mesma abordagem pode ser usada para converter um arquivo de áudio independente de outro formato suportado para WAV:
ffmpeg -i output.mp3 -vn -acodec pcm_s16le -ar 16000 -ac 1 audio_output.wavObserve que o comando é essencialmente o mesmo. As principais diferenças são o arquivo de entrada e o de saída.
Incrível! Agora você está pronto para transcrever o áudio extraído com um modelo de IA.
Passo #3: Use IA para Transcrever o Arquivo WAV
A etapa final é alimentar o áudio no formato WAV em um modelo de transcrição com IA, seja por meio de um LLM baseado em nuvem ou um modelo executado localmente.
Para essa tarefa, você pode usar um modelo de IA projetado para transcrição de fala para texto, ou outro modelo de IA multimodal que aceite entrada de áudio. A escolha depende de seus requisitos, como precisão da transcrição, marcações de tempo, identificação de falantes, velocidade de processamento e custo.
Obtenha a Transcrição com um Modelo de IA Multimodal Baseado em Nuvem
A OpenAI fornece vários modelos e APIs para transcrição de fala para texto. Utilize o SDK da OpenAI para enviar seu arquivo de áudio WAV a um modelo de transcrição e recuperar a transcrição resultante com marcação de tempo.
Comece instalando o SDK Python da OpenAI:
pip install openaiEm seguida, atinja o objetivo com:
from openai import OpenAI

# Substitua pela sua chave de API real da OpenAI
OPENAI_KEY = "<YOUR_OPENAI_API_KEY>"

client = OpenAI(api_key=OPENAI_KEY)

# Abra o arquivo de áudio e envie-o ao OpenAI Whisper para transcrição
with open("video_output.wav", "rb") as f:
    transcription = client.audio.transcriptions.create(
        model="whisper-1",
        file=f,
        response_format="verbose_json",
        timestamp_granularities=["segment"],
    )

# Escreva a transcrição completa com marcação de tempo em um arquivo de texto
with open("video_transcript.txt", "w", encoding="utf-8") as f:
    for segment in transcription.segments:
        # Obtenha o horário de início e fim do segmento
        start = segment.start
        end = segment.end

        # Obtenha o texto transcrito
        text = segment.text.strip()

        # Formate a marcação de tempo como HH:MM:SS
        start_time = f"{int(start // 3600):02d}:{int((start % 3600) // 60):02d}:{int(start % 60):02d}"
        end_time = f"{int(end // 3600):02d}:{int((end % 3600) // 60):02d}:{int(end % 60):02d}"

        # Crie uma linha de transcrição com marcação de tempo
        line = f"[{start_time} - {end_time}] {text}"

        # Imprima a linha e salve-a no arquivo de transcrição
        print(line)
        f.write(line + "\n")
Este script primeiro inicializa o cliente OpenAI usando sua chave de API e abre o arquivo WAV em modo binário. Em seguida, envia o áudio para o modelo whisper-1 e solicita uma resposta JSON detalhada contendo marcações de tempo em nível de segmento.
Em seguida, ele itera sobre os segmentos retornados, extrai o horário de início, horário de fim e texto transcrito para cada segmento, e os formata em linhas legíveis com marcação de tempo. Cada linha é impressa no terminal e gravada em video_transcript.txt.
Execute o script Python, e você verá a saída da transcrição no seu terminal:
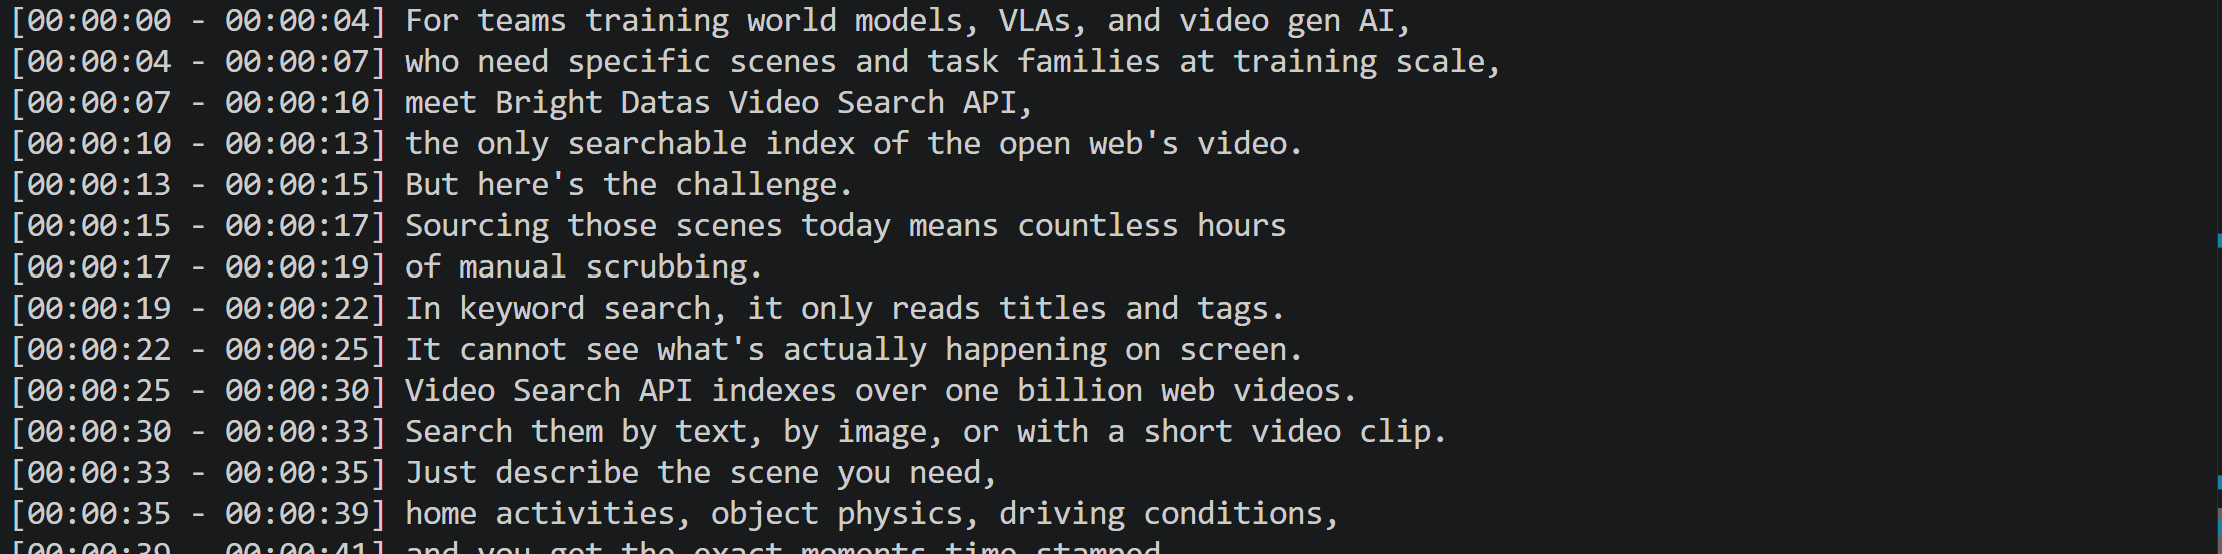
Após a conclusão do processamento, o arquivo video_transcript.txt conterá a transcrição com marcação de tempo:
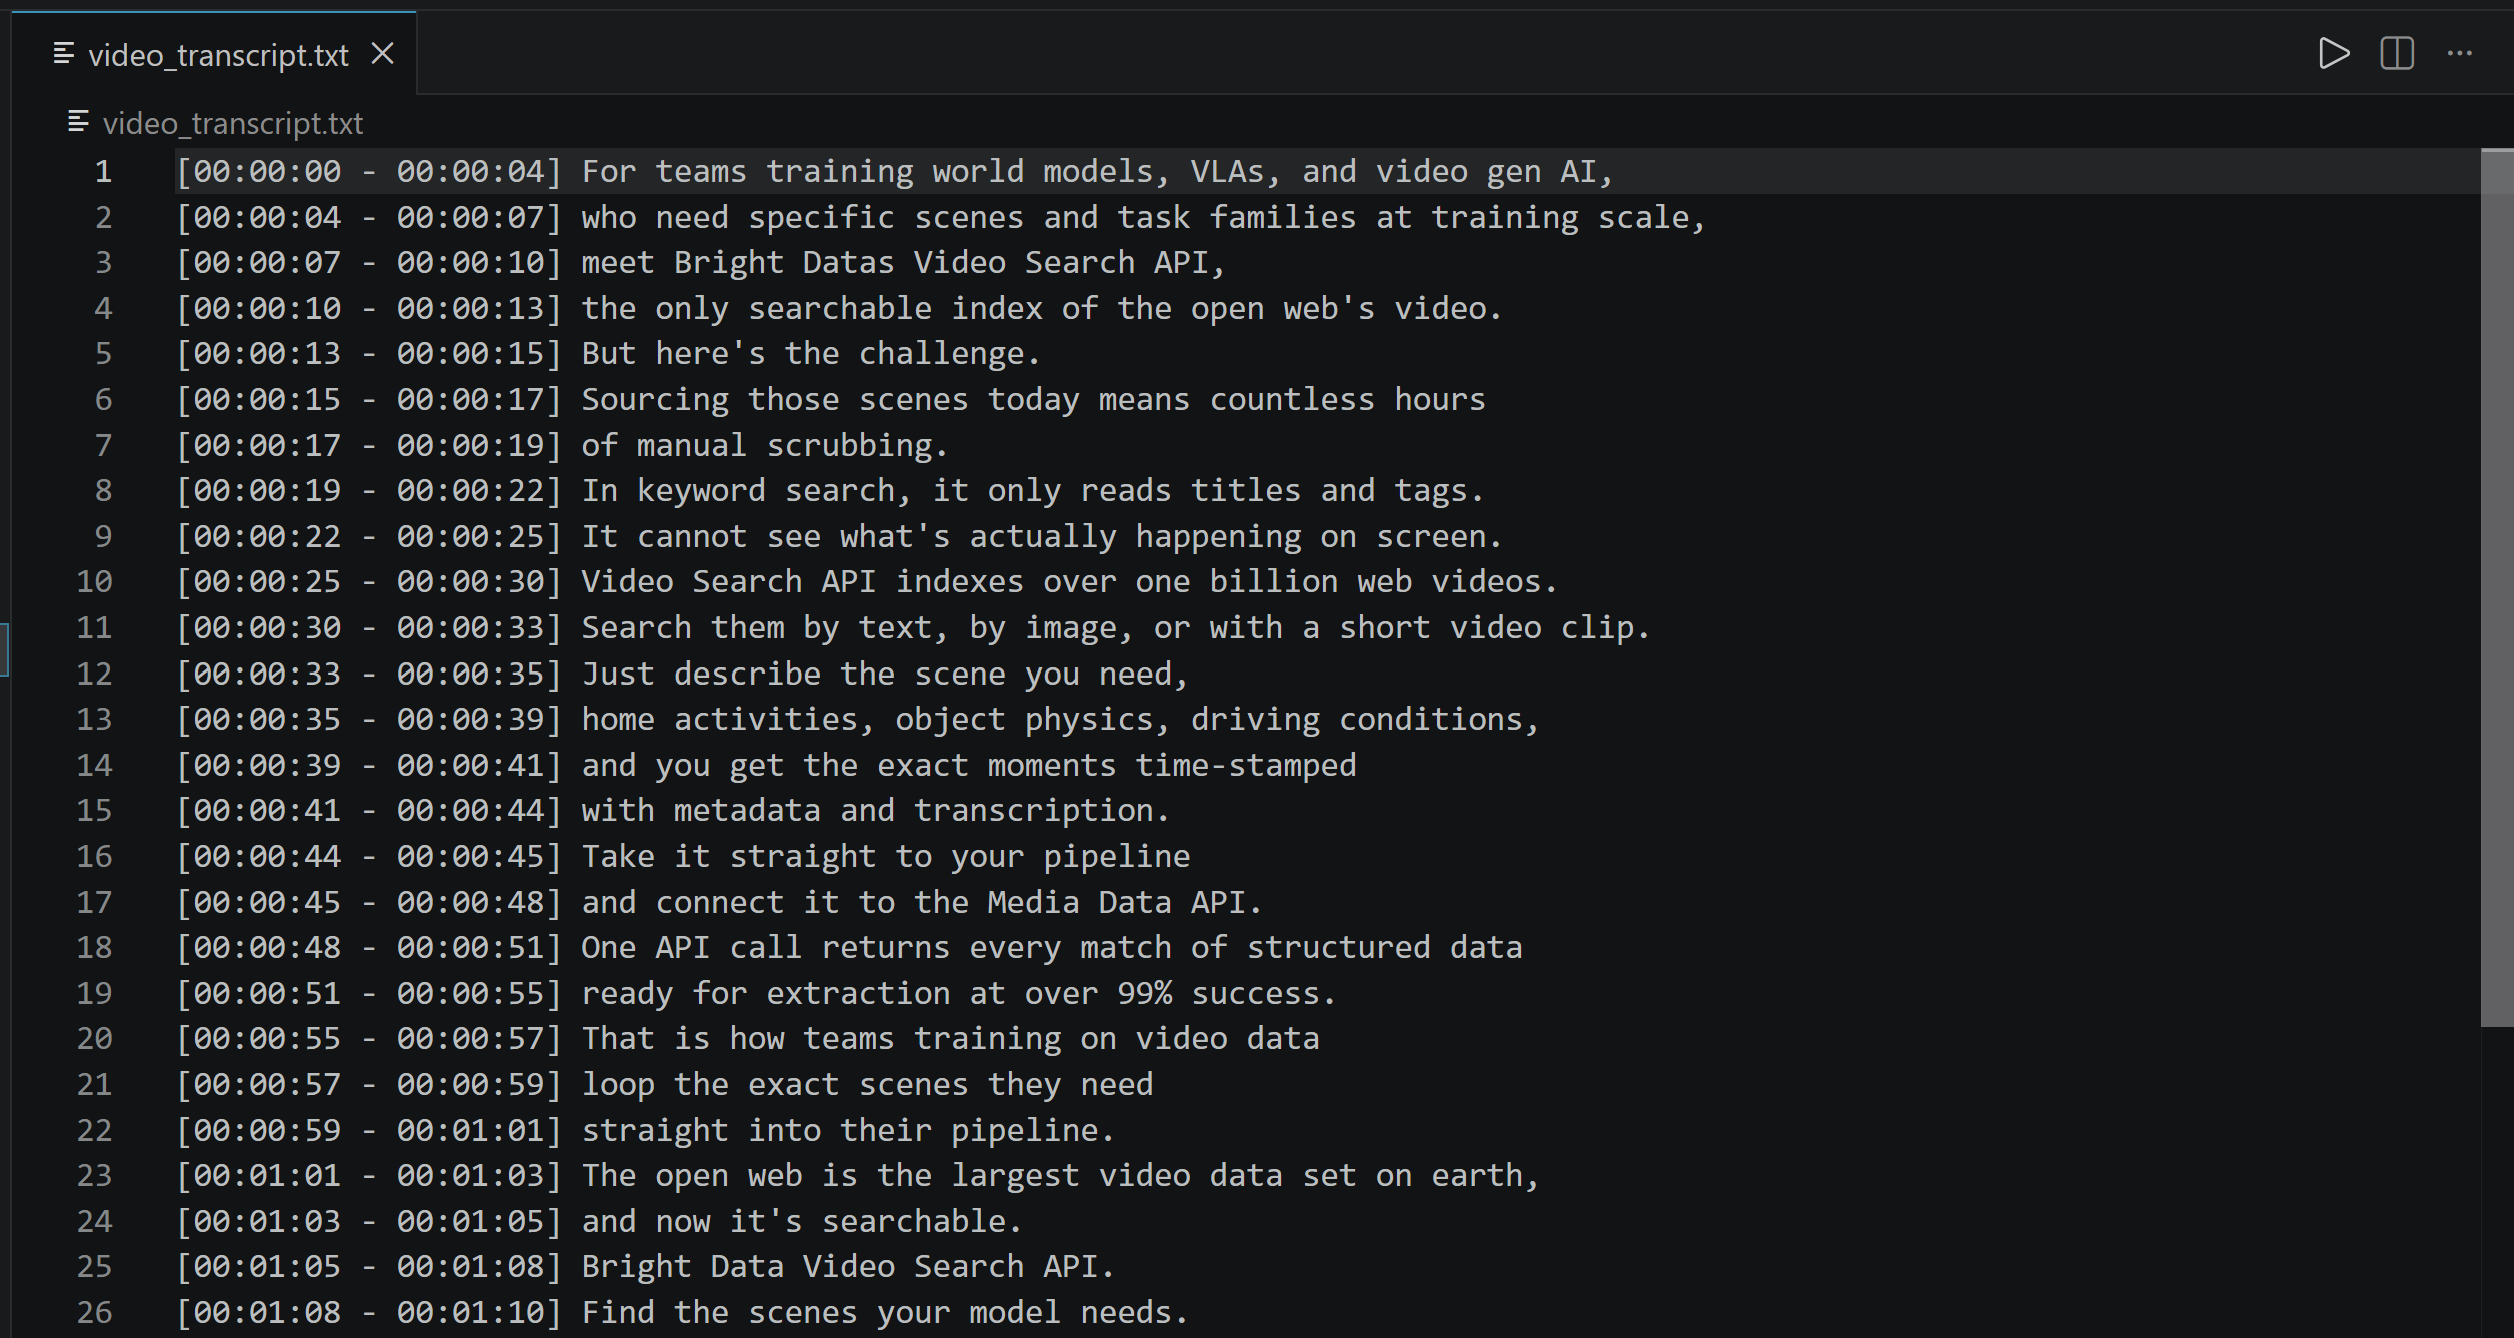
Missão cumprida! Você começou com um vídeo do YouTube, fez o scraping, converteu seu áudio para o formato WAV e, finalmente, o transcreveu em texto. Agora você tem uma transcrição limpa para análises posteriores.
As principais limitações dessa abordagem são:
- Tamanho do arquivo de entrada: Os arquivos de áudio enviados pela API de transcrição são limitados a 25 MB. Para gravações maiores, você precisa comprimir o áudio para reduzir seu tamanho ou dividi-lo em partes menores antes da transcrição.
- Custo: Gravações de áudio longas podem resultar em uso significativo da API. Quanto mais longo o áudio, mais tokens de entrada são necessários e mais tokens de saída são produzidos.
Alternativamente, você pode executar um modelo de fala para texto localmente, como mostrado na próxima seção.
Obtenha a Transcrição com um Modelo de IA Local
Existem vários modelos e bibliotecas locais de fala para texto que você pode usar para gerar transcrições. O faster-whisper é uma opção popular. Esta é uma reimplementação do modelo Whisper da OpenAI que usa o CTranslate2, um motor de inferência de alto desempenho para modelos Transformer.
Instale o faster-whisper com:
pip install faster-whisperEm seguida, use-o para gerar uma transcrição a partir do seu arquivo de áudio local:
from faster_whisper import WhisperModel

# Carregue o modelo Whisper local
model = WhisperModel(
    "small",
    device="cpu", # Execute a tarefa na CPU
    compute_type="int8"
)

# Transcreva o arquivo de áudio de entrada e retorne segmentos de transcrição com marcação de tempo
segments, info = model.transcribe(
    "audio_output.wav",
    beam_size=5
)

# Imprima o idioma detectado pelo Whisper
print(f"Detected language: {info.language}")

# Converta segundos em uma marcação de tempo legível HH:MM:SS
def format_timestamp(seconds):
    hours = int(seconds // 3600)
    minutes = int((seconds % 3600) // 60)
    seconds = int(seconds % 60)

    return f"{hours:02d}:{minutes:02d}:{seconds:02d}"

# Escreva cada segmento de transcrição com marcação de tempo em um arquivo de saída
with open("audio_transcript.txt", "w", encoding="utf-8") as f:
    for segment in segments:
        # Obtenha as marcações de tempo de início e fim deste segmento
        start = format_timestamp(segment.start)
        end = format_timestamp(segment.end)

        # Remova espaços em branco desnecessários do texto transcrito
        text = segment.text.strip()

        # Combine as marcações de tempo e a transcrição em uma única linha
        line = f"[{start} - {end}] {text}"

        # Imprima o segmento no console e salve-o no arquivo
        print(line)
        f.write(line + "\n")
Este script carrega o modelo Whisper small localmente e o executa na CPU usando quantização int8. Ele transcreve audio_output.wav em segmentos com marcação de tempo, detecta o idioma do áudio e formata cada segmento com seus horários de início e fim. A transcrição resultante é impressa no console e salva em video_transcript.txt.
Execute o script, e você verá uma saída semelhante a esta:
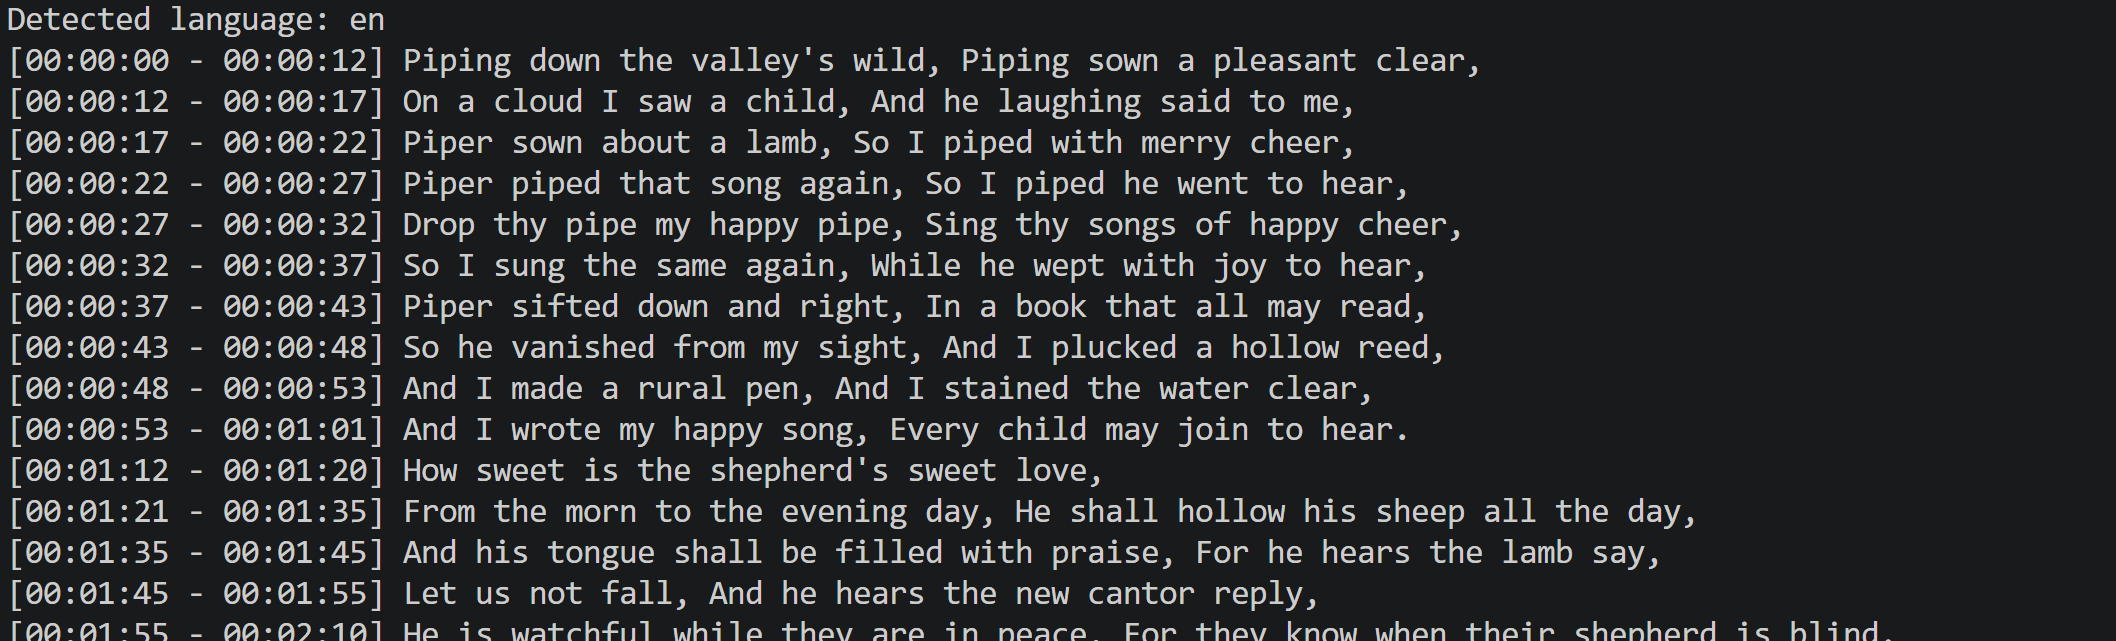
Agora o modelo faster-whisper detectou com sucesso o idioma do áudio como inglês e gerou uma transcrição precisa.
O arquivo video_transcript.txt resultante conterá a transcrição com marcação de tempo:
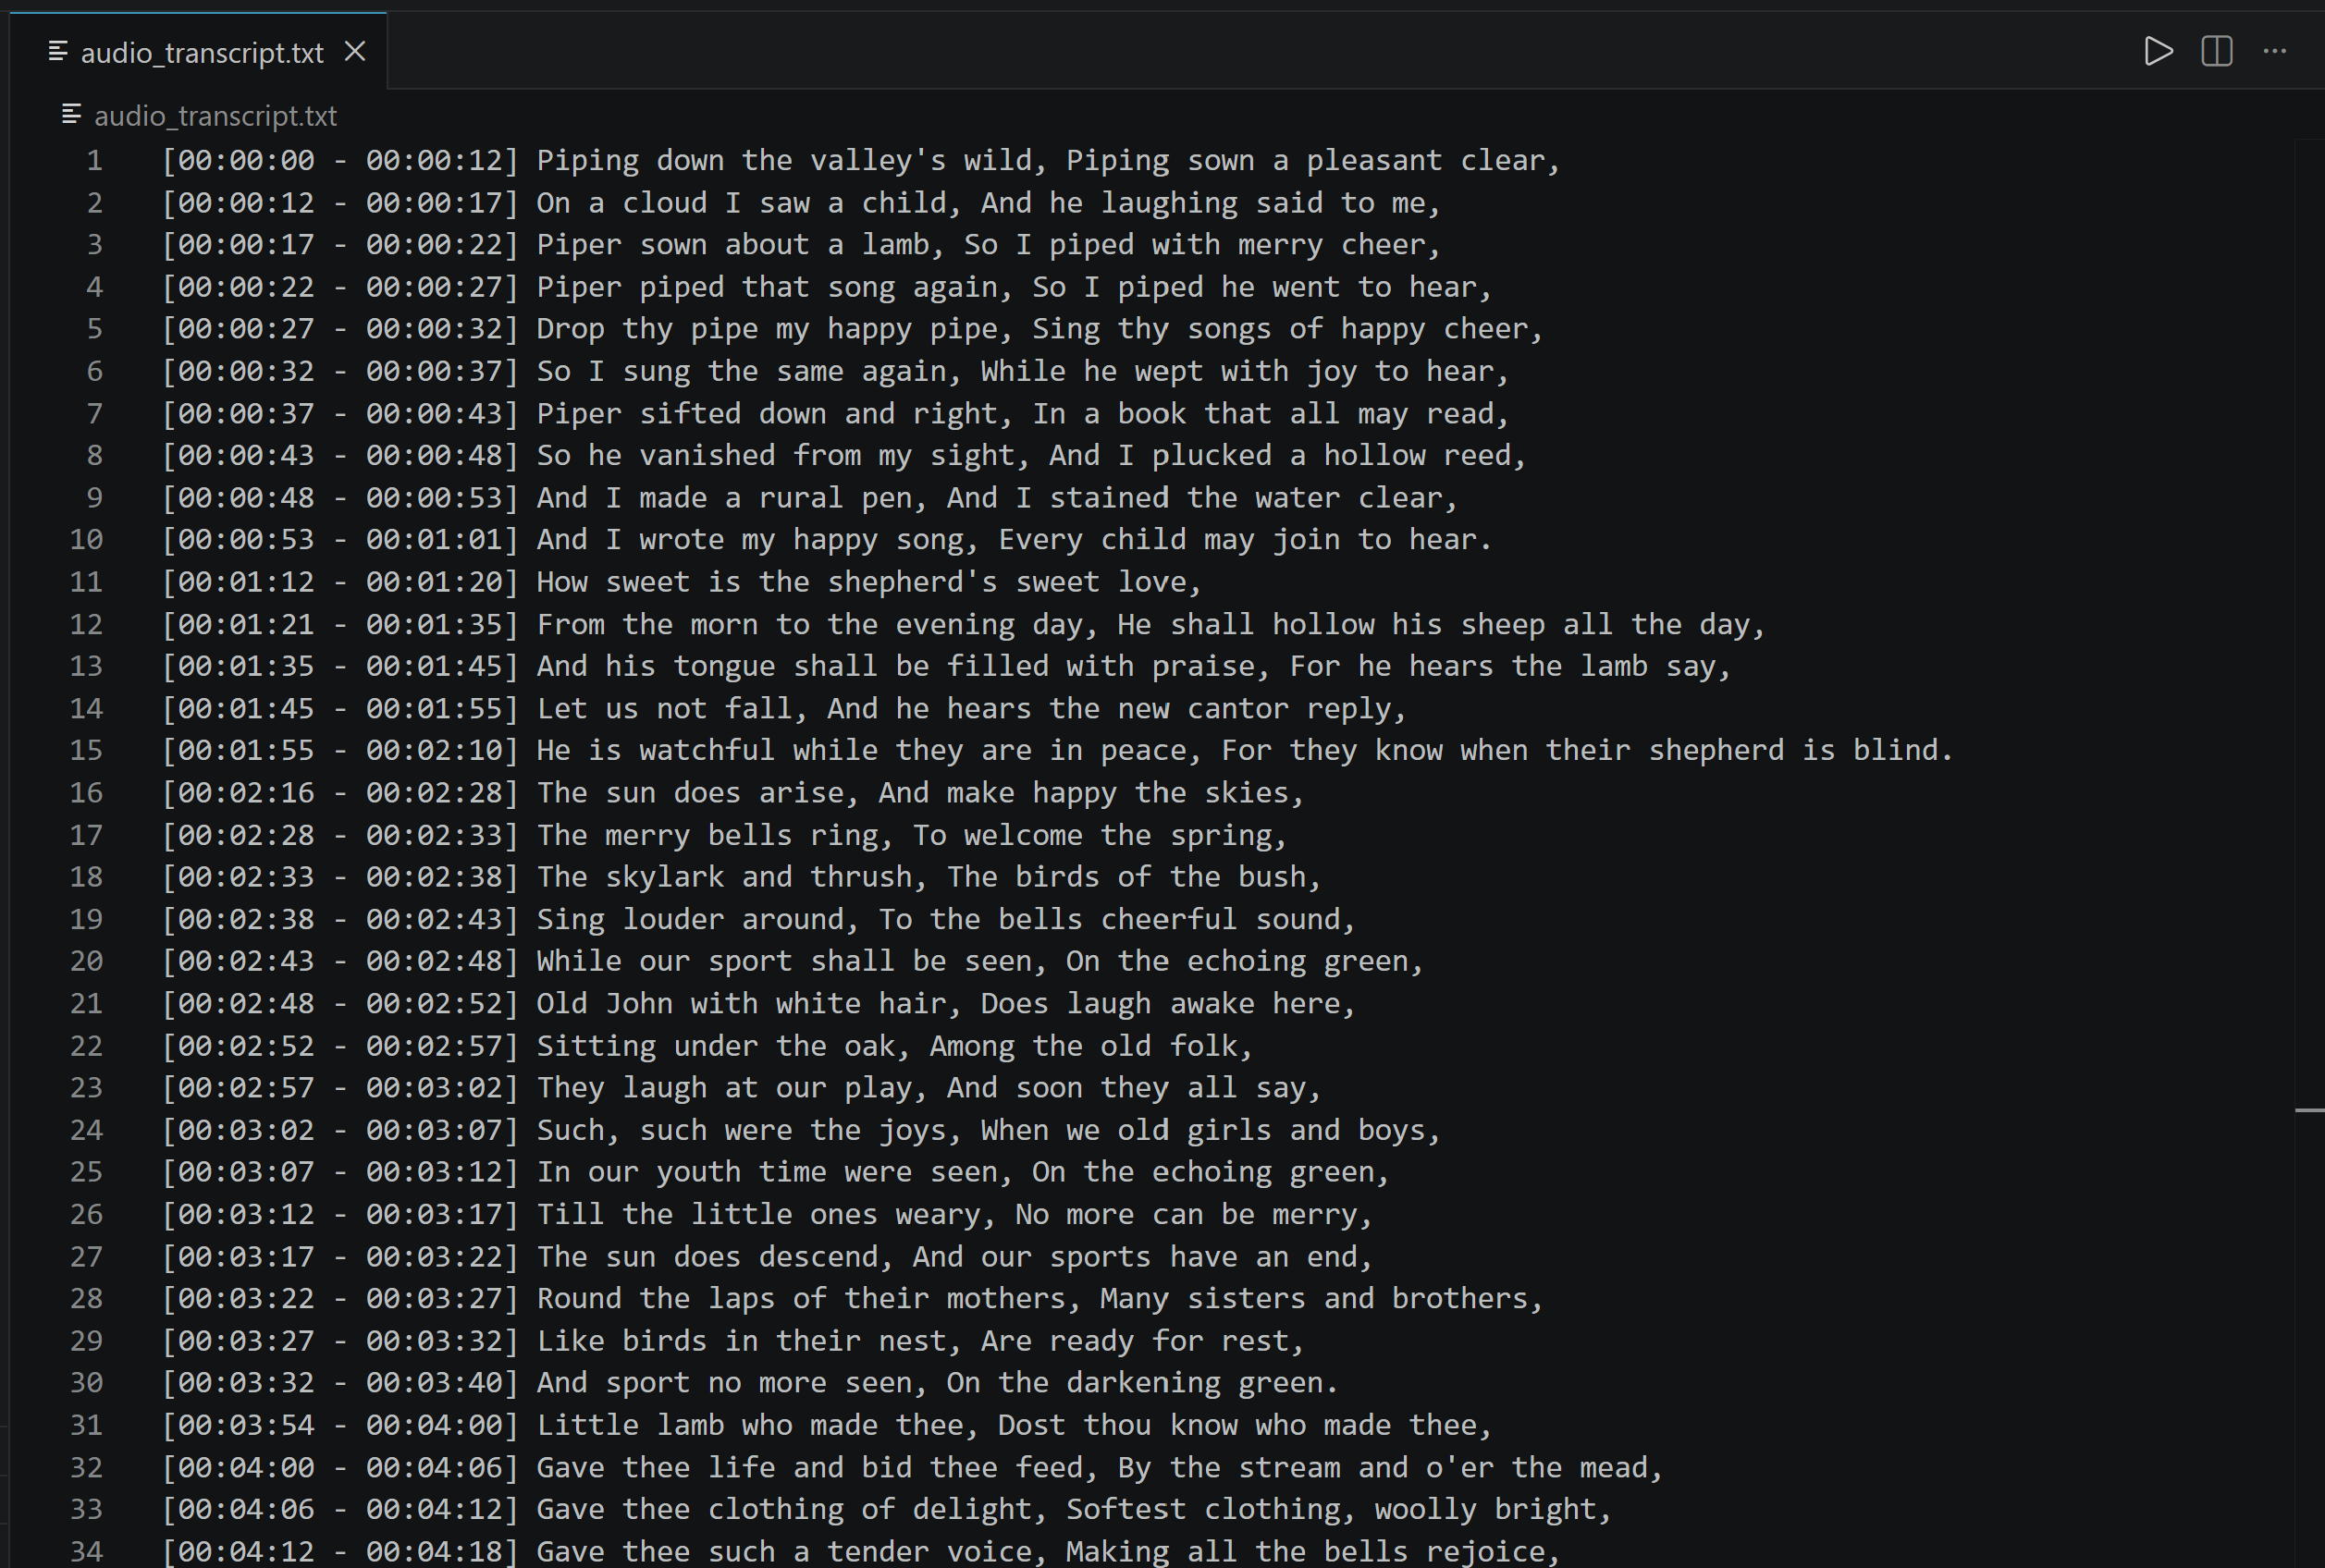
E pronto! Você concluiu o pipeline completo de web scraping de áudio ao:
- Recuperar uma gravação de áudio da web.
- Convertê-la em um arquivo WAV padronizado.
- Empregar um modelo de IA local para transformar o áudio em uma transcrição de texto com marcação de tempo.
Web Scraping de Áudio: Casos de Uso e Cenários
Depois de fazer o scraping de áudio da web e convertê-lo em texto, você pode usar o resultado para uma ampla gama de aplicações de IA e processamento de dados.
A combinação de áudio, transcrições e marcações de tempo permite tanto análise em nível de conteúdo quanto aplicações de áudio-texto. Alguns possíveis casos de uso incluem:
- Monitoramento de mídia: Acompanhe podcasts, entrevistas e transmissões para identificar menções, tópicos, marcas ou eventos.
- Análise de conteúdo: Analise grandes coleções de conteúdo falado para descobrir tópicos recorrentes, tendências, opiniões e temas-chave.
- Treinamento de modelos de IA: Construa conjuntos de dados de áudio-texto para treinar ou ajustar modelos de reconhecimento de fala e outros modelos de IA.
- Arquivos pesquisáveis: Transforme grandes coleções de áudio online em texto pesquisável, permitindo que os usuários localizem rapidamente informações específicas.
- Extração de informações: Extraia automaticamente nomes, organizações, locais, fatos ou outras informações estruturadas do conteúdo falado.
- Resumo de conteúdo: Gere resumos concisos de podcasts, entrevistas, palestras, reuniões e outras gravações longas.
- Alinhamento áudio-texto: Use marcações de tempo para conectar segmentos da transcrição às suas posições exatas no áudio original, permitindo recuperação e análise precisas do conteúdo.
Conclusão
Neste artigo, você aprendeu como fazer scraping de áudio da web e transformá-lo em texto com marcação de tempo para processamento com IA. Em detalhes, você viu como coletar áudio de vídeos ou arquivos independentes, convertê-lo para WAV e transcrevê-lo com modelos de IA baseados em nuvem ou locais.
O resultado é um pipeline completo de processamento de áudio que pode dar suporte a aplicações como análise de conteúdo, extração de informações, arquivos pesquisáveis e treinamento de modelos de IA.
Se você quiser pular a etapa de scraping, explore os conjuntos de dados de áudio prontos para IA e os pacotes de dados de vídeo da Bright Data. Para coleta de áudio personalizada, use o Web Unlocker da Bright Data para acessar os recursos web que você precisa de forma confiável e em escala, sem ser bloqueado.
Crie uma conta Bright Data e comece a construir seu pipeline de dados de áudio hoje mesmo!