Neste artigo, você vai descobrir:
- Por que o GLM-5.3 e o GLM-5.3-Flash representam um avanço significativo para tarefas de scraping de dados com LLM.
- Os principais obstáculos na construção de sistemas de extração de dados da web e como a API Web Unlocker da Bright Data os resolve.
- Uma implementação passo a passo de scraping de dados com IA usando GLM em Python.
- Como realizar scraping de dados visual com as capacidades multimodais do GLM-5.3.
Vamos começar!
Vantagens dos Modelos GLM para Extração de Dados da Web
Os LLMs modernos revolucionaram a abordagem ao scraping de dados. Em vez de implementar rotinas manuais de parsing para processar marcação HTML bruta, você pode aproveitar um modelo de IA para realizar a extração automaticamente. Isso elimina a fragilidade inerente às abordagens baseadas em seletores CSS e correspondência de expressões XPath.
Tudo que você precisa é de um prompt bem elaborado que especifique os elementos de dados que deseja recuperar. Com apenas algumas linhas de código, você pode instruir o LLM a identificar e extrair dados organizados de qualquer página da web. Essa metodologia orientada por IA produz scrapers de dados substancialmente mais robustos quando as estruturas das páginas mudam.
Nesse contexto, o GLM-5.3 é excepcionalmente proficiente em recuperação de informações baseada em texto e geração de dados estruturados. Já o GLM-5.3-Flash vem com funcionalidade de visão, permitindo analisar capturas de tela de páginas da web e elementos gráficos.
Para contexto adicional, consulte estes recursos relacionados:
- Princípios gerais da metodologia de scraping de dados com IA.
- Aplicação de IA para extração de dados visuais via GPT Vision.
Principais Desafios no Scraping de Dados com IA
A extração baseada em IA reduz a sensibilidade a mudanças na marcação das páginas. Ainda assim, os principais desafios técnicos encontrados no scraping de dados com IA são amplamente consistentes com os do scraping de dados tradicional.
Os principais problemas continuam sendo renderização de JavaScript, sistemas de detecção anti-bot, técnicas de fingerprinting de dispositivos, limitações de taxa de requisições, CAPTCHAs e problemas de reputação de IP. Afinal, antes que um LLM possa processar uma página da web, você precisa primeiro adquirir seu conteúdo. Isso exige lidar com as diversas medidas de proteção projetadas para impedir o acesso programático.
Portanto, a extração com IA não elimina a dificuldade fundamental de obter conteúdo de páginas da web em escala. O que é certo é que adicionar IA ao processo introduz considerações adicionais. Em particular, o consumo de tokens se torna um fator crítico.
Transmitir extensos documentos HTML para modelos avançados como o GLM-5.3 pode rapidamente acumular custos consideráveis. A solução ideal envolve transformar o HTML bruto em formato Markdown otimizado para LLMs.
Converter páginas da web em Markdown estruturado preserva informações essenciais e a hierarquia de layout enquanto reduz drasticamente o consumo desnecessário de tokens. Essa transformação mantém cabeçalhos, listas enumeradas, URLs de imagens e legendas, e hiperlinks em um formato que os LLMs podem processar eficientemente. Para mais detalhes, leia nosso tutorial sobre conversão de HTML para Markdown.
API Web Unlocker da Bright Data: A Solução
A API Web Unlocker da Bright Data oferece uma solução completa para os desafios subjacentes do scraping de dados. Isso vale tanto para parsing tradicional quanto para parsing com IA.
A API Web Unlocker funciona como um endpoint que aceita uma URL de destino e retorna seu conteúdo renderizado, lidando com todas as proteções anti-bot. Em particular, ela contorna proteções de CAPTCHA, processa páginas com uso intensivo de JavaScript, burla a detecção de fingerprinting de navegadores, rotaciona IPs automaticamente e muito mais. Saiba mais sobre a abordagem da Bright Data para contornar bloqueios anti-bot.
Além disso, a API Web Unlocker oferece flexibilidade para retornar os dados recuperados em múltiplos formatos de saída, incluindo:
Como resultado, os dados de resposta das requisições à API Web Unlocker servem como entrada ideal para extração subsequente de dados baseada em texto ou visão com LLMs, como o GLM-5.3 e o GLM-5.3-Flash.
Nota: A API Web Unlocker está incluída no nível gratuito da Bright Data, que concede 5.000 requisições de extração gratuitas por mês calendário.
O que diferencia a API Web Unlocker de outras APIs de scraping de dados é a infraestrutura de nível empresarial fornecida pela Bright Data. Isso inclui mais de 400 milhões de IPs residenciais, concorrência ilimitada, disponibilidade de 99,99% e taxa de sucesso de 99,95%. Essa infraestrutura permite extração programática de dados confiável e altamente escalável.
Como Construir um Scraper de Dados com IA usando GLM-5.3 em Python
Nesta seção guiada, você aprenderá a desenvolver um script Python que utiliza o GLM-5.3 para parsing de dados com IA.
O script foca na coleta de dados desta página de produto específica da IKEA:
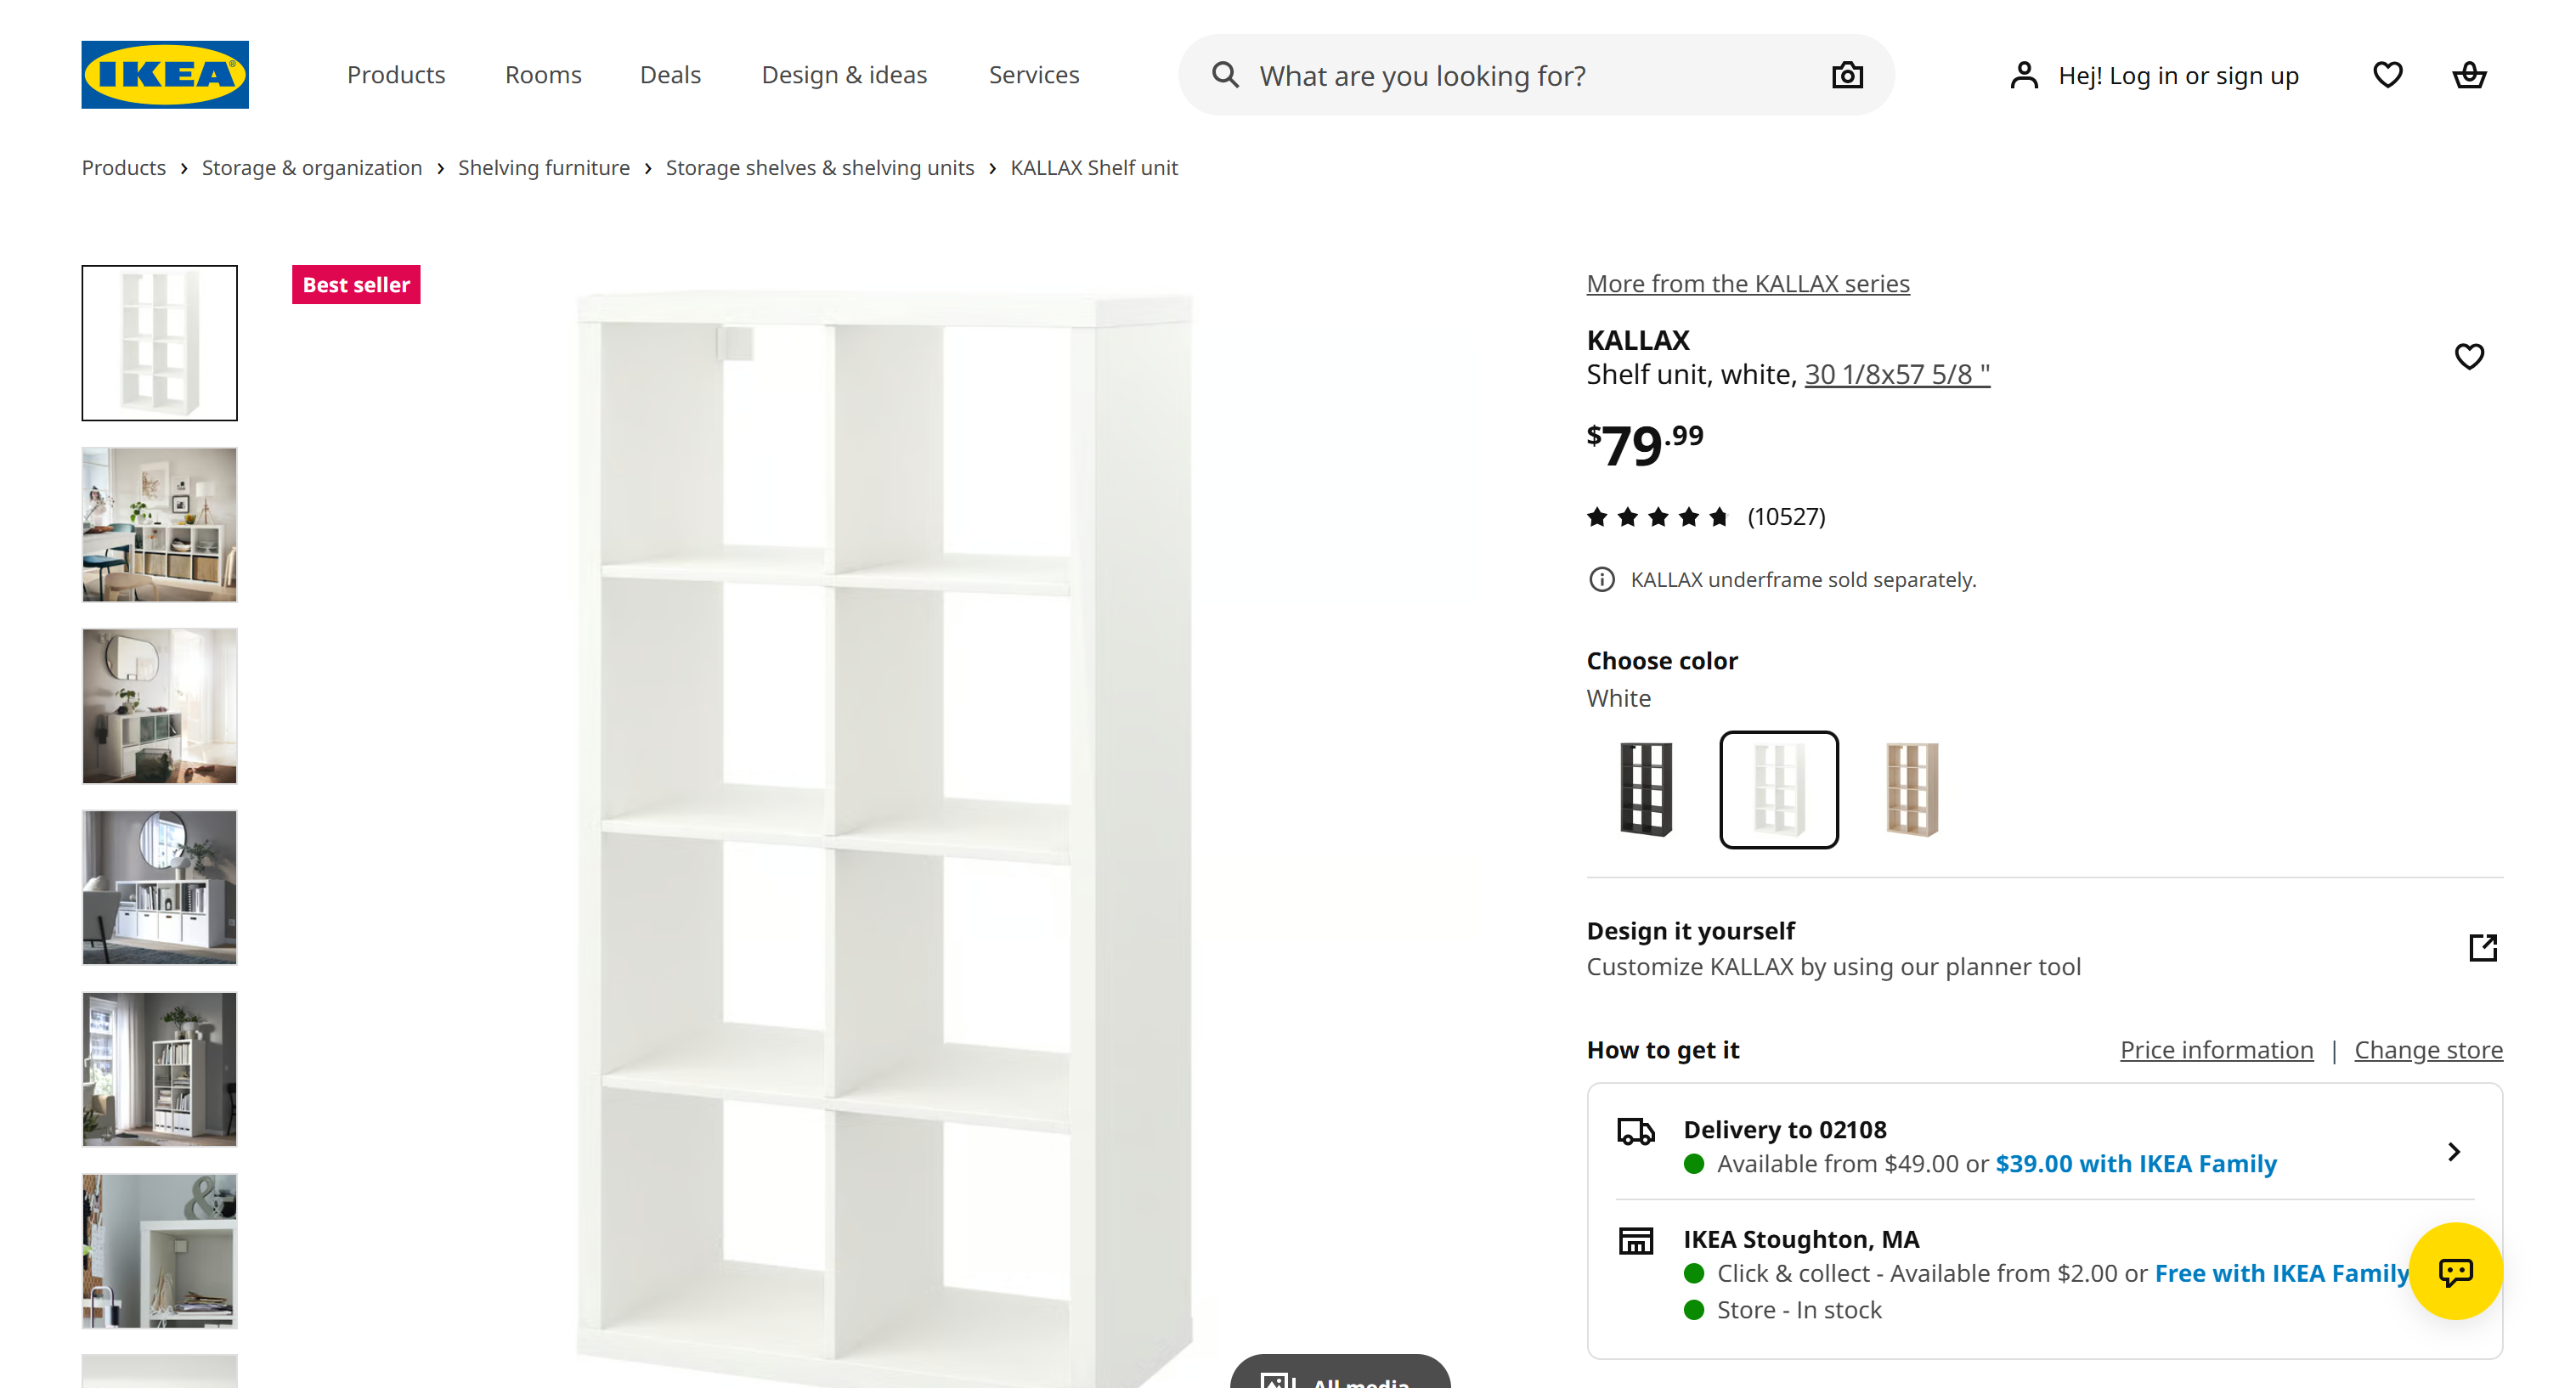
A principal vantagem do parsing de dados baseado em IA é que o mesmo código pode ser aplicado em todas as páginas de produtos da IKEA. Isso é verdade independentemente de seus layouts individuais ou variações de design.
O fluxo de trabalho será:
- A API Web Unlocker da Bright Data recupera a página de produto IKEA alvo e retorna seu conteúdo como Markdown otimizado para LLMs.
- O GLM-5.3 recebe o conteúdo Markdown através da API Z.ai compatível com OpenAI e extrai as informações do produto.
- A saída resultante, que está em conformidade com um esquema JSON predefinido, é exportada para o disco.
Nota: Para sistemas de produção que requerem dados estruturados de produtos IKEA em escala, considere usar a API Scraper IKEA da Bright Data.
Siga as instruções abaixo!
Pré-requisitos
Certifique-se da disponibilidade de:
- Python 3.10 ou posterior instalado no seu sistema.
- Uma conta GLM com saldo e uma chave de API configurada.
- Uma conta Bright Data com uma API Web Unlocker e uma chave de API configuradas.
– Consulte a documentação de configuração do Web Unlocker.
– Siga o guia oficial para recuperar sua chave de API da Bright Data.
Ao longo deste guia, assumiremos que o nome da sua zona da API Web Unlocker é web_unlocker:
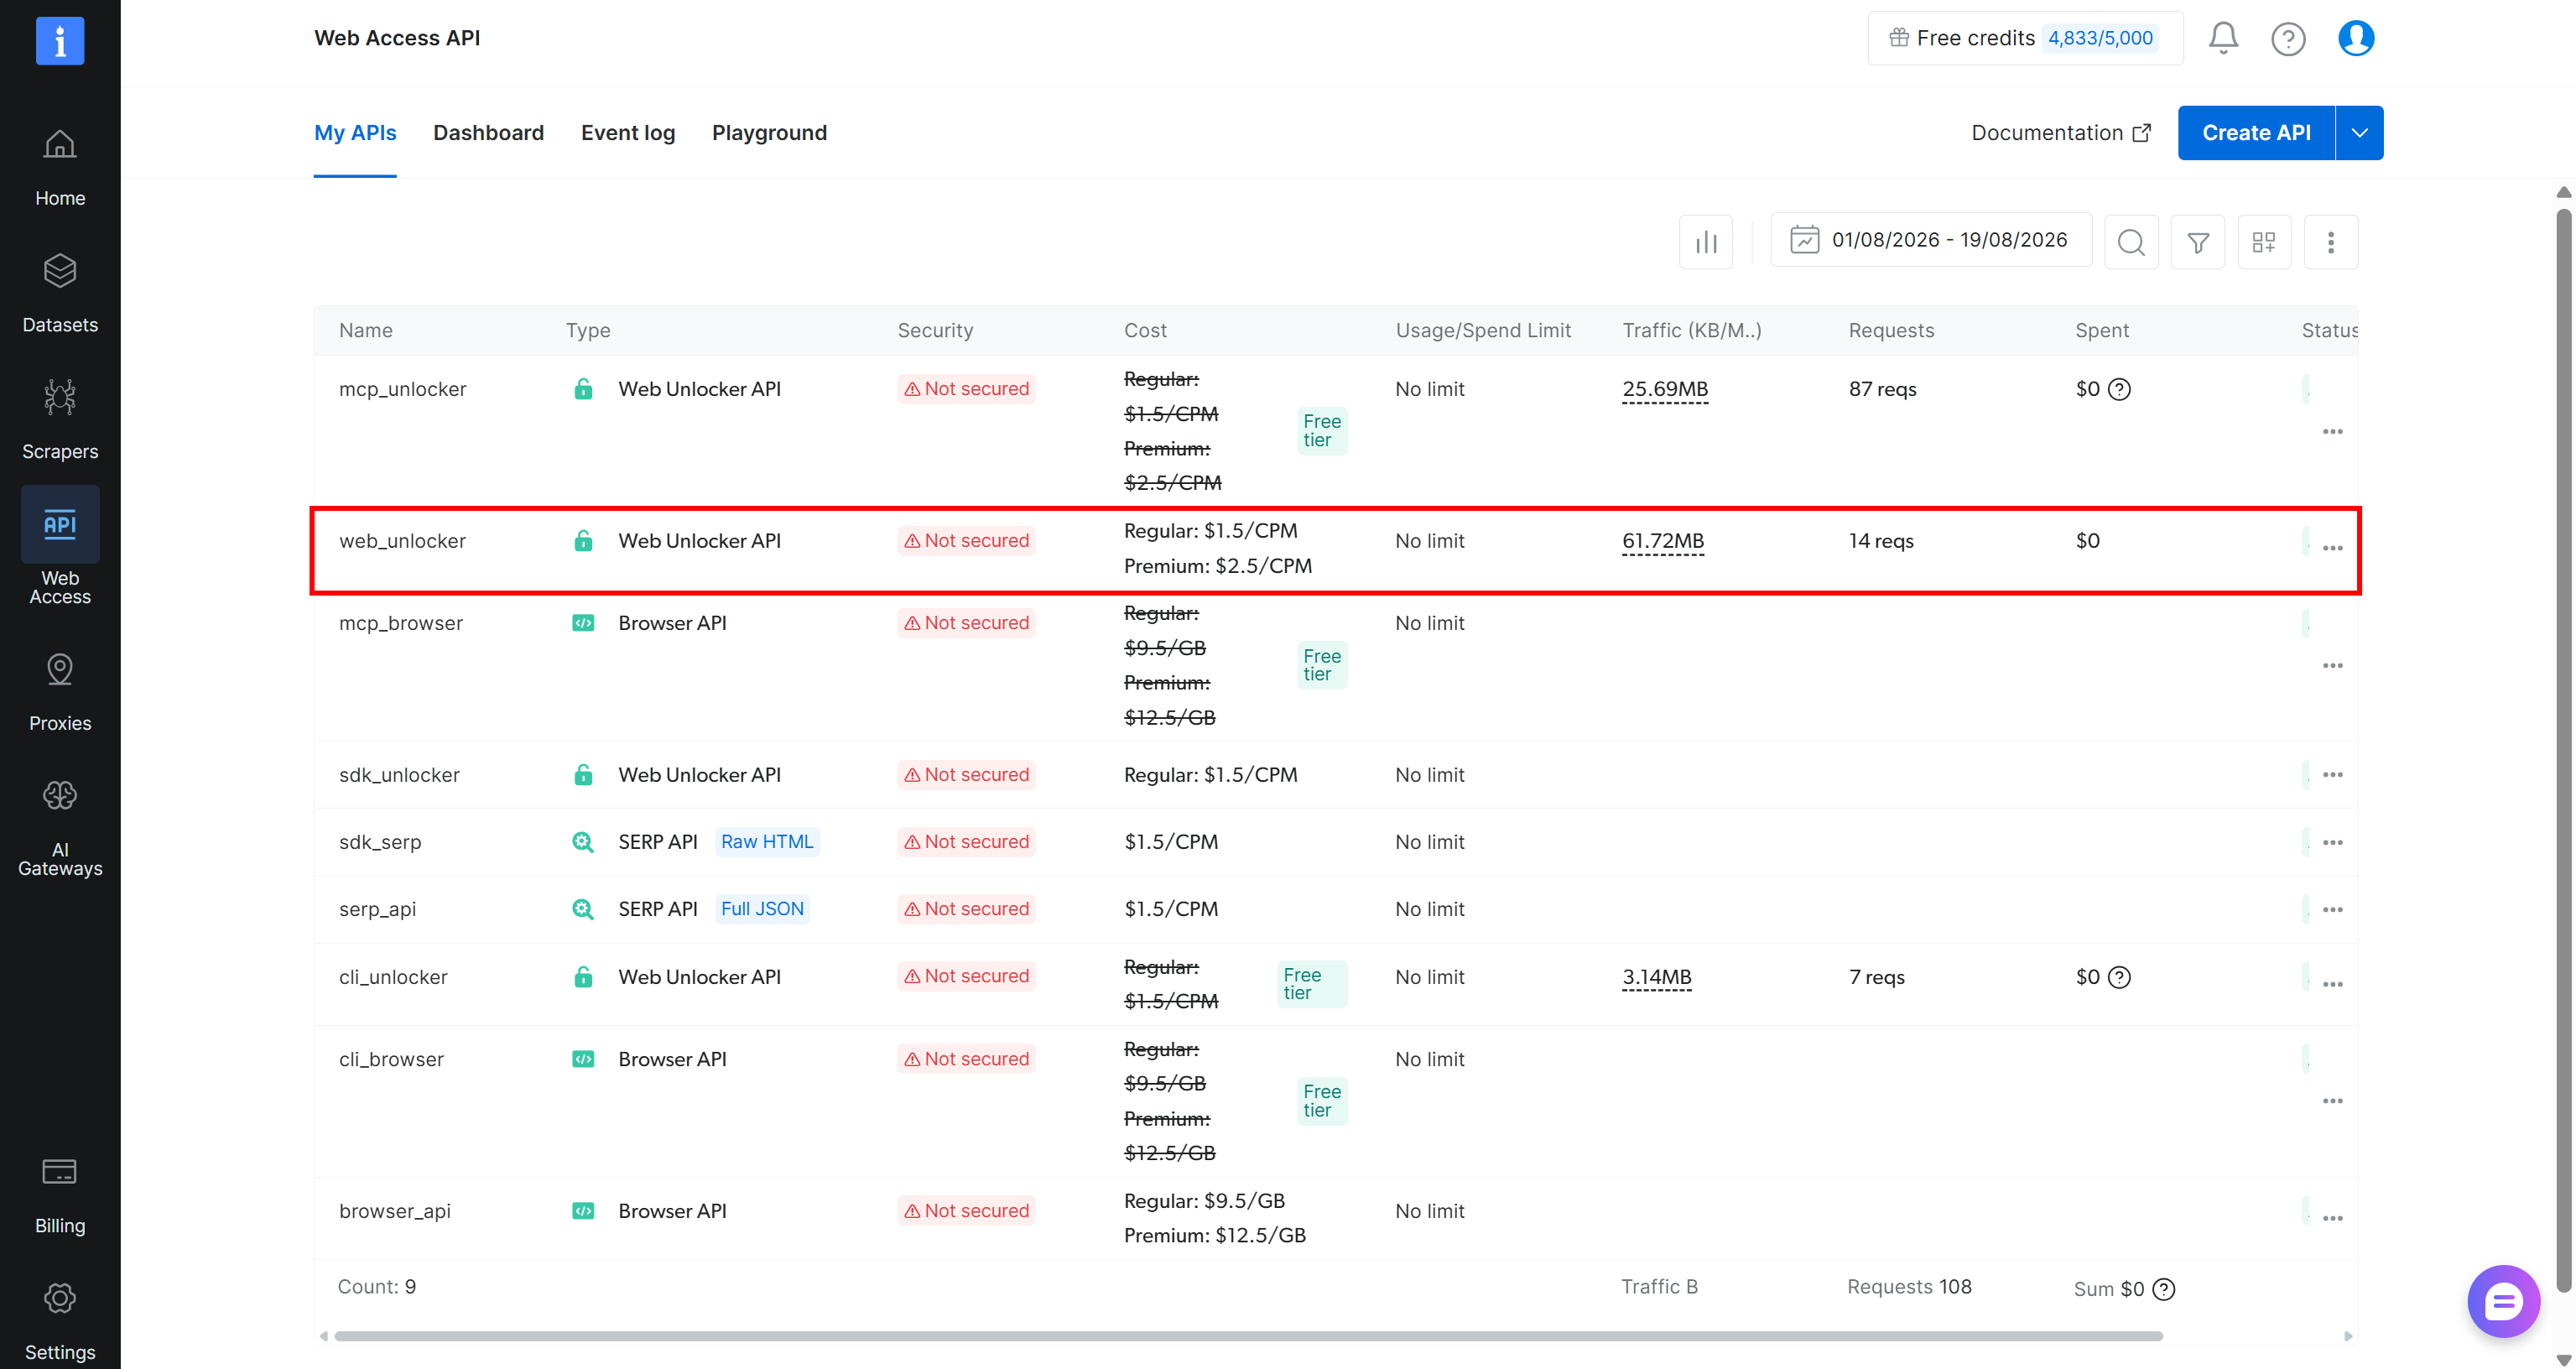
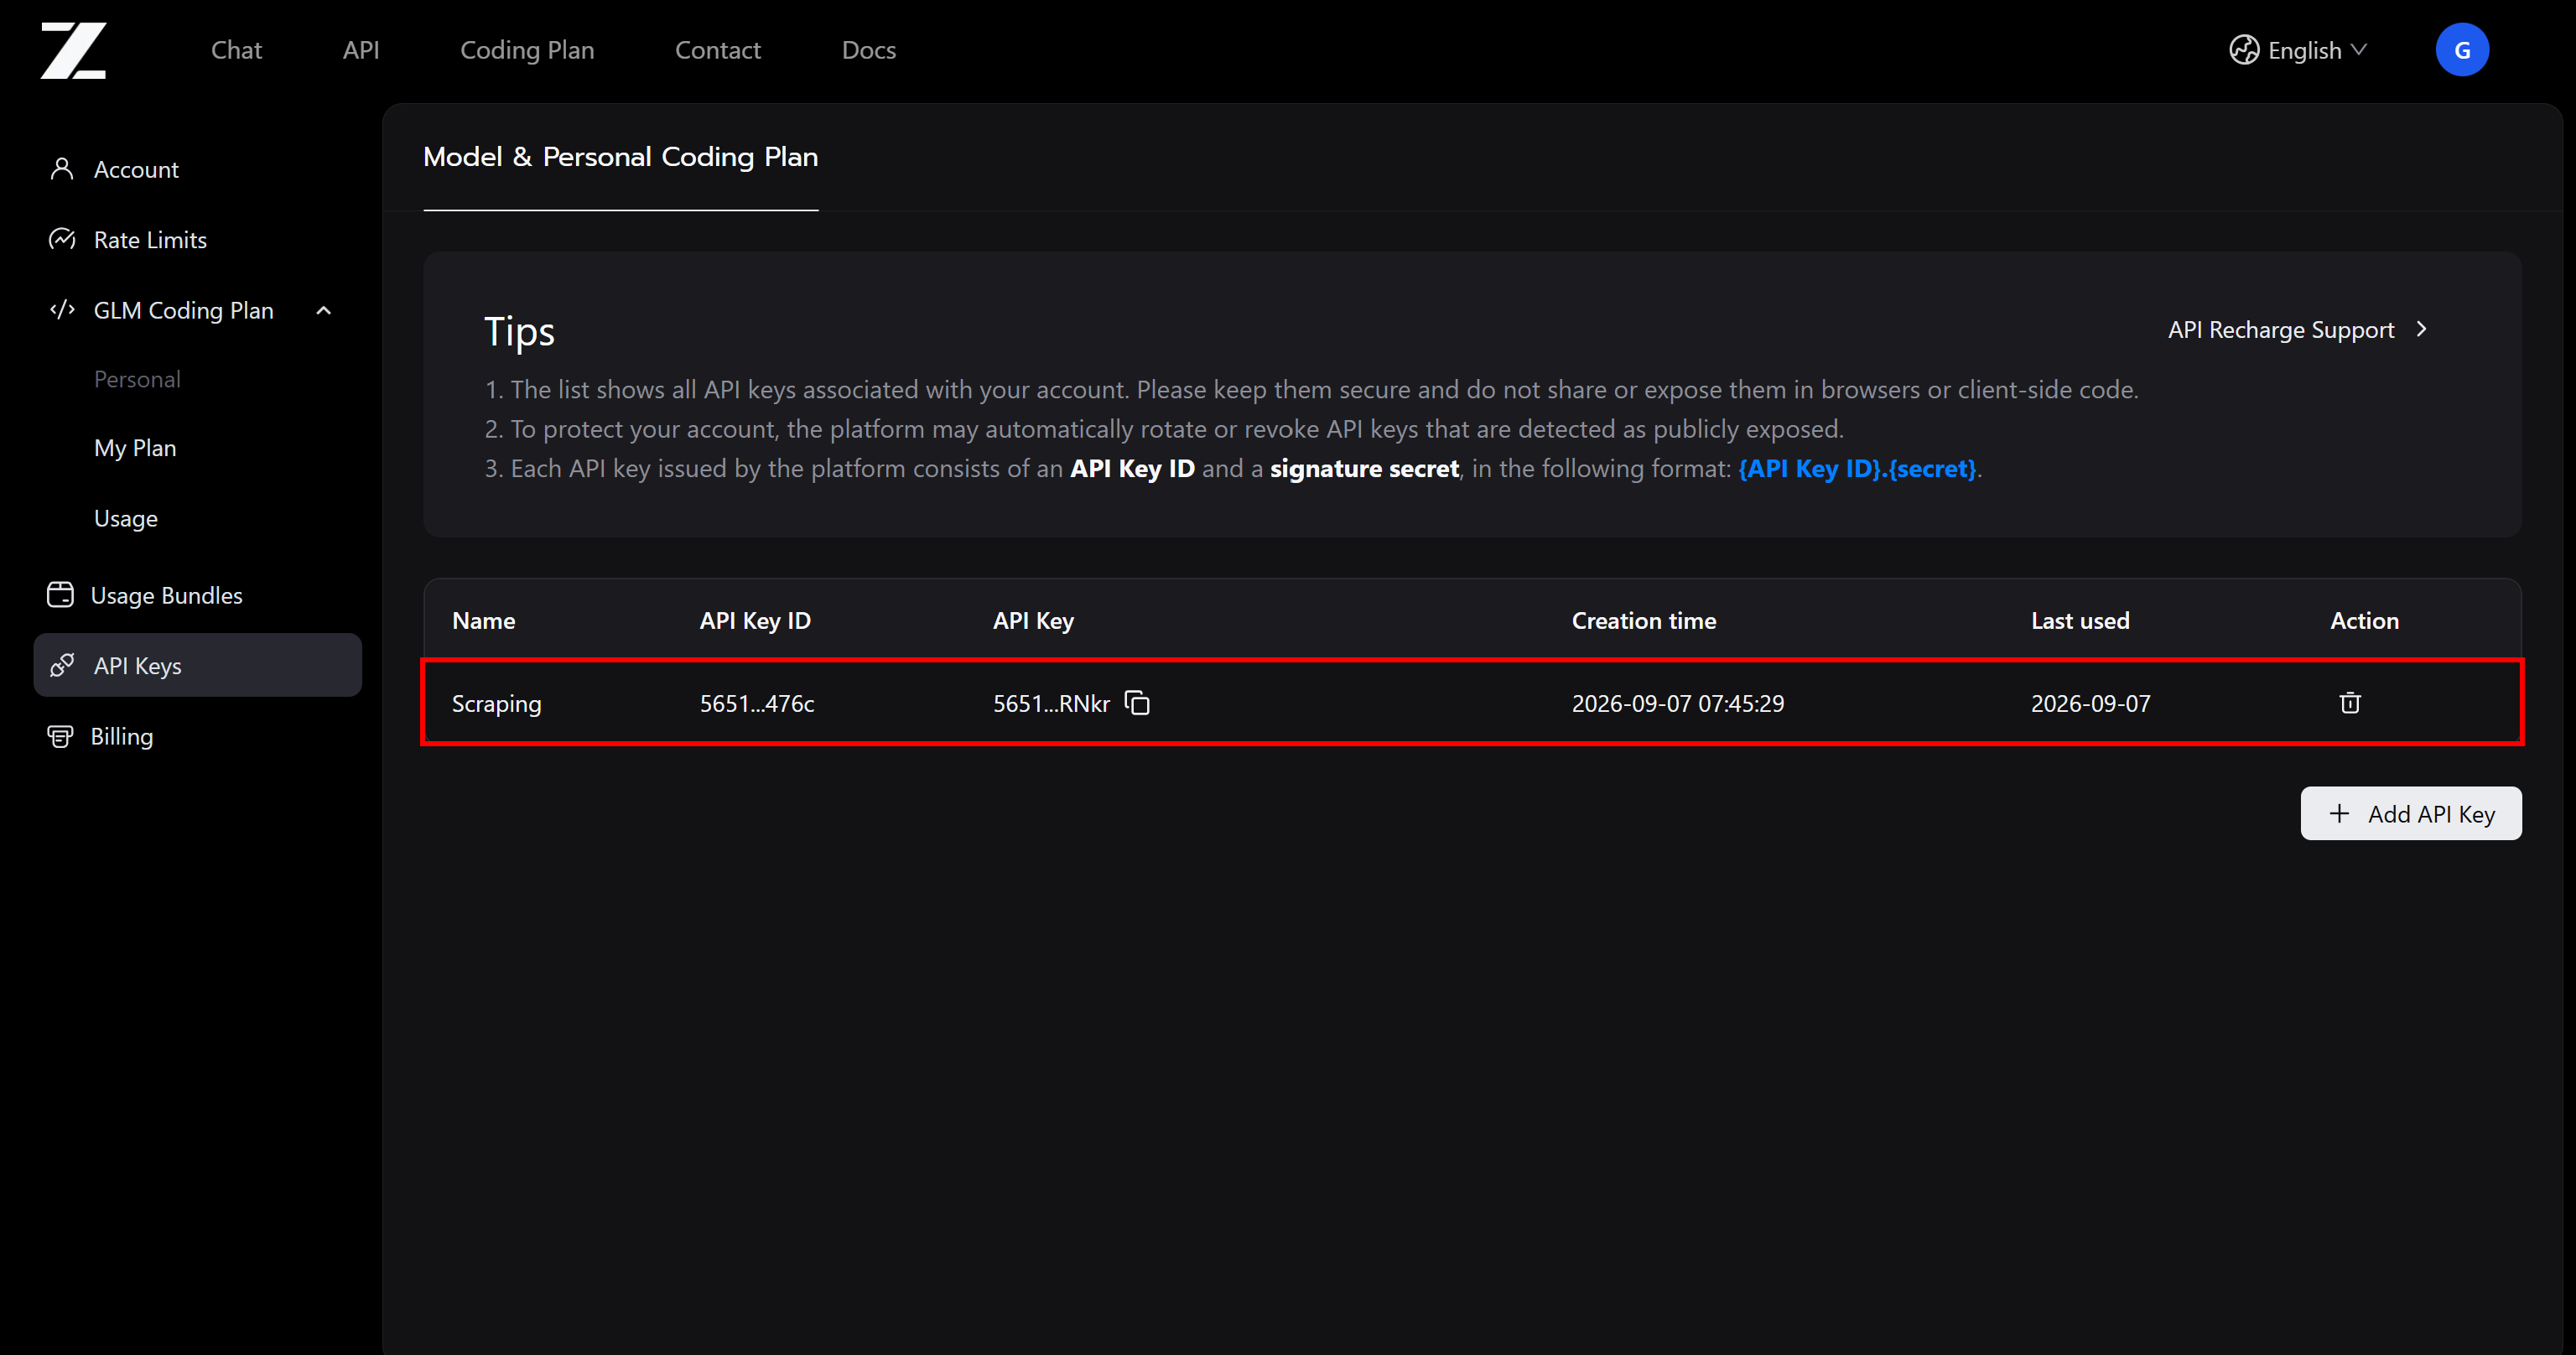
Além disso, sua chave de API Z.ai terá esta aparência:
Passo #1: Inicializar um Projeto Python
Crie um novo diretório para seu projeto de scraping com GLM:
mkdir glm-scraperAcesse este diretório e adicione um ambiente virtual Python dentro dele:
cd glm-scraper
python -m venv .venv
Carregue o diretório do projeto no seu editor Python preferido, como Visual Studio Code ou PyCharm.
Na raiz do projeto, adicione um arquivo scraper.py:
glm-scraper
├─── .venv/
└─── scraper.py # <-----
Este arquivo conterá o código Python para extração de dados com IA usando modelos GLM.
Em seguida, ative o ambiente virtual. Em sistemas Linux ou macOS, execute:
source .venv/bin/activateEm plataformas Windows, execute:
.venv\Scripts\activateCom a ativação concluída, instale todas as dependências necessárias do projeto:
pip install dotenv requests openai pydanticOs pacotes necessários são:
dotenv: Gerenciamento de variáveis de ambiente para armazenar chaves de API.requests: Cliente HTTP para comunicação com a API Web Unlocker da Bright Data.openai: Cliente compatível com OpenAI para acessar as APIs Z.ai compatíveis com OpenAI para acesso ao GLM.pydantic: Framework de definição e validação de modelos de dados para o esquema de saída.
Muito bem! Seu projeto Python está pronto para scraping de dados com GLM.
Passo #2: Adicionar Leitura de Variáveis de Ambiente
Seu scraper GLM requer autenticação com serviços externos, incluindo as APIs da Bright Data e da Z.ai. Essas integrações exigem chaves de API, que você nunca deve expor no código-fonte por razões de segurança.
Em vez disso, mantenha suas chaves de API em um arquivo de configuração de ambiente e carregue-as durante a execução. O pacote python-dotenv simplifica esse processo, permitindo que você leia variáveis de ambiente de um arquivo .env.
Para começar com o python-dotenv, adicione este código ao início do scraper.py:
from dotenv import load_dotenv

# Load the environment variables from the .env file
load_dotenv()
Em seguida, crie um arquivo .env na raiz do projeto:
glm-scraper
├─── .venv/
├─── .env       # <-----
└─── scraper.pyDica: Em um repositório real, inclua .env na sua configuração .gitignore para evitar exposição acidental de credenciais.
Preencha-o com suas credenciais de API:
BRIGHT_DATA_API_KEY="<YOUR_BRIGHT_DATA_API_KEY>"
ZAI_API_KEY="<YOUR_ZAI_API_KEY>"
Substitua:
<YOUR_BRIGHT_DATA_API_KEY>pelas suas credenciais de API da Bright Data.<YOUR_ZAI_API_KEY>pela sua chave de API Z.ai.
Em seguida, carregue essas variáveis de ambiente no seu script usando o os.getenv() do Python:
import os

# Loading the required secrets from the envs
ZAI_API_KEY = os.environ.get("ZAI_API_KEY")
BRIGHT_DATA_API_KEY = os.environ.get("BRIGHT_DATA_API_KEY")
Fantástico! Agora você tem acesso seguro às suas chaves de API no script Python.
Passo #3: Obter a Página Web Alvo em Formato Markdown com a API Web Unlocker
A primeira fase do scraping com IA envolve obter a página alvo, idealmente em formato Markdown pronto para LLMs. A API Web Unlocker da Bright Data fornece a maneira mais simples de realizar isso.
Para mais orientações sobre integração do Web Unlocker, consulte a documentação oficial ou examine os exemplos de integração Python da Bright Data.
Utilize a biblioteca requests para enviar uma requisição HTTP POST ao Web Unlocker e recuperar a página alvo renderizada como Markdown:
import requests

# Set up the authentication headers for Web Unlocker
headers = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {BRIGHT_DATA_API_KEY}"
}

# Define the request payload for the Web Unlocker API call
payload = {
    "zone": "web_unlocker", # Replace with your Web Unlocker zone name
    "url": "https://www.ikea.com/us/en/p/kallax-shelf-unit-white-20631663/", # The IKEA product page URL you want to scrape
    "format": "raw",
    "country": "us",
    "data_format": "markdown" # Request Markdown-formatted output
}

# Retrieve the unlocked content of the target page
web_unlocker_response = requests.post(
    "https://api.brightdata.com/request",
    json=payload,
    headers=headers
)
markdown_page = web_unlocker_response.text
Se você não está familiarizado com a sintaxe HTTP do Python, consulte nosso guia completo sobre Requests.
Observe o parâmetro data_format="markdown" no corpo. Esta configuração direciona a API Web Unlocker a retornar a página da web em formato Markdown em vez de fornecer HTML bruto.
Imprima markdown_page e você verá:
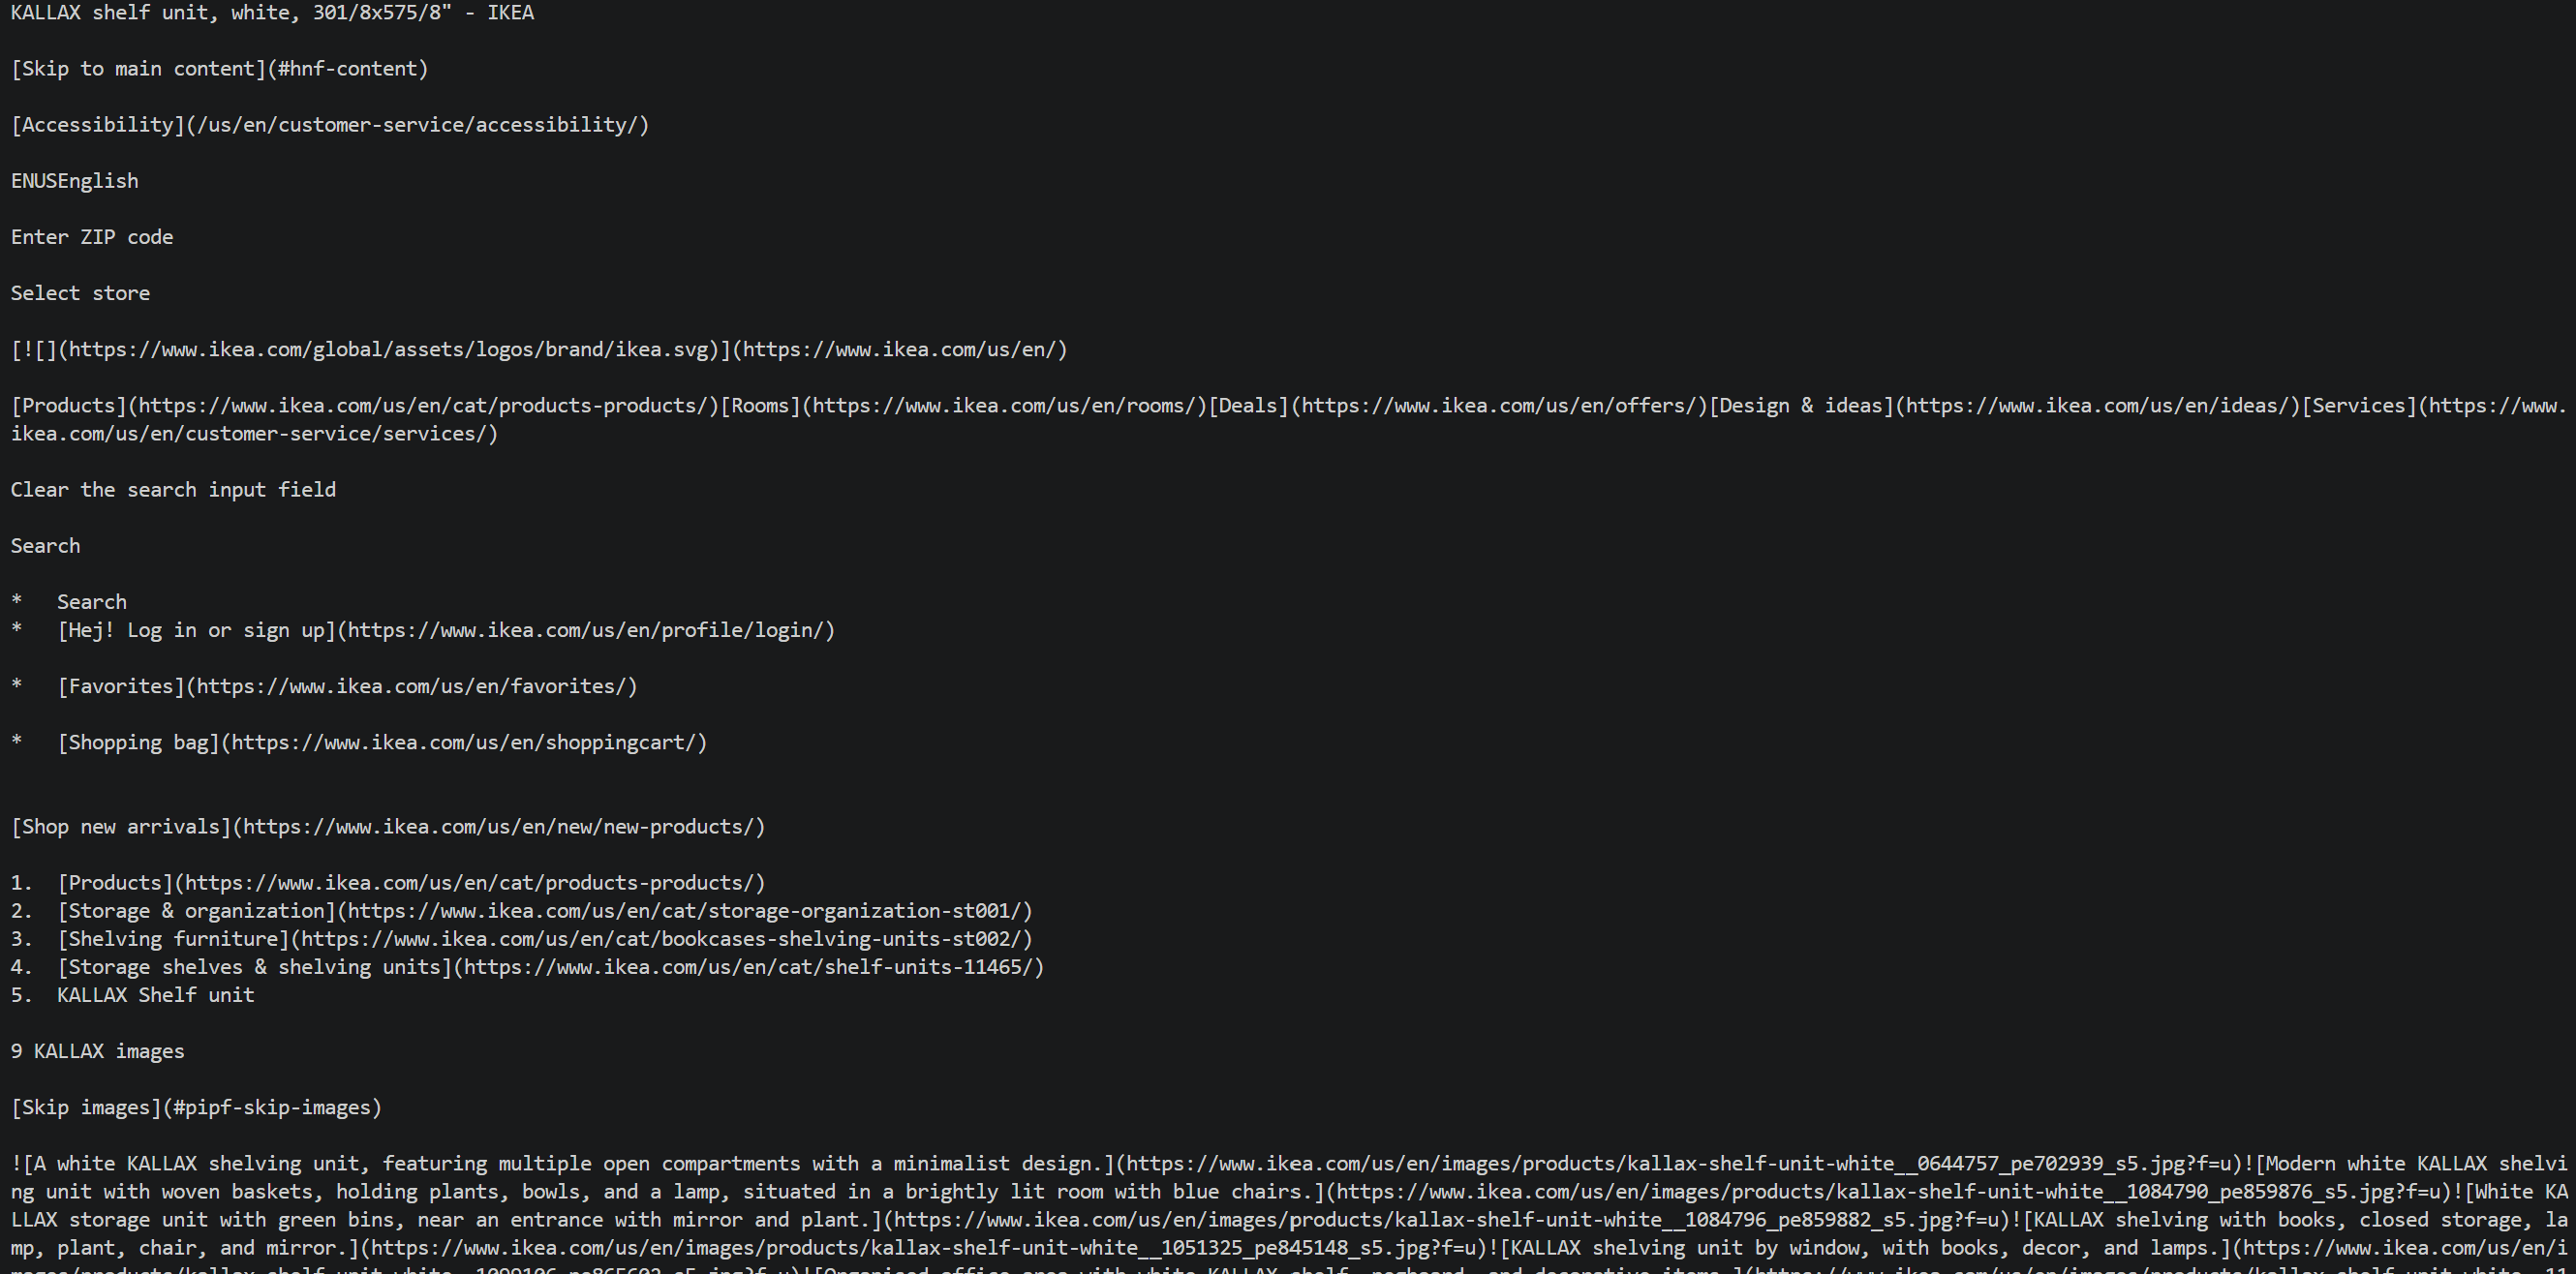
A saída retornada representa a versão convertida em Markdown da sua página de produto IKEA alvo.
Observe como a API Web Unlocker cuida dos obstáculos de recuperação de páginas da web:
- Acessando a infraestrutura IKEA alvo através da rede de proxies residenciais da Bright Data.
- Gerenciando contramedidas anti-bot típicas, como os sistemas anti-scraping da IKEA.
- Obtendo a marcação da página completamente renderizada.
- Transformando o HTML em Markdown otimizado para LLMs e retornando o resultado.
Agora você tem informações da página em um formato perfeito para parsing de dados baseado em texto com GLM-5.3. Antes de prosseguir, estabeleça a estrutura de saída que o GLM irá gerar!
Passo #4: Definir o Esquema JSON de Saída
O GLM-5.3, como a maioria dos outros LLMs, produz saída de texto por padrão. Isso é subótimo para fluxos de trabalho de extração de dados, onde o objetivo é converter conteúdo web bruto em dados estruturados.
Felizmente, a API do GLM-5.3 suporta saída estruturada através do modo JSON. Essa funcionalidade permite que o modelo retorne uma string JSON simples.
Nota: Embora você não possa especificar o esquema diretamente no argumento json_schema como é possível com as saídas estruturadas da OpenAI, você pode mencionar a estrutura de resposta desejada no prompt. Isso obrigará o modelo a produzir uma string JSON que está em conformidade com esse formato.
O método mais conveniente para definir esquemas JSON estruturados em Python é através do Pydantic, o framework de modelagem de dados mais popular. O Pydantic ajuda você a representar estruturas de dados via classes Python, que podem ser convertidas em formato JSON Schema para a API Z.ai.
Comece examinando a página IKEA alvo para identificar os campos de informação necessários. Para este exemplo, defina um modelo Pydantic capturando detalhes do produto IKEA:
from pydantic import BaseModel, Field
from typing import List, Optional

class IkeaProduct(BaseModel):
    title: Optional[str] = Field(None, description="Full product title as displayed on the IKEA website")
    product_number: Optional[str] = Field(None, description="IKEA product article number, such as 304.247.75")
    product_type: Optional[str] = Field(None, description="General type of IKEA product, such as armchair, shelf unit, cabinet, or table")
    price: Optional[float] = Field(None, description="Current one-time purchase price")
    currency: Optional[str] = Field(None, description="Currency used for the displayed price, such as USD")
    color: Optional[str] = Field(None, description="Product color or finish, such as birch veneer or dark gray")
    dimensions: Optional[str] = Field(None, description="Overall product dimensions as displayed by IKEA, including width, depth, and height")
    materials: Optional[List[str]] = Field(None, description="Main materials used to manufacture the product")
    rating: Optional[float] = Field(None, description="Average customer rating, typically on a 5-point scale")
    review_count: Optional[int] = Field(None, description="Total number of customer reviews")
    series: Optional[str] = Field(None, description="IKEA product series the item belongs to, such as POÄNG")
    assembly_required: Optional[bool] = Field(None, description="Whether the product requires assembly")
    is_in_stock: Optional[bool] = Field(True, description="Whether the product is currently available for purchase")
Este modelo organiza as informações do produto IKEA em campos Pydantic com tipagem explícita. O GLM-5.3 recuperará os valores correspondentes do conteúdo da página e os entregará como uma resposta em string JSON respeitando este esquema.
Dica profissional: Passe o Markdown recuperado da página pela API Web Unlocker para um LLM e peça para ele gerar um modelo Pydantic contendo todos os pontos de dados em que você está interessado.
Excelente! Agora você possui todos os componentes necessários para scraping de dados com GLM.
Passo #5: Usar o GLM-5.3 para Parsing Automatizado de Dados
A API Z.ai é compatível com as interfaces OpenAI Chat Completions e Responses, permitindo acesso via SDK Python da OpenAI. Configure o cliente OpenAI com suas credenciais de API Z.ai e a URL base da API apropriada.
from openai import OpenAI

# Initialize the OpenAI client for interacting with Z.ai API
glm_client = OpenAI(
    api_key=ZAI_API_KEY,
    base_url="https://api.z.ai/api/paas/v4/", # OpenAI Chat Completions-compatible GLMM API base URL
)
Em seguida, utilize o endpoint Chat Completions para transmitir o Markdown extraído ao GLM-5.3:
import json

# Prepare the scraping prompt with the output schema
scraping_prompt = f"""
Extract the IKEA product information from the given Markdown document and
return it as structured data that conforms to the provided JSON schema.

SCHEMA:
{json.dumps(IkeaProduct.model_json_schema(), indent=2)}

MARKDOWN:
{markdown_page}
"""

# Perform web data parsing with GLM-5.3
response = glm_client.chat.completions.create(
    model="glm-5.3",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": scraping_prompt,
                },
            ],
        }
    ],
    response_format={"type": "json_object"}
)

# Get the parsed data in a string matching the defined schema format
product_data = response.choices[0].message.content
Observe que o prompt precisa incluir:
- Suas instruções de extração de dados da web.
- O esquema JSON alvo.
- O conteúdo Markdown da API Web Unlocker da Bright Data.
O parâmetro response_format ativa o modo JSON com {"type": "json_object"}. Lembre-se que o GLM-5.3 suporta o formato json_object em vez de json_schema. Essa é uma distinção crítica em relação a alguns modelos alternativos, como ao realizar scraping de dados com Kimi.
Nota: Os parâmetros opcionais thinking e reasoning_effort ativam as capacidades de raciocínio estendido do GLM-5.3. Defina reasoning_effort como "max" para habilitar raciocínio profundo em tarefas de parsing de dados altamente complexas. Isso é particularmente valioso quando as páginas contêm layouts ambíguos ou não padronizados.
O resultado é product_data, contendo uma string JSON com as informações extraídas estruturadas de acordo com seu modelo IkeaProduct. Imprima-o e você verá:
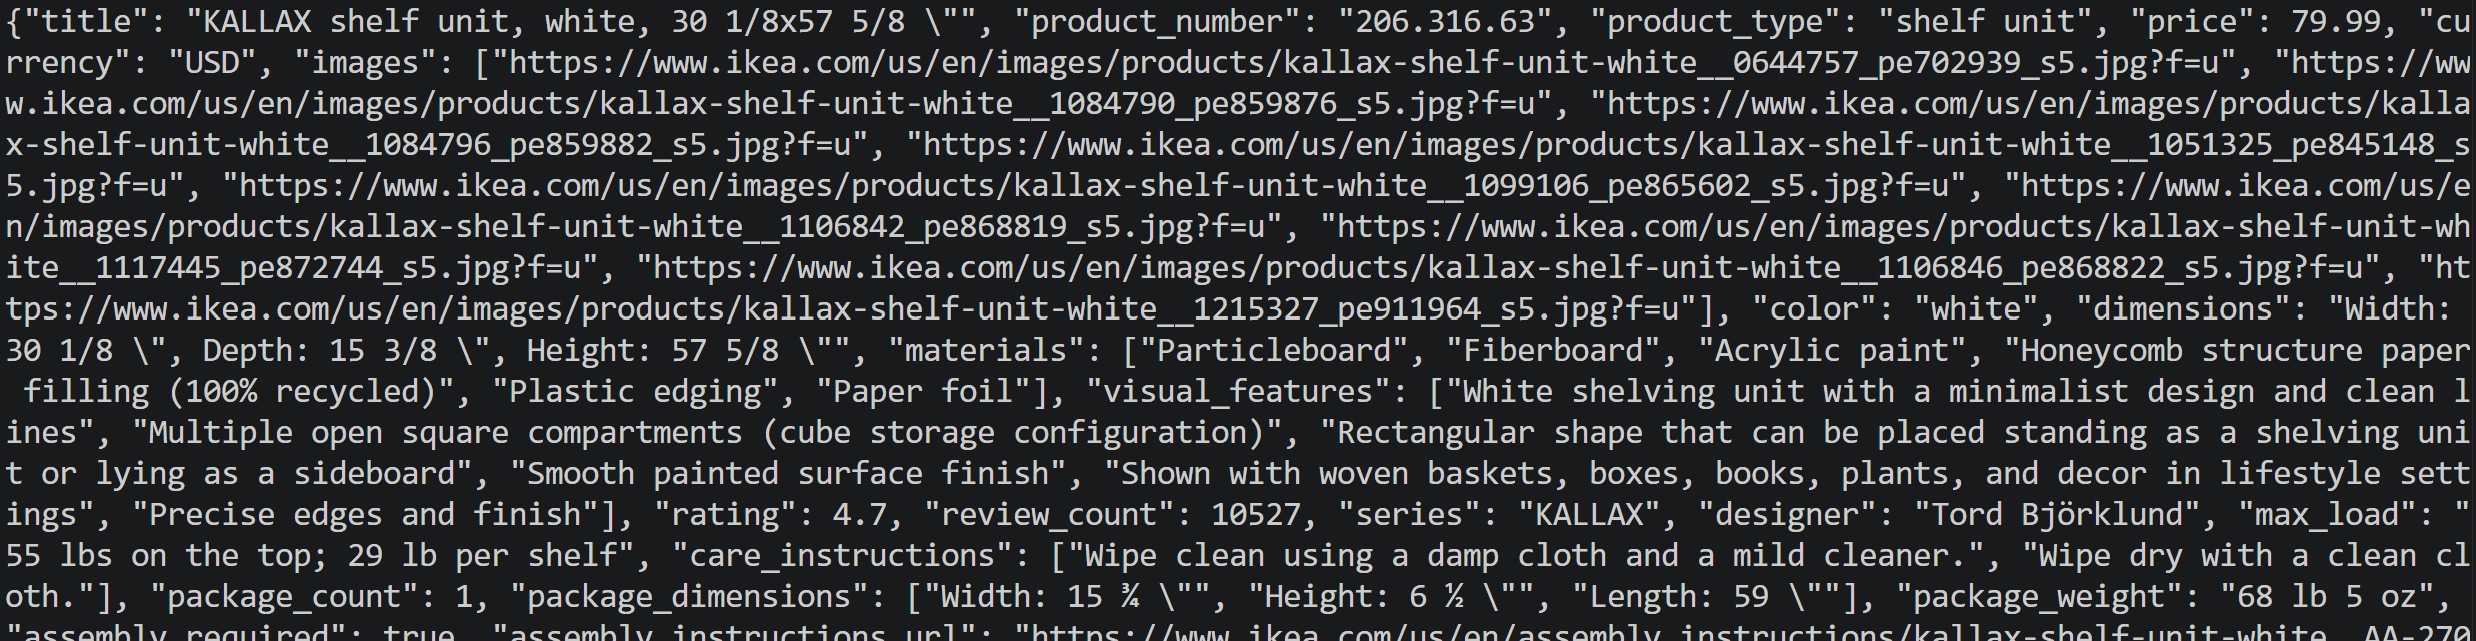
Ótimo! O único passo restante é persistir esses dados JSON no disco.
Passo #6: Salvar os Dados Coletados no Disco
Antes de armazenar product_data em um arquivo product.json, valide a resposta contra o modelo Pydantic IkeaProduct:
# Get the parsed data in the defined schema format
product_data = response.choices[0].message.content

# Validate the JSON string against the IkeaProduct schema
product = IkeaProduct.model_validate_json(product_data)
O método model_validate_json() verifica se a resposta do LLM está em conformidade com o esquema Pydantic esperado. Se a resposta contiver dados inválidos ou não corresponder aos tipos de campo definidos, o Pydantic lança um erro de validação em vez de salvar silenciosamente dados malformados.
Em seguida, persista-o no disco:
# Export the validated IkeaProduct object to a JSON file
with open("product.json", "w", encoding="utf-8") as f:
    f.write(product.model_dump_json(indent=2))
Este trecho usa product.model_dump_json() para serializar o objeto IkeaProduct validado e depois o grava em product.json. O arquivo resultante conterá os dados estruturados do produto IKEA extraídos pelo GLM-5.3. Missão cumprida!
Passo #7: Unir Tudo
Abaixo está a implementação completa do seu scraper de dados GLM para páginas de produtos IKEA:
# pip install dotenv requests openai pydantic

from dotenv import load_dotenv
import os
import requests
from pydantic import BaseModel, Field
from typing import List, Optional
from openai import OpenAI
import json

# Load the environment variables from the .env file
load_dotenv()

# Loading the required secrets from the envs
BRIGHT_DATA_API_KEY = os.environ.get("BRIGHT_DATA_API_KEY")
ZAI_API_KEY = os.environ.get("ZAI_API_KEY")

# The output schema for the product information
class IkeaProduct(BaseModel):
    title: Optional[str] = Field(None, description="Full product title as displayed on the IKEA website")
    product_number: Optional[str] = Field(None, description="IKEA product article number, such as 304.247.75")
    product_type: Optional[str] = Field(None, description="General type of IKEA product, such as armchair, shelf unit, cabinet, or table")
    price: Optional[float] = Field(None, description="Current one-time purchase price")
    currency: Optional[str] = Field(None, description="Currency used for the displayed price, such as USD")
    images: Optional[List[str]] = Field(None, description="URLs of product images from the IKEA website")
    color: Optional[str] = Field(None, description="Product color or finish, such as birch veneer or dark gray")
    dimensions: Optional[str] = Field(None, description="Overall product dimensions as displayed by IKEA, including width, depth, and height")
    materials: Optional[List[str]] = Field(None, description="Main materials used to manufacture the product")
    visual_features: Optional[List[str]] = Field(None, description="Physical characteristics visible in the supplied product images, such as shape, components, finish, or configuration")
    rating: Optional[float] = Field(None, description="Average customer rating, typically on a 5-point scale")
    review_count: Optional[int] = Field(None, description="Total number of customer reviews")
    series: Optional[str] = Field(None, description="IKEA product series the item belongs to, such as POÄNG")
    designer: Optional[str] = Field(None, description="Designer credited by IKEA for the product")
    max_load: Optional[str] = Field(None, description="Maximum supported load, such as maximum load on a seat, shelf, or tabletop")
    care_instructions: Optional[List[str]] = Field(None, description="IKEA-recommended care and cleaning instructions")
    package_count: Optional[int] = Field(None, description="Number of packages included with the product")
    package_dimensions: Optional[List[str]] = Field(None, description="Dimensions of the product packaging")
    package_weight: Optional[str] = Field(None, description="Weight of the packaged product")
    assembly_required: Optional[bool] = Field(None, description="Whether the product requires assembly")
    assembly_instructions_url: Optional[str] = Field(None, description="URL to the official IKEA assembly instructions")
    safety_information: Optional[List[str]] = Field(None, description="Important safety information, such as wall anchoring or tipping requirements")
    good_to_know: Optional[List[str]] = Field(None, description="Additional IKEA product information and usage recommendations")
    compatible_series: Optional[List[str]] = Field(None, description="IKEA product series or furniture lines that the product is described as coordinating with")
    accessories: Optional[List[str]] = Field(None, description="Accessories or complementary IKEA products shown or recommended on the product page")
    category_path: Optional[List[str]] = Field(None, description="IKEA category breadcrumb path leading to the product")
    available_colors: Optional[List[str]] = Field(None, description="Other color or finish options available for the same product")
    is_in_stock: Optional[bool] = Field(True, description="Whether the product is currently available for purchase")

# Set up the authentication headers for the Web Unlocker API
headers = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {BRIGHT_DATA_API_KEY}"
}

# Define the request payload for the Web Unlocker API scraping request
payload = {
    "zone": "web_unlocker", # Replace with your Web Unlocker zone name
    "url": "https://www.ikea.com/us/en/p/kallax-shelf-unit-white-20631663/", # The IKEA product page URL you want to scrape
    "format": "raw",
    "country": "us",
    "data_format": "markdown" # To get the web page in Markdown
}

# Retrieve the Markdown content of the unlocked target page
web_unlocker_response = requests.post(
    "https://api.brightdata.com/request",
    json=payload,
    headers=headers
)
markdown_page = web_unlocker_response.text

# Initialize the OpenAI client for Z.ai models
glm_client = OpenAI(
    api_key=ZAI_API_KEY,
    base_url="https://api.z.ai/api/paas/v4/",
)

# Prompt to LLM-powered web data parsing
scraping_prompt = f"""
Extract the IKEA product information from the given Markdown document and
return it as structured data that conforms to the provided JSON schema.

SCHEMA:
{json.dumps(IkeaProduct.model_json_schema(), indent=2)}

MARKDOWN:
{markdown_page}
"""

# Perform web data scraping with GLM-5.3
response = glm_client.chat.completions.create(
    model="glm-5.3",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": scraping_prompt,
                },
            ],
        }
    ],
    response_format={"type": "json_object"},
)

# Get the parsed data in the defined schema format
product_data = response.choices[0].message.content

# Convert the JSON string into a validated IkeaProduct object
product = IkeaProduct.model_validate_json(product_data)

# Export the IkeaProduct object to a JSON file
with open("product.json", "w", encoding="utf-8") as f:
    f.write(product.model_dump_json(indent=2))
No seu ambiente virtual ativado, execute o script Python usando:
python scraper.pyA recuperação da página via API Web Unlocker e o processamento subsequente pelo GLM-5.3 levam tempo. Portanto, seja paciente enquanto o arquivo product.json é produzido.
Quando ele aparecer na pasta do seu projeto, abra-o e você verá:
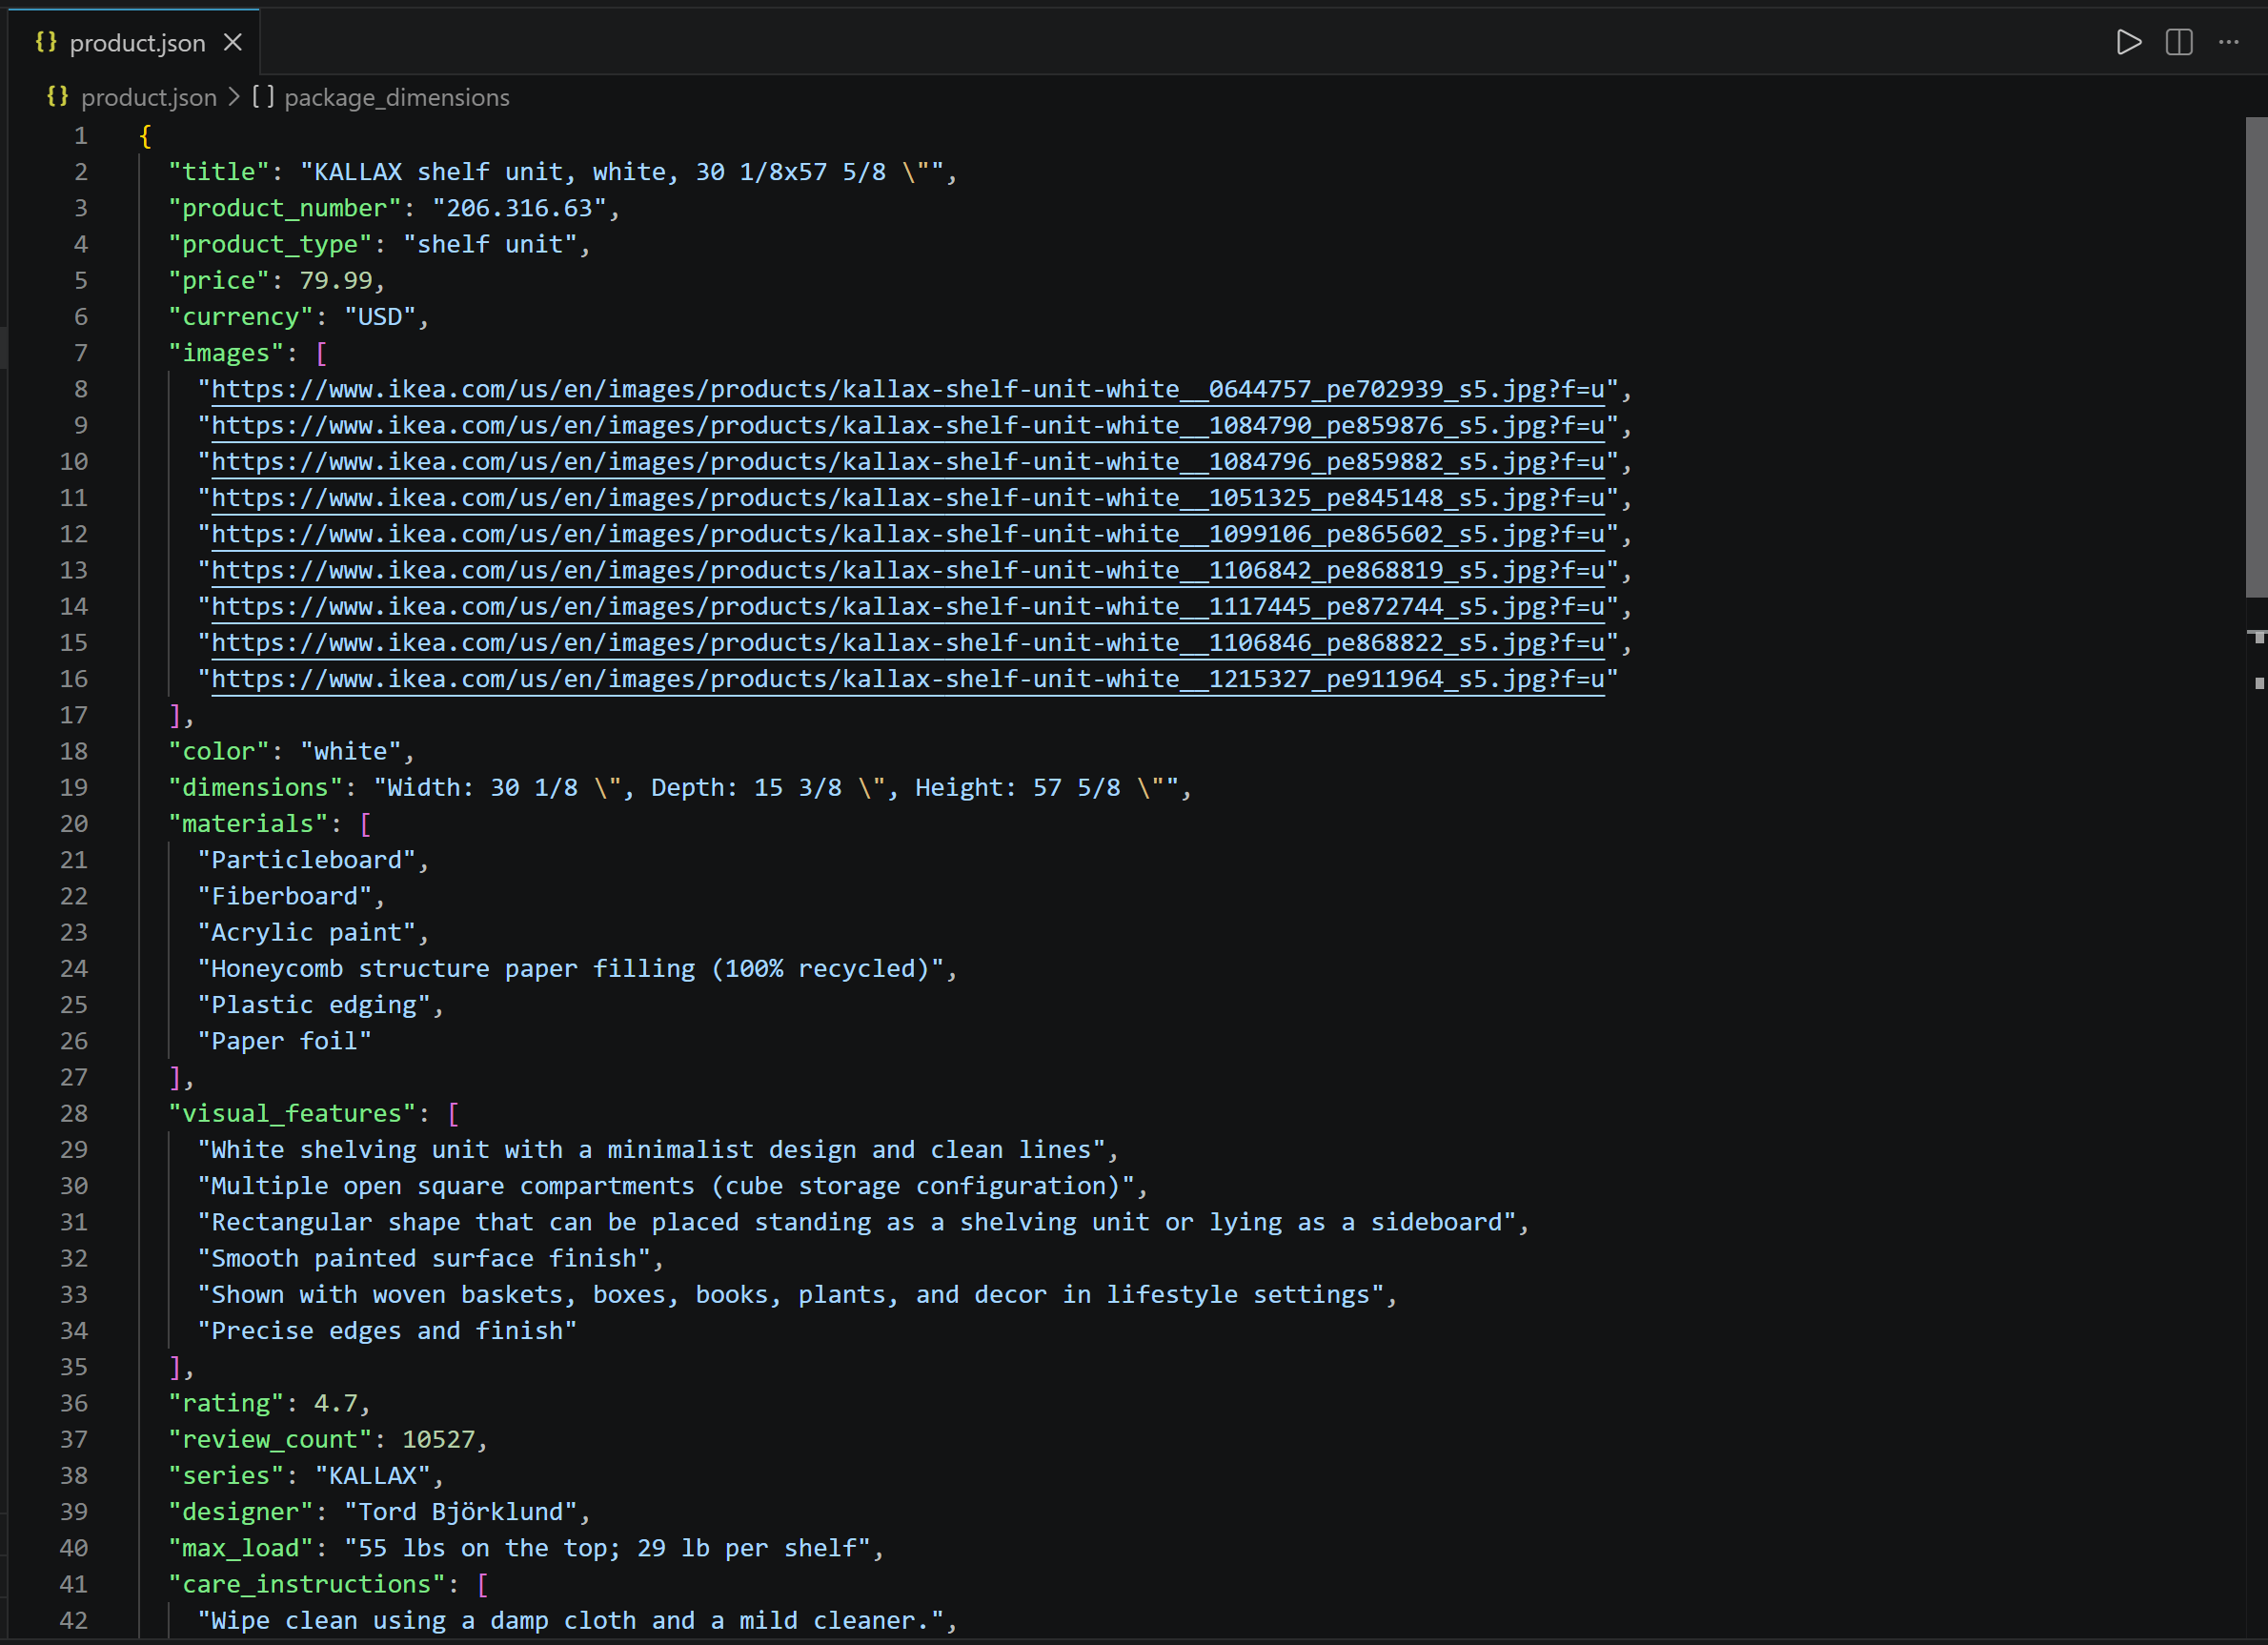
Observe o alinhamento entre os dados extraídos e as informações disponíveis na página de produto IKEA original.
Et voilà! A API Web Unlocker lidou com as proteções anti-bot da IKEA e entregou o conteúdo Markdown otimizado para LLMs, enquanto o GLM-5.3 processou com sucesso esse conteúdo e o transformou em dados bem organizados e estruturados.
Como Realizar Extração de Dados Visual com GLM-5.3-Flash
O GLM-5.3 não suporta nativamente entrada multimodal, o que significa que só pode processar entradas baseadas em texto. No entanto, outros modelos da família GLM suportam entrada multimodal, incluindo o GLM-5.3-Flash (assim como GLM-4.6V e outros).
Em vez de fornecer ao LLM conteúdo textual da página, você pode fornecer uma captura de tela ou imagem e pedir ao GLM-5.3-Flash para extrair informações estruturadas dela.
O procedimento de scraping permanece amplamente o mesmo:
- A API Web Unlocker da Bright Data captura uma screenshot da página IKEA alvo.
- O GLM-5.3-Flash recebe a screenshot através das APIs Z.ai e extrai informações do produto de acordo com um esquema predefinido.
- Os dados extraídos são validados e salvos como JSON estruturado.
Nota: O fluxo de trabalho principal muda muito pouco, portanto esta seção foca nas modificações necessárias para extração de dados visuais. Todos os pré-requisitos e etapas de configuração descritos anteriormente continuam válidos.
Passo #1: Recuperar a Screenshot da Página
Ajuste a requisição da API Web Unlocker para obter uma screenshot da página em vez de Markdown:
# Set up the authentication headers for Web Unlocker
headers = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {BRIGHT_DATA_API_KEY}"
}

# Define the request payload for the Web Unlocker API call
payload = {
    "zone": "web_unlocker", # Replace with your Web Unlocker zone name
    "url": "https://www.ikea.com/us/en/p/kallax-shelf-unit-white-20631663/", # The IKEA product page URL you want to visually scrape
    "format": "raw",
    "country": "us",
    "data_format": "screenshot" # Get a screenshot of the web page
}

# Retrieve the screenshot of the unlocked target page
web_unlocker_response = requests.post(
    "https://api.brightdata.com/request",
    json=payload,
    headers=headers
)

page_screenshot = web_unlocker_response.content
A modificação essencial é o campo data_format, agora configurado como "screenshot". Isso instrui o Web Unlocker a retornar uma screenshot da página. A resposta da API conterá dados de imagem da screenshot em formato PNG, representando a página completamente renderizada.
Exporte a screenshot para o disco:
with open("screenshot.png", "wb") as f:
    f.write(page_screenshot)
Esta etapa opcional é benéfica para inspeção visual da página recuperada e para solucionar problemas nos fluxos de extração.
A saída será um arquivo screenshot.png:
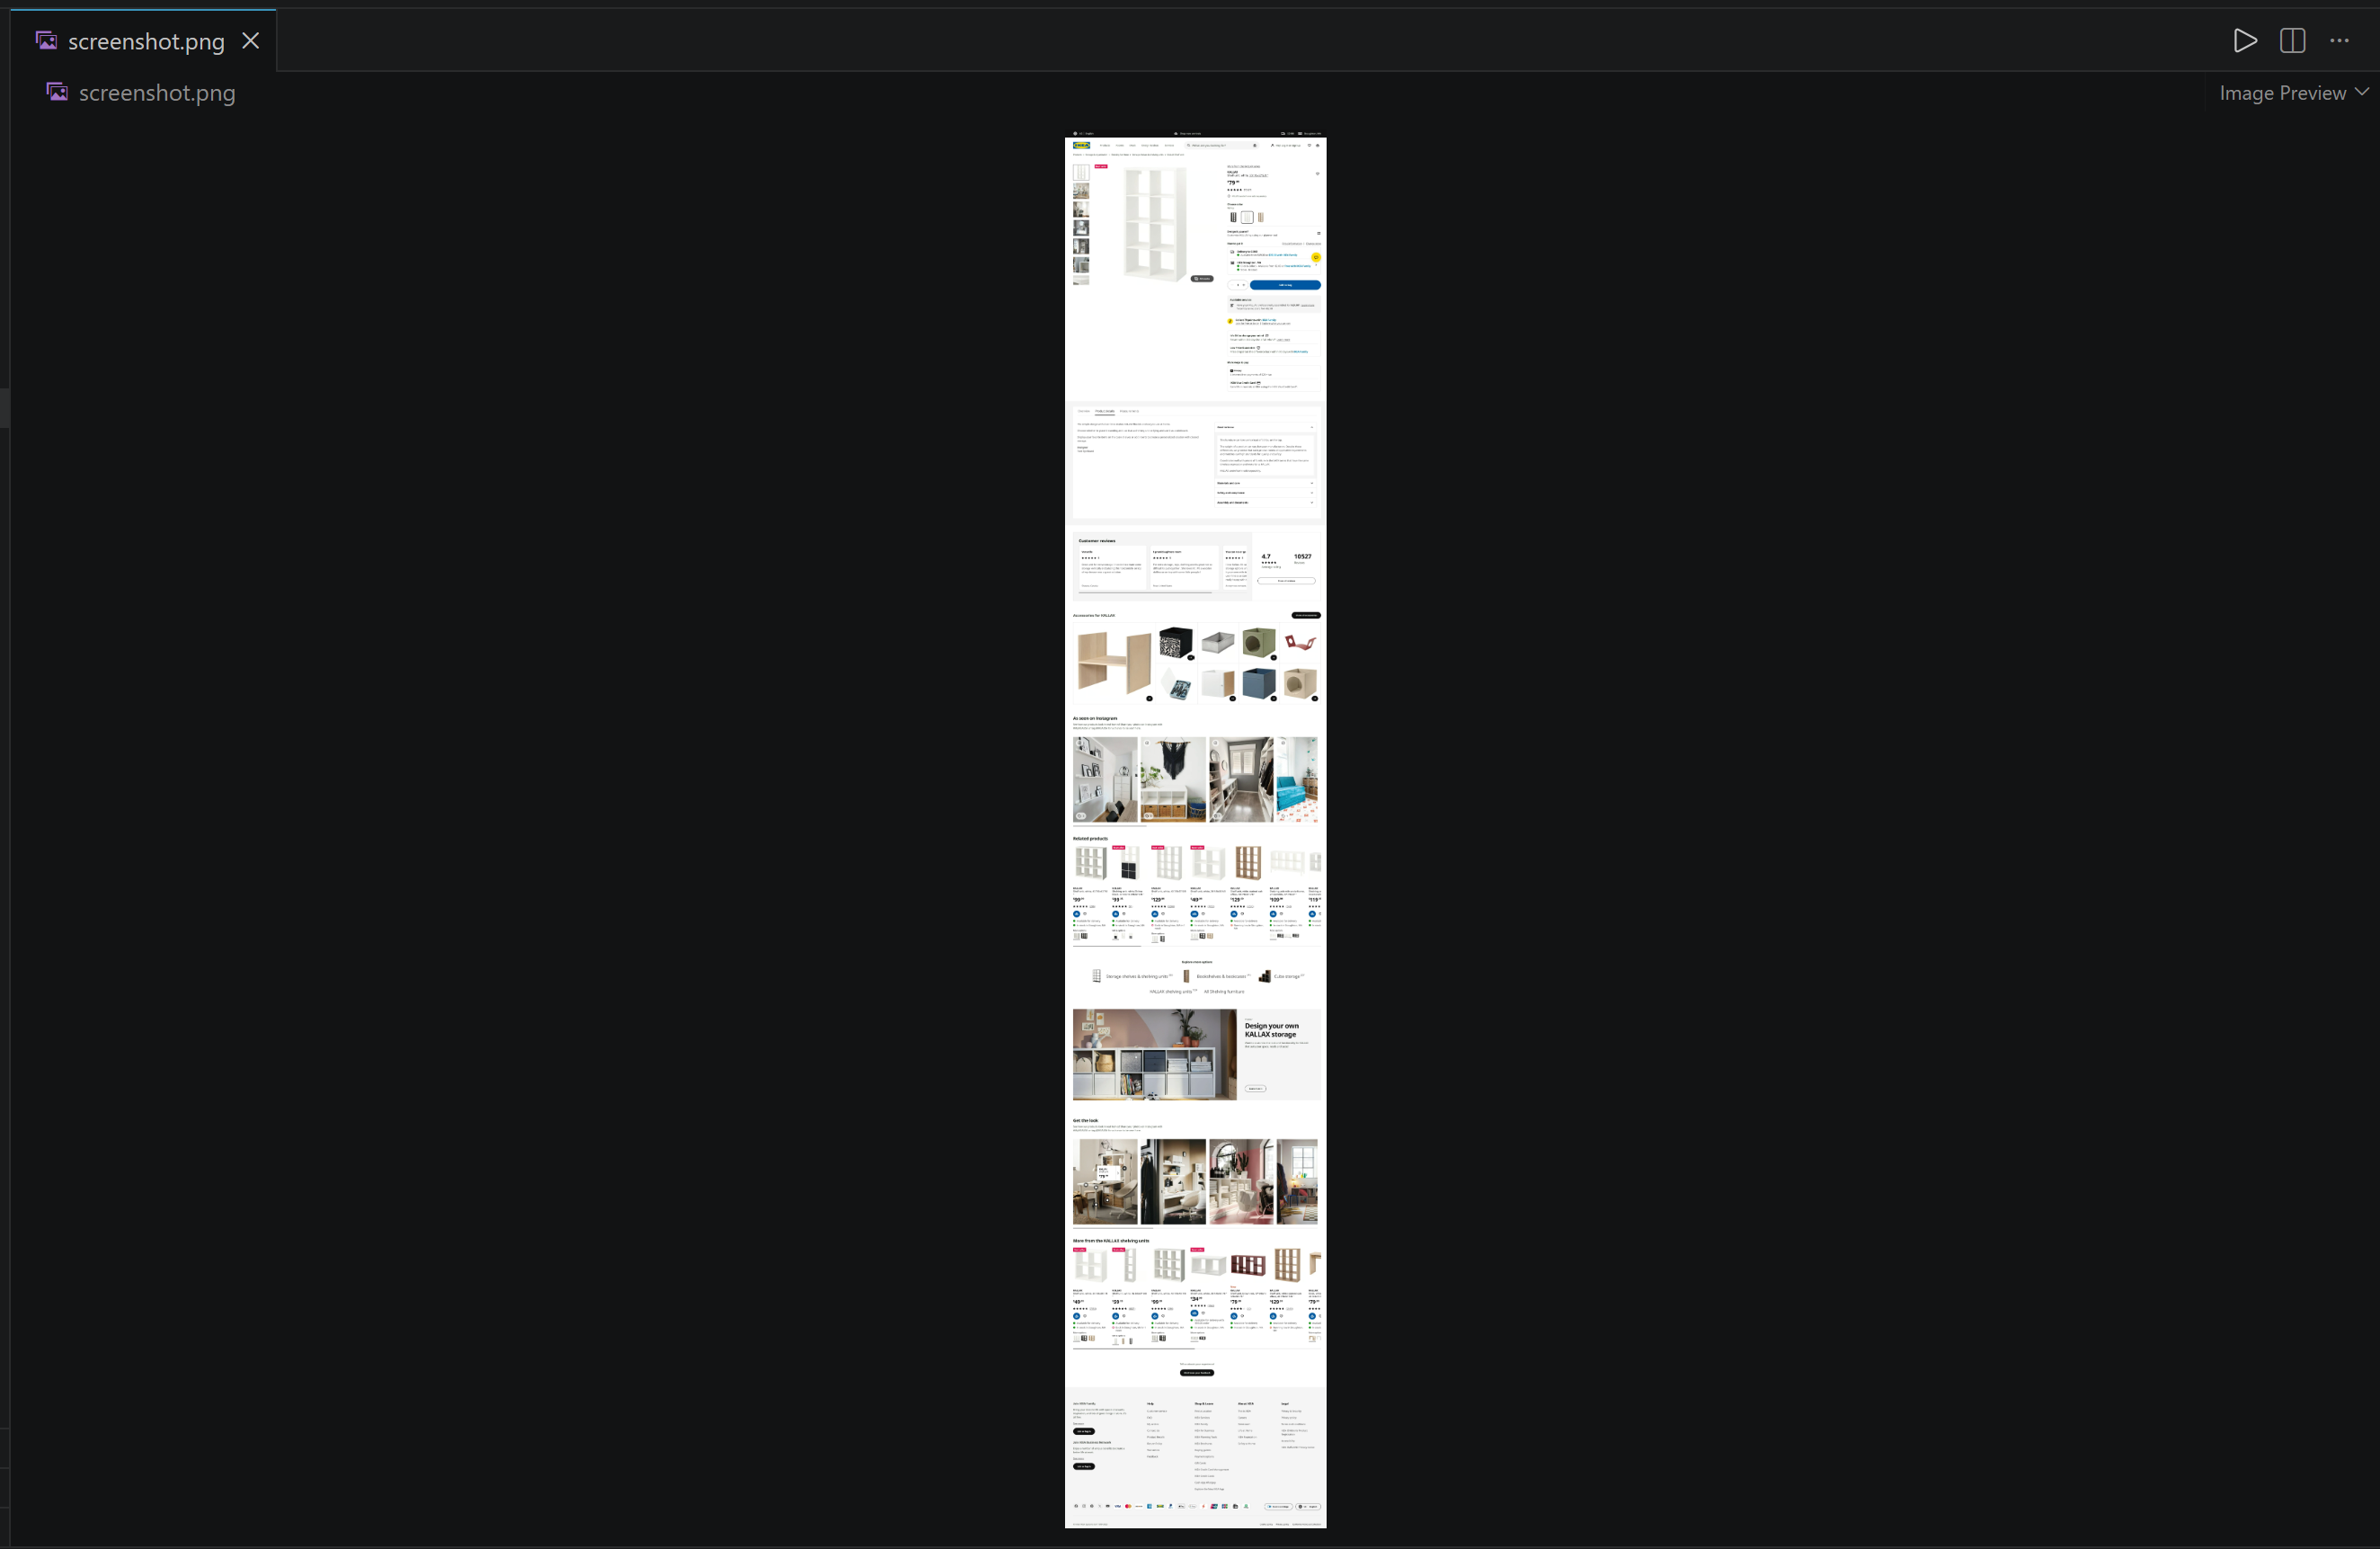
Observe como a API Web Unlocker da Bright Data capturou uma screenshot da página completa do produto IKEA. Continuando!
Passo #2: Atualizar o Modelo Pydantic
Através da análise de uma screenshot de página, o GLM-5.3-Flash pode identificar informações visuais indisponíveis na representação Markdown da página. Por exemplo, ele pode interpretar texto incorporado em rótulos visuais (por exemplo, a etiqueta “Best seller”):
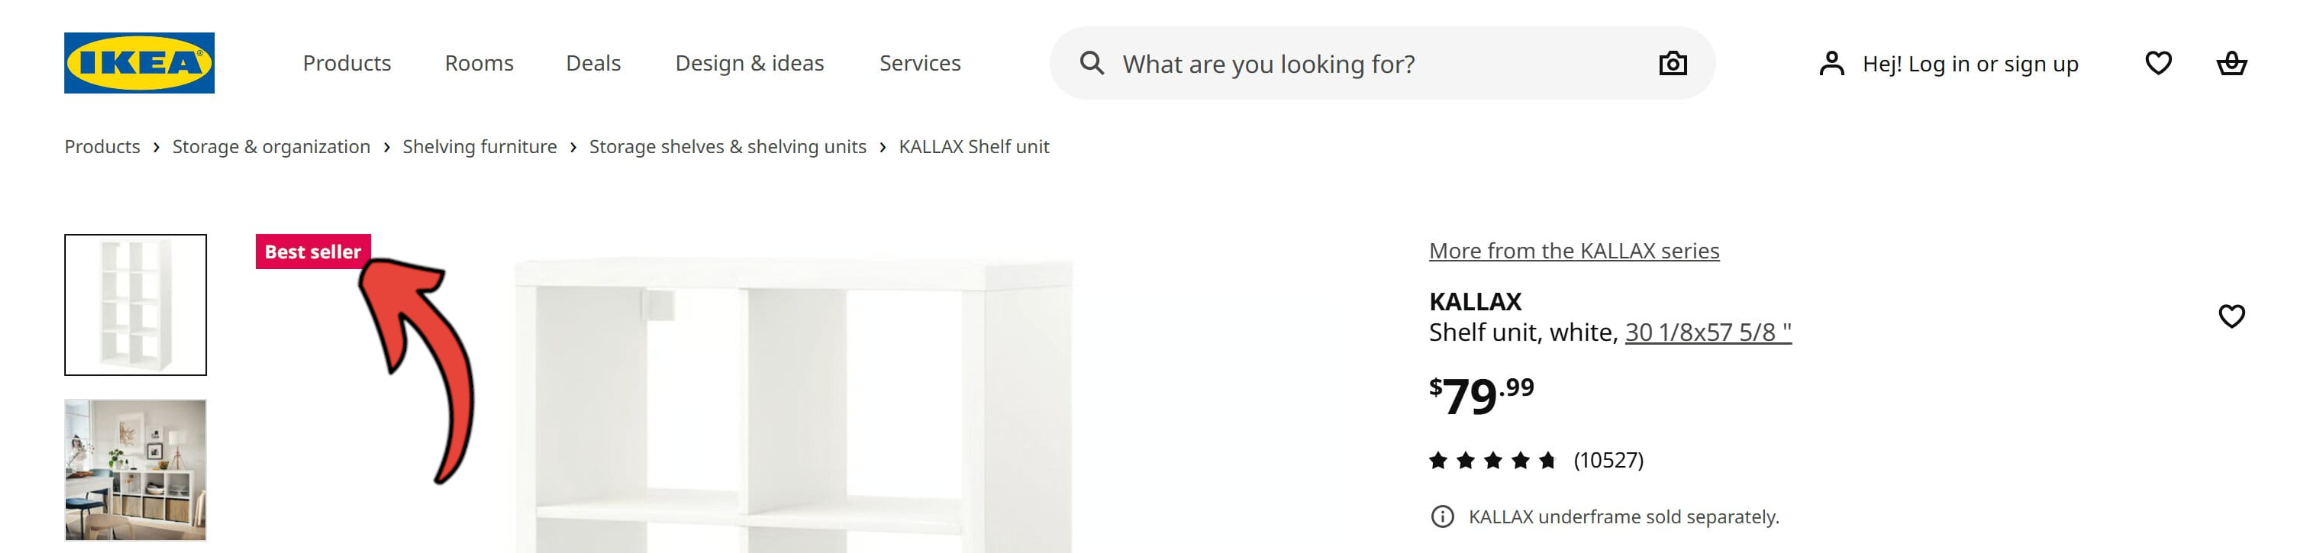
Simultaneamente, uma screenshot não entrega todas as informações da página. Por exemplo, campos como images ou assembly_instructions_url, que eram acessíveis através do fluxo de extração baseado em Markdown, não podem ser preenchidos a partir de dados visuais.
Portanto, adapte o modelo Pydantic IkeaProduct para processamento visual:
class IkeaProduct(BaseModel):
    title: Optional[str] = Field(None, description="Full product title as displayed on the IKEA website")
    product_type: Optional[str] = Field(None, description="General type of product, such as an armchair, shelf unit, cabinet, or table")
    price: Optional[float] = Field(None, description="Current displayed numerical price")
    currency: Optional[str] = Field(None, description="Currency used for the displayed price, such as USD")
    is_best_seller: Optional[bool] = Field(False, description="Whether a best-seller or top-seller badge is displayed")
    badge_label: Optional[str] = Field(None, description="Promotional or product badge displayed on the page, such as Top Seller")
    delivery_options: Optional[List[str]] = Field(None, description="Delivery or fulfillment options displayed on the page")
    color: Optional[str] = Field(None, description="Selected product color or finish, such as white or birch veneer")
    visual_aspects: Optional[str] = Field(None, description="Description of the physical characteristics visible in the product images, such as shape, components, finish, or configuration")
    dimensions: Optional[str] = Field(None, description="Overall product dimensions as displayed on the IKEA website")
    rating: Optional[float] = Field(None, description="Average customer rating, typically on a 5-point scale")
    review_count: Optional[int] = Field(None, description="Total number of customer reviews displayed")
Observe a introdução do campo visual_aspects. Este campo direciona o GLM a documentar características físicas visíveis nas imagens do produto, permitindo a extração de informações indisponíveis através do parsing baseado em texto. Além disso, observe os novos campos is_best_seller e badge_label.
Ótimo! Envie o modelo Pydantic atualizado e a screenshot da página da web para a API Z.ai para scraping visual com GLM-5.3-Flash.
Passo #3: Coletar Dados de uma Imagem com GLM-5.3 Vision
Assim como os modelos OpenAI com capacidades de visão, o GLM-5.3-Flash aceita imagens através do campo image_url. Isso aceita URLs de imagens publicamente acessíveis ou representações de imagens codificadas em Base64.
Como a screenshot existe localmente como bytes de imagem, é necessário codificá-la como Base64. Para isso, utilize o módulo base64 do Python:
import base64

screenshot_base64 = base64.b64encode(page_screenshot).decode("utf-8")
Agora, transmita a screenshot codificada em Base64 para o GLM-5.3-Flash junto com suas instruções de extração:
# Perform visual web data parsing with GLM-5.3-Flash
response = glm_client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/png;base64,{screenshot_base64}"
                    },
                },
                {
                    "type": "text",
                    "text": f"""
Extract the IKEA product information from the provided webpage screenshot
and return it as structured data that conforms to the provided JSON schema.

SCHEMA:
{json.dumps(IkeaProduct.model_json_schema(), indent=2)}
""",
                },
            ],
        }
    ],
    response_format={"type": "json_object"},
)

# Get the parsed data in the defined schema format
product_data = response.choices[0].message.content
A requisição para a API Z.ai compreende dois componentes:
- A imagem da screenshot da página.
- Uma instrução de texto direcionando o GLM-5.3 a recuperar informações do produto usando o esquema Pydantic designado.
Nota: Desta vez, o modelo alvo é glm-5.3-flash, não glm-5.3 como antes. Esta mudança é necessária pois o GLM-5.3 não possui capacidades de visão.
O resultado é uma variável product_data armazenando uma string JSON com os dados coletados visualmente. Armazene-a no disco conforme descrito anteriormente. Impressionante!
Passo #4: Testar o Script de Scraping Visual com GLM
O código final do seu script de scraping de dados visual com GLM será:
# pip install dotenv requests openai pydantic

from dotenv import load_dotenv
import os
import requests
import base64
import json
from pydantic import BaseModel, Field
from typing import List, Optional
from openai import OpenAI

# Load the environment variables from the .env file
load_dotenv()

# Loading the required secrets from the envs
BRIGHT_DATA_API_KEY = os.environ.get("BRIGHT_DATA_API_KEY")
ZAI_API_KEY = os.environ.get("ZAI_API_KEY")

class IkeaProduct(BaseModel):
    title: Optional[str] = Field(None, description="Full product title as displayed on the IKEA website")
    product_type: Optional[str] = Field(None, description="General type of product, such as an armchair, shelf unit, cabinet, or table")
    price: Optional[float] = Field(None, description="Current displayed numerical price")
    currency: Optional[str] = Field(None, description="Currency used for the displayed price, such as USD")
    is_best_seller: Optional[bool] = Field(False, description="Whether a best-seller or top-seller badge is displayed")
    badge_label: Optional[str] = Field(None, description="Promotional or product badge displayed on the page, such as Top Seller")
    delivery_options: Optional[List[str]] = Field(None, description="Delivery or fulfillment options displayed on the page")
    color: Optional[str] = Field(None, description="Selected product color or finish, such as white or birch veneer")
    visual_aspects: Optional[str] = Field(None, description="Description of the physical characteristics visible in the product images, such as shape, components, finish, or configuration")
    dimensions: Optional[str] = Field(None, description="Overall product dimensions as displayed on the IKEA website")
    rating: Optional[float] = Field(None, description="Average customer rating, typically on a 5-point scale")
    review_count: Optional[int] = Field(None, description="Total number of customer reviews displayed")

# Set up the authentication headers for Web Unlocker
headers = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {BRIGHT_DATA_API_KEY}"
}

# Define the request payload for the Web Unlocker API call
payload = {
    "zone": "web_unlocker", # Replace with your Web Unlocker zone name
    "url": "https://www.ikea.com/us/en/p/kallax-shelf-unit-white-20631663/", # The IKEA product page URL you want to visually scrape
    "format": "raw",
    "country": "us",
    "data_format": "screenshot" # Get a screenshot of the web page
}

# Retrieve the screenshot of the unlocked target page
web_unlocker_response = requests.post(
    "https://api.brightdata.com/request",
    json=payload,
    headers=headers
)

page_screenshot = web_unlocker_response.content

# Export the screenshot to a PNG file
with open("screenshot.png", "wb") as f:
    f.write(page_screenshot)

# Convert the screenshot to Base64 for vision processing
screenshot_base64 = base64.b64encode(page_screenshot).decode("utf-8")

# Initialize the OpenAI-compatible client for Z.ai
glm_client = OpenAI(
    api_key=ZAI_API_KEY,
    base_url="https://api.z.ai/api/paas/v4/",
)

# Perform visual web data parsing with GLM-5.3-Flash
response = glm_client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/png;base64,{screenshot_base64}"
                    },
                },
                {
                    "type": "text",
                    "text": f"""
Extract the IKEA product information from the provided webpage screenshot
and return it as structured data that conforms to the provided JSON schema.

SCHEMA:
{json.dumps(IkeaProduct.model_json_schema(), indent=2)}
""",
                },
            ],
        }
    ],
    response_format={"type": "json_object"},
)

# Get the parsed data in the defined schema format
product_data = response.choices[0].message.content

# Convert the JSON string into a validated IkeaProduct object
product = IkeaProduct.model_validate_json(product_data)

# Export the IkeaProduct object to a JSON file
with open("visual_product.json", "w", encoding="utf-8") as f:
    f.write(product.model_dump_json(indent=2))
Execute o script e isso gerará um arquivo visual_product.json contendo:
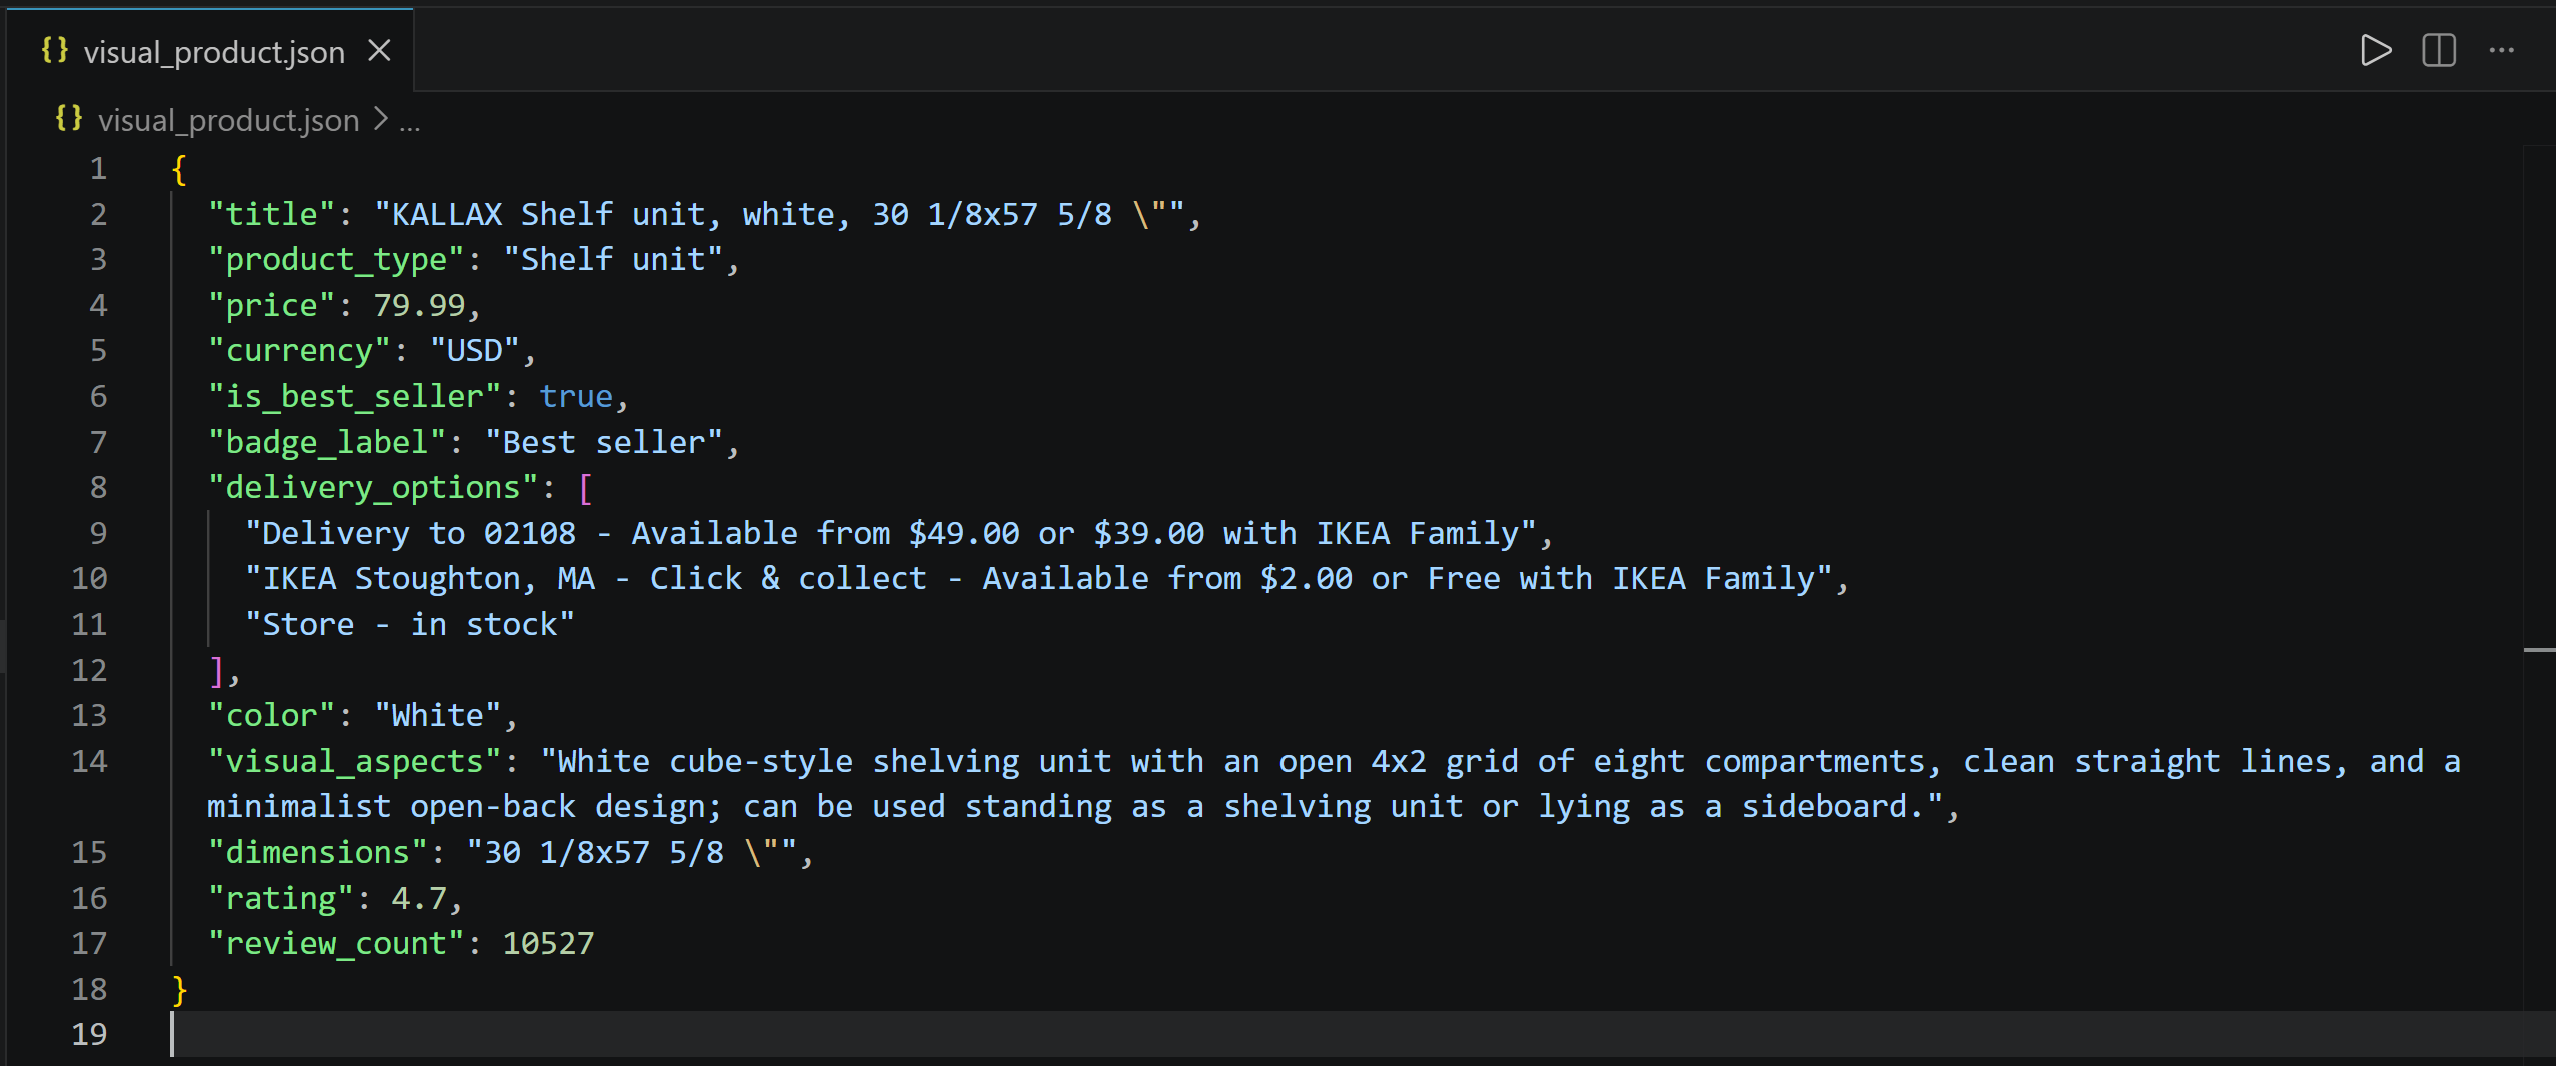
Observe a recuperação bem-sucedida de informações do produto a partir da screenshot da página, incluindo aspectos visuais e a etiqueta “Best seller”. Incrível!
Conclusão
Neste tutorial, você aprendeu como construir um sistema de extração de dados da web com LLM usando GLM-5.3 e GLM-5.3-Flash. Os principais desafios do scraping de dados com IA (ou seja, acessar conteúdo web sem ser bloqueado e convertê-lo em um formato pronto para LLMs) foram facilmente resolvidos com a API Web Unlocker da Bright Data.
Como demonstrado aqui, combinar GLM-5.3 e GLM-5.3-Flash com a API Web Unlocker permite extrair informações estruturadas tanto de páginas da web quanto de suas representações visuais. Este é apenas um dos muitos casos de uso suportados pelas soluções de acesso à web compatíveis com IA da Bright Data.
Registre-se na Bright Data hoje e comece a experimentar nossas APIs de scraping de dados gratuitamente!