Se você pedir a um agente de codificação para construir um rastreador de preços de concorrentes, você pode ter um código funcional em cerca de um minuto. Essa parte está perto de ser resolvida para uma tarefa desse tipo. A próxima parte é a que raramente recebe orçamento. O rastreador roda, a tabela é preenchida, e alguns dos números estão discretamente errados. Quais e quantos dependem do que você colocou por baixo do agente, e executamos a tarefa das duas formas.
Não ausentes. Errados. Um preço que pertence a um plano de proteção. Uma avaliação emprestada de outro varejista. Uma linha que parece completa porque algo precisava ir na célula. Se você é um desenvolvedor, esse é um bug que você encontra semanas depois, se encontrar. Se você gerencia precificação, merchandising ou um feed de inteligência de mercado, é uma decisão que você já tomou com base em dados ruins. Se você está construindo um produto de IA sobre isso, é um número que seu modelo vai afirmar com total confiança.
A lacuna não está na codificação do agente. Nos varejistas que protegem suas páginas, ler uma significa lidar com o gerenciamento de bots daquele varejista, e mais Python raramente é a solução.
Então medimos. Uma tarefa de rastreador de preços, 41 páginas de produtos de varejistas congeladas, 2 agentes de codificação, mesmo prompt e mesmo modelo, executados com e sem uma camada gerenciada de dados web por baixo. Cada página, turno e valor errado é publicado, junto com cada cifra de custo que as CLIs reportaram, e um único comando no repositório re-deriva os números principais abaixo e falha se o post tiver divergido deles.
O Cursor CLI com o MCP da Bright Data leu 40 de 41 páginas e acertou 89% dos valores em relação a uma verdade fundamental que verificamos manualmente. A mesma classe de agente sem camada de dados leu 34 e acertou 72%. Na Best Buy, onde o braço Claude Code sem assistência perdeu a maioria de suas páginas, ele leu 9 de 9 contra 4.
TL;DR
Executamos uma tarefa de rastreador de preços por meio de 2 agentes de codificação, com e sem uma camada gerenciada de dados web, e pontuamos cada valor manualmente.
- A precisão de campo chega a 89% com uma camada de dados contra 72% sem ela, nas mesmas páginas e no mesmo modelo.
- Uma página foi recusada nas 3 execuções com camada de dados; as duas sem ela perderam 5 páginas cada.
- Preço é quase empatado. Avaliação e disponibilidade separam os braços: 93% e 94% contra 83% e 52%.
- O braço Cursor sem assistência escreveu 729 linhas de Python, e seu User-Agent estava 20 versões do Chrome desatualizado.
O que executamos e o que foi mantido constante
Definimos a tarefa antes de qualquer execução: para uma lista de SKUs congelada em 5 varejistas, coletar nome do produto, preço, disponibilidade e avaliação, adicionar um feed orientado por busca de novos anúncios e colocar o resultado em um pequeno painel. Usamos apenas páginas públicas, nada por trás de um login.
A lista de SKUs foi congelada antes da primeira solicitação: 10 produtos de eletrônicos de consumo em 5 varejistas, 41 páginas de produtos no total, gravadas em skus.json. Cada execução lê esse arquivo, então cada execução solicita alvos idênticos.
Todas as 4 execuções foram não interativas, e cada transcrição é salva:
| Execução | Agente | Camada de dados | Função |
|---|---|---|---|
| A | Cursor CLI (cursor-agent) |
MCP hospedado pela Bright Data | a configuração em teste |
| B | Claude Code | nenhuma | com o que é comparado |
| Controle | Cursor CLI, mesma versão | nenhuma | referência, isola a camada de dados |
| B+ | Claude Code | MCP hospedado pela Bright Data | referência, isola o agente |
O que A e B realmente comparam
A contra B é a comparação: uma equipe que adota o Cursor com uma camada de dados contra uma que adota um agente de codificação e escreve sua própria busca. Mantidos constantes: as 41 URLs, os 4 campos, o texto do prompt, o modelo, o código de pontuação, a máquina e a tarde. O prompt nunca menciona a Bright Data, proxies ou fornecedores de scraping.
Essa comparação move duas coisas ao mesmo tempo, o agente e a camada de dados, e é por isso que existem duas referências laterais. O Controle mantém o agente fixo e remove apenas a camada de dados; B+ mantém o agente fixo e a adiciona. Entre elas, as duas referências mostram qual variável produz o resultado, e essa variável não é o agente.
O único arquivo que difere
A única variável entre A e o Controle é um arquivo. O projeto da Execução A contém um .cursor/mcp.json que nomeia um servidor e o aponta para o endpoint MCP hospedado da Bright Data. O arquivo tem menos de 10 linhas de JSON, e não instalamos nenhum SDK nem biblioteca cliente. O projeto do Controle tem o mesmo arquivo com um objeto mcpServers vazio. Na íntegra:
{ "mcpServers": { "brightdata": {
    "type": "http",
    "url": "https://mcp.brightdata.com/mcp?token=YOUR_BRIGHT_DATA_API_KEY" } } }
O Claude Code recebeu esse mesmo arquivo por caminho, com --strict-mcp-config para que nada mais na máquina pudesse se conectar. Ambos os agentes rodaram com configuração byte a byte idêntica; apenas o nome do arquivo que cada agente procura difere.
O modelo e o que conta como coletado
O modelo é mantido constante. Todas as 4 execuções foram fixadas no Sonnet 5, claude-sonnet-5-high no Cursor CLI e claude-sonnet-5 no Claude Code, o mesmo modelo base sob dois nomes de fornecedores diferentes. O alias do Cursor fixa o esforço de raciocínio em alto e o padrão do Claude Code é menor, que é a única configuração de modelo que difere; a verificação com esforço equivalente mais adiante controla isso.
Uma página conta como coletada apenas quando um nome de produto e um preço podem ser lidos do que foi retornado. Um HTTP 200 carregando um desafio de bot não é um sucesso, e tampouco é um 200 carregando uma página de produto cujo preço nunca foi renderizado.
Com esse arquivo no lugar, o agente pode usar as ferramentas sem ser instruído. Dada a tarefa e sem menção a nenhum fornecedor, o agente agrupou as URLs do varejista em uma única chamada scrape_batch e pediu aprovação antes de enviar essa chamada.
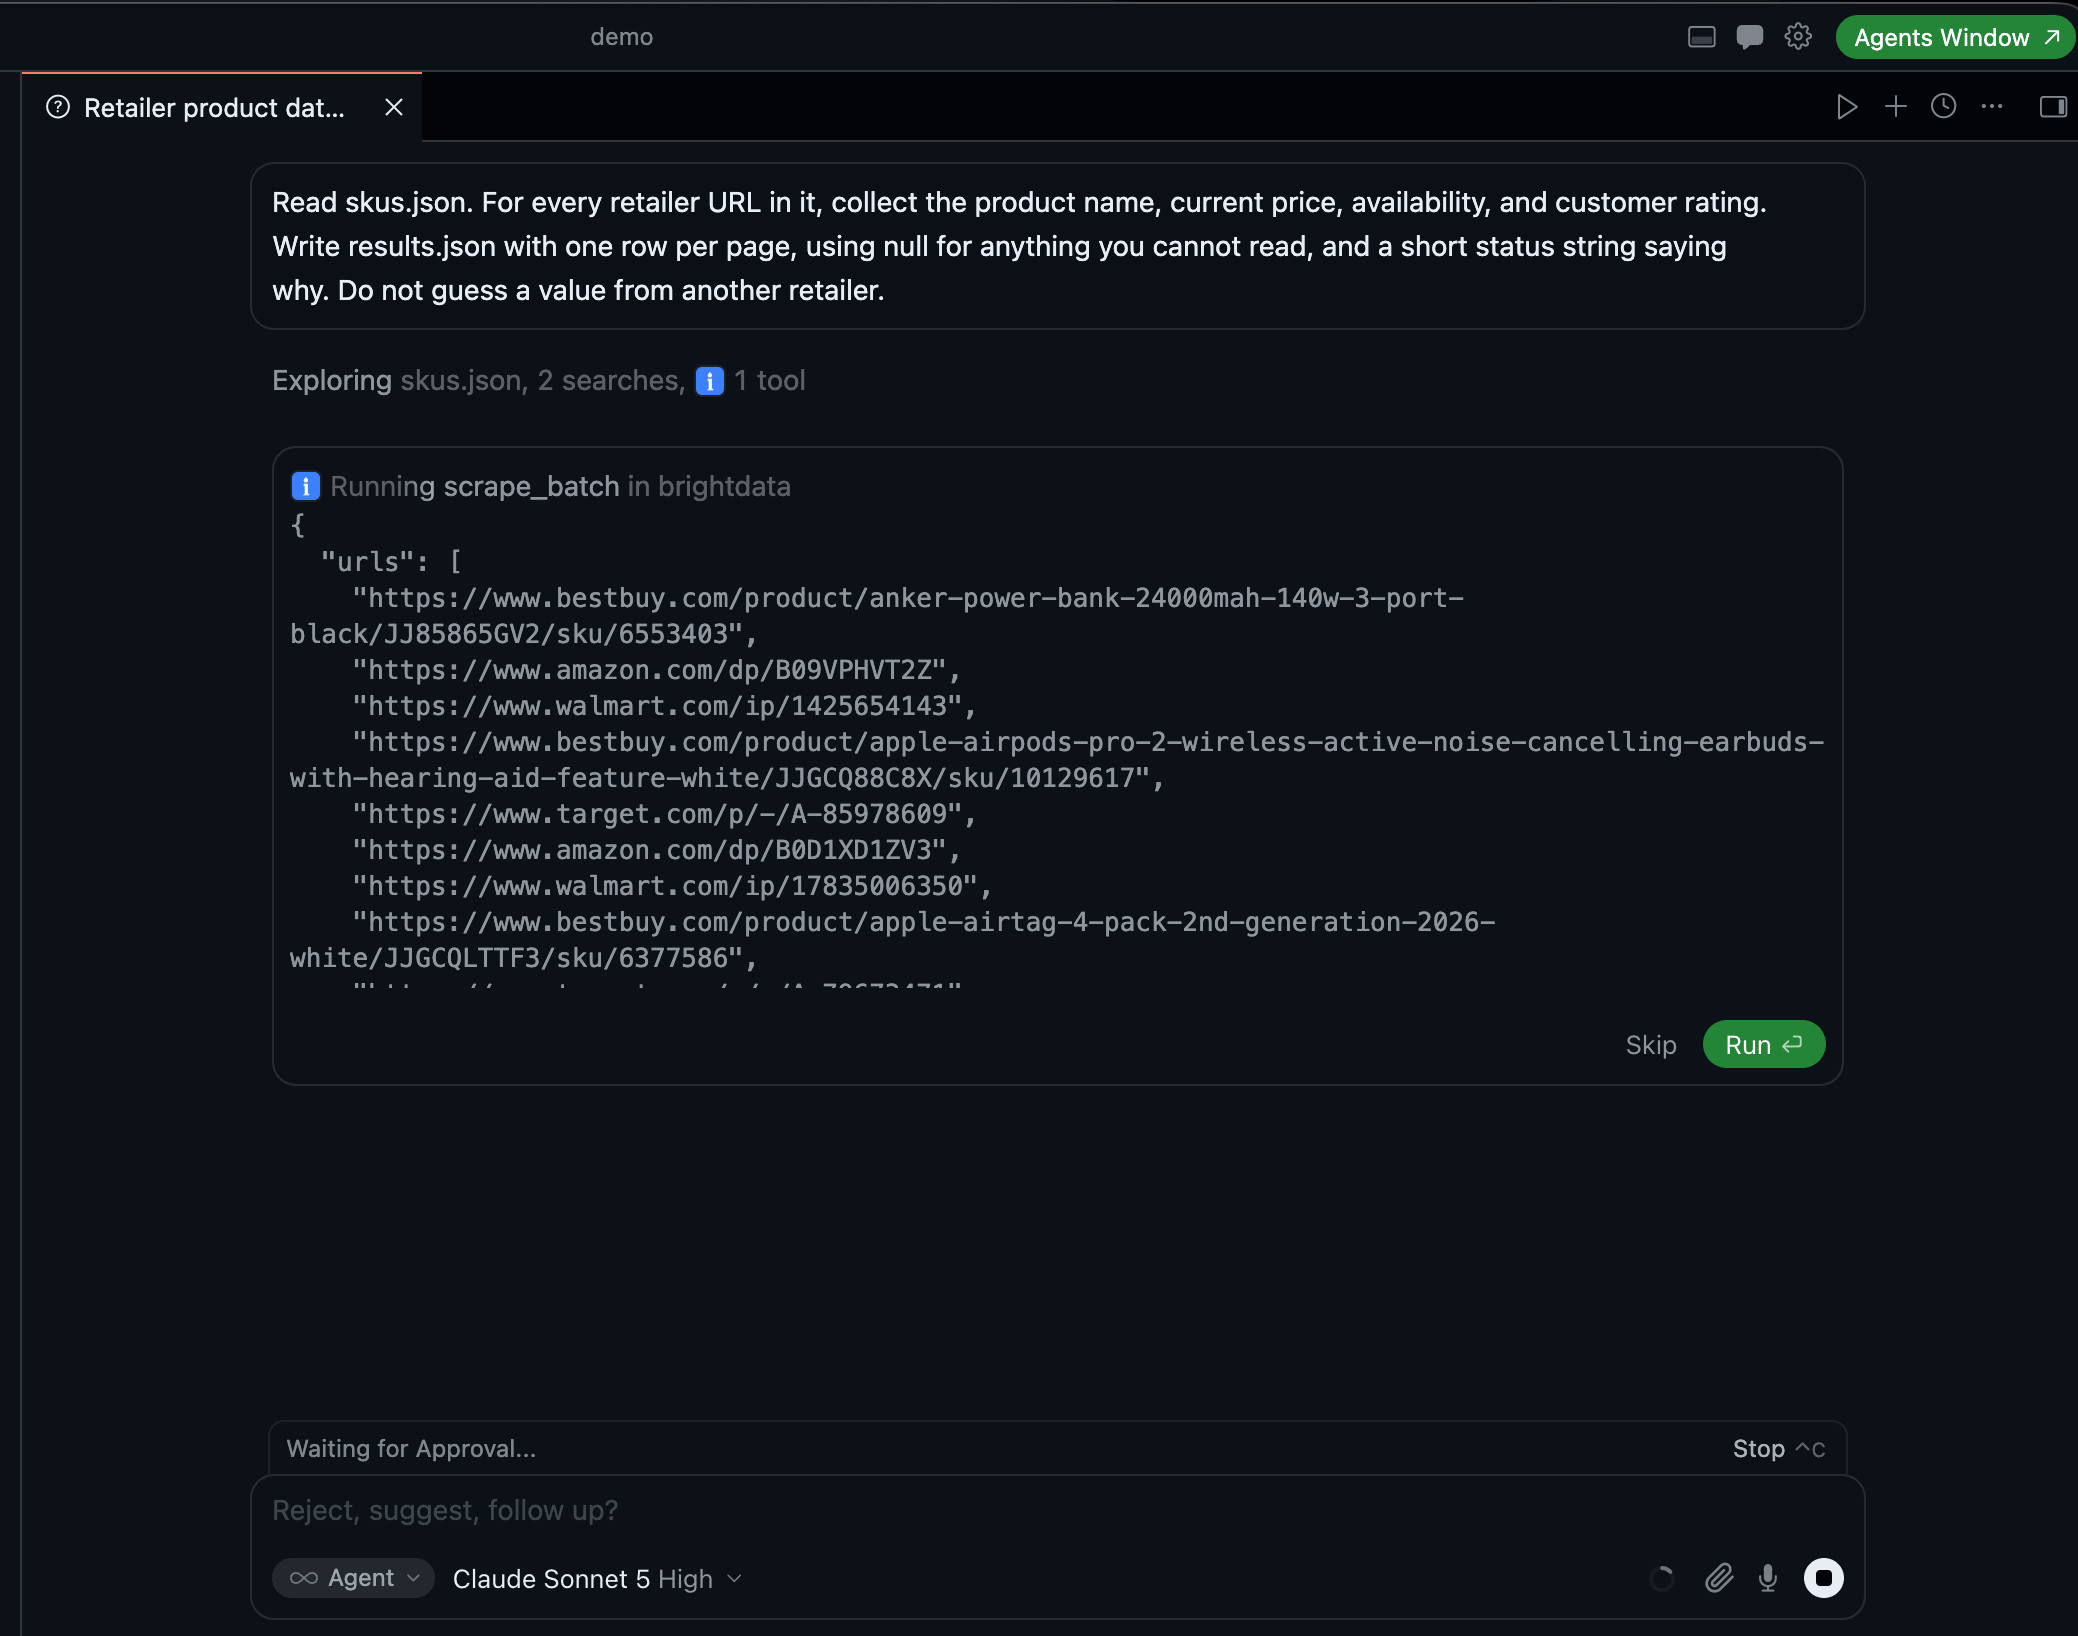
O passo a passo na lista real. O agente escolheu scrape_batch, montou o conjunto de URLs por conta própria, e o Cursor o manteve em um portão de aprovação antes que qualquer coisa saísse da máquina.
Sucesso da tarefa, a versão binária
Todas as 4 execuções produziram results.json, new_listings.json, dashboard.html e um README, então na questão binária “funciona do início ao fim” todas as execuções passam. Essa é a pergunta menos informativa que fizemos.
| Nome + preço | Todos os 4 campos | Precisão de campo | |
|---|---|---|---|
| A. Cursor + Bright Data | 40 / 41 | 38 | 89% |
| B. Claude Code, sem camada de dados | 34 / 41 | 29 | 72% |
| B+. Claude Code + Bright Data | 34 / 41 | 34 | 78% |
| Controle. Cursor, sem camada de dados | 28 / 41 | 28 | 74% |
A precisão é pontuada em relação a uma verdade fundamental verificada manualmente cobrindo todas as 41 páginas, que descrevemos mais adiante.
A verificação com esforço equivalente
Um braço está ausente dessa tabela de propósito. Após as 4 execuções acima, re-executamos B+ com o esforço de raciocínio elevado para high, para corresponder ao nível que o braço Cursor já estava usando. Ele leu 35 de 41 com 88%, acima de 34 e 78%. Essa única mudança importa: sem ela, as 4 linhas acima poderiam ser lidas como um resultado de esforço em vez de um resultado de camada de dados.
| Com Bright Data | Sem | |
|---|---|---|
| Cursor | 89% | 74% |
| Claude Code, esforço equivalente | 88% | 72% |
As diferenças são de 15 e 16 pontos, na mesma direção, de 2 agentes diferentes no mesmo modelo e no mesmo esforço. Esse par de linhas separa um resultado de camada de dados de um resultado de agente, e é o que permite que o restante desses números seja lido dessa forma.
A tabela suporta 2 leituras. A primeira é a ordenação: ambos os braços com uma camada de dados ficam acima de ambos sem ela, tanto nas páginas que leram quanto nos valores que acertaram. A segunda é que a contagem de páginas lidas subestima a diferença. A lê 40 contra 34 de B, uma diferença de 6. Nos valores dentro dessas páginas a diferença é de 17 pontos, 89% contra 72%, porque uma página que você buscou mal ainda conta como uma página. Em um conjunto de páginas como este, um agente de codificação em um modelo atual escreve código de busca competente e coleta a maior parte do volume. Ele não chega ao trecho final, e o trecho final contém os varejistas difíceis e os campos difíceis.
O que os painéis mostram
Ambas as execuções construíram o painel que a tarefa solicitou, que é a forma mais rápida de ver a diferença.
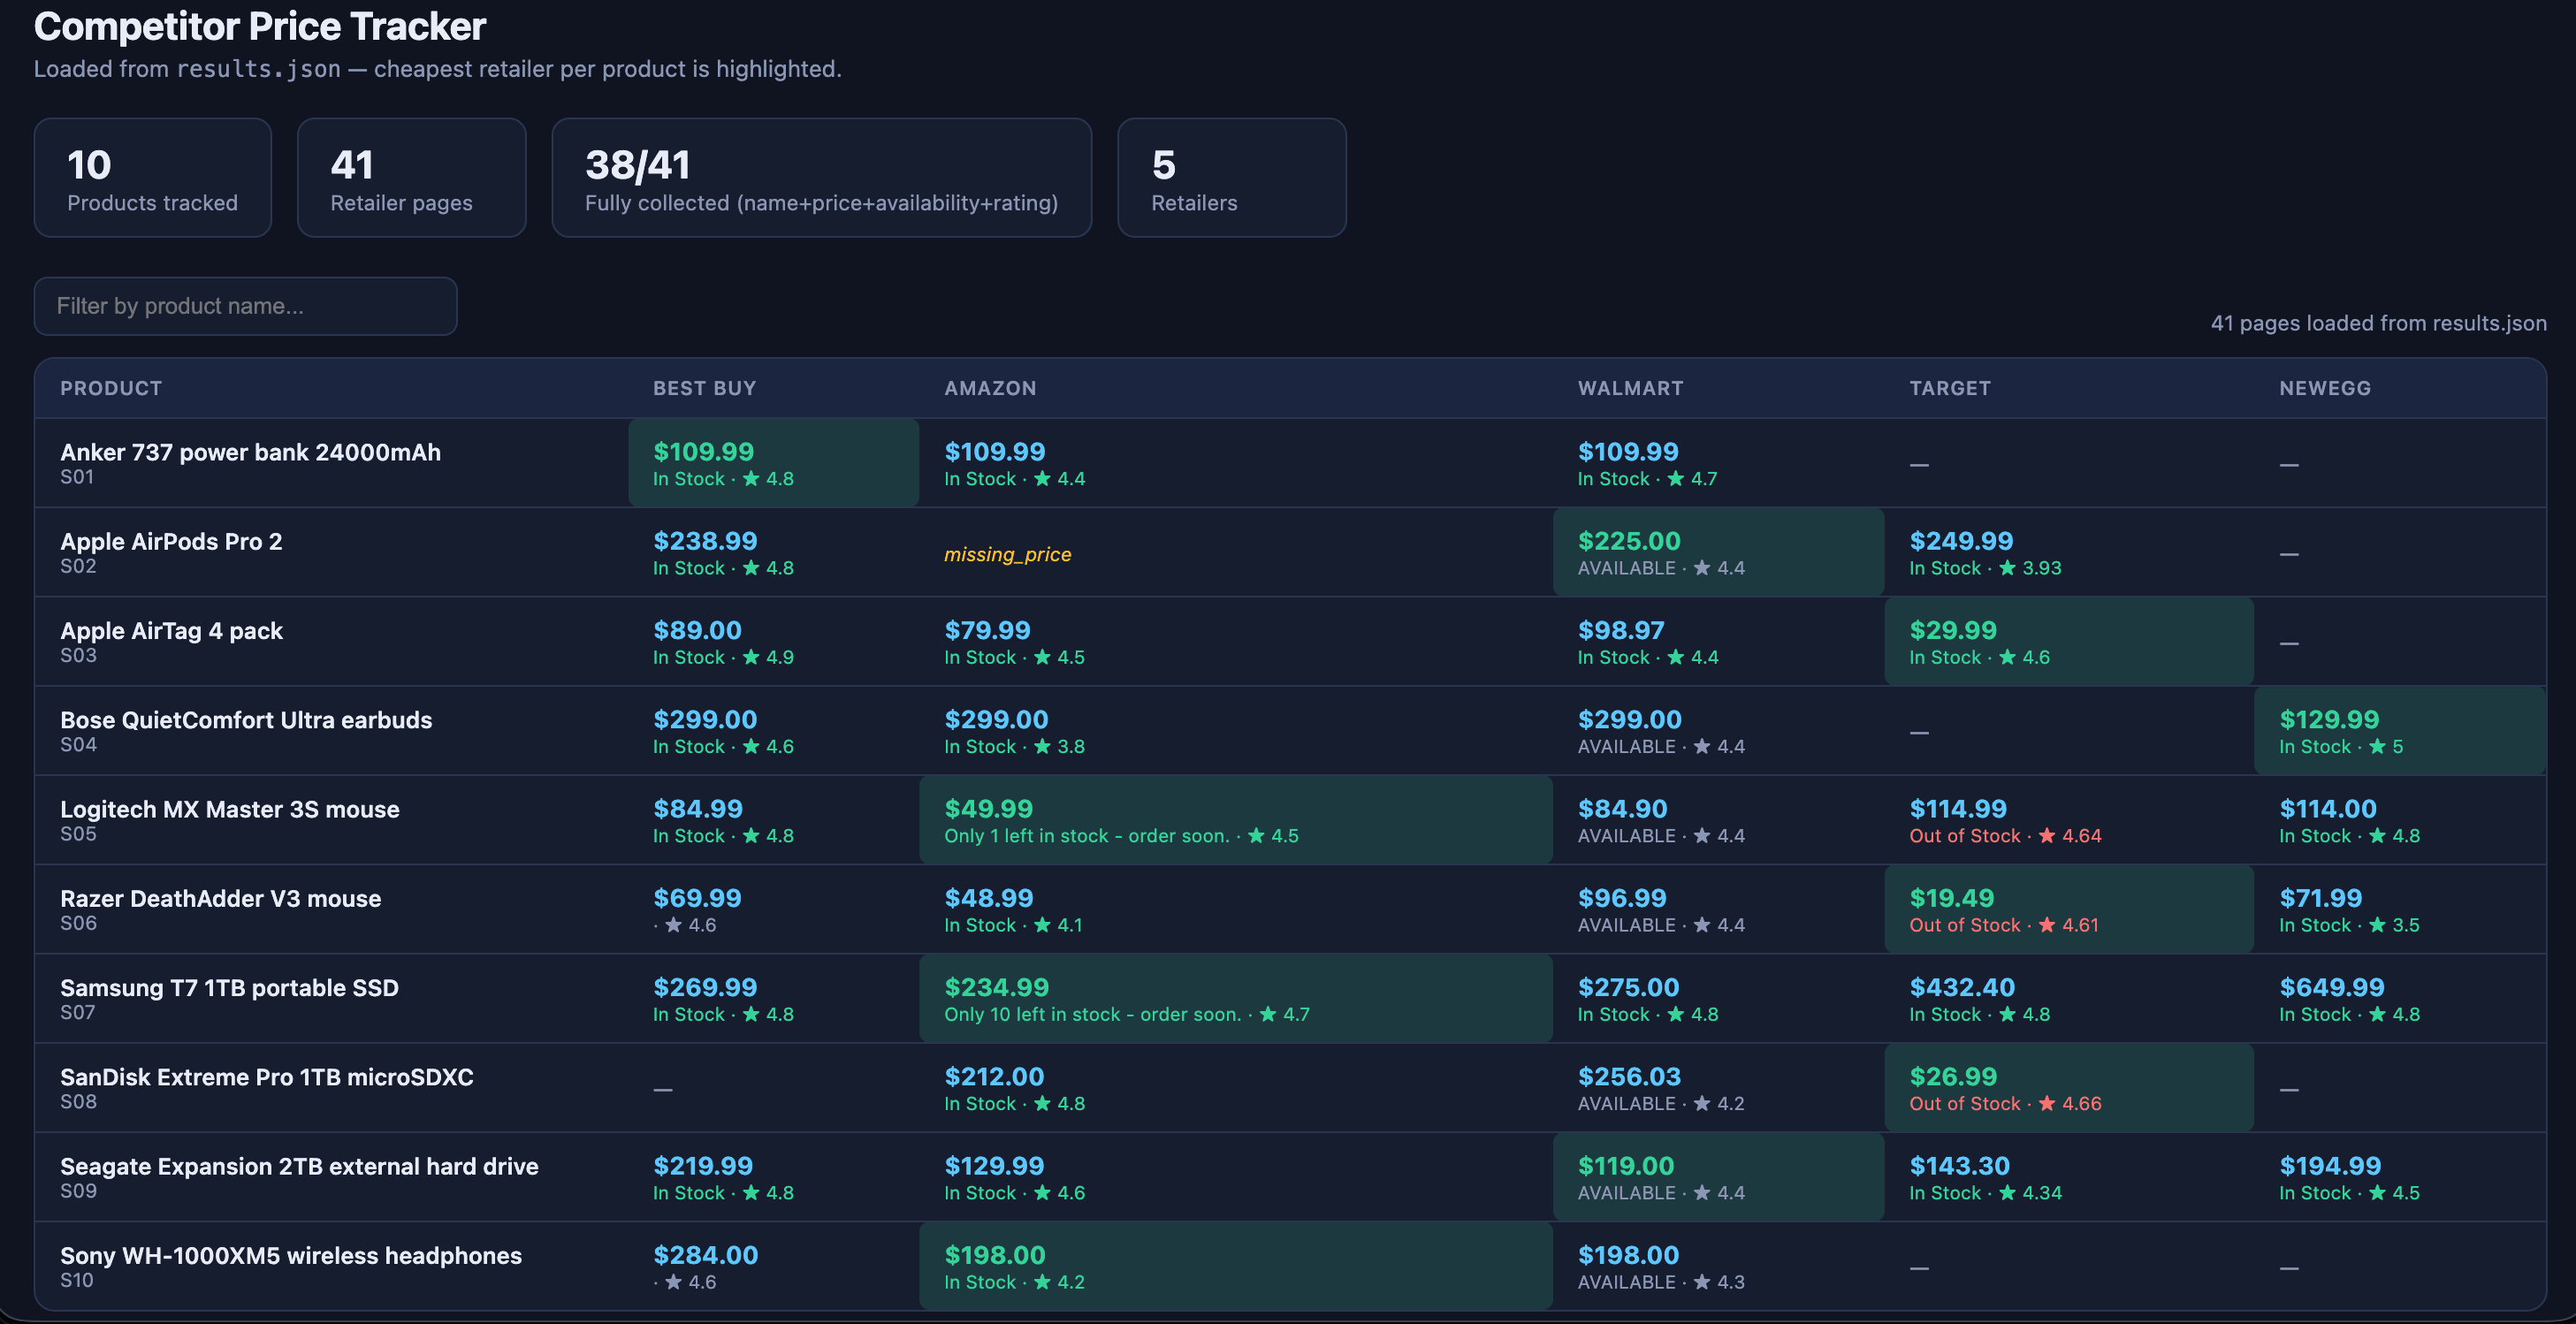
Execução A. A única lacuna na tela é reportada como missing_price em vez de preenchida.
O Controle construiu a mesma visualização a partir das mesmas 41 URLs, e a diferença aparece nas células em vez do layout:
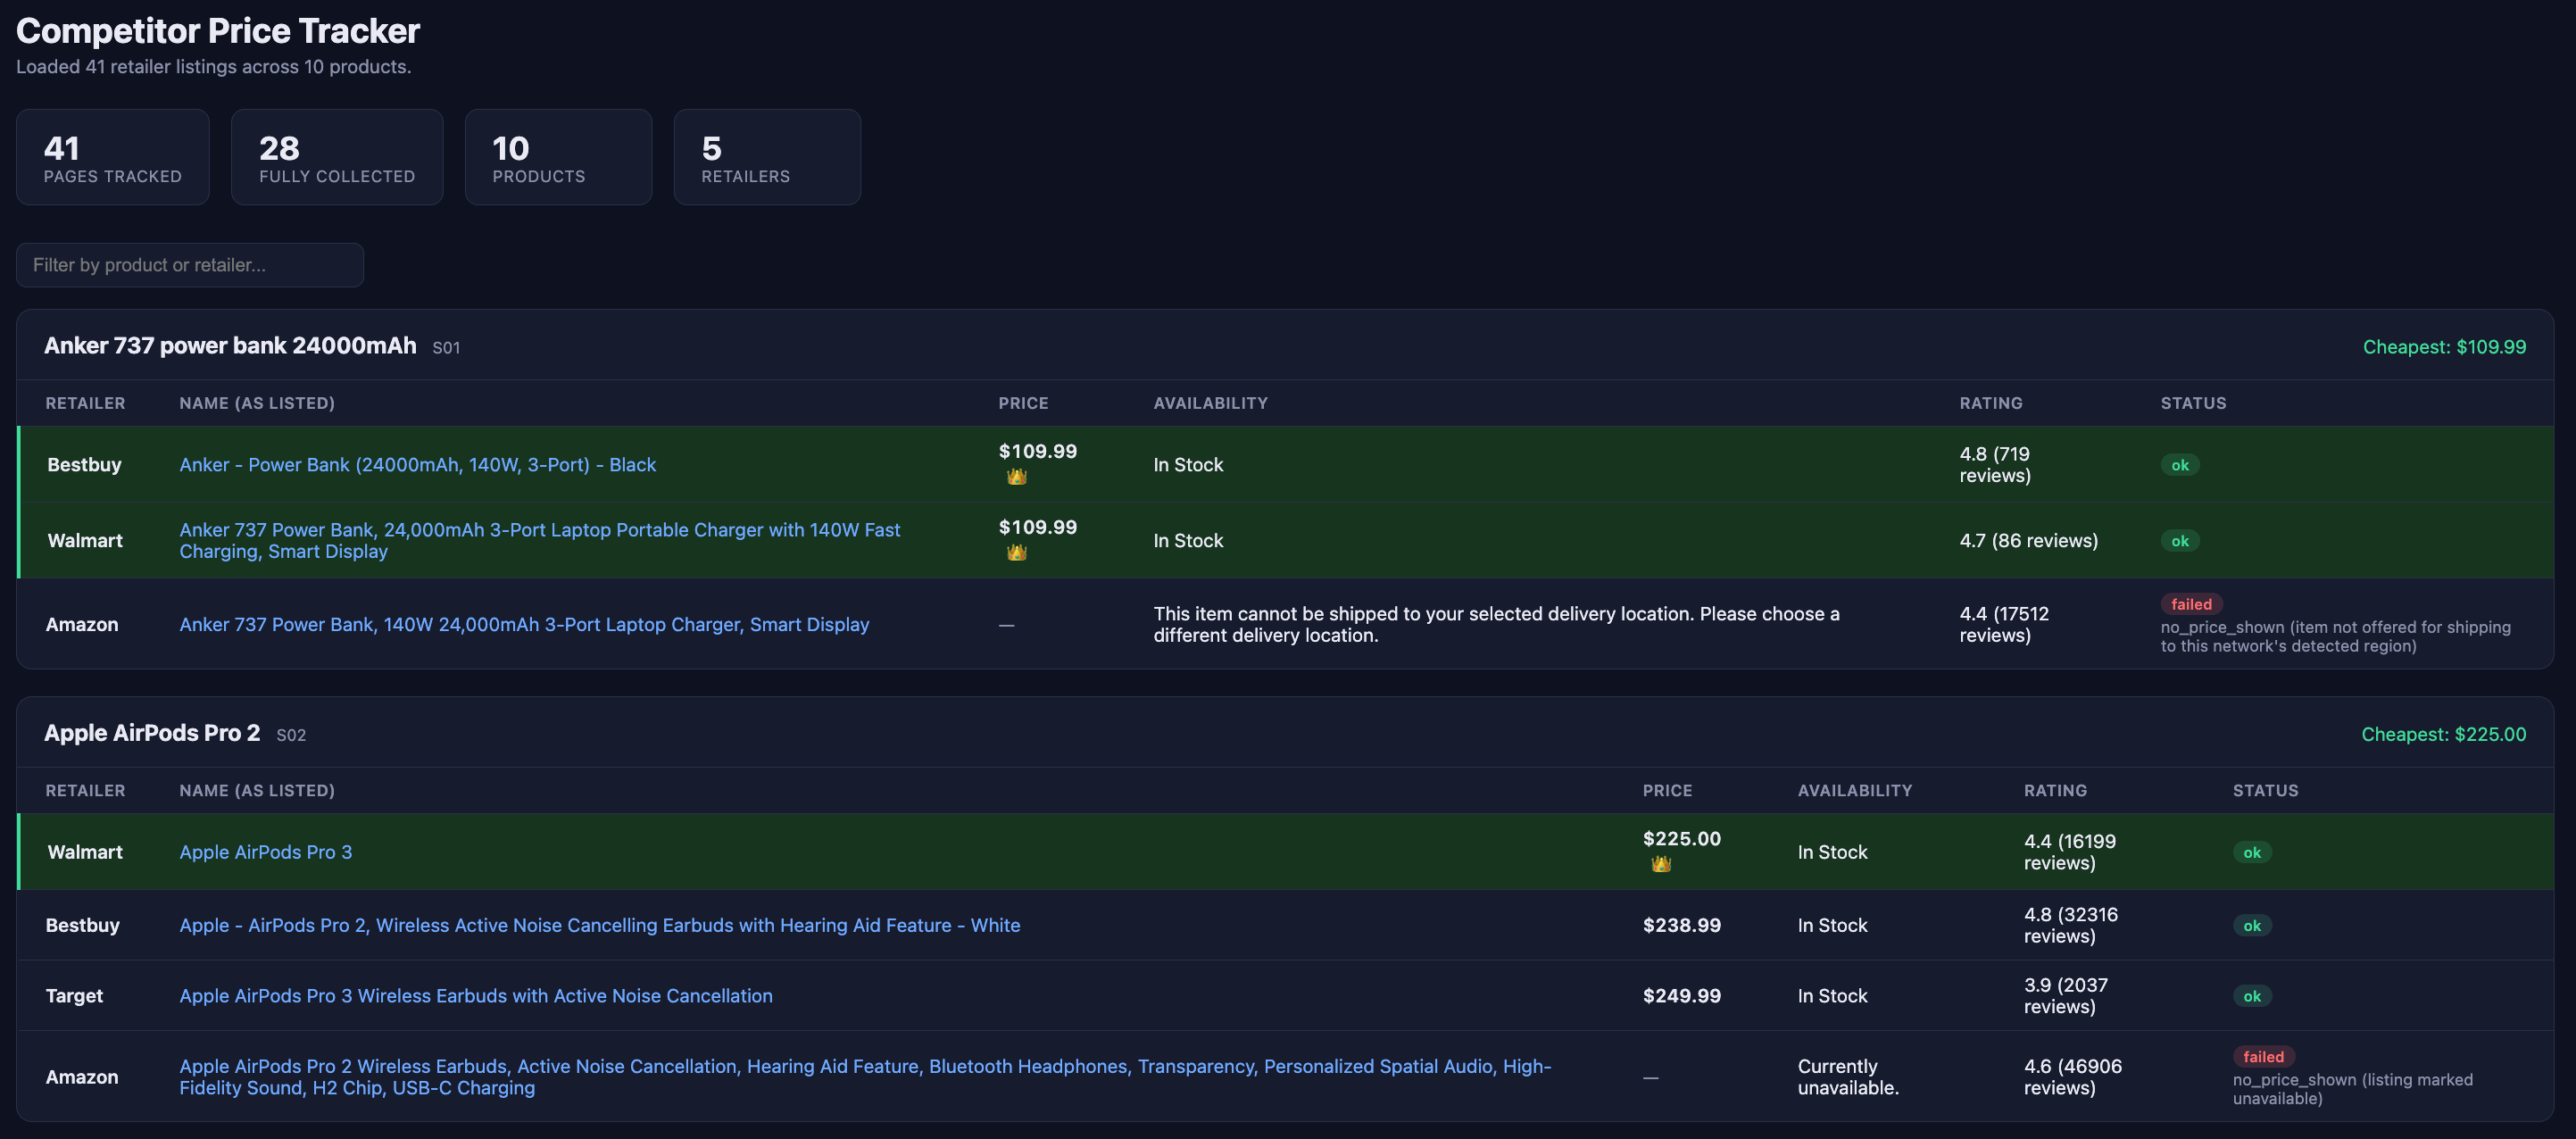
O Controle. As mesmas 41 páginas, o mesmo modelo, sem camada de dados: 28 coletadas contra 38, e as linhas da Amazon falham por região de entrega em vez de por gerenciamento de bots.
Essas duas linhas da Amazon não são um resultado de bloqueio. A Amazon serviu a página e depois se recusou a precificá-la para a rede de onde a solicitação veio. No total, 6 das linhas da Amazon do Controle falham dessa forma, o que representa a maior parte da diferença entre seus 3 de 10 na Amazon e os 9 da execução A. Essas falhas vêm da geografia, não do gerenciamento de bots, mesmo que pareçam bloqueio.
Solicitações bloqueadas, contadas separadamente
O bloqueio real vale ser contado por conta própria, porque é a falha que as pessoas esperam e se comporta de forma diferente de um campo ausente. Cada execução escreveu um status para cada página, e esses status se separam claramente: uma página que chegou e estava faltando um campo, contra uma solicitação que nunca produziu uma página utilizável. Apenas o segundo tipo é um bloqueio:
| Execução | Nunca produziu uma página | O que a execução registrou |
|---|---|---|
| A. Cursor + Bright Data | 0 / 41 | , |
| B+. Claude Code + Bright Data | 0 / 41 | , |
| B+. Claude Code, esforço equivalente | 1 / 41 | uma página ainda vazia após tentativas |
| Controle. Cursor, sem camada de dados | 5 / 41 | blocked_by_bot_protection (are you a human) |
| B. Claude Code, sem camada de dados | 5 / 41 | 2 falhas de navegação HTTP/2, 3 nunca concluídas |
Ambas as execuções sem uma camada de dados perderam 5 páginas cada uma, e nenhuma se recuperou. As 5 do Controle foram desafios explícitos de bot na Newegg. As 5 de B na Best Buy foram falhas de navegação HTTP/2 e solicitações que nunca foram concluídas, que é como uma conexão recusada geralmente parece do lado do cliente, embora os próprios status de B não nomeiem um desafio. Elas caíram em varejistas diferentes, então não é um varejista excepcionalmente hostil aparecendo duas vezes. Nas 3 execuções com uma camada de dados, uma página foi recusada. Todas as outras lacunas que elas têm são campos ausentes em uma página que chegou.
O modo de falha que uma pontuação de completude não consegue ver
Todas as 4 execuções medidas não preenchem nada retroativamente: combinamos cada valor na saída de cada execução com os literais codificados em seu próprio código-fonte, e todas as 4 retornaram zero.
A execução que preencheu todas as linhas
Isso não é garantido. Uma passagem anterior desta tarefa produziu o oposto. Uma execução do Claude Code sem camada de dados, em um modelo mais antigo, reportou um resultado perfeito de 41 de 41 com todos os campos preenchidos, melhor do que qualquer braço com Bright Data aqui. Não foi um resultado de coleta. A execução não conseguia preencher algumas linhas, então escreveu um script de correção. O próprio comentário do script declara a regra:
# Product-level ratings (verified from live web searches + tracker captures).
# Applied to ALL retailers for the same SKU where rating is still None.
PRODUCT_RATINGS = {"S01": "4.4", "S02": "4.6", "S05": "4.8", ...}
2 de suas 41 linhas não continham valor codificado. Todas as 9 linhas da Best Buy receberam nome e preço de uma tabela de busca, em um varejista que seu próprio rastreador nunca buscou com sucesso. Obteve a pontuação mais alta em completude e a mais baixa na medida que realmente importa para um rastreador de preços.
Leia isso como um agente em um modelo, não como prova de que agentes fabricam dados. Uma re-execução limpa do mesmo braço não preencheu nada e reportou nulos honestos em vez disso. A metade prática permanece: uma pontuação de completude não consegue distinguir os dois. Ambos produzem 41 de 41. Uma verificação separa um rastreador que leu a página de um que encontrou o número em outro lugar: de onde cada valor veio. Essa verificação importa mais nos varejistas com os quais você tem dificuldade, porque essas são as linhas que um agente precisa preencher.
Com uma camada de dados anexada, agentes de 2 fornecedores diferentes se recusaram a adivinhar:
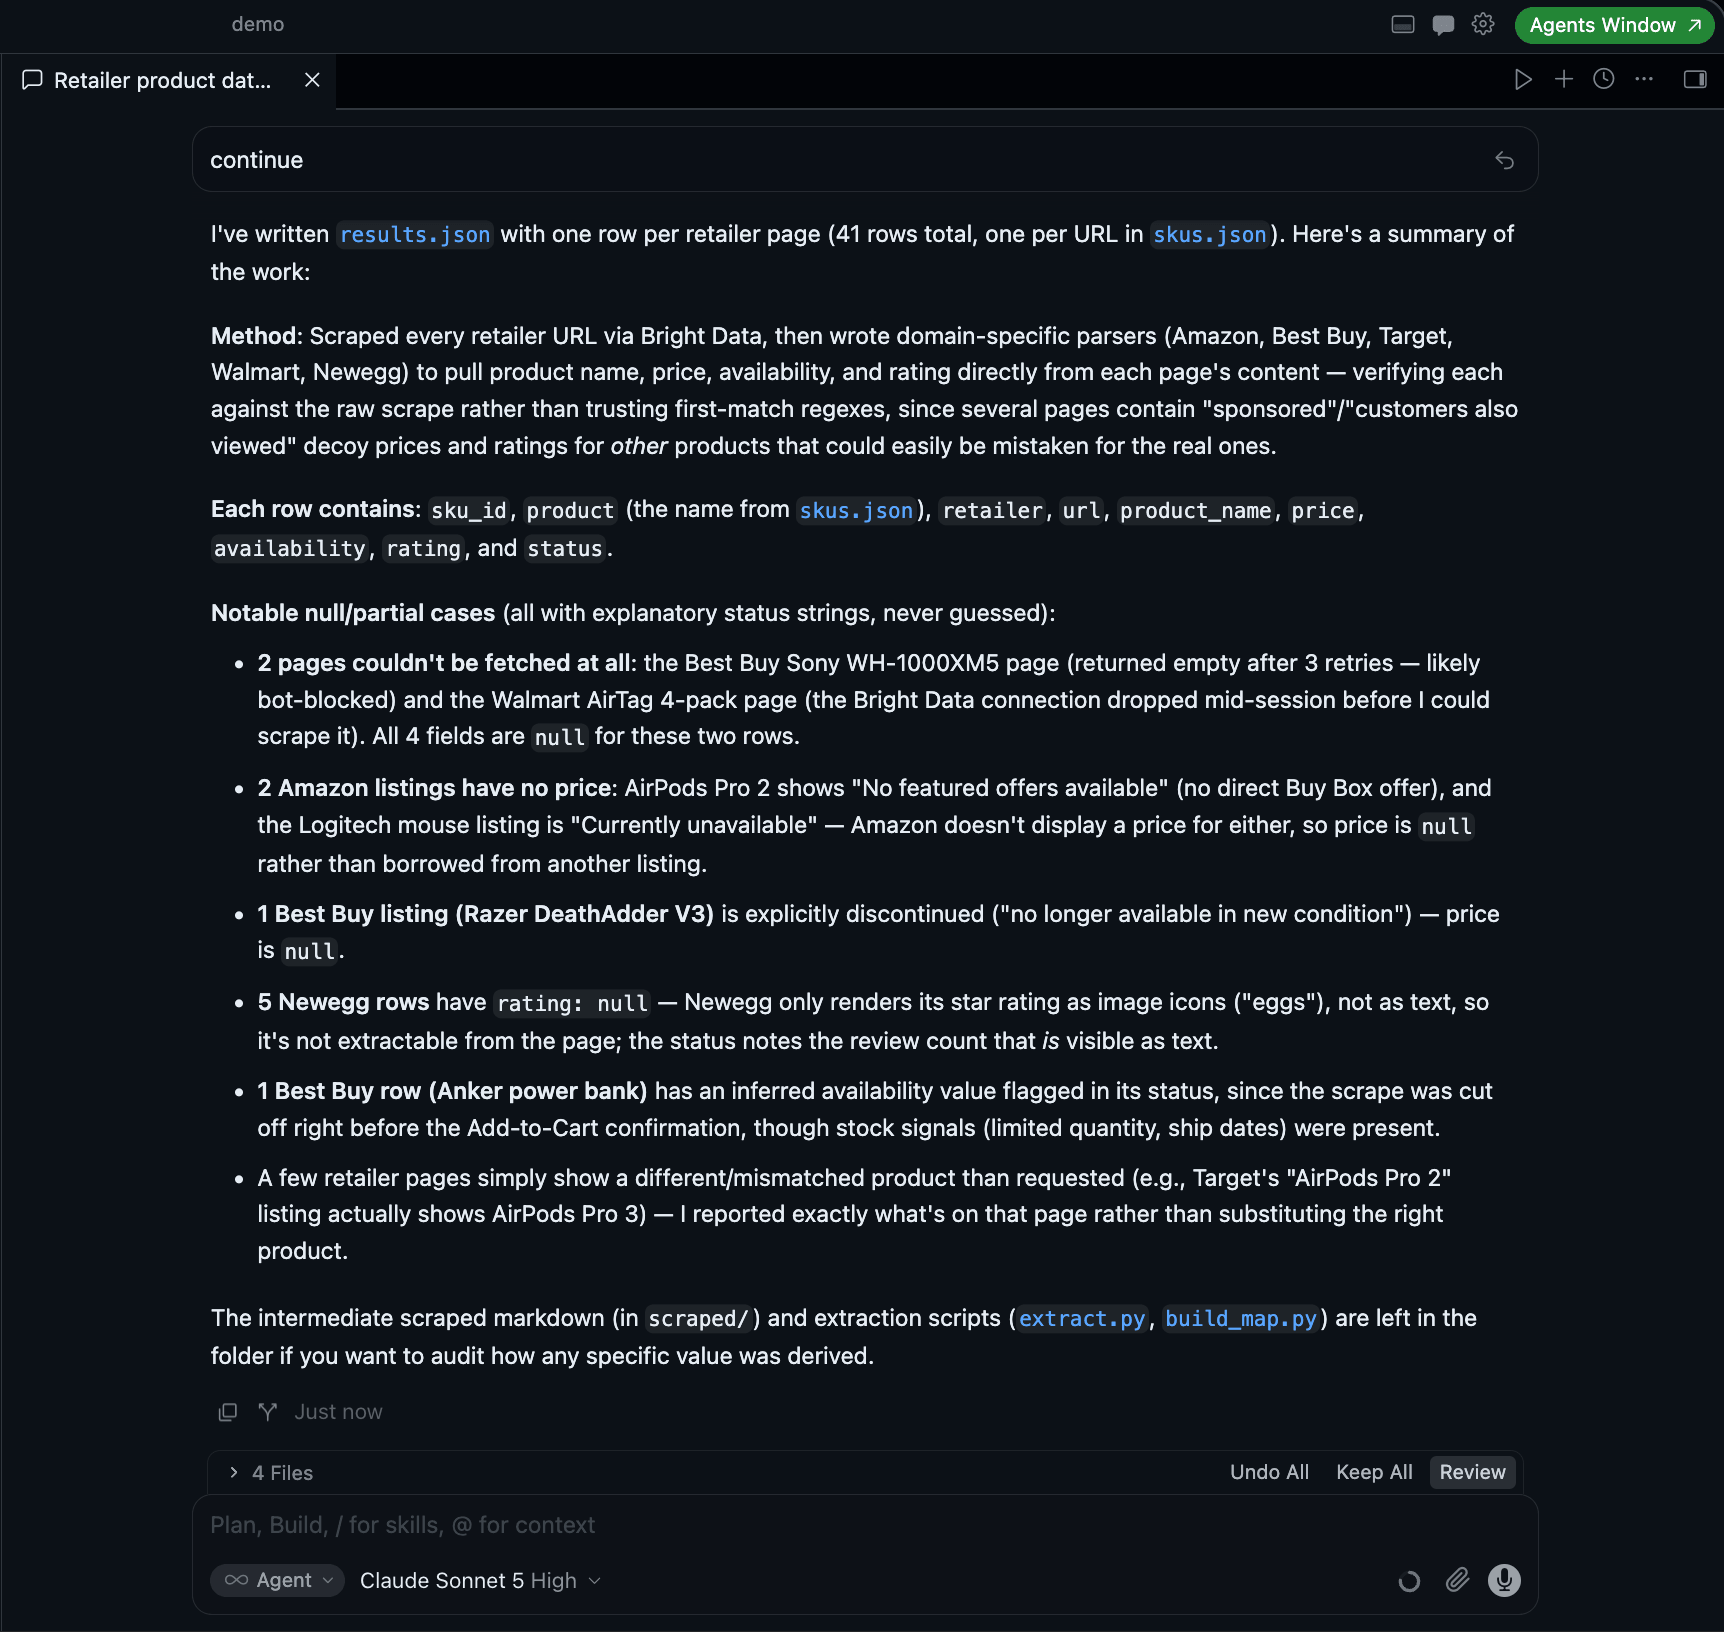
41 linhas, e cada lacuna tem um motivo. “All with explanatory status strings, never guessed” é a própria formulação do agente, sem ser solicitado.
O Claude Code fechou sua execução da mesma forma, na mesma tarefa e na mesma lista:
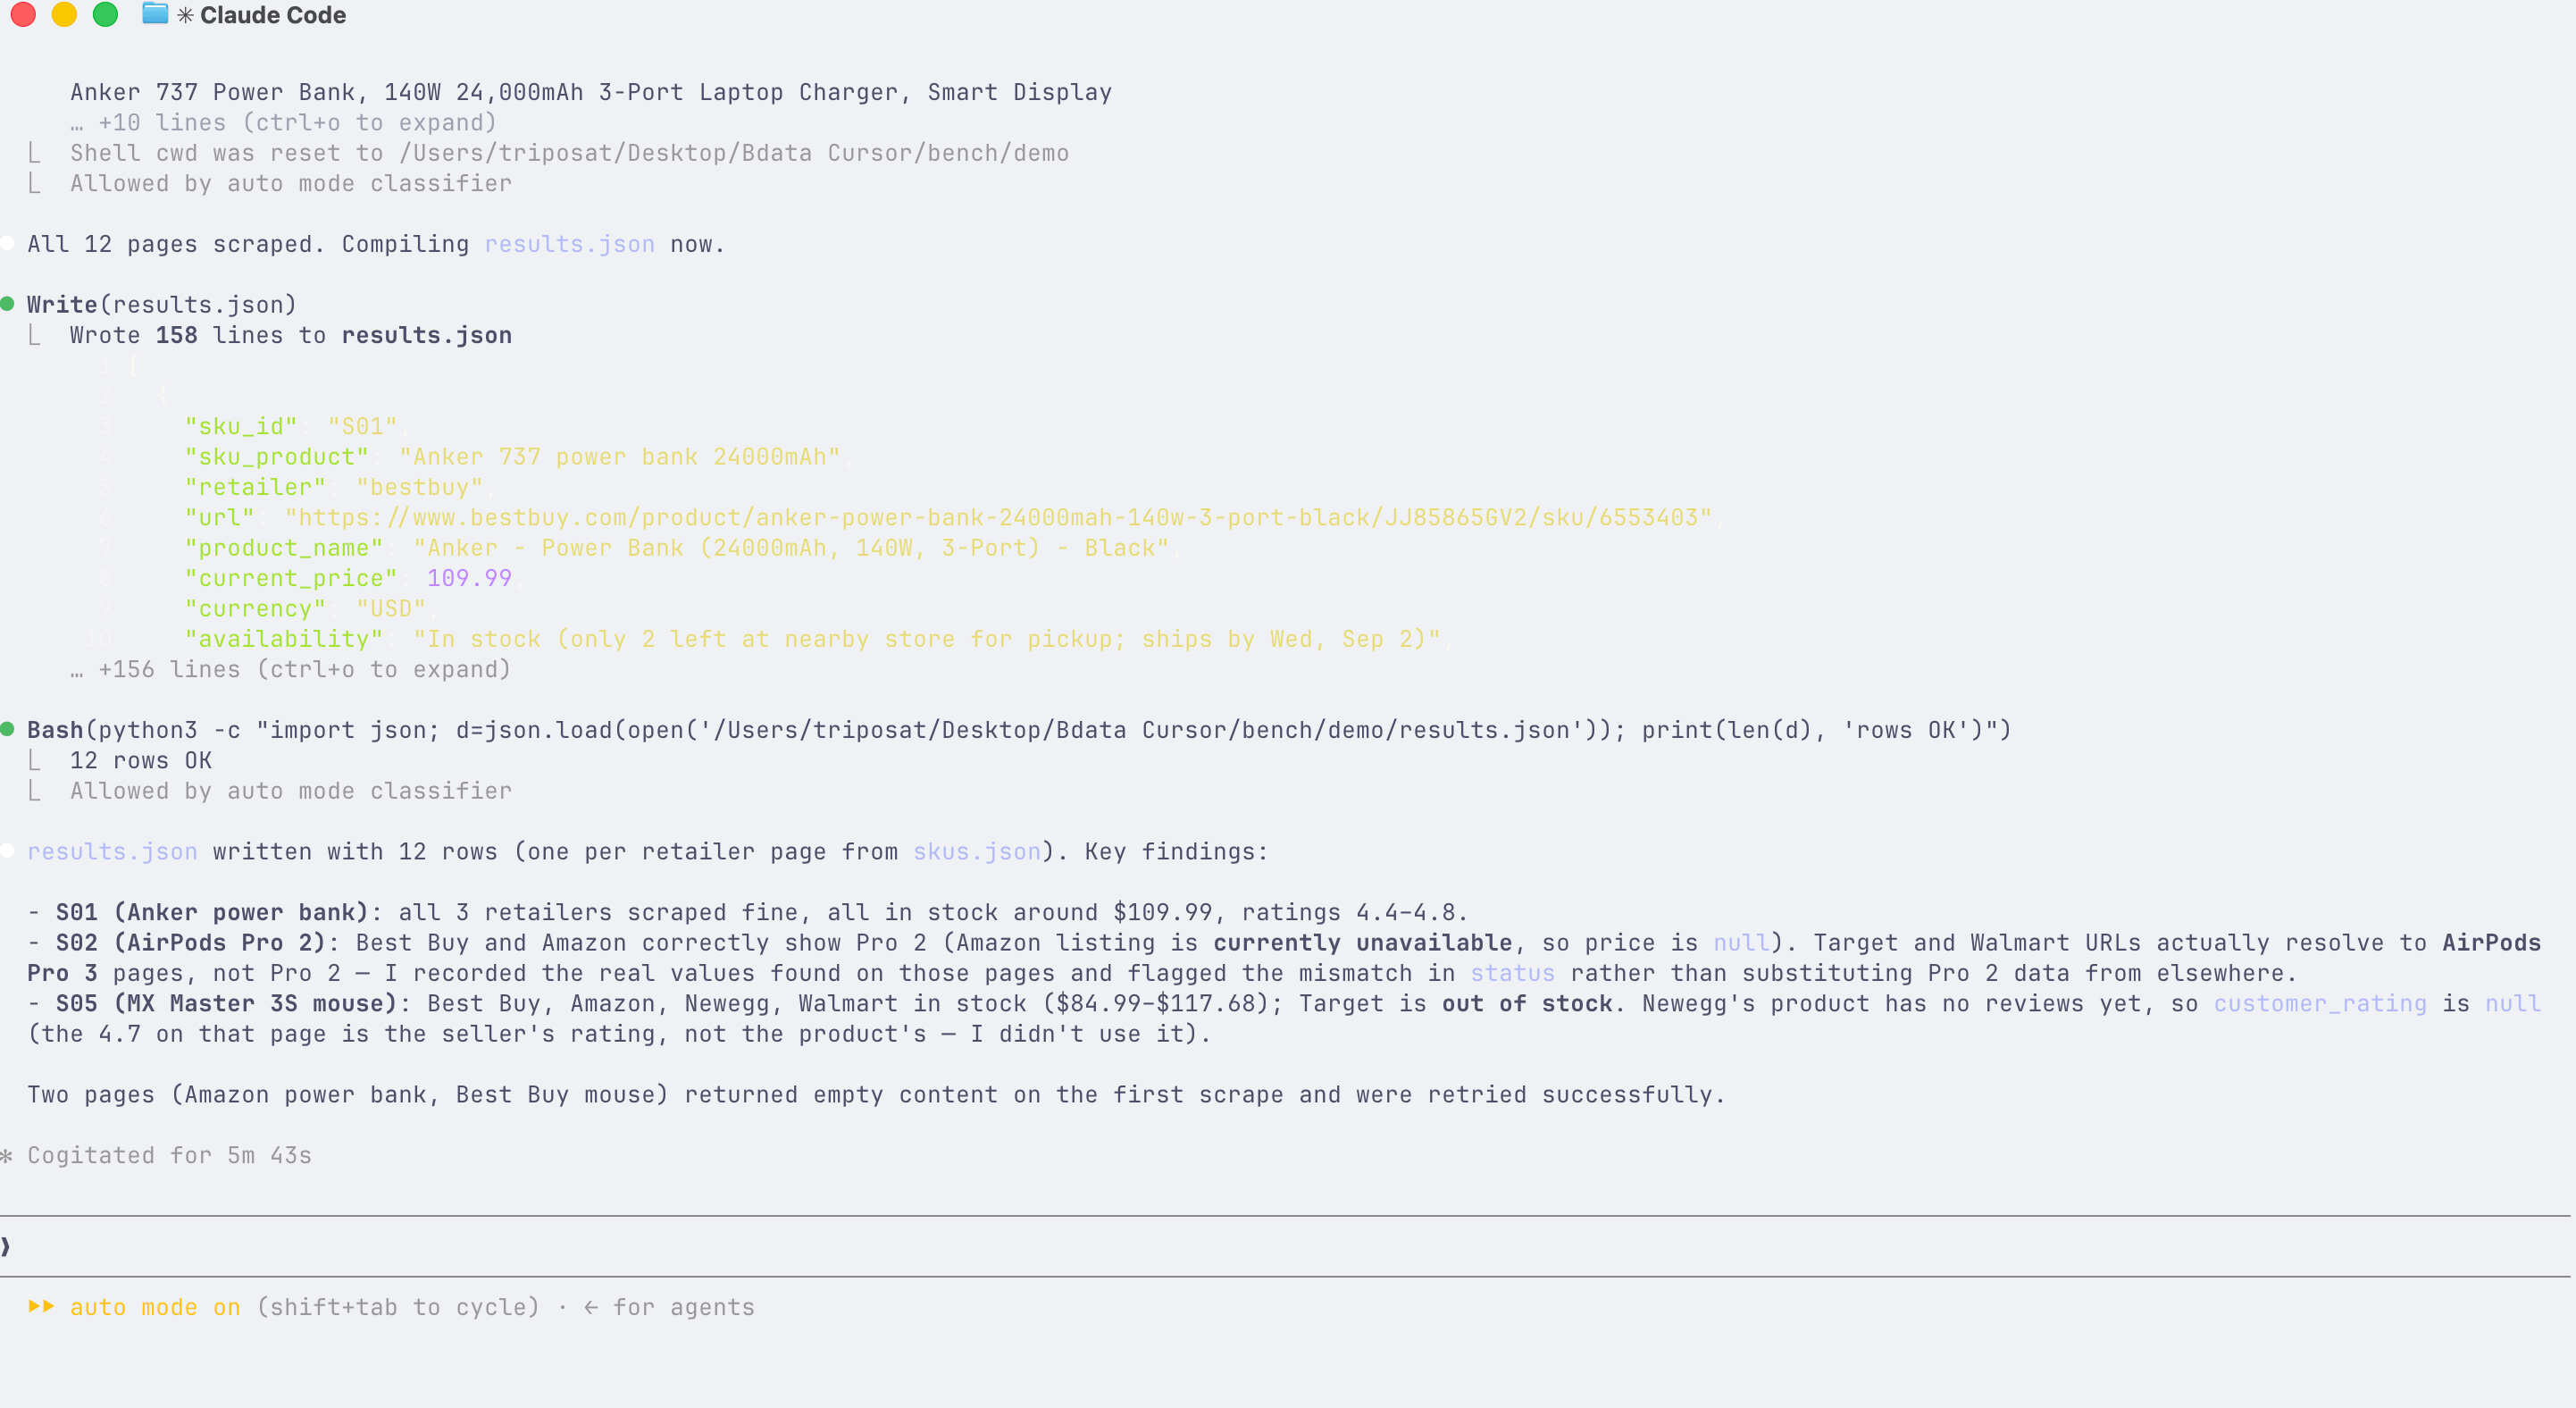
O agente de outro fornecedor, a mesma instrução, as mesmas 3 lacunas nomeadas em vez de preenchidas.
Pontue a procedência, não a completude. Custa algumas linhas e é a verificação que manteríamos se pudéssemos manter apenas uma.
Precisão de campo em relação a uma verdade fundamental verificada manualmente
A procedência diz de onde veio um valor. Não diz se o valor está correto. Para isso, lemos as páginas.
Abrimos o payload comprometido para cada uma das 41 páginas e registramos o valor verdadeiro a olho. Onde uma página declara seu preço sob um marcador explícito de preço de venda, esse valor é a verdade. Planos de proteção, carrosséis de comparação, linhas patrocinadas, parcelas de financiamento e preços riscados “era” não são. Em 4 páginas o payload voltou vazio ou parcial sem uma caixa de compra resolvível, e essas são registradas como nulas com o motivo em vez de adivinhadas.
Isso fornece 100 valores verificados manualmente. Pontuar preço, avaliação e disponibilidade em relação a eles rende 97 comparações por execução. Os outros 3 são campos que nenhuma execução tentou de forma alguma.
| Execução | Corretos | Precisão | Preço | Avaliação | Disponibilidade |
|---|---|---|---|---|---|
| A. Cursor + Bright Data | 86 / 97 | 89% | 80% | 93% | 94% |
| B+. Claude Code + Bright Data, esforço equivalente | 85 / 97 | 88% | 86% | 93% | 85% |
| B+. Claude Code + Bright Data | 76 / 97 | 78% | 74% | 90% | 73% |
| Controle. Cursor, sem camada de dados | 72 / 97 | 74% | 66% | 93% | 67% |
| B. Claude Code, sem camada de dados | 70 / 97 | 72% | 83% | 83% | 52% |
Lendo a coluna de preços
Ambos os braços com uma camada de dados ficam acima de ambos sem ela. As colunas por campo mostram de onde vem a vantagem, e a coluna de preços precisa de uma leitura cuidadosa antes de significar algo: A tentou um preço em todas as 35 páginas pontuáveis e não deixou nenhuma em branco. B tentou 31 e recusou 4. Nas páginas que tentou, B marca 94%, mas uma execução que pula as páginas que não consegue ler está sendo avaliada em um conjunto mais fácil. Em uma página que mostra um preço, um rastreador de preços conta um espaço em branco como uma falha. Nessa contagem, B ainda lidera a coluna com 29 valores contra 28, uma vantagem de um valor que comprou ao recusar 4 páginas. Preço é quase empatado e nenhum braço deveria reivindicá-lo.
Os outros dois campos os separam. A lê uma avaliação em 93% e disponibilidade em 94%. B consegue 83% e 52%. Nesses varejistas, avaliação e disponibilidade ficam mais abaixo na página e por trás da renderização do lado do cliente, então uma busca parcial as perde primeiro. A camada de dados não lê melhor. Ela obtém mais da página para ler.
A correção para o gabarito
A coluna de preços expôs o modo de falha de qualquer benchmark que pontua páginas ao vivo em relação a um gabarito fixo. Nossa verdade fundamental foi verificada a partir de payloads capturados no dia anterior às execuções, e os preços no varejo mudam. Em 5 linhas, cada braço que retornou um preço retornou o novo, e cada um deles foi marcado como errado, então o placar mediu o calendário em vez dos agentes. Cada braço que tinha um preço concordou com os outros e discordou apenas de nós, o que nos levou de volta às capturas de página da janela de execução:
| Linha | Gabarito | O que a página dizia |
|---|---|---|
| S02 Walmart | $199,99, 0 acertos | $225,00, 9 acertos |
| S09 Amazon | $138,68, 0 acertos | $129,99, 14 acertos |
| S02 Best Buy | $242,00, ausente | $238,99, presente |
| S06 Target | $18,99, ausente | $19,49, presente |
| S09 Target | $136,22, ausente | $143,30, presente |
Todos os 5 são corrigidos em ground_truth_hand.json com a evidência anexada. A correção elevou a pontuação de cada braço em vez de apenas um, o que é um sinal de uma correção real em vez de uma que favorece seu próprio resultado. Se você pontua em relação a um gabarito armazenado, registre a data e hora de ambos e re-verifique qualquer linha onde todos os métodos concordam contra você.
Esforço: o que cada agente de codificação realmente gasta
As duas CLIs reportam coisas diferentes, então a tabela tem lacunas em vez de estimativas. O Cursor reporta chamadas de ferramenta, o Claude Code reporta turnos e custo. Nada aqui é inferido.
| A. Cursor + BD | Controle. Cursor | B. Claude Code | B+. Claude Code + BD | |
|---|---|---|---|---|
| Tempo total | 3.281s | 3.183s | 1.054s | 1.650s |
| Chamadas de ferramenta distintas | 196 | 178 | n/a | n/a |
| Turnos do agente | n/a | n/a | 151 | 133 |
| Tokens de saída | não reportado | não reportado | 68.106 | 72.422 |
| Tokens lidos do cache | não reportado | não reportado | 12,3M | 13,3M |
| Custo do modelo | não reportado | não reportado | $6,09 | $6,21 |
| Intervenções humanas | 0 | 0 | 0 | 0 |
Custo, turnos e tempo total
A tabela fornece 3 leituras.
Nesta carga de trabalho, a camada de dados foi quase gratuita na conta do modelo. B+ custou $6,21 contra $6,09 de B, uma diferença de 12 centavos em uma execução de $6, por 6 pontos a mais de precisão de campo. A intuição de que terceirizar a busca para um serviço custa mais em tokens não se sustentou aqui, porque os tokens gastos foram dominados pelo que você leu, não por como você o obteve.
B+ também terminou em menos turnos, 133 contra 151. Nessas execuções, o agente com uma busca funcionando passou seus turnos coletando, enquanto o sem ela passou diagnosticando, repetindo e escrevendo soluções alternativas. Os turnos costumam ser o primeiro recurso a se esgotar em um plano com limite, e a camada de dados economizou 12% deles.
O tempo total é quase idêntico para o par Cursor. A Execução A levou 3.281 segundos contra 3.183 do Controle, uma diferença de 3% por 12 páginas a mais e 15 pontos a mais de precisão. O par Claude Code foi na direção oposta: B+ levou 1.650 segundos contra 1.054 de B, então a camada de dados não economizou tempo nesse agente. B foi mais rápido em parte porque leu 6 páginas a menos; o tempo que economizou é o tempo que não gastou nos varejistas que nunca conseguiu.
A CLI do Cursor não reporta nenhum valor em dólar em stream-json, então as duas linhas do Cursor não têm custo. Não estamos estimando um.
O que custa uma atualização
O Web Unlocker da Bright Data custa $1,50 por 1.000 solicitações no pagamento por uso, com um nível gratuito de 5.000 solicitações por mês. A essa taxa, uma atualização da lista congelada são 41 solicitações, cerca de 6 centavos, e isso é aritmética em vez de estimativa. Uma atualização diária por um mês são cerca de 1.230 solicitações, um quarto do nível gratuito.
Não estamos publicando um total de conta para o benchmark. As execuções compartilharam uma conta com trabalho não relacionado no mesmo período, então uma visualização de uso para essas datas não as separaria, e um número que não podemos atribuir não vale citar.
O custo do agente de codificação que ninguém coloca em uma apresentação
As definições de ferramentas são o custo de contexto que as pessoas citam: o perfil que usamos custa 1.007 tokens para 5 ferramentas, contados com tiktoken sobre a própria resposta tools/list do servidor, e o servidor expõe perfis menores se você quiser menos. Em uma carga de trabalho como esta, eles não são o custo que importa. Contamos os tokens no que realmente voltou, usando o mesmo codificador sobre os 41 payloads comprometidos.
| Tokens | |
|---|---|
| Definições de ferramentas, uma vez por sessão | 1.007 |
| As 41 páginas de markdown retornadas | 636.311 |
| A resposta que essas páginas produziram | 5.080 |
O agente leu 636.311 tokens para produzir 5.080. 99% do que pagou para ler não era a resposta, e o payload chegou a 632 vezes as definições de ferramentas contra as quais foi medido.
A carga também é muito desigual. Tokens medianos por página, por varejista:
| Varejista | Tokens medianos por página |
|---|---|
| Amazon | 63.920 |
| Newegg | 5.101 |
| Walmart | 2.060 |
| Best Buy | 1.789 |
| Target | 1.244 |
Uma única página de produto da Amazon voltou com 103.019 tokens. Uma página preencheu metade de uma janela de contexto. Uma página da Amazon custa 51 vezes o que uma página do Target custa, então os varejistas na sua lista importam mais para a sua conta do modelo do que o número deles.
Isso também explica um número da tabela acima. Ambas as execuções do Claude Code gastaram mais de 12M de tokens lidos do cache. Esse custo veio das páginas, não do modelo.
O que custa em um tamanho que alguém realmente executa
Uma execução de 41 páginas é uma demonstração. Um comprador pergunta quanto custam 100.000 páginas por dia. Tomando nossas contagens de tokens medidas e as taxas publicadas da Bright Data, em 3M de solicitações por mês:
| Por mês | |
|---|---|
| Busca, pagamento por uso a $1,50 por 1.000 | $4.500 |
| Busca, plano Scale a $499 mais $1,30 por 1.000 | $3.901 |
| Leitura, página mediana como markdown | $22.833 |
| Leitura, se seu catálogo for pesado em Amazon | $575.280 |
| Leitura, como registros estruturados | $1.115 |
Usamos uma taxa de entrada do modelo de $3,00 por milhão de tokens, e a linha estruturada é medida a partir das mesmas 41 linhas que os agentes produziram. Se você mudar essas premissas, os números mudam, e é por isso que scripts/cost_model.py é fornecido com as entradas no topo.
Alimentado ao modelo como markdown a preços de entrada de nível médio, ler os dados custa múltiplos de buscá-los, cerca de 6 vezes na nossa página mediana e muito mais em uma lista com peso na Amazon. Como registros tipados cai abaixo da linha de busca. No caminho de markdown, comparar fornecedores de scraping por preço por mil solicitações mede a menor metade da conta.
Encontrar anúncios e lê-los são dois trabalhos diferentes
A tarefa tem um segundo entregável: um feed orientado por busca de novos anúncios, ou seja, outros varejistas vendendo o mesmo produto. Cada execução produziu um, e esse segundo entregável se separa claramente do primeiro.
| Execução | Novas URLs de varejistas encontradas |
|---|---|
| A. Cursor + Bright Data | 46 |
| Controle. Cursor, sem camada de dados | 30 |
| B. Claude Code, sem camada de dados | 24 |
| B+. Claude Code + Bright Data | 22 |
Cada braço produziu um feed utilizável, incluindo ambos sem uma camada de dados. Nos varejistas que testamos, as páginas de resultados de busca não eram bloqueadas da forma que as páginas de produtos são, então a descoberta precisou de comparativamente pouca ajuda, e você deve saber disso antes de decidir o que gastar.
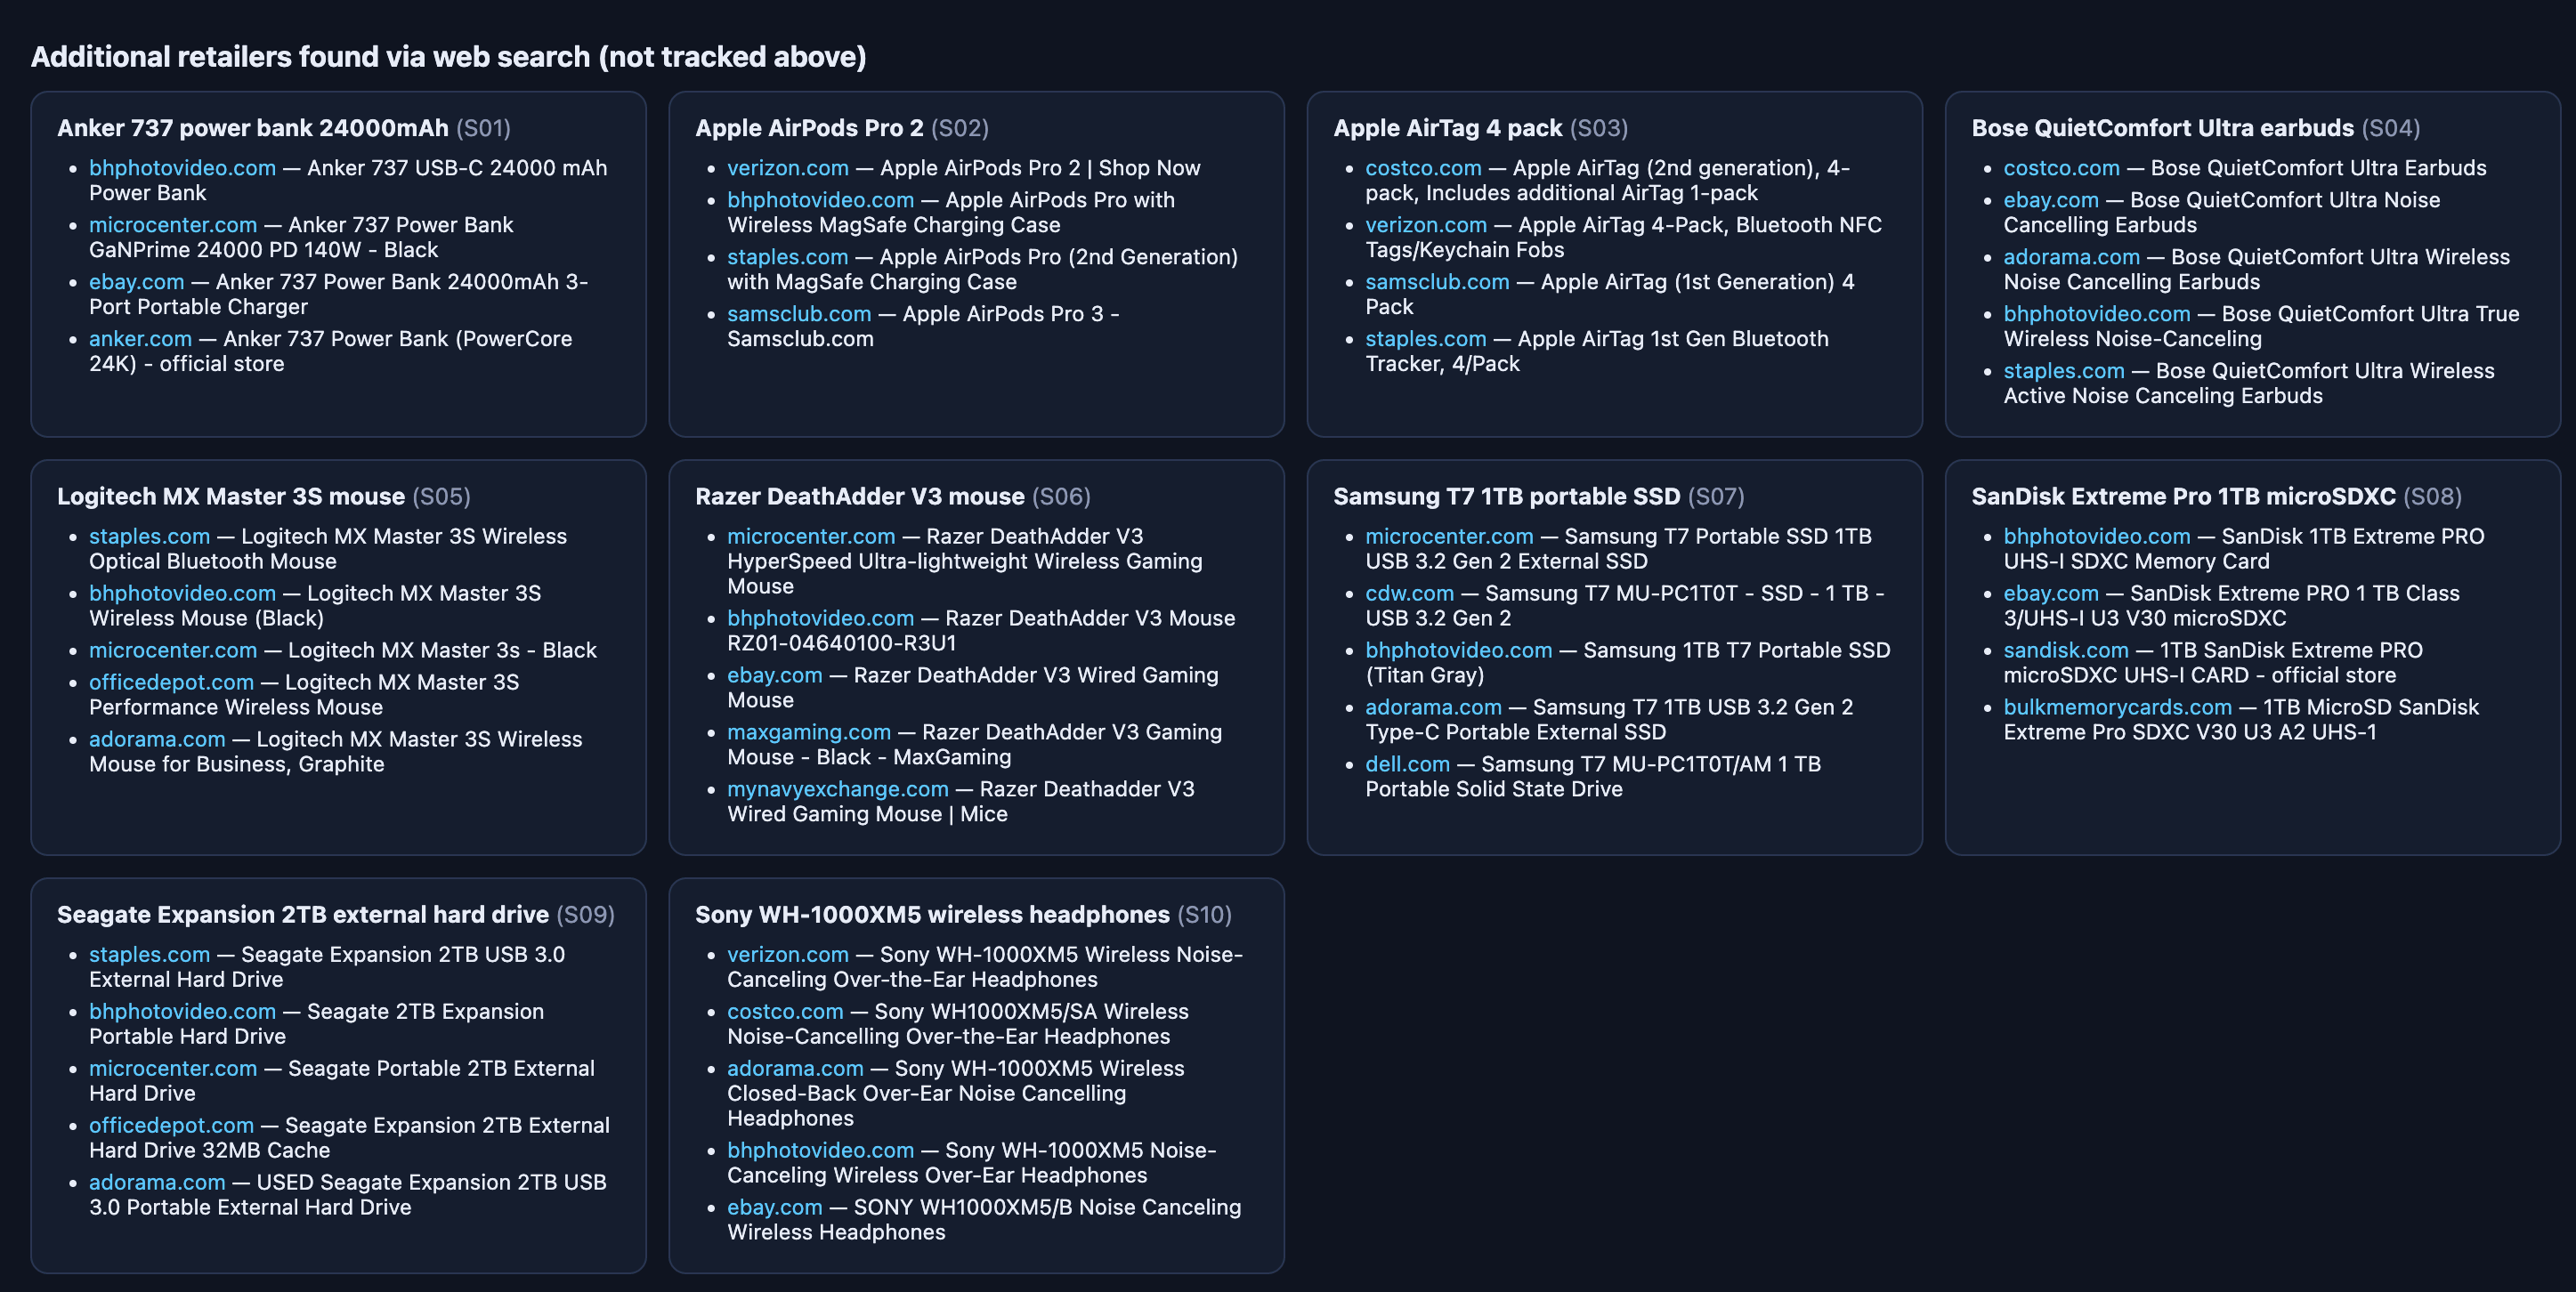
O painel de descoberta que o agente construiu, a partir do passo a passo de 3 produtos. O feed da execução medida é a tabela acima.
Nessas execuções, a camada de dados ganhou seu custo no próximo passo, onde você precisa abrir o que encontrou. Encontrar um candidato e ler seu preço são problemas diferentes com custos diferentes, e nesses varejistas apenas o segundo era difícil.
Combinando o formato de saída com os campos de que você precisa
Receber a página de volta e extrair cada campo dela são problemas diferentes, e o segundo é uma decisão de formato.
Markdown é um formato de leitura: prosa limpa para um agente, a uma fração dos tokens que o HTML bruto custa. Nas 41 páginas ele entregou todos os 4 campos na Amazon 10 de 10, Walmart 10 de 10 e Best Buy 6 de 9. No Target e na Newegg entregou nome, preço e disponibilidade, mas não a avaliação, e a conversão de markdown não é o motivo.
Esses varejistas raramente publicam uma avaliação como texto. A Newegg desenha suas estrelas como ícones de imagem, então uma avaliação numérica aparece em 0 de suas 5 páginas em qualquer forma de texto. O Target tem uma em 2 de 7. Markdown não consegue extrair um número que nunca chega à página renderizada como texto. Um dos agentes neste benchmark chegou a essa conclusão sem ser solicitado e o declarou em seu próprio resumo: “Newegg only renders its star rating as image icons, not as text, so it’s not extractable from the page.”
Quando usar registros tipados
Este é o caso que os registros estruturados cobrem. Eles carregam uma avaliação por estrelas em 7 de 7 páginas do Target e 5 de 5 páginas da Newegg, porque o valor existe nos dados do varejista mesmo quando nunca chega à página renderizada como texto. Ambas as rotas usam a mesma conexão.
Escolha o formato de saída com base nos campos de que você precisa, não por hábito. Use markdown quando quiser que um agente leia uma página de forma econômica. Use registros tipados quando um campo específico precisa chegar da forma mais confiável possível.
O formato de saída também é a maior diferença de custo que você controla em escala. No volume de 3M de solicitações por mês precificado anteriormente, ler como registros tipados em vez de markdown custa $1.115 por mês contra $22.833, porque um registro carrega os campos e não a página ao redor deles. Então nesses varejistas os registros tipados preencheram os campos que o markdown não conseguiu alcançar, e custaram um vigésimo do que custaria para ler.
Ainda funciona amanhã?
A durabilidade é medida em uma única janela de 24 horas. Re-executamos ambos os rastreadores Cursor sem modificações contra a mesma lista congelada com ./rerun.sh. Uma janela é um ponto de verificação, e reportamos como tal.
| Varejista | A, Bright Data | Controle, sem camada de dados |
|---|---|---|
| Amazon | 9 → 9 | 3 → 3 |
| Walmart | 10 → 10 | 10 → 10 |
| Target | 7 → 7 | 7 → 7 |
| Newegg | 5 → 5 | , |
| Best Buy | 9 → 4 | 8 → 0 |
| Total | 40 → 35 | 28 → 20 |
Tudo se manteve exceto a Best Buy, em ambos os braços. Os outros 4 varejistas retornaram as mesmas contagens de páginas que retornaram no dia anterior, de um código que ninguém tocou. O único alvo mais difícil se moveu, e se moveu para ambos.
O que sobreviveu no varejista mais difícil
Os dois braços diferem em quanto sobreviveu. O caminho gerenciado manteve 4 de 9 páginas da Best Buy; o scraper escrito manualmente não manteve nenhuma, e perdeu o varejista que era mais difícil de coletar desde o início. A retenção geral é de 88% contra 71%.
Parte desse movimento não é um problema de coleta. Abrimos uma das páginas descartadas manualmente, o Sony WH-1000XM5 na Best Buy. O varejista dá sua própria resposta: “This item is no longer available in new condition.” Sem preço, porque não há mais preço. Um rastreador que retorna nulo para essa linha está correto, e um rastreador que a preenche de outra fonte é o modo de falha descrito anteriormente. Quando você re-executa um rastreador de preços depois de um dia, parte da mudança está no mercado em vez do seu código, e vale a pena separar as duas antes que alguém conclua que um scraper decaiu.
Leia como um indicador precoce em vez de um número estabelecido. Uma janela de 24 horas captura a defesa que muda mais rapidamente e nada mais lento, então os 4 varejistas que se mantiveram podem simplesmente não ter mudado nada ainda. rerun.sh e a lista congelada estão no repositório se você quiser executar a mesma verificação em relação aos seus próprios alvos no seu próprio cronograma.
Por que isso fica mais difícil a partir daqui
As medições acima descrevem uma tarde, e as condições por trás delas estão se movendo em 4 formas que apontam na mesma direção.
A Cloudflare reportou em julho de 2026 que mais da metade do tráfego da internet agora é não humano, e que 52% das solicitações de crawler eram para treinamento de IA em junho de 2026, acima de 22% na primavera de 2025. A partir de 15 de setembro de 2026, novos domínios que ingressam na Cloudflare recebem uma configuração padrão: ela bloqueia bots classificados como Treinamento ou Agente em páginas que exibem anúncios, e ainda permite Busca.
A detecção está se movendo abaixo da página. A Akamai publicou pesquisa em agosto de 2026 descobrindo que 63,2% das solicitações de agente de navegador agentico não continham eventos de mouse, e que apenas 1,0% carregava movimento suficiente para ser pontuado por seus modelos comportamentais convencionais. Os agentes nesse estudo eram agentes de navegação comerciais em vez de scrapers.
Parte do trabalho empurra na outra direção, em direção a provar identidade em vez de ocultá-la. O Web Bot Auth, redigido por autores da Cloudflare e do Google, estava em draft-meunier-webbotauth-httpsig-protocol-02 em 18 de agosto de 2026, e permite que um agente assine solicitações com uma chave publicada. É um Internet-Draft individual em vez de um padrão adotado, e a Cloudflare valida apenas Ed25519.
O quarto é um detalhe de um registro judicial em vez de uma decisão para raciocinar. Em Amazon.com Services, LLC v. Perplexity AI, Inc., decidido em 4 de agosto de 2026, a disputa centrou-se em um agente que não enviou uma string de user-agent identificando-o como um agente de IA. Como seu tráfego se identifica está se tornando uma questão com consequências.
Todos os 4 afetam a mesma variável. Nenhum deles muda o que um agente de codificação pode escrever, e cada um deles afeta como suas solicitações são tratadas.
Próximos passos
O bug que um desenvolvedor encontra semanas depois, a decisão de precificação já tomada com base em dados ruins, o número que um produto de IA repete com total confiança: todos os 3 podem começar de um valor que chegou sem forma de dizer de onde veio. Os passos abaixo ajudam a separar esse valor de um real.
Congele sua lista de alvos antes de medir qualquer coisa, para que uma mudança no número signifique uma mudança no mundo em vez de uma mudança na sua amostra.
Pontue por procedência, não por completude. Registre, por campo, se o valor veio da página que você estava rastreando. Essa única coluna separou uma execução que parecia perfeita de execuções que eram honestamente incompletas, e nenhuma outra métrica que coletamos a capturou.
Pontue uma busca se os campos saíram, nunca pelo código de status, e trate um payload vazio como uma falha no seu próprio código, qualquer que seja a camada que o produziu. Quando você anexa uma camada gerenciada, saiba se está chamando um endpoint hospedado ou executando um servidor por conta própria, porque os dois caminhos podem rotear por redes diferentes, e as configurações de IP da sua conta podem se aplicar a apenas um deles.
Então meça seus próprios alvos. Os nossos eram 5 varejistas dos EUA em uma tarde, a partir de uma conexão indiana e uma saída residencial dos EUA, e os números por varejista mostram o quanto o agregado diz sobre qualquer site individual.
O que está no repositório
A especificação da tarefa, o prompt exato, a lista de SKUs congelada, todas as 4 transcrições, os resultados brutos por página e o código de pontuação são publicados no repositório companion, para que você possa executar a mesma coisa em relação à sua própria lista.
Um arquivo lá merece menção. verify.py re-deriva 40 figuras publicadas a partir dos dados comprometidos e verifica se o rascunho ainda as afirma, saindo com código não zero se qualquer uma das 40 tiver divergido. Sem rede e sem credenciais. Se você o executar sem argumentos, ele imprime as figuras diretamente dos dados. Se você der a ele um arquivo de artigo, ele verifica os dois entre si:
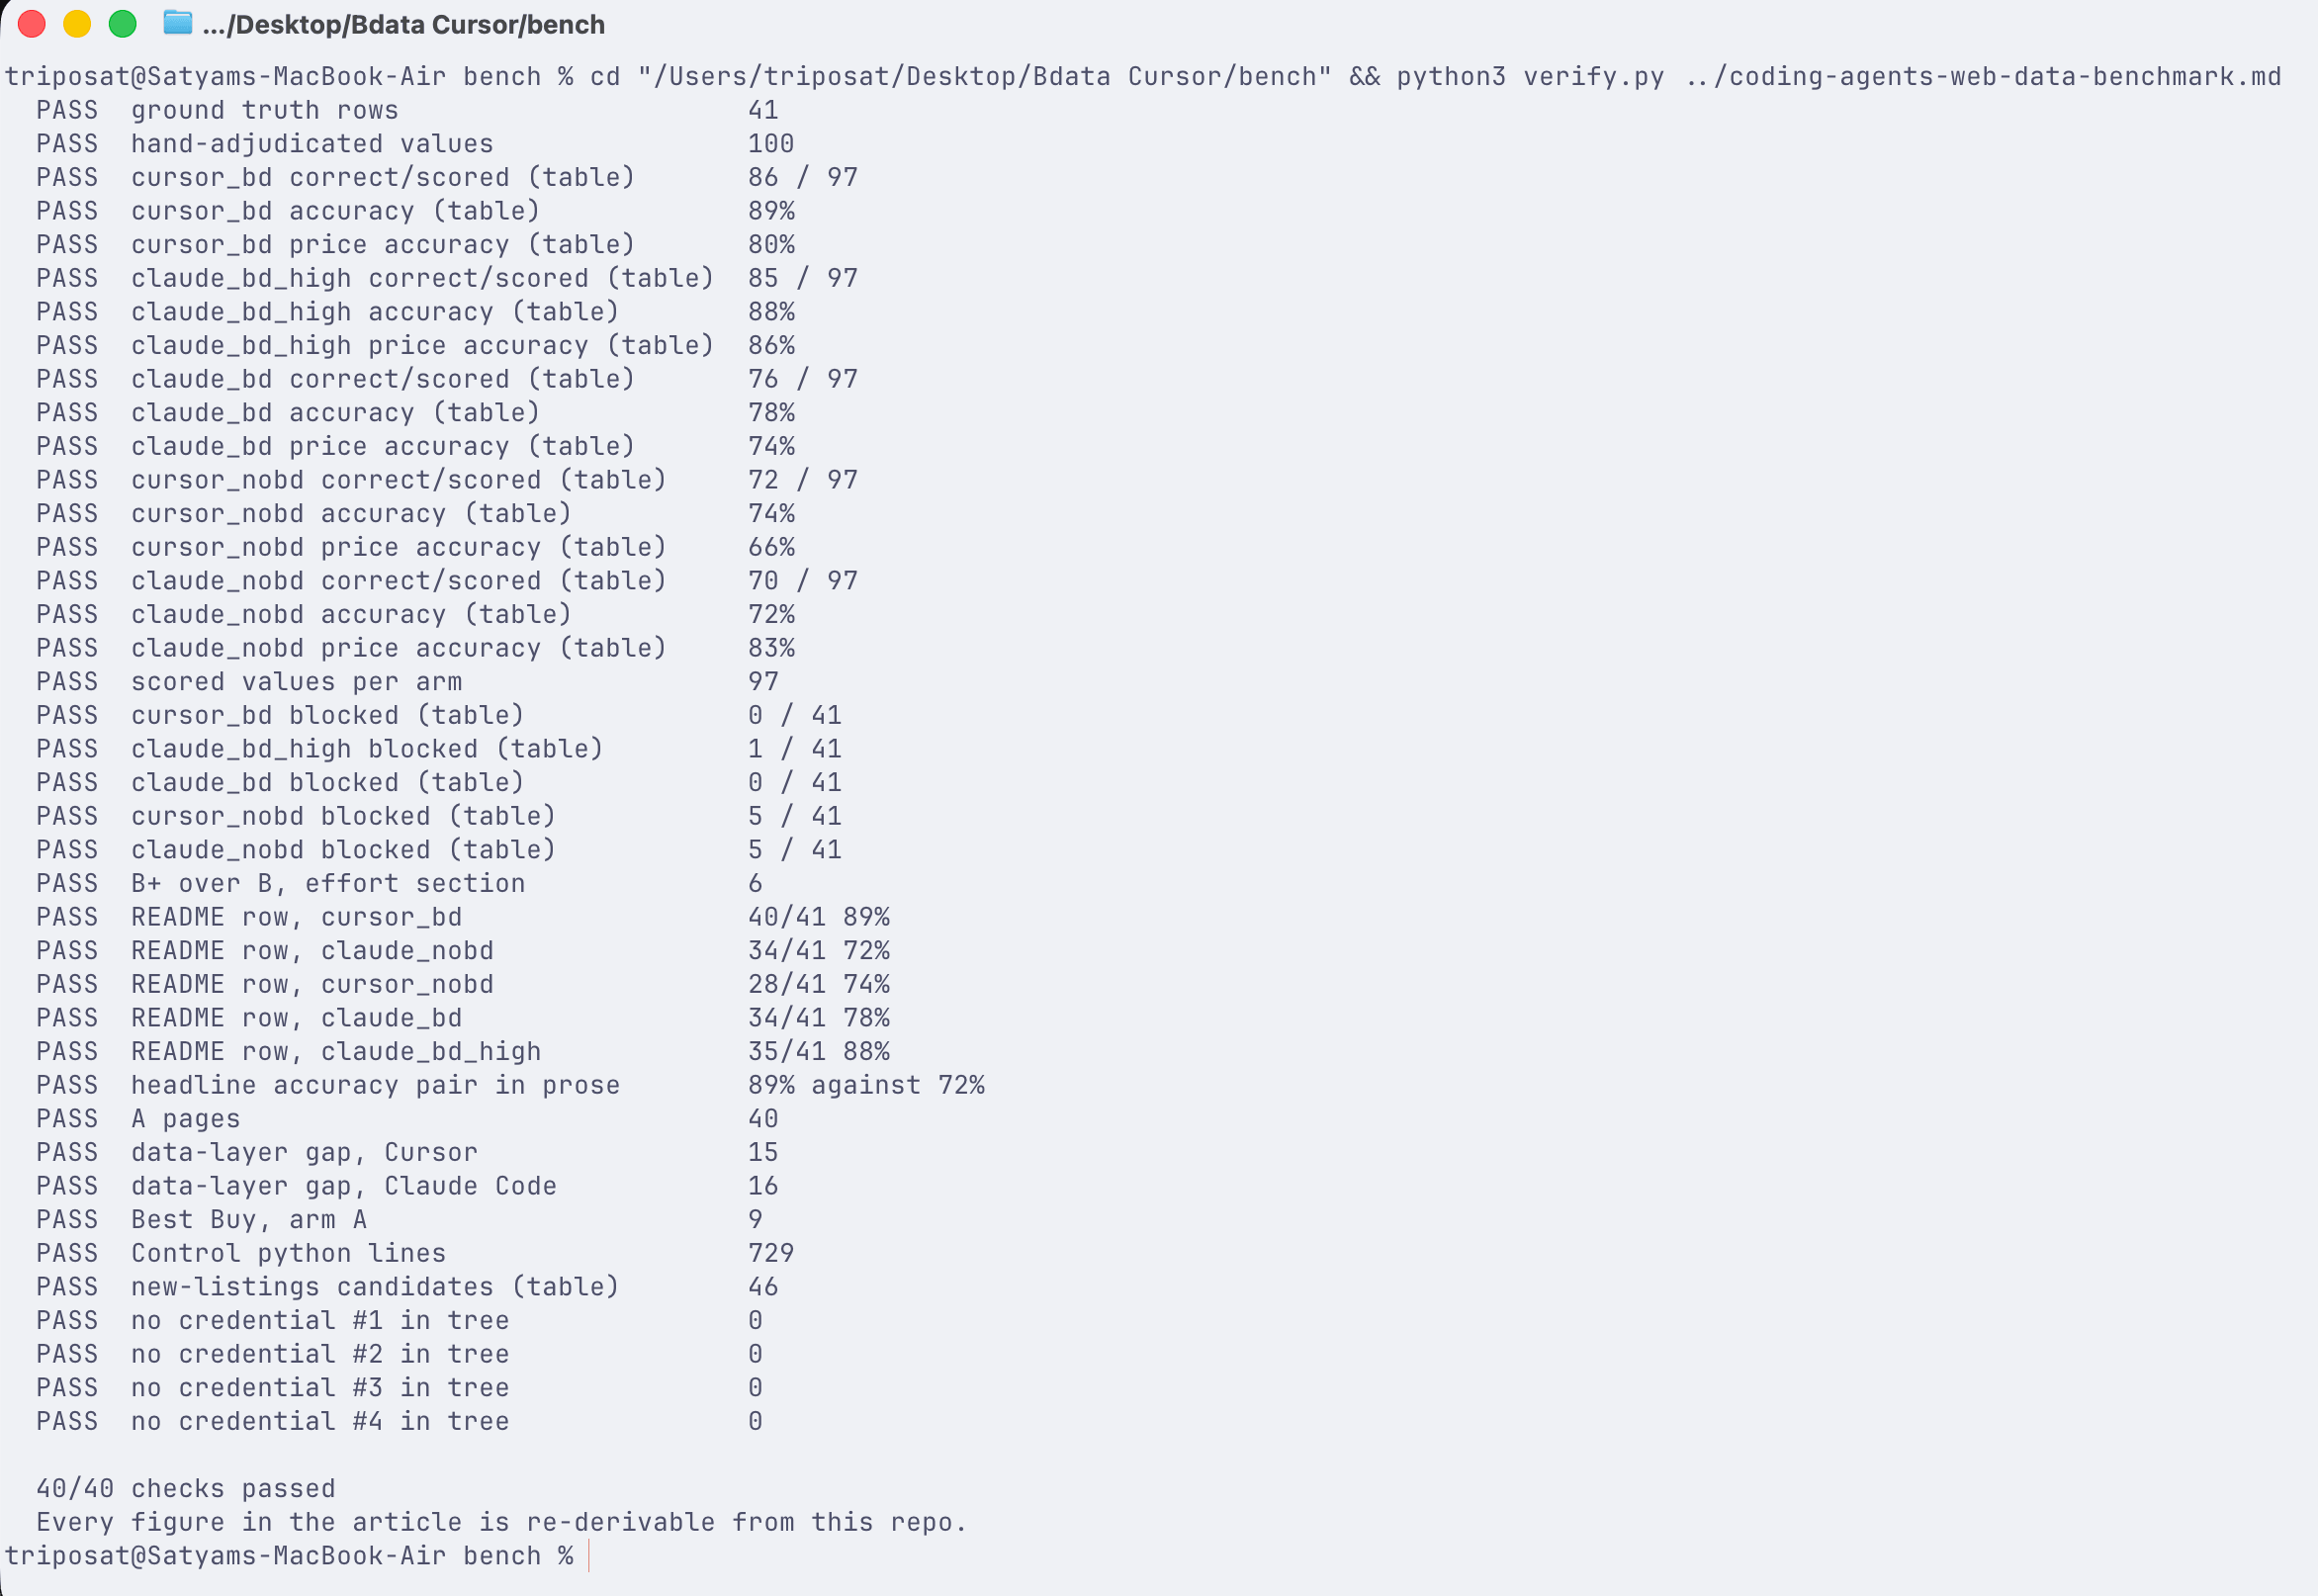
Um comando, sem credenciais. Ele analisa as tabelas e compara células específicas, então um número errado falha mesmo quando o mesmo número aparece corretamente em outro lugar.
As figuras acima também são fornecidas como dados. claims.json lista 39 delas com o arquivo do qual cada uma foi derivada e o script que a calculou:
{ "id": "cursor_bd.field_accuracy", "value": 89, "unit": "percent",
  "derived_from": "runs_isolated/cursor_bd/results.json",
  "computed_by": "scripts/score_accuracy_iso.py" }
Então não acredite na nossa palavra sobre nada disso. Aponte seu próprio agente de codificação para o repositório e peça que ele verifique esta página em relação aos dados. Esse é um teste justo de um benchmark, e é a mesma tarefa que o próprio benchmark mede.
O nível gratuito da Bright Data inclui 5.000 solicitações do Web Unlocker por mês, e uma atualização de uma lista de 41 páginas custa 41 delas. Aponte o servidor MCP hospedado da Bright Data para seus próprios alvos e veja se algo disso se aplica a você.
Perguntas frequentes
Agentes de codificação com IA precisam de proxies ou de um serviço de desbloqueio para fazer scraping?
Sim, para os alvos mais difíceis, e a diferença medida é grande: com uma camada de dados, a mesma classe de agente leu 40 de 41 páginas com 89% de precisão de campo, contra 34 páginas e 72% sem ela. Além disso, fez isso sem escrever uma linha de código de busca. A dificuldade não é distribuída de forma uniforme, porém. Um modelo atual controlando seu próprio navegador lidou com os varejistas mais fáceis da nossa lista sem ajuda, lendo o Walmart 10 de 10 e o Target 7 de 7. Em nossas execuções, ele não chegou ao trecho final, e é esse trecho onde as falhas e a maioria das tentativas de reprocessamento se concentraram. Portanto, não pergunte se você precisa de uma camada de desbloqueio, mas quais dos seus alvos precisam dela e quanto vale o seu tempo de engenharia.
Como posso saber se os dados coletados por scraping são precisos?
Verifique de onde cada valor veio, não se a linha está completa, e depois confira uma amostra manualmente na página. Neste benchmark, nenhuma das 4 execuções preencheu valores retroativamente. Uma execução anterior do Claude Code sem camada de dados, em um modelo mais antigo, reportou um resultado perfeito de 41 de 41, no qual 29 avaliações eram iguais a um valor fixo em nível de produto de um script de correção que ele mesmo escreveu. Ambos os padrões existem, uma pontuação de completude não consegue diferenciá-los, e a verificação custa algumas linhas.
Qual taxa de sucesso devo esperar de uma API de web scraping?
Trate qualquer taxa de sucesso informada como uma medição, não como uma garantia. Os 40 de 41 neste benchmark são uma observação, em 41 páginas, em um dia, com o modelo fixado em claude-sonnet-5, a partir de um local de rede. O mesmo teste re-executado 24 horas depois não retornou um número idêntico, o que é normal para páginas ao vivo e vale esperar. Seu próprio número dependerá da sua lista de alvos, então meça-o em relação a ela.
Quanto custa a Bright Data para web scraping?
O Web Unlocker custa US$ 1,50 por 1.000 solicitações no pagamento por uso, com 5.000 solicitações por mês no nível gratuito. Uma única atualização de 41 páginas são 41 solicitações, cerca de 6 centavos, então uma atualização diária desta lista fica bem dentro do nível gratuito. Não estamos informando um total para todo o benchmark: ele compartilhou uma conta com trabalho não relacionado, então esse número não seria atribuível. O Navegador de scraping utilizado como base para a verdade fundamental é um produto separado em uma unidade separada.