O web scraping tradicional geralmente envolve escrever código intrincado e demorado, adaptado a layouts específicos de sites, que pode facilmente quebrar quando os sites mudam. ScrapeGraphAI utiliza modelos de linguagem grandes (LLMs) para extrair informações e interpretá-las como um humano faria, permitindo que você se concentre nos dados em vez do layout. Integrar LLMs com o ScrapeGraphAI melhora a extração de dados, automatiza a agregação de conteúdo e permite análises em tempo real.
Neste artigo, você aprenderá a usar o ScrapeGraphAI para scraping de dados. Mas antes disso, vamos apresentar as soluções da Bright Data que podem economizar seu tempo e dinheiro.
Soluções de Web Scraping da Bright Data
A Bright Data oferece um conjunto abrangente de soluções de scraping de dados, otimizadas para extração de dados eficiente, escalável e em conformidade:
- Web Scraper API
- Conjuntos de Dados Prontos para Uso
- Conjuntos de Dados Personalizados
Essas soluções permitem coleta de dados rápida, precisa e escalável, perfeita para projetos de qualquer escopo, desde aplicações em pequena escala até necessidades de nível empresarial.
Implementando LLM Web Scraping com ScrapeGraphAI
Antes de iniciar este tutorial, você precisa dos seguintes pré-requisitos:
- Python 3.x instalado.
- Uma conta da OpenAI. Este tutorial usa LLMs da OpenAI para fazer scraping de dados com o ScrapeGraphAI. Embora seja possível usar outros modelos, como Anthropic, Google, ou modelos de código aberto, como Llama e Mistral AI, este tutorial usa o GPT-4 devido à sua popularidade e facilidade de configuração.
Se você não estiver familiarizado com scraping de dados em Python, confira este tutorial de web scraping para começar.
Configure Seu Ambiente
A primeira coisa que você precisa fazer é criar um ambiente virtual. Abra seu terminal e navegue até o diretório do seu projeto:
python -m venv venv
Em seguida, ative o ambiente virtual. No macOS e Linux, você pode fazer isso com o seguinte comando:
source venv/bin/activate
No Windows, você pode usar este comando:
venvScriptsactivate
Depois de ativar o ambiente virtual, você precisa instalar o ScrapeGraphAI e suas dependências:
pip install scrapegraphai
playwright install
O comando playwright install configura os navegadores necessários para Chromium, Firefox e WebKit.
Para gerenciar variáveis de ambiente com segurança, instale o python-dotenv:
pip install python-dotenv
É importante proteger informações sensíveis, como chaves de API. Recomenda-se armazenar variáveis de ambiente em um arquivo .env para mantê-las separadas dos arquivos de código.
Crie um novo arquivo chamado .env no diretório do projeto e adicione a seguinte linha especificando sua chave da OpenAI:
OPENAI_API_KEY="your-openai-api-key"
Este arquivo não deve ser enviado para sistemas de controle de versão como o Git. Para evitar isso, adicione .env ao seu arquivo .gitignore.
Extraia Dados com o ScrapeGraphAI
Neste tutorial, você começará extraindo dados de produtos do Books to Scrape, um site de demonstração especificamente para praticar técnicas de scraping de dados. Este site simula uma livraria online, oferecendo uma variedade de livros em diferentes gêneros, completos com preços, avaliações e status de disponibilidade:
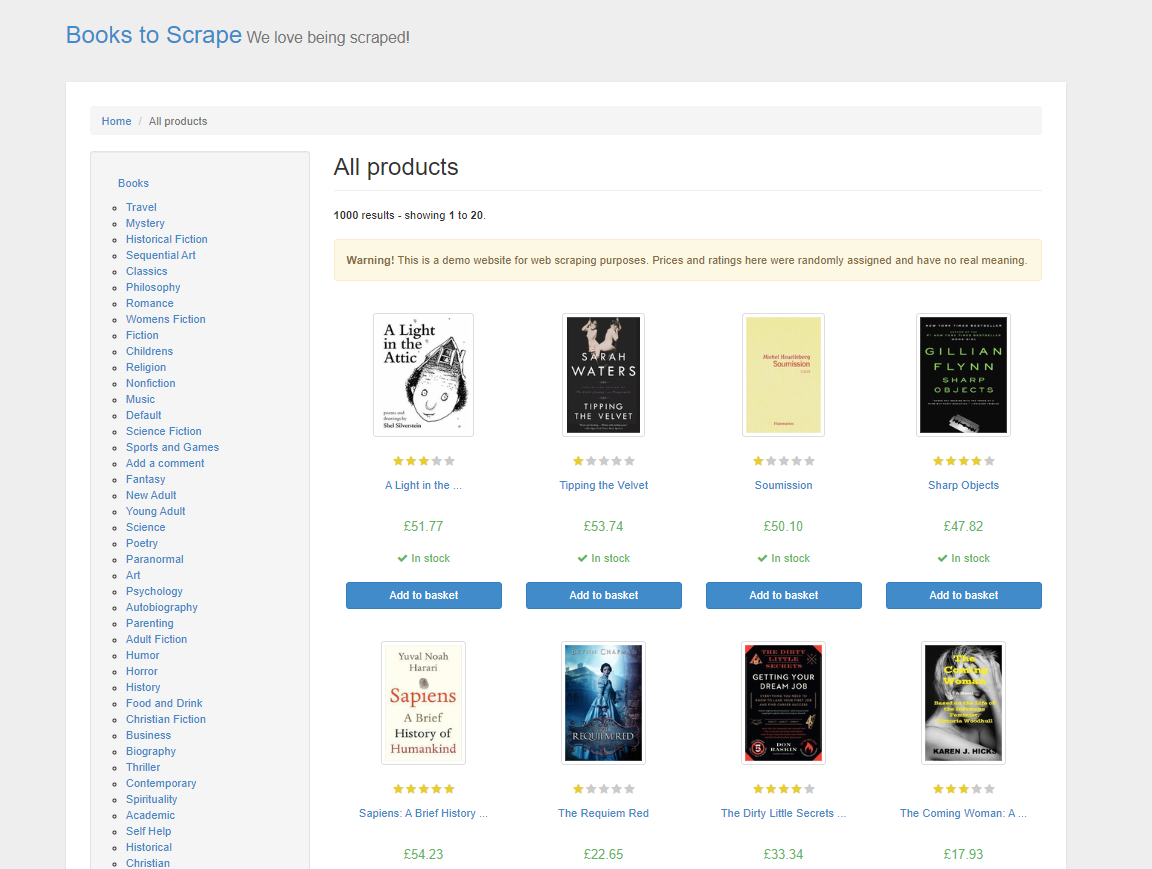
No web scraping de HTML tradicional, você precisaria analisar o HTML da página, inspecionando manualmente elementos e tags para localizar os dados desejados. Esse processo é demorado e exige um bom entendimento das estruturas da web. Com o ScrapeGraphAI, você só precisa especificar os dados desejados usando um prompt, e o LLM é inteligente o suficiente para extraí-los.
O ScrapeGraphAI oferece diferentes tipos de grafos para diferentes necessidades de scraping. Esses grafos definem como o processo de scraping é estruturado e o que ele visa realizar. Aqui está uma breve visão geral de alguns dos diferentes grafos:
- SmartScraperGraph é um scraper de página única onde você fornece um prompt e uma URL ou arquivo local. Ele usa um LLM para extrair as informações especificadas.
- SearchGraph é um scraper multipáginas que extrai informações de resultados de mecanismos de busca com base no seu prompt.
- SpeechGraph estende o SmartScraperGraph adicionando um recurso de texto para voz, gerando um arquivo de áudio do conteúdo extraído.
- ScriptCreatorGraph recebe um prompt e uma URL e, em vez de gerar resultados, produz um script Python capaz de fazer scraping da URL fornecida.
Se esses grafos não atenderem exatamente às suas necessidades, o ScrapeGraphAI também permite criar grafos personalizados combinando diferentes nós e adaptando o processo de scraping aos seus requisitos específicos.
Além de escolher o tipo certo de grafo, você também precisa configurar corretamente seu scraper, especialmente quando se trata da seleção de prompt e modelo. O prompt orienta o LLM a entender exatamente quais dados extrair—certifique-se de que seja claro e explícito. Além disso, escolher o modelo LLM certo determina o quão bem o scraper processa e interpreta o conteúdo do site. Você também pode configurar outras opções, como proxies, para garantir um scraping mais tranquilo de conteúdo com restrição geográfica, e o modo headless para manter o processo eficiente e rápido. A configuração adequada determina, em última análise, quão precisos e relevantes serão os dados extraídos.
Escreva o Código do Scraper
Para escrever o código do scraper, crie um novo arquivo chamado app.py e adicione as seguintes linhas de código a ele:
from dotenv import load_dotenv
import os
from scrapegraphai.graphs import SmartScraperGraph

# Carregar variáveis de ambiente do arquivo .env
load_dotenv()

# Acessar a chave da API da OpenAI
OPENAI_API_KEY = os.getenv('OPENAI_API_KEY')

# Configuração para o ScrapeGraphAI
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 }
}

# Definir o prompt e a fonte
prompt = "Extract the title, price and availability of all books on this page."
source = "http://books.toscrape.com/"

# Criar o grafo do scraper
smart_scraper_graph = SmartScraperGraph(
 prompt=prompt,
 source=source,
 config=graph_config
)

# Executar o scraper
result = smart_scraper_graph.run()

# Exibir os resultados
print(result)
Este código importa módulos essenciais como os e dotenv para lidar com variáveis de ambiente e a classe SmartScraperGraph do ScrapeGraphAI, que é usada para scraping. Em seguida, ele carrega as variáveis de ambiente via dotenv para manter dados sensíveis, como chaves de API, seguros. Depois, o código cria uma configuração de LLM para scraping, especificando qual modelo usar e a chave da API. Essa configuração, juntamente com a URL do site e o prompt de scraping, é usada para definir seu SmartScraperGraph, que é executado usando o método run(), acionando o processo de coleta dos dados especificados.
Para executar este código, abra seu terminal e execute python app.py. Sua saída deve ser parecida com esta:
{
    "books": [
        {
            "title": "A Light in the Attic",
            "price": "£51.77",
            "availability": "In stock"
        },
        {
            "title": "Tipping the Velvet",
            "price": "£53.74",
            "availability": "In stock"
        }, ...
       ]
}
Nota: Se você encontrar problemas ao executar o código, talvez seja necessário instalar manualmente o pacote
grpcio, que é uma dependência subjacente do ScrapeGraphAI. Você pode fazer isso com o seguinte comando:
pip install grpcio
Embora o ScrapeGraphAI facilite a parte de extração de dados do web scraping, ainda existem alguns desafios comuns, como CAPTCHAs e bloqueios de IP, que você precisa saber como lidar.
Para simular o comportamento de navegação, você pode implementar atrasos cronometrados em seu código. Você também pode utilizar proxies rotativos para evitar detecção. Além disso, serviços de resolução de CAPTCHA como o solucionador de CAPTCHA da Bright Data ou o Anti Captcha podem ser integrados ao seu scraper para resolver CAPTCHAs automaticamente para você.
Observação: Sempre garanta que você está em conformidade com os termos de serviço de um site. O scraping para uso pessoal geralmente é aceitável, mas redistribuir dados pode ter implicações legais.
Usando Proxies com o ScrapeGraphAI
O ScrapeGraphAI permite que você configure um serviço de proxy para evitar bloqueio de IP e acessar conteúdo com restrição geográfica. Você pode usar um serviço de proxy gratuito ou configurar seu próprio servidor de proxy personalizado.
Para usar um serviço de proxy gratuito, adicione o seguinte ao seu graph_config:
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 },
    "loader_kwargs": {
        "proxy": {
            "server": "broker",
            "criteria": {
                "anonymous": True,
                "secure": True,
                "countryset": {"US"},
                "timeout": 10.0,
                "max_tries": 3
 },
 },
 }
}
Esta configuração instrui o ScrapeGraphAI a usar um serviço de proxy gratuito que corresponda aos seus critérios.
Para usar um servidor de proxy personalizado de um provedor como a Bright Data, altere seu graph_config da seguinte forma, inserindo a URL do seu servidor, nome de usuário e senha:
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 },
    "loader_kwargs": {
        "proxy": {
            "server": "http://your_proxy_server:port",
            "username": "your_username",
            "password": "your_password",
 },
 }
}
Usar um servidor de proxy personalizado oferece várias vantagens, especialmente para scraping de dados em larga escala. Ele fornece controle sobre a localização do proxy, permitindo que você extraia conteúdo com restrição geográfica. Além disso, proxies personalizados são mais confiáveis e seguros em comparação com proxies gratuitos, reduzindo as chances de ter seu IP bloqueado ou sofrer limitação de taxa.
Limpe e Prepare os Dados
Depois de extrair os dados, você precisa limpá-los e pré-processá-los, especialmente se planeja alimentá-los em um modelo de IA. Dados limpos garantem que seus modelos aprendam com informações precisas e consistentes, o que impacta diretamente seu desempenho e confiabilidade. A limpeza de dados geralmente envolve lidar com valores ausentes, corrigir tipos de dados, normalizar texto e remover duplicatas.
Aqui está um exemplo de como você pode limpar os dados extraídos anteriormente usando pandas:
import pandas as pd

# Converter o resultado em um DataFrame
df = pd.DataFrame(result["books"])

# Remover símbolos de moeda e converter preços para float
df['price'] = df['price'].str.replace('£', '').astype(float)

# Padronizar o texto de disponibilidade
df['availability'] = df['availability'].str.strip().str.lower()

# Lidar com valores ausentes, se houver
df.dropna(inplace=True)

# Visualizar os dados limpos
print(df.head())
Este código limpa os dados removendo o símbolo da moeda dos preços dos livros, padroniza o status de disponibilidade convertendo-o para minúsculas e trata quaisquer valores ausentes.
Antes de executar o código, você precisa instalar a biblioteca pandas para manipulação de dados:
pip install pandas
Para executar o código, abra seu terminal e execute python app.py. Sua saída deve ser parecida com esta:
                                   title  price availability
0                   A Light in the Attic  51.77     in stock
1                     Tipping the Velvet  53.74     in stock
2                             Soumission  50.10     in stock
3                          Sharp Objects  47.82     in stock
4  Sapiens: A Brief History of Humankind  54.23     in stock
Este é apenas um exemplo de como você pode limpar dados extraídos—o processo de limpeza varia com base nos dados e no caso de uso do LLM sendo treinado. Quando você limpa seus dados, garante que seus modelos de linguagem recebam entradas bem estruturadas e significativas. Se você quiser aprender mais sobre como utilizar dados para projetos de IA, considere dados para IA.
Todo o código deste tutorial está disponível neste repositório do GitHub.
Conclusão
O ScrapeGraphAI usa LLMs para fornecer uma abordagem adaptativa ao web scraping, ajustando-se a mudanças nas estruturas dos sites e extraindo dados de forma inteligente. No entanto, escalar o web scraping traz desafios, como bloqueio de IPs, resolução de CAPTCHAs e manutenção da conformidade legal.
Para ajudar a superar esses desafios, a Bright Data fornece um conjunto abrangente de soluções de scraping de dados personalizadas para projetos de IA e machine learning. Isso inclui as APIs Web Scraper da Bright Data, serviços de proxy, e Serverless Scraping. Além disso, a Bright Data também oferece conjuntos de dados prontos para uso, repletos de dados de mais de cem sites populares.
Comece hoje mesmo!