Para monitoramento de preços, fazer scraping de produtos da Target em grande escala significa ler preços e estoque das lojas a partir de APIs JSON internas em vez do HTML da página.
Em nossos testes, um pacote de 31 cápsulas Tide custava $9,99 em Cedar Rapids e $12,69 em Chicago ao mesmo tempo. Algumas respostas pareciam válidas, mas continham um preço online ou a faixa de preço de um produto pai. A partir de IPs dos EUA, apenas 1 de 112 chamadas à API de produto feitas por clientes curl e Python com configurações padrão teve sucesso.
Este guia mostra como coletar esses preços, detectar respostas inválidas e decidir entre construir um scraper ou usar um Target Price Scraper.
TL;DR
- Solicite preços por ID da loja. Mapeie CEPs para IDs de loja e depois chame a API de produto da Target com sua chave de API pública.
- Verifique a localização e a variante de cada preço. A localização 3991 marca um preço online, e um produto pai pode retornar uma faixa, então salve 1 linha por variante.
- Encontre bloqueios nos corpos das respostas. Chamadas bloqueadas retornaram HTTP 435, às vezes como JSON válido.
- Escolha a ferramenta pela forma como você rastreia localizações. Para CEPs, o Target Scraper API da Bright Data bateu com nosso scraper em 20 de 20 verificações. Para IDs de loja ou estoque por canal, execute seu código na Web Unlocker API.
Como a Target disponibiliza dados de produtos
Em nossos testes, um scraper conseguia ler preços, estoque e detalhes de produtos de 3 hosts da Target. O HTML da página do produto foi a única fonte sem preço. A Target identifica cada produto por um TCIN (Target.com Item Number), o número depois de A- na URL do produto.
Os 3 hosts estavam atrás do CDN Fastly da Target. Nos hosts www e redsky, a verificação de bots da HUMAN Security podia bloquear uma solicitação e retornar uma resposta de bloqueio em vez de dados:
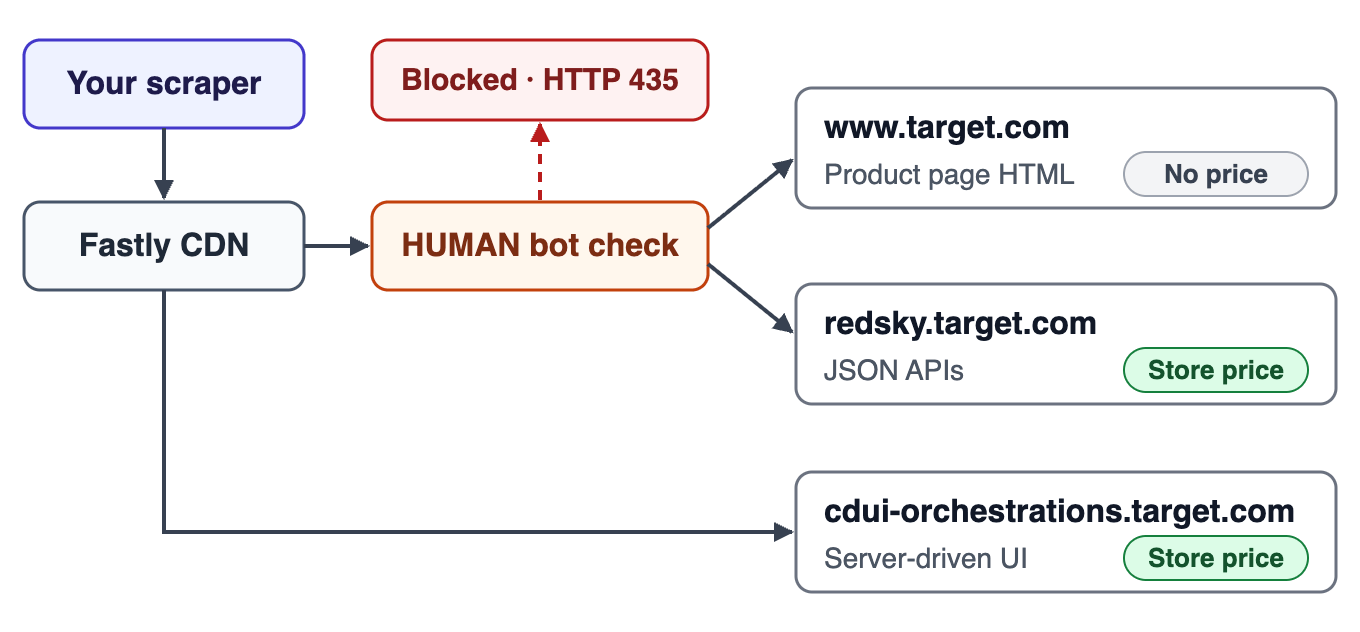
Em nossos testes, o HTML da página não tinha preço, enquanto as APIs JSON e os módulos de UI server-driven tinham o preço da loja.
O HTML da página não tinha preço
A página do produto era uma aplicação Next.js. Seu script __NEXT_DATA__ tinha o título, descrição, imagens e um resumo de avaliações, mas nenhum preço. As propriedades da página continham isProductDetailServerSideRenderPriceEnabled: false em toda página que buscamos com curl, seja o user agent curl, python-requests, Chrome ou HeadlessChrome. Se essa flag se tornar true, o HTML pode incluir preços, então verifique a flag antes de fazer parsing do HTML.
As mesmas propriedades identificavam cada visitante com flags isBot, isAiAgent e isSeoPhantom. Solicitações que afirmavam ser um crawler de mecanismo de busca, como o Googlebot, recebiam uma página diferente, em cache, com JSON-LD do schema.org e um preço renderizado.
Esse preço pertencia a uma única localização padrão. Mecanismos de busca publicam como verificar seus crawlers com DNS reverso, para que um site possa detectar um crawler falsificado. Para preços de loja, use as APIs JSON abaixo em vez dessa página.
Preços e estoque vinham de APIs JSON
A API de agregação da Target em redsky.target.com retorna preços por loja. Todo endpoint que chamamos exigia um parâmetro key. Sem a chave, a API retornava 401 com "no API key found in request".
A chave é uma chave de API pública, não um segredo. Ela apareceu 28 vezes em cada página de produto que salvamos, exceto na página em cache que os crawlers recebiam. Leia-a de uma página da Target, como a página inicial, em vez de fixá-la no código.
Quando verificamos, o robots.txt do host da API proibia todo crawler, enquanto o robots.txt do site principal permitia páginas de produtos.
Esses 4 endpoints foram suficientes para todo trabalho de dados de produto que testamos:
| Endpoint | O que retorna | Limites e erros em nossos testes |
|---|---|---|
pdp_client_v1 |
Produto, preço em 1 store_id, e toda variante da família |
404 para um TCIN que não existe mais |
plp_search_v2 |
Resultados de busca para uma palavra-chave ou número de código de barras UPC | count até 28, offset até 1.199 |
nearby_stores_v1 |
IDs de lojas próximas a um CEP | Nenhum |
product_fulfillment_v1 |
Envio, retirada e estoque na loja solicitada, às vezes com uma loja próxima | Nenhum |
Esta solicitação obtém o preço de uma caixa de leite UHT Parmalat na loja Chelsea em Nova York, loja 3412, com curl e jq:
KEY=$(curl -s https://www.target.com/ \
  | grep -oE '[0-9a-f]{40}' | sort | uniq -c | sort -rn \
  | head -1 | awk '{print $2}')

REDSKY=https://redsky.target.com/redsky_aggregations/v1/web
Q="key=$KEY&tcin=15078349"
Q="$Q&store_id=3412&pricing_store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
curl -s "$REDSKY/pdp_client_v1?$Q" \
  | jq '.data.product.children[]
        | select(.tcin=="15078349") | .price'
O campo location_id na resposta mostra a qual loja o preço pertence:
{
  "current_retail": 3.89,
  "display_was_now": false,
  "formatted_current_price": "$3.89",
  "formatted_current_price_type": "reg",
  "formatted_unit_price": "$0.12",
  "formatted_unit_price_suffix": "/fluid ounce",
  "reg_retail": 3.89,
  "location_id": 3412,
  "external_system_id": "15078349-3412-3.89-2025080815"
}
O preço está dentro de children porque este TCIN é uma variante de um produto pai. Ambos os comandos curl acima funcionaram a partir da nossa conexão na Índia. A partir de IPs dos EUA, a verificação de bots da Target bloqueou quase todas essas solicitações em nossos testes. Nesse caso, o jq exibia um erro de parsing, porque a resposta era uma página de bloqueio HTML, não JSON.
A Web Unlocker API envia as mesmas solicitações através da sua camada de desbloqueio e retorna o JSON da Target. Defina primeiro as variáveis de ambiente BRIGHTDATA_API_KEY e UNLOCKER_ZONE, conforme mostrado no guia rápido da Web Unlocker API:
unlock() {
  curl -s https://api.brightdata.com/request \
    -H "Authorization: Bearer $BRIGHTDATA_API_KEY" \
    -H "Content-Type: application/json" \
    -d "{\"zone\": \"$UNLOCKER_ZONE\",
         \"url\": \"$1\", \"format\": \"raw\"}"
}

KEY=$(unlock https://www.target.com/ \
  | grep -oE '[0-9a-f]{40}' | sort | uniq -c | sort -rn \
  | head -1 | awk '{print $2}')

REDSKY=https://redsky.target.com/redsky_aggregations/v1/web
Q="key=$KEY&tcin=15078349"
Q="$Q&store_id=3412&pricing_store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
unlock "$REDSKY/pdp_client_v1?$Q" \
  | jq '.data.product.children[]
        | select(.tcin=="15078349") | .price'
A função unlock aceita qualquer URL da Target, incluindo a solicitação de estoque abaixo.
A página ao vivo carregava módulos de UI server-driven
Em nossas capturas de rede do navegador, a página do produto não chamava pdp_client_v1. Seu layout vinha de módulos de UI server-driven, seções de página que o servidor envia como dados, seja dentro de __NEXT_DATA__ ou de cdui-orchestrations.target.com. Uma chamada deferred_enrichment em www.target.com adicionava os módulos específicos de localização.
A resposta de cdui-orchestrations.target.com e os módulos deferred_enrichment continham ambos preços. Com include_data_source_modules=true, uma solicitação para cdui-orchestrations.target.com para a loja Chelsea retornou o mesmo preço e ID de localização que pdp_client_v1 para 16 de 16 produtos testados. Um endpoint que a página do produto não chamava, como pdp_client_v1, pode desaparecer sem aviso, e os preços correspondentes do cdui oferecem um fallback testado.
Por que scrapers da Target falham em grande escala
Algumas falhas ocorrem na primeira solicitação, e outras aparecem apenas quando um trabalho inclui muitas lojas e produtos.
Bloqueios dependiam do IP e do cliente
Em nossos testes, a Target usava HUMAN Security, um serviço de detecção de bots que se fundiu com a PerimeterX em 2022. Toda página de produto que buscamos com um user agent de navegador ou cliente HTTP carregava o script sensor da HUMAN a partir de client.px-cloud.net.
Em nosso teste de IP e cliente, enviamos as mesmas 16 URLs pdp_client_v1 de cada fonte de IP e cliente, em execuções distribuídas por 3 horas. Uma chamada passava se retornasse 200 ou 206 sem bloqueio da HUMAN no corpo:
| Fonte de IP | Cliente | Chamadas aprovadas |
|---|---|---|
| IPs na Índia | curl | 63 de 64 |
| IPs nos EUA | curl ou Python requests, user agent padrão |
1 de 112 |
| Web Unlocker API com IPs de saída dos EUA | Selecionado pela Web Unlocker API | 32 de 32 |
Da Índia, até o curl passou. De IPs dos EUA, o resultado dependia do cliente, e cabeçalhos semelhantes a navegador permitiam mais chamadas passarem. A Web Unlocker API seleciona os cabeçalhos e a impressão digital do navegador para você, e passou todas as chamadas neste teste.
O host cdui-orchestrations.target.com se comportou de forma diferente quando alternamos chamadas para ele e para pdp_client_v1 com o user agent padrão do Python a partir de IPs dos EUA. O host cdui respondeu a todas as 8 chamadas, enquanto a verificação de bots bloqueou todas as 8 chamadas para pdp_client_v1. A partir da nossa conexão na Índia, respostas cdui com preços tinham um tamanho mediano de transferência de 80 KB, e as respostas pdp_client_v1 tinham 9 KB. O host cdui evitou o bloqueio em nossos testes, mas seu formato de dados segue o layout da página e pode mudar a qualquer lançamento de página.
Em nossos testes, mudar um único cabeçalho fazia uma configuração que passava falhar, e a resposta de bloqueio da HUMAN não dava motivo. Mude uma variável por vez. Antes de confiar em uma correção, alterne-a com a configuração antiga e execute chamadas suficientes para ver uma diferença clara. Ao comparar impressões digitais TLS com um serviço de eco de impressão digital, use JA4 e a impressão digital HTTP/2, porque handshakes estilo Chrome mudam o JA3 entre conexões.
A HUMAN também define seus próprios cookies. Quando verificamos, sua documentação de cookies listava um tempo de vida de 5,5 minutos para _px3 e 1 ano para _pxvid. A mesma página dizia que esses cookies mantêm uma sessão e ajudam a distinguir usuários reais de bots. Para toda a sessão, use cada conjunto de cookies com o IP e cliente que o recebeu, ou deixe a Web Unlocker API gerenciar os cookies.
Chamadas bloqueadas retornaram HTTP 435 em 2 formatos
Quando verificamos, a documentação de enforcers da HUMAN listava 403 e 429 como status de bloqueio e dizia que cada site podia personalizar a resposta. Na Target, chamadas de API bloqueadas retornavam HTTP 435 em vez disso, e a resposta de bloqueio tinha 2 formatos.
Nossas chamadas curl não solicitavam JSON e recebiam uma página de desafio HTML. Renderizada em um navegador, essa página pedia ao visitante para pressionar e segurar um botão:
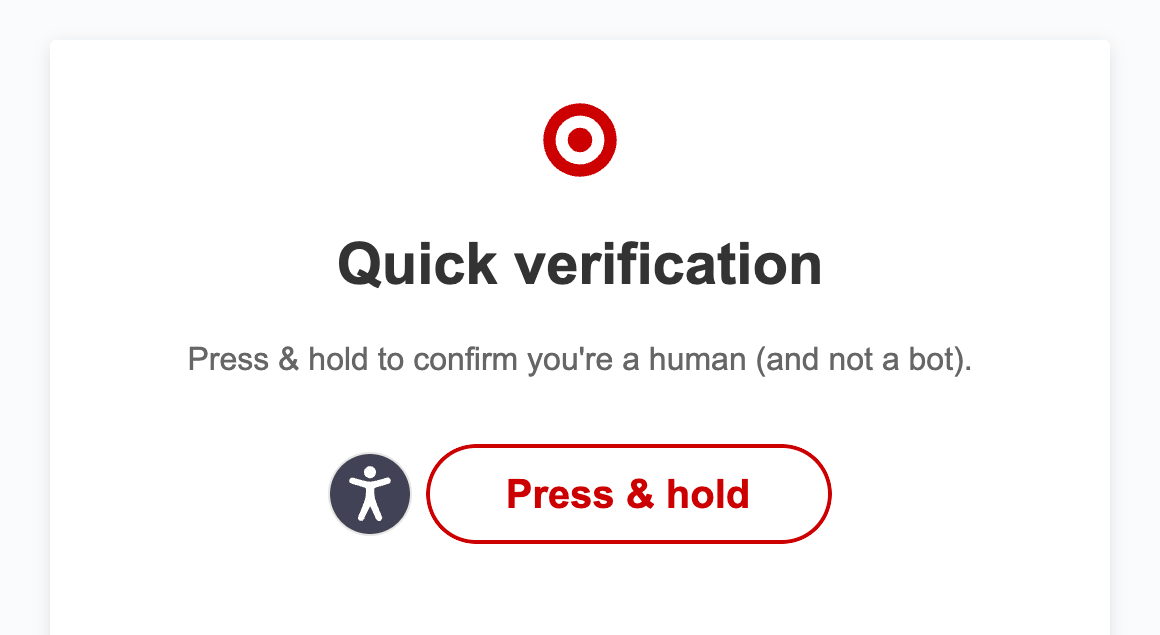
A página de desafio que nossas chamadas curl receberam com HTTP 435 em vez de dados.
Nossas chamadas Python requests solicitavam JSON e recebiam um objeto JSON de 343 bytes que começa com {"appId". Se você verificar apenas JSON válido, esse bloqueio parece dados válidos. Ambos os formatos continham a URL do script de captcha da HUMAN, e nenhuma resposta normal em nossas amostras a continha:
def is_human_block(body):
    """HUMAN envia um bloqueio como uma página HTML ou um pequeno objeto JSON.

    Ambos os formatos contêm a URL do seu script de captcha. Páginas
    normais da Target não contêm.
    """
    return "captcha.px-" in body
Em um conjunto de 21 respostas da Target, a verificação sinalizou todos os 4 bloqueios em ambos os formatos e aprovou todas as 17 normais. Uma verificação mais simples na string px-captcha teria sinalizado uma página de produto renderizada e perdido o bloqueio JSON.
Os preços diferiam por loja
Em 8 lojas, 12 dos 16 produtos que verificamos tinham mais de um preço. A Target relatou mais de 2.000 lojas. O endpoint nearby_stores_v1 mapeia um CEP para os IDs de loja mais próximos. Para cada um dos 8 CEPs, coletamos preços dos 16 produtos na loja mais próxima em uma única execução de 2 minutos.
Um subconjunto de 6 produtos em 5 das 8 lojas mostra as diferenças de preço em dólares americanos. Essas 5 lojas incluem o preço mais baixo e mais alto de cada produto:
| Produto | Nova York | Chicago | Cedar Rapids | Anchorage | Honolulu |
|---|---|---|---|---|---|
| Leite integral UHT Parmalat, 32 fl oz | 3,89 | 3,49 | 3,59 | 4,49 | 3,89 |
| Cápsulas Tide Original, 31 unidades | 11,19 | 12,69 | 9,99 | 10,59 | 10,59 |
| Cheerios, tamanho família 18 oz | 5,99 | 5,69 | 5,29 | 6,79 | 5,69 |
| Market Pantry Classic Roast, 25,9 oz | 14,69 | 14,19 | 12,89 | 16,99 | 17,59 |
| Starbucks Fall Blend, 10 oz | 14,39 | 13,59 | 12,79 | 14,29 | 13,59 |
| LEGO Creator Space Shuttle 31134 | 7,99 | 7,99 | 7,99 | 7,99 | 7,99 |
O café Market Pantry teve a maior variação: $17,59 em Honolulu era 36% mais alto que $12,89 em Cedar Rapids. Mesmo sem Anchorage e Honolulu, 11 dos 16 produtos tinham mais de um preço, e as cápsulas Tide variaram mais, em 27%.
Os preços também podem mudar dentro de um dia. Entre 2 de nossas execuções no mesmo dia, a loja de Chicago baixou o preço do leite de $3,49 para $2,97, e o pdp_client_v1 o marcou como sale. Defina a taxa de atualização de acordo com a frequência com que os preços mudam nas suas categorias. Mantenha o tipo de preço, como promoção ou regular, com cada linha.
Os 4 produtos com o mesmo preço em todas as lojas eram 2 conjuntos LEGO e 2 modelos de AirPods. Para todos os 4, a API retornou um preço da localização 3991, qualquer que fosse a loja solicitada. A localização 3991 marca um preço online, não um preço de loja.
Passar 3991 como ID de loja retornava 206 com "Parameter store_id cannot be digital store 3991." no array errors. Para nossa conexão na Índia, a página do produto da Target também definia a loja como 3991 e o CEP como 52404.
Você pode usar a localização 3991 para economizar solicitações. Primeiro, solicite cada produto em 2 lojas. Se ambas as respostas mostrarem a localização 3991, colete o produto uma vez por atualização em vez de uma vez por loja. Para 4 dos nossos 16 produtos de teste, essa regra reduziu as solicitações de 8 para 1 por atualização.
Para coletar preços de loja, envie a solicitação de produto com um ID de loja através da Web Unlocker API. O Target Scraper API retorna preços para o CEP que você enviar.
Produtos pais retornavam faixas de preço
A Target lista cada variante, como um tamanho de pacote, como um TCIN filho sob um produto pai. Os resultados de busca retornavam o TCIN filho, mas o endpoint de produto retornava o pai. As cápsulas Tide TCIN 87767249 retornavam o pai 79394303 com o preço "$11.19 - $30.99", e seu array children listava os pacotes de 31, 42, 76 e 112. Se um scraper salvar apenas o preço de nível superior, ele registra uma faixa ou seu valor mais baixo para um produto que tem 4 preços.
A faixa também pode esconder diferenças de loja. No nível do pai, as fraldas Pampers Swaddlers mostravam "$9.99 - $59.99" em todas as 8 lojas em uma execução anterior. No nível da variante, o pacote tamanho 1 com 164 unidades custava $47,99 em Nova York e $44,99 nas outras 7 lojas.
Uma solicitação retorna toda variante da família na loja solicitada. Se você enviar 1 TCIN por família, paga por 1 solicitação por família em cada loja.
A busca parava em um offset de 1.199
O endpoint de busca rejeitava qualquer count acima de 28 com "Parameter 'count' cannot be requested with more than 28". Também rejeitava qualquer offset acima de 1.199, então 1 consulta podia retornar cerca de 1.227 resultados. Uma busca por “shirts” relatou 131.690 resultados em nosso teste, então uma única palavra-chave podia retornar cerca de 1% deles.
Quando verificamos, o robots.txt de www.target.com proibia páginas de busca para todos os user agents e listava 6 índices de sitemap. O índice de sitemap de produtos apontava para 110 arquivos, que listavam 2.504.600 URLs de produtos quando os baixamos. Descubra produtos a partir de sitemaps e páginas de categoria, e use a API de busca para consultas ocasionais, como a resolução de UPC para TCIN. Com o UPC como palavra-chave, ambos os UPCs que testamos retornaram exatamente 1 produto com seu TCIN.
Alguns códigos de status eram enganosos
A Target retorna 3 tipos de respostas que precisam de tratamento próprio, e 2 delas têm um código de status enganoso:
| Resposta | O que significava | O que fazer |
|---|---|---|
206 com um array errors |
Parte da consulta falhou, e os dados do produto ainda estavam presentes | Fazer parsing dos dados, registrar o erro |
404 com "No product found with tcin" |
O produto não existe mais | Marcar a URL como inativa, pular novas tentativas |
435 com corpo HTML ou JSON |
Um bloqueio da HUMAN | Detectá-lo pelo corpo, pausar esse cliente e esperar antes de tentar novamente |
Produtos removidos podem aparecer em qualquer lista de entrada, então planeje para isso. Um produto em nossa lista de teste retornou "No product found with tcin 1002219928".
O estoque tinha 3 canais por loja
Em nossos testes, o endpoint product_fulfillment_v1 relatava envio, retirada na loja e disponibilidade na loja separadamente, e dava uma quantidade por loja. Esta solicitação reutiliza KEY e REDSKY da solicitação à API de produto acima e verifica o leite na loja Chelsea:
Q="key=$KEY&tcin=15078349&store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
curl -s "$REDSKY/product_fulfillment_v1?$Q" \
  | jq '.data.product.fulfillment | {
      shipping: .shipping_options.availability_status,
      stores: [.store_options[] | {
        store: .location_id,
        units: .location_available_to_promise_quantity,
        pickup: .order_pickup.availability_status,
        in_store: .in_store_only.availability_status
      }]
    }'
A loja Chelsea não tinha unidades nem retirada, mas o envio mostrava o leite em estoque, e uma loja próxima listava 6 unidades:
{
  "shipping": "IN_STOCK",
  "stores": [
    {
      "store": "3412",
      "units": 0.0,
      "pickup": "UNAVAILABLE",
      "in_store": "OUT_OF_STOCK"
    },
    {
      "store": "1886",
      "units": 6.0,
      "pickup": "IN_STOCK",
      "in_store": "IN_STOCK"
    }
  ]
}
Em outra solicitação, a loja de Anchorage listava 2 unidades do mesmo leite. Salve o status de envio, retirada e disponibilidade na loja para cada loja, porque uma única flag is_available não pode conter 3 valores separados. Para estoque, use endpoints de leitura como product_fulfillment_v1, que já retornam quantidades por loja, em vez de solicitações de carrinho. Engenheiros que fazem engenharia reversa de APIs de varejo também relatam que endpoints de escrita são mais bem protegidos.
Fazer scraping de preços de lojas da Target com a Web Unlocker API
A Web Unlocker API roteia cada solicitação através de IPs e impressões digitais de navegador que seleciona para cada site. Ela também lida com cabeçalhos, cookies, CAPTCHAs e novas tentativas, e retorna a resposta do site. Fornecedores de detecção de bots atualizam suas verificações com frequência, e a Web Unlocker API se adapta a essas atualizações para você. Você mantém controle total do seu parser e da lógica de endpoints.
Para começar, crie uma conta Bright Data com uma chave de API e uma zona da Web Unlocker API, uma configuração nomeada para solicitações e seu faturamento. Você também precisa do Python e da biblioteca requests, e o script roda no Python 3.13. A Web Unlocker API é self-serve e cobra apenas por solicitações bem-sucedidas. A página de preços da Web Unlocker API lista as taxas atuais, e o nível gratuito inclui 5.000 solicitações por mês sem necessidade de cartão de crédito.
O script lê a chave de API da Target em sua página inicial e mapeia cada CEP para uma loja. Em seguida, obtém o preço de cada variante e separa linhas válidas das rejeitadas:
"""Coleta preços da Target por loja através da Web Unlocker API da Bright Data.

Uso:
    export BRIGHTDATA_API_KEY=...        # chave de API da conta
    export UNLOCKER_ZONE=web_unlocker    # sua zona da Web Unlocker API
    python target_store_prices.py 15078349,87767249 10001,99501
"""
import collections
import html
import json
import os
import re
import sys
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone
from urllib.parse import urlencode

import requests

API_KEY = os.environ["BRIGHTDATA_API_KEY"]
ZONE = os.environ.get("UNLOCKER_ZONE", "web_unlocker")
REDSKY = "https://redsky.target.com/redsky_aggregations/v1/web/"
ONLINE_STORE = "3991"  # a localização que a API da Target chama de loja digital


def is_human_block(body):
    """HUMAN envia um bloqueio como uma página HTML ou um pequeno objeto JSON.

    Ambos os formatos contêm a URL do seu script de captcha. Páginas
    normais da Target não contêm.
    """
    return "captcha.px-" in body


def unlock(url, attempts=3):
    """Busca uma URL através da Web Unlocker API e retorna a resposta da Target."""
    status = None
    for attempt in range(attempts):
        try:
            r = requests.post(
                "https://api.brightdata.com/request",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json={"zone": ZONE, "url": url, "format": "raw"},
                timeout=120,
            )
        except requests.RequestException as error:
            status = type(error).__name__
            time.sleep(2 ** attempt)
            continue
        # A Web Unlocker API relata o resultado próprio da Target nos
        # cabeçalhos x-brd-status-code e x-brd-error.
        status = int(r.headers.get("x-brd-status-code", r.status_code))
        if is_human_block(r.text):
            status = "blocked"  # um bloqueio pode chegar com qualquer código de status
        elif status in (200, 206):
            return status, r.text
        elif "404" in r.headers.get("x-brd-error", ""):
            return 404, ""  # página de produto inativa: não tentar novamente
        time.sleep(2 ** attempt)
    return status, ""


def web_api_key():
    """Lê a chave de API web que a Target incorpora em suas próprias páginas."""
    status, page = unlock("https://www.target.com/")
    keys = re.findall(r'apiKey\\?"\s*:\s*\\?"([0-9a-f]{40})', page)
    if not keys:
        raise RuntimeError(f"no apiKey in the home page (status {status})")
    return collections.Counter(keys).most_common(1)[0][0]


def store_for_zip(key, zip_code):
    """Resolve um CEP para o ID da loja Target mais próxima."""
    query = urlencode({"key": key, "place": zip_code, "limit": 1,
                       "within": 100, "channel": "WEB", "page": "/s"})
    status, body = unlock(f"{REDSKY}nearby_stores_v1?{query}")
    try:
        store = json.loads(body)["data"]["nearby_stores"]["stores"][0]
    except (ValueError, KeyError, IndexError) as error:
        raise RuntimeError(f"no store for {zip_code} ({status})") from error
    return store["store_id"], store["location_name"]


def price_rows(key, tcin, store_id, zip_code):
    """Retorna uma linha por variante vendável (TCIN filho) em uma loja."""
    query = urlencode({"key": key, "tcin": tcin, "store_id": store_id,
                       "pricing_store_id": store_id,
                       "has_pricing_store_id": "true", "channel": "WEB",
                       "page": f"/p/A-{tcin}"})
    status, body = unlock(f"{REDSKY}pdp_client_v1?{query}")
    error = {"tcin": tcin, "store_id": store_id, "zip": zip_code}
    try:
        product = json.loads(body)["data"]["product"]
    except (ValueError, KeyError, TypeError):
        return [{**error, "error": status or "no_response"}]
    # Um TCIN filho retorna seu pai. O preço do pai é uma faixa, então
    # salve o preço de cada filho em sua própria linha.
    items = product.get("children") or [product]
    now = datetime.now(timezone.utc).isoformat(timespec="seconds")
    rows = []
    for item in items:
        price = item.get("price", {})
        priced_at = str(price.get("location_id"))
        rows.append({
            "tcin": item["tcin"],
            "parent_tcin": product["tcin"],
            "title": html.unescape(
                item["item"]["product_description"]["title"]),
            "zip": zip_code,
            "store_id": store_id,
            "priced_at": priced_at,
            "scope": "online" if priced_at == ONLINE_STORE else "store",
            "price": price.get("current_retail"),
            "regular_price": price.get("reg_retail"),
            "price_type": price.get("formatted_current_price_type"),
            "collected_at": now,
        })
    return rows


def valid(row):
    """Mantém linhas com um preço da loja solicitada ou da loja online."""
    return (isinstance(row.get("price"), (int, float))
            and row["priced_at"] in (str(row["store_id"]), ONLINE_STORE))


if __name__ == "__main__":
    tcins = sys.argv[1].split(",")
    zips = sys.argv[2].split(",")
    key = web_api_key()
    stores = {z: store_for_zip(key, z) for z in zips}
    jobs = [(t, stores[z][0], z) for t in tcins for z in zips]
    with ThreadPoolExecutor(max_workers=8) as pool:
        results = list(pool.map(lambda job: price_rows(key, *job), jobs))
    # TCINs de uma família retornam as mesmas linhas. Mantenha uma linha por
    # variante e loja, e nunca deixe um erro substituir uma linha com preço.
    unique = {}
    for row in (r for batch in results for r in batch):
        slot = (row["tcin"], row["store_id"])
        if slot not in unique or "error" in unique[slot]:
            unique[slot] = row
    good = [r for r in unique.values() if valid(r)]
    bad = [r for r in unique.values() if not valid(r)]
    # Anexa, para que cada execução adicione ao histórico de preços.
    for name, batch in (("target_prices", good), ("target_rejects", bad)):
        with open(f"{name}.jsonl", "a") as out:
            out.writelines(json.dumps(row) + "\n" for row in batch)
    print(f"{len(good)} válidos, {len(bad)} rejeitados, lojas: {stores}")
Com 2 TCINs de entrada em 2 CEPs, o script produziu 12 linhas, porque cada solicitação retornou toda a família de variantes:
12 válidos, 0 rejeitados, lojas: {'10001': ('3412', 'Chelsea 23rd and 8th'), '99501': ('2371', 'Anchorage NE')}As primeiras linhas de target_prices.jsonl mostram a família de leite na loja Chelsea:
{"tcin": "15078348", "parent_tcin": "94758333", "title": "Parmalat UHT 2% Reduced Fat Milk - 32 fl oz", "zip": "10001", "store_id": "3412", "priced_at": "3412", "scope": "store", "price": 3.89, "regular_price": 3.89, "price_type": "reg", "collected_at": "2026-09-27T05:34:07+00:00"}
{"tcin": "15078349", "parent_tcin": "94758333", "title": "Parmalat UHT Whole Milk - 32 fl oz", "zip": "10001", "store_id": "3412", "priced_at": "3412", "scope": "store", "price": 3.89, "regular_price": 3.89, "price_type": "reg", "collected_at": "2026-09-27T05:34:07+00:00"}
A execução que produziu a tabela de preços incluiu 128 pares de produto e loja, 16 produtos em 8 lojas, e gravou 800 linhas sem rejeições. Este script repetiu a execução no dia seguinte em 97 segundos com 8 workers, e todos os 800 preços coincidiram com a primeira execução. O script também mantém um arquivo target_rejects.jsonl para qualquer par que precise de nova tentativa.
A Web Unlocker API relata o resultado próprio da Target nos cabeçalhos x-brd-status-code e x-brd-error, então o script lê ambos. Para um produto removido, x-brd-error mostra o 404 da Target, e o script o registra sem tentar novamente.
Cada decisão de design lida com uma falha que pode ocorrer em um scraper da Target:
- Chave da página: o scraper continua funcionando após uma rotação de chave, contanto que a página ainda incorpore a chave como
apiKey. - Uma linha por filho: sua tabela nunca armazena uma faixa do pai.
- Coluna
scope: um preço online é rotulado comoonline, para não ser confundido com um preço de loja. - Verificação de bloqueio: um bloqueio da HUMAN em HTML ou JSON é registrado como
blocked, qualquer que seja o código de status. - Sem sobrescrita: um erro para uma variante nunca substitui a linha de outra variante que tenha um preço.
- Arquivo de rejeitados: linhas sem um preço de loja válido ou preço online são salvas para uma passagem de nova tentativa, e produtos removidos mantêm seu
404.
O código depende de pdp_client_v1 e nearby_stores_v1, então envie uma solicitação canário diária para ambos e alerte quando o esquema de resposta mudar. Nosso guia sobre retentar solicitações Python falhas explica o backoff em mais detalhes.
Para rodar o mesmo código em proxies residenciais, envie um requests.get() com proxy dentro de unlock() e trate um 404 simples como um produto removido. O restante do script permanece o mesmo. Com proxies residenciais, você controla o cliente e o user agent, então teste-os e cada endpoint contra a Target antes de escalar.
Coletar produtos da Target com o Target Scraper API
O Target Scraper API é o scraper da Web Scraper API para a Target. Você envia URLs de produtos e CEPs, e ele retorna registros estruturados com campos como preço, variantes, avaliações, especificações e vendedor. A Bright Data mantém o parsing e os endpoints, então seu código apenas normaliza os registros. A Bright Data também oferece um Target Price Scraper, um Target Reviews Scraper e um Target Image Scraper para trabalhos mais específicos.
O console mostra os campos de entrada do scraper acima dos seus modos síncrono e assíncrono. Os campos são uma URL, uma flag all_variations e um CEP:
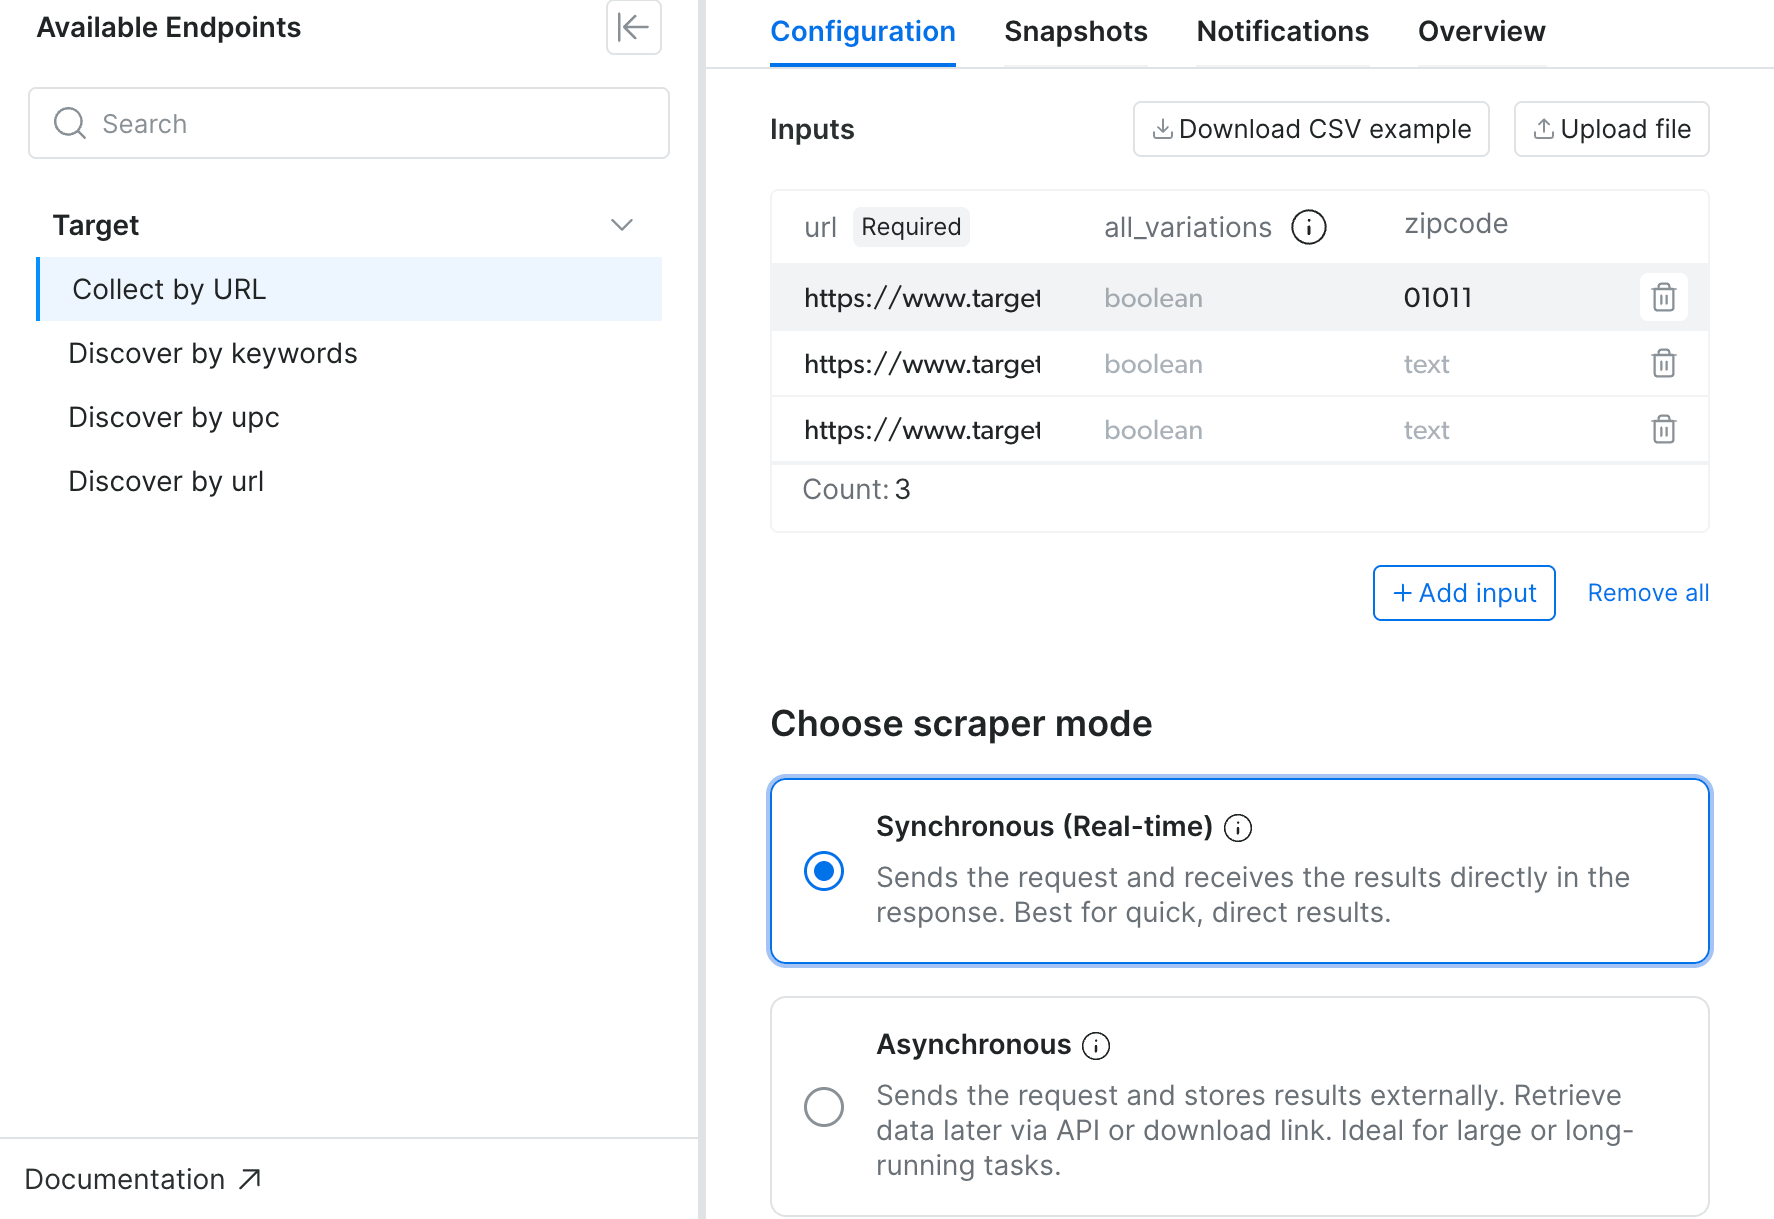
Cada linha de entrada lista um único produto e pode adicionar um CEP, que define a localização para o preço do registro.
A Web Scraper API cobra apenas por registros entregues. A página de preços da Web Scraper API lista as taxas atuais, e o nível gratuito inclui 5.000 solicitações por mês sem necessidade de cartão de crédito. Para uma biblioteca cliente, instale o SDK Python da Bright Data com pip install brightdata-sdk.
O script abaixo inicia um trabalho assíncrono, aguarda sua conclusão, baixa os registros e os normaliza:
"""Coleta registros de produtos da Target por URL e CEP com a Web Scraper API.

Uso:
    export BRIGHTDATA_API_KEY=...
    python target_scraper_api.py inputs.csv   # colunas: url,zipcode
"""
import csv
import json
import os
import re
import sys
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_ltppk5mx2lp0v1k0vo"  # scraper de produtos da Target
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}


def trigger(inputs):
    """Inicia uma coleta assíncrona e retorna seu snapshot ID."""
    r = requests.post(
        f"{API}/trigger",
        headers=HEADERS,
        params={"dataset_id": DATASET_ID, "include_errors": "true"},
        json=inputs,
        timeout=60,
    )
    r.raise_for_status()
    return r.json()["snapshot_id"]


def wait(snapshot_id, poll_seconds=15, max_minutes=60):
    """Consulta o snapshot até ficar pronto e retorna seu registro de progresso."""
    deadline = time.time() + max_minutes * 60
    while time.time() < deadline:
        progress = requests.get(f"{API}/progress/{snapshot_id}",
                                headers=HEADERS, timeout=30).json()
        if progress["status"] in ("ready", "failed"):
            return progress
        time.sleep(poll_seconds)
    raise TimeoutError(snapshot_id)


def download(snapshot_id):
    """Baixa todos os registros, incluindo registros de erro, como uma lista."""
    r = requests.get(f"{API}/snapshot/{snapshot_id}",
                     headers=HEADERS, params={"format": "json"}, timeout=300)
    r.raise_for_status()
    return r.json()


def normalize(record):
    """Mapeia um registro para uma linha plana, ou retorna None para um registro de erro."""
    if record.get("error_code"):
        return None
    price = record.get("final_price")
    if price is None and record.get("price_range"):
        # Um registro pode ter seu preço em price_range, como "$24.99".
        match = re.fullmatch(r"\$([\d,]+\.\d{2})", record["price_range"])
        price = float(match.group(1).replace(",", "")) if match else None
    origin = record.get("discovery_input") or record.get("input") or {}
    reviewed = bool(record.get("reviews_count"))  # avaliação 0 significa sem avaliação
    url_tcin = re.search(r"/A-(\d+)", record.get("url") or "")
    return {
        "tcin": url_tcin.group(1) if url_tcin else record.get("tcin_id"),
        "parent_tcin": record.get("group_id"),
        "title": record.get("title"),
        "zipcode": origin.get("zipcode") or None,
        "price": price,
        "initial_price": record.get("initial_price"),
        "available": record.get("is_available"),
        "rating": record.get("rating") if reviewed else None,
        "reviews_count": record.get("reviews_count"),
        "collected_at": record.get("timestamp"),
    }


if __name__ == "__main__":
    with open(sys.argv[1], newline="") as f:
        inputs = [{"url": row["url"], "zipcode": row["zipcode"]}
                  for row in csv.DictReader(f)]
    snapshot_id = trigger(inputs)
    progress = wait(snapshot_id)
    records = download(snapshot_id)
    rows = [row for row in map(normalize, records) if row]
    with open("target_records.jsonl", "w") as out:
        out.writelines(json.dumps(row) + "\n" for row in rows)
    print(f"snapshot {snapshot_id}: {len(rows)} linhas, "
          f"erros: {progress.get('error_codes', {})}")
O arquivo de entrada tem o leite em 2 CEPs, mais um conjunto LEGO de preço nacional e um pacote Tide de 112 unidades, ambos em Anchorage. A última linha é um produto que a Target removeu:
url,zipcode
https://www.target.com/p/-/A-15078349,10001
https://www.target.com/p/-/A-15078349,60601
https://www.target.com/p/-/A-86216189,99501
https://www.target.com/p/-/A-84114518,99501
https://www.target.com/p/petal-and-pup-skarlett-top/-/A-1002219928,10001
O trabalho retornou 4 registros e sinalizou o produto removido como dead_page:
snapshot sd_muifuppi1d0g830zfd: 4 linhas, erros: {'dead_page': 1}Todos os 4 preços coincidiram com nosso scraper. O café Market Pantry e o pacote Tide de 31 unidades variaram em preço por localização. Nós os comparamos com nosso scraper em todos os 8 CEPs, ao mesmo tempo:
| Produto | Pares de produto e CEP | Preços distintos | Correspondeu com nosso scraper |
|---|---|---|---|
| Market Pantry Classic Roast, 25,9 oz | 8 | 7 | 8 de 8 |
| Cápsulas Tide Original, 31 unidades | 8 | 5 | 8 de 8 |
| Leite, conjunto LEGO e Tide 112 unidades (arquivo de entrada acima) | 4 | Não aplicável | 4 de 4 |
Todos os 20 pares de produto e CEP corresponderam ao preço do nosso scraper na loja mais próxima. Um dia depois, uma nova execução do arquivo de entrada retornou o novo preço promocional de $2,97 de Chicago, que nosso scraper confirmou.
Cada registro inclui o CEP usado para seu preço e uma flag de disponibilidade para esse CEP. O normalizador mapeia estes campos:
- ID do pai:
group_idtem o TCIN do pai. - Origem:
inputtem a URL e o CEP de um registro coletado.discovery_inputtem a palavra-chave ou URL de categoria, e qualquer CEP, quando o Target Scraper API encontrou o produto sozinho. - Preço: o normalizador pega o preço de
final_priceouprice_range. - Produtos sem avaliação: uma
ratingde 0 com 0 avaliações significa que o produto não tem avaliação.
Escolha o modo síncrono ou assíncrono
O endpoint síncrono /scrape retorna resultados na resposta para trabalhos rápidos e retorna um snapshot_id para consultar em trabalhos mais longos. A documentação de solicitações síncronas fornece o limite de tempo atual. Use /trigger para lotes agendados. Você consulta um snapshot_id de qualquer endpoint da mesma forma.
Para trabalhos recorrentes, configure a API para entregar os resultados. As opções de entrega incluem webhooks e armazenamento em nuvem como Amazon S3, Google Cloud Storage e Microsoft Azure. Em /scrape, defina limit_per_input no corpo da solicitação para limitar os registros por entrada, como mostra a documentação.
Descubra produtos por palavra-chave ou categoria
O Target Scraper API também pode encontrar produtos para você:
- Palavra-chave: “dog treats” e “shirts” com
limit_per_inputdefinido para 20 retornaram 40 registros sem erros. - URL de categoria: 2 páginas de categoria, cada uma com um CEP, retornaram 40 registros.
O normalizador acima já lê discovery_input, então o mesmo código processa registros descobertos.
Use o Browser API para sessões e depuração
O Browser API roda um Chrome remoto que você controla com Playwright ou Puppeteer sobre o Chrome DevTools Protocol (CDP), ou com Selenium sobre WebDriver. Na Target, ele carregava a página do produto como uma sessão de navegador completa, incluindo o script da HUMAN. Por carregar a página inteira, o Browser API funciona bem para capturar o tráfego de rede depois que a Target muda seu front end.
O Bright Data MCP Server fornece ferramentas para agentes de IA através do Model Context Protocol (MCP). Suas ferramentas de navegador dão aos agentes o mesmo navegador remoto para fluxos de trabalho que clicam ou digitam em uma página.
O Browser API cobra por GB, como mostra a página de preços do Browser API. Bloquear imagens e rastreadores ajuda a manter cada sessão pequena. Assim que uma captura mostra as solicitações que você precisa, a Web Unlocker API pode enviá-las diretamente, sem carregar a página.
Sem um cookie de localização armazenado, a Target atribuiu a cada uma de nossas sessões de navegador nos EUA uma loja próxima ao IP de saída. O comando Proxy.setLocation do Browser API, enviado via CDP, seleciona um IP de saída próximo às coordenadas que você escolher. Para rodar o script, instale playwright e defina a string de conexão de uma zona do Browser API na variável de ambiente BROWSER_API_WSS, como mostra o guia rápido do Browser API:
import asyncio
import os

from playwright.async_api import async_playwright

# wss://brd-customer-<id>-zone-<zone>:<password>@brd.superproxy.io:9222
WSS = os.environ["BROWSER_API_WSS"]


async def main():
    async with async_playwright() as pw:
        browser = await pw.chromium.connect_over_cdp(WSS)
        page = await browser.contexts[0].new_page()
        cdp = await page.context.new_cdp_session(page)
        # Saída próxima a Manhattan, para que a Target geolocalize a sessão ali.
        await cdp.send("Proxy.setLocation", {
            "lat": 40.7506, "lon": -73.9972, "distance": 10, "strict": True,
        })
        await page.goto("https://www.target.com/p/-/A-15078349",
                        wait_until="domcontentloaded", timeout=120_000)
        # A página renderiza o preço duas vezes, e uma cópia fica oculta.
        price = page.locator('[data-test="product-price"]').first
        await price.wait_for(state="attached", timeout=60_000)
        cookies = await page.context.cookies("https://www.target.com")
        store = {c["name"]: c["value"] for c in cookies}.get("fiatsCookie")
        print(store, await price.text_content())
        await browser.close()

asyncio.run(main())
Em 3 execuções com as mesmas coordenadas, a Target atribuiu 3 lojas de Nova York diferentes próximas a essas coordenadas. O valor de fiatsCookie listava o ID da loja (DSI), nome (DSN) e CEP (DSZ):
DSI_2475|DSN_Bronx%20Terminal|DSZ_10451 $3.59
DSI_3284|DSN_Lower%20East%20Side%20Grand%20and%20Clinton|DSZ_10002 $3.99
DSI_3394|DSN_Upper%20West%20Side%2098th%20and%20Columbus|DSZ_10025 $3.99
Como cada sessão recebeu uma loja próxima, essa configuração é útil para amostrar preços em uma área metropolitana.
Compre o Target Dataset para preencher o catálogo
O Target Dataset oferece registros de produtos da Target pré-coletados que você pode filtrar e comprar sem rodar um scraper. Funciona bem para um preenchimento de catálogo que precisa de muitas linhas de uma vez.
A página do conjunto de dados lista a contagem atual de registros, campos e preços. No Dataset Marketplace, você pode filtrar registros e pré-visualizar uma amostra antes de comprar:
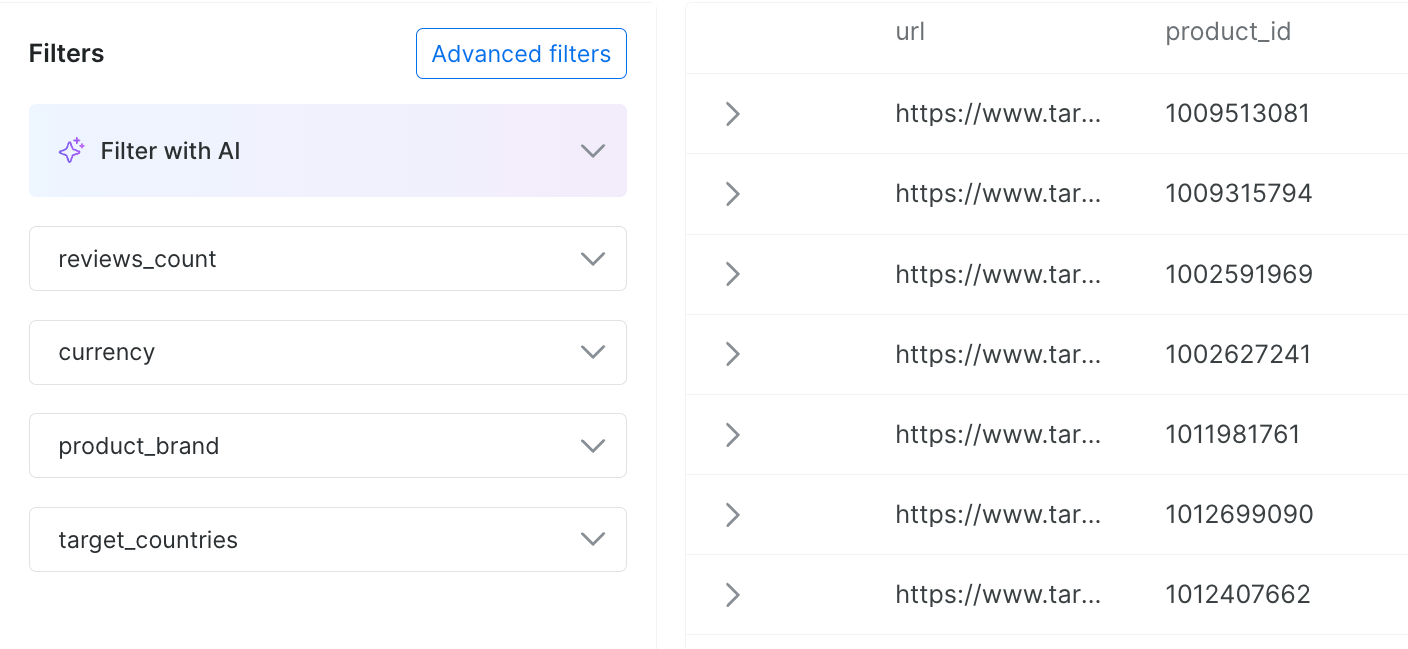
Os filtros de campo do conjunto de dados da Target e uma amostra de seus registros.
Antes de carregar, mapeie os registros para seu próprio esquema:
- IDs de produto: use o TCIN na URL de cada registro como chave da sua tabela, o mesmo ID que os scrapers acima usam.
- Avaliações: uma
ratingde 0 com 0 avaliações significa que o produto ainda não tem avaliação.
Escolha a abordagem pela localização, volume e taxa de atualização
Opções com mais controle precisam de mais manutenção, que cresce conforme a frequência com que a Target muda suas páginas e endpoints. Equipes que querem dashboards prontos da Target podem usar o Target Price Tracker ou o Target Inventory Tracker. Para outros varejistas, veja nosso guia de scraping de dados de e-commerce. Cada abordagem cobra por sua própria unidade, e a página de preços de cada produto lista as taxas atuais:
| Abordagem | Cobrado por | Escopo de 1 chamada ou registro | Melhor para |
|---|---|---|---|
| Seu código com Web Unlocker API | Solicitação bem-sucedida | 1 família de variantes em 1 ID de loja | IDs de loja e estoque por canal |
| Seu código com proxies residenciais | GB de tráfego | 1 família de variantes em 1 ID de loja, cerca de 15 KB comprimidos em nossos testes | Baixo custo por chamada, com controle total do cliente |
| Target Scraper API | Registro entregue | 1 produto em 1 CEP | Coleta recorrente com parsing e manutenção feitos para você |
| Browser API | GB de tráfego | 1 sessão completa de navegador | Sessões e depuração |
| Target Dataset | Registro | 1 registro de produto pré-coletado | Preenchimento e pesquisa de catálogo |
Escolha pela forma como você rastreia localizações. Se você rastreia por CEP, o Target Scraper API coincidiu com o preço da loja mais próxima em nossos testes, e a Bright Data o mantém para você. Se você rastreia IDs de loja e estoque por canal, rode seu próprio código na Web Unlocker API ou em proxies residenciais. Para um preenchimento, escolha o conjunto de dados, como explica nossa comparação entre conjuntos de dados e APIs de scraping de dados.
Antes de escolher, estime o volume mensal multiplicando produtos por lojas, por atualizações por dia, e por 30. Rastrear 5 mil produtos em 50 lojas uma vez ao dia significa 7,5 milhões de solicitações ou registros por mês. O estoque por canal adiciona 1 solicitação product_fulfillment_v1 por TCIN e loja. Multiplique o total pela taxa por unidade na página de preços, onde planos mensais reduzem a taxa.
Seu próprio código pode enviar menos solicitações do que essa estimativa, de 2 formas. Dos nossos 16 produtos de teste, 4 tinham o mesmo preço em todas as lojas e precisavam de apenas 1 solicitação por atualização. Uma solicitação à API de produto também retorna toda uma família de variantes, então 128 pares de produto e loja produziram 800 linhas em nossa execução.
Em proxies residenciais, 7,5 milhões de chamadas pdp_client_v1 comprimidas em gzip transfeririam cerca de 110 GB. Como observa a página de preços de proxies residenciais, o faturamento conta cabeçalhos e corpos, que em média foram 15 KB por chamada para nós. O FAQ de faturamento explica como o tráfego é medido. Solicite respostas comprimidas, porque os mesmos corpos de pdp_client_v1 tinham em média 134 KB sem compressão e 14 KB com gzip.
A Web Unlocker API lida com o desbloqueio para você e cobra apenas por solicitações bem-sucedidas. Em nosso teste de IP e cliente, ela passou em todas as chamadas em IPs de saída dos EUA sem ajuste de cliente. Você também pode usar tanto a Web Unlocker API quanto proxies residenciais. Envie as solicitações de cada endpoint pela opção que se encaixa no seu volume, e mova um endpoint para a Web Unlocker API quando a verificação de bots da Target mudar.
Valide e monitore a coleta da Target
Um bloqueio que is_human_block() detecta aparece como um erro. Um preço de loja errada que parece válido aparece como dados, então nenhum erro o sinaliza. As verificações abaixo ajudam a detectar falhas que podem parecer dados válidos ou desperdiçar solicitações:
| Verificação | Onde procurar | Detecta |
|---|---|---|
| O preço é um número acima de zero | price |
Preços ausentes e faixas |
| O preço veio da loja que você solicitou, ou é rotulado como online | location_id, scope |
Preços de loja errada |
| A linha é um TCIN filho | tcin, children |
Faixas de nível do pai |
| O corpo tem o esquema JSON esperado e nenhum bloqueio da HUMAN | Corpo da resposta | Respostas de bloqueio HTML e JSON (HTTP 435) |
| O produto ainda existe | 404, dead_page |
URLs inativas repetidas em cada execução |
| A mudança de preço desde a última execução está dentro do seu limite | Histórico de preços | Preços mal interpretados ou errados |
Execute as verificações em cada lote, e salve cada linha com seu TCIN, ID da loja e horário de coleta, para que o histórico cresça. Conte as falhas por motivo, como um bloqueio, uma loja errada, um produto removido ou um timeout. Uma taxa geral de falhas pode esconder um aumento de falhas por um motivo específico, então alerte quando a taxa de qualquer motivo subir acima do normal. Acompanhe também o custo por registro bem-sucedido, para poder comparar abordagens com a mesma medida.
Considerações finais
A Target mostra seus dados de produtos publicamente, mas um preço pode depender da loja, da variante e do momento em que você o coleta. Em nossos testes, preços online da localização 3991, faixas de preço do pai e respostas de bloqueio JSON pareciam todos dados válidos. Mantenha o ID da loja, a variante e o status da solicitação com cada linha, e execute um canário diário contra todo endpoint do qual você depende.
A Web Unlocker API lida com o desbloqueio e seu código controla lojas e canais, enquanto o Target Scraper API também lida com parsing e manutenção. Para escolher, execute uma amostra dos seus produtos e CEPs em ambos através do nível gratuito, que inclui 5.000 solicitações por mês sem necessidade de cartão de crédito, e compare os preços.
FAQ
A Target tem uma API de produtos pública?
Não, o portal de desenvolvedores da Target é apenas para funcionários da Target, vendedores Target Plus e parceiros. O site chama APIs JSON internas em redsky.target.com com uma chave de API de suas páginas, e esses endpoints podem mudar sem aviso. O Target Scraper API da Bright Data retorna registros de produtos a partir de uma URL e um CEP.
Como obter preços de produtos da Target por loja?
Chame a API de produto da Target com um ID de loja e sua chave de API pública para obter o preço de cada variante nessa loja. Outro endpoint mapeia um CEP para o ID de loja mais próximo. Um ID de localização 3991 marca o preço online da Target, não um preço de loja. O Target Scraper API da Bright Data retorna preços para o CEP que você enviar.
É possível rastrear o estoque da Target por loja?
Sim, em nossos testes, o endpoint product_fulfillment_v1 da Target retornou uma contagem de unidades e o status de envio, retirada e disponibilidade na loja para a loja solicitada. Uma loja de Nova York tinha 0 unidades e uma loja próxima tinha 6, enquanto o envio mostrava o item em estoque. Salve o estoque por loja e por canal.
Quanto custa fazer scraping de dados da Target?
O custo cresce com o número de produtos, lojas e atualizações diárias. Rastrear 5 mil produtos em 50 lojas diariamente significa 7,5 milhões de solicitações ou registros por mês. A Bright Data cobra registros da Web Scraper API na entrega, solicitações da Web Unlocker API no sucesso, e proxies residenciais por GB. Cada página de preços lista as taxas atuais.
Como fazer scraping de produtos da Target gratuitamente?
O nível gratuito da Bright Data inclui 5.000 solicitações por mês sem necessidade de cartão de crédito, e cobre tanto o Target Scraper API quanto a Web Unlocker API, para que você possa testar preços em seus próprios produtos. Solicitações HTTP simples são gratuitas, mas a verificação de bots da Target bloqueou clientes com configurações padrão de IPs dos EUA em nossos testes.