DSPy é um framework Python que melhora programas de modelos de linguagem com dados. DSPy carrega ferramentas de agentes de servidores Model Context Protocol (MCP). Com o servidor MCP da Bright Data, um agente pesquisa no Google e lê páginas como Markdown, enquanto o servidor cuida da proteção contra bots.
O padrão do tutorial MCP do DSPy funciona bem para uma única execução do agente. O avaliador do DSPy e o GEPA, seu otimizador de prompts, executam agentes em threads de worker, onde chamadas de ferramentas assíncronas falharam silenciosamente nos testes e o agente respondeu de memória.
Este guia mostra como construir esse agente, executar suas ferramentas em paralelo e medir o que os dados da web acrescentam.
Resumo
- Dados da web aumentaram a precisão. Com o servidor MCP da Bright Data, o
gpt-5.4-minirespondeu corretamente 54-58 de 60 perguntas, subindo de 14, e todas as 8 sobre eventos após seu corte de conhecimento, subindo de 0. - Escolha 2 ferramentas e adicione um callback de elicitação. Menos ferramentas mantêm os prompts pequenos. O callback aprova páginas marcadas como possível injeção de prompt.
- Forneça ferramentas síncronas para execuções em threads. Ferramentas assíncronas falharam silenciosamente ou travaram no
dspy.Evaluatee no GEPA. Um loop de eventos em segundo plano corrigiu ambos. - Corrija as ferramentas primeiro. O GEPA copiou respostas de treinamento para suas instruções sem aumentar a pontuação. Em 6 perguntas de páginas longas, um argumento
findreduziu pela metade os tokens de prompt.
O que você precisa
O agente se conecta via HTTP ao Web MCP da Bright Data, o servidor MCP hospedado da Bright Data, então Python é o único runtime a instalar. O servidor roda na Web Unlocker API, que cuida da rotação de proxy e proteção contra bots para o agente. Para o código, o repositório GitHub complementar tem todos os scripts e arquivos de dados, incluindo evaluate.py e post_cutoff_questions.csv para as etapas de avaliação. Você precisa de:
- Python 3.10 ou posterior, e uv para instalar pacotes
- Uma conta Bright Data gratuita e sua chave de API em Configurações da Conta
- Uma chave de API OpenAI, ou uma chave de outro provedor que
dspy.LMsuporte com chamada de ferramentas
Copie a chave Bright Data da tabela de chaves de API na aba Usuários e chaves de API:
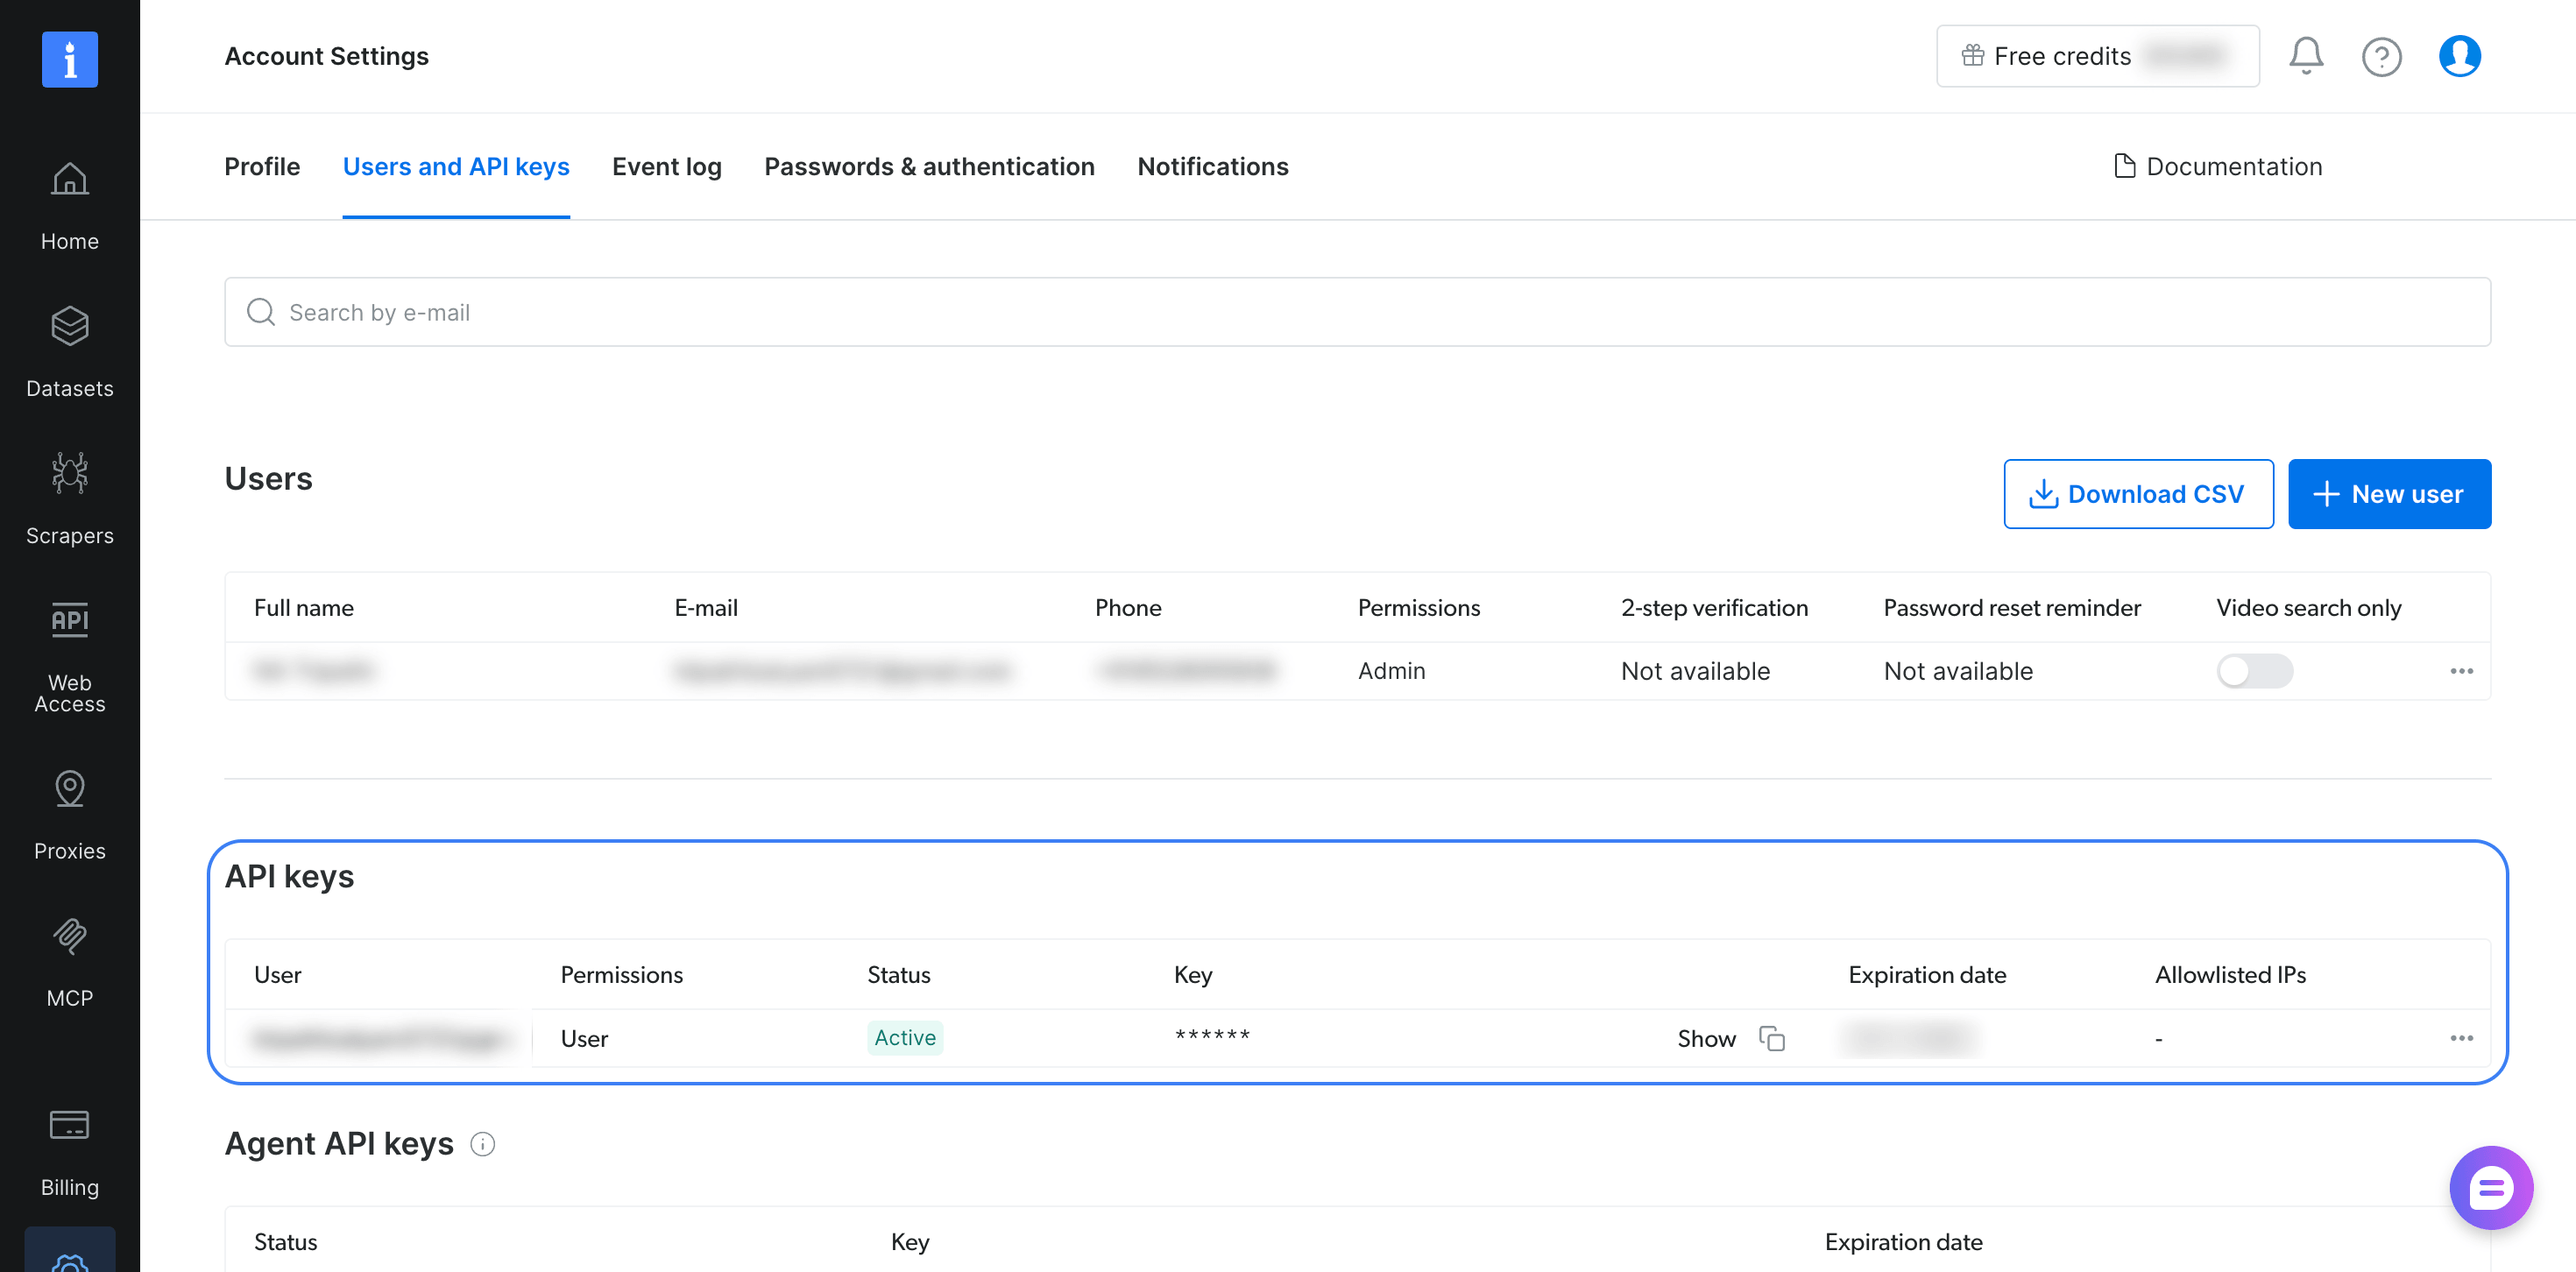
A mesma chave funciona com o servidor hospedado e o servidor local.
Clone o repositório, instale o DSPy com seu extra MCP, fixado nas versões testadas, e exporte ambas as chaves:
git clone https://github.com/triposat/dspy-bright-data-research-agent && cd dspy-bright-data-research-agent
uv venv && source .venv/bin/activate
uv pip install "dspy[mcp]==3.4.1" "mcp==2.3.0"
export BRIGHTDATA_API_TOKEN="sua-chave-de-api-bright-data"
export OPENAI_API_KEY="sua-chave-de-api-openai"
O comando fixa o MCP Python SDK na versão testada 2.3.0, porque o extra dspy[mcp] no DSPy 3.4.1 não fixa a versão do SDK. Você pode começar com solicitações mensais gratuitas, e a página de preços do servidor MCP lista o limite atual.
Conecte o servidor MCP da Bright Data ao DSPy
dspy.Tool.from_mcp_tool converte cada ferramenta que um servidor MCP lista em uma ferramenta DSPy, então o agente vê o nome, descrição e esquema de argumentos de cada ferramenta. O script abaixo, agent.py no repositório, conecta-se ao servidor MCP hospedado da Bright Data e carrega suas ferramentas de busca e scraping. Em seguida, pergunta sobre um evento após o corte de conhecimento do modelo:
import asyncio
import os

import dspy
from mcp import types
from mcp.client import Client
from mcp.client.streamable_http import create_mcp_http_client, streamable_http_client

dspy.configure(
    lm=dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000),
    adapter=dspy.ChatAdapter(use_native_function_calling=True),
)

SERVER_URL = "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_as_markdown"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}


async def approve_page(context, params):
    # O servidor pergunta antes de retornar uma página que contém instruções
    # de configuração MCP. As ferramentas deste agente apenas leem a web, então retorne-a.
    return types.ElicitResult(action="accept", content={"return_content": True})


class ResearchQuestion(dspy.Signature):
    """Responda à pergunta com fatos encontrados na web."""

    question: str = dspy.InputField()
    answer: str = dspy.OutputField(desc="uma resposta curta e direta")
    sources: list[str] = dspy.OutputField(desc="URLs das páginas que sustentam a resposta")


async def main():
    async with create_mcp_http_client(headers=HEADERS) as http:
        transport = streamable_http_client(SERVER_URL, http_client=http)
        async with Client(transport, elicitation_callback=approve_page) as client:
            mcp_tools = (await client.list_tools()).tools
            tools = [dspy.Tool.from_mcp_tool(client, t) for t in mcp_tools]
            agent = dspy.ReActV2(ResearchQuestion, tools=tools, max_iters=8)

            question = "Quem venceu a final da Copa do Mundo da FIFA de 2026, e qual foi o placar?"
            pred = await agent.acall(question=question)
            for event in pred.history.messages:
                for call in getattr(event.get("tool_calls"), "tool_calls", []):
                    print(f"{call.name}: {call.args}")
            print("\nResposta:", pred.answer)
            print("Fontes:", pred.sources)


asyncio.run(main())
Executar python agent.py imprimiu 2 buscas, depois a chamada final submit:
search_engine: {'query': '2026 FIFA World Cup final winner score', 'engine': 'google', 'cursor': '', 'geo_location': 'us'}
search_engine: {'query': '2026 FIFA World Cup final winner score site:en.wikipedia.org OR site:fifa.com', 'engine': 'google', 'cursor': '', 'geo_location': 'us'}
submit: {'answer': 'A Espanha venceu a final da Copa do Mundo da FIFA de 2026, derrotando a Argentina por 1–0 após a prorrogação.', 'sources': ['https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/final', 'https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/articles/spain-argentina-final-report-highlights']}

Resposta: A Espanha venceu a final da Copa do Mundo da FIFA de 2026, derrotando a Argentina por 1–0 após a prorrogação.
Fontes: ['https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/final', 'https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/articles/spain-argentina-final-report-highlights']
Sem ferramentas, o gpt-5.4-mini disse que a final da Copa do Mundo de 2026 é posterior ao seu corte de conhecimento.
O script é baseado no tutorial MCP do DSPy, que usa um servidor de demonstração local, e adiciona 3 configurações para o servidor hospedado.
Envie a chave de API em um cabeçalho. create_mcp_http_client envia a chave como um cabeçalho Authorization em cada solicitação, então a chave não aparece em URLs, que proxies e logs registram.
Escolha as ferramentas que o agente precisa. O servidor MCP da Bright Data oferece ferramentas para busca, scraping, tarefas em lote, automação de navegador e scrapers pré-construídos que retornam JSON estruturado para sites como Amazon e LinkedIn. O parâmetro de URL tools seleciona as que o agente vê, e a referência de ferramentas do servidor MCP lista cada nome, como search_engine_batch e scraping_browser_navigate. O esquema de cada ferramenta selecionada é enviado com cada chamada ao modelo, então este agente seleciona apenas search_engine e scrape_as_markdown para manter o prompt pequeno.
Responda às solicitações de elicitação do servidor. O servidor MCP da Bright Data inclui uma proteção contra injeção de prompt. Quando uma página extraída contém instruções para alterar uma configuração MCP, o servidor pede ao cliente para confirmar através de elicitação MCP antes de retornar a página. Passe um callback de elicitação para Client com o argumento elicitation_callback para que o cliente DSPy possa responder.
approve_page aprova cada solicitação porque este agente apenas lê a web. Para um agente que pode escrever arquivos ou alterar sua própria configuração, envie a solicitação a uma pessoa para aprovação.
Para executar o servidor localmente, instale o Node.js e passe StdioServerParameters(command="npx", args=["-y", "@brightdata/mcp@latest"], env=...) para o mesmo Client, com API_TOKEN e TOOLS em env. Com @latest, o npx busca a versão para a qual a tag latest aponta a cada inicialização. Para avaliações reprodutíveis, substitua pela versão que você testou nas versões do Bright Data MCP.
Em um notebook Jupyter, substitua asyncio.run(main()) por await main(), porque o Jupyter já executa um loop de eventos.
O script usa dspy.ReActV2, que a documentação do DSPy ReAct lista como a implementação que dspy.ReAct usa a partir do DSPy 3.5, com o nome ReActV2 removido na 3.6. O ReActV2 retorna history em vez de trajectory e finaliza com uma ferramenta submit. Ao atualizar, troque dspy.ReActV2 por dspy.ReAct e reexecute sua avaliação.
O mesmo servidor também funciona com outros frameworks de agentes, como AutoGen, LangGraph, e Pydantic AI.
Execute as ferramentas MCP do DSPy com threads e GEPA
No DSPy 3.4.1, dspy.Evaluate executa seu programa de forma síncrona em threads de worker, e o GEPA usa isso para avaliar cada instrução candidata. Ferramentas de from_mcp_tool são funções assíncronas vinculadas ao loop de eventos que abriu a sessão MCP. Nos testes, chamá-las de threads de worker síncronas falhou de 2 formas fáceis de passar despercebidas.
Com ferramentas carregadas como no tutorial MCP do DSPy, o Evaluate terminou sem exceção. Cada chamada de ferramenta falhou antes de chegar ao servidor, e o Python imprimiu apenas um aviso de que uma corrotina nunca foi aguardada. O agente respondeu de memória, e o Evaluate ainda reportou uma pontuação. Com a configuração allow_tool_async_sync_conversion do DSPy ativada, a execução travou e ainda estava esperando 9 minutos depois.
A correção mantém uma única sessão MCP aberta em um loop de eventos em segundo plano e fornece ao DSPy funções síncronas que enviam cada chamada para esse loop:
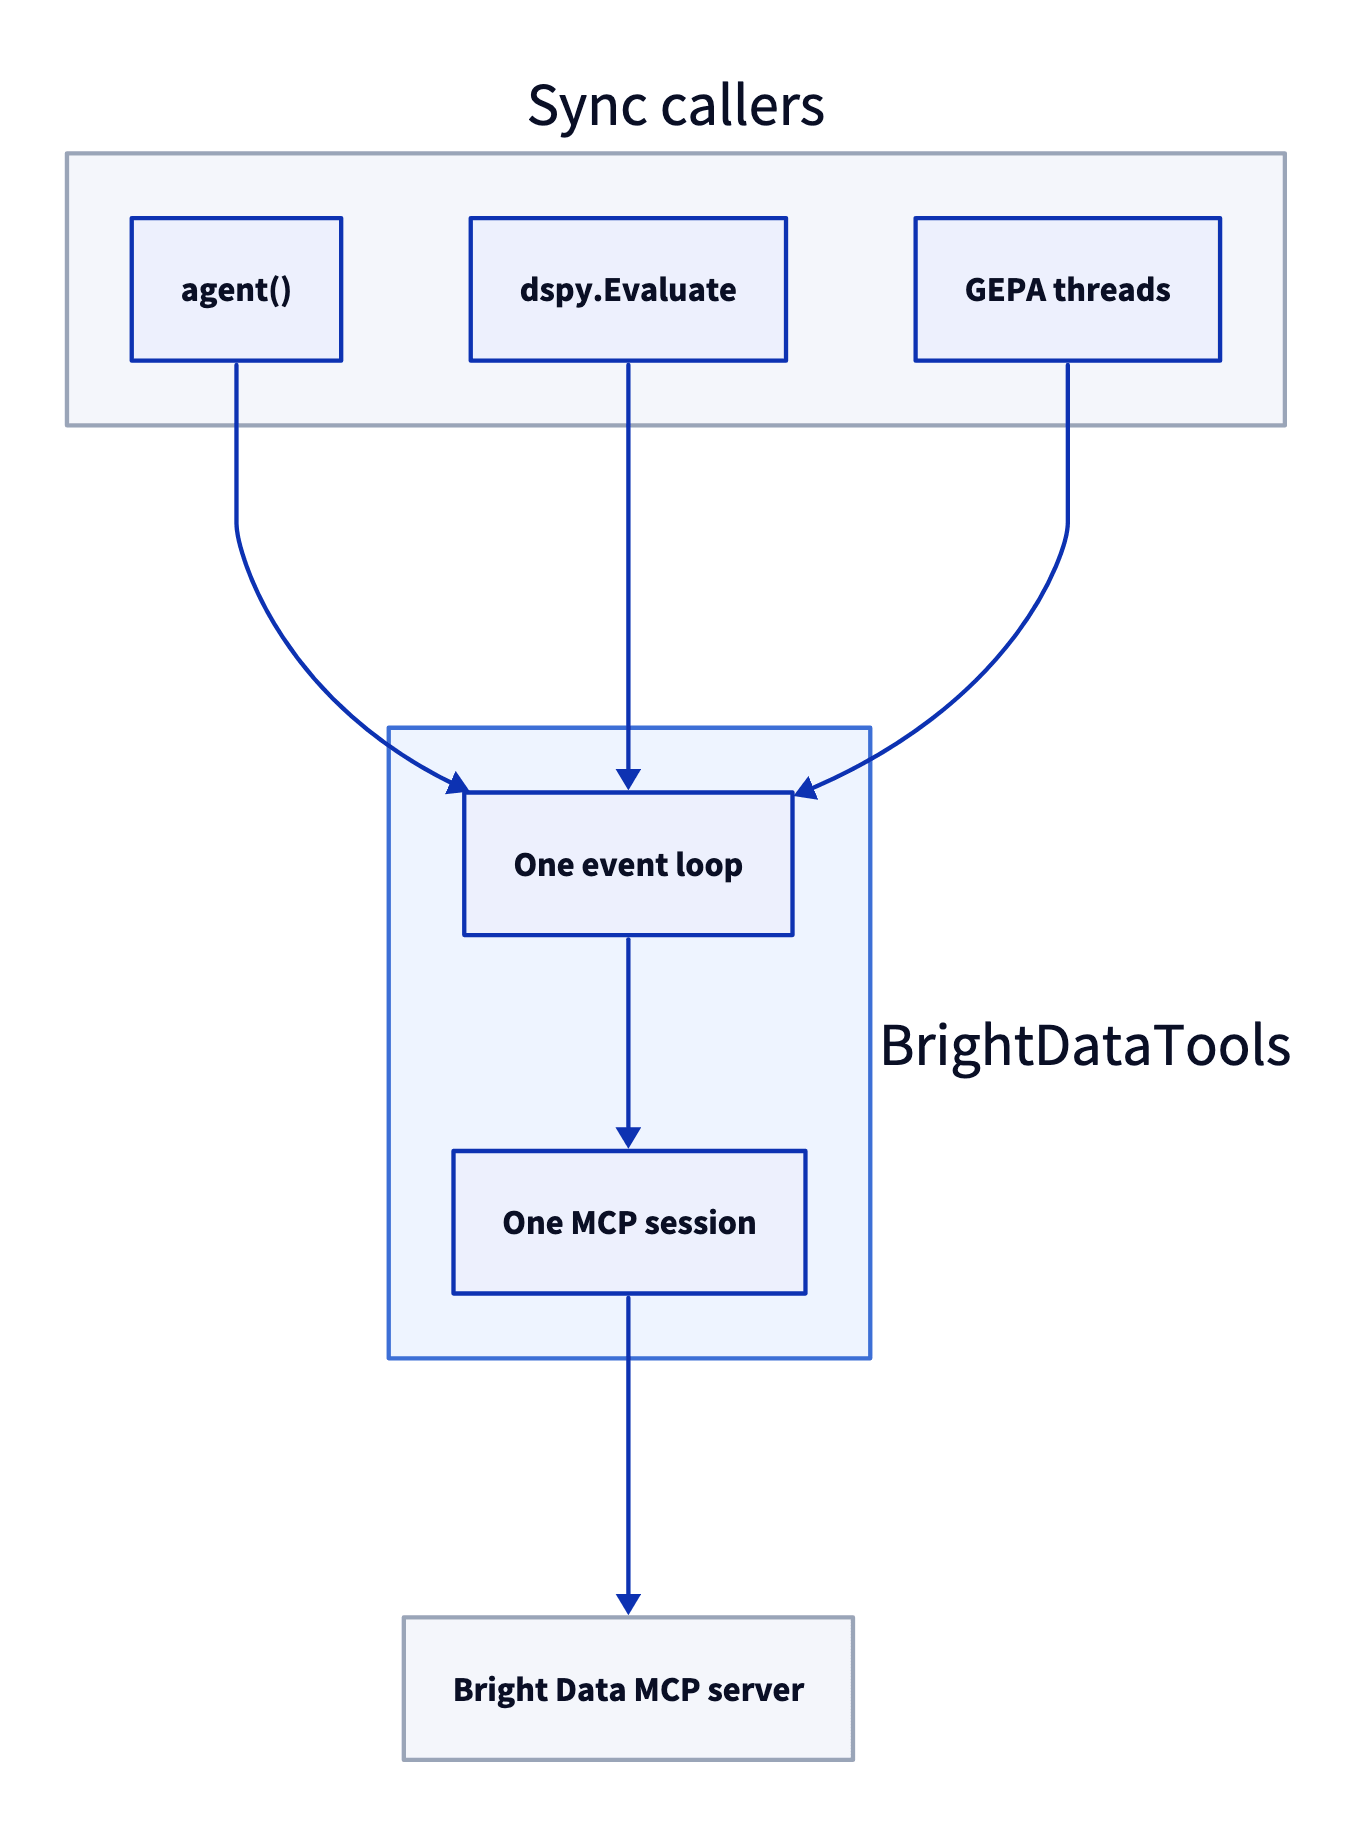
Cada chamada síncrona é enviada ao loop com run_coroutine_threadsafe, então apenas o loop de eventos que abriu a sessão MCP usa essa sessão.
A classe está em brightdata_tools.py, o módulo que os scripts de avaliação e otimização importam:
import asyncio
import json
import os
import re
import threading
from urllib.parse import urlparse

import dspy
from mcp import StdioServerParameters, types
from mcp.client import Client
from mcp.client.streamable_http import create_mcp_http_client, streamable_http_client

SERVER_URL = "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_as_markdown"
# O servidor MCP da Bright Data envolve os resultados em um aviso de segurança e dois marcadores
WRAPPED = re.compile(r"(=====UNTRUSTED_\w+_BEGIN=====\n)(.*)(\n=====UNTRUSTED_\w+_END=====)", re.S)


async def approve_page(context, params):
    # Ferramentas somente leitura, então páginas com texto de configuração MCP são retornadas como dados
    return types.ElicitResult(action="accept", content={"return_content": True})


class BrightDataTools:
    """Uma sessão MCP em um loop de eventos em segundo plano, exposta como dspy.Tools síncronas."""

    def __init__(self, country="us", max_chars=20_000, retries=2,
                 blocked_domains=(), timeout=180, cache=False, remote=True):
        self.country = country
        self.max_chars = max_chars
        self.retries = retries
        self.blocked = tuple(blocked_domains)
        self.timeout = timeout
        self.cache = {}  # páginas sempre, buscas também quando cache=True
        self.keep_all = cache  # reutiliza resultados de busca durante a otimização
        self.lock = threading.Lock()
        self.stats = {"calls": 0, "sent": 0, "errors": 0}
        self.error = None  # motivo da sessão MCP não iniciar ou parar
        self.remote = remote
        self.loop = asyncio.new_event_loop()
        self.ready = threading.Event()
        self.thread = threading.Thread(target=self.loop.run_until_complete,
                                       args=(self._serve(),), daemon=True)
        self.thread.start()
        self.ready.wait()
        if self.error:
            raise RuntimeError("Não foi possível conectar ao servidor MCP") from self.error

    async def _serve(self):
        try:
            await self._connect()
        except Exception as e:  # reporta em vez de esperar para sempre
            self.error = e
        finally:
            self.ready.set()

    async def _connect(self):
        token = os.environ["BRIGHTDATA_API_TOKEN"]
        if self.remote:  # servidor hospedado via HTTP streamable
            async with create_mcp_http_client(headers={"Authorization": f"Bearer {token}"}) as http:
                async with Client(streamable_http_client(SERVER_URL, http_client=http),
                                  elicitation_callback=approve_page) as client:
                    await self._hold(client)
        else:  # servidor local, versão mais recente
            local = StdioServerParameters(
                command="npx", args=["-y", "@brightdata/mcp@latest"],
                env={"API_TOKEN": token, "TOOLS": "search_engine,scrape_as_markdown",
                     "PATH": os.environ["PATH"]})
            async with Client(local, elicitation_callback=approve_page) as client:
                await self._hold(client)

    async def _hold(self, client):
        self.client = client
        self.mcp_tools = (await client.list_tools()).tools
        self.stop = asyncio.Event()
        self.ready.set()
        await self.stop.wait()

    def close(self):
        self.loop.call_soon_threadsafe(self.stop.set)
        self.thread.join(timeout=30)  # deixa a sessão encerrar de forma limpa

    def _is_blocked(self, url):
        host = urlparse(url).netloc.lower()
        return any(host == d or host.endswith("." + d) for d in self.blocked)

    def call(self, name, args):
        start = int(args.pop("start", 0) or 0)  # onde retomar uma página longa
        find = args.pop("find", "") or ""  # frase para procurar em uma página longa
        if name == "search_engine":
            args = {**args, "geo_location": self.country}
        if name == "scrape_as_markdown" and self._is_blocked(args.get("url", "")):
            return "Este domínio está excluído para esta tarefa. Use outra fonte."
        key = (name, json.dumps(args, sort_keys=True))
        with self.lock:
            self.stats["calls"] += 1
            text = self.cache.get(key)
        if text is None:
            try:
                text = self._send(name, args)
            except Exception:
                with self.lock:
                    self.stats["errors"] += 1  # o agente vê um erro, não uma página
                raise
            with self.lock:
                self.stats["sent"] += 1
                if self.keep_all or name == "scrape_as_markdown":
                    self.cache[key] = text  # páginas permanecem em cache, então continuar lendo é gratuito
        wrapped = WRAPPED.search(text)
        head, body, tail = (text[:wrapped.start(2)], wrapped.group(2), text[wrapped.end(2):]
                            ) if wrapped else ("", text, "")
        if name == "search_engine" and self.blocked:
            data = json.loads(body)
            data["organic"] = [r for r in data.get("organic", [])
                               if not self._is_blocked(r["link"])]
            body = json.dumps(data, indent=1)
        if find:
            spans = [(max(0, m.start() - 1500), m.end() + 1500)
                     for m in re.finditer(re.escape(find), body, re.I)][:6]
            body = ("\n...\n".join(body[a:b] for a, b in spans)
                    or f"[{find!r} não encontrado na página de {len(body)} caracteres]")
        end = start + self.max_chars
        if len(body) > end:
            body = (body[start:end] + f"\n[mostrando caracteres {start} a {end} de {len(body)}. "
                    f"Chame {name} novamente com start={end} para continuar lendo, ou com "
                    "find='uma palavra ou frase' para obter trechos correspondentes de toda a página]")
        elif start:
            body = body[start:] + f"\n[fim da página: caracteres {start} a {len(body)}]"
        return head + body + tail

    def _send(self, name, args):
        if self.error or not self.thread.is_alive():
            raise RuntimeError("A sessão MCP está fechada") from self.error
        for _ in range(self.retries + 1):
            future = asyncio.run_coroutine_threadsafe(
                self.client.call_tool(name, args), self.loop)
            try:
                result = future.result(self.timeout)
            finally:
                future.cancel()  # uma chamada esgotada é interrompida em vez de continuar
            text = "\n".join(c.text for c in result.content if hasattr(c, "text"))
            wrapped = WRAPPED.search(text)
            body = wrapped.group(2) if wrapped else text
            if not result.is_error and body.strip():
                return text
        raise RuntimeError(text[:500] or "resultado vazio")

    def tools(self):
        out = []
        for t in self.mcp_tools:
            spec = dspy.Tool.from_mcp_tool(self.client, t)  # nome, descrição, args
            args, types, desc = dict(spec.args), dict(spec.arg_types), spec.desc
            if t.name == "scrape_as_markdown":  # permite ao agente ler além do limite de caracteres
                args["start"] = {"type": "integer", "default": 0,
                                 "description": "Deslocamento de caracteres para ler, para páginas longas"}
                args["find"] = {"type": "string", "default": "",
                                "description": "Palavra ou frase para encontrar; retorna trechos correspondentes"}
                types["start"], types["find"] = int, str
                desc += (f" Retorna {self.max_chars} caracteres por vez; passe find para pesquisar"
                         " toda a página por uma palavra ou frase.")

            def run(_name=t.name, **kwargs):
                return self.call(_name, kwargs)

            out.append(dspy.Tool(run, name=spec.name, desc=desc,
                                 args=args, arg_types=types))
        return out
BrightDataTools().tools() retorna 2 ferramentas síncronas que mantêm os nomes, descrições e argumentos das ferramentas do servidor. A ferramenta de scraping recebe 2 argumentos extras, start e find, para que o agente possa ler texto além do limite de caracteres definido por max_chars. O servidor MCP da Bright Data envolve os resultados em um aviso de segurança que marca o texto da página e diz ao modelo para tratá-lo como dados. A classe filtra e trunca apenas o texto marcado, então o modelo ainda recebe o aviso completo.
As configurações do construtor:
remote=Falseusa o servidor local em vez do hospedado.countrydefinegeo_locationem cada busca, para que cada execução obtenha resultados do mesmo país.max_charslimita cada resultado a 20.000 caracteres, porque alguns sites publicam páginas muito longas, como artigos completos da Wikipedia. Sem o limite, 1 solicitação ao modelo teve 491.564 tokens e excedeu a janela de contexto do modelo. Com ele, nenhuma pergunta usou mais de 58.651 tokens de prompt em 2 execuções de avaliação. As páginas permanecem em cache, então uma chamada comstartoufindnão envia nenhuma nova solicitação.retriesetimeoutajudam execuções longas de avaliação a terminar. Uma chamada que retorna um erro é reenviada até 2 vezes, e uma chamada ainda em execução apóstimeoutsegundos é cancelada em vez de continuar em segundo plano. Cada chamada que ainda falha é contada emstats["errors"], queevaluate.pyeoptimize.pyimprimem. Verifique antes de confiar em uma pontuação, porque o agente responde de memória quando suas ferramentas falham.blocked_domainsremove sites escolhidos dos resultados de busca e bloqueia scraping desses sites. Use-o durante a avaliação, e deixe-o vazio em produção.cache=Truetambém reutiliza resultados de busca, eoptimize.pyativa isso.
BrightDataTools é construído para tarefas síncronas e com threads, como dspy.Evaluate e GEPA, e funciona sem alterações em um notebook Jupyter. Em um serviço web assíncrono, como um endpoint FastAPI, execute um agente construído sobre BrightDataTools em uma thread de worker com await asyncio.to_thread(agent, question=question), para que o loop de eventos continue atendendo outras solicitações.
Avalie o agente no SimpleQA Verified
O GEPA melhora um programa avaliando-o com uma métrica, então o agente precisa primeiro de perguntas com respostas conhecidas. O SimpleQA Verified as fornece. É um conjunto público, licenciado sob MIT, de 1.000 perguntas factuais curtas com respostas verificadas.
Baixe as perguntas na pasta do repositório:
curl -L -o simpleqa_verified.csv https://huggingface.co/datasets/google/simpleqa-verified/resolve/main/simpleqa_verified.csvresearch.py contém o agente, um juiz LLM no estilo SimpleQA chamado grader, e a métrica que o GEPA usa:
import csv
import random

import dspy

# Hosts que publicam as respostas do benchmark, excluídos durante a avaliação
EVAL_BLOCKLIST = ("huggingface.co", "github.com", "raw.githubusercontent.com",
                  "kaggle.com", "openaipublic.blob.core.windows.net")

AGENT_LM = dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000)
JUDGE_LM = dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000)


class ResearchQuestion(dspy.Signature):
    """Responda à pergunta com fatos encontrados na web."""

    question: str = dspy.InputField()
    answer: str = dspy.OutputField(desc="uma resposta curta e direta")
    sources: list[str] = dspy.OutputField(desc="URLs das páginas que sustentam a resposta")


def make_agent(tools):
    return dspy.ReActV2(ResearchQuestion, tools=tools, max_iters=8)


def load_examples(path="simpleqa_verified.csv", seed=7):
    rows = list(csv.DictReader(open(path)))
    random.Random(seed).shuffle(rows)
    return [dspy.Example(question=r["problem"], gold=r["answer"]).with_inputs("question")
            for r in rows]


class Grade(dspy.Signature):
    """Avalie uma resposta prevista contra a resposta correta, no estilo SimpleQA.
    CORRECT: a previsão contém o significado da resposta correta e não a contradiz.
    Pequenas diferenças de ortografia ou formatação são aceitáveis; para números e datas o valor deve coincidir.
    INCORRECT: a previsão apresenta uma resposta diferente ou contraditória, ou hesita entre várias.
    NOT_ATTEMPTED: a previsão não fornece uma resposta."""

    question: str = dspy.InputField()
    gold_answer: str = dspy.InputField()
    predicted_answer: str = dspy.InputField()
    grade: str = dspy.OutputField(desc="CORRECT, INCORRECT, ou NOT_ATTEMPTED")


grader = dspy.Predict(Grade)


def tool_calls(pred):
    calls = []
    history = getattr(pred, "history", None)
    for event in (history.messages if history else []):
        for call in getattr(event.get("tool_calls"), "tool_calls", []):
            if call.name != "submit":
                calls.append((call.name, call.args))
    return calls


def metric(gold, pred, trace=None, pred_name=None, pred_trace=None):
    """Pontuação para o GEPA, mais feedback que nunca mostra a resposta de referência."""
    answer = getattr(pred, "answer", "") or ""
    with dspy.context(lm=JUDGE_LM):
        grade = grader(question=gold.question, gold_answer=gold.gold,
                       predicted_answer=answer).grade.strip().upper()
    correct = grade.startswith("CORRECT")
    calls = tool_calls(pred)
    searches = [args.get("query") for name, args in calls if name == "search_engine"]
    pages = [args.get("url") for name, args in calls if name == "scrape_as_markdown"]
    feedback = (f"Nota: {'CORRECT' if correct else 'INCORRECT'}. O agente respondeu: {answer!r}. "
                f"Buscas ({len(searches)}): {searches}. Páginas abertas ({len(pages)}): {pages}.")
    if not correct and not pages:
        feedback += " O agente respondeu sem abrir uma página."
    return dspy.Prediction(score=float(correct), feedback=feedback)


def leaked_answers(instruction, examples):
    """Respostas de referência (4+ caracteres) que uma instrução otimizada repete."""
    text = instruction.lower()
    return sorted({ex.gold for ex in examples if len(ex.gold) >= 4 and ex.gold.lower() in text})
O juiz usa o próprio modelo pequeno do agente para atribuir as 3 notas do SimpleQA, que são correto, incorreto e não tentado. A métrica retorna uma pontuação e feedback escrito que lista as buscas e páginas do agente, mas não a resposta de referência. Durante a avaliação, EVAL_BLOCKLIST bloqueia os sites que publicam as respostas do benchmark, então o agente precisa encontrar cada resposta na web aberta.
evaluate.py no repositório executa o agente em uma fatia das perguntas embaralhadas, 8 por vez, e salva cada resposta em results.json. Por padrão, avalia as 60 perguntas de teste. --no-tools avalia o modelo sozinho, e --local usa o servidor local. As execuções deram estes resultados:
Configuração, todas com gpt-5.4-mini |
Corretas, das mesmas 60 perguntas SimpleQA Verified |
|---|---|
| Modelo sozinho, sem ferramentas | 14 (1 execução) |
Agente com ferramentas Bright Data, servidor local, sem find |
58, 55, 58, 54 (4 execuções) |
Agente com ferramentas Bright Data, servidor hospedado, com find |
57 (1 execução) |
Todos os 46 erros do modelo sozinho foram respostas erradas específicas, como Omaha para um pintor nascido em Beatrice, Nebraska. As respostas erradas do modelo pareciam corretas.
Repetir execuções do mesmo agente mostra quanto de qualquer pontuação única é ruído. As 4 execuções do agente diferiram em parte devido à amostragem aleatória do modelo e à avaliação do juiz. O agente nomeou instrumentos diferentes para a mesma peça de John Cage entre execuções, e o juiz avaliou “4½ pontos” como correto, mas “4.5” como incorreto para o mesmo resultado de xadrez.
Trate uma mudança de até 4 perguntas em 60 como ruído, e compare programas pergunta por pergunta em seus resultados salvos, não por totais. O DSPy armazena em cache chamadas ao modelo por padrão, então defina cache=False em ambos os LMs antes de repetir uma execução.
Verifique também as notas do juiz pontualmente, especialmente quando o juiz é o mesmo modelo que o agente. Em uma revisão manual de 1 outra execução, todas as 60 notas estavam corretas quando verificadas contra as respostas de referência.
O que custa uma execução. Uma execução de 60 perguntas teve média de 2,3 chamadas de ferramenta por pergunta, menos de 200 solicitações à Bright Data, e $0,29 de chamadas gpt-5.4-mini para o agente. A avaliação completa cabe nas solicitações mensais gratuitas.
Teste o agente em eventos posteriores ao corte de conhecimento do modelo
As perguntas estáveis do SimpleQA Verified não são projetadas para testar fatos posteriores ao corte de conhecimento do modelo. Para esses fatos, post_cutoff_questions.csv no repositório contém 14 perguntas sobre eventos de 2025 e 2026, com respostas verificadas contra a Wikipedia. Execute python evaluate.py --csv post_cutoff_questions.csv --start 0 --n 14, depois novamente com --no-tools. Cada configuração executou uma vez:
| Perguntas sobre, 1 execução cada | gpt-5.4-mini sozinho |
gpt-5.4-mini com ferramentas Bright Data, servidor hospedado |
|---|---|---|
| Eventos de 2025 | 5 de 6 | 6 de 6 |
| Eventos de 2026 | 0 de 8 | 8 de 8 |
Sem ferramentas, o modelo disse que vários eventos de 2026 ainda não haviam acontecido. Ele sabia 5 de 6 fatos de 2025, embora tenha dito que seu corte de conhecimento era junho de 2024. Teste o que um modelo sabe em vez de confiar em seu corte de conhecimento declarado, e adicione perguntas do seu próprio caso de uso cujas respostas aparecem apenas em páginas publicadas recentemente.
Otimize o agente com GEPA
GEPA é o otimizador de prompts reflexivo do DSPy. Ele executa o programa em pequenos lotes de perguntas de treinamento. Em seguida, mostra as execuções falhas e o feedback da métrica para um modelo de reflexão mais forte, que é o gpt-5.5 nessas execuções. O GEPA mantém as novas instruções que têm melhor desempenho em um conjunto de validação.
O GEPA precisa de respostas erradas para aprender. Quando o agente responde corretamente a todas as perguntas de treinamento amostradas, o GEPA não propõe nenhuma nova instrução.
Então construa o conjunto de treinamento a partir de perguntas que o agente erra. Execute python evaluate.py --start 108 --n 400 --out pool.json em perguntas fora do conjunto de teste. optimize.py então combina 12 respostas erradas com 12 respostas corretas para o conjunto de treinamento e constrói o conjunto de validação da mesma forma:
import json
import random

import dspy
from brightdata_tools import BrightDataTools
from research import AGENT_LM, EVAL_BLOCKLIST, leaked_answers, make_agent, metric

dspy.configure(lm=AGENT_LM, adapter=dspy.ChatAdapter(use_native_function_calling=True))

# Metade respostas erradas, metade corretas de uma execução do evaluate.py fora do conjunto de teste
pool = json.load(open("pool.json"))
misses = [r for r in pool if not r["correct"] and not r.get("error")]
hits = [r for r in pool if r["correct"]]
random.Random(0).shuffle(hits)


def to_ex(rows):
    return [dspy.Example(question=r["question"], gold=r["gold"]).with_inputs("question")
            for r in rows]


half = min(12, len(misses) // 2)
trainset = to_ex(misses[:half] + hits[:half])
valset = to_ex(misses[half:2 * half] + hits[half:2 * half])

bd = BrightDataTools(blocked_domains=EVAL_BLOCKLIST, cache=True)
agent = make_agent(bd.tools())
gepa = dspy.GEPA(
    metric=metric,
    reflection_lm=dspy.LM("openai/gpt-5.5", temperature=1.0, max_tokens=32000),
    max_metric_calls=300,
    num_threads=8,
    track_stats=True,
    log_dir="gepa_logs",
)
optimized = gepa.compile(agent, trainset=trainset, valset=valset)
optimized.save("optimized_agent.json")

instruction = optimized.react.signature.instructions
print(instruction)
print("Respostas de treinamento na instrução:", leaked_answers(instruction, trainset + valset))
print("Chamadas de ferramentas:", bd.stats["calls"], "| solicitações enviadas:", bd.stats["sent"],
      "| erros:", bd.stats["errors"])
bd.close()
Execute com python optimize.py. O cache em BrightDataTools importa aqui, porque o GEPA faz as mesmas perguntas várias vezes. Em 1 execução do GEPA, o cache respondeu 524 de 994 chamadas de ferramentas sem uma nova solicitação.
Estas 4 execuções do GEPA usaram cada uma 24 perguntas de treinamento, 24 de validação e as mesmas 60 perguntas de teste:
| Conjunto de treinamento | Resposta esperada no feedback | Pontuação de validação, de 24 | Respostas de treinamento copiadas na instrução | Pontuação no teste, de 60 |
|---|---|---|---|---|
| 24 perguntas aleatórias | Sim | 21 a 23 | 3 | 55, 52 |
| 24 perguntas aleatórias | Não | 24, nenhuma nova instrução | 0 | Não medido |
| 12 erradas, 12 respostas corretas | Sim | 18 a 21 | 3 | 57, 55 |
| 12 erradas, 12 respostas corretas | Não | 20 a 21 | 3 | Não medido |
O GEPA pode escrever respostas de treinamento na instrução. A instrução da primeira execução terminou assim:
Fatos conhecidos que podem ser úteis para perguntas repetidas:
- Galip Ulsoy recebeu o Prêmio Memorial Charles Russ Richards da ASME e Pi Tau Sigma em 2013. ...
- O tamanho da bacia do rio Koshi/Kosi é comumente listado como cerca de 74.500 km². ...
- Para o terremoto de 25 de abril de 2015 no Nepal/Gorkha, um tremor secundário de Mw 6,6 ocorreu cerca de 34 minutos após o evento inicial de Mw 7,8 ...
Cada linha responde a 1 pergunta de treinamento, e cada instrução que o GEPA propôs nessa execução tinha um bloco semelhante. Ocultar a resposta esperada não o impediu. O modelo de reflexão então pegou as respostas das próprias execuções corretas do agente, como o número de residências em Weston, Ohio, no censo de 2000.
Reexecute respostas erradas antes de treinar com elas. No conjunto de validação construído a partir de respostas erradas, o agente básico já obteve 18 a 20 de 24. Então pelo menos 6 de suas 12 respostas erradas estavam corretas em uma reexecução. Mantenha apenas as perguntas que o agente erra em mais de uma execução.
Meça o resultado em perguntas de retenção. As pontuações de validação subiram em cada execução que propôs uma instrução. Nas 60 perguntas de teste, os programas otimizados pontuaram de 52 a 57, e o agente básico com ferramentas Bright Data pontuou de 54 a 58. As mudanças de instrução do GEPA não aumentaram mensuravelmente a pontuação, e apenas a primeira execução custou $3,31 de chamadas ao modelo para o agente gpt-5.4-mini e o modelo de reflexão gpt-5.5.
Verifique a instrução em busca de respostas copiadas. leaked_answers em research.py detecta respostas de referência de 4 ou mais caracteres que uma instrução repete. Nessas execuções, encontrou a maioria das respostas copiadas, mas uma correspondência de string não detecta números curtos ou respostas reformuladas. Leia toda a instrução e exclua qualquer linha sobre uma pergunta de treinamento específica.
Encontre correções de ferramentas com análise de erros
O GEPA apenas reescreve instruções, então não pode corrigir um problema nas próprias ferramentas. A análise de erros das respostas erradas encontra esses problemas. Aqui, as respostas erradas se concentraram em datas e números. Em 3 execuções e 519 perguntas avaliadas, o agente errou cerca de 15% das perguntas sobre datas e números, comparado com 7% das perguntas sobre pessoas e lugares.
Essas execuções limitaram cada página a 20.000 caracteres com a própria configuração max_chars do agente. Em 24 de suas 62 respostas erradas, o agente tinha aberto uma página mais longa que o limite. Quando buscadas novamente na íntegra, 6 dessas páginas tinham a resposta após o limite:
| Página que o agente abriu | Resposta começa no caractere (limite do agente é 20.000) | Resposta do agente | Resposta correta |
|---|---|---|---|
| Wikipedia, Equinócio | 38.604 | equinócio | equilux |
| Wikipedia, ChromeOS | 24.709 | outubro de 2011 | agosto de 2011 |
| Wikipedia, Cannibal Corpse | 25.566 | março de 1993 | fevereiro de 1993 |
| Notas de versão do Aseprite | 59.987 | v1.2.22 | v1.3-rc8 |
| Baseball-Reference, Tim Wakefield | 65.663 | 2.25 | 12.27 |
| RuPaul’s Drag Race Wiki, Temporada 1 | 99.250 | “I Will Survive” | “Stronger” |
Em todos os 6 casos, o agente citou a página que continha a resposta correta. Uma citação mostra onde o agente procurou, não o que a página diz.
Em BrightDataTools, a classe wrapper, start retorna os próximos 20.000 caracteres, e find retorna até 6 trechos de cerca de 3.000 caracteres ao redor de cada correspondência de uma palavra ou frase. Uma nota no final de uma página truncada informa o agente sobre ambos os argumentos. A paginação sozinha não foi suficiente. Em um teste separado apenas com start, o agente solicitou a próxima parte de uma página em 3 de 18 execuções.
Cada configuração executou 8 vezes por pergunta:
| Configuração, mesmas 6 perguntas de páginas longas | Corretas, de 48 execuções | Tokens de prompt por execução | Custo gpt-5.4-mini, todas as 48 execuções |
|---|---|---|---|
| Apenas limite de caracteres | 24 | 23.023 | $0,52 |
Limite de caracteres com start e find |
33 | 11.908 | $0,35 |
O agente chamou find em 28 das 48 execuções. O ganho de precisão é promissor, mas ainda não estatisticamente significativo com 48 execuções por versão (p ≈ 0,10).
Verifique as fontes antes de mostrá-las aos usuários. O agente frequentemente citou resultados de busca que nunca abriu. Nas execuções locais, ele havia aberto menos de 1 em cada 4 URLs que citou. Para verificar uma fonte, chame a ferramenta de scraping do BrightDataTools com find e uma parte distintiva da resposta.
Rastreie cada chamada de ferramenta com MLflow
Um rastreamento mostra cada busca que o agente executou e cada página que leu. Com ele, você pode ver como o agente produziu cada resposta e encontrar rapidamente a etapa que causou uma errada. A integração MLflow DSPy registra cada módulo, chamada de modelo e chamada de ferramenta como um span. Instale a versão testada do MLflow:
uv pip install "mlflow==3.17.1"Em seguida, adicione estas linhas a agent.py, antes da execução do agente:
import mlflow

mlflow.set_tracking_uri("sqlite:///mlflow.db")
mlflow.dspy.autolog()
O MLflow 3.17 precisa de um backend de banco de dados, então a URI de rastreamento é definida para um arquivo SQLite local. Execute mlflow ui --backend-store-uri sqlite:///mlflow.db para visualizar os rastreamentos. Esta árvore de spans é de 1 pergunta:
CHAIN       ReActV2.forward
LLM         Predict.forward          x6
CHAT_MODEL  LM.__call__              x6
PARSER      ChatAdapter.format       x6
TOOL        Tool.search_engine       x4
TOOL        Tool.scrape_as_markdown  x1
TOOL        Tool.submit              x1
Cada span TOOL armazena os argumentos que o modelo enviou e o texto que o servidor MCP da Bright Data retornou. Selecionar o primeiro span de busca na interface do MLflow mostra ambos para essa chamada:
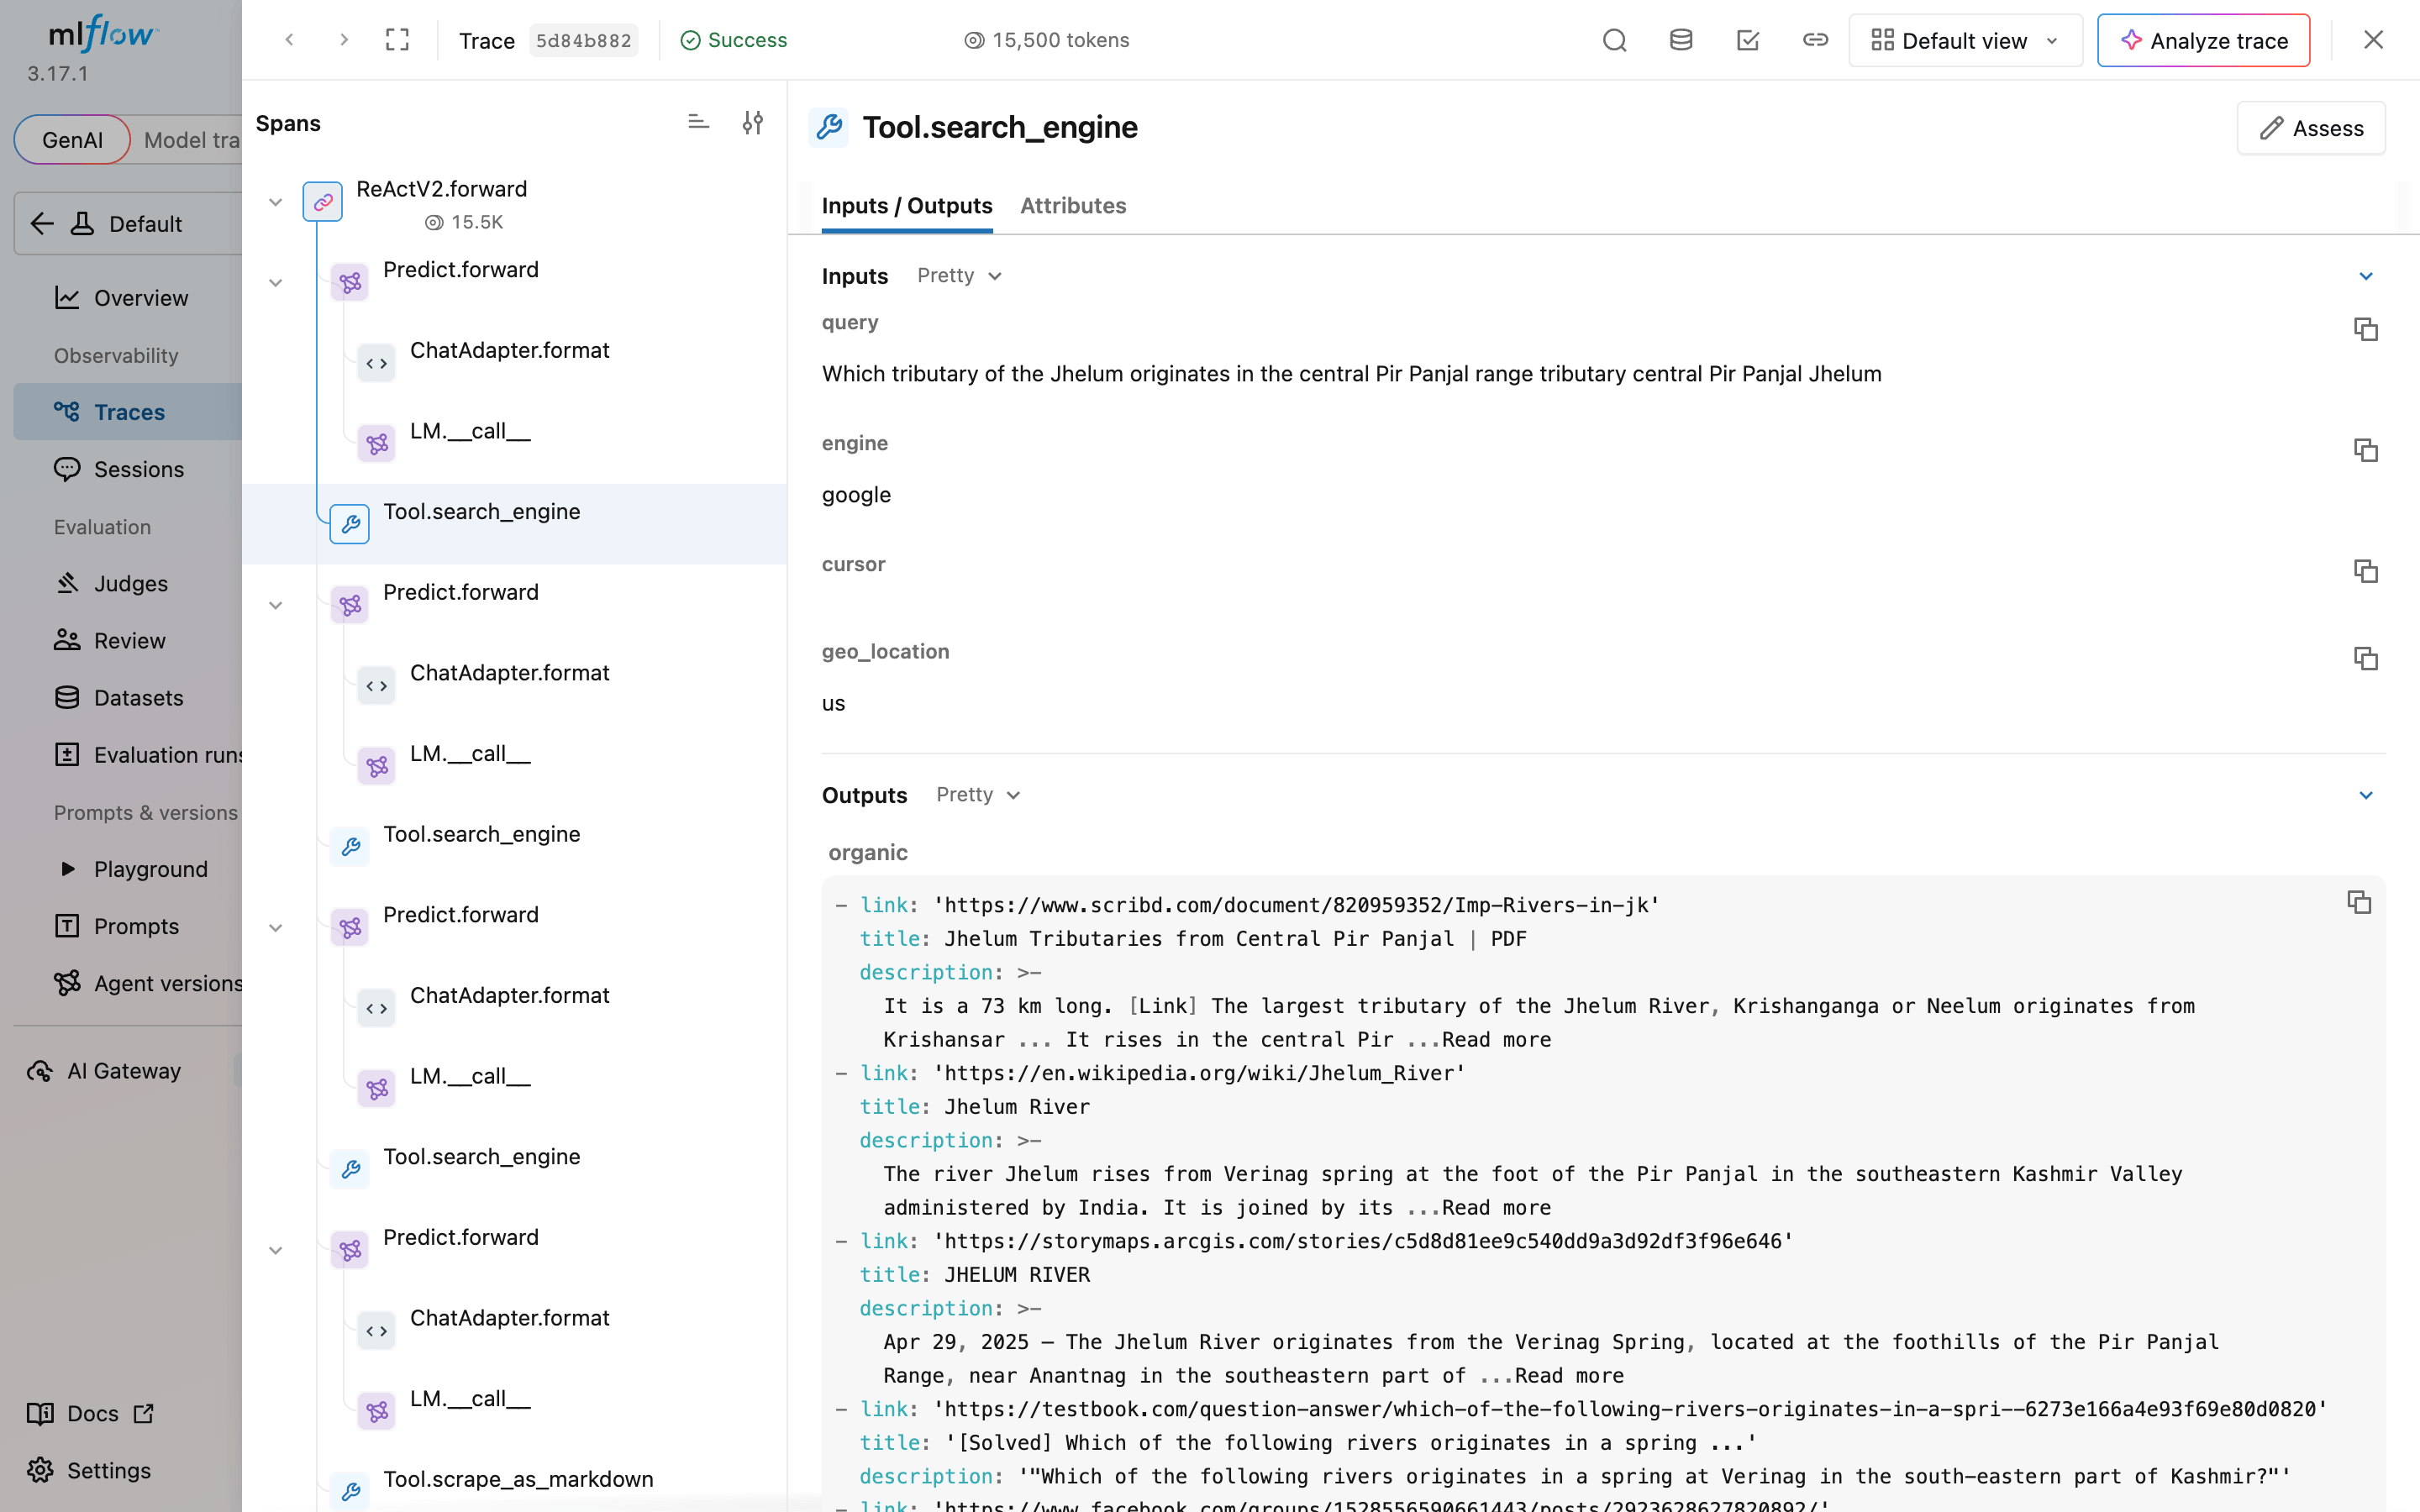
Para uma resposta errada, esta visualização mostra se a consulta do agente encontrou uma página com a resposta correta.
Considerações finais
Com o servidor MCP da Bright Data, este agente DSPy respondeu corretamente 54 a 58 de 60 perguntas de benchmark, subindo de 14, e todas as 8 perguntas sobre eventos após seu corte de conhecimento. Para avaliá-lo e otimizá-lo, mantenha a sessão MCP em seu próprio loop de eventos, porque dspy.Evaluate e GEPA chamam ferramentas de threads de worker. Revise as respostas erradas antes de otimizar, porque 6 delas aqui tinham a resposta além do próprio limite de caracteres do agente, e find permite que o agente pesquise toda a página. O GEPA pode ajudar mais quando respostas erradas compartilham uma causa que uma instrução pode corrigir, e você deve verificar sua saída em busca de respostas copiadas. Crie uma conta Bright Data gratuita, execute agent.py em uma pergunta que seu modelo não consiga responder de memória, e execute evaluate.py em suas próprias perguntas.
Perguntas Frequentes
O DSPy suporta servidores MCP?
Sim. Com dspy.Tool.from_mcp_tool e um cliente do MCP Python SDK, o DSPy converte as ferramentas de um servidor MCP, como o servidor MCP da Bright Data, em ferramentas DSPy. Instale o extra MCP com pip install "dspy[mcp]". No DSPy 3.4.1, as ferramentas MCP são assíncronas, então chame agentes com acall. Em threads de worker, use wrappers síncronos em um loop de eventos em segundo plano.
O DSPy é um cliente MCP?
Não, não por si só. O DSPy usa um cliente do MCP Python SDK, e dspy.Tool.from_mcp_tool converte as ferramentas desse cliente em ferramentas DSPy. O DSPy constrói e otimiza o programa do agente, e o MCP conecta o agente a servidores como o servidor MCP da Bright Data.
Como adiciono busca web a um agente DSPy?
Conecte o servidor MCP da Bright Data e passe suas ferramentas de busca e scraping para dspy.ReActV2, a implementação que dspy.ReAct usa a partir do DSPy 3.5. O agente pesquisa no Google, lê páginas como Markdown, e retorna suas URLs de origem. Uma função Python que chama a API SERP da Bright Data, que retorna resultados de busca como JSON, também funciona como uma ferramenta DSPy.
Qual ferramenta de busca web funciona com o DSPy?
O servidor MCP da Bright Data fornece a um agente DSPy resultados do Google e páginas completas como Markdown através de uma única conexão, e o servidor cuida da proteção contra bots. Em 60 perguntas SimpleQA Verified, gpt-5.4-mini respondeu corretamente 54-58 com ele, subindo de 14 sem ele. Outras ferramentas de busca também funcionam, e a comparação de ferramentas de busca para agentes de IA as aborda.
O que é o DSPy ReActV2?
dspy.ReActV2 é o módulo experimental de agente DSPy construído sobre chamada nativa de ferramentas. Mantém histórico estruturado, pode fazer várias chamadas de ferramentas por turno, e finaliza com uma ferramenta submit. A documentação do DSPy o lista como a implementação que dspy.ReAct usa a partir do DSPy 3.5, com o nome ReActV2 removido na 3.6.
O DSPy ainda é relevante?
Sim, para programas que você pode avaliar com uma métrica. O DSPy mantém a tarefa separada do prompt, então você pode trocar modelos e reotimizar com uma métrica e um otimizador como o GEPA. Com configurações padrão, o GEPA propõe mudanças apenas quando o programa ainda responde incorretamente a algumas perguntas de treinamento, então avalie o programa primeiro.
O DSPy está pronto para produção?
Sim, quando você fixa versões e torna as chamadas de ferramentas robustas. Fixe o dspy e qualquer servidor MCP, limite o tamanho da saída da ferramenta, permita que o agente pesquise texto além desse limite, adicione tentativas, tempos limite e contagens de erros às chamadas de ferramentas, e rastreie execuções com MLflow. Módulos experimentais como o ReActV2 podem mudar entre versões menores.
O DSPy pode ser usado para otimização de prompts?
Sim. Otimizadores DSPy como o GEPA reescrevem as instruções de um programa com base em exemplos avaliados. O GEPA revisa execuções avaliadas e seu feedback escrito e propõe novas instruções, depois mantém as que têm melhor desempenho em um conjunto de validação. Revise o resultado antes de implantá-lo, porque o GEPA pode às vezes copiar respostas de treinamento para a instrução.