Se o seu scraper recebe um HTTP 429 ou 403 com cabeçalhos x-kpsdk-*, o Kasada está bloqueando-o, e a resposta não explica o motivo. Kasada é uma plataforma anti-bot que protege sites, APIs e aplicativos móveis contra tráfego automatizado. Ele executa um desafio JavaScript ofuscado no navegador, avalia o cliente e emite um token de curta duração que toda solicitação posterior deve incluir.
Para contornar o Kasada, primeiro você precisa saber o que esse script de desafio verifica. Analisei um real, e o que descobri decide se você constrói um solver ou compra um.
Resumo
- O Kasada precisa de um token válido:
x-kpsdk-ctvem apenas da conclusão do seu desafio JavaScript, então a personificação TLS sozinha não consegue passá-lo. - O desafio muda em cada solicitação: é uma máquina virtual personalizada, então um solver copiado para de funcionar em poucas horas.
- Navegadores automatizados deixam sinais: uma configuração padrão expõe
navigator.webdriver, um user agentHeadlessChrome, e nomes de frameworks de automação que o Kasada pode detectar. - Você pode construir ou comprar: manter um solver é um trabalho contínuo, enquanto o Web Unlocker da Bright Data executa o desafio para você e cobra por solicitação bem-sucedida.
Como confirmar que um site usa Kasada
Um 403 ou 429 informa que algo bloqueou a solicitação. Não informa qual sistema foi, e essa resposta decide tudo o que você faz a seguir. Cloudflare, DataDome, Akamai e Kasada retornam os mesmos códigos de status, então o código sozinho não consegue identificar o sistema. Os cabeçalhos e cookies de cada fornecedor o identificam, e você pode lê-los com 1 solicitação:
curl -sI https://target.example/ | grep -i \
  -e '^x-kpsdk' -e '^set-cookie: kp_uidz' \
  -e '^cf-ray:' -e '^set-cookie: __cf_bm' -e '^server: cloudflare' \
  -e '^x-datadome' -e '^set-cookie: datadome' \
  -e '^server: akamaighost' -e '^set-cookie: _abck'
Faça a correspondência a partir do início da linha de cabeçalho (é isso que o ^ faz), não em qualquer lugar da linha. Um grep -i akamai amplo também corresponde a cabeçalhos não relacionados que contêm um nome de host de CDN, como o Content-Security-Policy da página, e retorna falsos positivos.
Cada sistema tem uma assinatura diferente. A linha do Kasada vem da minha própria captura, e as outras linhas vêm da documentação pública de cada fornecedor:
| O que a resposta contém | O sistema é |
|---|---|
Cabeçalhos x-kpsdk-* e um cookie KP_UIDz, mais um script ips.js que define window.KPSDK |
Kasada |
Cabeçalho cf-ray, cookie __cf_bm, server: cloudflare |
Cloudflare |
Cabeçalho x-datadome e um cookie datadome |
DataDome |
server: AkamaiGHost em uma resposta bloqueada, ou um cookie _abck em uma resposta permitida |
Akamai |
Se você vir qualquer cabeçalho x-kpsdk-*, o sistema é o Kasada. Se você vir um dos outros, as etapas específicas do Kasada a seguir não se aplicam, e os guias da Bright Data para contornar o Cloudflare e a detecção de bots da Akamai cobrem esses sistemas.
O que o Kasada verifica antes de conceder acesso a um cliente
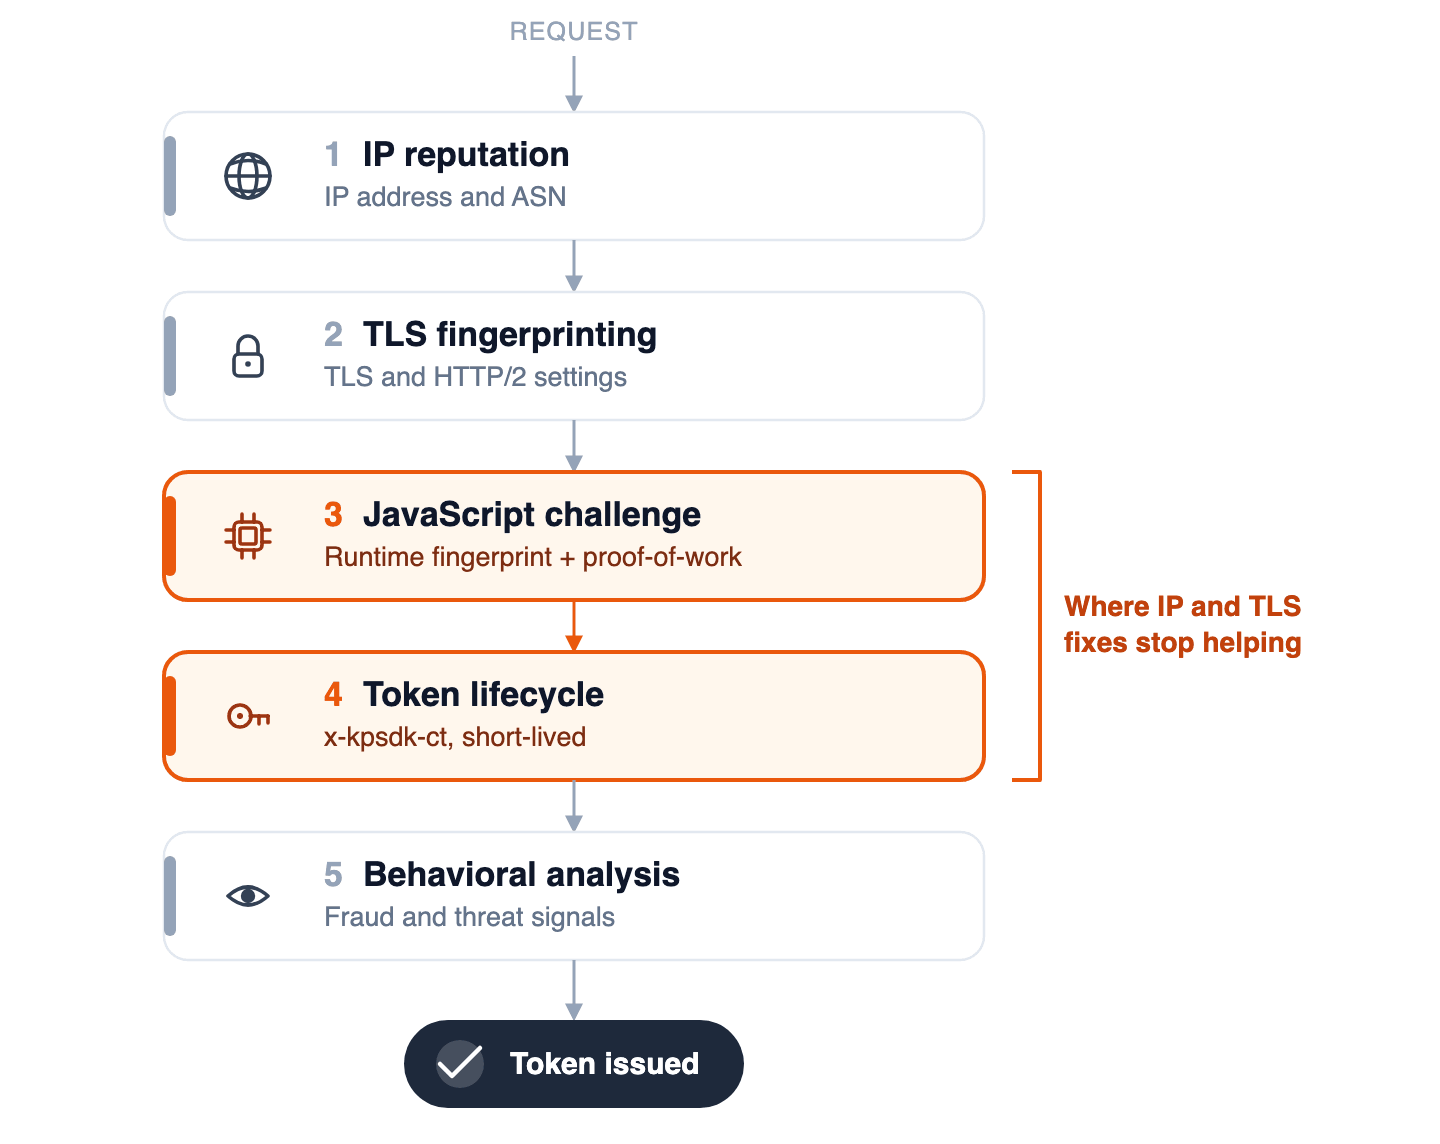
O Kasada não depende de um único sinal. Ele usa várias camadas, e uma solicitação tem que passar por todas elas para receber um token. Entender as camadas explica por que uma correção que funciona contra um sistema mais simples não tem efeito aqui.
A primeira camada é a reputação de IP. O Kasada verifica a reputação do endereço IP e seu Autonomous System Number (a rede à qual o endereço pertence). Uma faixa de IP de datacenter que muitos scrapers já usaram tem uma reputação ruim antes mesmo de você enviar um único cabeçalho. Endereços IPs residenciais de ISPs de consumidores reais têm uma reputação melhor, porque usuários reais se conectam a partir dessas mesmas redes.
A segunda camada é o fingerprinting TLS. O Kasada lê o handshake TLS e as configurações HTTP/2, depois as compara com o que um navegador real envia. Um cliente Python padrão oferece conjuntos de cifras e extensões em uma ordem que nenhum navegador usa, então o fingerprint não corresponde ao user agent que ele afirma ser. Como funciona o fingerprinting TLS cobre isso em mais detalhes.
A terceira camada é o desafio JavaScript. O Kasada envia um script ofuscado ao seu cliente e verifica o que ele retorna. O script constrói um fingerprint do ambiente de execução, executa um cálculo de proof-of-work (um quebra-cabeça que o cliente deve resolver), e combina ambos em um pacote criptografado. A quarta camada é o ciclo de vida do token, que inferi de como o protocolo funciona e não capturei diretamente, e a quinta é a análise comportamental, que não testei. Um bom IP e um handshake TLS correspondente satisfazem apenas as camadas 1 e 2, então as seções abaixo focam nas camadas 3 e 4.
Na ordem em que uma solicitação passa por elas, as camadas ficam assim:
Como funciona o desafio ips.js do Kasada
O desafio ips.js é uma máquina virtual personalizada, então ler o script não mostra o que ele verifica. Para ver isso diretamente, solicitei uma página protegida pelo Kasada e li a resposta. O alvo era um site público de imóveis, e a resposta foi um 429 em vez da página.
A resposta 429 e o script ips.js
A resposta incluiu os cabeçalhos do Kasada e um pequeno corpo HTML que inicia o desafio:
HTTP/2 429
x-kpsdk-r: 1-AA
x-kpsdk-ct: <token inicial>
content-type: text/html; charset=utf-8
access-control-expose-headers: x-kpsdk-ct,x-kpsdk-r,x-kpsdk-c,x-kpsdk-h,x-kpsdk-fc
set-cookie: KP_UIDz-ssn=<valor>
Você pode ver os mesmos cabeçalhos no Chrome DevTools, na primeira solicitação na aba Network (a entrada vermelha no topo da lista):
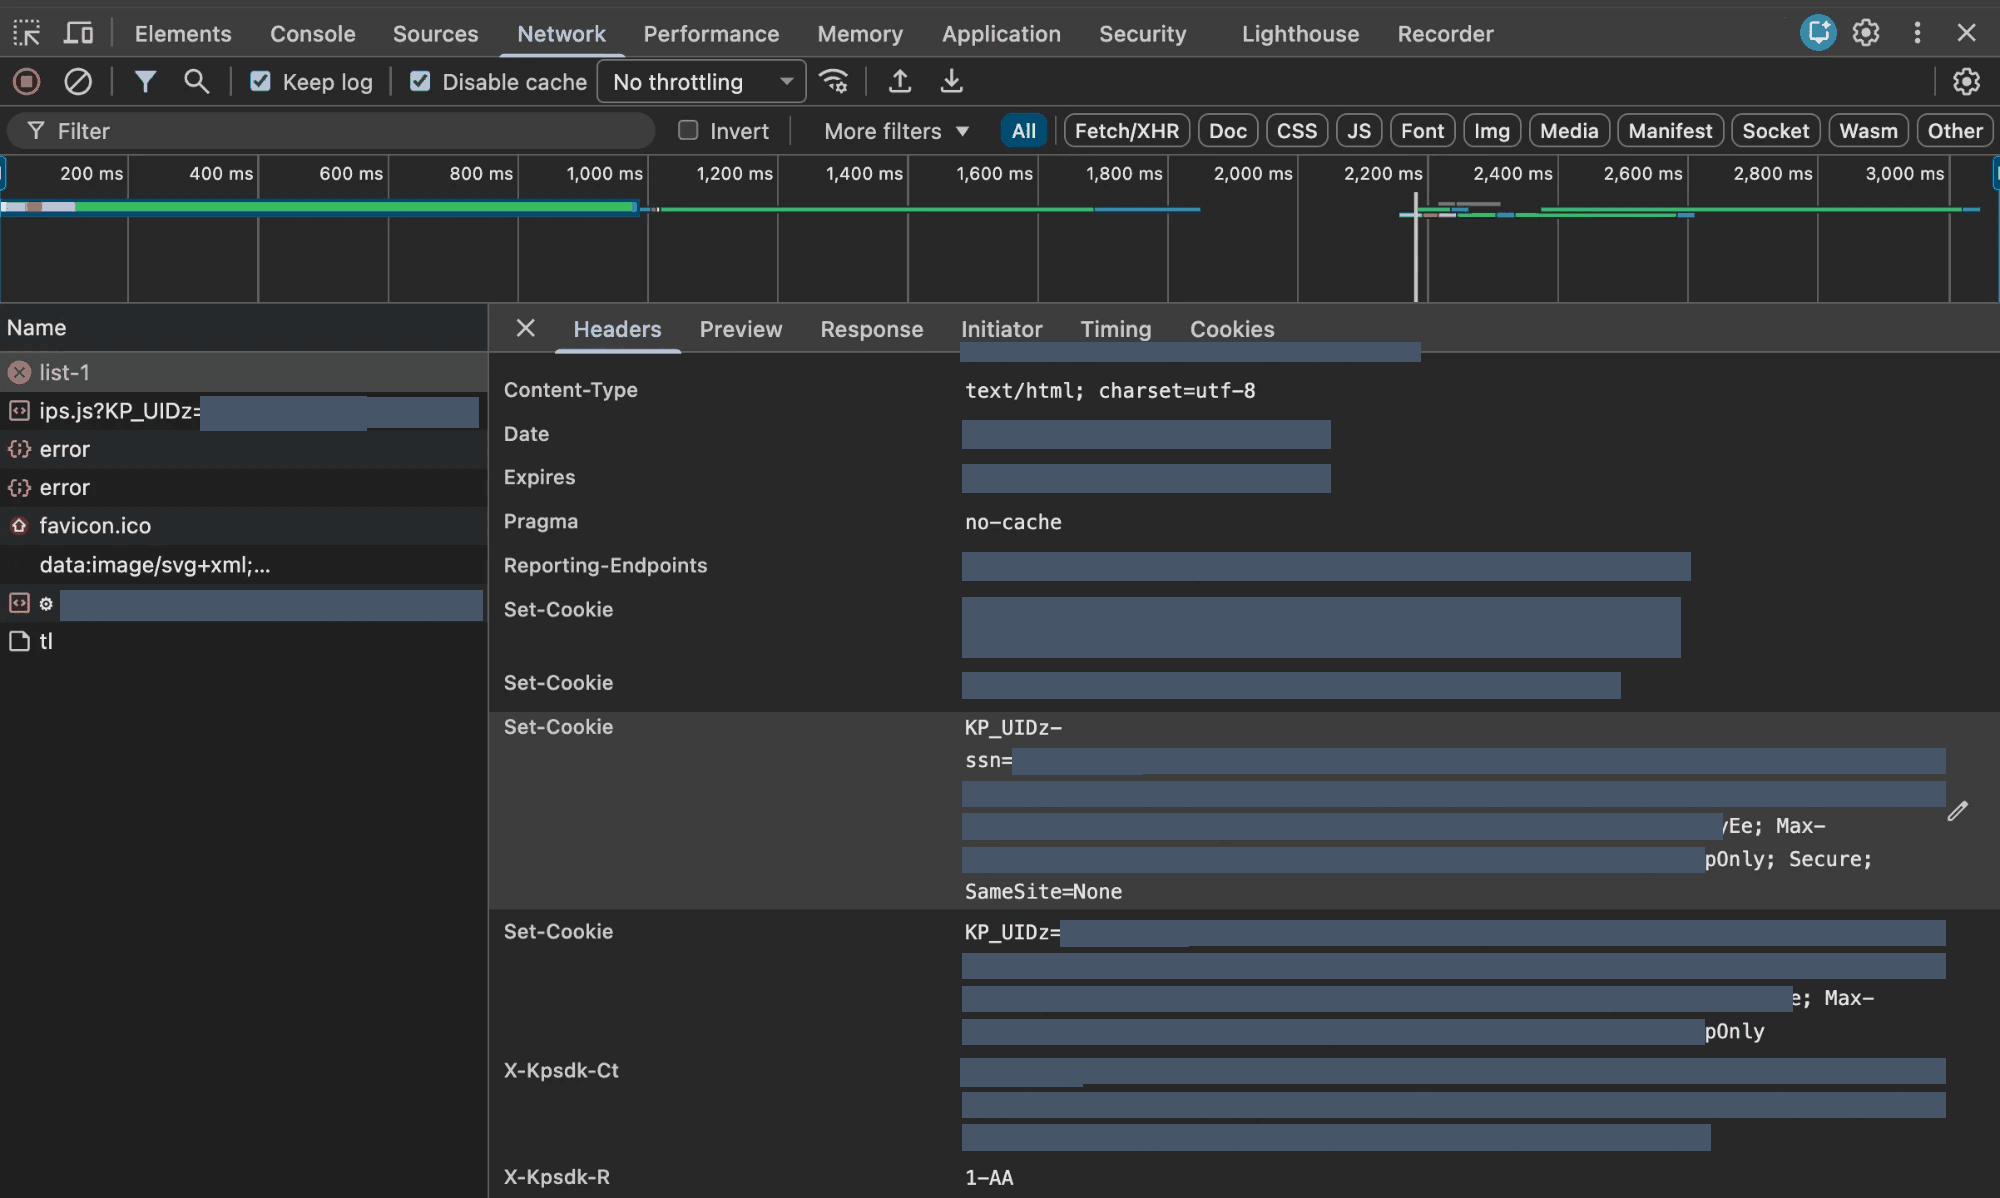
O 429 é o próprio desafio, não um limite de taxa, e inclui um token inicial e uma tag de script. O corpo define um objeto window.KPSDK e carrega o script de desafio a partir de um caminho que é único para cada site protegido:
<script>window.KPSDK={};KPSDK.now=typeof performance!=='undefined'&&performance.now?performance.now.bind(performance):Date.now.bind(Date);KPSDK.start=KPSDK.now();</script>
<script src="/<site-id>/<script-id>/ips.js?KP_UIDz=...&x-kpsdk-im=..."></script>
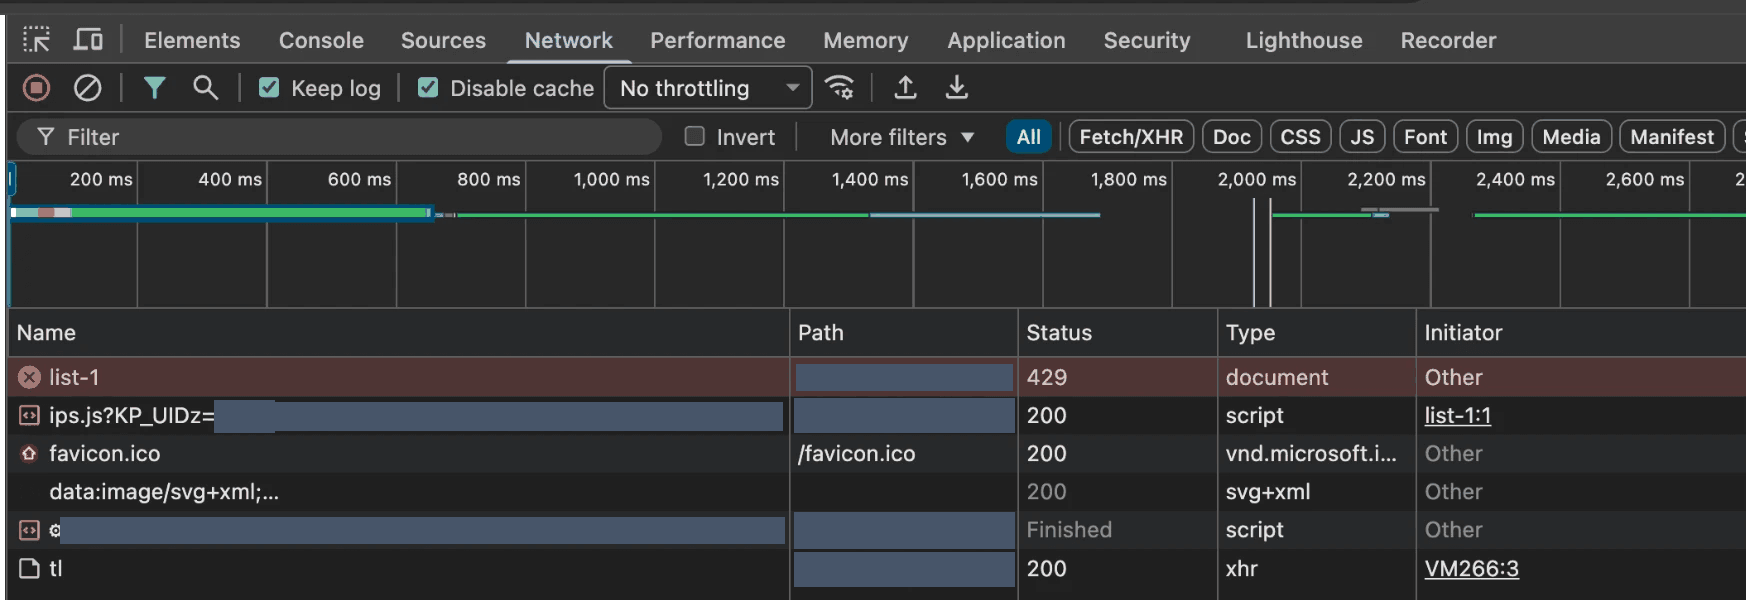
No DevTools, toda a troca aparece como o documento 429 seguido pelo script que ele carrega, e a coluna Initiator liga o script a esse documento:
O script, ips.js, é um arquivo de 641 KB com quase todo o seu código em 1 linha. Aberto em um editor de texto, é ilegível:
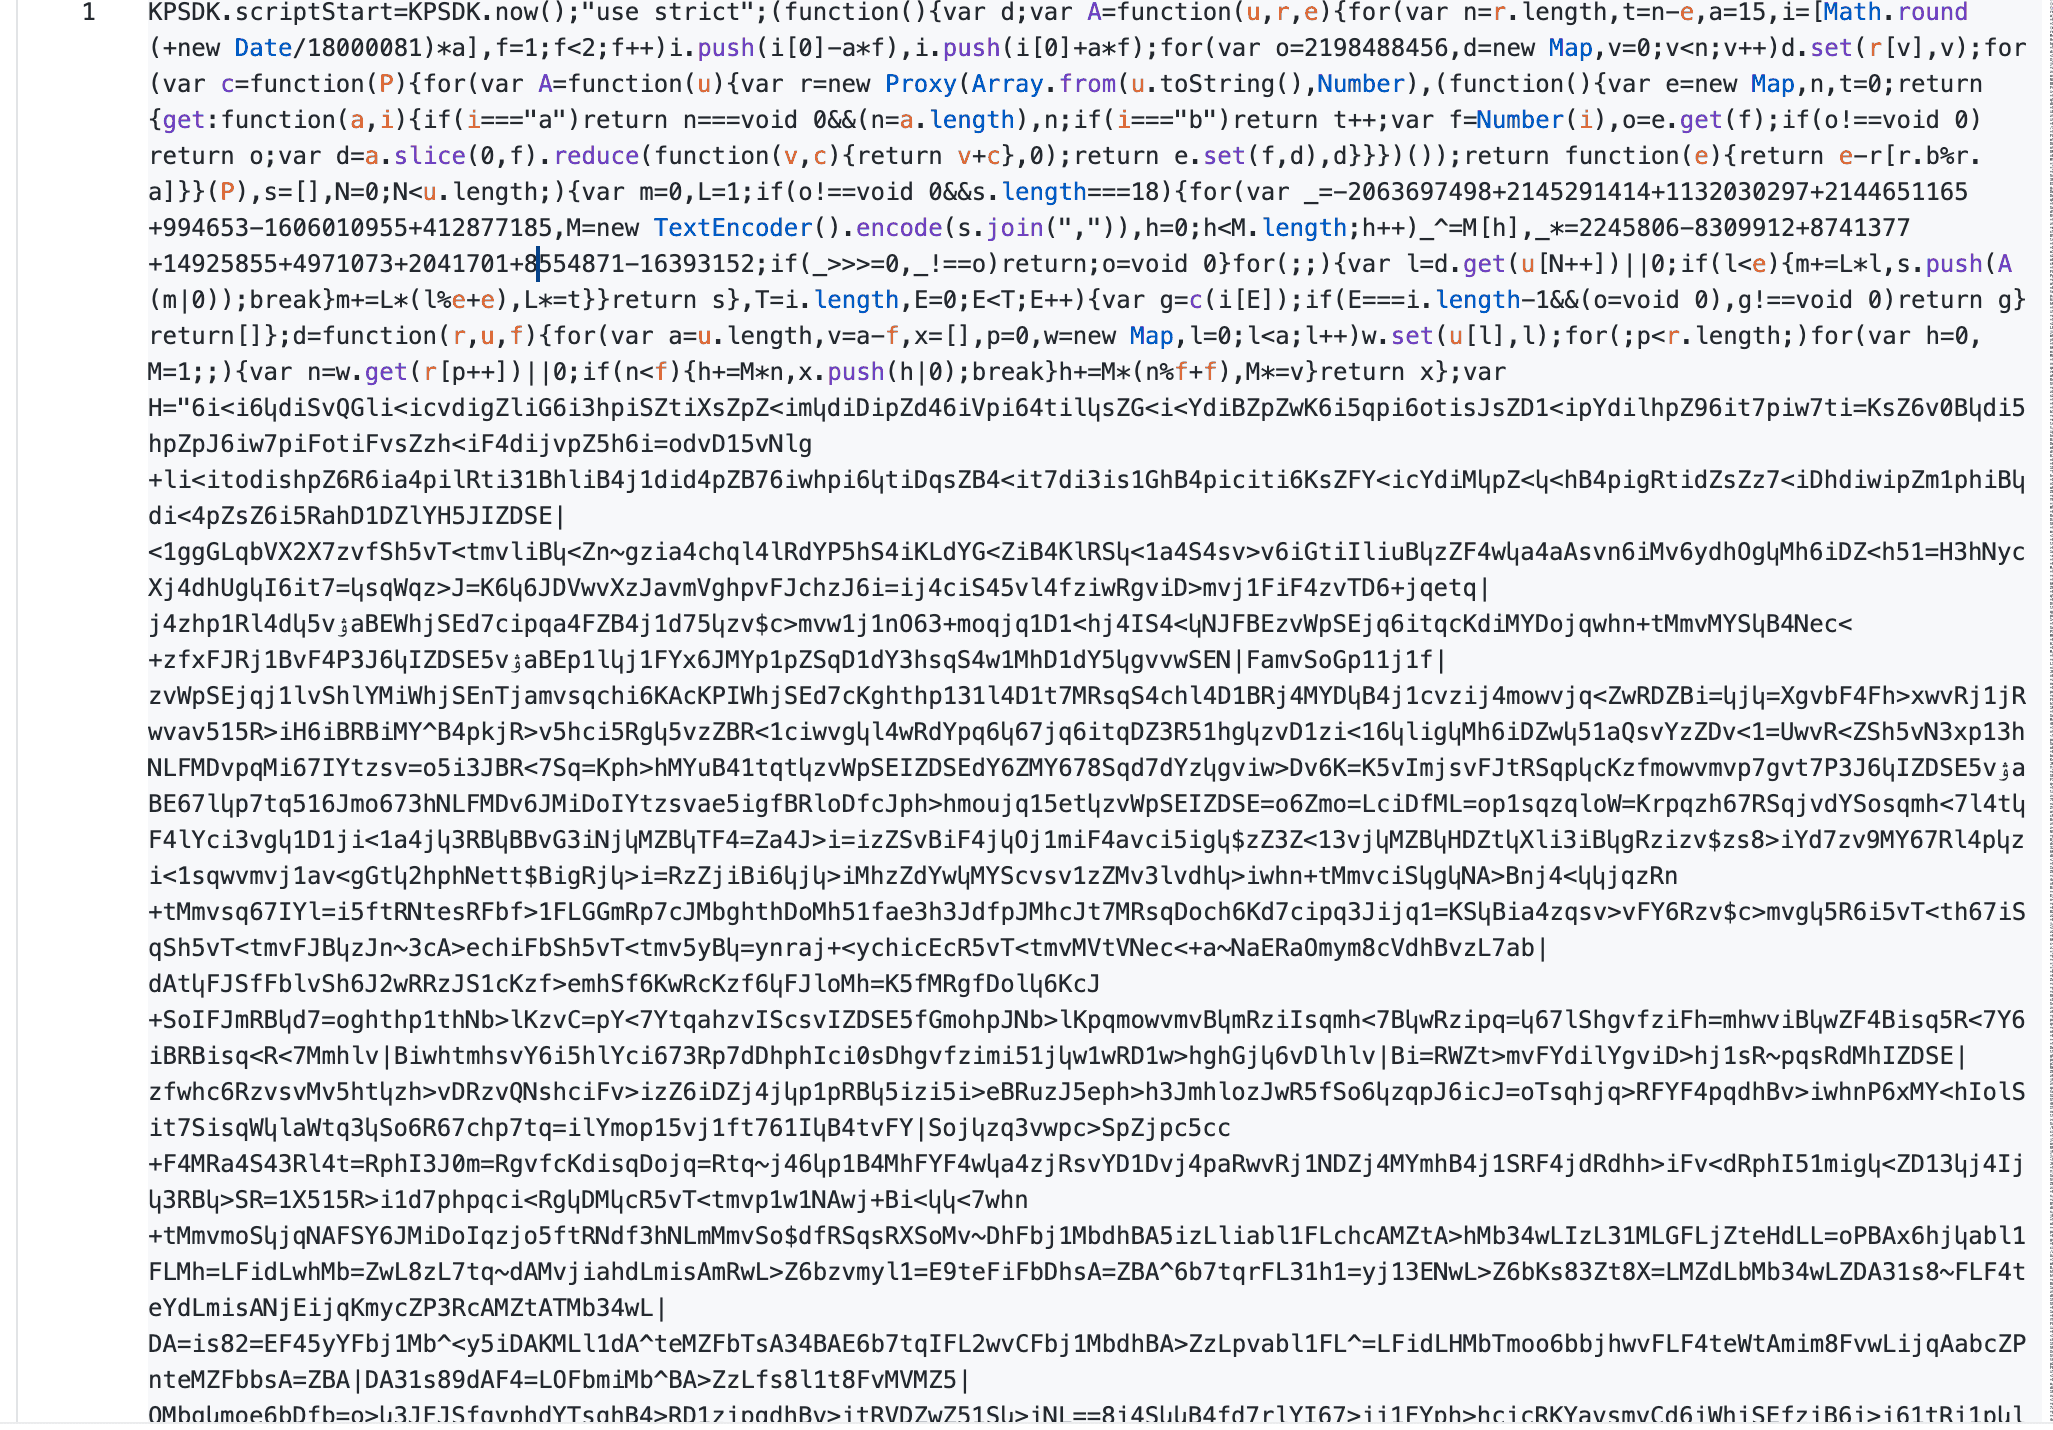
Não há nomes legíveis para as verificações, nenhuma string navigator.webdriver, e nenhuma função chamada detectHeadless. O programa inteiro é uma máquina virtual (VM) personalizada com sua lógica compilada em bytecode, então o código-fonte que você pode ler é o interpretador, e as verificações permanecem ocultas no bytecode.
Decodificando o bytecode e a tabela de strings
Para olhar dentro do interpretador, executei seu estágio de decodificação em um processo Node.js isolado e imprimi o que ele produziu. O resultado mostra o tamanho real do programa:
BYTECODE len: 268444
STRING POOL len: 38459
Então o payload é um programa em bytecode mais uma tabela de strings (a linha STRING POOL), ambos decodificados em tempo de execução a partir de uma grande string no início do script. Como o programa se decodifica em tempo de execução, as strings que você procuraria não existem até que a VM as construa enquanto é executada. Busque o mesmo script novamente e os tamanhos mudam. Em 3 solicitações consecutivas adicionais à mesma URL, o programa decodificado teve 266.322, 275.713 e 266.322 entradas de bytecode.
Partes diferentes mudam em cronogramas diferentes. Uma janela de 5 horas controla a chave que decodifica qualquer conteúdo que uma solicitação recebe. O próprio conteúdo, ou seja, o preenchimento e os valores armazenados dentro do script, muda aleatoriamente a cada resposta, independentemente dessa chave. Então uma cópia salva falha por dois motivos: sua chave expira, e cada nova busca tem conteúdo diferente.
Por que uma cópia salva do script para de funcionar
Algumas propriedades do decodificador importam se você planeja construir um solver a partir de uma cópia salva do script. Primeiro, a chave depende do horário atual. O decodificador a deriva de Math.round(Date.now() / 18000081), e 18000081 milissegundos é quase exatamente 5 horas. Quando avancei o relógio do sistema além dessa janela e executei a decodificação novamente, ela retornou um programa vazio:
 0h  -> bytecode len 268444, pool len 38459
 6h  -> bytecode len 0, pool len undefined
O decodificador aceita uma chave de cerca de 1 janela de tempo antes ou depois da atual, então quanto tempo um script salvo continua funcionando depende de onde dentro de sua janela você o capturou. Na minha nova execução 6 horas à frente, ela já retornou nada, então um script salvo permanece útil por algumas horas, não um dia.
Segundo, o payload verifica sua própria integridade. Quando troquei 2 caracteres no alfabeto de 72 caracteres que o decodificador usa, o programa inteiro falhou ao decodificar em vez de produzir uma saída errada. Um verificador no loop de decodificação mantém uma soma de verificação contínua e para se qualquer byte foi alterado.
Nada disso lhe dá um código que vale a pena copiar. O desafio é polimórfico (muda a cada busca), então a lógica que você copia de 1 captura não continuará funcionando por muito tempo. Um solver que busca o script novamente evita a cópia desatualizada, mas então tem que decodificar conteúdo diferente sob uma nova chave a cada execução, que é o trabalho de manutenção descrito na seção construir-versus-comprar. Os números acima vêm de 1 site protegido e 1 execução, e o Kasada pode mudar qualquer um deles em uma versão posterior. O que se aplica a outros sites é o design. O script se verifica, a chave depende do horário, e o proof-of-work está vinculado ao fingerprint.
Por que o token, não o proof-of-work, bloqueia os scrapers
O proof-of-work é leve para um navegador real e barato para o servidor verificar, então não é caro o suficiente para bloquear a automação apenas pelo custo. O token é o que bloqueia um scraper, porque o Kasada emite um válido apenas para um resultado de uma execução completa da VM, e o proof-of-work é uma parte desse resultado.
O proof-of-work exige que o cliente execute a VM. A VM calcula a prova e coleta o fingerprint, depois combina ambos em 1 pacote criptografado. O script verifica sua própria integridade enquanto decodifica, então um cliente tem que executar a VM e deixar o fingerprinting funcionar normalmente para retornar um resultado válido. Calcular a prova em um servidor e anexar um fingerprint separado não ajuda, porque o Kasada só aceita um token de 1 execução completa da VM.
Esse fluxo termina com um token. Não capturei essa troca diretamente, então o que se segue é inferido de como o protocolo funciona. O cliente envia o pacote criptografado de volta com uma solicitação POST, e se passar, o Kasada substitui o valor inicial de x-kpsdk-ct por um válido que concede acesso. Toda solicitação posterior tem que incluir esse token em seu cabeçalho e cookie, e o token expira. Como o token expira, um scraper tem que repetir a troca para obter um novo.
Do primeiro 429 a um token válido, a troca entre cliente e servidor fica assim:
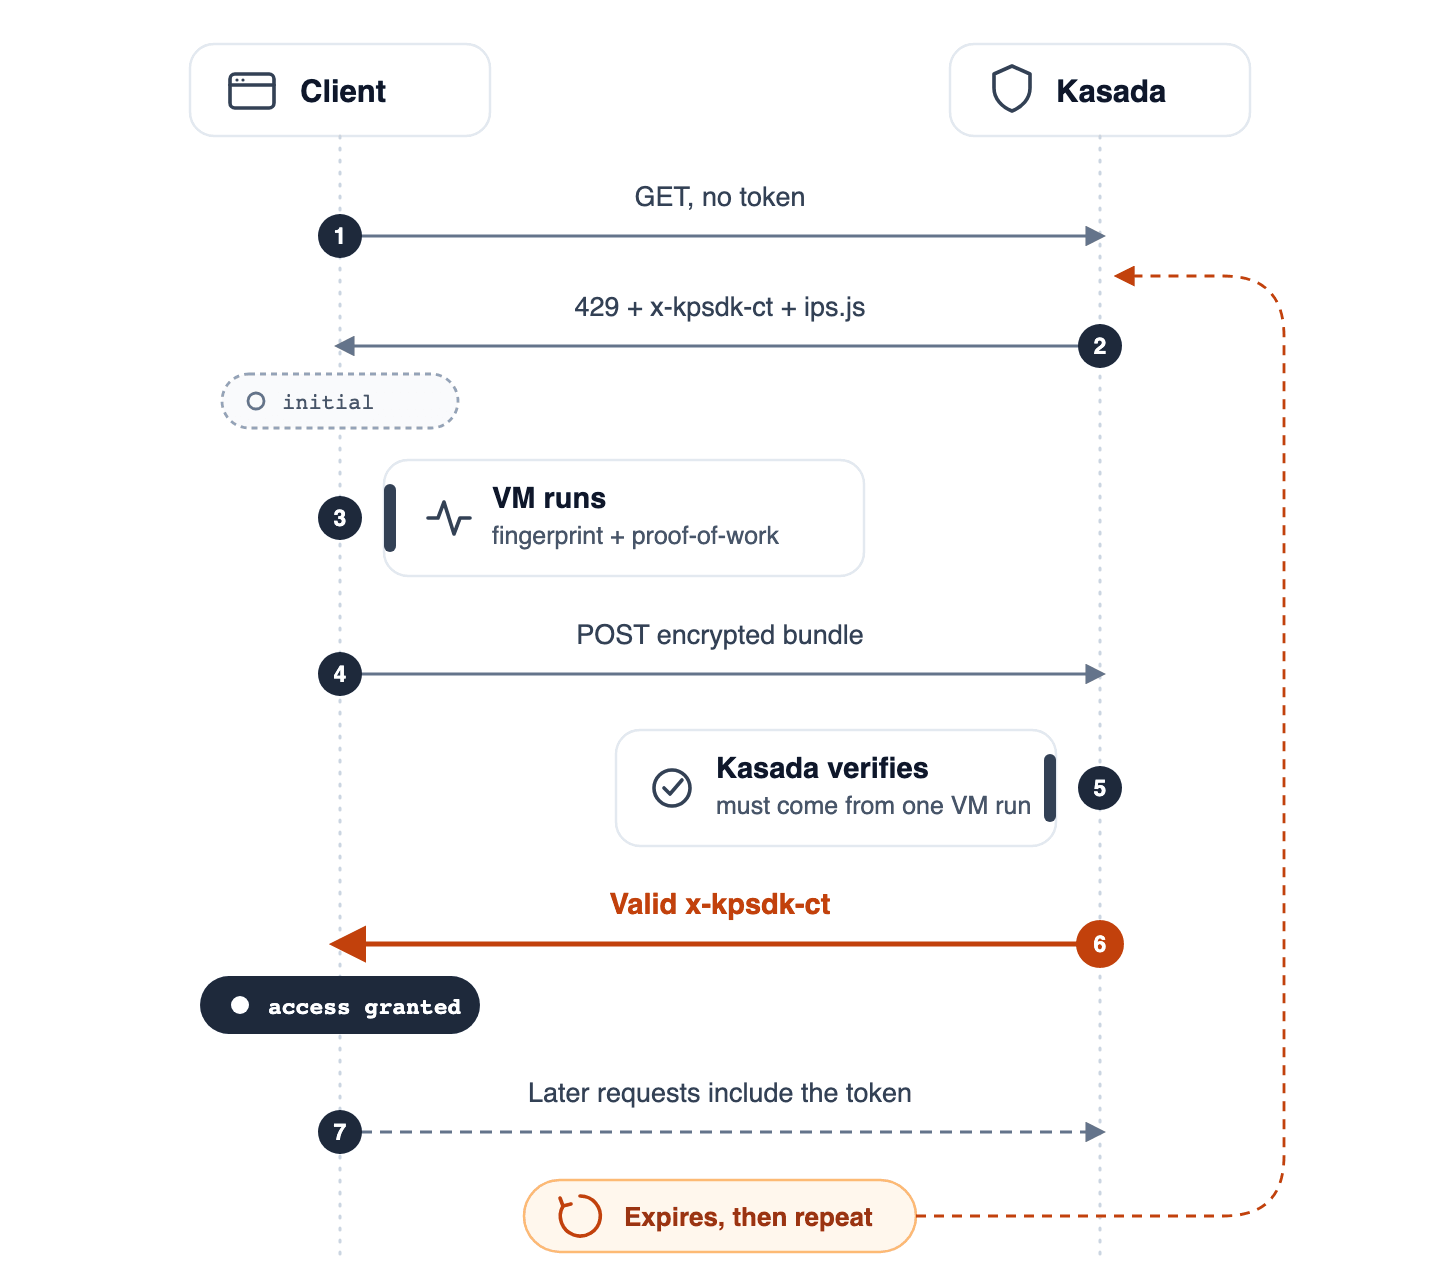
O token também difere entre respostas. Em 3 solicitações consecutivas, o mesmo 429 do Kasada retornou 3 valores diferentes de x-kpsdk-ct, então o token não é um valor fixo que você pode capturar uma vez e enviar novamente.
Como o Kasada detecta navegadores headless
Se a VM precisa de um ambiente de execução que se comporte como um navegador real, a jogada óbvia é automatizar um navegador real. Isso funciona melhor do que um cliente HTTP, mas um navegador automatizado padrão ainda envia sinais, e a tabela de strings decodificada contém os nomes que o Kasada verifica.
Sinais em um navegador headless padrão
Um Chromium headless não modificado mostra que é automatizado. Iniciei um com o Playwright e li as propriedades do navegador que o payload verifica:
# pip install playwright, se você ainda não tiver
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    page = p.chromium.launch().new_page()
    print(page.evaluate("[navigator.webdriver, navigator.userAgent, navigator.plugins.length, window.chrome]"))
Os valores que ele imprime, mostrados aqui um por linha:
navigator.webdriver     true
userAgent               ...HeadlessChrome/<versão> Safari/537.36
navigator.plugins       0        (um navegador real com interface lista vários)
window.chrome           null     (presente em um Chrome desktop normal)
Cada linha é um sinal. navigator.webdriver é true sob automação e false em um navegador normal. A string de user agent contém HeadlessChrome. A lista de plugins está vazia, e o objeto window.chrome que um Chrome desktop expõe está faltando.
Você pode ocultar esses sinais, mas como você os oculta importa quando o alvo é o Kasada. Um Playwright com patch de furtividade altera essas propriedades com JavaScript depois que o navegador inicia, então uma verificação projetada para encontrar tais substituições ainda pode detectá-la. Uma compilação em nível de código-fonte, como o fork Camoufox do Firefox ou um Chromium com patch como o BotBrowser, altera os valores no próprio código C++ do navegador antes de qualquer script ser executado. Isso não deixa nenhuma substituição JavaScript para a verificação encontrar. Uma compilação desatualizada do Chrome também é um sinal, porque sua versão não corresponde ao que os usuários reais usam. Mas atualizar o navegador não remove os próprios sinais do framework de automação.
Sinais de frameworks de automação
O Playwright deixa nomes na página que um navegador normal não tem. Quando adicionei um único binding a uma página do Playwright, ele criou essas variáveis globais:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    page = p.chromium.launch().new_page()
    page.expose_binding("demo", lambda source: None)
    print([k for k in page.evaluate("Object.keys(window)") if "playwright" in k.lower()])
Ele imprime estes nomes:
['__playwright__binding__', '__playwright__binding__controller__']Os nomes acima são apenas o que um único binding cria. Separadamente, pesquisei na tabela de strings decodificada os nomes de binding internos do Playwright. Cerca de metade dos nomes na versão do Playwright que testei apareceu lá como strings simples, ao lado de webdriver, HeadlessChrome e electron. Os nomes que apareceram são seus bindings de gravador e devtools.
Um nome na tabela de strings decodificada não prova que a VM atua sobre ele. Ainda assim, encontrá-los lá mostra que o Kasada conhece essas ferramentas pelo nome, então não precisa adivinhar qual biblioteca de automação está detectando.
Detecção de CDP e as ferramentas que a evitam
Mesmo sem um binding, o Chrome DevTools Protocol (CDP) que os frameworks de automação usam para controlar o navegador os expõe. Um artigo sobre fingerprinting de CDP mostrou que chamar Runtime.enable, o que o Playwright e o Puppeteer fazem por padrão, faz o navegador serializar (converter em texto) imediatamente objetos passados para métodos console. Um script curto pode detectar isso sem medições de tempo, passando um objeto Proxy para uma chamada console:
let detected = false;
const trap = new Proxy({}, { ownKeys() { detected = true; return []; } });
console.groupEnd(Object.create(trap));
// detected é true em Chromium mais antigo quando um cliente CDP chamou Runtime.enable
O autor relatou que a técnica funcionava quando a publicou, e confirmei isso de forma independente em compilações mais antigas do Chromium, onde o trecho retorna true em uma página padrão do Playwright porque o Playwright chama Runtime.enable por padrão. Nas compilações mais novas do Chromium que testei, o mesmo trecho retorna false, mesmo depois de eu mesmo chamar Runtime.enable, então o Chrome mudou como lida com argumentos do console. Execute-o em sua própria versão do navegador antes de depender dele. Uma verificação como essa não precisa de permissões ou extensões, então é barata para um sistema anti-bot executar e difícil de você notar.
Uma resposta é controlar o Chrome sem o código do framework que chama Runtime.enable. Ferramentas como nodriver, seu fork zendriver, e o SeleniumBase’s CDP Mode se comunicam com o Chrome diretamente via CDP e nunca chamam Runtime.enable. Forks do Playwright com patch como o patchright corrigem o mesmo problema dentro do Playwright. Na compilação mais antiga onde o trecho retornou true para o Playwright, ele retornou false contra a página padrão do zendriver, porque nenhuma chamada Runtime.enable é feita. Cada uma dessas ferramentas ajuda, mas nenhuma é permanente, porque o sinal, a correção e a verificação do Kasada mudam todos em seus próprios cronogramas, e a mudança do navegador acima é um exemplo.
Scraping com um cliente HTTP e seus limites
Muitas equipes tentam pular completamente o navegador, e por um bom motivo. Um navegador é lento e intensivo em recursos, e um cliente HTTP que apresenta o fingerprint correto é muito mais barato por solicitação. A questão é quão bem essa abordagem funciona contra o Kasada.
Você pode passar na verificação de fingerprint TLS com bibliotecas como curl_cffi em Python ou surf em Go, que alteram o handshake TLS para corresponder a um navegador real. Para verificar isso, use um serviço que relata o handshake TLS que recebe. Ele relata JA4, um fingerprint calculado apenas a partir do handshake, e lista as configurações HTTP/2 (que o Kasada também lê) como um fingerprint separado:
# pip install curl_cffi, se você ainda não tiver
from curl_cffi import requests as cf

r = cf.get("https://tls.peet.ws/api/all", impersonate="chrome")
print(r.json()["tls"]["ja4"])
# remova impersonate= para ver o JA4 do cliente padrão em vez disso
Execute-o das duas formas e compare. Estes são os valores que obtive, e os seus vão diferir conforme navegadores e bibliotecas são atualizados, então verifique-os contra um Chrome real no mesmo serviço:
curl_cffi impersonate="chrome"  JA4=t13d1516h2_8daaf6152771_806a8c22fdea
curl_cffi (sem impersonate)      JA4=t13d2712h2_b4f9224df7c1_9ced094328c9
O cliente personificado envia um JA4 que corresponde a um navegador real, enquanto o cliente padrão envia um JA4 que nenhum navegador usa. Se você fixar uma versão específica de navegador, o User-Agent continua afirmando essa versão depois que o Chrome real já atualizou, o que faz seu cliente parecer desatualizado. Usar impersonate="chrome" em vez disso deixa a biblioteca escolher a versão do Chrome, então você não precisa atualizar um número de versão. O guia do curl_cffi mostra a configuração completa.
Executei o trecho novamente através de um segundo serviço, https://tls.browserleaks.com/json, e o JA4 personificado foi idêntico. Ele relata o valor como r.json()["ja4"], então funciona como alternativa se o tls.peet.ws estiver inacessível, o que aconteceu na minha rede uma vez.
O problema é que o handshake TLS não é onde o Kasada toma sua decisão. Um cliente HTTP que passa na verificação TLS ainda recebe o desafio, e não consegue executar a VM.
Para obter um token com uma abordagem somente HTTP, você teria que portar o interpretador, a coleta de fingerprint e o proof-of-work para o seu próprio código, depois atualizar esse código toda vez que o payload mudar. Serviços especializados de solver vendem exatamente isso como uma API, gerando o token e o proof-of-work via HTTP. De qualquer forma, você paga um custo contínuo, que é sua própria manutenção ou uma taxa por solução, e o solver tem que se adaptar a cada mudança no payload. A abordagem HTTP lida com a verificação TLS de forma rápida e correta, mas não consegue produzir o token que o Kasada exige.
Mais um ponto afeta como você decide se uma solicitação foi bem-sucedida. O próprio CTO de campo do Kasada descreveu a abordagem que preferem. Em vez de bloquear com um erro, servem uma página que parece correta, mas está errada, então o operador continua acreditando que o bot funciona. Uma resposta com conteúdo nem sempre é uma resposta correta, então qualquer teste contra o Kasada tem que comparar o conteúdo com o que um navegador mostra, não apenas verificar se algo foi retornado.
Construir versus comprar para o Kasada
Juntas, as análises mostram que um solver que você mesmo constrói não é um único problema difícil. É um trabalho de manutenção contínuo. Você teria que manter tudo isto:
- Um interpretador de VM que se adapta a um payload autoverificável e uma chave rotacionada frequentemente
- Um perfil de fingerprint que corresponde às verificações em constante mudança do Kasada
- Um tratamento de token que funciona quando um token expira durante uma sessão
- Um pool de proxies com reputação boa o suficiente para passar na verificação de reputação de IP
Construir pode fazer sentido quando você tem como alvo um único site e tem engenheiros que podem manter o solver atualizado. Quando você tem como alvo vários sites ou não pode dedicar tempo de engenharia, um serviço gerenciado tira esse trabalho da sua equipe.
Web Unlocker para solicitações únicas
Um serviço gerenciado é a alternativa a contratar engenheiros para esse trabalho contínuo. O Web Unlocker da Bright Data recebe uma URL alvo e cuida do desafio, da sessão e da escolha do IP de saída (o endereço que o alvo vê) para você, então seu código envia 1 solicitação e lê o resultado:
curl -H "Content-Type: application/json" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -d '{"zone":"YOUR_ZONE_NAME","url":"https://target.example/listing","format":"raw"}' \
  https://api.brightdata.com/request
Substitua ambos os espaços reservados pelo nome da sua zona e chave de API, e defina url como seu próprio alvo, antes de executá-lo.
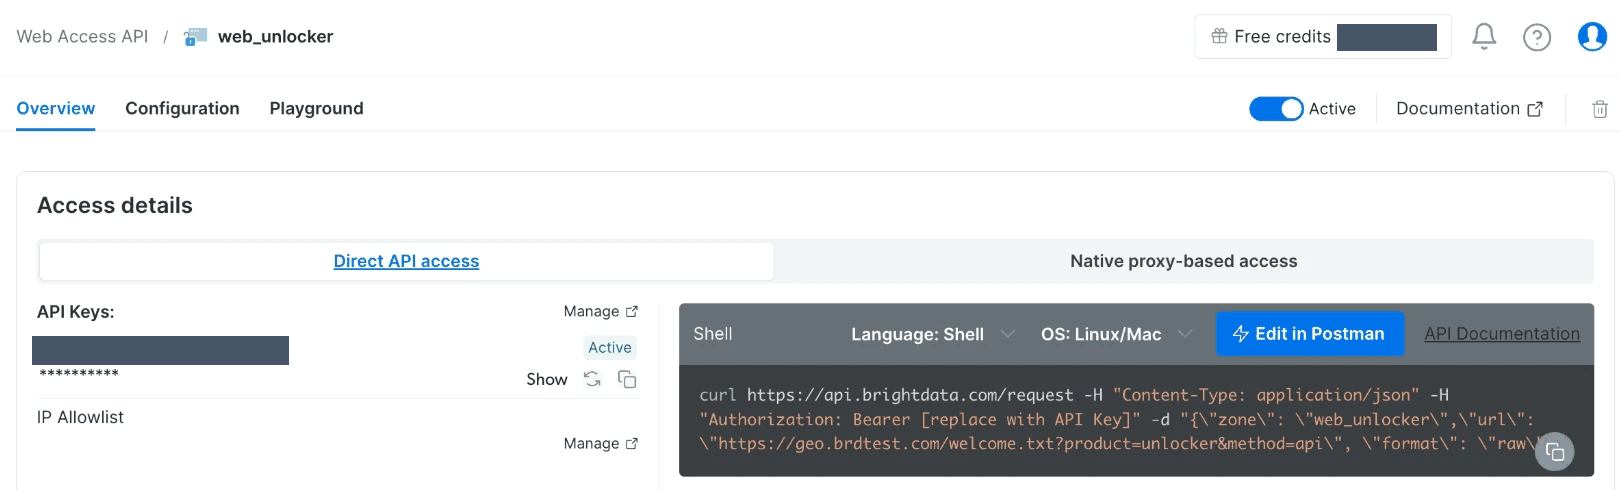
Ambos os valores estão na aba Overview da sua zona Web Unlocker. O painel Direct API access lista sua chave e uma solicitação pronta para executar que já inclui o nome da sua zona:
Para ver uma chamada bem-sucedida antes de usá-la em um alvo real, a aba Playground da zona executa a mesma solicitação contra a URL de teste da Bright Data e mostra a resposta:
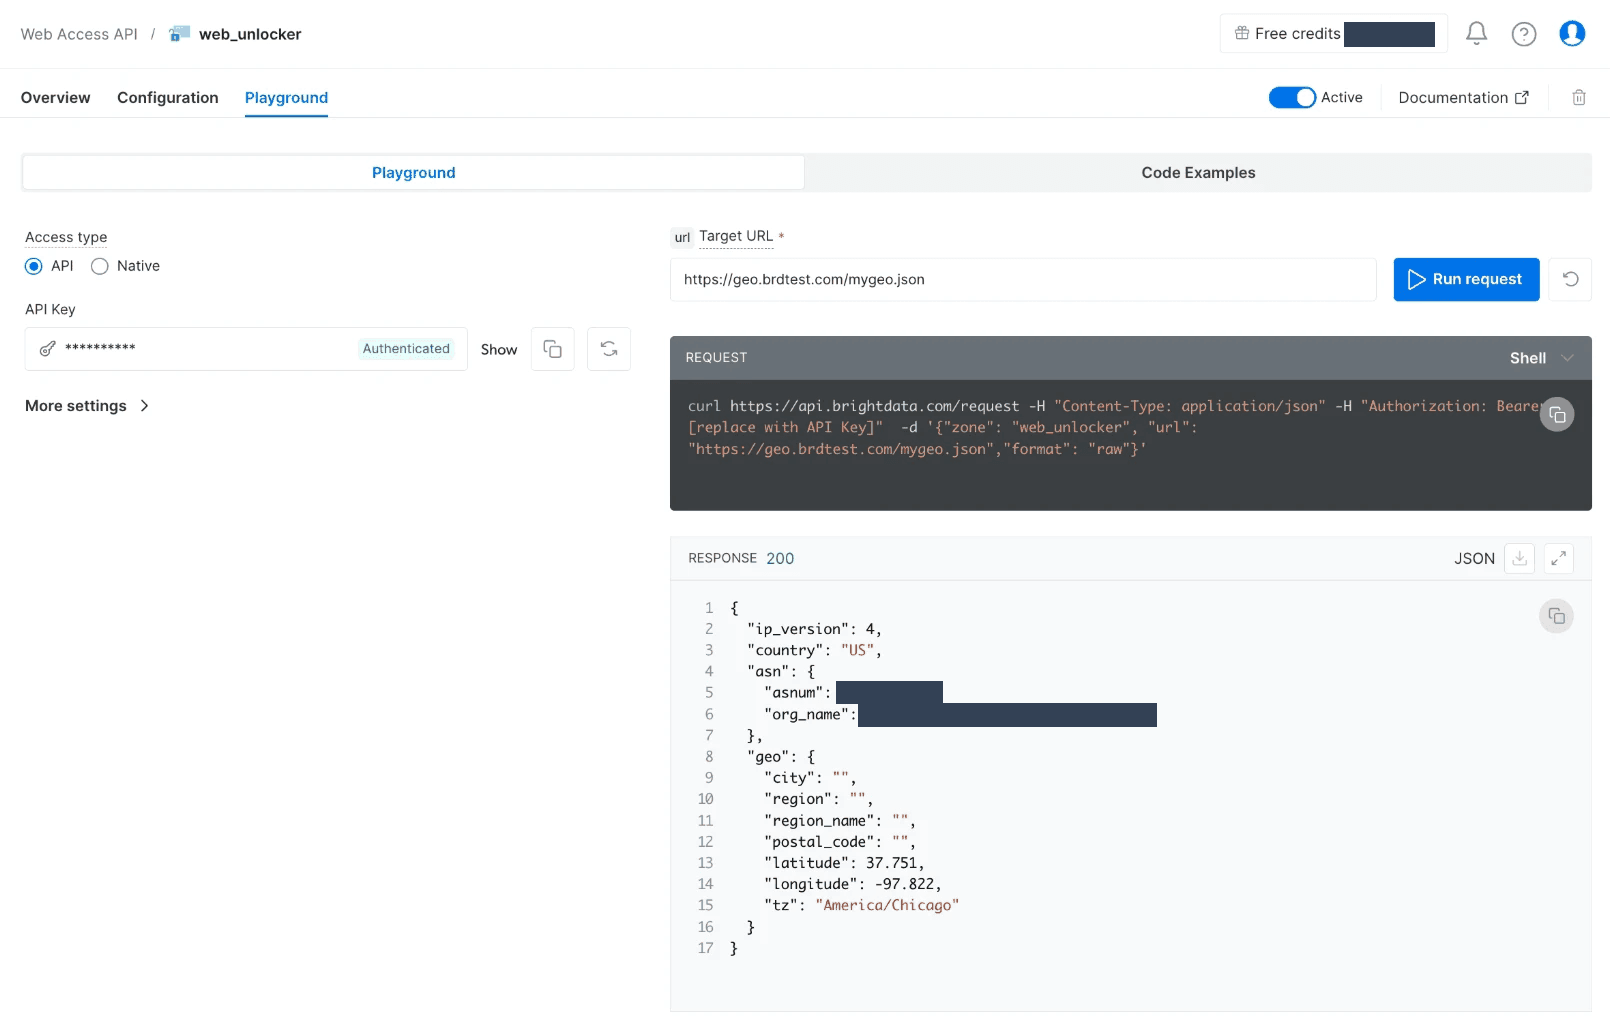
Uma chamada bem-sucedida retorna o corpo da página desbloqueada. O Web Unlocker cobra por solicitação bem-sucedida, e seu plano gratuito inclui 5.000 solicitações por mês sem necessidade de cartão de crédito, então você pode testá-lo contra seu próprio alvo. A resolução do Kasada está embutida, conforme descrito na página de solver do Kasada da Bright Data. Os planos e taxas atuais estão na página de preços do Web Unlocker. Campos opcionais de solicitação permitem escolher o país de saída com country e carregar páginas que precisam de JavaScript com render, ambos listados na referência da API.
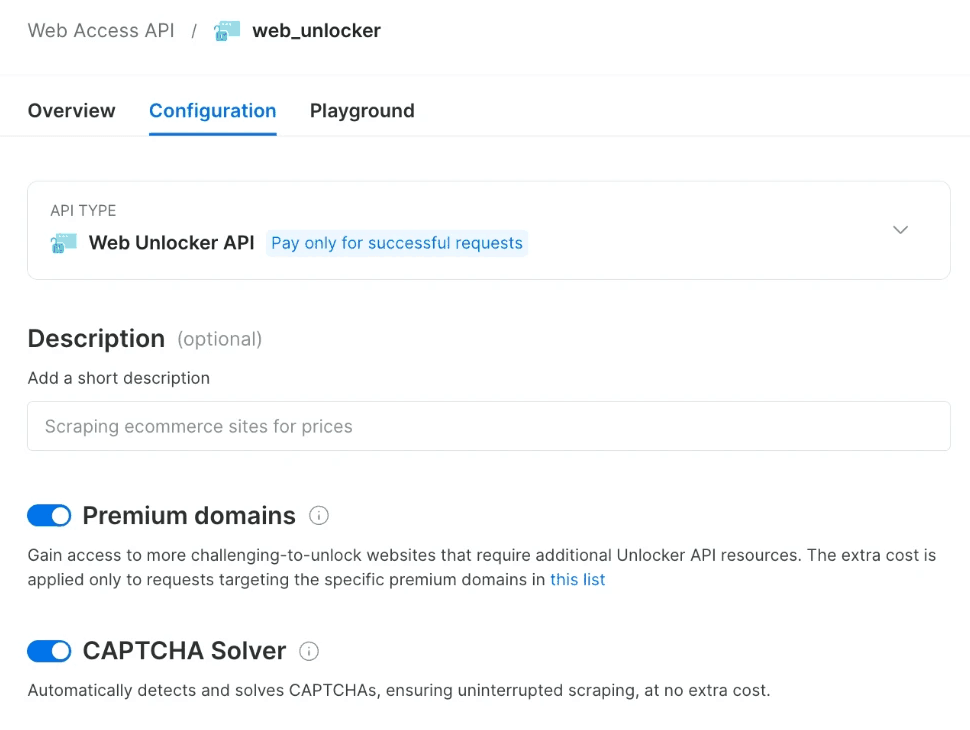
Para sites mais desafiadores, ative a opção Premium domains na aba Configuration da zona para adicionar os recursos extras que esses sites precisam:
Browser API para páginas interativas
Quando o alvo precisa de interação completa com a página, como um fluxo de login ou uma pesquisa em várias etapas, a Browser API executa um navegador gerenciado ao qual você se conecta. O Playwright e o Puppeteer o controlam via CDP. A URL de conexão contém seu ID de cliente, o nome da zona e a senha da zona, e a aba Overview da zona lista todos eles em Access details:
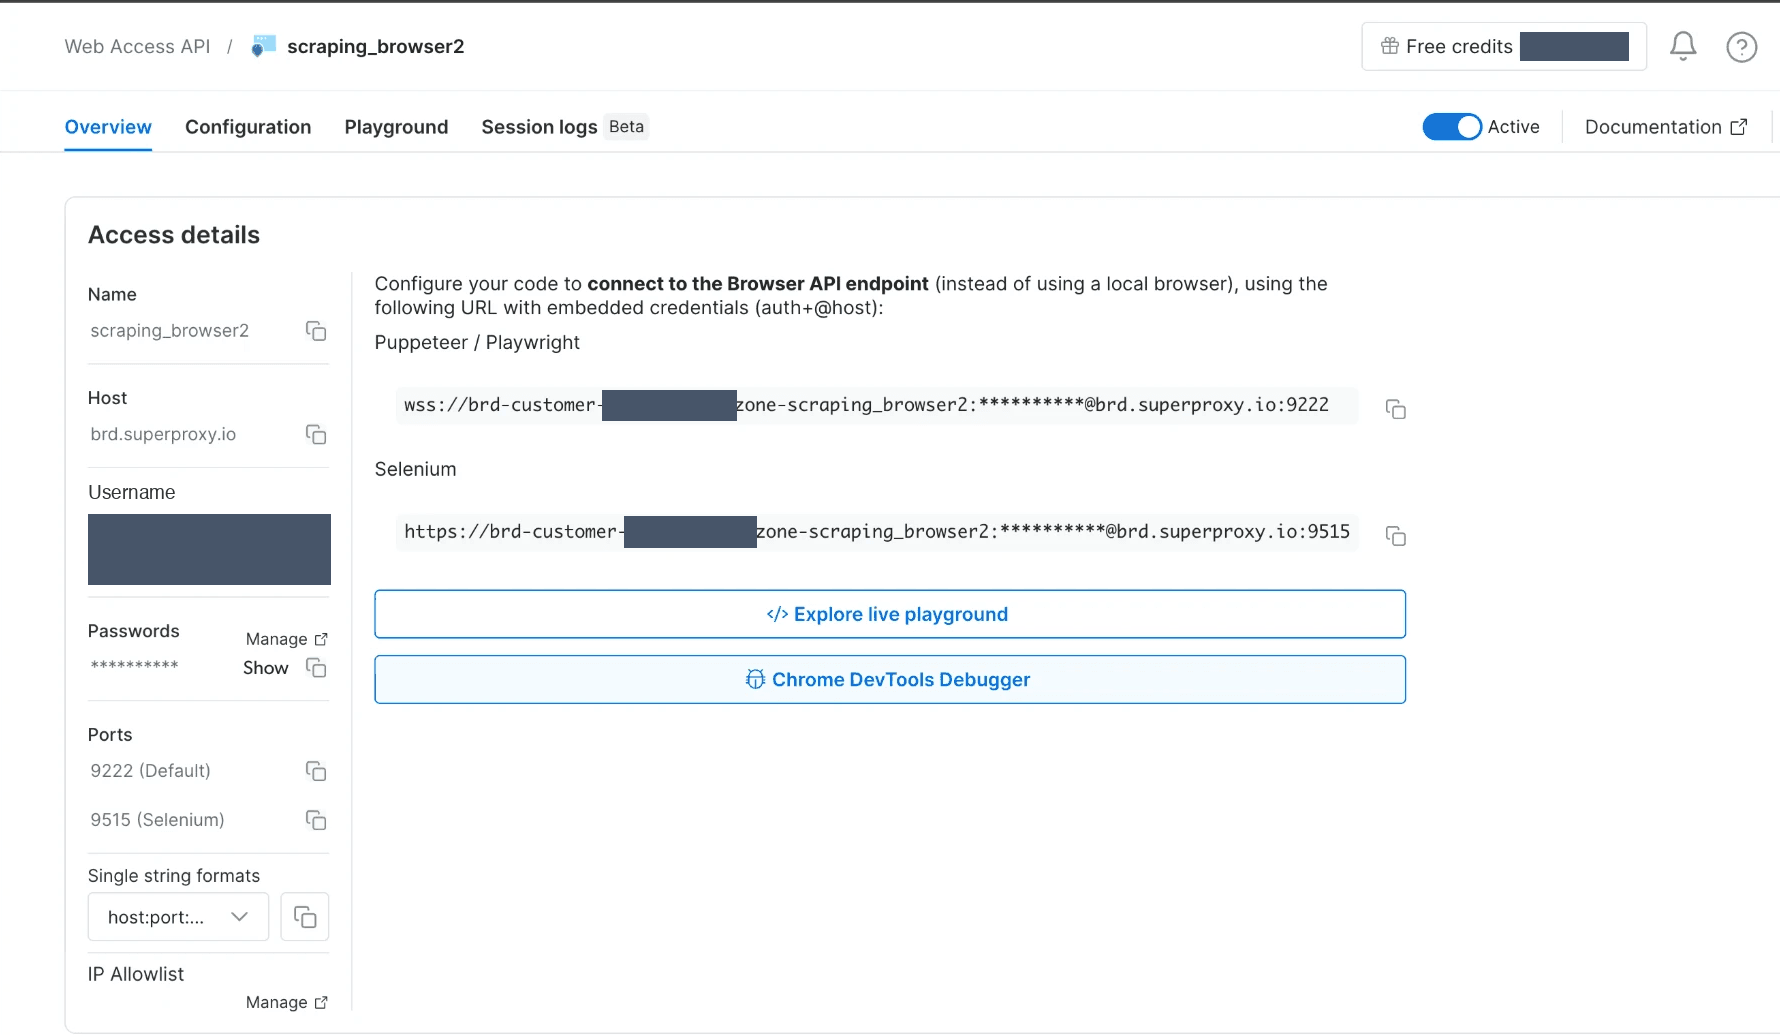
Depois de inserir esses valores, ele se conecta como qualquer navegador remoto:
# pip install playwright, se você ainda não tiver
from playwright.sync_api import sync_playwright

CDP = "wss://brd-customer-CUSTOMER_ID-zone-ZONE_NAME:[email protected]:9222"
with sync_playwright() as p:
    browser = p.chromium.connect_over_cdp(CDP)
    page = browser.new_page()
    page.goto("https://target.example/search")
    page.wait_for_selector("YOUR_CONTENT_SELECTOR")  # substitua por um seletor para o conteúdo que você precisa
    print(page.title())
    browser.close()
Quando você se conecta dessa forma, o desbloqueio embutido da Browser API cuida do desafio do Kasada, então seu script funciona com uma página comum. Espere pelo conteúdo que precisa com um seletor, e use esse conteúdo, não um código de status, para confirmar sucesso. A Browser API também suporta o Selenium, e para um alvo Kasada, comece com a conexão CDP mostrada acima. A aba Overview da zona também tem links para um playground ao vivo e um depurador do Chrome DevTools, então você pode observar uma sessão enquanto constrói.
As taxas atuais da Browser API estão na sua página de preços. Para páginas mais simples, uma única solicitação do Web Unlocker é a opção mais rápida, e técnicas padrão anti-bloqueio lidam com os casos restantes.
Agentes de IA e bots verificados
O Kasada ainda está evoluindo, e o tráfego de agentes de IA muda o que ele tem que detectar. Lançou o AI Agent Trust, um produto que gerencia o tráfego de agentes de IA. Ele classifica os agentes por quão bem conseguem provar sua identidade, e permite que um site permita alguns agentes e bloqueie outros.
Identificar agentes depende de um padrão chamado Web Bot Auth. Ele permite que um bot prove sua identidade a cada solicitação, usando HTTP Message Signatures (definido na RFC 9421), um cabeçalho assinado e um diretório de chaves publicado. O grupo de trabalho do Internet Engineering Task Force (IETF) mantém os rascunhos, então verifique o status atual antes de depender disso. O Cloudflare já verifica essas assinaturas para bots que se registram com ele. A direção é uma web onde um agente verificado tem acesso permitido e um agente não verificado tem que completar o desafio completo. Nada disso torna um token do Kasada opcional para um scraper.
Considerações finais
O Kasada bloqueia solicitações que não têm um token válido, e emite um apenas depois que o cliente completa seu desafio autoverificável. A personificação TLS passa apenas na verificação TLS, então o problema a corrigir é o token x-kpsdk-ct. Compare um solver que você constrói e mantém, que pode parar de funcionar em poucas horas, com o Web Unlocker da Bright Data, que executa o desafio para você e inclui 5.000 solicitações gratuitas por mês sem necessidade de cartão de crédito. Se você está decidindo onde focar seu tempo de engenharia, comece com a opção gerenciada enviando 1 solicitação para a URL exata que está retornando seus 429s, e verifique o corpo da resposta em vez do código de status.
FAQ
Como funciona o Kasada?
O Kasada serve um desafio JavaScript ofuscado a partir de um caminho como /ips.js. O script executa uma máquina virtual que faz fingerprint do ambiente de execução, calcula um proof-of-work, e envia um pacote criptografado de volta. Se passar, o Kasada emite um token x-kpsdk-ct, e toda solicitação deve incluí-lo ou receber uma resposta 429.
Você pode contornar o Kasada com um solver gratuito e de código aberto?
Um solver gratuito do GitHub pode funcionar no início, mas para de funcionar rapidamente. O payload muda sua chave decodificadora com frequência (cerca de a cada 5 horas na minha captura) e verifica sua própria integridade, então a lógica capturada para de decodificar em poucas horas. Um solver público pode estar desatualizado, então use-o para estudar, não em produção.
Atualizar o Chrome contorna o Kasada?
Atualizar ajuda, mas não resolve o problema. Uma compilação antiga do Chrome é um sinal por si só, então uma compilação atual remove esse sinal. Não remove os outros sinais, como navigator.webdriver, uma lista de plugins vazia, ou os próprios sinais do framework de automação, que o desafio também verifica.
O que são os cabeçalhos x-kpsdk?
São os cabeçalhos do Kasada. x-kpsdk-ct é o token do cliente (um válido concede acesso), x-kpsdk-r e x-kpsdk-c são cabeçalhos de desafio relacionados, e os cookies KP_UIDz correspondentes rastreiam a sessão. Ver qualquer cabeçalho x-kpsdk-* em um 429 ou 403 é um sinal confiável de que o Kasada recusou a solicitação.
Qual é a forma mais rápida de contornar um 429 do Kasada?
Encaminhe a solicitação através do Web Unlocker da Bright Data, que recebe a URL, cuida do desafio para você, e cobra por solicitação bem-sucedida. Para páginas que precisam de login ou interação em várias etapas, use a Browser API via CDP, cujo desbloqueio embutido cuida do desafio.