O Naver encerrou sua API de busca do Shopping em 31 de julho de 2026, sem substituto oficial. As equipes ainda precisavam de preços, rankings e nomes de vendedores do Naver Shopping e SmartStore, então sua principal opção era fazer scraping das páginas do Naver.
Em nossos testes, clientes HTTP simples obtiveram resultados completos das páginas de busca do Naver. As páginas de shopping do Naver, porém, retornaram uma página de bloqueio, um CAPTCHA ou um redirecionamento para login. Os dados ainda estavam lá, embutidos nessas páginas como JSON.
Este guia mostra como ler esse JSON em Python, qual ferramenta da Bright Data busca cada tipo de página, e como cada ferramenta é cobrada.
Resumo
- Faça scraping das páginas de busca do Naver com a API SERP da Bright Data. Leia os preços em
discountedSalePrice, porquesalePriceera 0 em 6 de 8 cartões de comparação de preços para 아이폰 17. - Use o Web Unlocker para resultados da Plus Store e a Browser API para paginação. Sinalize anúncios: nenhuma das primeiras 6 listagens para 코카콜라 제로 era orgânica.
- Reconstrua a maioria dos campos da API Shopping a partir da busca de comparação de preços. O Web Unlocker retornou o JSON da página, com
lowPrice,brande categorias, para 10 de 10 consultas. - Envie URLs de produtos do SmartStore para a Naver Shopping Scraper API. Um lote de 10 retornou todas as listagens públicas, com preços correspondentes a cada página.
O fim da API de busca do Shopping do Naver
A Open API do Naver era a fonte oficial de dados para monitoramento de preços e de vitrine digital. Seu endpoint de busca do Shopping retornava até 100 produtos por chamada e permitia 25 mil chamadas por dia com uma chave gratuita.
O aviso do centro de desenvolvedores do Naver anunciou que as APIs de busca do Shopping, Book e de documentos de pesquisa encerrariam em 31 de julho de 2026. O aviso disse que as chaves existentes parariam de funcionar sem período de carência. Também disse que o Naver não forneceria API substituta, nem mesmo no NAVER API HUB:
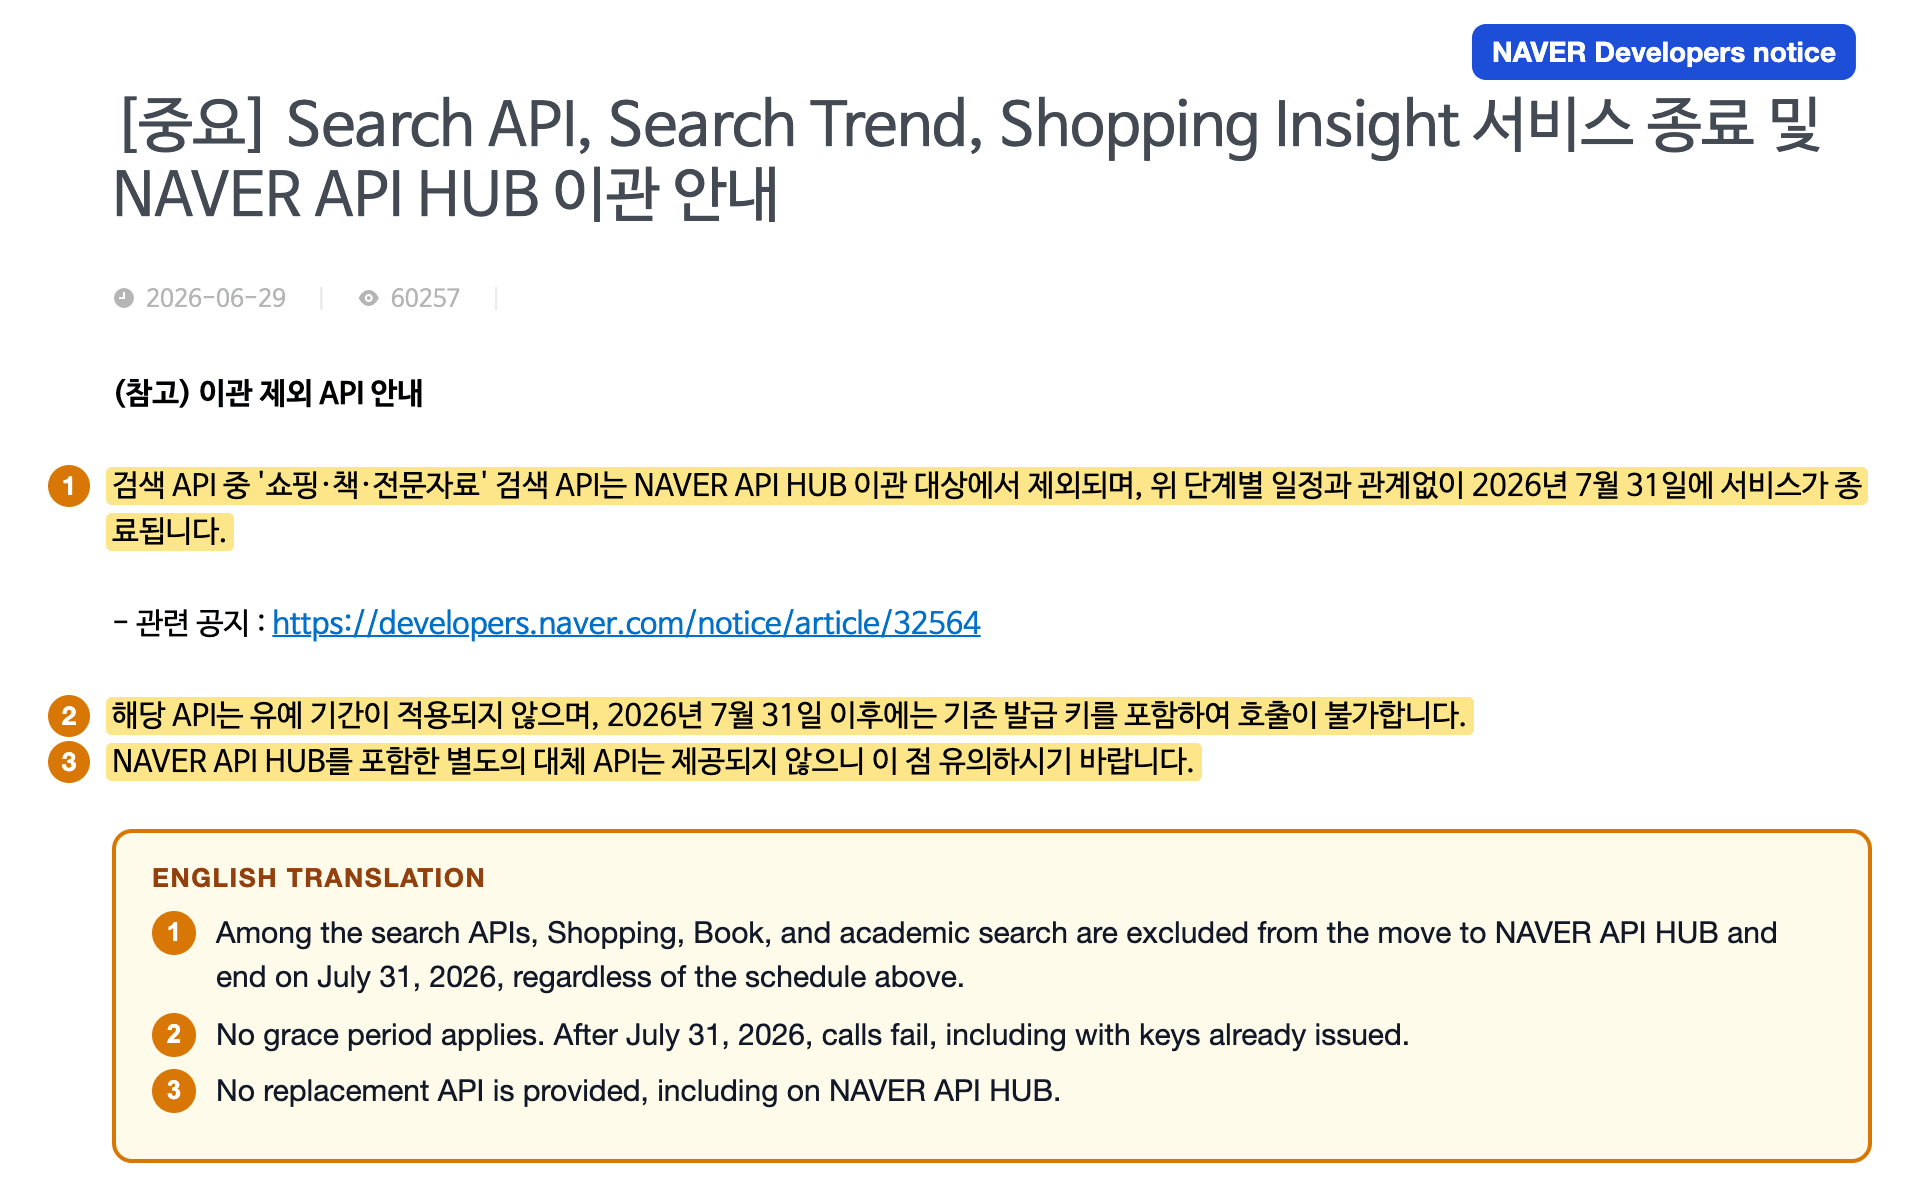
Com uma data final fixa e sem período de carência, os feeds que chamavam essa API precisavam de uma nova fonte até 31 de julho de 2026.
O mesmo aviso disse que as outras APIs de busca, incluindo blog, notícias e busca de documentos web, migrariam para o NAVER API HUB na NAVER Cloud Platform. As chaves do centro de desenvolvedores emitidas antes de 31 de julho de 2026 continuariam funcionando para essas APIs até 30 de junho de 2027.
De acordo com os termos da Open API do Naver, essas APIs também não deveriam ser usadas como feed de monitoramento. Os termos proibiam copiar, armazenar ou fazer cache de resultados, exceto cache temporário para continuidade do serviço. Também proibiam fornecer ou vender resultados a terceiros e usá-los como entrada ou dados de treinamento de IA.
A API DataLab Shopping Insight do Naver retornava tendências de cliques por categoria e palavra-chave. Ela escalava cada tendência para que seu ponto mais alto fosse 100. Essas tendências mostravam se o interesse subia ou caía, mas sem preços. As páginas públicas do Naver mostravam preços, rankings e nomes de vendedores, então colete-os ali.
Como cada propriedade do Naver respondeu aos scrapers
Testamos 4 clientes HTTP simples em cada uma de 4 propriedades do Naver a partir de uma conexão residencial na Índia. As páginas de busca e de hotéis retornaram HTML completo, mas as páginas de shopping e de produtos bloquearam esses clientes. Para as páginas bloqueadas, a tabela também inclui navegadores e desbloqueadores:
| Propriedade do Naver | Clientes HTTP simples obtiveram | Navegadores e desbloqueadores obtiveram |
|---|---|---|
Busca (search.naver.com) |
A página de resultados completa, cerca de 1,5 MB, mesmo com o User-Agent padrão do python-requests | Não foi necessário para carregar a página |
Busca de shopping (search.shopping.naver.com) |
Uma página de bloqueio HTTP 418, uma página de CAPTCHA HTTP 405, ou um redirecionamento 307 para a página de login do Naver | Chrome headless obteve o 418, Chrome com interface obteve o CAPTCHA, e o Web Unlocker obteve os resultados |
Produtos do SmartStore (smartstore.naver.com) |
Uma página HTTP 429 intitulada “시스템오류” (“erro de sistema”) na primeira solicitação | Web Unlocker e Browser API obtiveram a página do produto |
Hotéis (hotels.naver.com) |
A página completa com seus dados do Next.js | Não foi necessário para carregar a página |
A busca do Naver retornou resultados para todas as 500 solicitações de teste, sem CAPTCHA ou bloqueio. As primeiras 200 foram sequenciais, espaçadas por cerca de 2 segundos. As outras 300 foram enviadas em rajada a 4,9 solicitações por segundo de 8 workers concorrentes, e cada solicitação da rajada usou uma nova sessão.
A página 418 na busca de shopping dizia que o acesso estava temporariamente restrito. A página listava 4 gatilhos: visitas de promoções externas não relacionadas a shopping, rajadas de solicitações de um único IP, IPs de VPN e certas extensões de navegador. A página 405 carregava o próprio script de CAPTCHA do Naver a partir de ncpt.naver.com.
No Chrome com interface, a página 405 carregava um módulo WebAssembly de wtm.pstatic.net e postava um payload criptografado para ncpt.naver.com/v2/tokens. A página então exibia um CAPTCHA de recibo: um recibo de loja gerado com uma pergunta de preenchimento de lacuna sobre ele.
Um cliente HTTP simples com o User-Agent do Chrome obteve o CAPTCHA 405 em vez do 418. O CAPTCHA 405 ainda apareceu depois que o curl_cffi combinou com o fingerprint TLS e HTTP/2 do Chrome. O Chrome headless obteve o 418 em sua primeira solicitação de documento, após 0,5 segundos e antes que qualquer script da página fosse executado. Nenhum dos 6 clientes, do python-requests ao Chrome com interface, obteve resultados de shopping.
O 429 do SmartStore apareceu na primeira solicitação de cada novo cliente, então se comportou mais como um bloqueio do que um limite de taxa típico. Seu texto de erro dizia que a causa era tráfego intenso ou rede instável.
Colete apenas páginas que carregam sem login. Dados atrás de um redirecionamento de login não são públicos, porque acessá-los exige automatizar uma conta do Naver. A política de uso aceitável da Bright Data também exclui dados atrás de um login.
Trate cada propriedade como um alvo separado.
O JSON embutido em cada página do Naver
Todas as páginas do Naver que testamos tinham seus dados no HTML como JSON ou um objeto JavaScript, então os parsers não precisam de seletores CSS. Na página de resultados de busca, os dados de cada bloco de shopping eram atribuídos à sua própria variável JavaScript:
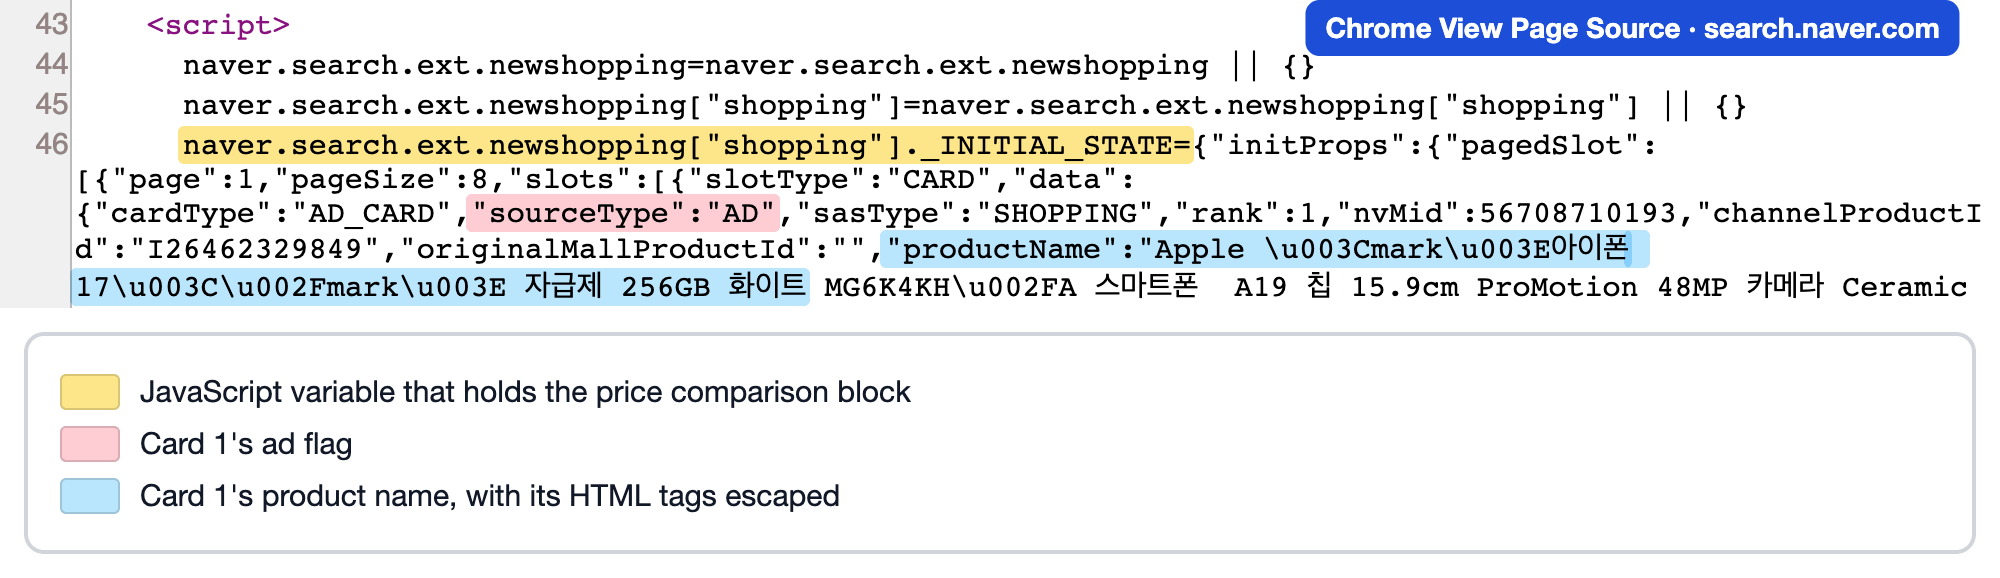
Os dados do bloco de comparação de preços eram um único objeto JSON, então uma única chamada de decodificador lê todos os cartões nele. No View Page Source, essa atribuição era uma única linha de 32.182 caracteres.
Cada página armazenava seu JSON em um local diferente, e cada página tinha seu próprio problema de parsing:
| Página | Localização do JSON | Problema de parsing |
|---|---|---|
| Resultados de busca | Um objeto _INITIAL_STATE em naver.search.ext.newshopping["shopping"], e outro em ["nstore"] |
salePrice era 0 em 6 dos 8 cartões de comparação de preços para 아이폰 17. O preço exibido estava em discountedSalePrice. |
Busca da Plus Store (/ns/search) |
Blocos de React Server Component enviados com self.__next_f.push, sob a chave initPagedCompositeCards |
As aspas do JSON eram escapadas dentro do HTML, então junte e decodifique os blocos antes de pesquisá-los. |
Busca de comparação de preços (/search/all) |
__NEXT_DATA__, em props.pageProps.compositeList.list[].item |
price era uma string, enquanto lowPrice era um inteiro, então converta price para número antes de usá-lo. |
| Produto SmartStore | window.__PRELOADED_STATE__, em simpleProductForDetailPage |
O objeto não era JSON estrito, e a chave product de nível superior continha zeros. |
Quando um parser começar a não retornar nada, verifique esses caminhos primeiro.
Analise o JSON mesmo quando a página renderizada parecer mais fácil de ler. A página do Naver limitava a contagem de avaliações exibida de uma listagem da Apple em “9.999+”. O JSON embutido para a mesma listagem continha a contagem exata, 13.971.
O estado do SmartStore precisou de 3 verificações extras. Em uma página de produto, o estado era um literal de objeto JavaScript com 34 valores undefined soltos, então json.loads gerava um erro. O id do produto correspondia ao número na URL, mas o productNo interno era um número diferente, então use id como o ID do produto. A página também tinha 2 contagens de avaliações, uma para o produto e uma maior para seu grupo de produtos.
A função abaixo normaliza o objeto e separa listagens ativas das inativas:
import json
import re

MARKER = "window.__PRELOADED_STATE__="


def smartstore_product(html: str) -> dict | None:
    start = html.index(MARKER) + len(MARKER)
    # O estado é um literal de objeto JavaScript, e valores undefined soltos quebram o json
    text = re.sub(r"(?<=[:\[,])undefined(?=[,\]}])", "null", html[start:])
    state, _ = json.JSONDecoder().raw_decode(text)
    product = state["simpleProductForDetailPage"]
    # None para uma listagem excluída, um id vazio para uma atrás de uma verificação de autorização
    return product if product and product.get("id") else None
A URL de um produto excluído ainda retornava uma página normal, intitulada “상품이 존재하지 않습니다” (“o produto não existe”). Portanto, uma verificação de código de status tratava essa página como uma listagem ativa. A função retorna None para essa página e para listagens atrás de uma verificação de autorização. Trate um resultado None como o sinal para remover a URL da sua lista de monitoramento.
Configure a Bright Data para o Naver
Quatro scripts chamam as APIs REST da Bright Data com requests, e o script de paginação controla um navegador em nuvem com Playwright. Você precisa de:
- Uma conta Bright Data e uma chave de API das configurações da conta.
- Uma zona de SERP API, uma zona de Web Unlocker e uma zona de Browser API. Uma zona é a configuração de um produto no painel de controle, e os scripts usam seu nome. A Naver Shopping Scraper API precisa apenas da chave de API.
- Python 3.10 ou mais recente com
requestseplaywright. O script de paginação conecta o Playwright a um navegador remoto, então você não precisa baixar um local.
Por segurança, uma zona pode aceitar solicitações apenas dos endereços na sua IP Allowlist. Se as solicitações para sua zona retornarem ip_forbidden, adicione o IP da sua máquina a essa lista.
Instale os pacotes e exporte suas credenciais:
pip install requests playwright
export BRIGHTDATA_API_KEY="your_api_key"
export BRIGHTDATA_SERP_ZONE="your_serp_zone"
export BRIGHTDATA_UNLOCKER_ZONE="your_unlocker_zone"
export BRIGHTDATA_BROWSER_WSS="wss://brd-customer-<id>-zone-<zone>-country-kr:<password>@brd.superproxy.io:9222"
O valor de BRIGHTDATA_BROWSER_WSS é a URL do WebSocket mostrada em Puppeteer / Playwright nos Access details da sua zona:
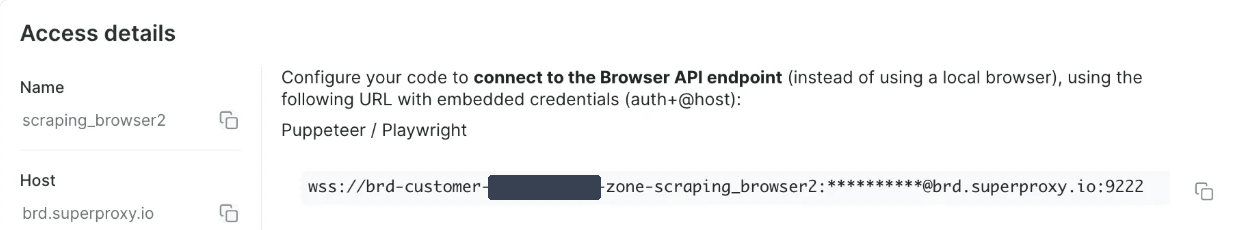
A URL já embute o nome de usuário e a senha da zona.
Adicione -country-kr após o nome da zona para rotear solicitações através de IPs coreanos. Se preferir um SDK em vez de HTTP puro, instale o Bright Data Python SDK, brightdata-sdk.
Para verificar uma única URL antes de escrever código, use a CLI da Bright Data, que busca a URL através do Web Unlocker:
bdata scrape "https://smartstore.naver.com/acnope/products/10444371682" --country kr -f html -o product.htmlO comando salvou a página completa do produto SmartStore, então smartstore_product(open("product.html", encoding="utf-8").read()) retorna os dados do produto.
Faça scraping de resultados de shopping da busca do Naver com a SERP API
Para 아이폰 17 (iPhone 17), a página de resultados desktop do Naver mostrou 2 blocos de shopping, um com cartões de comparação de preços e outro com produtos da Naver Plus Store:
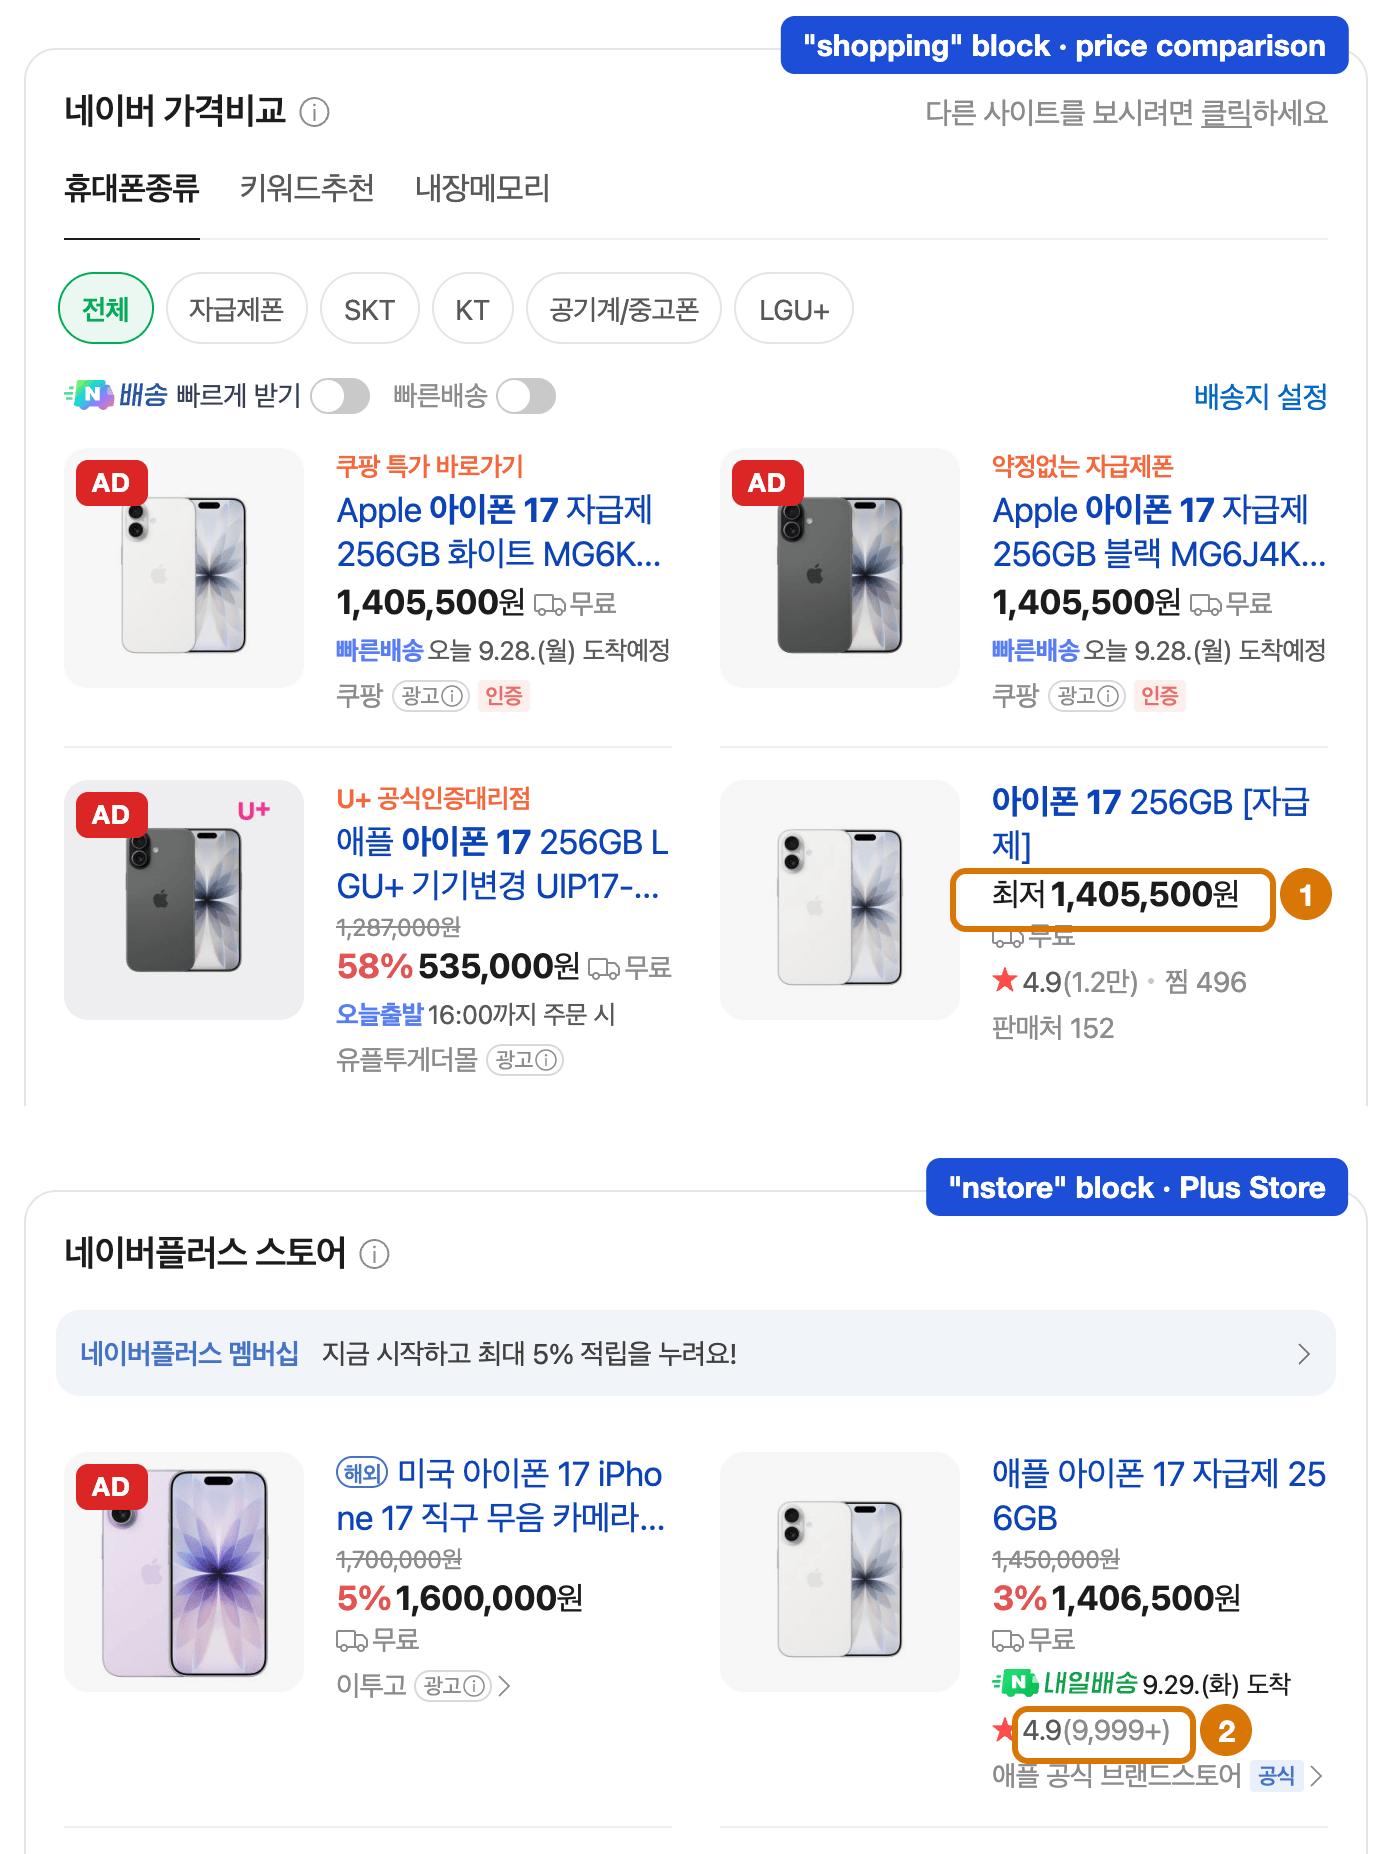
Tags vermelhas marcam os cartões que o Naver rotulou como 광고 (anúncio), que o parser sinaliza como is_ad. No marcador 1, o cartão mostrava 1.405.500원, enquanto seu campo salePrice era 0. No marcador 2, a contagem de avaliações mostrava 9.999+, enquanto o JSON continha 13.971.
Use a API SERP para páginas de resultados de mecanismos de busca (SERPs), incluindo o Naver, e o Web Unlocker para outros sites. A API SERP cobra por solicitação bem-sucedida.
O Naver geolocalizou as solicitações da API SERP para a Coreia. Seu JSON embutido registrou KR para essas solicitações, e registrou IN com uma cidade indiana para solicitações diretas da Índia.
Para o Naver, defina o formato de dados da zona para Raw HTML, ou passe "data_format": "html" em cada solicitação:
Raw HTML retornou a página de resultados completa, incluindo o JSON de shopping embutido do Naver.
O script abaixo busca uma página de resultados e retorna todos os cartões de ambos os blocos de shopping, com anúncios sinalizados:
import json
import os
import re
from urllib.parse import quote

import requests

API_URL = "https://api.brightdata.com/request"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
SERP_ZONE = os.environ["BRIGHTDATA_SERP_ZONE"]

# Cada bloco de shopping na página de resultados atribui seus dados a uma global JS
STATE = re.compile(r'naver\.search\.ext\.newshopping\["(\w+)"\]\._INITIAL_STATE\s*=\s*')


def fetch_naver_serp(query: str) -> str:
    url = f"https://search.naver.com/search.naver?where=nexearch&query={quote(query)}"
    resp = requests.post(
        API_URL,
        headers=HEADERS,
        # Solicitar a página bruta, que contém o JSON de shopping embutido do Naver
        json={"zone": SERP_ZONE, "url": url, "format": "raw", "data_format": "html"},
        timeout=120,
    )
    resp.raise_for_status()
    if resp.headers.get("x-brd-error") or "_INITIAL_STATE" not in resp.text:
        raise RuntimeError(f"Sem estado de shopping para {query!r}: {resp.headers.get('x-brd-error')}")
    return resp.text


def parse_shopping_blocks(html: str) -> list[dict]:
    decoder = json.JSONDecoder()
    rows = []
    for match in STATE.finditer(html):
        block = match.group(1)  # "shopping" = comparação de preços, "nstore" = Plus Store
        state, _ = decoder.raw_decode(html, match.end())
        props = state["initProps"]
        if block == "shopping":
            items = [slot["data"] for page in props["pagedSlot"] for slot in page["slots"]]
        else:
            items = props["products"]
        for position, item in enumerate(items, start=1):
            rows.append({
                "block": block,
                "position": position,
                "is_ad": item.get("sourceType") == "AD",
                "name": re.sub(r"<[^>]+>", "", item.get("productName", "")),
                # discountedSalePrice contém o preço exibido, e salePrice pode ser 0
                "price": item.get("discountedSalePrice") or item.get("salePrice"),
                "mall": item.get("mallName") or None,
                "reviews": item.get("totalReviewCount"),
                "nv_mid": item.get("nvMid"),
                "channel_product_id": item.get("channelProductId"),
            })
    return rows


if __name__ == "__main__":
    for row in parse_shopping_blocks(fetch_naver_serp("아이폰 17")):
        label = "ad" if row["is_ad"] else "  "
        print(f'{row["block"]:<8} {row["position"]} {label} {row["price"]:>9,} KRW  '
              f'{row["mall"] or "(catalog)":<12} {row["name"][:24]}')
Para 아이폰 17, o script imprimiu 8 cartões de comparação de preços e 4 produtos da Plus Store:
shopping 1 ad 1,405,500 KRW  쿠팡           Apple 아이폰 17 자급제 256GB 화
shopping 2 ad 1,405,500 KRW  쿠팡           Apple 아이폰 17 자급제 256GB 블
shopping 3 ad   535,000 KRW  유플투게더몰       애플 아이폰 17 256GB LGU+ 기기변
shopping 4    1,405,500 KRW  (catalog)    아이폰 17 256GB [자급제]
shopping 5    1,713,000 KRW  (catalog)    아이폰 17 프로 256GB [자급제]
shopping 6    2,006,400 KRW  (catalog)    아이폰 17 프로 512GB [자급제]
shopping 7       29,600 KRW  로트박스         [대여] 애플 아이폰 17 프로 대여 렌탈
shopping 8    2,294,400 KRW  (catalog)    아이폰 17 프로 1TB [자급제]
nstore   1 ad 1,600,000 KRW  이투고          미국 아이폰 17 iPhone 17 직구 무
nstore   2    1,406,500 KRW  애플 공식 브랜드스토어 애플 아이폰 17 자급제
nstore   3    1,790,000 KRW  애플 공식 브랜드스토어 애플 아이폰 17 프로 자급제
nstore   4    1,697,500 KRW  애플 공식 브랜드스토어 애플 아이폰 17 자급제
Os primeiros 3 cartões eram anúncios, e o terceiro mostrava um preço que exigia um contrato com operadora, não o preço do aparelho desbloqueado. Os cartões de produto de catálogo não tinham valor de mall e um channel_product_id vazio, porque apontavam para as páginas de comparação de preços do Naver em vez de uma única loja. Em 10 consultas, a API SERP retornou uma página com o JSON de shopping 10 de 10 vezes.
Entre 2 execuções no mesmo dia, 2 posições da Plus Store trocaram de lugar. Armazene um timestamp e o sinalizador de anúncio com cada linha, e amostre uma palavra-chave mais de uma vez antes que seu rastreamento de ranking reporte uma mudança.
Faça scraping dos resultados de busca da Naver Plus Store com o Web Unlocker
O Naver lançou a Plus Store, uma plataforma de shopping, em 2024. Em sua página de busca, clientes HTTP simples obtiveram a página de bloqueio 418, o CAPTCHA 405 ou o redirecionamento de login.
O Web Unlocker, o desbloqueador web automatizado da Bright Data, busca uma URL e cobra por solicitação bem-sucedida. Com IPs coreanos, ele retornou a página de busca com seus primeiros 50 cartões embutidos. Em 10 consultas, o Web Unlocker retornou uma página da Plus Store contendo os dados de resultado 10 de 10 vezes.
A função de busca abaixo solicita IPs coreanos, confirma que a resposta contém os dados de resultado, e tenta novamente com backoff:
import json
import os
import re
import time
from collections import Counter
from urllib.parse import quote

import requests

API_URL = "https://api.brightdata.com/request"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
UNLOCKER_ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]

FLIGHT = re.compile(r"self\.__next_f\.push\((\[.*?\])\)</script>", re.S)
KEY = '"initPagedCompositeCards":'
MARKER = "initPagedCompositeCards"  # as aspas são escapadas dentro do HTML bruto


def fetch_plus_store_search(query: str, attempts: int = 3) -> str:
    url = f"https://search.shopping.naver.com/ns/search?query={quote(query)}"
    for attempt in range(1, attempts + 1):
        resp = requests.post(
            API_URL,
            headers=HEADERS,
            json={"zone": UNLOCKER_ZONE, "url": url, "format": "raw", "country": "kr"},
            timeout=180,
        )
        # O Naver pode redirecionar para uma página de login, então verifique os dados, não o status
        if resp.ok and MARKER in resp.text:
            return resp.text
        reason = resp.headers.get("x-brd-error") or ("login wall" if "nidlogin" in resp.text else "no data")
        print(f"tentativa {attempt} falhou: {reason}")
        time.sleep(5 * attempt)
    raise RuntimeError(f"Busca da Plus Store falhou para {query!r}")


def parse_search(html: str) -> dict:
    # A página transmite dados do React Server Component em blocos de string
    chunks = [json.loads(m.group(1)) for m in FLIGHT.finditer(html)]
    flight = "".join(c[1] for c in chunks if len(c) == 2 and isinstance(c[1], str))
    start = flight.index(KEY) + len(KEY)
    result, _ = json.JSONDecoder().raw_decode(flight, start)
    products = []
    for card in result["data"]:
        item = card.get("card", {}).get("product")
        if not item:
            continue  # banners e slots de promoção não têm produto
        products.append({
            "rank": len(products) + 1,
            "type": item.get("cardType") or "ORGANIC",
            "name": item.get("productName"),
            "price": item.get("discountedSalePrice"),
            "list_price": item.get("salePrice"),
            "mall": item.get("mallName"),
            "reviews": item.get("totalReviewCount"),
            "url": (item.get("productUrl") or {}).get("pcUrl"),
        })
    return {"total": result["total"], "next_cursor": result["cursor"], "products": products}


if __name__ == "__main__":
    page = parse_search(fetch_plus_store_search("코카콜라 제로"))
    mix = Counter(p["type"] for p in page["products"])
    print("total de resultados:", page["total"], "| próximo cursor:", page["next_cursor"], "| mix da página 1:", dict(mix))
    for p in page["products"][:3] + [p for p in page["products"] if p["type"] == "ORGANIC"][:2]:
        print(json.dumps(p, ensure_ascii=False))
Para 코카콜라 제로 (Coke Zero), a página 1 tinha 47 produtos entre seus 50 cartões, e a primeira listagem orgânica estava na posição 7:
total results: 7746 | next cursor: 33 | page 1 mix: {'AD': 12, 'SUPER_POINT': 2, 'ORGANIC': 31, 'SME_SLOT': 2}
{"rank": 1, "type": "AD", "name": "코카-콜라 제로 CAN 350ml 24개", "price": 21600, "list_price": 35290, "mall": "코카콜라직영몰", "reviews": 96956, "url": "https://smartstore.naver.com/main/products/4660954096"}
{"rank": 2, "type": "AD", "name": "코카-콜라 제로 CAN 190ml 30개", "price": 18000, "list_price": 24790, "mall": "코카콜라직영몰", "reviews": 46451, "url": "https://smartstore.naver.com/main/products/4609271837"}
{"rank": 3, "type": "AD", "name": "코카-콜라 제로 레몬라임 CAN 350ml 48개(2x24입) + 코크 큐브 블럭캘린더 (옵션선택)", "price": 38720, "list_price": 70580, "mall": "코카콜라직영몰", "reviews": 440, "url": "https://smartstore.naver.com/main/products/13689352448"}
{"rank": 7, "type": "ORGANIC", "name": "코카-콜라 제로 라벨프리 PET 370ml 24개", "price": 22880, "list_price": 35300, "mall": "코카콜라직영몰", "reviews": 25197, "url": "https://smartstore.naver.com/main/products/6006925665"}
{"rank": 8, "type": "ORGANIC", "name": "코카-콜라 제로 제로 라벨프리 PET 370ml 18개", "price": 16720, "list_price": 20900, "mall": "코카콜라직영몰", "reviews": 3676, "url": "https://smartstore.naver.com/main/products/11574172085"}
Na própria página, nenhuma das primeiras 6 posições era uma listagem orgânica:
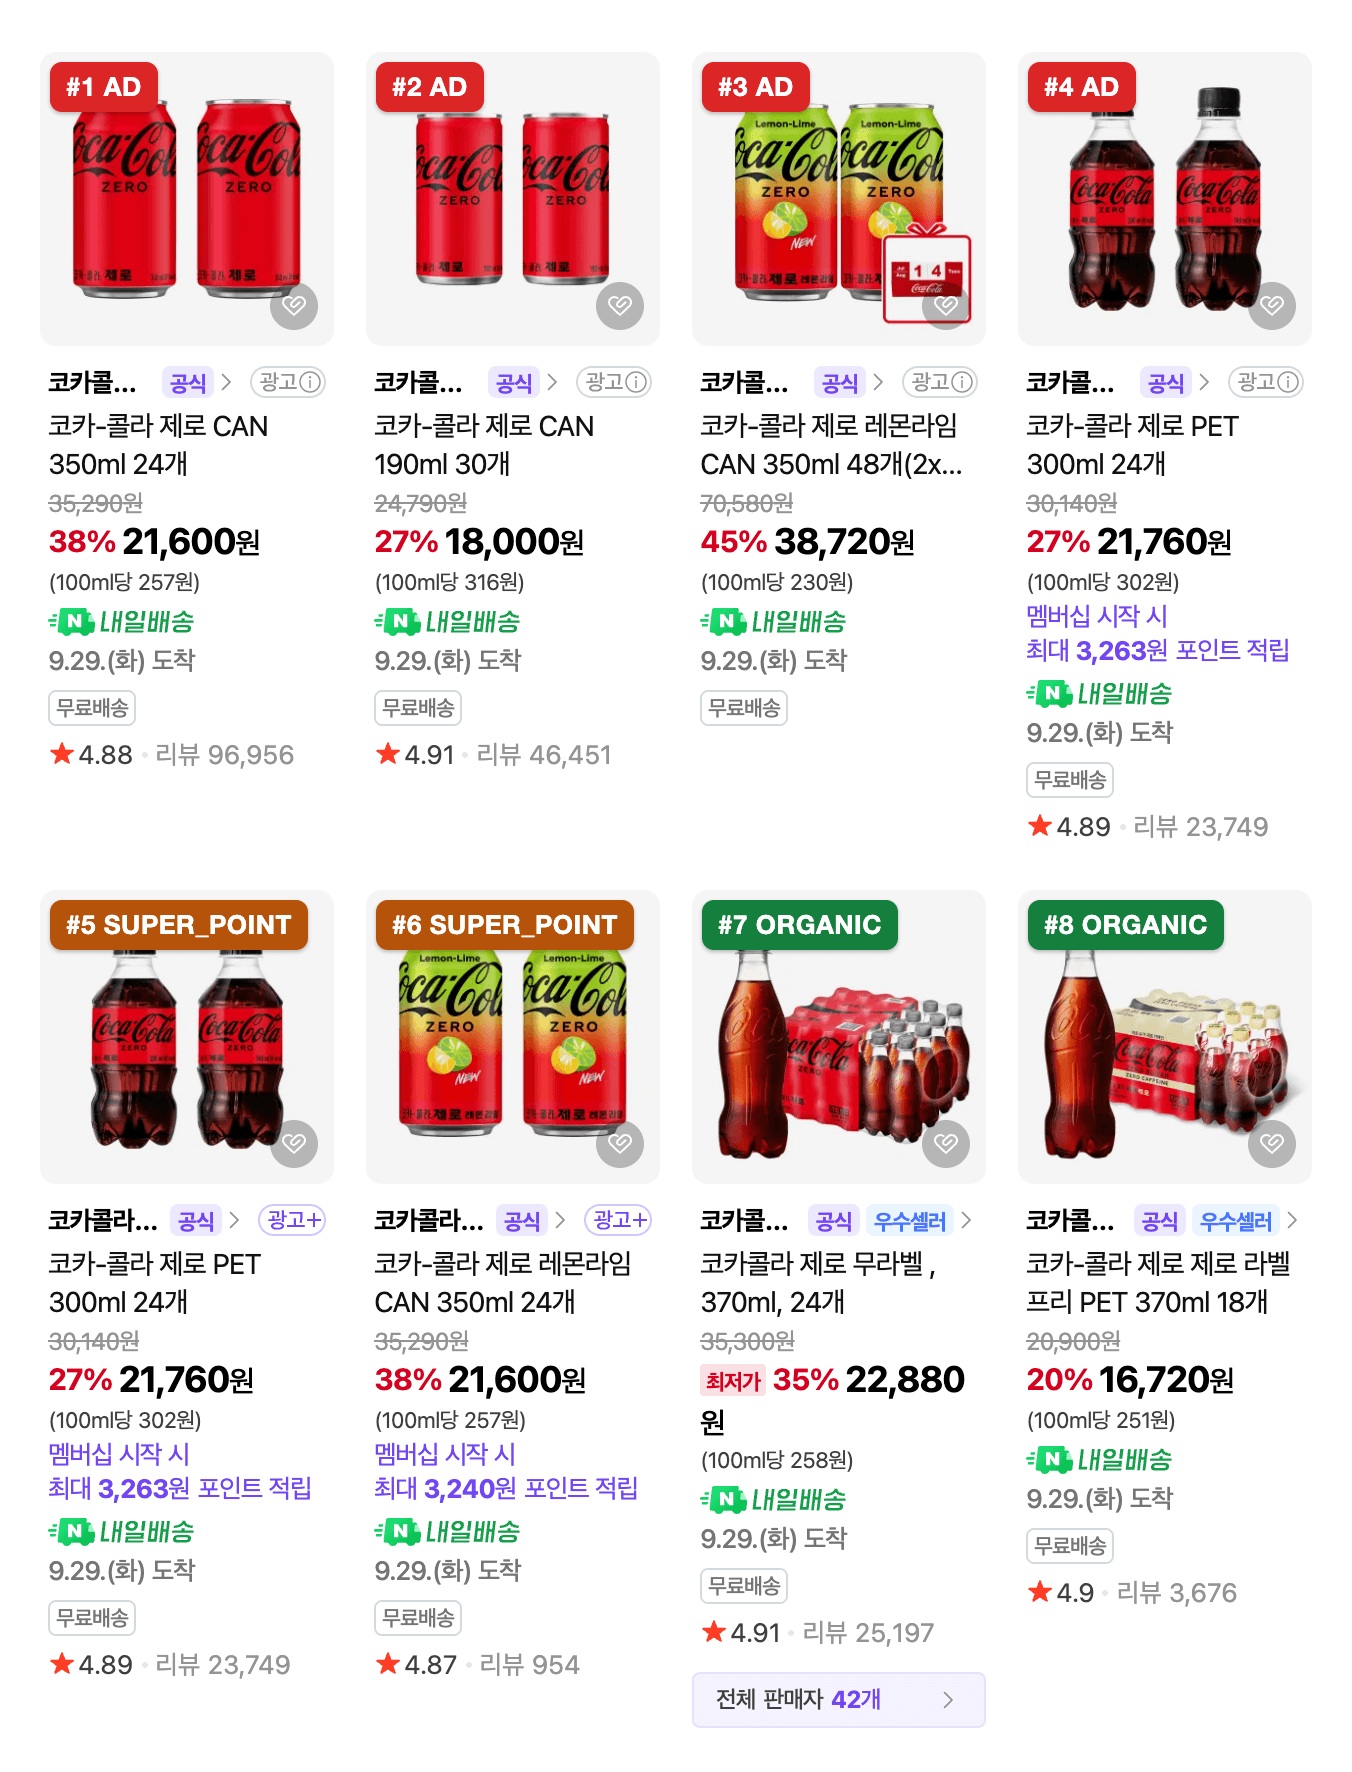
O Naver marcou as posições 1 a 6 com rótulos 광고 (anúncio), e o parser definiu seu type como AD ou SUPER_POINT.
Mantenha type em cada linha, para que um relatório de share-of-shelf separe anúncios e promoções de listagens orgânicas. Use o número do produto na URL de cada listagem como o ID do produto. Nomes são IDs não confiáveis, porque nessa página, todos os 8 cartões vinculados a um catálogo do Naver exibiam catalogName, não o productName armazenado.
Pagine os resultados de busca da Plus Store com a Browser API
A página 1 dos resultados da Plus Store estava embutida no HTML, e o site carregava as páginas 2 e seguintes com scroll infinito. Essa é a diferença entre Web Unlocker e Browser API: o Web Unlocker retorna uma página, e a Browser API pode rolá-la. Quando um comprador rolava, a página solicitava /ns/v1/search/paged-composite-cards com um cursor, e cada solicitação carregava um cabeçalho x-wtm-ncaptcha-token. A página gerava um novo token para cada chamada:
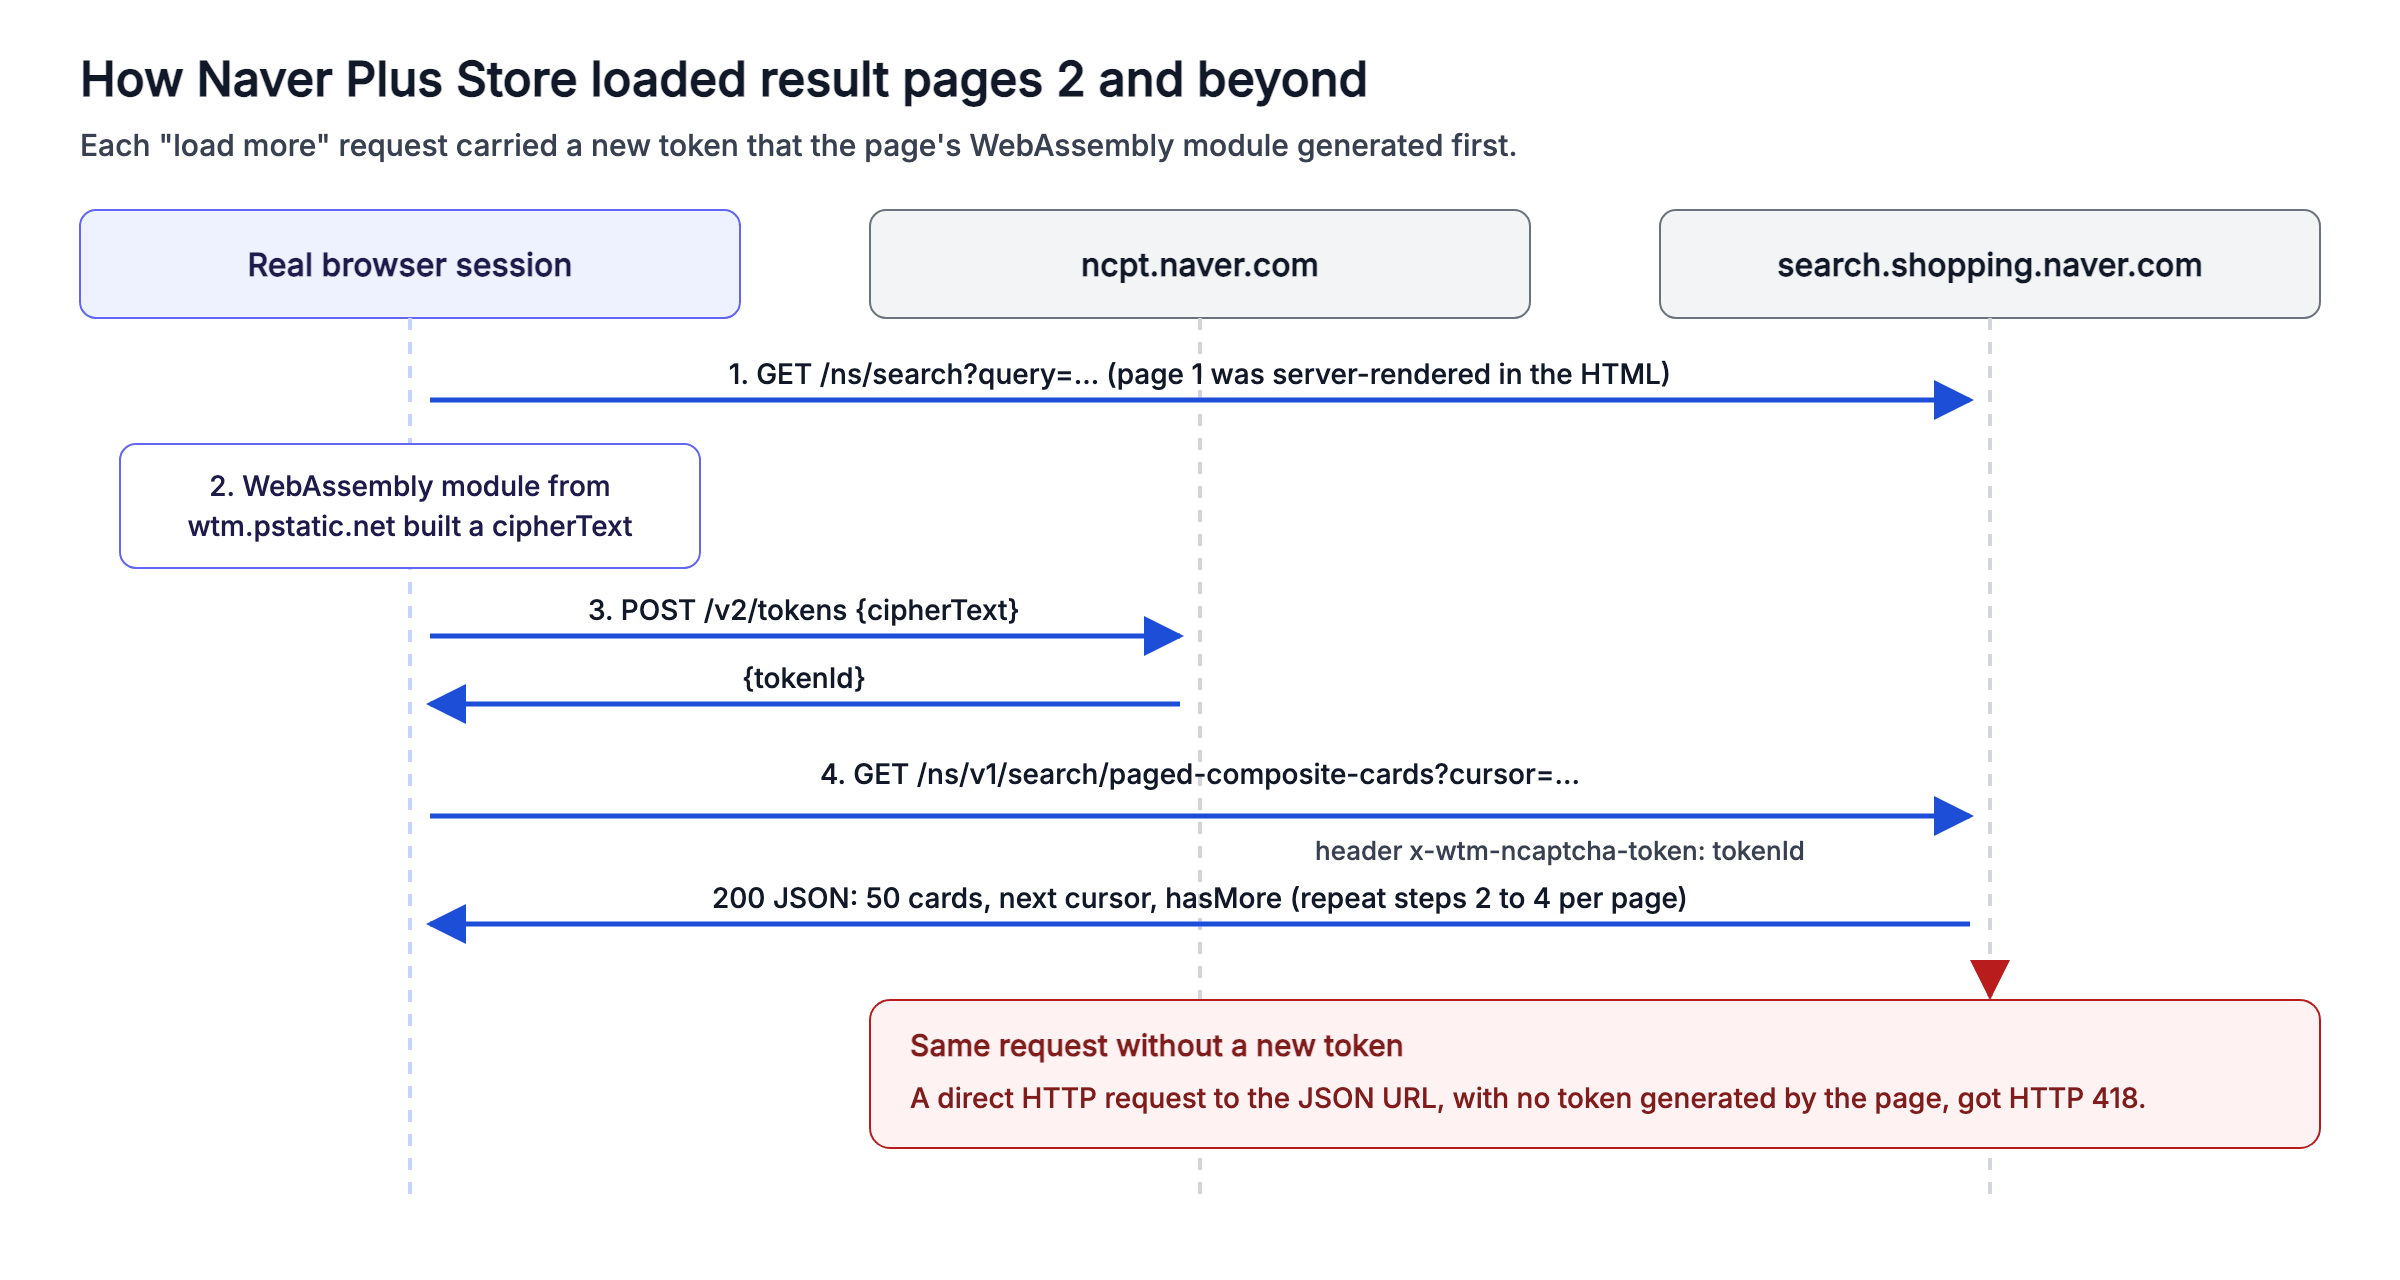
Uma solicitação direta ao endpoint sem um novo token recebeu HTTP 418. Executar a página em um navegador real permitiu que seus próprios scripts gerassem cada token.
A Browser API executa o Chrome na nuvem da Bright Data e cobra por largura de banda. Nesse navegador, o próprio WebAssembly da página gerava cada token, e o código só precisava ler as respostas JSON. O script abaixo se conecta via Chrome DevTools Protocol (CDP), rola em etapas irregulares com pausas, e captura cada página de resultados:
import asyncio
import os
import random
import time
from urllib.parse import quote

from playwright.async_api import async_playwright

# wss://brd-customer-<id>-zone-<zone>-country-kr:<password>@brd.superproxy.io:9222
BROWSER_WSS = os.environ["BRIGHTDATA_BROWSER_WSS"]
PAGED_API = "/ns/v1/search/paged-composite-cards"


async def plus_store_pages(query: str, extra_pages: int = 5, budget_s: int = 120) -> list[dict]:
    """Retorna as páginas de resultados 2..N como JSON. A página gera o token de cada solicitação sozinha."""
    pages = []
    async with async_playwright() as p:
        browser = await p.chromium.connect_over_cdp(BROWSER_WSS)
        page = await browser.new_page()

        async def on_response(response):
            # A página busca cada novo conjunto de cartões como JSON enquanto rola
            if PAGED_API in response.url and response.ok:
                pages.append((await response.json())["data"])

        page.on("response", on_response)
        first = await page.goto(f"https://search.shopping.naver.com/ns/search?query={quote(query)}",
                                wait_until="domcontentloaded", timeout=120_000)
        if first.status != 200:
            raise RuntimeError(f"página de destino retornou {first.status}")
        deadline = time.time() + budget_s
        while len(pages) < extra_pages and time.time() < deadline:
            if pages and not pages[-1]["hasMore"]:
                break
            # Rolar em etapas irregulares com pausas
            await page.mouse.wheel(0, random.randint(900, 1500))
            await page.wait_for_timeout(random.randint(2500, 4500))
        await browser.close()
    return pages


if __name__ == "__main__":
    result = asyncio.run(plus_store_pages("캠핑의자"))
    for data in result:
        products = [c["card"]["product"] for c in data["data"] if c.get("card", {}).get("product")]
        print(f"página {data['data'][0]['page']}: {len(products)} produtos, próximo cursor {data['cursor']}")
Para 캠핑의자 (cadeira de camping), a sessão coletou as páginas 2 a 6:
page 2: 50 products, next cursor 74
page 3: 50 products, next cursor 112
page 4: 50 products, next cursor 151
page 5: 50 products, next cursor 189
page 6: 50 products, next cursor 239
Em mais 3 sessões com esse padrão de rolagem, cada uma coletou todas as 5 páginas extras. Mantenha as etapas irregulares e as pausas ao adaptar o script, para que suas sessões correspondam ao padrão testado.
Reconstrua os campos da API Shopping a partir da busca de comparação de preços
Das páginas que testamos, a busca de comparação de preços do Naver, em /search/all, foi a mais semelhante à API aposentada. Seu __NEXT_DATA__ continha 12 dos 14 campos que a API de busca do Shopping retornava, então um feed quebrado pode manter a maior parte de seu esquema:
| Campo da API de busca Shopping | Campo da busca de comparação de preços |
|---|---|
productId |
id |
title |
productTitle |
link |
mallProductUrl para produtos de loja única, ou crUrl, o link de rastreamento do Naver, para produtos de catálogo |
image |
imageUrl |
lprice |
lowPrice, o preço mais baixo entre lojas para um produto de catálogo |
hprice |
Deixe sem mapear: highPrice estava vazio ou “0” em todos os resultados verificados |
mallName |
mallName, vazio para produtos de catálogo porque muitas lojas os vendem |
productType |
Parcialmente de mallCount: acima de 0 marcava um produto de catálogo |
brand e maker |
brand e maker |
category1 a category4 |
category1Name a category4Name |
O Web Unlocker retornou essa página com sua lista de resultados para 10 de 10 consultas de teste. O script abaixo busca a página através do Web Unlocker, tenta até 3 vezes, e renomeia os campos de cada resultado para os nomes da API:
import json
import os
import re
import time
from urllib.parse import quote

import requests

API_URL = "https://api.brightdata.com/request"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
UNLOCKER_ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]
NEXT_DATA = re.compile(r'<script id="__NEXT_DATA__" type="application/json">(.*?)</script>', re.S)


def fetch_price_comparison(query: str, attempts: int = 3) -> str:
    url = f"https://search.shopping.naver.com/search/all?query={quote(query)}"
    for attempt in range(1, attempts + 1):
        resp = requests.post(
            API_URL,
            headers=HEADERS,
            json={"zone": UNLOCKER_ZONE, "url": url, "format": "raw", "country": "kr"},
            timeout=180,
        )
        # Uma página de login também retorna 200, então verifique a lista de resultados
        if resp.ok and "compositeList" in resp.text:
            return resp.text
        print(f"tentativa {attempt} falhou: {resp.headers.get('x-brd-error') or 'sem lista de resultados'}")
        time.sleep(5 * attempt)
    raise RuntimeError(f"Busca de comparação de preços falhou para {query!r}")


def as_api_items(html: str) -> list[dict]:
    """Renomeia os campos de cada resultado para os que a API de busca Shopping retornava."""
    data = json.loads(NEXT_DATA.search(html).group(1))
    rows = []
    for entry in data["props"]["pageProps"]["compositeList"]["list"]:
        item = entry["item"]
        rows.append({
            "productId": item.get("id"),
            "title": item.get("productTitle"),
            "link": item.get("mallProductUrl") or item.get("crUrl"),  # produtos de catálogo não têm URL de loja
            "lprice": item.get("lowPrice"),  # o preço mais baixo entre lojas para um produto de catálogo
            "mallName": item.get("mallName") or None,
            "mallCount": item.get("mallCount"),  # acima de 0 marca um produto de catálogo de comparação de preços
            "brand": item.get("brand"),
            "maker": item.get("maker"),
            **{f"category{i}": item.get(f"category{i}Name") for i in range(1, 5)},
            # adId marca um anúncio, e tipos de entrada diferentes de "product" são slots promovidos
            "is_ad": bool(item.get("adId")) or entry["type"] != "product",
        })
    return rows


if __name__ == "__main__":
    rows = as_api_items(fetch_price_comparison("코카콜라 제로"))
    first = next(i for i, row in enumerate(rows) if not row["is_ad"])
    print(f"{len(rows)} resultados, {sum(r['is_ad'] for r in rows)} anúncios ou slots promovidos, primeiro orgânico na posição {first + 1}")
    print(json.dumps({k: v for k, v in rows[first].items() if k != "link"}, ensure_ascii=False))
Para 코카콜라 제로, os primeiros 8 resultados eram anúncios ou slots promovidos, e o primeiro resultado orgânico era um produto de catálogo:
56 results, 16 ads or promoted slots, first organic at rank 9
{"productId": "54166199731", "title": "코카콜라 콜라 , 190ml, 30개", "lprice": 13400, "mallName": null, "mallCount": 8702, "brand": "코카콜라", "maker": "코카콜라", "category1": "식품", "category2": "음료", "category3": "청량/탄산음료", "category4": "콜라", "is_ad": false}
O JSON da página também marca anúncios, um sinal que a API aposentada não retornava, então filtre por is_ad antes de comparar rankings antigos e novos.
Obtenha registros de produtos do SmartStore com a Naver Shopping Scraper API
Para detalhes de produtos, solicite registros estruturados em vez de HTML. A Naver Shopping Scraper API, parte do Web Scraper API da Bright Data, executa um scraper de SmartStore em cada URL que você envia. No painel de controle, seu endpoint Collect by URL recebe uma lista de URLs de produtos:
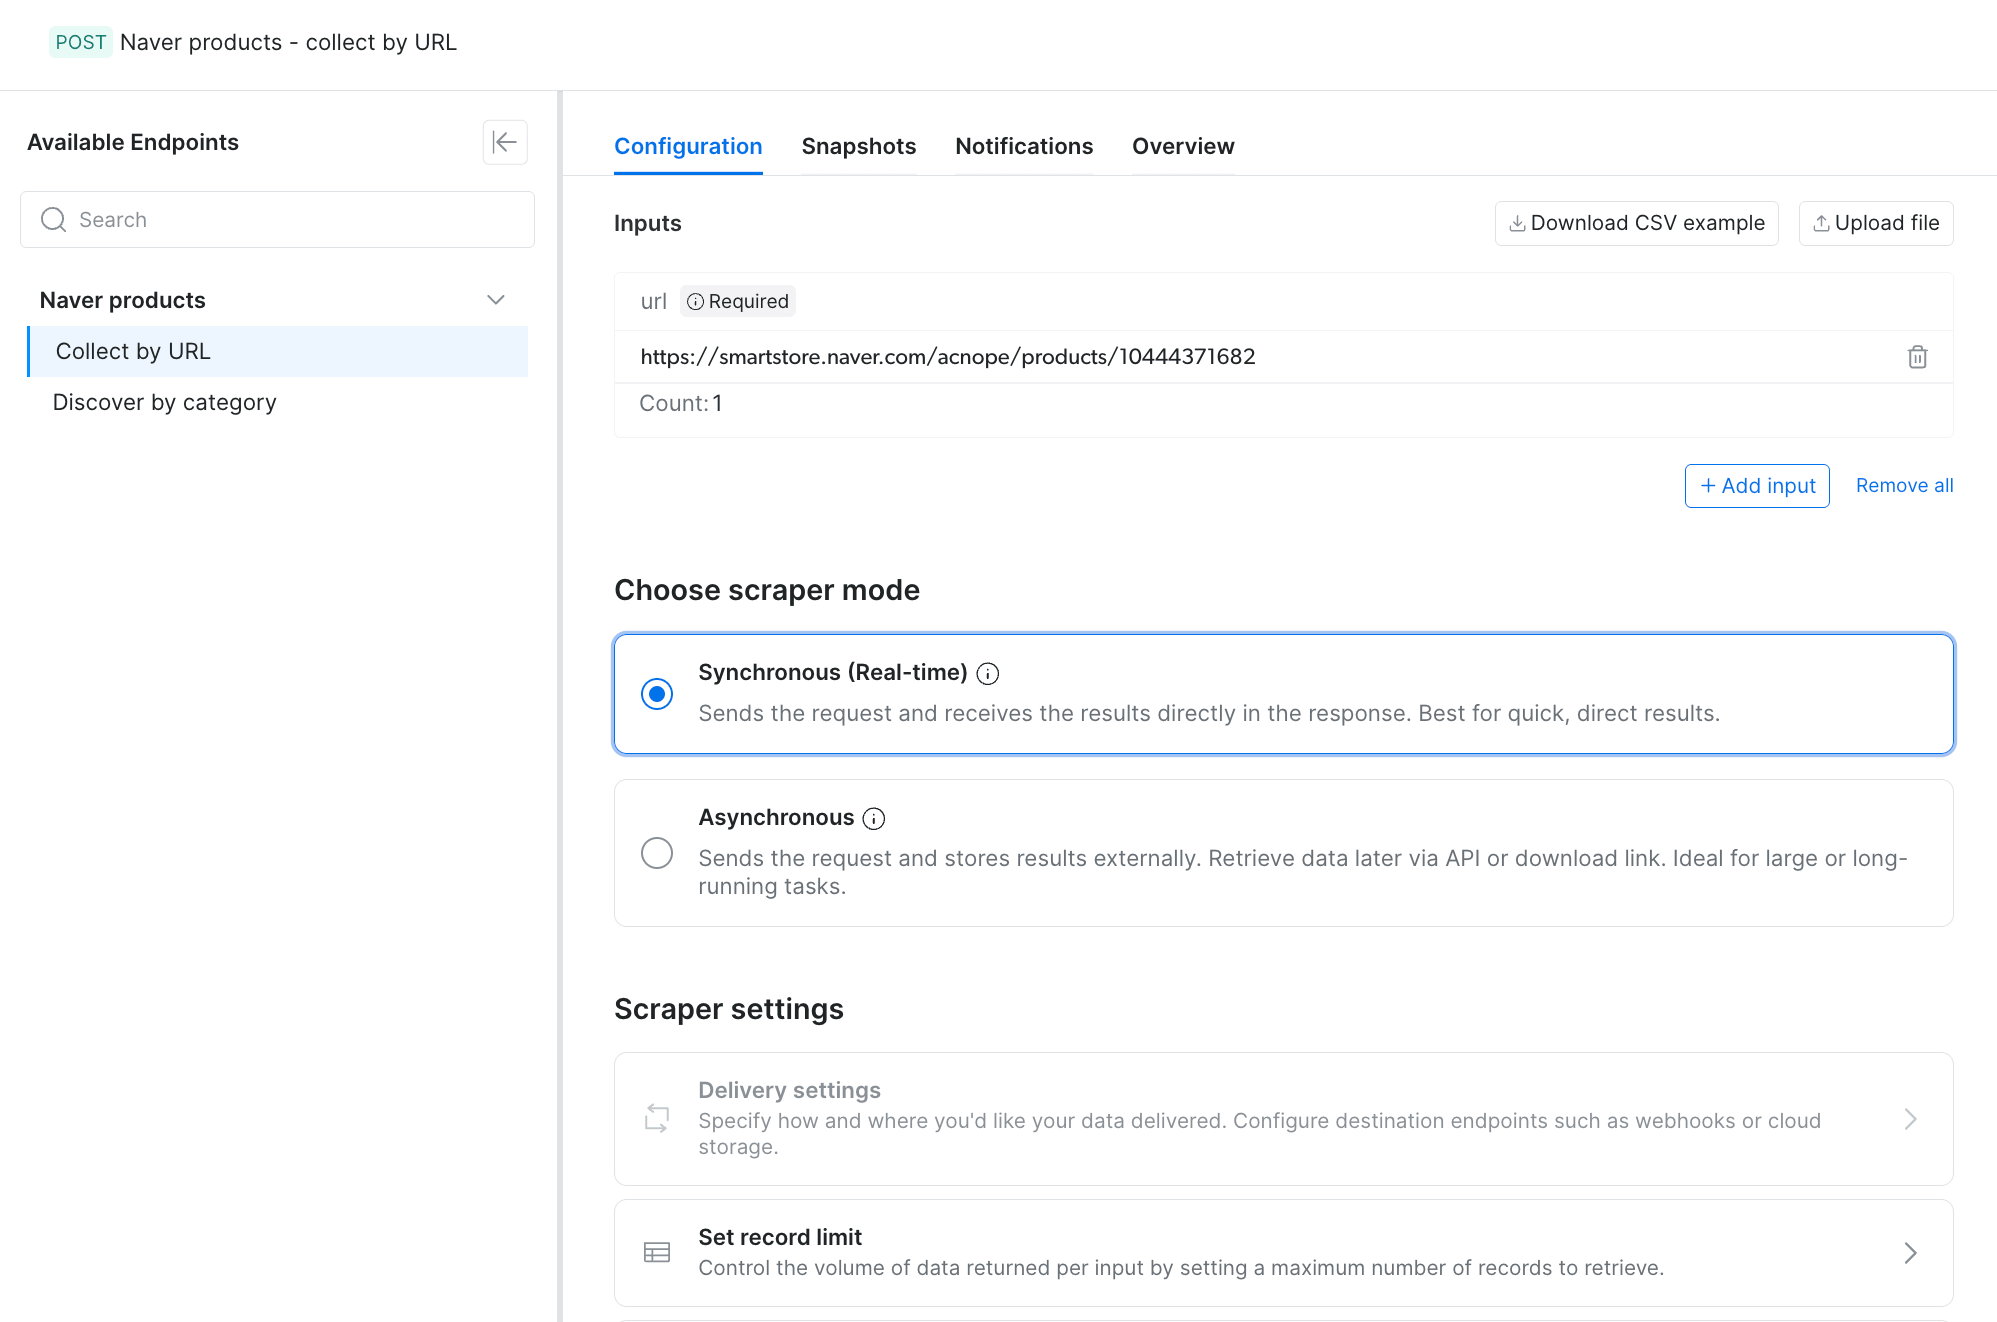
O mesmo endpoint está disponível através da API REST, com o ID do dataset gd_m9qqjxxr1hab7okefj.
O script depende de 3 detalhes da API. Se um job demorar mais do que o limite de timeout síncrono, o endpoint /scrape retorna HTTP 202 com um ID de snapshot que você consulta. Use /scrape para lotes pequenos, e envie jobs maiores para o endpoint assíncrono /trigger, cuja documentação informa o limite atual de tamanho de lote. E custom_output_fields retorna apenas os campos que você listar, então adicione input, error e error_code para ver por que uma URL não retornou produto.
O script abaixo envia um lote, alterna para consulta de snapshot quando necessário, e valida cada registro:
import json
import os
import sys
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
NAVER_PRODUCTS = "gd_m9qqjxxr1hab7okefj"
# custom_output_fields retorna apenas o que você listar, então inclua input e os campos de erro
FIELDS = ("input|error|error_code|url|product_id|title|original_price|final_price"
          "|discount_rate|total_reviews|sold_out|breadcrumbs|timestamp")


def collect_products(urls: list[str]) -> list[dict]:
    params = {"dataset_id": NAVER_PRODUCTS, "format": "json",  # um array JSON em vez do NDJSON padrão
              "include_errors": "true", "custom_output_fields": FIELDS}
    body = {"input": [{"url": u} for u in urls]}
    resp = requests.post(f"{API}/scrape", params=params, json=body, headers=HEADERS, timeout=180)
    if resp.status_code == 202:  # o job demorou mais do que o limite de timeout síncrono
        snapshot_id = resp.json()["snapshot_id"]
        while True:
            status = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS, timeout=60).json()["status"]
            if status == "ready":
                break
            if status == "failed":
                raise RuntimeError(f"snapshot {snapshot_id} falhou")
            time.sleep(10)
        while True:  # o endpoint de snapshot retorna 202 até que o arquivo seja construído
            resp = requests.get(f"{API}/snapshot/{snapshot_id}", params={"format": "json"},
                                headers=HEADERS, timeout=120)
            if resp.status_code != 202:
                break
            time.sleep(10)
    resp.raise_for_status()
    records = resp.json()
    # Mantenha uma forma de lista mesmo se a API retornar um único objeto
    return records if isinstance(records, list) else [records]


def validate(record: dict) -> dict:
    if record.get("error_code"):
        # dead_page significa que a listagem sumiu: remova-a da lista de monitoramento, não tente novamente
        return {"url": record["input"]["url"], "ok": False, "reason": record["error_code"]}
    list_price = int(record["original_price"]) if record.get("original_price") else None  # int() também aceita a forma string
    price = record.get("final_price")
    ok = isinstance(price, int) and price > 0 and (list_price is None or price <= list_price)
    return {"product_id": record.get("product_id"), "ok": ok, "price": price, "list_price": list_price,
            "reviews": record.get("total_reviews"), "title": (record.get("title") or "")[:40]}


if __name__ == "__main__":
    urls = json.load(open(sys.argv[1])) if len(sys.argv) > 1 else [
        "https://smartstore.naver.com/acnope/products/10444371682"]
    records = collect_products(urls)
    print(f"{len(records)} registros")
    for row in map(validate, records):
        print(json.dumps(row, ensure_ascii=False))
Um lote de 10 URLs do SmartStore retornou registros para todas as 7 listagens públicas e sinalizou as outras 3 com códigos de erro:
10 records
{"url": "https://smartstore.naver.com/bestymall/products/9824862314", "ok": false, "reason": "dead_page"}
{"url": "https://smartstore.naver.com/wonliveshopm/products/12177447319", "ok": false, "reason": "dead_page"}
{"url": "https://smartstore.naver.com/dajunemall/products/12725077707", "ok": false, "reason": "wait_element_timeout"}
{"product_id": "11219337734", "ok": true, "price": 16890, "list_price": null, "reviews": null, "title": "TROLLI 트롤리 올인원 젤리 1kg  사우어 구미캔디"}
{"product_id": "11499596414", "ok": true, "price": 615340, "list_price": null, "reviews": null, "title": "LG전자 2도어 344L 몽블랑 네이처 (M344MB14) 2도어 냉장고"}
{"product_id": "12465433420", "ok": true, "price": 17900, "list_price": 35000, "reviews": 41, "title": "[국산 100%] 꿈에그린X알파플러스 KF94 새부리형 마스크 100매("}
{"product_id": "12332341407", "ok": true, "price": 299000, "list_price": 608000, "reviews": 12, "title": "마이크로소프트  MS office 2024 Home & Business "}
{"product_id": "12385071329", "ok": true, "price": 277000, "list_price": null, "reviews": null, "title": "-ku- 일렉트로룩스 WELL Q8 무선스틱청소기 WQ81-3OMBF"}
{"product_id": "5494837526", "ok": true, "price": 31490, "list_price": null, "reviews": 1, "title": "로슈 아큐첵 인스턴트 혈당계+시험지50매"}
{"product_id": "9280411528", "ok": true, "price": 32200, "list_price": 32250, "reviews": 33, "title": "오딧세이 남성2종 로맨틱 레드 스페셜세트+아이오페 포케터블 토트백 증 정"}
Todos os preços, contagens de avaliações e sinalizadores corresponderam à mesma página de produto buscada através do Web Unlocker. As 3 URLs sinalizadas eram 2 listagens excluídas e 1 listagem atrás da verificação de autorização do Naver. Remova as URLs dead_page da sua lista de monitoramento após cada execução. Busque qualquer outra URL sinalizada através do Web Unlocker, e analise cada página com smartstore_product.
Cada URL no lote começava com a URL da loja, como o padrão do script smartstore.naver.com/acnope/products/10444371682. Para construir uma a partir de um cartão da Plus Store, leia a URL da loja do parâmetro url de mallUrl.pcUrl e anexe /products/<channelProductId>.
Verifique o contrato de dados antes de carregar registros em um warehouse:
original_priceera uma string, efinal_priceera um inteiro, em todos os 930 registros de uma amostra do dataset de produtos Naver e em registros em tempo real. Converta ambos para inteiros antes de compará-los, como fazvalidate.- Nesse lote, um
original_pricenulo significava sem desconto, e umtotal_reviewsnulo significava nenhuma avaliação ainda. total_reviewscorrespondia à contagem de avaliações na página do produto, 19.581 para a URL padrão do script. Essa contagem era para todo o grupo do produto, e o estado da página também continha 15.422 para o produto individual.- Nesse lote,
product_idcorrespondia ao número do produto em cada URL de entrada, então você pode usá-lo para unir registros aos resultados da Plus Store. custom_output_fieldscontrola quais campos você armazena, então mantenha apenas os campos que você monitora e não armazene detalhes pessoais do vendedor.
Para histórico ou cobertura em massa em vez de coleta em tempo real, obtenha o dataset de produtos Naver, com preço por registro. Equipes que desejam insights de preço e promoção em vez de registros brutos podem usar o Naver Shopping Price Tracker.
A Bright Data também tem scrapers dedicados para avaliações do SmartStore, avaliações do Naver Shopping, e Naver Hotels.
Compare ferramentas e custos para cada tipo de página do Naver
Cada tarefa no monitoramento de preços e vitrine digital do Naver combina com um produto da Bright Data:
| Tarefa | Produto Bright Data | Resultado do teste | Como é cobrado |
|---|---|---|---|
| Resultados de shopping na busca do Naver para uma palavra-chave | SERP API com Raw HTML | 10 de 10 consultas | Por solicitação bem-sucedida (preços da API SERP) |
| Primeira página de resultados da Plus Store, 50 cartões | Web Unlocker | 10 de 10 consultas | Por solicitação bem-sucedida (preços do Web Unlocker) |
| Páginas 2 e seguintes da Plus Store | Browser API | 5 de 5 páginas extras em cada uma de 4 sessões com pausas de rolagem | Por GB de largura de banda (preços da Browser API) |
| Campos da API Shopping para uma palavra-chave, da busca de comparação de preços | Web Unlocker | 10 de 10 consultas | Por solicitação bem-sucedida |
| Registros completos para URLs de produtos conhecidos | Naver Shopping Scraper API | 7 de 7 listagens públicas, com preços e avaliações correspondentes a cada página | Por registro (preços da Web Scraper API) |
| Histórico ou dados de produtos em massa | Dataset de produtos Naver | Tipos de campo de preço em uma amostra de 930 registros corresponderam aos registros em tempo real | Por registro (preços de datasets) |
Através do Web Unlocker, uma página de resultados da Plus Store é cobrada como 1 solicitação. A Naver Shopping Scraper API cobra por registro, então o custo escala com o número de URLs de produtos que você envia. Em nosso teste, uma sessão da Browser API que carregou 5 páginas extras de 50 produtos usou cerca de 18 MB. Multiplique essas unidades pelas taxas atuais em cada página de preços para estimar seu orçamento.
Use as páginas de busca para encontrar produtos e rastrear seu ranking de busca. Depois envie as URLs que você monitora para a Naver Shopping Scraper API, para pagar por registros apenas nos produtos que você rastreia.
Considerações finais
As páginas de shopping e produtos do Naver bloquearam clientes HTTP simples, mas sua busca de comparação de preços ainda continha a maioria dos campos da API aposentada. Leia o JSON embutido e verifique seu conteúdo, não o código de status, porque os redirecionamentos de login e listagens excluídas do Naver retornavam como páginas comuns.
Use a API SERP e o Web Unlocker para descoberta, a Browser API para paginação, e a Naver Shopping Scraper API para registros estruturados de produtos. A coleta em tempo real mostra preços e rankings atuais, e o dataset de produtos Naver fornece histórico ou dados de produtos em massa. Comece executando o script de comparação de preços nas 5 palavras-chave que você mais monitora, e carregue suas linhas em suas tabelas de feed existentes.
Perguntas frequentes
O Naver ainda tem uma API de shopping?
O Naver encerrou sua API de busca do Shopping em 31 de julho de 2026, sem substituto no NAVER API HUB. Uma alternativa semelhante foi sua busca de comparação de preços, cujos dados embutidos continham a maioria dos campos da API, incluindo preço mais baixo, marca e categorias. O Web Unlocker da Bright Data a retornou para 10 de 10 consultas.
Por que o Naver Shopping retorna um erro 418?
HTTP 418 era a página de bloqueio do Naver Shopping para acesso temporariamente restrito. Ela listava 4 gatilhos: visitas de promoções externas não relacionadas a shopping, rajadas de solicitações de um IP, IPs de VPN e algumas extensões de navegador. O requests do Python e o Chrome headless a obtiveram, enquanto o Web Unlocker da Bright Data obteve os resultados.
É possível fazer scraping do Naver de fora da Coreia?
Sim, com um desbloqueador para as páginas de shopping. Da Índia, clientes HTTP simples obtiveram páginas completas da busca do Naver, enquanto o Naver Shopping retornou páginas de bloqueio, CAPTCHAs ou redirecionamentos de login. O Web Unlocker da Bright Data retornou 10 de 10 páginas da Plus Store ali. Use IPs coreanos, já que o Naver registrava o país de cada solicitante.
Como fazer scraping do Naver com Python?
Busque a página, depois analise o JSON embutido no HTML em vez de usar seletores CSS. As páginas de busca armazenavam dados de shopping em objetos _INITIAL_STATE, e o SmartStore usava window.__PRELOADED_STATE__. O Naver Shopping bloqueava clientes HTTP Python, então roteie essas solicitações através do Web Unlocker da Bright Data.
Quanto custa fazer scraping do Naver?
A API SERP e o Web Unlocker da Bright Data cobram por solicitação bem-sucedida, a Naver Shopping Scraper API cobra por registro, e a Browser API cobra por GB. Em nossos testes, uma página de resultados era 1 solicitação, e 5 páginas extras através da Browser API usaram cerca de 18 MB. As taxas atuais estão na página de preços.