Neste guia, você aprenderá:
- O que é o SDK Python da Bright Data.
- Como ele funciona internamente, incluindo como funciona a autenticação.
- O que ele oferece, incluindo modos síncronos e assíncronos, principais recursos e métodos.
- Como instalar o SDK e executar suas primeiras solicitações passo a passo.
- Tópicos avançados como polling, scraping simultâneo e mais.
- Casos de uso reais, desde comparar resultados de mecanismos de busca até fazer parsing de páginas web com BeautifulSoup para extração manual de dados.
Vamos começar!
O Que É o SDK Python da Bright Data?
O SDK Python da Bright Data é uma biblioteca Python projetada para simplificar as interações com os produtos da Bright Data.
O SDK está disponível através do pacote PyPI brightdata-sdk. Ele fornece uma interface unificada para fazer scraping de sites, recuperar resultados de mecanismos de busca, acessar conjuntos de dados prontos e trabalhar com soluções da Bright Data.
Em detalhes, o SDK Python inclui integrações prontas para uso com mais de 100 Scraper APIs da Bright Data, ajudando você a acessar dados públicos, estruturados e atualizados de plataformas como Amazon, LinkedIn, Instagram, TikTok e muitas outras.
Nota: Se você preferir trabalhar no terminal, o CLI da Bright Data oferece muitas das mesmas capacidades através de comandos de linha de comando. Saiba como usar o CLI da Bright Data com agentes de IA.
Leitura adicional:
Como Funciona o SDK Python
Internamente, o SDK envolve as APIs da Bright Data em classes Python. Dessa forma, você pode interagir com os serviços da Bright Data sem construir manualmente solicitações HTTP, chamar endpoints de API e fazer parsing de respostas. Em vez disso, você só precisa chamar métodos Python amigáveis para desenvolvedores.
A biblioteca é totalmente tipada e bem documentada, facilitando a exploração de suas capacidades em seu IDE.
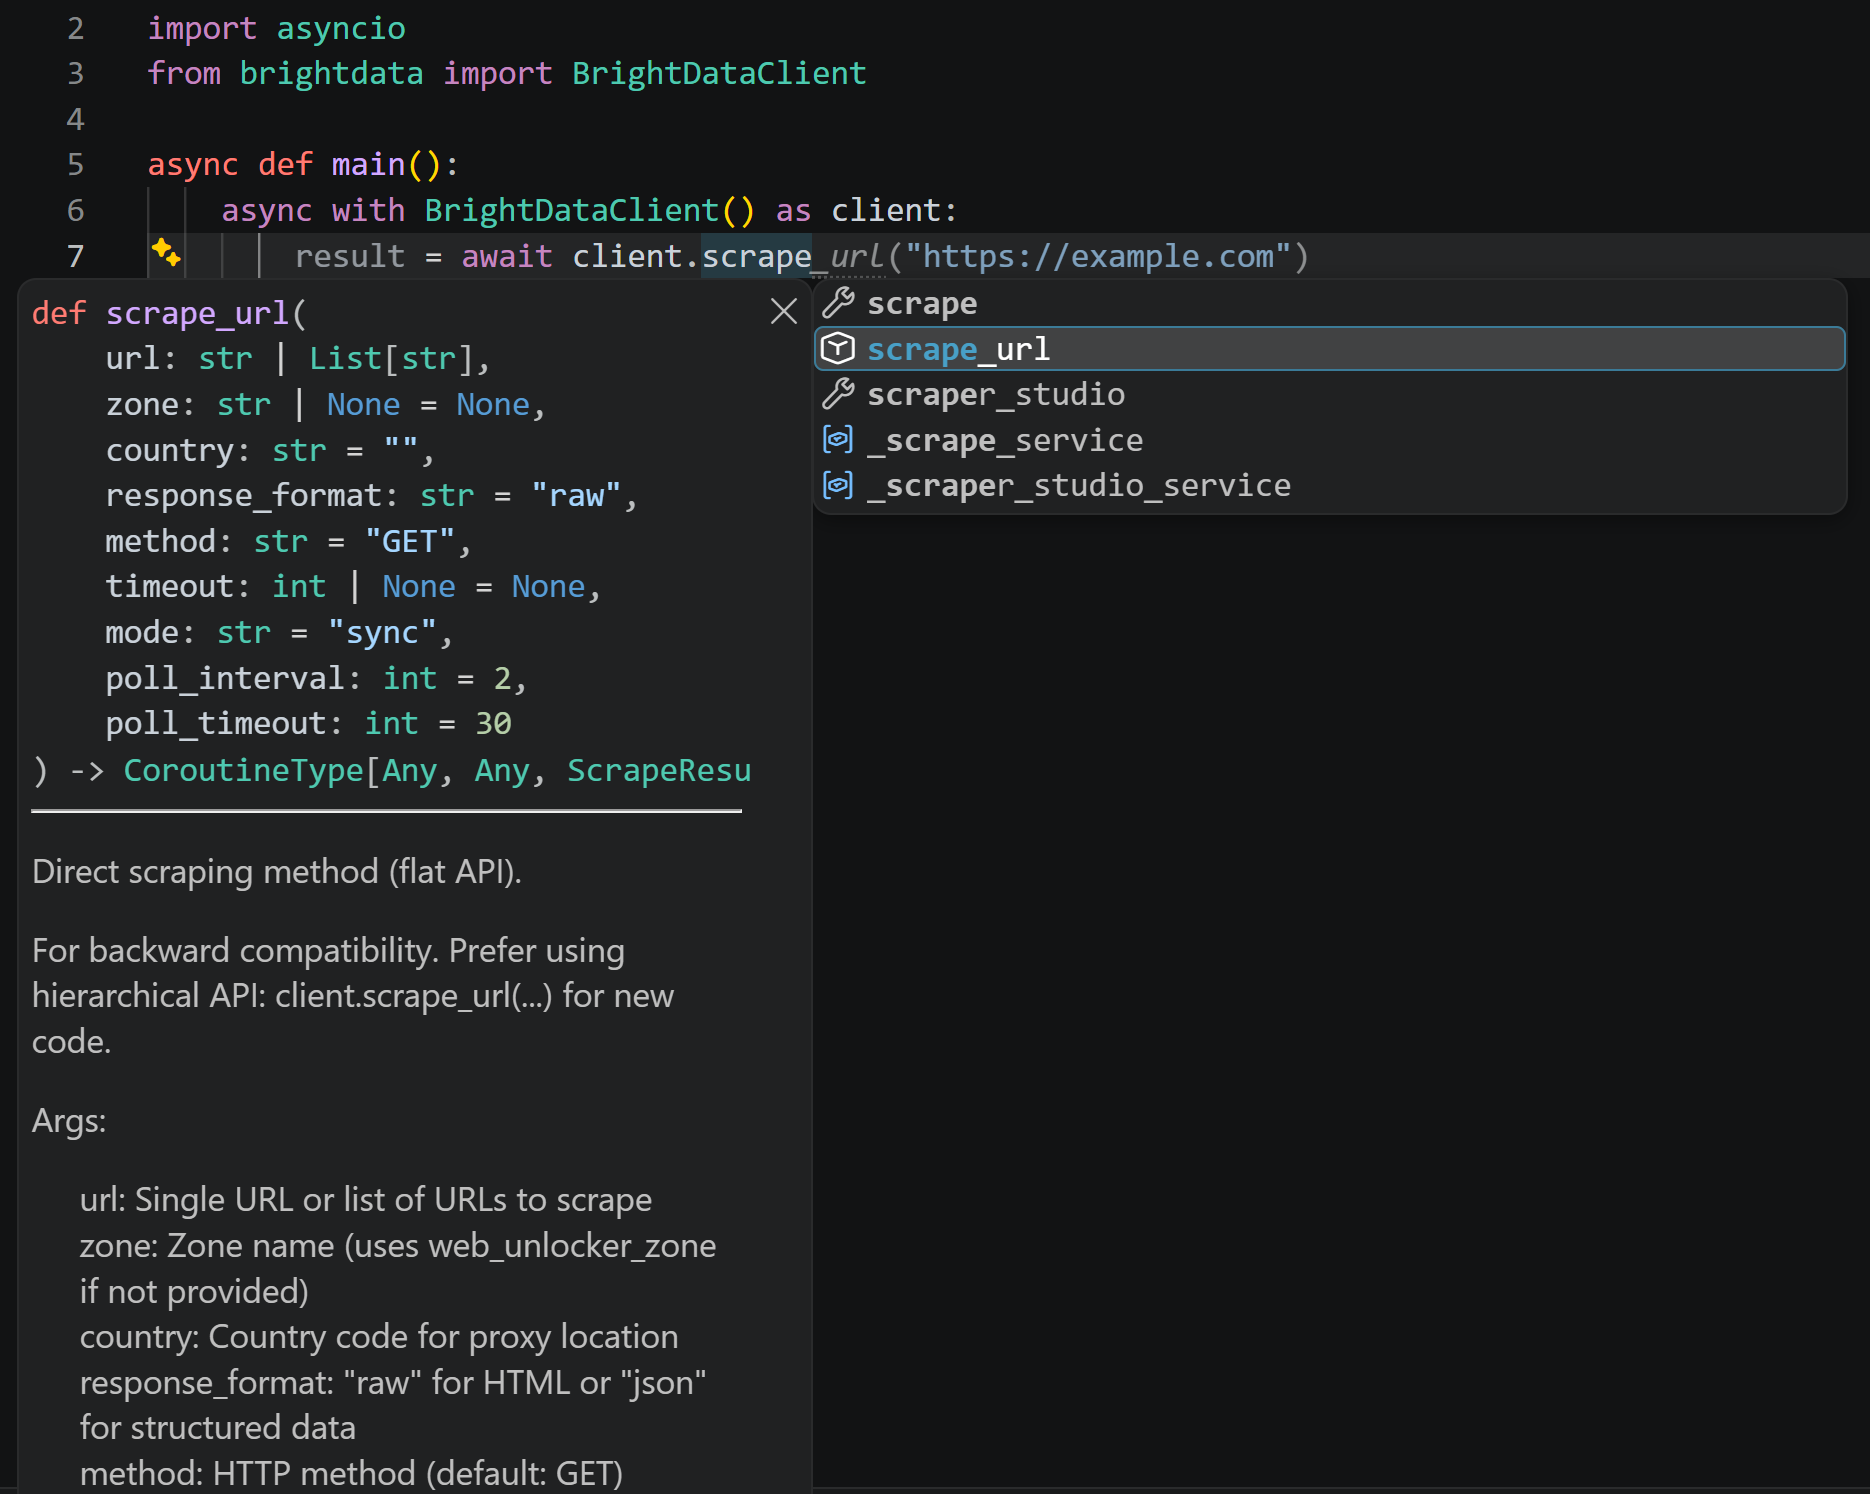
Você obtém autocompletar, dicas de tipo e exemplos de uso para ajudar a entender os parâmetros disponíveis e como usar cada método. Os objetos retornados também são tipados, permitindo que você acesse facilmente os campos de resposta.
A autenticação é feita através do token de API da Bright Data ou, se você já se autenticou via CLI da Bright Data, das credenciais salvas por brightdata login. Observe que, se sua conta Bright Data não tiver as APIs necessárias que o SDK chama internamente, a biblioteca as configura automaticamente para você.
O Que o SDK Oferece
Agora que o modelo central está claro, o próximo passo é explorar o que o SDK Python traz para a mesa.
Principais Recursos
O SDK Python da Bright Data cobre um amplo conjunto de capacidades, incluindo:
- Scraping de dados: Faça scraping de URLs individuais ou múltiplas simultaneamente e recupere o conteúdo do site com código mínimo.
- Resultados de mecanismos de busca: Recupere resultados do Google, Bing e Yandex, com suporte para consultas específicas de localização e pesquisas em lote.
- Scrapers específicos de plataforma: Extraia dados estruturados de Amazon, LinkedIn, Instagram, Facebook, TikTok, YouTube, Reddit, Pinterest, ChatGPT, Perplexity e outras plataformas.
- Pesquisa específica de plataforma: Descubra perfis, vagas, publicações e outros conteúdos usando parâmetros de pesquisa em vez de apenas URLs.
- Integração com o Scraper Studio: Execute scrapers personalizados, dispare tarefas de coleta, monitore seu status e recupere resultados.
- Métodos e respostas tipados: Beneficie-se de dicas de tipo, autocompletar do IDE, sugestões de parâmetros e objetos de resposta estruturados para facilitar o desenvolvimento.
- Gerenciamento de conta e API: Verifique a conectividade, inspecione informações da conta e uso, liste APIs e gerencie configurações de API.
- Exportação de dados: Salve os resultados de conjuntos de dados da web coletados em formatos JSON, CSV ou JSONL.
Principais Métodos do SDK
Comece instalando o SDK Python da Bright Data:
pip install brightdata-sdkUma vez instalado, importe o SDK e você terá acesso a vários métodos, como:
| Método | O que faz | Produto Bright Data |
|---|---|---|
client.scrape_url(url) |
Busca o conteúdo de uma URL ou de uma lista de URLs, contornando qualquer sistema anti-bot | Unlocker API |
client.search.google(query=...) |
Executa uma pesquisa no Google e retorna resultados orgânicos processados | API SERP |
client.search.bing(query=...) |
Executa uma pesquisa no Bing e retorna resultados orgânicos processados | API SERP (consulte o guia de migração para a Bing Web Search API) |
client.scrape.<platform>.<method>(url=...) |
Extrai dados estruturados de uma plataforma alvo, como client.scrape.amazon.products |
Scraper APIs |
client.search.linkedin.jobs(...) |
Pesquisa em uma plataforma por parâmetros em vez de URLs | Scraper APIs específicas |
client.datasets.<name>(filter=...) |
Solicita um snapshot filtrado de um conjunto de dados pré-coletado | Dataset APIs |
client.scraper_studio.run(collector=..., input=...) |
Dispara um coletor de scraping de dados personalizado e retorna seus registros | Scraper Studio |
client.browser.get_connect_url() |
Constrói o endpoint CDP para conectar Playwright ou Puppeteer a um navegador na nuvem | Browser API |
client.list_zones() |
Lista as zonas disponíveis em sua conta | Nenhum |
Clientes Síncronos e Assíncronos
O SDK fornece dois clientes com os mesmos nomes de método, mas modelos de execução diferentes:
BrightDataClient: O cliente assíncrono, projetado para aplicações que usamasyncioe precisam lidar com cargas de trabalho de alta concorrência.SyncBrightDataClient: O cliente síncrono, ideal para scripts simples e solicitações sequenciais diretas.
É assim que se chama scrape_url() usando SyncBrightDataClient:
from brightdata import SyncBrightDataClient

with SyncBrightDataClient() as client:
    result = client.scrape_url("https://example.com")
    print(result.data)
De forma equivalente, com BrightDataClient, você precisa usar async with para gerenciar o cliente e await para chamar métodos assíncronos:
import asyncio
from brightdata import BrightDataClient

async def main():
    async with BrightDataClient() as client:
        result = await client.scrape_url("https://example.com")
        print(result.data)

asyncio.run(main())
Ambos os exemplos retornam o HTML da página alvo em result.data:
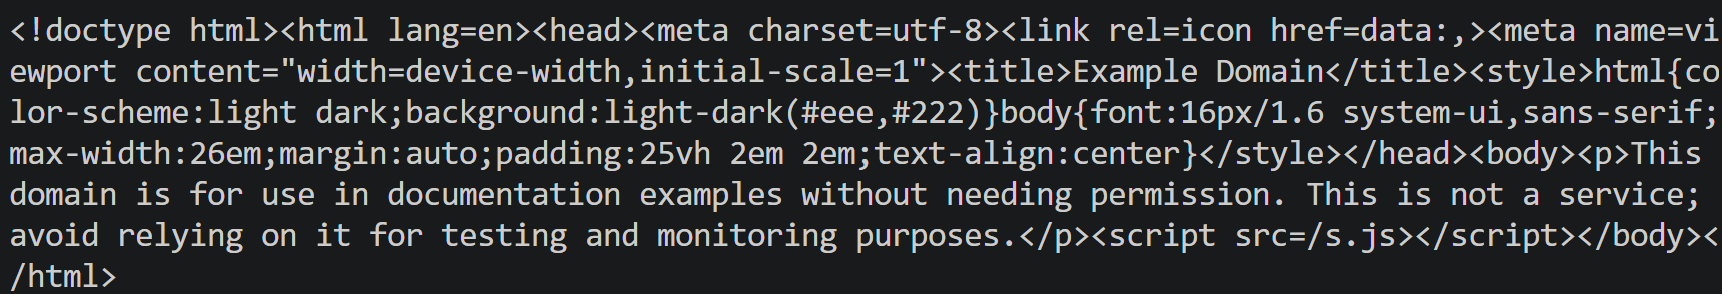
Lembre-se de que, embora BrightDataClient seja assíncrono, scrape_url() usa mode="sync" por padrão. Isso significa que a chamada espera até que o resultado do scraping esteja disponível antes de retornar. Para usar scrape_url() em modo puramente assíncrono, passe mode="async":
import asyncio
from brightdata import BrightDataClient

async def main():
    async with BrightDataClient() as client:
        result = await client.scrape_url(
            url="https://example.com",
            mode="async",
            poll_interval=5,   # Verifica a cada 5 segundos
            poll_timeout=180,  # Permite até 3 minutos
        )
        print(result.data)

asyncio.run(main())
No modo de scraping assíncrono, o SDK:
- Envia uma solicitação ao endpoint da Web Unlocker API.
- Recebe um
response_idque identifica a solicitação pendente. - Faz polling no endpoint de resultados usando esse ID até que os dados estejam prontos ou o tempo limite seja atingido.
- Retorna os dados do resultado quando ficam disponíveis.
Para mais informações sobre como escolher entre os modos de solicitação síncrono e assíncrono, consulte a documentação Sync vs. Async.
Notas:
- Os parâmetros
poll_intervalepoll_timeoutcontrolam com que frequência o SDK verifica os resultados e por quanto tempo espera. Parascrape_url(), seus padrões são2segundos e30segundos, respectivamente. - As solicitações assíncronas do Web Unlocker podem levar cerca de dois minutos para serem concluídas, então defina
poll_timeoutadequadamente.
Configuração Automática das APIs da Bright Data
As solicitações feitas através do SDK dependem das APIs da Bright Data configuradas em sua conta:
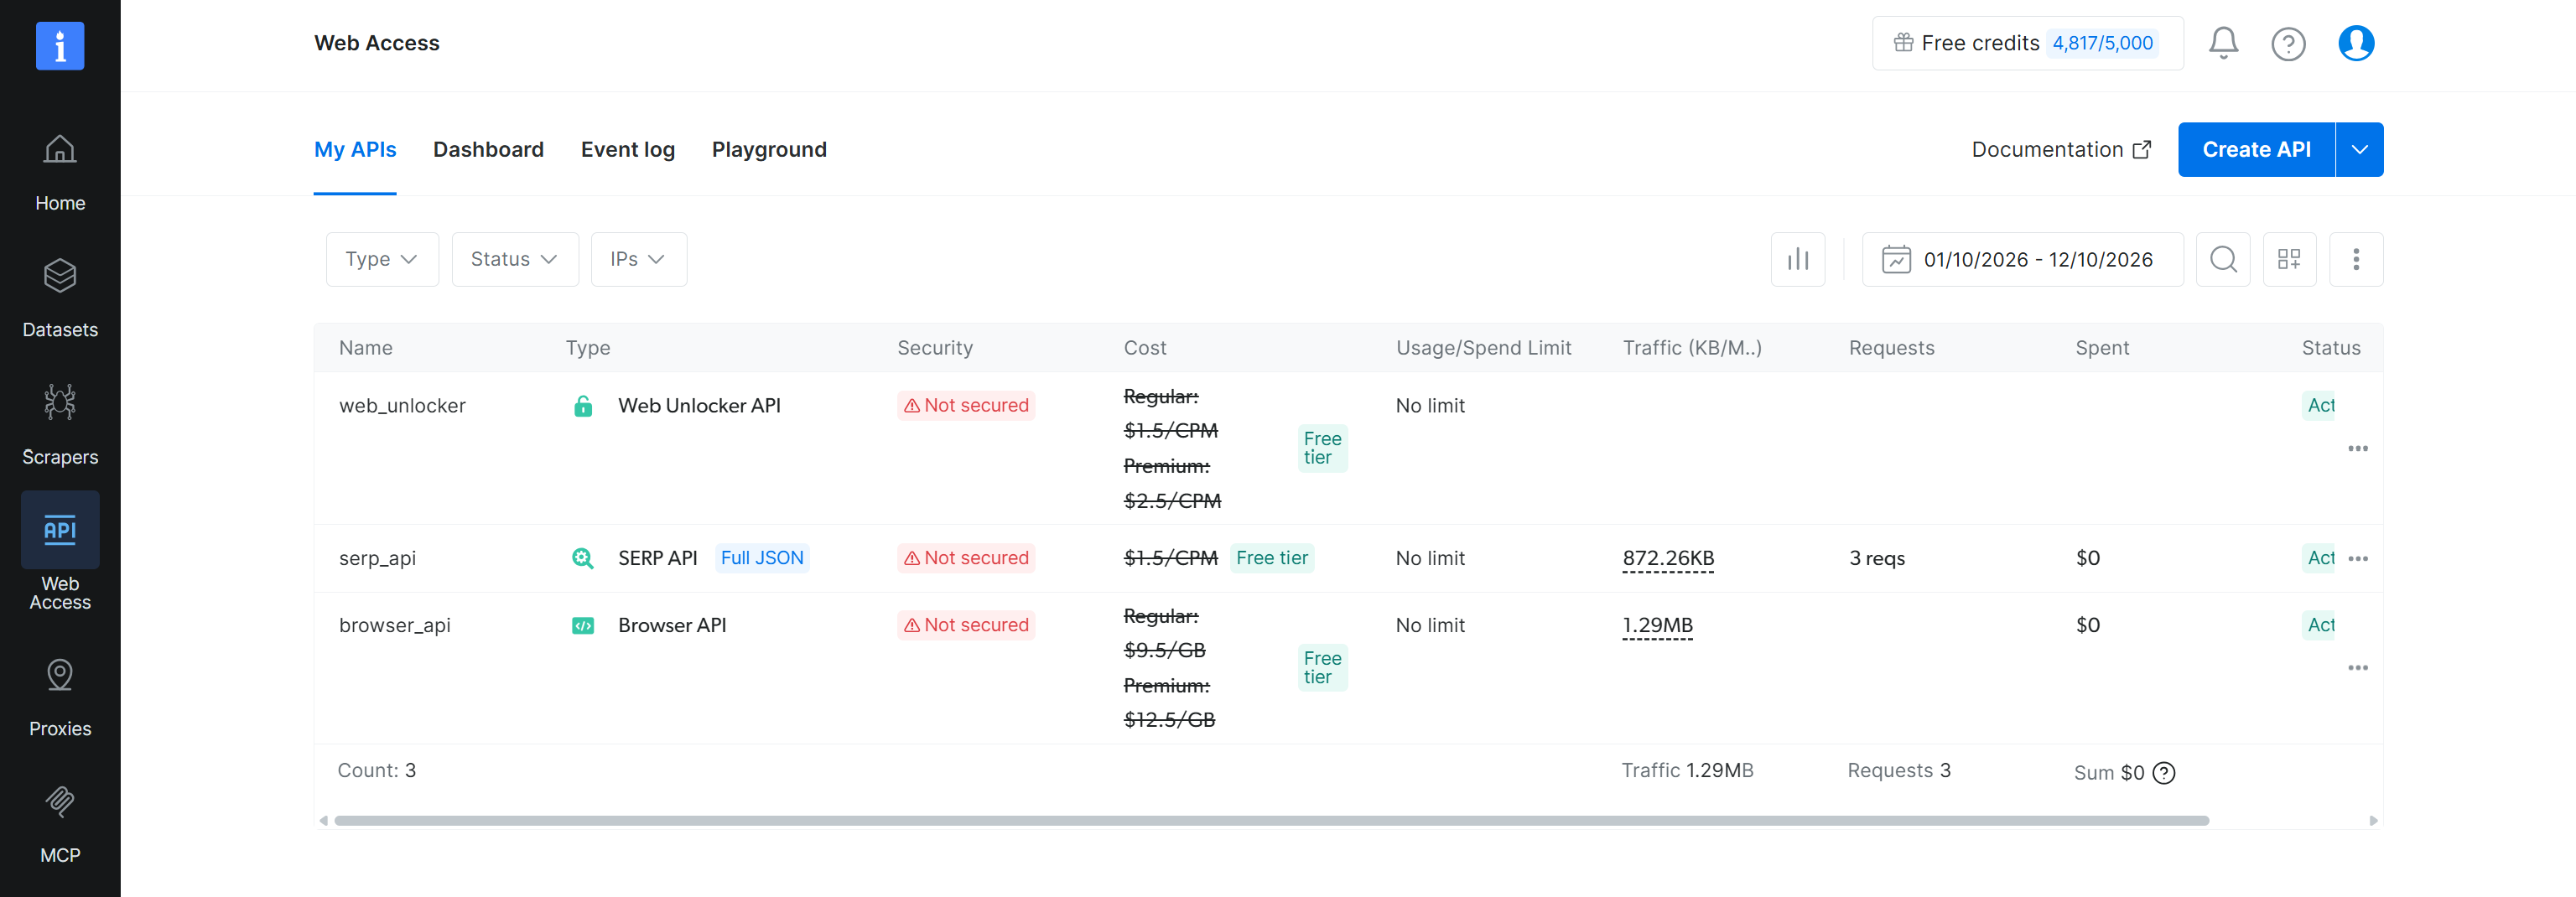
Por padrão, tanto SyncBrightDataClient quanto BrightDataClient definem auto_create_zones=True. Essa opção controla se o SDK cria as zonas de API necessárias caso ainda não existam.
Quando a criação automática está habilitada, o SDK garante que as seguintes zonas estejam disponíveis antes de fazer a primeira solicitação de API:
sdk_unlockerpara a Web Unlocker APIsdk_serppara a API SERP
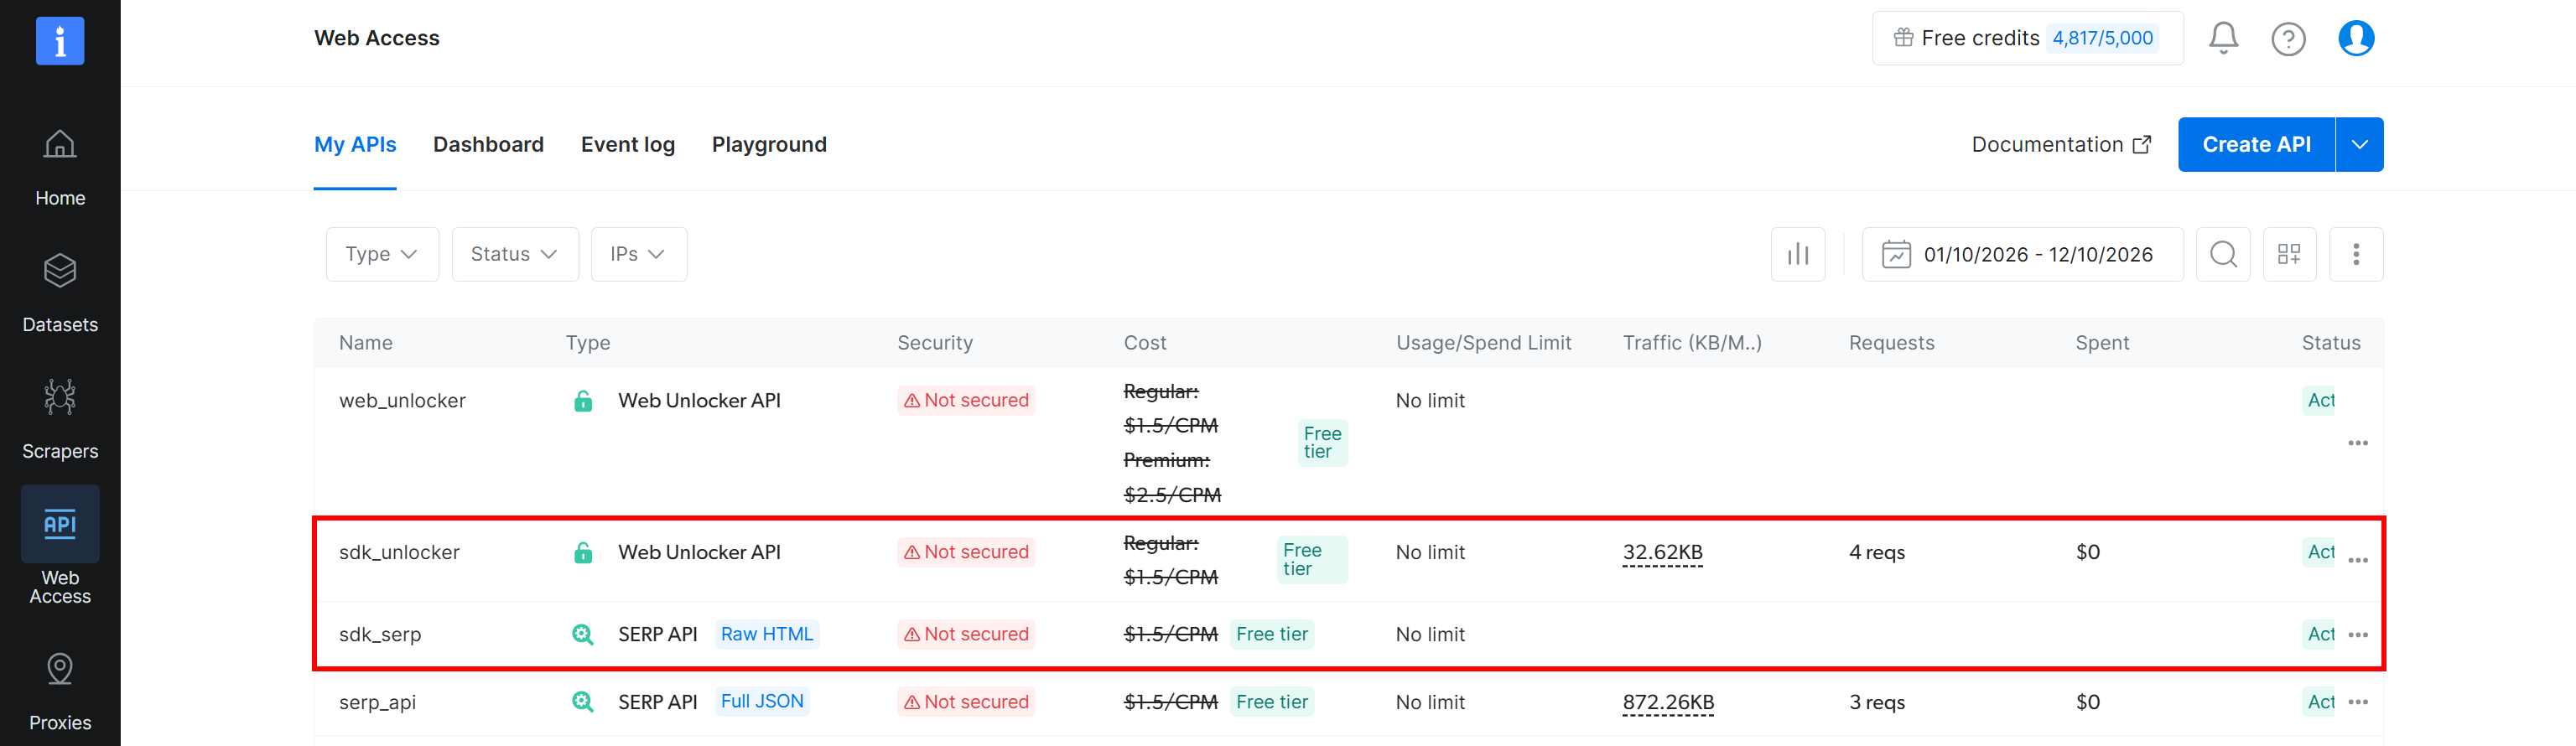
Se preferir gerenciar suas zonas de API você mesmo, defina auto_create_zones=False. O SDK não criará as APIs, então você deve fornecer os nomes de suas zonas existentes através de web_unlocker_zone e serp_zone.
Para usar uma zona de Unlocker API personalizada, escreva:
import asyncio
from brightdata import BrightDataClient

async def main():
    async with BrightDataClient(
        auto_create_zones=False,
        web_unlocker_zone="web_unlocker", # Substitua pela sua zona personalizada de Unlocker API
    ) as client:
        result = await client.scrape_url("https://example.com")
        print(result.data)

asyncio.run(main())
Começando com o SDK Python da Bright Data: Guia Passo a Passo
Com os conceitos claros, é hora de instalar, autenticar e testar os métodos do SDK.
Pré-requisitos
Antes de começar, certifique-se de ter:
- Python 3.9+ instalado localmente.
- Uma conta Bright Data.
- Um token de API da Bright Data, que você pode gerar no Painel de Controle da Bright Data.
Passo #1: Instale o SDK
Instale o SDK Python da Bright Data via pip com:
pip install brightdata-sdkSe você já tiver uma versão mais antiga instalada, atualize-a com:
pip install -U brightdata-sdkImportante: Este guia se refere a versões do SDK posteriores a 2.5.0.
Muito bem! Avance para a autenticação agora mesmo.
Passo #2: Autentique-se com Seu Token de API da Bright Data
O SDK Python da Bright Data lê a variável de ambiente BRIGHTDATA_API_KEY para autenticar solicitações às APIs da Bright Data.
No Linux ou macOS, defina a variável de ambiente necessária para sua chave de API da Bright Data com:
export BRIGHTDATA_API_KEY="<SUA_CHAVE_DE_API_DA_BRIGHT_DATA>"No Windows PowerShell, execute:
$Env:BRIGHTDATA_API_KEY = "<SUA_CHAVE_DE_API_DA_BRIGHT_DATA>"Uma vez definida a variável de ambiente, o cliente assíncrono padrão captura sua chave de API automaticamente:
from brightdata import BrightDataClient

async with BrightDataClient() as client:
    # ...
Você também pode passar sua chave de API diretamente ao criar o cliente através do argumento token:
from brightdata import BrightDataClient

async with BrightDataClient(token="<SUA_CHAVE_DE_API_DA_BRIGHT_DATA>") as client:
    # Faça solicitações de API aqui
    ...
Passar o token diretamente pode ser útil para testes rápidos. No entanto, evite codificar chaves de API diretamente em arquivos de código-fonte.
O SDK verifica as credenciais na seguinte ordem:
- O argumento
tokenpassado paraBrightDataClientouSyncBrightDataClient. - A variável de ambiente
BRIGHTDATA_API_TOKEN. - A variável de ambiente
BRIGHTDATA_API_KEY. - Credenciais salvas pelo CLI da Bright Data usando
brightdata login, se disponíveis.
Tudo pronto! Agora você pode usar o SDK Python para fazer scraping de páginas web, recuperar resultados de pesquisa e acessar outras APIs da Bright Data.
Passo #3: Execute Sua Primeira Tarefa de Coleta de Dados da Web
Com o SDK instalado e autenticado, execute seu primeiro scraping. Suponha que você queira coletar dados estruturados de um perfil específico do LinkedIn.
Para essa tarefa, você pode usar a Bright Data LinkedIn Profiles Scraper API, disponível através do método client.scrape.linkedin.profiles(). Isso retorna os dados do perfil em um objeto estruturado:
import asyncio
from brightdata import BrightDataClient
from pprint import pprint

async def main():
    async with BrightDataClient() as client:
        result = await client.scrape.linkedin.profiles(
            url="https://linkedin.com/in/antonello-zanini" # Perfil do LinkedIn alvo para scraping
        )

        print(f"Sucesso: {result.success}")
        print("\nDados do perfil coletados:")
        pprint(result.data, indent=2, sort_dicts=False)

asyncio.run(main())
O resultado será:
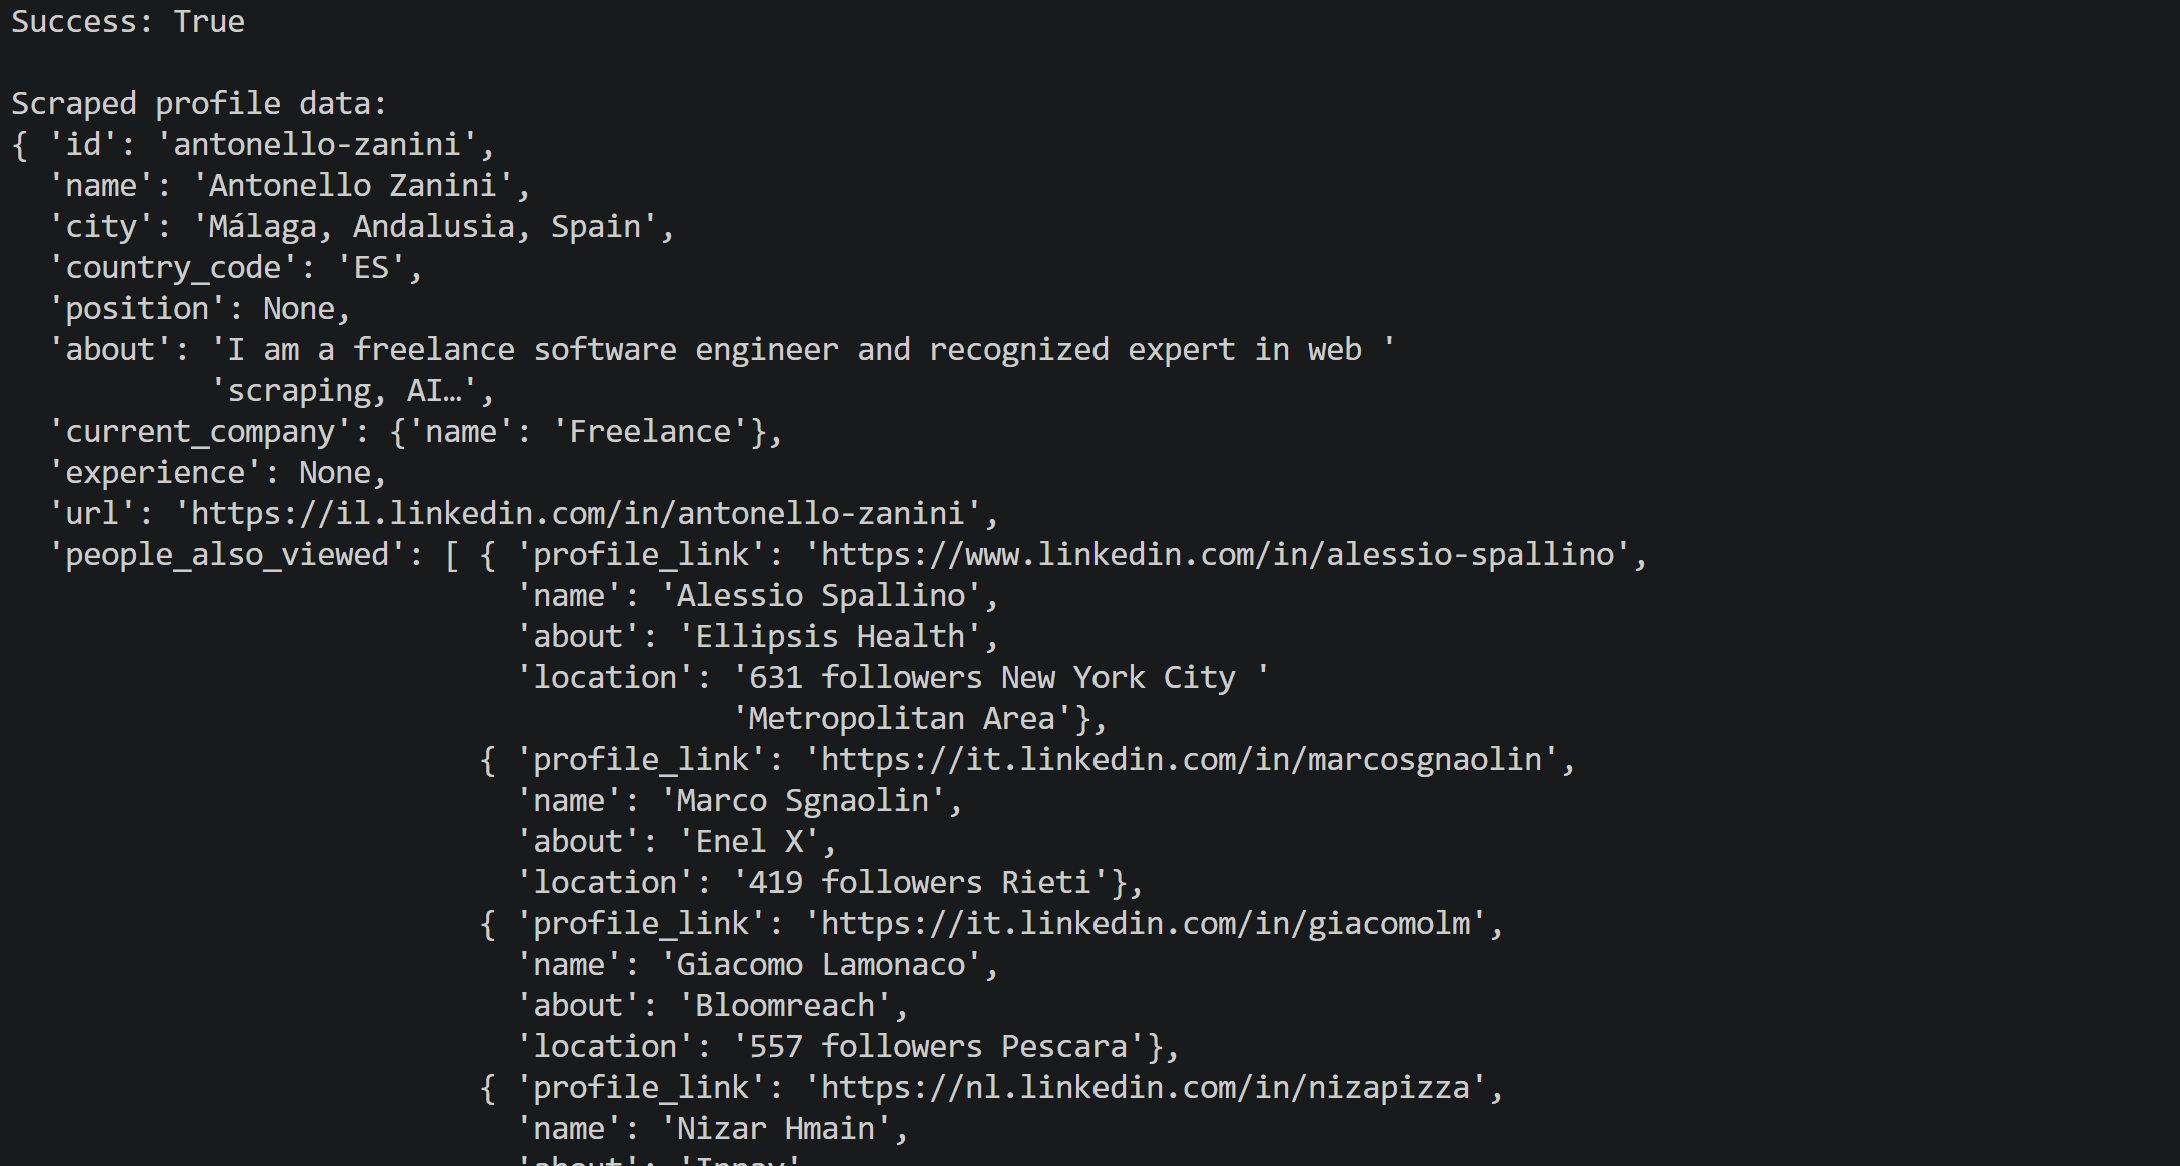
Observe como o método retorna dados públicos, estruturados e recém-coletados do perfil do LinkedIn fornecido, exatamente como esperado:
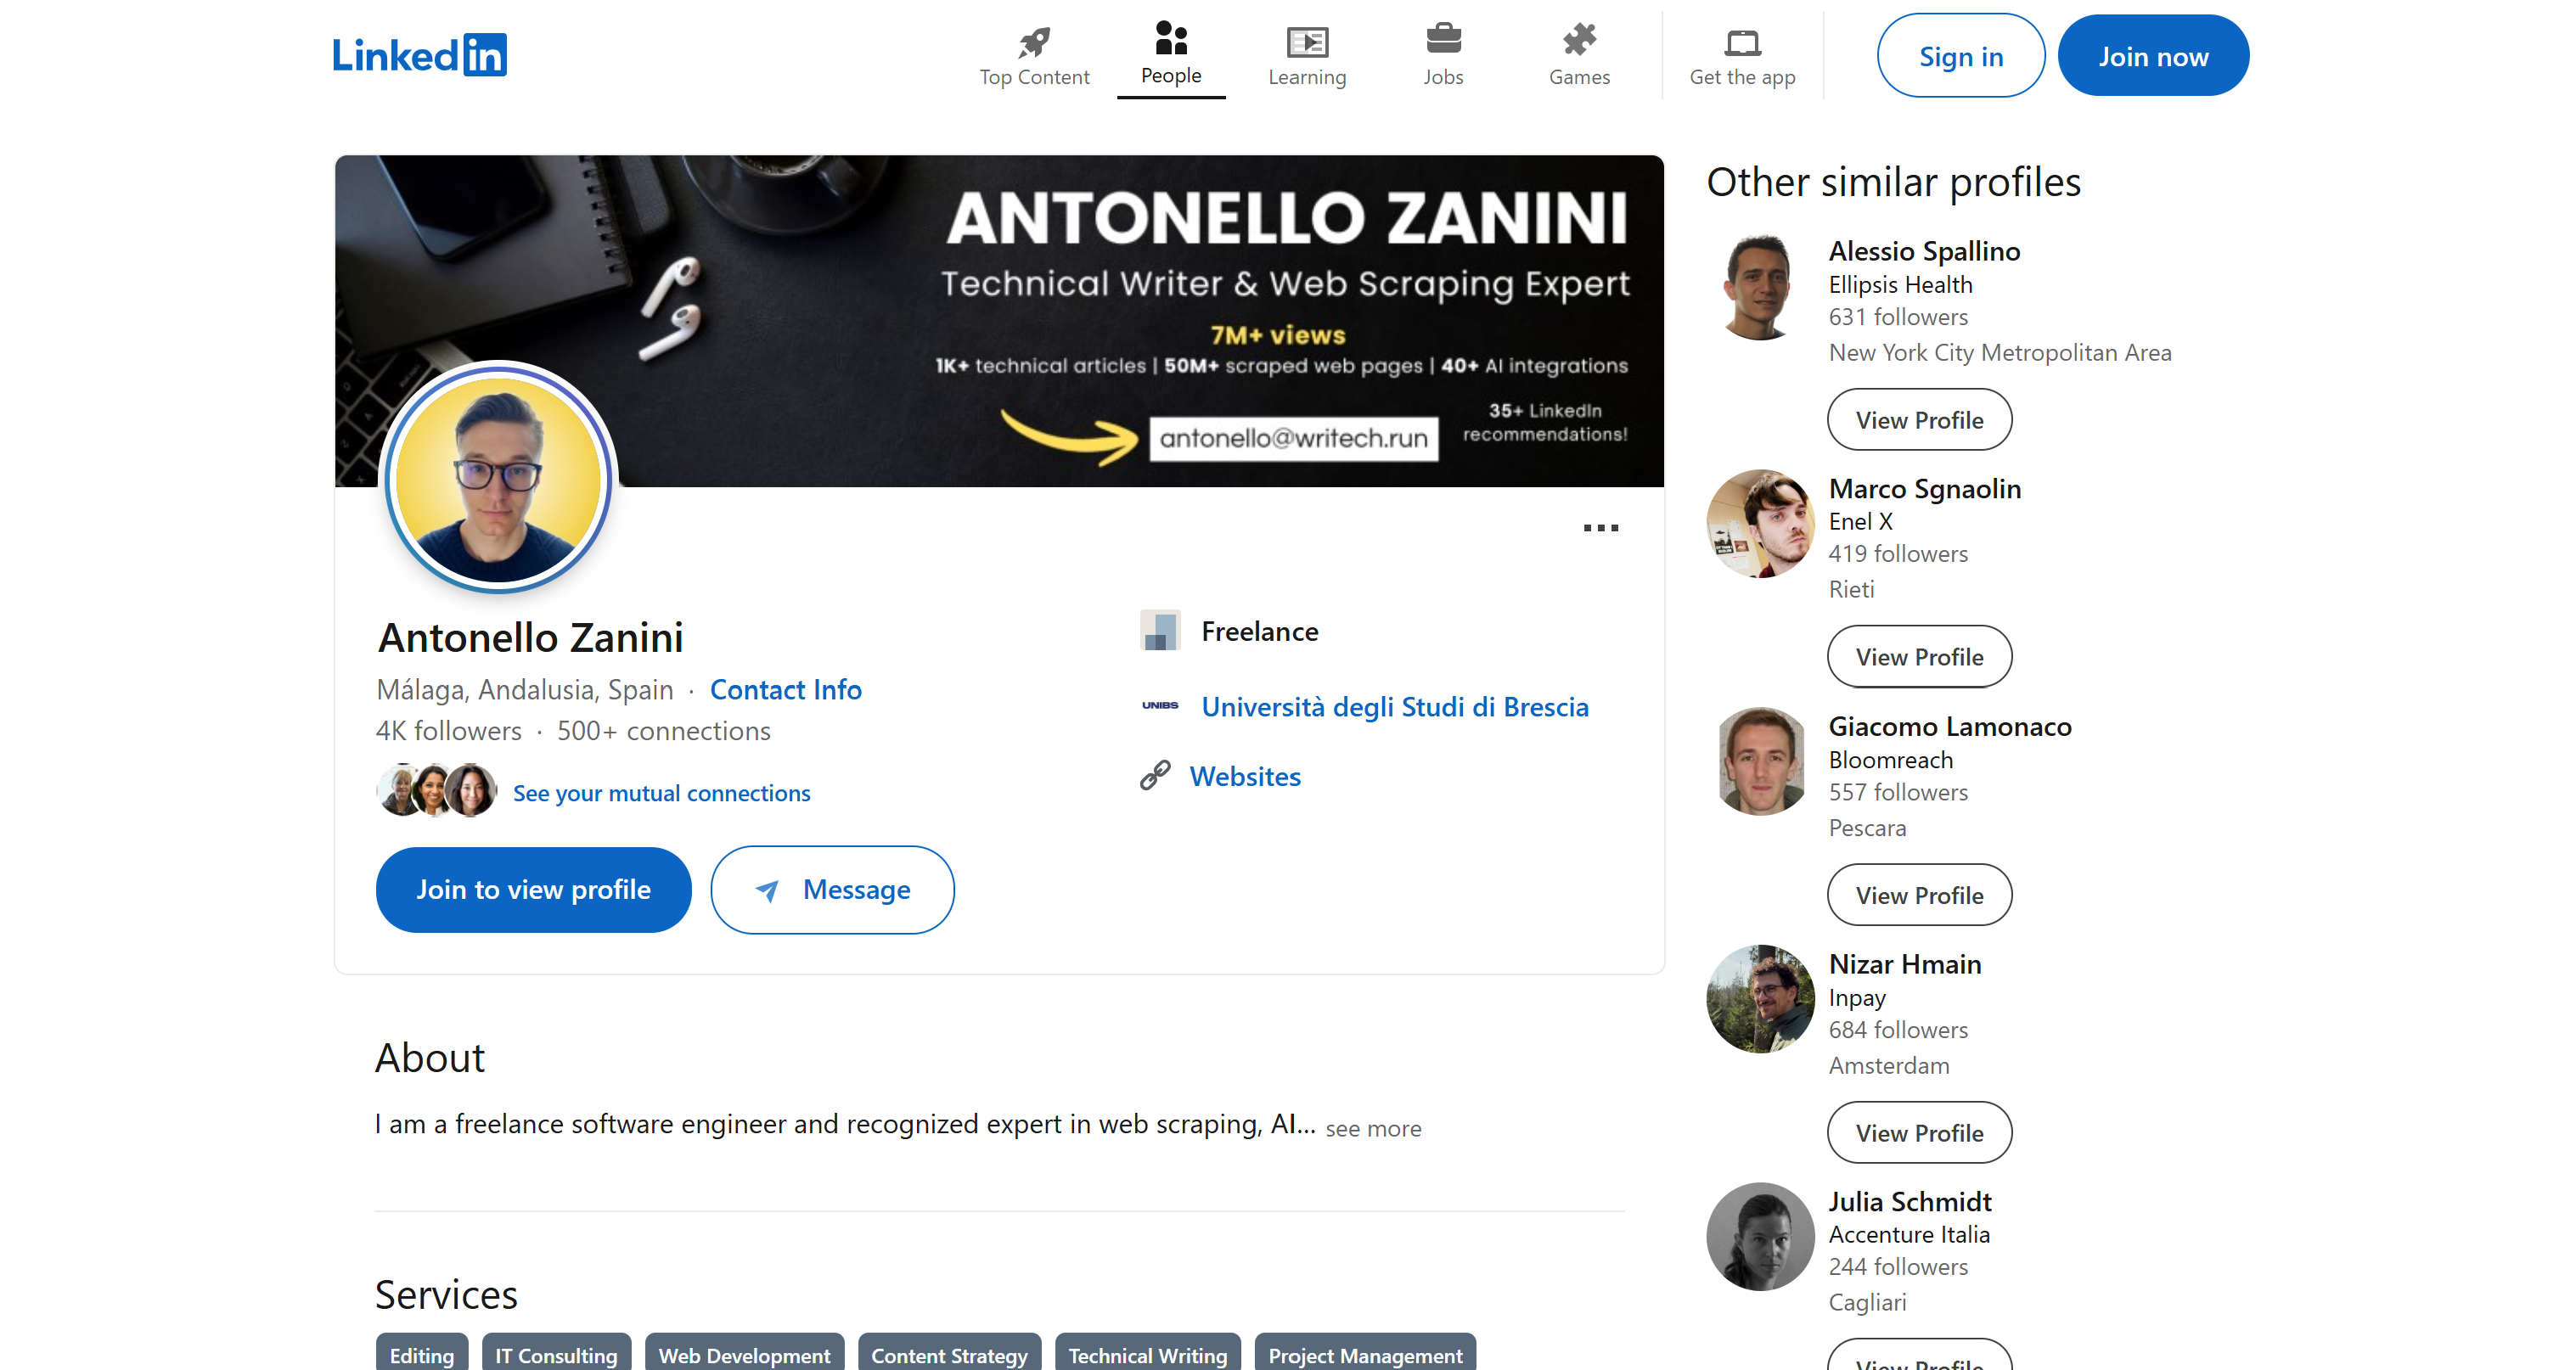
Missão cumprida!
Uso Avançado
Agora que você está confortável com o básico, está pronto para explorar tópicos mais avançados.
Mecanismo de Polling
Algumas tarefas de scraping levam mais do que alguns segundos, e você pode querer ter controle sobre o que está acontecendo enquanto elas são executadas. Para essas situações, a Bright Data permite executar Scraper APIs como tarefas assíncronas.
A ideia é disparar o scraping e receber uma tarefa imediatamente de volta. Depois, você verifica seu status, espera que ela termine e busca os resultados quando foram produzidos. Normalmente, isso exigiria uma lógica de polling personalizada, mas o SDK já fornece métodos que simplificam o processo.
O script a seguir realiza scraping assíncrono para um perfil do LinkedIn:
import asyncio
from brightdata import BrightDataClient

async def main():
    async with BrightDataClient() as client:
        # Inicia a tarefa de scraping e retorna uma tarefa imediatamente
        job = await client.scrape.linkedin.profiles_trigger(
            url="https://es.linkedin.com/in/antonello-zanini"
        )
        print(f"Tarefa disparada: {job.snapshot_id}")  # O ID que identifica essa tarefa

        # Verifica o estado atual da tarefa, como "running" ou "ready"
        status = await job.status()
        print(f"Status: {status}")

        # Faz polling na tarefa até que esteja "ready"
        await job.wait(timeout=180, verbose=True)

        # Baixa os registros assim que a tarefa estiver pronta
        data = await job.fetch()
        print(f"Obtidos {len(data) if isinstance(data, list) else 1} registros")

asyncio.run(main())
Abaixo está o que cada método do SDK faz:
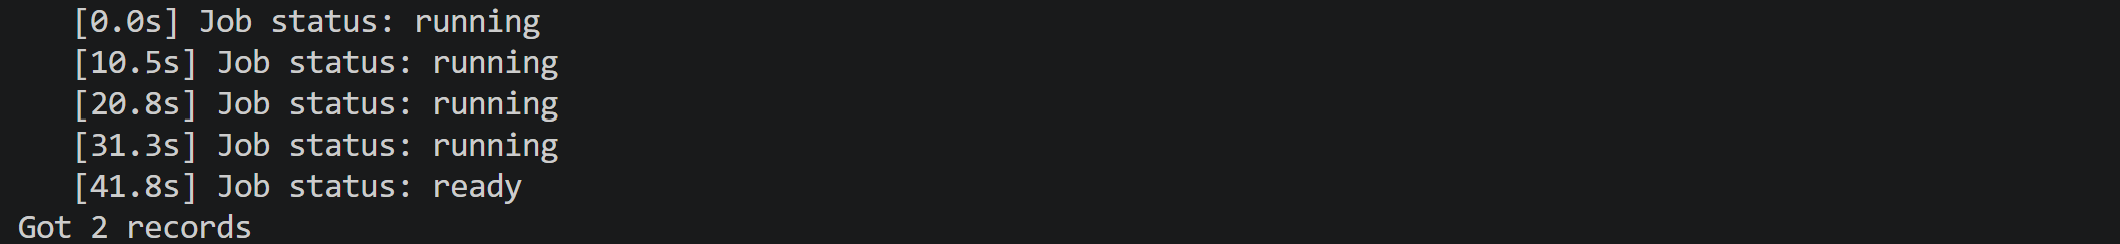
profiles_trigger()inicia a tarefa de scraping e retorna um objeto de tarefa sem esperar que o scraping termine.job.status()verifica o status atual da tarefa.job.wait()faz polling no status da tarefa em intervalos regulares até que a tarefa esteja pronta ou o tempo limite seja atingido. Por padrão, verifica o status a cada 10 segundos. Se o tempo limite for atingido primeiro, levanta umTimeoutError.job.fetch()recupera os registros coletados assim que a tarefa estiver pronta.
Definir verbose=True imprime cada verificação de status, para que você possa acompanhar o progresso da tarefa:
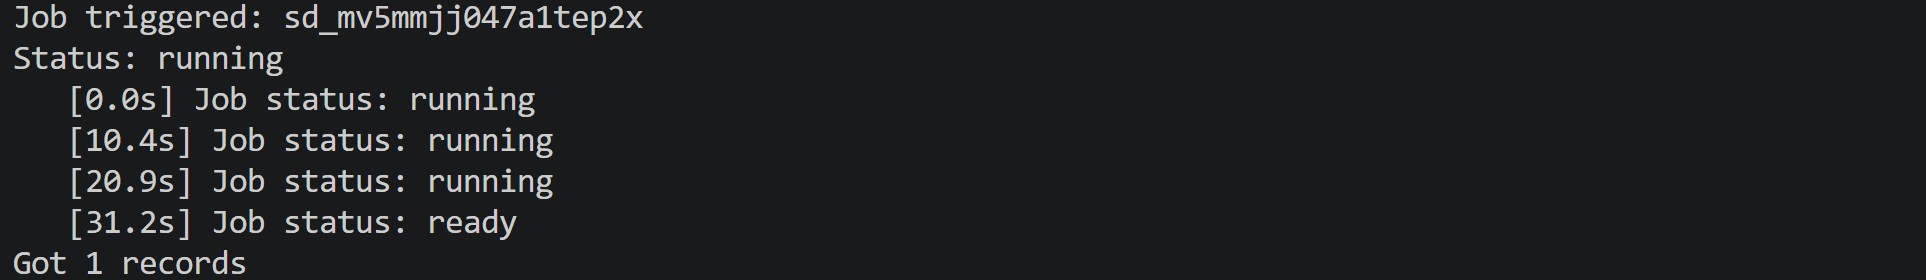
Se você não precisar gerenciar cada etapa sozinho, to_result() combina esperar, buscar e encapsular os dados em um objeto de resultado:
import asyncio
from brightdata import BrightDataClient
from pprint import pprint

async def main():
    async with BrightDataClient() as client:
        # Inicia a tarefa de scraping e retorna uma tarefa imediatamente
        job = await client.scrape.linkedin.profiles_trigger(
            url="https://es.linkedin.com/in/antonello-zanini"
        )
        print(f"Tarefa disparada: {job.snapshot_id}")  # O ID que identifica essa tarefa

        result = await job.to_result(timeout=180) # Faz polling, busca e obtém os dados

        print(f"Sucesso: {result.success}")
        print("\nDados do perfil coletados:")
        pprint(result.data, indent=2, sort_dicts=False)

asyncio.run(main())
Isso retorna o mesmo objeto de resultado que o método scrape.linkedin.profiles() mostrado anteriormente neste tutorial.
Se precisar de mais controle sobre o polling, considere implementar seu próprio loop chamando repetidamente job.status() e ajustando sua lógica com base no status retornado (ou seja, "running", "ready", ou "error").
Fazer Scraping de Várias Páginas Simultaneamente
Quando você precisa buscar várias páginas, passe uma lista de URLs para o método de scraping do SDK Python da Bright Data. O SDK as busca simultaneamente e retorna um objeto de resultado por URL. Dê uma olhada no exemplo abaixo:
import asyncio
from brightdata import BrightDataClient

urls = [
    "https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html",
    "https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html",
    "https://books.toscrape.com/catalogue/soumission_998/index.html",
]

async def main():
    async with BrightDataClient() as client:
        # Busca todas as URLs simultaneamente
        results = await client.scrape_url(urls)

        # Cada item em results é um objeto de resultado para uma URL
        for i, r in enumerate(results):
            if r.success:  # Ignora as URLs que falharam
                print(f"URL: {urls[i]}")
                print(f"{r.data[:500]}...")  # Primeiros 500 caracteres do HTML bruto
                print("-" * 80 + "\n")

asyncio.run(main())
O script imprime uma linha para cada URL bem-sucedida, mostrando os primeiros 500 caracteres de seu HTML bruto:
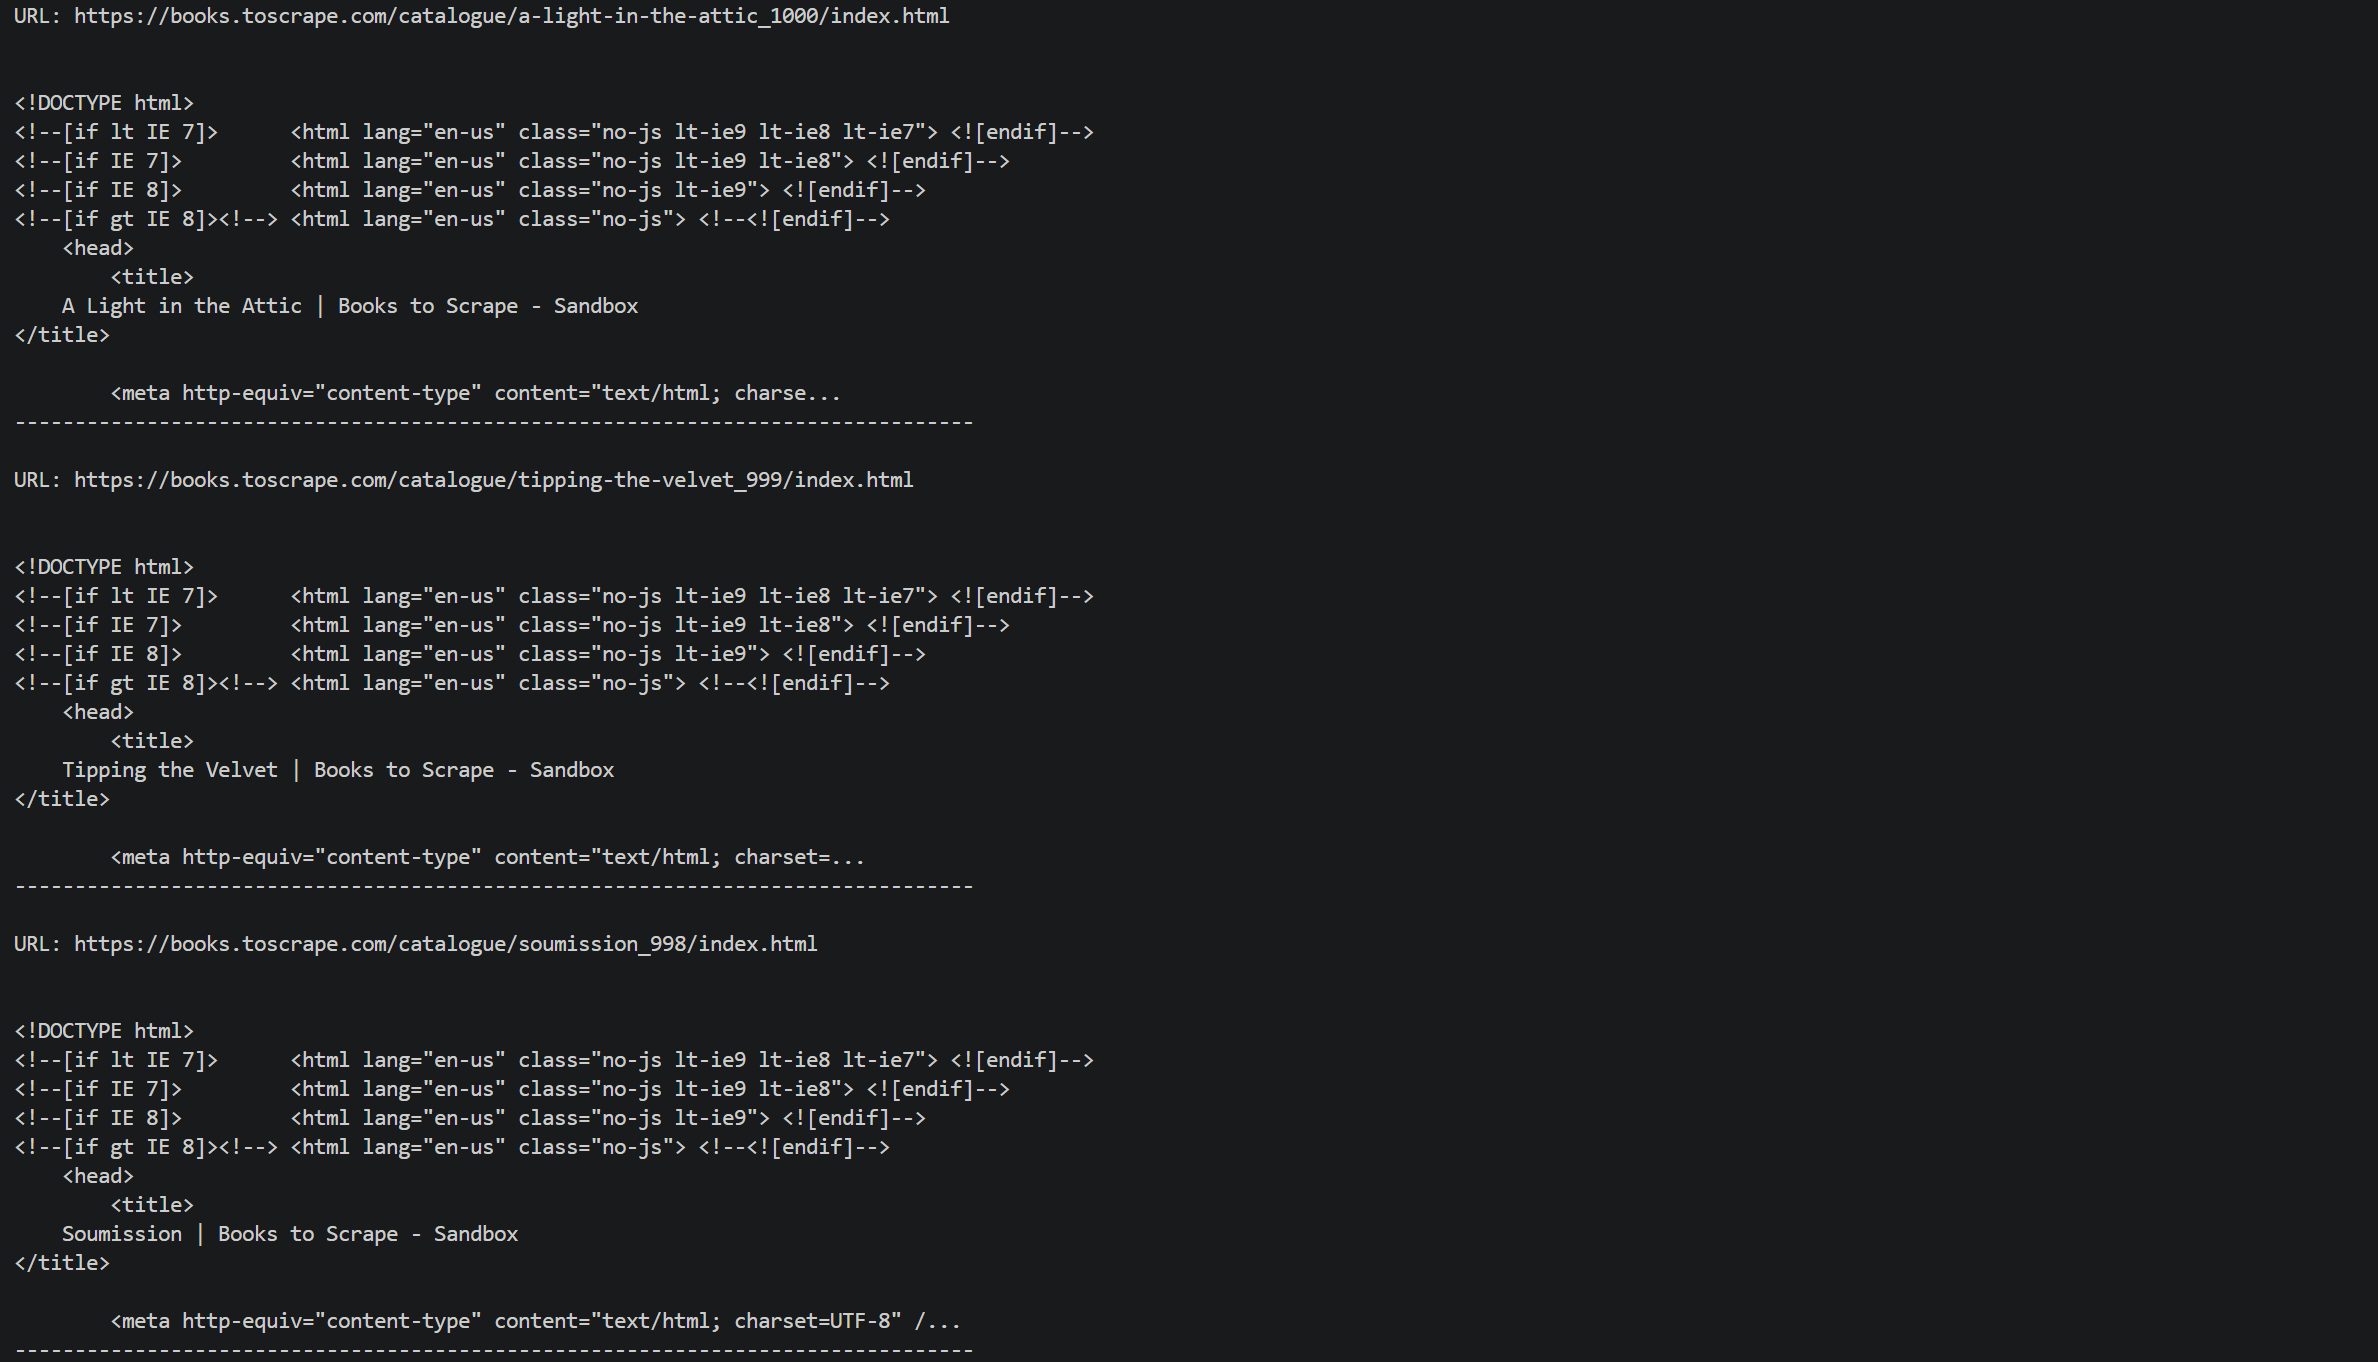
A mesma ideia se aplica aos scrapers de plataforma. O script a seguir coleta dois perfis do LinkedIn ao mesmo tempo:
import asyncio
from brightdata import BrightDataClient

PROFILE_URLS = [
    "https://es.linkedin.com/in/antonello-zanini",
    "https://it.linkedin.com/in/federico-trotta",
]

async def main():
    async with BrightDataClient() as client:
        linkedin = client.scrape.linkedin

        # Dispara todos os perfis primeiro, para que todas as tarefas comecem antes de você esperar por qualquer uma delas
        job = await linkedin.profiles_trigger(url=PROFILE_URLS)

        # Faz polling na tarefa até que esteja "ready"
        await job.wait(timeout=180, verbose=True)

        # Baixa os registros assim que a tarefa estiver pronta
        data = await job.fetch()
        print(f"Obtidos {len(data) if isinstance(data, list) else 1} registros")

asyncio.run(main())
A saída será um conjunto de dados contendo dois perfis, coletados simultaneamente:
Exportar Dados Recuperados
O SDK pode salvar dois tipos de dados: registros de conjuntos de dados e resultados do método scrape. Os registros de conjuntos de dados podem ser exportados com o auxiliar export(), enquanto um resultado de scrape tem o auxiliar save_to_file().
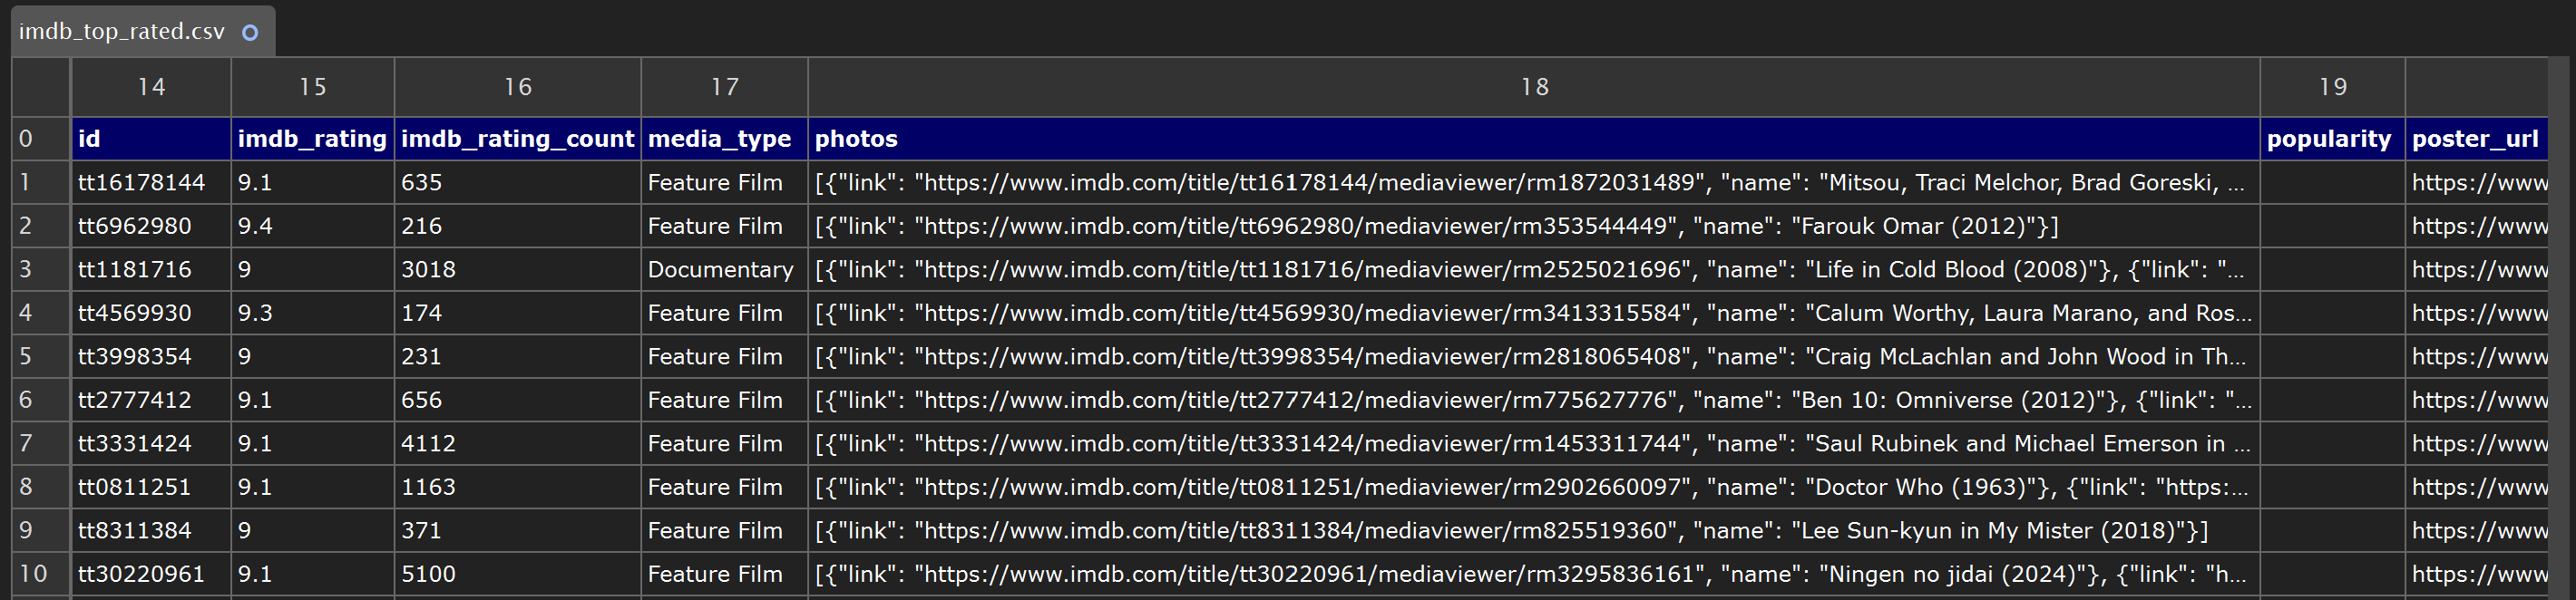
Os conjuntos de dados são úteis quando você precisa de dados pré-coletados em vez de scrapings novos. Para exportar registros de conjuntos de dados, crie um snapshot e baixe os registros, depois passe-os para o auxiliar export(), que os grava em um arquivo:
import asyncio
from brightdata import BrightDataClient
from brightdata.datasets import export

async def main():
    async with BrightDataClient() as client:
        imdb = client.datasets.imdb_movies

        # Cria um snapshot para os registros filtrados
        # (filmes com classificação IMDB de 9+ e 100+ avaliações)
        # depois os baixa como uma lista
        snapshot_id = await imdb(
            filter={
                "operator": "and",
                "filters": [
                    {"name": "imdb_rating", "operator": ">=", "value": 9},
                    {"name": "imdb_rating_count", "operator": ">", "value": 100},
                ],
            },
            records_limit=10,
        )
        data = await imdb.download(snapshot_id)

        export(data, "imdb_top_rated.csv")  # A extensão .csv seleciona o formato CSV

asyncio.run(main())Nota: O formato de saída é escolhido a partir da extensão, e .json, .jsonl e .csv são suportados.
O script acima criará o seguinte arquivo imdb_top_rated.csv na pasta do seu projeto:
Para exportar um resultado do método scrape para um arquivo, chame save_to_file():
import asyncio
from brightdata import BrightDataClient

async def main():
    async with BrightDataClient() as client:
        result = await client.scrape.linkedin.profiles(
            url="https://es.linkedin.com/in/antonello-zanini"
        )

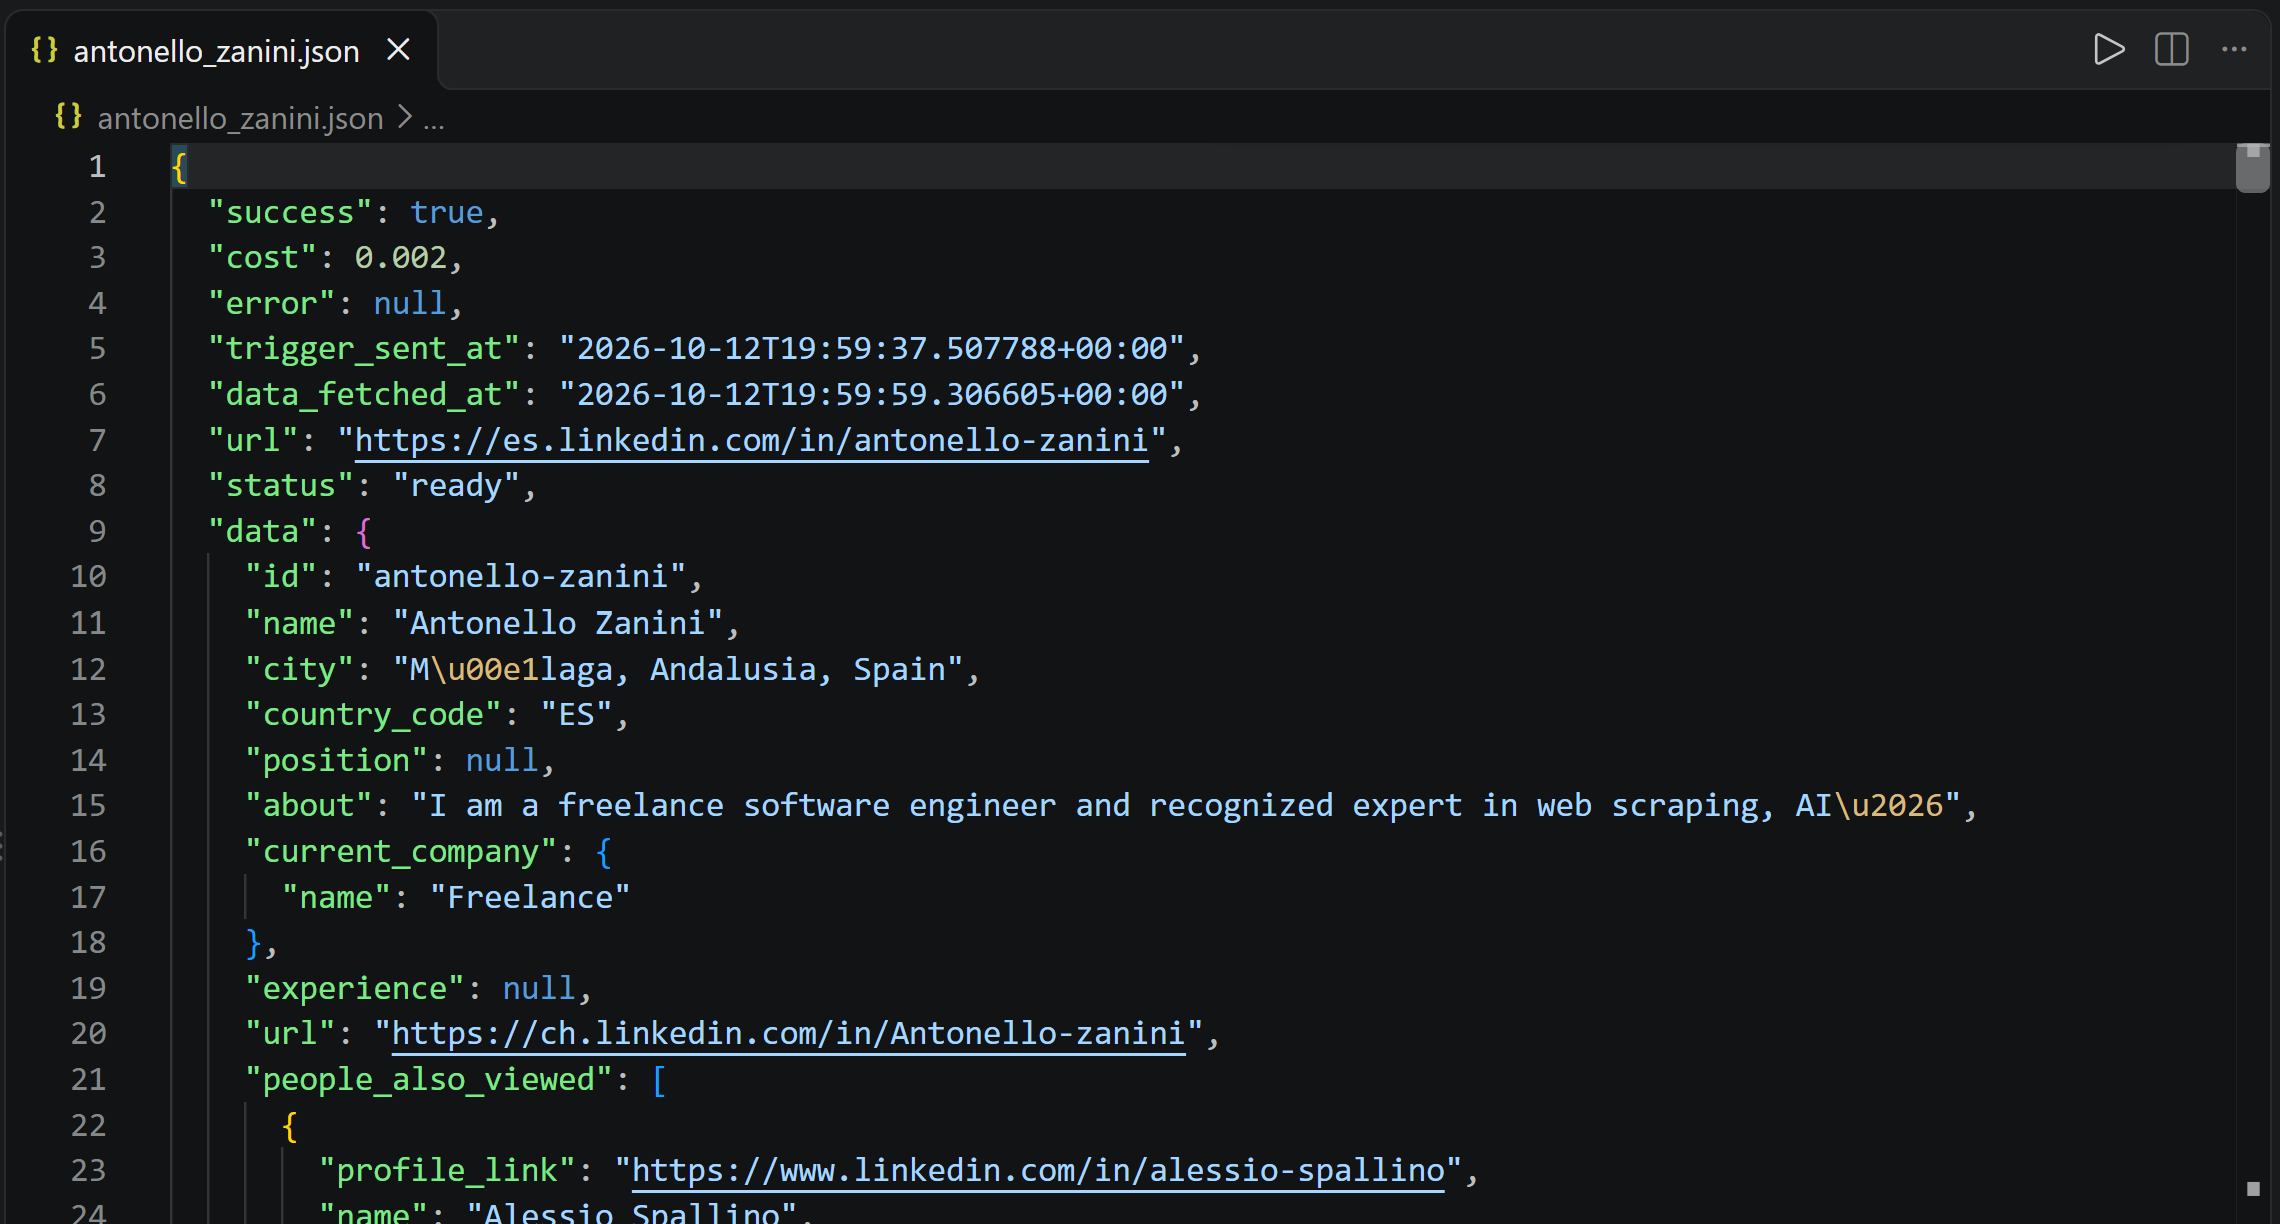
        result.save_to_file("antonello_zanini.json", format="json")  # Gravado em disco

asyncio.run(main())Nota: Apenas o formato JSON é suportado.
Isso produzirá um arquivo antonello_zanini.json da seguinte forma:
SDK Python da Bright Data em Ação: Casos de Uso
Depois de explorar cenários mais avançados, agora você tem a base necessária para enfrentar casos de uso reais.
Comparar Resultados de Mecanismos de Busca
Quando se trata de monitoramento de SERP, é importante entender como diferentes mecanismos de busca lidam com a mesma consulta. O script a seguir executa a mesma consulta no Google e no Bing:
# pip install brightdata-sdk

import asyncio
from brightdata import BrightDataClient

# A consulta a ser executada em vários mecanismos de busca
query = "best HTML parsers"

async def main():
    async with BrightDataClient() as client:
        # Obtém resultados de pesquisa processados do Google e do Bing
        google = await client.search.google(query=query, num_results=10)
        bing = await client.search.bing(query=query, num_results=10)

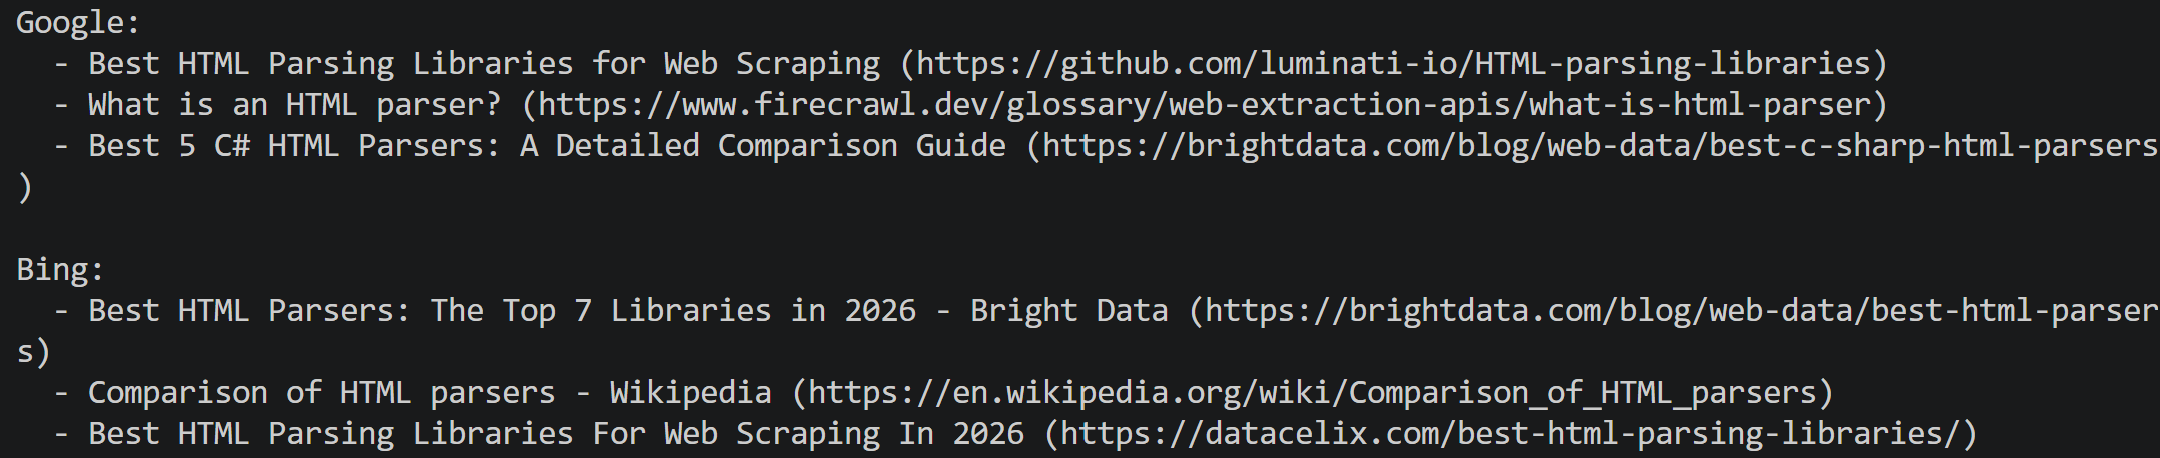
        # Imprime os três principais resultados de cada mecanismo de busca
        for name, result in [("Google", google), ("Bing", bing)]:
            print(f"\n{name}:")
            for item in result.data[:3]:
                print(f"  - {item['title']} ({item['url']})")

asyncio.run(main())
Google e Bing retornam resultados orgânicos de pesquisa processados com campos como title e url. Você pode acessar esses dados diretamente, por exemplo, para imprimir os três principais resultados:
Obter Informações Completas de Produtos da Amazon
Fazer scraping da Amazon é mais do que coletar dados estruturados de uma página de produto. Também pode envolver a extração de avaliações de produtos, que fornecem informações valiosas para avaliação de produtos, análise de sentimento, monitoramento e mais.
Graças às diferentes Scraper APIs da Bright Data, você pode recuperar tanto informações de produtos quanto avaliações através do SDK, como mostrado abaixo:
# pip install brightdata-sdk

import asyncio
from brightdata import BrightDataClient

product_url = "https://www.amazon.com/dp/B0DCH8VDXF/"

async def main():
    async with BrightDataClient() as client:
        # Recupera tanto os dados do produto quanto das avaliações
        product = await client.scrape.amazon.products(url=product_url)
        reviews = await client.scrape.amazon.reviews(url=product_url, pastDays=30, keyWord="quality")

        # Imprime os dados coletados
        print(f"Título: {product.data['title']}")
        print(f"Preço: {product.data['final_price']}")
        print(f"Avaliação: {product.data['rating']}")
        print(f"Avaliações obtidas: {len(reviews.data)}")

asyncio.run(main())
O script utilizou as opções de filtragem de client.scrape.amazon.reviews() para recuperar apenas avaliações dos últimos 30 dias que contenham a palavra-chave “quality”.
A saída será assim:

Nota: Os valores retornados dependem do produto e do horário da solicitação.
Fazer Parsing de uma Página Desbloqueada com BeautifulSoup
Um roteiro comum de scraping de dados envolve:
- Recuperar uma página web.
- Fazer parsing dela com um parser de HTML.
- Extrair os dados necessários.
O problema é que muitos sites usam medidas anti-scraping que podem bloquear solicitações automatizadas de conteúdo HTML. Uma solução possível é acessar essas páginas através de um serviço como a Bright Data Web Unlocker API, que lida com fingerprinting de navegador, rotação de proxy, resolução de CAPTCHA e outros desafios.
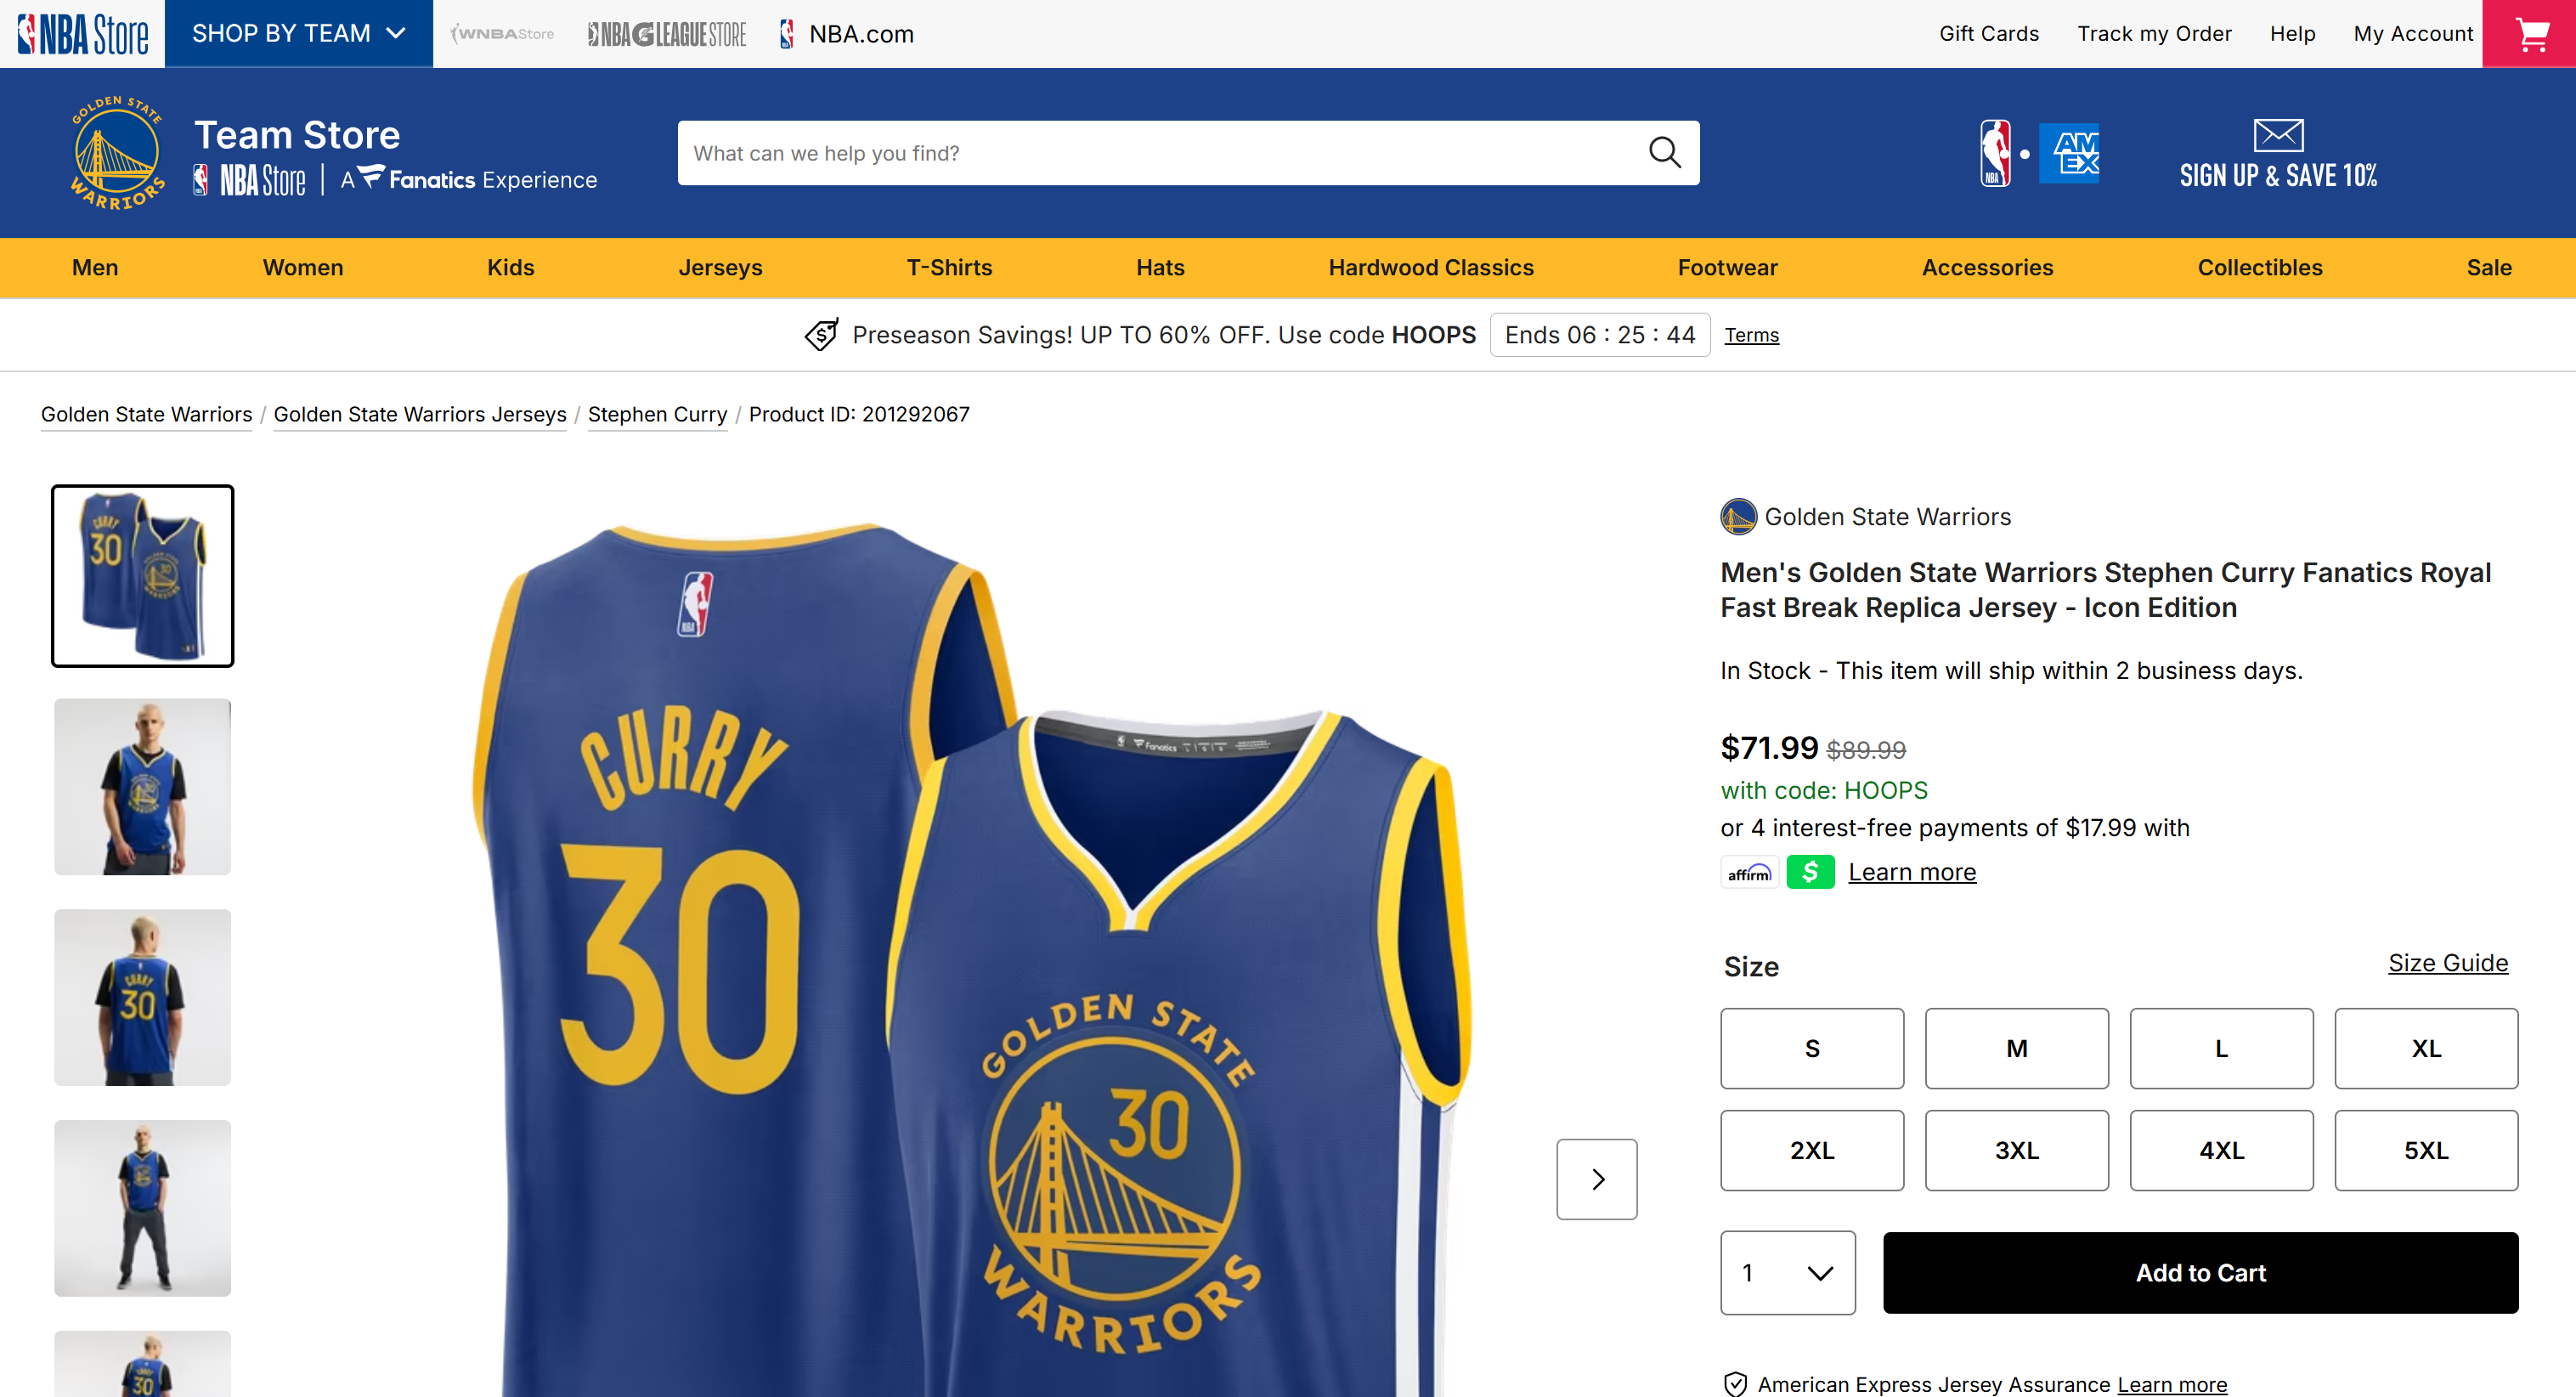
Por exemplo, suponha que você queira recuperar uma página de produto da NBA Store para uma camisa do Golden State Warriors de Stephen Curry e coletar seu nome, marca, preço, disponibilidade e tamanhos disponíveis.
O script a seguir usa o método scrape_url() do SDK para buscar a página, carrega o HTML retornado no BeautifulSoup e extrai os campos do produto:
# pip install brightdata-sdk beautifulsoup4

import asyncio
from brightdata import BrightDataClient
from bs4 import BeautifulSoup
import json


NBA_PRODUCT_URL = (
    "https://store.nba.com/golden-state-warriors/mens-golden-state-warriors-stephen-curry-"
    "fanatics-royal-fast-break-replica-jersey-icon-edition/t-14140641+p-138834682113177+z-9-2551128663"
    "?_ref=p-SFLP:m-GRID:i-r0c0:po-0"
)

async def main():
    # Busca a página via scrape_url() para evitar anti-bots
    async with BrightDataClient() as client:
        result = await client.scrape_url(NBA_PRODUCT_URL)

    # Carrega o HTML no BeautifulSoup para fazer o parsing
    soup = BeautifulSoup(result.data, "html.parser")

    # Extrai o nome do produto do título principal da página
    title = soup.find("h1", attrs={"data-talos": "labelPdpProductTitle"}).get_text(strip=True)

    # Encontra o bloco JSON-LD que descreve o produto
    product_ld_data = None
    for script in soup.find_all("script", type="application/ld+json"):
        data = json.loads(script.string)
        if data.get("@type") == "Product":
            product_ld_data = data
            break

    # Acessa alguns dados dele
    brand = product_ld_data["brand"]
    images = product_ld_data["image"]

    # Lê o preço e disponibilidade da primeira oferta
    offer = product_ld_data["offers"][0]
    price = offer["priceSpecification"]["price"]
    currency = offer["priceSpecification"]["priceCurrency"]
    availability = offer["availability"].rsplit("/", 1)[-1]

    # Extrai os tamanhos, que são botões, e seu texto visível é o rótulo do tamanho (S, M, L, ...)
    sizes = [b.get_text(strip=True) for b in soup.find_all("button", attrs={"data-talos": "buttonSize"})]

    # Coleta os dados obtidos
    product = {
        "title": title,
        "brand": brand,
        "images": images,
        "price": price,
        "currency": currency,
        "availability": availability,
        "sizes": sizes,
    }

    # Imprime os dados coletados
    print(json.dumps(product, indent=2))

asyncio.run(main())
A saída será assim:
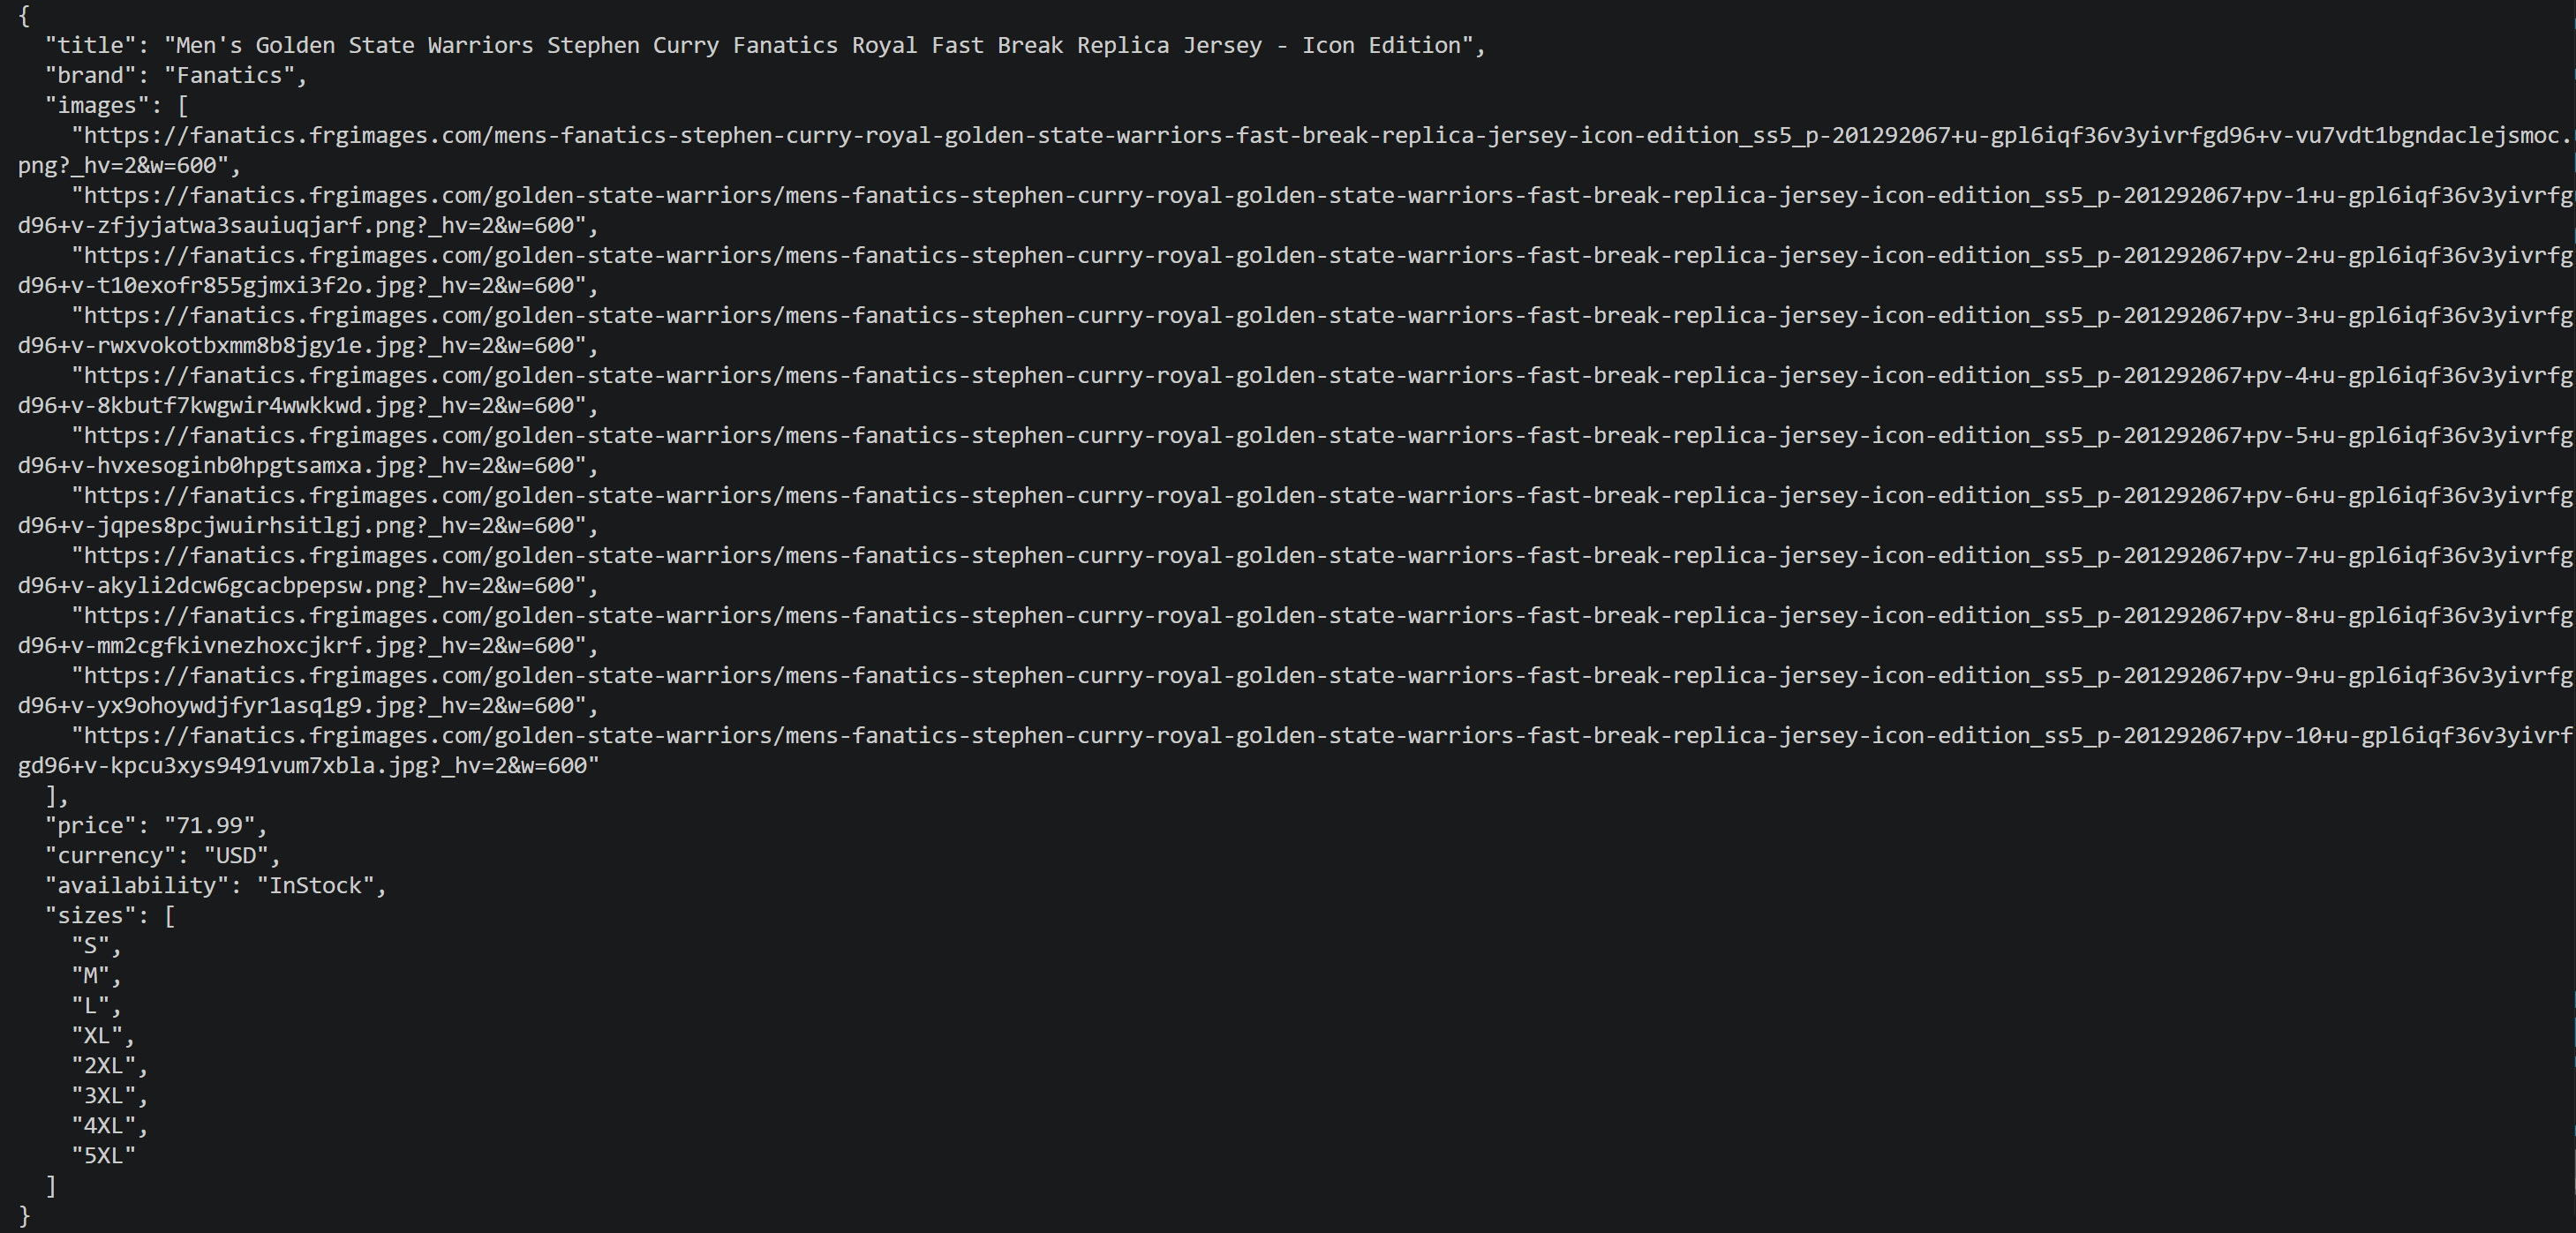
Esses campos correspondem às informações exibidas na página alvo.
Conclusão
Nesta publicação do blog, você aprendeu como o SDK Python da Bright Data fornece um único pacote Python para acessar os produtos de scraping, pesquisa e conjuntos de dados da Bright Data. Você também viu como instalar o SDK e usá-lo em cenários reais.
Para saber mais, explore a documentação oficial, o repositório no GitHub e o diretório de exemplos, que contém scripts funcionais para cada recurso. Se você achar o SDK útil, considere dar uma estrela ao repositório!
Crie uma conta Bright Data hoje mesmo e experimente o SDK Python para simplificar o acesso às APIs da Bright Data.
Perguntas Frequentes
Por que o SDK Python da Bright Data é útil?
Ele oferece aos desenvolvedores Python um único pacote consistente para fazer scraping de sites, executar consultas de mecanismos de busca, contornar detecção de bots e CAPTCHAs, extrair dados estruturados de plataformas e acessar mais de 100 conjuntos de dados prontos. Graças a ele, você não precisa construir essa infraestrutura sozinho.
Preciso do CLI da Bright Data para usar o SDK?
Não. O SDK funciona com um token de API definido em BRIGHTDATA_API_KEY ou BRIGHTDATA_API_TOKEN. Se você já executou brightdata login, o SDK recorre às credenciais armazenadas pelo CLI, então você não precisa configurar mais nada.
Qual é a diferença entre o CLI da Bright Data, o SDK Python, o MCP e as Agent Skills?
O CLI executa comandos da Bright Data a partir do seu terminal. O SDK Python permite que seu código Python chame as APIs. O servidor MCP da Bright Data fornece ferramentas de scraping e pesquisa para agentes de IA, e as Agent Skills ensinam agentes de codificação a usar a Bright Data.
Qual é a diferença entre o SDK Python da Bright Data e o SDK JavaScript da Bright Data?
O SDK Python (brightdata-sdk, instalado com pip) oferece clientes síncronos e assíncronos com métodos em snake_case como scrape_url(). O SDK JavaScript (@brightdata/sdk, instalado com npm) roda no Node.js e usa métodos em camelCase como scrapeUrl().
Quando devo usar o modo síncrono ou assíncrono?
Use o cliente síncrono para scripts simples e verificações rápidas, já que cada chamada bloqueia até que o resultado esteja pronto. Use o cliente assíncrono para cargas de trabalho de alta concorrência, tarefas em lote e processamento em segundo plano.