


Crawler do Twitter
Faça crawling do X (antigo Twitter) em grande escala em posts e perfis. Colete dados públicos como ID do post, autor, texto do post, data de publicação, fotos, posts citados, nome do perfil, biografia, status de verificação e muito mais.

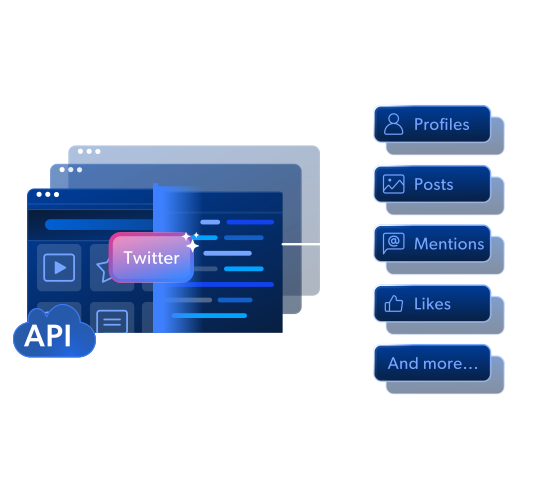
- Scrape sob demanda via API ou sem código
- Raspagem 100% ética e em conformidade
- Recuperar resultados em múltiplos formatos
- Solicitações em massa, até 5K URLs
Aprovado por 50,000+ clientes em todo o mundo.


Crawlers de Twitter disponíveis
 11.1K+
 1.2K+

Só quer dados do Twitter? Pule o crawling.
Compre um conjunto de dados do Twitter
Preços do Crawler Twitter
Pague apenas pelo que for entregue com sucesso. Sem taxas ocultas, sem cobranças por entregas falhas.

- Pague apenas pelo sucesso, sem taxas ocultas
- Comece grátis com 5.000 créditos mensais
- Sem compromisso inicial, cancele quando quiser
- Suporte especializado 24/7 e recursos empresariais

EXEMPLOS DE CÓDIGO
Faça crawling de dados do Twitter facilmente sem se preocupar em ser bloqueado.
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://x.com/FabrizioRomano/status/1683559267524136962","country":""},{"url":"https://x.com/FabrizioRomano/status/1552015619251634176","country":""},{"url":"https://x.com/FabrizioRomano/status/1665296716721946625","country":""},{"url":"https://x.com/CNN/status/1796673270344810776","country":""},{"url":"https://x.com/elonmusk/status/1587911540770222081","country":""}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_lwxkxvnf1cynvib9co&format=json&uncompressed_webhook=true"[
{
"timestamp": "2026-10-22",
"id": "1969079755266736458",
"user_posted": "Ene***a_A***",
"name": "Sec***arí***e E*********",
"description": "Argentina profundiza su perfil exportador de energía \n\nEn agosto, el país alcanzó los USD 1.056 millones en exportacione...",
"date_posted": "2025-09-19T16:42:52.000Z",
"photos": [
"https:\/\/pbs.twimg.com\/media\/G1OTmSkW8AERdLE.jpg"
],
"url": "https:\/\/x.com\/LuisCaputoAR\/status\/1969079755266736458"
},
{
"timestamp": "2026-10-22",
"id": "1922001569333051469",
"user_posted": "Fre***Sta***DF",
"name": "Bulldog F********n",
"description": "🚨It all kicks off TOMORROW!🚨\n\nFresno State Coaches are hitting the road and heading to a Central Valley town near YOU....",
"date_posted": "2025-05-12T18:50:57.000Z",
"photos": [
"https:\/\/pbs.twimg.com\/media\/GqxSPOZbAAA7UDw.jpg"
],
"url": "https:\/\/x.com\/FresnoStateFB\/status\/1922001569333051469"
},
{
"timestamp": "2026-10-22",
"id": "1898923042417279278",
"user_posted": "mul***y",
"name": "John M*****y",
"description": "We take calls.",
"date_posted": "2025-03-10T02:25:08.000Z",
"photos": [
"https:\/\/pbs.twimg.com\/media\/GlpUcS6XsAAt4LS.jpg"
],
"url": "https:\/\/x.com\/netflix\/status\/1898923042417279278"
},
{
"timestamp": "2026-10-22",
"id": "1831373364759580943",
"user_posted": "******",
"name": "******",
"description": "A visual feast.\nBehold the #LOrdeDior exhibition at Beijing\u0027s Guardian Art Center until September 29th, featuring a spec...",
"date_posted": "2024-09-04T16:46:50.000Z",
"photos": [
"https:\/\/pbs.twimg.com\/media\/GWpXC1NXcAA1xCC.jpg",
"https:\/\/pbs.twimg.com\/media\/GWpXEmrXIAEkrh3.jpg"
],
"url": "https:\/\/x.com\/LVMH\/status\/1831373364759580943"
},
{
"timestamp": "2026-10-22",
"id": "1876559886336811259",
"user_posted": "******",
"name": "******",
"description": "A true showcase of #DiorSavoirFaire at the @GoldenGlobes, Dior Ambassador Monica Barbaro\u0027s #DiorCouture gown by Maria Gr...",
"date_posted": "2025-01-07T09:21:56.000Z",
"photos": [
"https:\/\/pbs.twimg.com\/media\/GgrhP4FWgAAWVv1.jpg",
"https:\/\/pbs.twimg.com\/media\/GgrhP4DW4AAewxk.jpg"
],
"url": "https:\/\/x.com\/LVMH\/status\/1876559886336811259"
}
]curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://x.com/elonmusk","max_number_of_posts":100},{"url":"https://x.com/cnn","max_number_of_posts":20},{"url":"https://x.com/BillGates","max_number_of_posts":35},{"url":"https://x.com/fabrizioromano","max_number_of_posts":10}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_lwxmeb2u1cniijd7t4&format=json&uncompressed_webhook=true"[
{
"timestamp": "2026-10-22",
"x_id": "238725841",
"url": "https:\/\/x.com\/brunokoba_",
"id": "bru***oba***",
"profile_name": "Bruno K**a",
"biography": "Building @astorinvest | GSB \u002725",
"is_verified": true,
"profile_image_link": "https:\/\/pbs.twimg.com\/profile_images\/2025015124306829312\/PYI9TAib_normal.jpg"
},
{
"timestamp": "2026-10-22",
"x_id": "2081487773463146496",
"url": "https:\/\/x.com\/harveyiconea",
"id": "har***ico***",
"profile_name": "Har*** Ic***✨",
"biography": "Hot male, heavy pulsing 😈 — meet me in my page or TG https:\/\/t.co\/srpJ0DGhFg",
"is_verified": false,
"profile_image_link": "https:\/\/pbs.twimg.com\/profile_images\/2112858545603694592\/8ti3hfGA_normal.jpg"
},
{
"timestamp": "2026-10-22",
"x_id": "2081509053310570496",
"url": "https:\/\/x.com\/evangingerthi_b",
"id": "eva***nge***i_b***",
"profile_name": "Eva***ing***Thi*********",
"biography": "Ripped \u0026 ready, hard dick 🍆 — meet me in my page or TG https:\/\/t.co\/R9p9SvBGGP",
"is_verified": false,
"profile_image_link": "https:\/\/pbs.twimg.com\/profile_images\/2112864008369733632\/N6xxEyD8_normal.jpg"
},
{
"timestamp": "2026-10-22",
"x_id": "2081532514808532992",
"url": "https:\/\/x.com\/iambarbiehot",
"id": "iam***bie***",
"profile_name": "Bar*** Ho***",
"biography": "Sexy soft hung 😈 — TG https:\/\/t.co\/TlI9gBiAm9",
"is_verified": false,
"profile_image_link": "https:\/\/pbs.twimg.com\/profile_images\/2113114292962951168\/2EDAjcIS_normal.jpg"
},
{
"timestamp": "2026-10-22",
"x_id": "2081487793075650560",
"url": "https:\/\/x.com\/realharveyv",
"id": "rea***rve***",
"profile_name": "Har*** Ve***t ***",
"biography": "Muscular stud, rock cock 🍆 — slide to my page or TG https:\/\/t.co\/Y8w06ZTpJ6",
"is_verified": false,
"profile_image_link": "https:\/\/pbs.twimg.com\/profile_images\/2112858536959188992\/F2x-p_Sg_normal.jpg"
}
]API para Acesso Contínuo a Dados do Twitter
Extração de Dados Web Abrangente, Escalável e em Conformidade
API para Acesso Contínuo a Dados do Twitter
Adaptado ao seu fluxo de trabalho
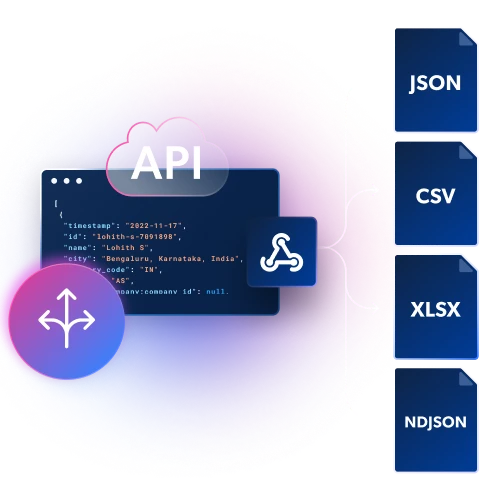
Obtenha dados estruturados em arquivos JSON, NDJSON ou CSV por meio de entrega via Webhook ou API.
Infraestrutura integrada e desbloqueio
Tenha controle e flexibilidade máximos sem manter infraestrutura de Proxy e desbloqueio. Faça scraping de dados de qualquer localização geográfica evitando CAPTCHAs e bloqueios.
Infraestrutura comprovada em batalha
A plataforma da Bright Data impulsiona mais de 20.000 empresas em todo o mundo, oferecendo tranquilidade com 99,99% de uptime e acesso a mais de 150 milhões de IPs reais de usuários em 195 países.
Conformidade líder do setor
Nossas práticas de privacidade estão em conformidade com as leis de proteção de dados, incluindo o marco regulatório de proteção de dados da UE, GDPR e CCPA.
API para Acesso Contínuo a Dados do Twitter


Crawling simplificado do Twitter
Casos de uso do crawling do Twitter
Descoberta de tendências
Encontre influenciadores
Monitore a reputação da marca
Liderando o caminho na coleta ética de dados da web
Estabelecemos o padrão-ouro para práticas éticas e conformes de dados da web. Nossa rede de peers é construída sobre confiança, com cada membro optando pessoalmente e a garantia de zero coleta de dados pessoais. Defendemos a coleta apenas de dados publicamente disponíveis, apoiada por um processo líder do setor de Verificação KYC e uma Política de Uso Aceitável transparente. Nossa equipe global e multilíngue de Conformidade e Ética, a primeira do seu tipo, garante que estejamos à frente das mudanças regulatórias e das melhores práticas.
Por que 50,000+ clientes escolhem a Bright Data

100% Conformidade

Suporte Global 24/7

Cobertura Completa de Dados

Qualidade de Dados Incomparável

Infraestrutura Poderosa

Soluções Personalizadas
A Bright Data é utilizada pelas principais marcas do mundo



Perguntas frequentes sobre o Crawler Twitter
O que é o crawler Twitter?
O crawler Twitter é uma ferramenta automatizada que descobre e coleta dados públicos do Twitter em escala. Você não precisa de uma lista completa de URLs. Pode começar com uma palavra-chave, uma categoria, uma URL de busca ou uma página específica. O crawler encontra os registros correspondentes e envia os dados de volta em um formato estruturado.
Qual é a diferença entre fazer crawling e scraping do Twitter?
Crawling é sobre descoberta: encontrar as páginas. Scraping é sobre extração: extrair campos específicos de uma página que você já conhece. Um scraper precisa que você informe qual URL visitar. Um crawler encontra os registros para você e depois extrai os dados. Use o crawler quando não tiver a lista completa de URLs, ou quando a lista estiver sempre mudando, como todos os itens de uma categoria ou todos os resultados de uma palavra-chave. Se você já tem as URLs exatas, coletar por URL é a opção mais direta.
Qual é a diferença entre o crawler Twitter e um conjunto de dados do Twitter?
Um conjunto de dados é dados que já foram coletados, e você compra como um arquivo pronto. O crawler coleta dados novos quando você o executa, com base nas suas próprias entradas. Escolha um conjunto de dados se quiser cobertura ampla imediatamente, sem configuração. Escolha o crawler se precisar de um escopo específico, dos dados mais recentes ou de coleta em uma programação que você controla.
Qual é a diferença entre o crawler Twitter e o uso de proxies?
Proxies são infraestrutura. Eles enviam suas solicitações por meio de diferentes endereços IP, mas você ainda precisa construir e manter o crawler, o parser e o desbloqueio. O crawler Twitter inclui tudo isso: gerenciamento de proxy, renderização completa de navegador, resolução de CAPTCHA, parsing de dados e entrega. Escolha proxies se quiser escrever e possuir o código. Escolha o crawler se quiser apenas os dados.
O crawler Twitter é o mesmo que a Crawl API da Bright Data?
Não. A Crawl API funciona em qualquer site público. Você fornece uma URL raiz, e ela retorna o conteúdo do site em Markdown, Texto, HTML ou JSON. O crawler Twitter é construído apenas para o Twitter. Ele retorna campos prontos para uso específicos do Twitter, para que você não precise escrever sua própria lógica de parsing.
Quais entradas posso usar para iniciar um crawl?
Depende do crawler escolhido. Pontos de partida comuns são uma URL direta, uma palavra-chave, uma URL de categoria, uma URL de busca, ou uma URL de perfil, vendedor ou loja. Você pode enviar até 5.000 URLs em uma única solicitação em lote.
Posso agendar crawls recorrentes do Twitter?
Sim. O crawler suporta coleta em lote e agendada, para que você possa reexecutar o mesmo crawl em intervalos regulares. Isso é útil para acompanhar mudanças ao longo do tempo, como preços, disponibilidade, classificações ou números de engajamento, sem precisar iniciar cada execução manualmente.
Preciso lidar com bloqueios, CAPTCHAs ou renderização de JavaScript?
Não. Gerenciamento de proxy, resolução de CAPTCHA e renderização completa de navegador já estão incluídos. O crawler funciona na rede da Bright Data com mais de 400 milhões de IPs de usuários reais em 195 países, para que você possa fazer crawling do Twitter de qualquer local sem manter sua própria infraestrutura de desbloqueio.
Como é o preço do crawler Twitter?
Você paga apenas pelos registros entregues com sucesso. Entregas malsucedidas nunca são cobradas. Você pode começar no plano gratuito com 5.000 registros por mês e sem cartão de crédito, e depois migrar para pagamento por uso ou um plano mensal conforme crescer. Detalhes dos planos estão na seção de preços acima.
É legal fazer crawling do Twitter?
O crawler coleta apenas dados disponíveis publicamente. As práticas de privacidade da Bright Data seguem leis de proteção de dados, incluindo GDPR e CCPA. Também existe um processo de Verificação KYC e uma Política de Uso Aceitável pública. Você ainda é responsável por garantir que o seu próprio uso dos dados esteja em conformidade com as leis aplicáveis a você.
Quer saber mais?
Fale com um especialista para discutir suas necessidades de crawling do Twitter