Fazer scraping do Yelp significa coletar listagens de empresas, avaliações e reviews para análise de sentimento, pesquisa de mercado ou leads de vendas. Os planos self-serve da API do Yelp incluíam no máximo 7 trechos de reviews por empresa, enquanto o yelp.com mostra o texto completo.
A proteção contra bots do Yelp retornou uma página de desafio para toda requisição HTTP em Python que enviamos. Um navegador Chromium local recebeu um CAPTCHA de slider. Mesmo quando uma página de empresa carregava, seu HTML não tinha o texto completo das reviews.
Este guia mostra onde o Yelp armazena seus dados e como coletar detalhes de empresas e reviews completas em Python. Também explica quando usar o Yelp Scraper API da Bright Data.
Resumo
- O DataDome, proteção contra bots do Yelp, bloqueou clientes HTTP em Python com um desafio JavaScript, mesmo com impersonação de TLS e IPs residenciais dos EUA. O Web Unlocker API da Bright Data carregou todas as 30 páginas de teste de empresas.
- Reviews completas vieram da API GraphQL do Yelp, até 49 por chamada. As 582 reviews recomendadas de um restaurante precisaram de 12 chamadas.
- O ID da query persistida pode mudar quando o Yelp faz deploy, e um script do Browser API captura o novo. Um scraper open-source publicou um ID desatualizado.
- O Yelp Scraper API da Bright Data cuida da manutenção do parser e do ID de query para você, com um preço maior por review. Também coleta reviews que o Yelp não recomenda.
O que bloqueia um scraper do Yelp
Em nossos testes, as páginas do Yelp eram protegidas pelo DataDome, um serviço comercial de proteção contra bots. As respostas bloqueadas incluíam seus headers (server: DataDome e x-datadome: protected) e definiam um cookie datadome.
Enviamos requisições para páginas de empresas do Yelp a partir de várias configurações de cliente. Os clientes incluíam curl_cffi, um cliente HTTP Python que imita o handshake TLS de um navegador.
Na banda larga residencial, toda configuração solicitou a mesma página. Através de proxies residenciais dos EUA, cada cliente solicitou 12 páginas diferentes. Nenhuma das configurações passou pelo desafio:
| Cliente | Rede | O que o Yelp retornou |
|---|---|---|
requests e httpx (HTTP/2) |
Banda larga residencial fora dos EUA | Página CAPTCHA 403, 5 de 5 cada |
curl_cffi com perfil TLS Chrome, Safari ou Firefox |
Banda larga residencial fora dos EUA | Página de verificação de dispositivo 403, 5 de 5 cada |
curl_cffi com perfil TLS Chrome e User-Agent Python |
Banda larga residencial fora dos EUA | Página CAPTCHA 403, 5 de 5 |
requests e curl_cffi |
Proxies residenciais dos EUA, novo IP por requisição | Página de verificação de dispositivo 403, 12 de 12 cada |
| Playwright com Chromium headless | Banda larga residencial fora dos EUA | Página CAPTCHA 403 |
| Playwright com Chromium com interface | Banda larga residencial fora dos EUA | Verificação de dispositivo primeiro, depois um CAPTCHA de slider em até 8 segundos |
Todo corpo 403 dessas configurações era a página de desafio do DataDome. A página incorporava um objeto var dd={...}, e o campo rt do objeto mostrava o tipo de desafio. O valor c carregava o script CAPTCHA, e i carregava uma página de verificação de dispositivo.
Na conexão residencial, requests e httpx receberam c. Com um perfil TLS de navegador, o curl_cffi recebeu i, e com um User-Agent Python recebeu c novamente. Através de IPs residenciais dos EUA, a biblioteca requests também recebeu i. Forçar HTTP/1.1 no curl_cffi retornou a mesma página de verificação de dispositivo.
A verificação de dispositivo executava JavaScript, e um cliente HTTP não consegue executá-lo. Uma sessão de navegador com interface executou a verificação de dispositivo e depois recebeu este slider:
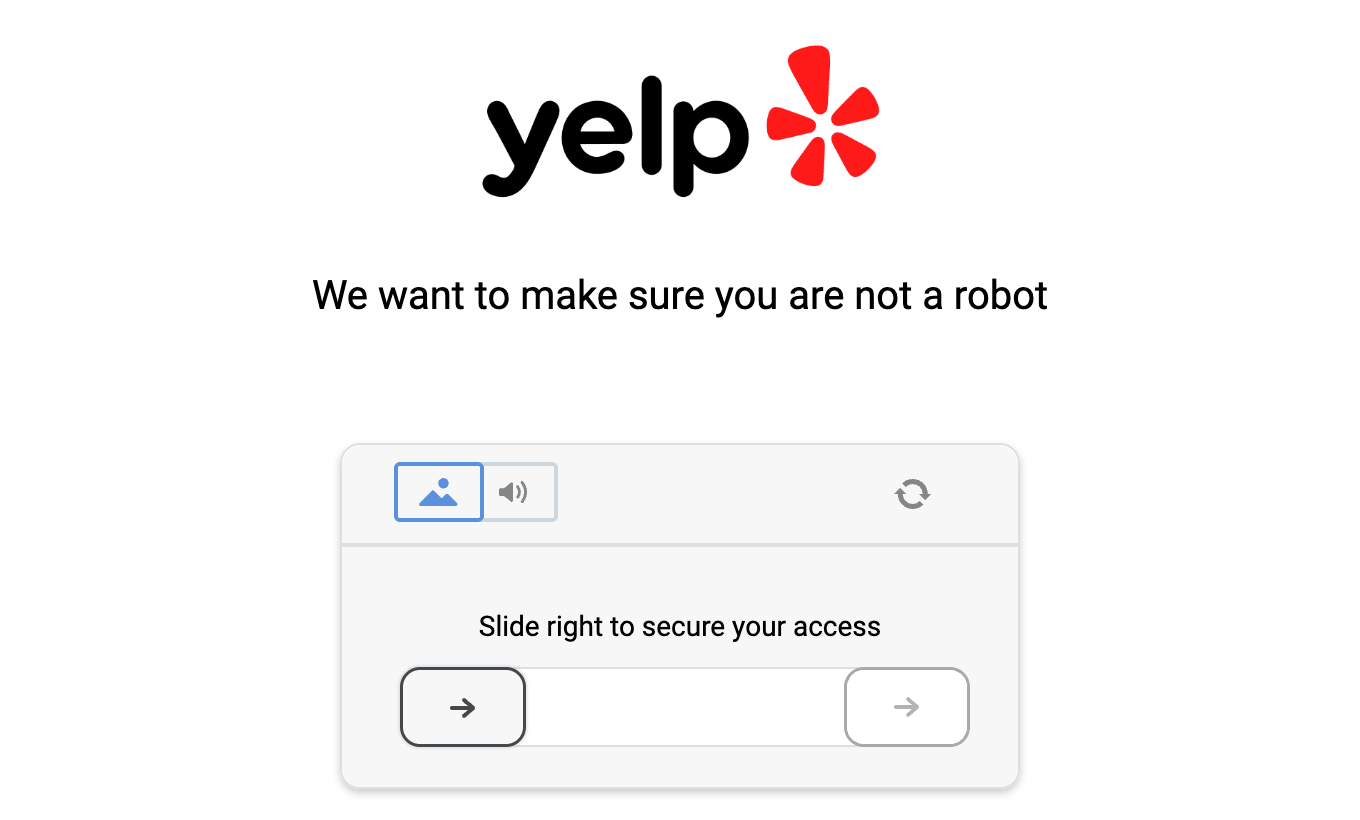
Uma sessão Chromium com interface em uma conexão residencial mostrou este slider em até 8 segundos após carregar a página. Se uma pessoa precisa arrastar o slider, um scraper não consegue rodar automaticamente.
Os clientes HTTP pararam em um desafio JavaScript que não conseguem executar, mesmo através de IPs residenciais dos EUA. Os navegadores conseguiam executar JavaScript, mas usavam um único IP residencial, e o Yelp retornava páginas CAPTCHA para esse IP. O Web Unlocker API da Bright Data cuida do ambiente de navegador, do IP e dos desafios DataDome para você, incluindo os CAPTCHAs no Yelp. Toda requisição ao Yelp no scraper em Python o utiliza.
Onde o Yelp armazena dados de empresas e reviews
O Browser API da Bright Data, um navegador em nuvem que você controla com Playwright, mostra como uma página de empresa do Yelp carrega seus dados. Um carregamento de página registrado enviou 12 requisições XHR e fetch para www.yelp.com, e 7 das 12 eram requisições POST para /gql/batch. Os dados estavam em 3 lugares:
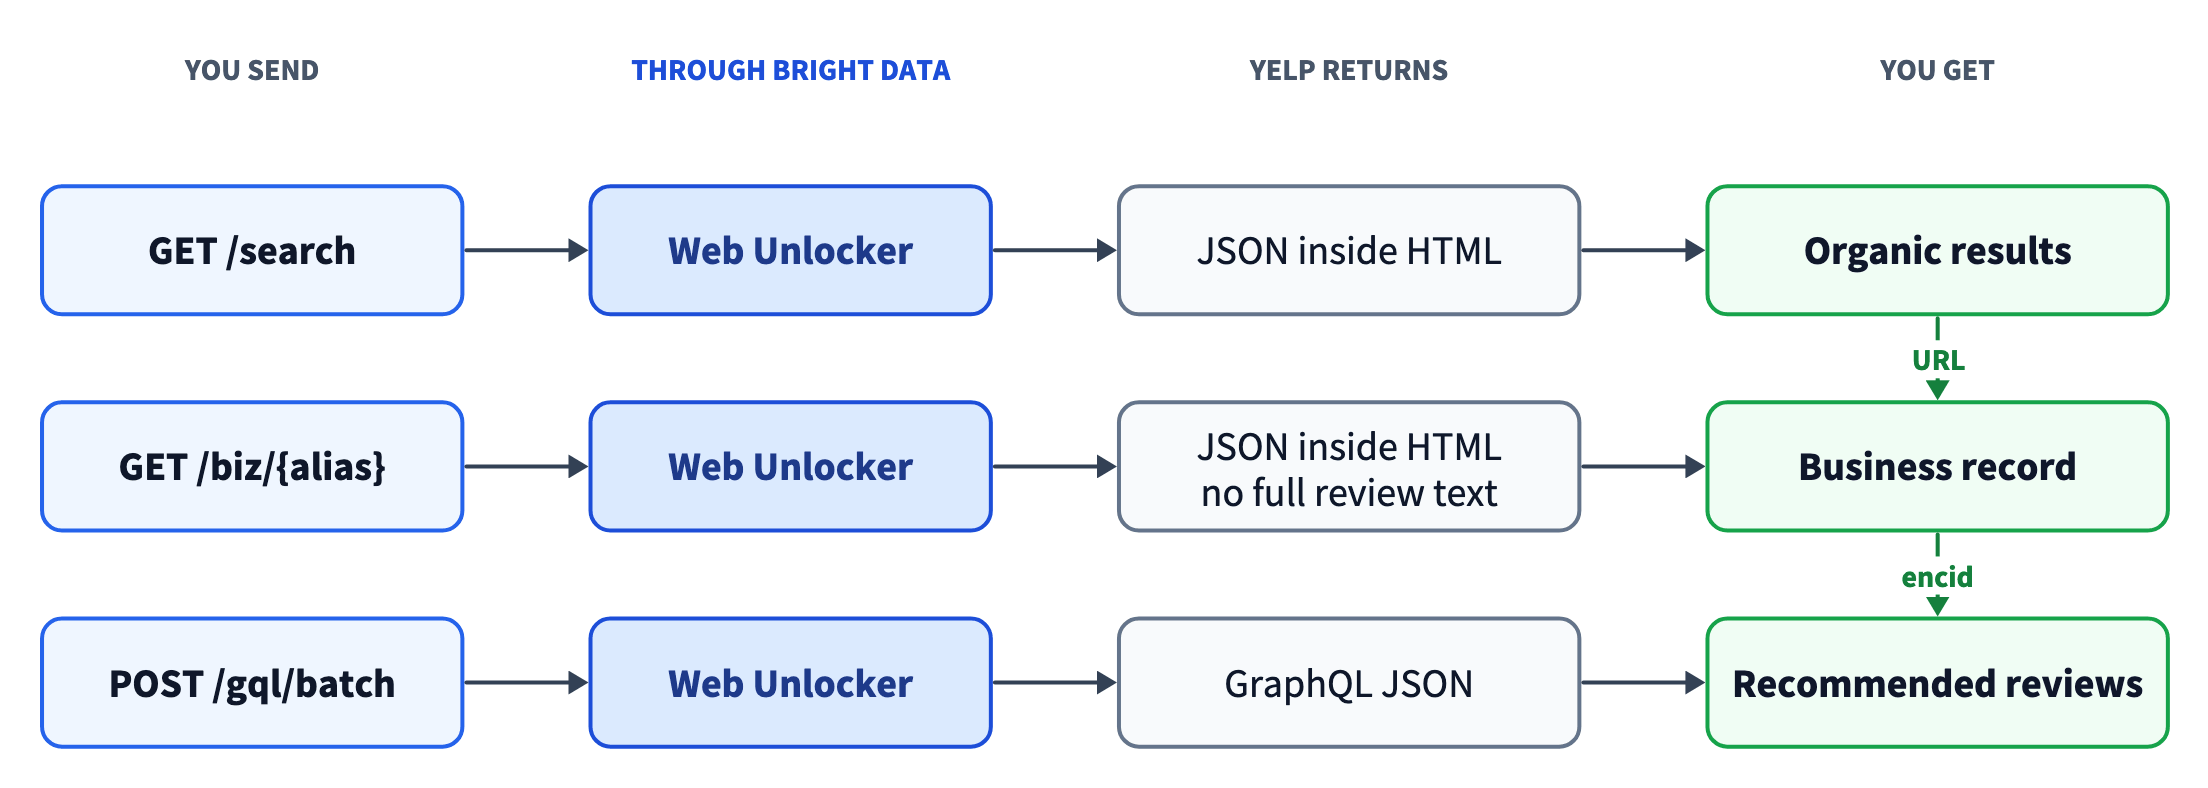
Páginas de busca e empresa continham seus dados como JSON dentro do HTML. Reviews precisavam de uma chamada GraphQL separada que usava o ID da empresa a partir da página.
Páginas de busca
O Yelp renderizava resultados de busca no servidor com Hypernova, que incorporava 2 objetos JSON no HTML. Uma tag <script data-hypernova-key> continha as props da página, incluindo a lista de cards de resultado. Uma tag <script data-apollo-state> continha um cache Apollo Client. Ambos os objetos JSON estavam envolvidos em um comentário HTML, e o cache Apollo também tinha escape HTML (").
Os 2 objetos dividiam cada resultado entre si. Um card orgânico incluía apenas seu bizId, posição e URL, enquanto o nome, a avaliação e a contagem de reviews estavam no cache Apollo sob Business:<bizId>. Cards patrocinados eram o inverso, com seus detalhes em linha e links através de /adredir. Um parser que lesse apenas os cards obteria detalhes completos para resultados patrocinados e nenhum nome, avaliação ou contagem de reviews para os orgânicos.
Na página de busca renderizada, os 2 tipos de card pareciam assim:
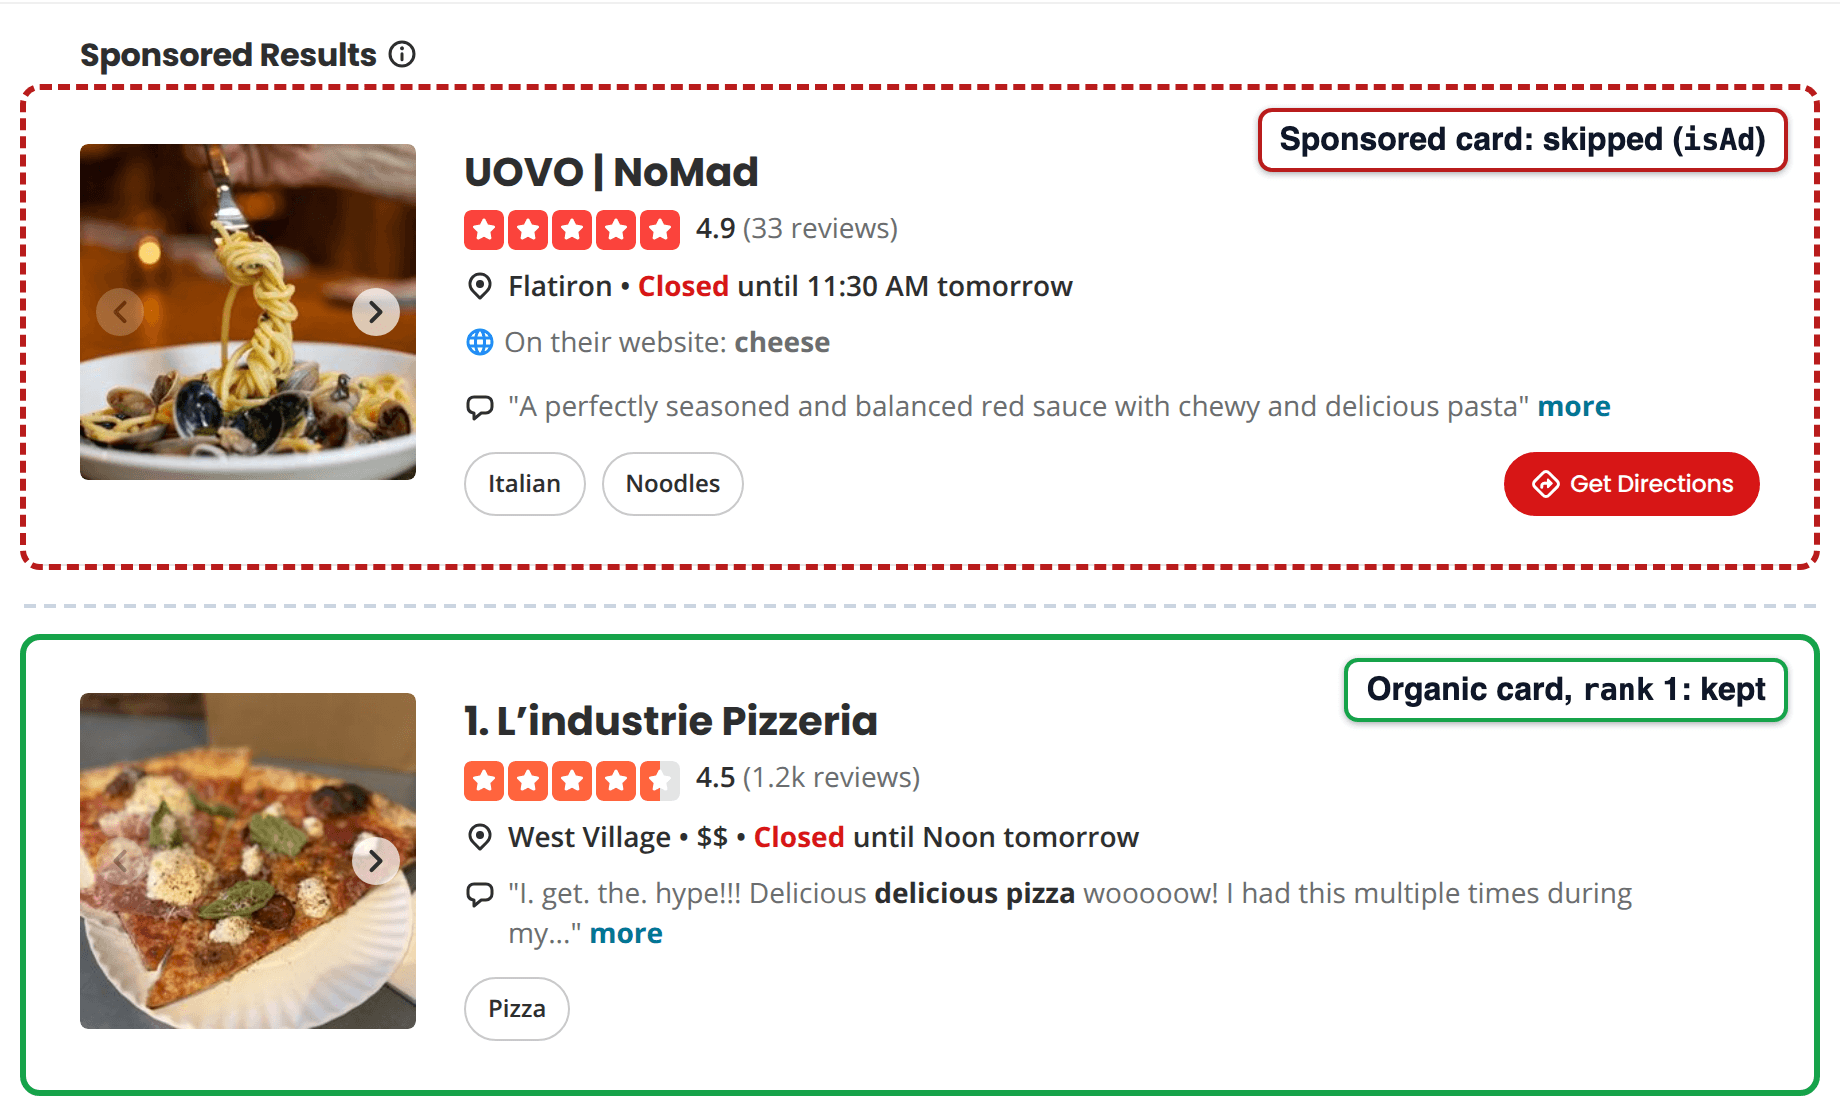
O Yelp listava resultados patrocinados antes dos resultados orgânicos numerados. parse_search() mantém a posição de cada card orgânico e pula qualquer card marcado como isAd.
A busca do Yelp também limitava o número de resultados. O bloco de paginação informava totalResults: 240 para todas as 4 queries que verificamos, incluindo “Restaurants” em Dallas, e cada página mostrava 10 resultados. Para coletar resultados de uma cidade inteira, divida a query por bairro, categoria ou área do mapa.
Páginas de empresa
Uma página de empresa continha o mesmo cache Apollo, e esse cache tinha a maioria dos campos da empresa. Incluía o ID da empresa (encid), avaliação, contagem de reviews, endereço, telefone, faixa de preço, categorias, status de reivindicação e site. A tag <meta name="yelp-biz-id"> também continha o encid. Cards de busca chamam o mesmo ID de bizId, e a requisição GraphQL o chama de encBizId.
Na página da L’industrie Pizzeria, esses campos apareciam no cabeçalho e na barra lateral:
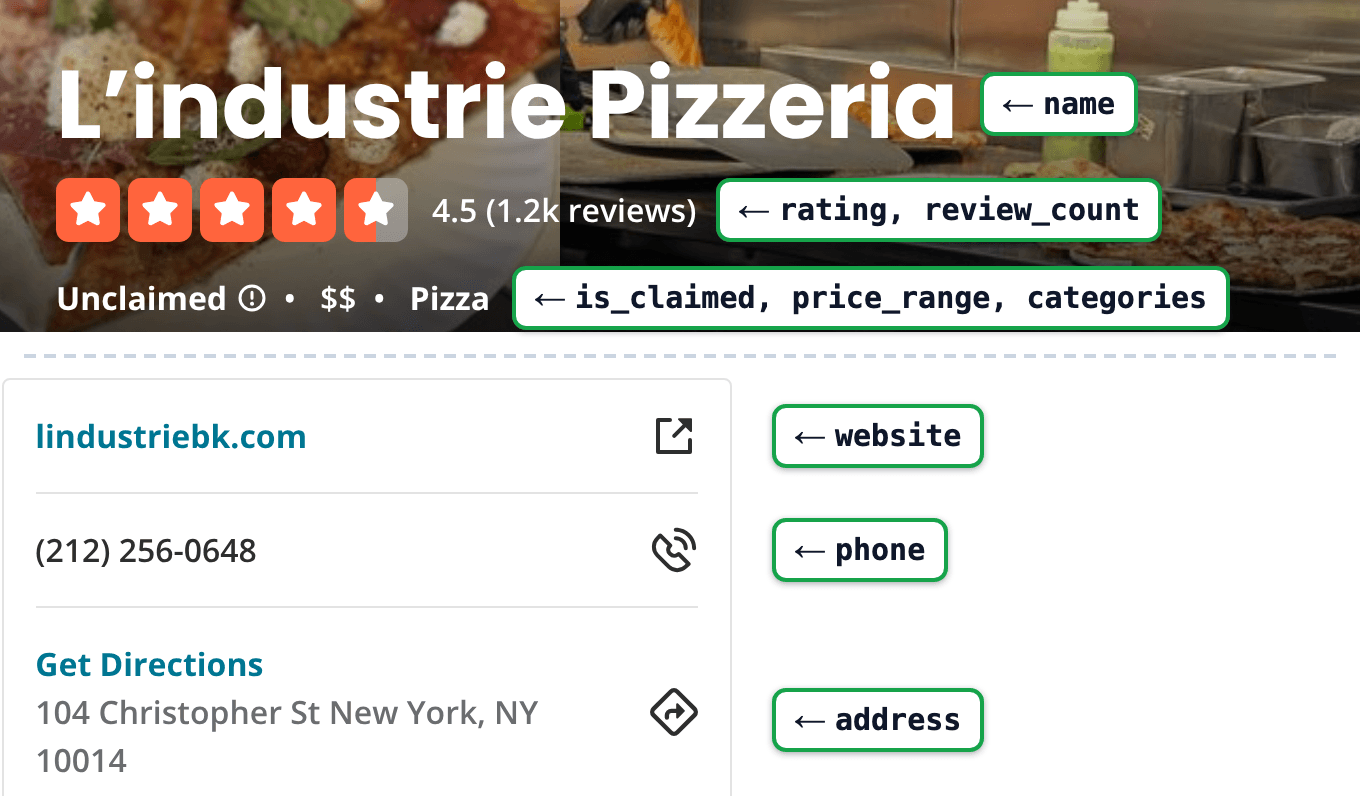
Os rótulos são as chaves que parse_business() retorna, e todo valor veio do cache Apollo no HTML da página. A página arredondou a contagem de reviews para 1.2k, enquanto o cache tinha o número exato.
Guias mais antigos liam a avaliação do JSON-LD e liam as reviews da própria página. Nas 19 páginas de empresa que salvamos, os blocos JSON-LD continham apenas listas de fotos e breadcrumbs, sem avaliação da empresa. O cache Apollo não continha texto completo de review em nenhuma das 19 páginas.
Em 14 dessas páginas, o cache tinha IDs de review e trechos curtos de destaque, e as outras 5 não tinham referências de review. A lista completa de reviews carregava depois, através de uma requisição GraphQL do navegador.
Reviews na API GraphQL
As reviews vinham do endpoint GraphQL do Yelp. A página enviava um POST para /gql/batch com um array JSON de operações, e a operação GetBusinessReviewFeed retornava a lista de reviews. O Yelp usava queries persistidas, então a requisição continha um ID de query persistida (documentId) de 64 caracteres em vez do texto da query. O servidor rejeitava IDs que não reconhecia.
Abrir a página 2 das reviews enviou esta requisição, mostrada aqui no Chrome DevTools:
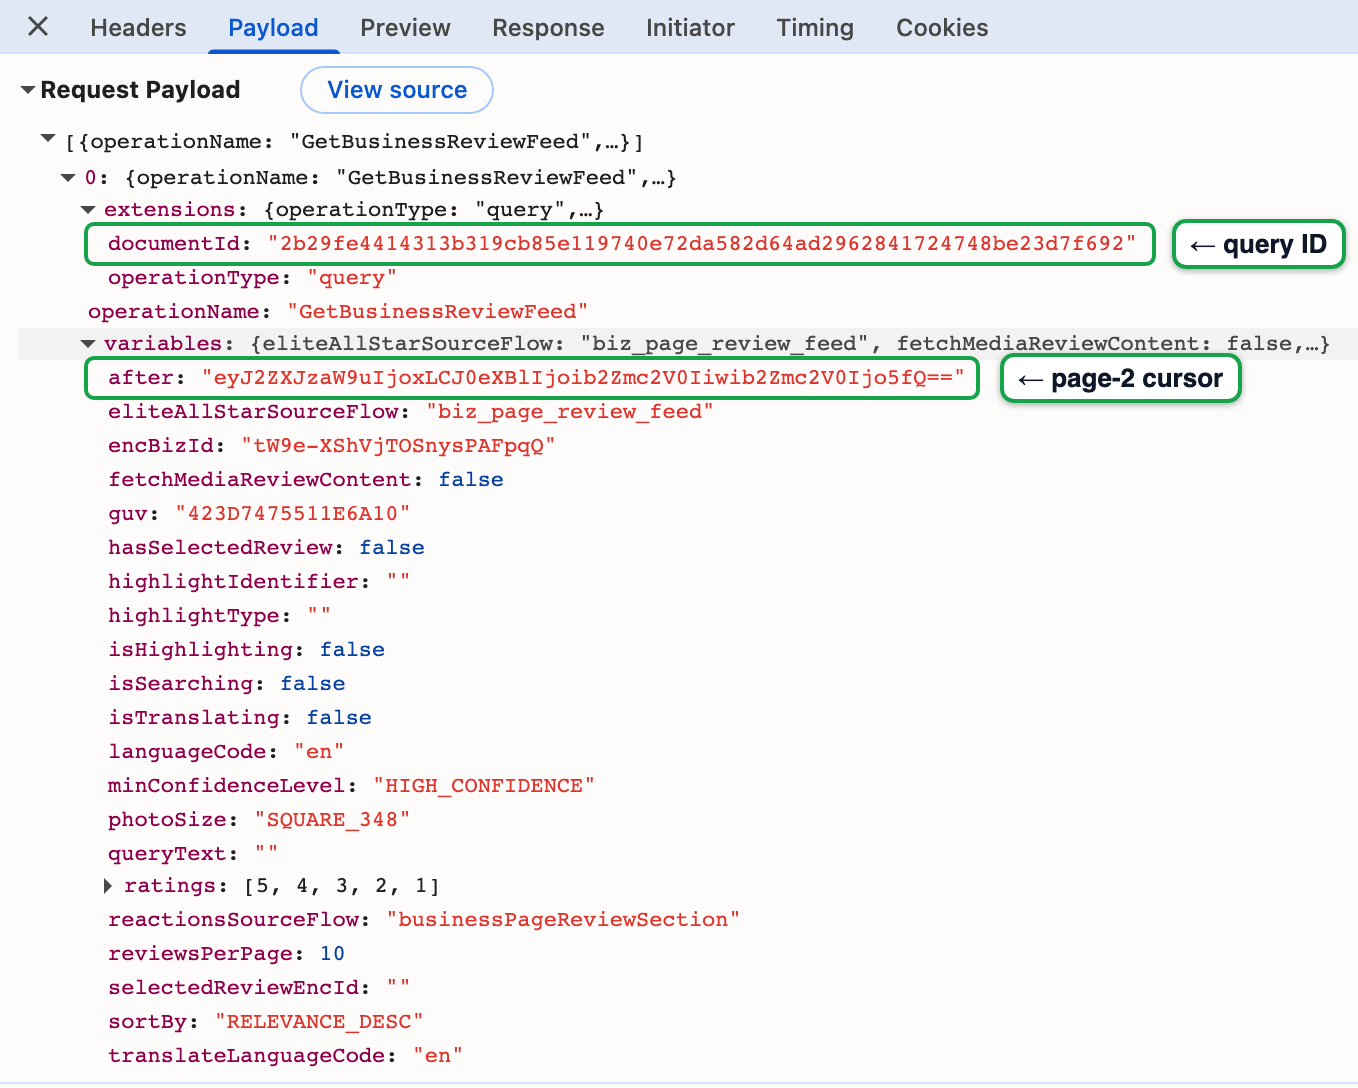
A própria requisição da página para a review página 2. O scraper envia o mesmo documentId e constrói o cursor after ele mesmo.
A API GraphQL se comportou assim em nossos testes:
- Tamanho da página:
reviewsPerPageaceitava 49. Um valor de 50 retornava um erroBAD_USER_INPUT. - Paginação: o cursor
afterera JSON codificado em base64. O navegador solicitava 10 reviews por página, e seu cursor da página 2 decodificava para{"version":1,"type":"offset","offset":9}. Esse formato permite construir o cursor de cada página você mesmo e buscar as páginas em paralelo. - Ordenação e filtros:
sortByaceitavaRELEVANCE_DESC,DATE_DESC,DATE_ASC,RATING_ASC, eELITES_DESC. Um valorratingsde[1]reduziutotalCountpara 35. Essa é a contagem de reviews de 1 estrela no Ziziki’s em Dallas, o restaurante que usamos para os testes GraphQL. - Erros: erros de validação eram retornados em uma resposta HTTP 200 e listavam cada variável ausente. Um
documentIddesconhecido recebeu uma resposta HTTP 403Forbiddenno navegador. Através do Web Unlocker, a mesma requisição retornou502com código de errohttp_status, o que significa que o Yelp retornou um status de erro. Nenhuma das respostas continha a página de desafio do DataDome, então um ID desatualizado não parece um bloqueio. - Escopo:
GetBusinessReviewFeedretornava as reviews recomendadas pelo Yelp, o conjunto que a página da empresa lista. Segundo o Yelp, seu software move reviews que marca como não confiáveis, solicitadas ou injustamente tendenciosas para uma lista separada de não recomendadas. Para o Ziziki’s,totalCountera 582, o cabeçalho da empresa mostrava 583, e a seção recolhida da página mostrava 39 reviews não recomendadas.
A página do Yelp mostrava a mesma divisão. Sob a paginação de reviews, uma seção recolhida mostrava o número de reviews que não recomendava:
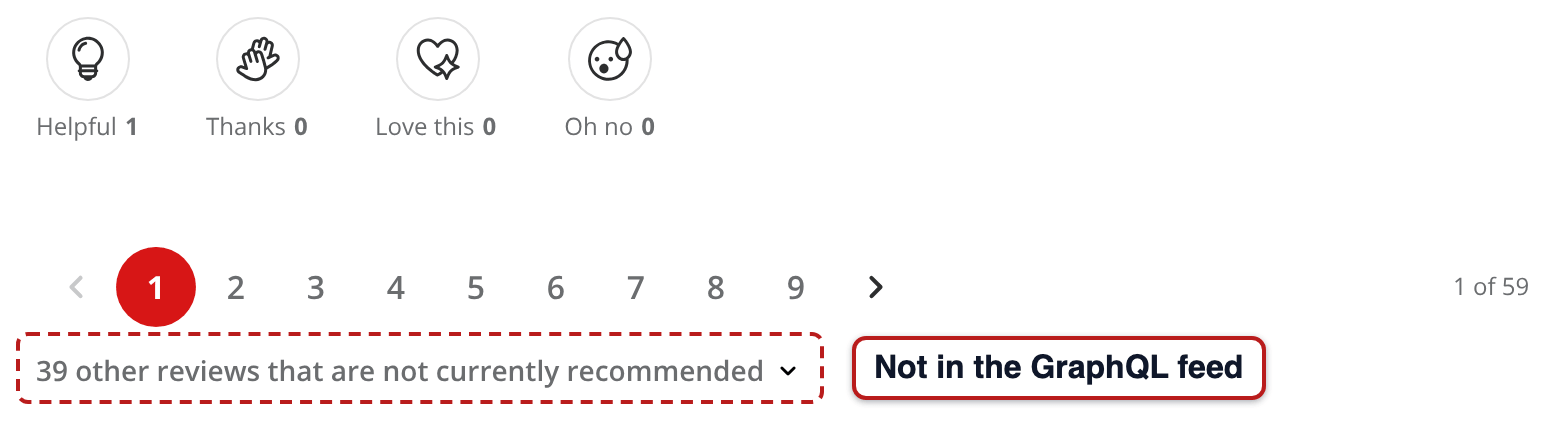
A página do Ziziki’s listava 59 páginas de reviews recomendadas, 10 por página, e mostrava mais 39 na seção recolhida.
O documentId pode mudar quando o Yelp lança novo código de frontend. Um scraper open-source popular do Yelp publicou um documentId, mas esse ID não correspondia mais ao que a página ao vivo enviava. Um script curto do Browser API, refresh_doc_id.py, captura o ID atual de uma página ao vivo, para que você possa atualizar o scraper depois que o Yelp lançar novo código.
Construa um scraper do Yelp em Python
O scraper solicita páginas de busca e empresa através do Web Unlocker com GET. Ele envia a requisição GraphQL para reviews como um POST com um corpo JSON.
O código gera um erro quando um objeto JSON ou uma chave obrigatória está ausente. Também gera um quando o ID de query persistida está desatualizado ou o Yelp rejeita uma variável GraphQL. Outras mudanças aparecem como campos vazios ou uma contagem de linhas abaixo de totalCount, então verifique ambos após cada execução.
Se você é novo em scraping de dados com Python, comece com nosso guia de scraping de dados com Python, que cobre os fundamentos. Você precisa do Python 3.10 ou posterior, do pacote requests e de uma conta Bright Data. Crie uma zona Web Unlocker, a configuração nomeada que cada requisição referencia, seguindo o guia rápido do Web Unlocker da Bright Data. Depois gere uma chave de API.
O plano gratuito inclui 5 mil créditos por mês, compartilhados entre as APIs de scraping da Bright Data. Cada requisição Web Unlocker ou registro entregue do Yelp Scraper API usa 1 crédito. O Web Unlocker cobra apenas por requisições bem-sucedidas. Instale a dependência e exporte sua chave de API e nome de zona:
pip install requests
export BRIGHTDATA_API_KEY="your_api_key"
export BRIGHTDATA_UNLOCKER_ZONE="web_unlocker"
Requisições Web Unlocker e Browser API ao Yelp precisam de uma conta com acesso total. Contas em modo de acesso imediato, que não exige verificação KYC, seguem o robots.txt. O robots.txt do Yelp desautorizava crawlers que não nomeava quando o lemos.
Você obtém acesso total após verificação KYC ou através do seu gerente de conta. Até lá, o Web Unlocker retorna um erro ub_bad_endpoint_robots para URLs do Yelp, e o Browser API retorna um erro brob.
Busque páginas através do Web Unlocker
O helper envia cada URL por POST ao endpoint /request do Web Unlocker e retorna o corpo da resposta do alvo, com até 3 tentativas por URL. Salve-o como a primeira parte de yelp_scraper.py:
import base64
import html
import json
import os
import re
import time
import urllib.parse
from concurrent.futures import ThreadPoolExecutor

import requests

API_KEY = os.environ["BRIGHTDATA_API_KEY"]
ZONE = os.environ.get("BRIGHTDATA_UNLOCKER_ZONE", "web_unlocker")

# ID de query persistida da operação GetBusinessReviewFeed do Yelp.
# Pode mudar quando o Yelp faz deploy. refresh_doc_id.py o captura.
REVIEW_FEED_DOC_ID = os.environ.get(
    "YELP_REVIEW_FEED_DOC_ID",
    "2b29fe4414313b319cb85e119740e72da582d64ad2962841724748be23d7f692",
)
PAGE_SIZE = 49  # a API GraphQL do Yelp rejeitou 50 com BAD_USER_INPUT


class FetchError(Exception):
    pass


def unlock(url, method="GET", body=None, attempts=3):
    """Busca uma URL através do Web Unlocker; retorna o corpo da resposta do alvo."""
    payload = {"zone": ZONE, "url": url, "format": "raw",
               "country": "us", "method": method}
    if body is not None:
        payload["body"] = json.dumps(body)
        payload["headers"] = {"content-type": "application/json"}
    last_error = None
    for attempt in range(attempts):
        try:
            r = requests.post(
                "https://api.brightdata.com/request",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json=payload,
                timeout=180,
            )
            # r.status_code informa sobre a chamada da API em si.
            # O status do próprio alvo está em x-brd-status-code.
            status = r.headers.get("x-brd-status-code", str(r.status_code))
            if status == "200" and r.text:
                return r.text
            last_error = f"{status} {r.headers.get('x-brd-error-code')}"
        except requests.RequestException as exc:
            last_error = type(exc).__name__
        if attempt < attempts - 1:
            time.sleep(2 ** attempt)
    raise FetchError(f"{url}: {last_error}")
Em um teste separado de 30 páginas de empresas do Yelp, unlock() carregou todas as páginas.
Faça parsing de detalhes da empresa a partir do cache Apollo
Adicione este parser a yelp_scraper.py. Ele extrai o cache Apollo, encontra a empresa sobre a qual a página trata e achata seus campos em um único registro:
def embedded_json(page, marker, escaped):
"""Retorna o JSON que o Yelp envolve em <!-- --> dentro de uma tag <script>."""
m = re.search(
r"<script[^>]*" + marker + r"[^>]*>\s*<!--(.*?)-->\s*</script>",
page,
re.S,
)
if not m:
raise FetchError(f"{marker} ausente: bloqueio brando ou mudança de markup")
raw = html.unescape(m.group(1)) if escaped else m.group(1)
return json.loads(raw)
def apollo_state(page):
# O cache Apollo tinha escape HTML (") dentro de um comentário HTML.
return embedded_json(page, "data-apollo-state", escaped=True)
def parse_business(page):
state = apollo_state(page)
ref = next(v["__ref"] for k, v in state["ROOT_QUERY"].items()
if k.startswith("business("))
biz = state[ref]
loc = state[biz["location"]["__ref"]]
claim = next((v for k, v in biz.items()
if k.startswith("claimability(")), None) or {}
website = (biz.get("externalResources") or {}).get("website") or {}
return {
"encid": biz["encid"],
"alias": biz["alias"],
"name": biz["name"],
"rating": biz["rating"],
"review_count": biz["reviewCount"],
"price_range": (biz.get("priceRange") or {}).get("display"),
"phone": (biz.get("phoneNumber") or {}).get("formatted"),
"address": loc["address"]["formatted"].replace("\n", ", "),
"neighborhoods": loc.get("neighborhoods"),
"categories": [state[c["__ref"]]["title"] for c in biz["categories"]],
"is_claimed": claim.get("isClaimed"),
"is_closed": biz.get("isClosed"),
"website": website.get("url"),
}
def get_business(url):
return parse_business(unlock(url))O Apollo armazena objetos relacionados uma única vez e aponta para eles com chaves __ref, então o parser segue location e categories até suas próprias entradas. Algumas chaves incluíam seus argumentos de query, como claimability({"useConsumerClaimability":true}), então o código combina essas chaves por prefixo. O parser leu todas as 19 páginas de empresa salvas sem erro.
Faça scraping de reviews do Yelp a partir da API GraphQL
Para fazer scraping de reviews do Yelp, envie uma requisição com o encid da empresa, o documentId persistido e as variáveis que a query espera. A próxima parte de yelp_scraper.py constrói o cursor de offset ela mesma, então toda página após a primeira roda em paralelo. O cursor do Yelp continha o offset da última review da página anterior, então review_page() passa start - 1:
def review_cursor(offset):
    # O cursor "after" do Yelp é JSON base64 com um offset numérico dentro.
    raw = json.dumps({"version": 1, "type": "offset", "offset": offset},
                     separators=(",", ":"))
    return base64.b64encode(raw.encode()).decode()


def review_page(encid, start, sort_by="DATE_DESC"):
    variables = {
        "encBizId": encid,
        "reviewsPerPage": PAGE_SIZE,
        "after": review_cursor(start - 1) if start else None,
        "sortBy": sort_by,  # RELEVANCE_DESC, DATE_DESC, DATE_ASC, ...
        "ratings": [5, 4, 3, 2, 1],
        "queryText": "",
        "isSearching": False,
        "selectedReviewEncId": "",
        "hasSelectedReview": False,
        "isTranslating": False,
        "translateLanguageCode": "en",
        "isHighlighting": False,
        "highlightType": "",
        "highlightIdentifier": "",
        "photoSize": "SQUARE_348",
        "fetchMediaReviewContent": False,
        "eliteAllStarSourceFlow": "biz_page_review_feed",
        "reactionsSourceFlow": "businessPageReviewSection",
        "minConfidenceLevel": "HIGH_CONFIDENCE",
    }
    body = [{
        "operationName": "GetBusinessReviewFeed",
        "variables": variables,
        "extensions": {"operationType": "query",
                       "documentId": REVIEW_FEED_DOC_ID},
    }]
    try:
        raw = unlock("https://www.yelp.com/gql/batch", method="POST",
                     body=body)
    except FetchError as exc:
        # Através do Web Unlocker, um documentId desconhecido foi retornado como
        # 502 http_status, então a mensagem sugere atualizar o ID.
        raise FetchError(f"{exc} (documentId desatualizado? rode refresh_doc_id.py)")
    result = json.loads(raw)[0]
    # Erros GraphQL podem ser retornados em uma resposta HTTP 200.
    if result.get("errors"):
        raise FetchError(result["errors"][0]["message"])
    return result["data"]["business"]["reviews"]


def flatten_review(node):
    author = node.get("author") or {}
    # Campos do autor são dados pessoais, então descarte-os se você só precisa de sentimento.
    return {
        "review_id": node["encid"],
        "rating": node["rating"],
        "created_at": node["createdAt"]["localDateTimeForBusiness"],
        "text": (node.get("text") or {}).get("full"),
        "language": (node.get("text") or {}).get("language"),
        "author": author.get("displayName"),
        "author_location": author.get("displayLocation"),
        "author_review_count": author.get("reviewCount"),
    }


def get_reviews(encid, max_reviews=None, workers=4):
    first = review_page(encid, 0)
    total = first["totalCount"]
    if max_reviews:
        total = min(total, max_reviews)
    reviews = [e["node"] for e in first["edges"]]
    # Offsets são conhecidos com antecedência, então as páginas restantes rodam em paralelo.
    starts = range(PAGE_SIZE, total, PAGE_SIZE)
    with ThreadPoolExecutor(workers) as pool:
        for page in pool.map(lambda s: review_page(encid, s), starts):
            reviews += [e["node"] for e in page["edges"]]
    unique = {r["encid"]: flatten_review(r) for r in reviews}
    return list(unique.values())[:total], first["totalCount"]
get_reviews() coletou todas as 582 reviews recomendadas do Ziziki’s em 12 chamadas GraphQL, e as datas das reviews cobriam cerca de 20 anos.
O navegador também enviava um ID de visitante guv e um valor languageCode. A API GraphQL não exigia nenhum dos dois em nossos testes, então o código não os envia.
O valor created_at está no fuso horário local da empresa, com um offset como -05:00 ou -06:00 para Dallas, dependendo do horário de verão. Antes de comparar datas de reviews entre cidades, mantenha o offset ao armazenar cada valor, ou converta-o para UTC.
Descubra empresas a partir de resultados de busca
As funções até agora partem de uma URL de empresa que você já tem. Páginas de busca fornecem as URLs de empresas para get_business() e os valores encid para get_reviews(). Adicione as funções de busca a yelp_scraper.py também. O parser combina cada card orgânico com seu registro Apollo e pula cards patrocinados:
def parse_search(page):
    props = embedded_json(page, "data-hypernova-key", escaped=False)
    comps = (props["legacyProps"]["searchAppProps"]["searchPageProps"]
             ["mainContentComponentsListProps"])
    state = apollo_state(page)
    hits = []
    for comp in comps:
        section = comp.get("props") or {}
        if comp.get("type") != "searchResultSection":
            continue
        for item in section.get("searchResults", []):
            if item.get("isAd"):
                continue  # pula cards patrocinados
            # Pega detalhes do cache Apollo; cards orgânicos podem não tê-los.
            biz = state.get(f"Business:{item['bizId']}", {})
            hits.append({
                "rank": item.get("ranking"),
                "encid": item["bizId"],
                "name": biz.get("name"),
                "rating": biz.get("rating"),
                "review_count": biz.get("reviewCount"),
                "url": "https://www.yelp.com"
                       + item["businessUrl"].split("?")[0],
            })
    paging = next(c["props"] for c in comps if c.get("type") == "pagination")
    return hits, paging["totalResults"]


def search(term, location, pages=1):
    query = urllib.parse.urlencode({"find_desc": term, "find_loc": location})
    base = f"https://www.yelp.com/search?{query}"
    hits = []
    for n in range(pages):
        # A página 1 não tem parâmetro start, assim como um navegador a carrega.
        url = f"{base}&start={n * 10}" if n else base
        batch, total = parse_search(unlock(url))
        hits += batch
        if (n + 1) * 10 >= total:
            break
    return hits
search() envia a página 1 sem start, assim como um navegador carrega uma busca pela primeira vez. Ela para na última página que totalResults permite, então uma query que atinge o limite de 240 resultados do Yelp precisa de 24 páginas.
Execute o scraper do Yelp
O último bloco de yelp_scraper.py executa os passos em ordem. Ele busca 2 páginas de busca, 1 página de empresa e as 150 reviews mais recentes dessa empresa, e escreve as reviews em um arquivo JSON Lines:
if __name__ == "__main__":
    hits = search("Pizza", "Lower Manhattan, New York, NY", pages=2)
    print(f"{len(hits)} resultados orgânicos")
    for hit in hits[:3]:
        print(hit["rank"], hit["name"], hit["rating"], hit["review_count"])

    business = get_business(hits[0]["url"])
    print(json.dumps(business, indent=2, ensure_ascii=False))

    reviews, reported = get_reviews(business["encid"], max_reviews=150)
    print(f"coletadas {len(reviews)} de {reported} reviews")
    for r in reviews[:2]:
        print(r["created_at"], r["rating"], r["text"][:60])

    with open("reviews.jsonl", "w") as f:
        for row in reviews:
            f.write(json.dumps({"business": business["alias"], **row}) + "\n")
Execute o script a partir do diretório onde você o salvou. A primeira linha só imprime depois que ambas as páginas de busca carregam:
python yelp_scraper.pyA execução imprimiu os principais resultados de busca, o registro da empresa e as 2 primeiras reviews:
20 resultados orgânicos
1 L’industrie Pizzeria 4.5 1222
2 Prince Street Pizza 4.3 5720
3 Juliana's 4.4 2997
{
  "encid": "G9hV4H2iGpWD8RoUpjtokg",
  "alias": "l-industrie-pizzeria-new-york",
  "name": "L’industrie Pizzeria",
  "rating": 4.5,
  "review_count": 1222,
  "price_range": "$$",
  "phone": "(212) 256-0648",
  "address": "104 Christopher St, New York, NY 10014",
  "neighborhoods": [
    "West Village"
  ],
  "categories": [
    "Pizza"
  ],
  "is_claimed": false,
  "is_closed": false,
  "website": "http://lindustriebk.com"
}
coletadas 150 de 1220 reviews
2026-09-25T20:43:26-04:00 4 I arrived here on a Saturday afternoon and man what a line.
2026-09-25T20:37:09-04:00 4 The pizza was like 4.25/5, I came with locals and they said
A execução usou 7 requisições faturáveis (2 para páginas de busca, 1 para a página de empresa e 4 para chamadas GraphQL). A página da empresa reportava 1.222 reviews, enquanto o totalCount da API GraphQL era 1.220. Compare sua contagem de linhas com totalCount, não com o número na página, ao verificar se uma execução está completa.
Atualize o ID de query persistida quando o Yelp fizer deploy
Quando as chamadas de review começam a falhar com 502 http_status enquanto páginas de empresa ainda carregam, o documentId provavelmente mudou. Salve este script como refresh_doc_id.py. Ele abre uma única página de empresa no Browser API e rola até que a página envie a requisição GraphQL para reviews. Ele imprime o ID dessa requisição, ou None após 30 rolagens sem um:
import asyncio
import json
import os

from playwright.async_api import async_playwright

# Endpoint do Browser API da aba Overview da zona, com -country-us adicionado.
BROWSER_WSS = os.environ["BRIGHTDATA_BROWSER_WSS"]
BIZ_URL = "https://www.yelp.com/biz/zizikis-dallas-2"


async def capture_review_feed_doc_id():
    async with async_playwright() as p:
        browser = await p.chromium.connect_over_cdp(BROWSER_WSS)
        page = await browser.new_page()
        found = asyncio.get_running_loop().create_future()

        def on_request(request):
            if (request.url.endswith("/gql/batch")
                    and "GetBusinessReviewFeed" in (request.post_data or "")
                    and not found.done()):
                ops = json.loads(request.post_data)
                op = next(o for o in ops
                          if o["operationName"] == "GetBusinessReviewFeed")
                found.set_result(op["extensions"]["documentId"])

        page.on("request", on_request)
        await page.goto(BIZ_URL, wait_until="domcontentloaded",
                        timeout=120_000)
        # Rola até que a página envie a requisição GraphQL para reviews.
        for _ in range(30):
            if found.done():
                break
            await page.mouse.wheel(0, 1200)
            await page.wait_for_timeout(1500)
        await browser.close()
        return found.result() if found.done() else None


if __name__ == "__main__":
    print(asyncio.run(capture_review_feed_doc_id()))
Instale o Playwright com pip install playwright, e crie uma zona Browser API seguindo o guia rápido do Browser API da Bright Data. Depois defina BRIGHTDATA_BROWSER_WSS para o endpoint da zona, e adicione -country-us ao nome de usuário. O valor tem a forma wss://brd-customer-<id>-zone-<zone>-country-us:<password>@brd.superproxy.io:9222. A execução imprimiu o ID que o scraper já usa:
2b29fe4414313b319cb85e119740e72da582d64ad2962841724748be23d7f692Quando o ID impresso for diferente, exporte-o como YELP_REVIEW_FEED_DOC_ID e execute yelp_scraper.py novamente.
O Browser API cobra por GB de tráfego, e 6 carregamentos de páginas de empresa do Yelp tiveram em média cerca de 8 MB cada. O Web Unlocker cobra por requisição bem-sucedida. Use o Browser API apenas para a atualização ocasional do documentId, e envie requisições de páginas e reviews através do Web Unlocker.
Solucione erros comuns
Compare o que você vê com uma causa provável:
| O que você vê | Causa provável | O que fazer |
|---|---|---|
FetchError com 401 None ou 400 None |
Uma chave de API errada (401) ou nome de zona (400) | Verifique BRIGHTDATA_API_KEY, e defina BRIGHTDATA_UNLOCKER_ZONE para o nome exato da zona |
FetchError com ub_bad_endpoint_robots, ou brob do Browser API |
A conta está em modo de acesso imediato (sem KYC), que segue o robots.txt do Yelp | Complete a verificação KYC, ou peça acesso total ao seu gerente de conta |
FetchError com data-apollo-state missing ou data-hypernova-key missing |
Um bloqueio brando (uma página de bloqueio retornada com HTTP 200) ou uma mudança de markup | Salve o HTML que unlock() retornou e procure nele a tag <script> nomeada no erro |
Chamadas de review falham com 502 http_status enquanto páginas de empresa carregam |
Um novo documentId |
Execute refresh_doc_id.py e exporte o ID que ele imprime |
FetchError com uma mensagem de validação GraphQL |
Uma variável ausente ou fora do intervalo | Compare suas variáveis com o payload da página no DevTools |
Qualquer outro FetchError de unlock() |
A requisição falhou em todas as 3 tentativas | Tente a URL novamente depois, ou aumente attempts em unlock() |
Campos vazios, ou um KeyError ou StopIteration em um parser |
Uma chave renomeada no JSON do Yelp | Compare o JSON da página com as chaves que o parser lê |
Escale o scraping do Yelp com o Yelp Scraper API da Bright Data
Quando você escreve seu próprio scraper, também o mantém. O ID de query persistida, a lista de variáveis e os parsers dependem todos do frontend do Yelp, então cada um pode quebrar quando o Yelp lança mudanças de frontend.
O Yelp Scraper API, parte do Web Scraper API da Bright Data, recebe URLs do Yelp ou filtros de busca e retorna registros com parsing já feito. A Bright Data mantém os parsers conforme o frontend do Yelp muda. A Bright Data também oferece um scraper de imagens do Yelp dedicado e um servidor MCP do Yelp para agentes de IA.
O Yelp Scraper API também pode coletar reviews não recomendadas, que a query GetBusinessReviewFeed não retornou em nossos testes. O software do Yelp não recomendou 17% das reviews postadas em 2025, segundo seu Relatório de Confiança e Segurança de 2025.
Execute o Yelp Scraper API a partir do Python
No painel de controle, a biblioteca de scrapers lista os endpoints do Yelp. Os endpoints de empresa aceitam URLs, filtros de busca ou uma caixa delimitadora como entrada, e os endpoints de review aceitam URLs de empresa ou filtros de busca. Cada endpoint aceita uma lista de entradas e roda em modo síncrono ou assíncrono:
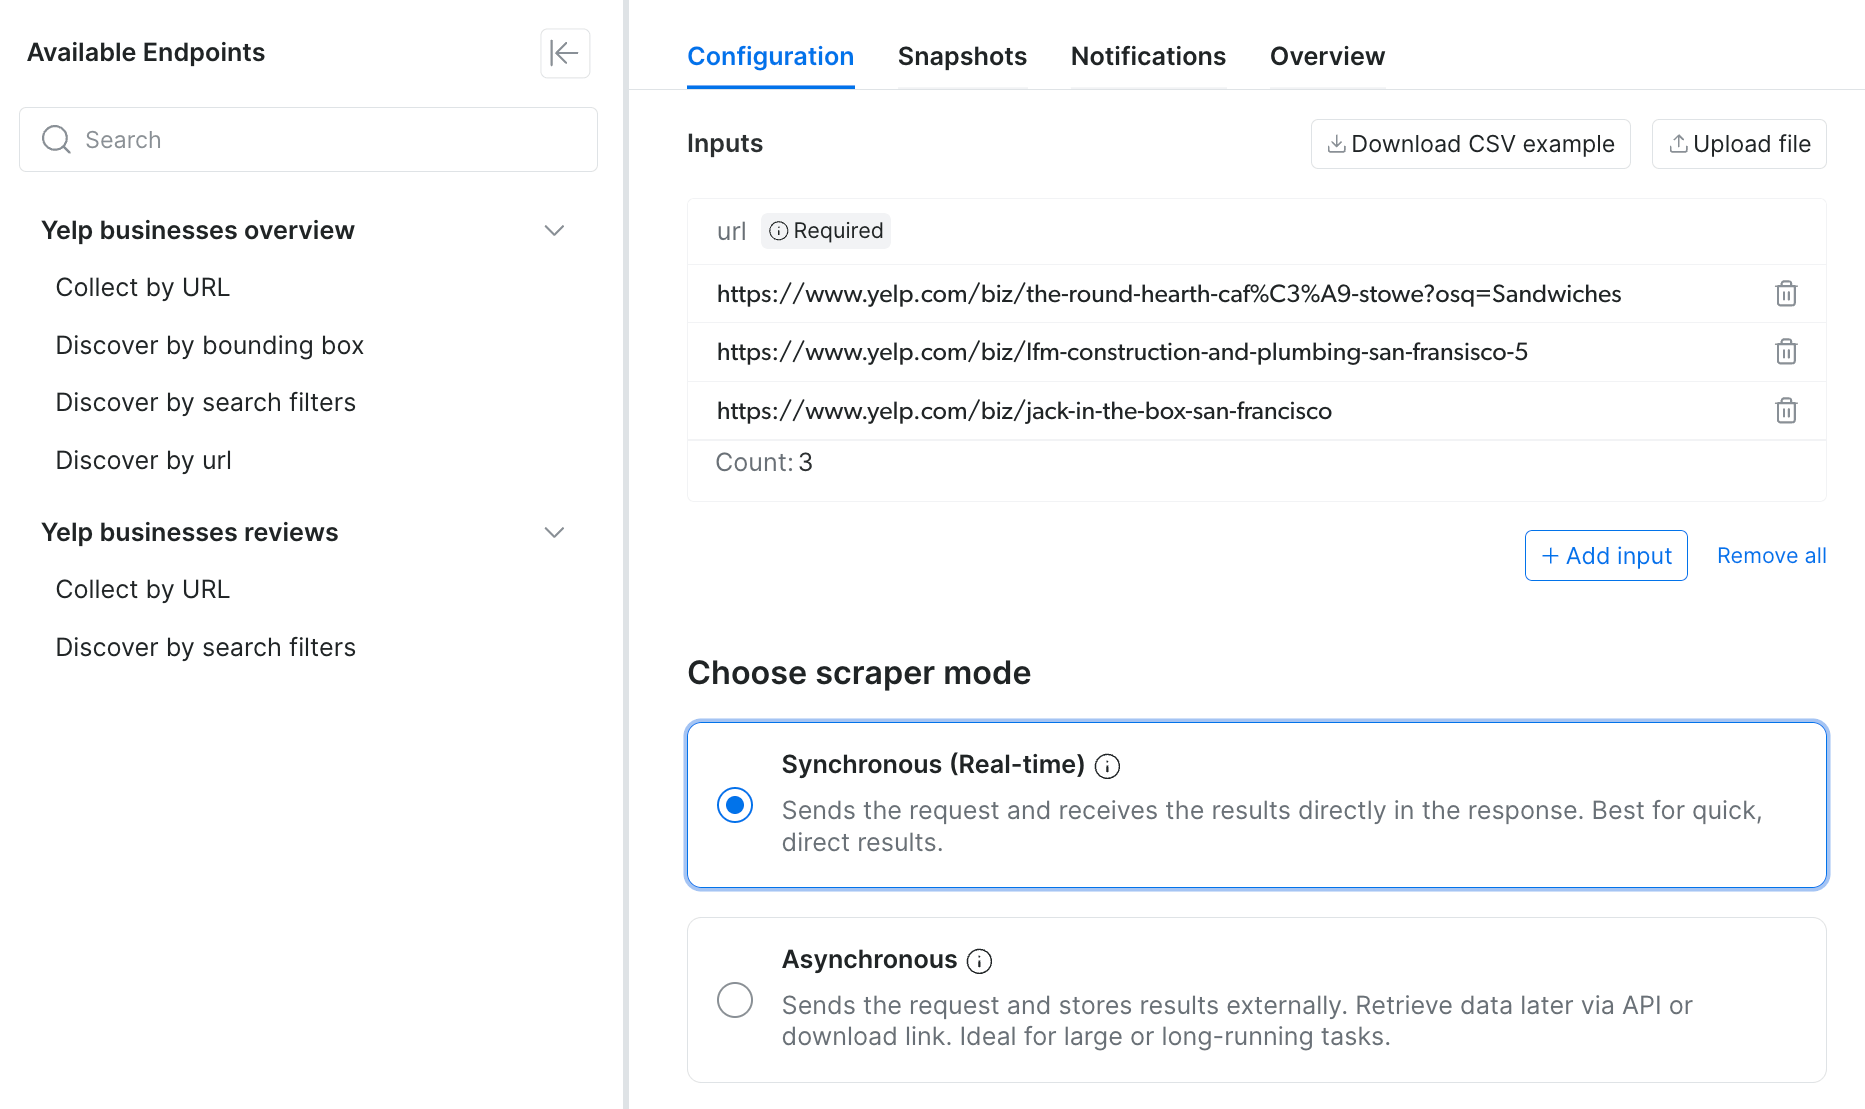
O endpoint Collect by URL para registros de empresa, com 3 entradas de exemplo e o modo Synchronous selecionado. Uma chamada síncrona que leva mais que seu limite de 1 minuto retorna um ID de snapshot em vez de registros, então scraper_api.py roda de forma assíncrona.
Você pode executar os mesmos scrapers a partir do Python através do endpoint de disparo assíncrono. Salve este script como scraper_api.py. Ele precisa apenas de BRIGHTDATA_API_KEY, porque chamadas do Scraper API não usam uma zona. Ele executa uma busca de descoberta por pizza em Brooklyn, NY, e depois coleta as 20 reviews mais recentes do primeiro resultado:
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}

YELP_BUSINESSES = "gd_lgugwl0519h1p14rwk"
YELP_REVIEWS = "gd_lgzhlu9323u3k24jkv"


def collect(dataset_id, inputs, limit_per_input=None, poll_every=15,
            **params):
    """Dispara um job do Scraper API, aguarda e retorna seus registros."""
    body = {"input": inputs}
    if limit_per_input:
        body["limit_per_input"] = limit_per_input
    r = requests.post(
        f"{API}/trigger",
        headers=HEADERS,
        params={"dataset_id": dataset_id, "include_errors": "true",
                **params},
        json=body,
        timeout=60,
    )
    r.raise_for_status()
    snapshot_id = r.json()["snapshot_id"]

    while True:
        progress = requests.get(f"{API}/progress/{snapshot_id}",
                                headers=HEADERS, timeout=60).json()
        if progress["status"] == "ready":
            break
        if progress["status"] in ("failed", "canceled"):
            raise RuntimeError(f"{snapshot_id}: {progress}")
        time.sleep(poll_every)

    records = requests.get(f"{API}/snapshot/{snapshot_id}",
                           headers=HEADERS, params={"format": "json"},
                           timeout=120).json()
    # Com include_errors=true, entradas que falharam são retornadas como registros de erro.
    errors = [x for x in records if x.get("error")]
    rows = [x for x in records if not x.get("error")]
    return rows, errors


if __name__ == "__main__":
    rows, errors = collect(
        YELP_BUSINESSES,
        [{"country": "US", "category": "Pizza",
          "location": "Brooklyn, NY, United States"}],
        limit_per_input=5,
        type="discover_new",
        discover_by="search_filters",
    )
    for row in rows:
        print(row["name"], row["overall_rating"], row["reviews_count"],
              row["url"])
    print(f"{len(rows)} empresas, {len(errors)} erros")
    if not rows:
        raise SystemExit("descoberta não retornou empresas")

    reviews, errors = collect(
        YELP_REVIEWS,
        [{"url": rows[0]["url"], "unrecommended_reviews": False,
          "sort_by": "DATE_DESC"}],
        limit_per_input=20,
    )
    print(f"{len(reviews)} reviews, {len(errors)} erros")
    for r in reviews[:1]:
        print(r["date_iso_format"], r["Rating"], r["Content"][:120])
YELP_BUSINESSES e YELP_REVIEWS são os IDs de conjunto de dados dos scrapers do Yelp da Bright Data, mostrados nos exemplos de API de cada scraper no painel de controle. collect() verifica o progresso de cada job a cada 15 segundos e retorna seus registros assim que o job está pronto. Para cada empresa descoberta, o script imprime o nome, avaliação, contagem de reviews e URL. Depois imprime o número de reviews e a data, avaliação e os primeiros 120 caracteres do texto da primeira review.
O Yelp Scraper API cobra apenas por entregas bem-sucedidas. limit_per_input define o número máximo de registros por entrada. Este script usa 5 para empresas e 20 para reviews, então uma execução de teste em uma empresa com 5 mil reviews não é cobrada por 5 mil registros. Entradas que um job não conseguiu coletar são retornadas como registros de erro que incluem sua entrada, prontos para reenvio.
Configure jobs de review e mapeie seus campos
Estes 3 detalhes afetam quais registros um job retorna e como você os lê:
unrecommended_reviewsselecionava 1 dos 2 conjuntos de reviews. Comtrue, um job retornava apenas reviews não recomendadas (recommended_review: false). Para coletar ambos os conjuntos, envie a URL da empresa uma vez com cada valor. Deixe o intervalo de datas vazio na entradatruepara coletar reviews não recomendadas de todas as datas.- Filtros de data em reviews recomendadas correspondiam à contagem GraphQL. Com
unrecommended_reviewsdefinido comofalsee um intervalo de datas destart_dateaend_date, o job retornou 6 reviews. O scraper GraphQL encontrou as mesmas 6 para esse intervalo. - Os rótulos de reação do Yelp mudaram ao longo do tempo. Registros recentes usavam
Helpful,Thanks,Love this, eOh no, enquanto reviews mais antigas do Yelp usavamuseful,funny, ecool. Mapeie ambos os conjuntos antes de comparar reações entre anos.
Para jobs recorrentes, o Yelp Scraper API entrega para um webhook, Amazon S3, Google Cloud Storage, Google Pub/Sub, Microsoft Azure Storage, Snowflake ou SFTP.
API do Yelp, scraper ou conjunto de dados: quanto custam 1 mil empresas
A opção certa depende de você precisar do texto completo das reviews e de quem mantém a coleta de dados. Esta tabela mostra o custo de uma única carga de trabalho, 1 mil empresas com 200 reviews cada, nos preços de tabela quando verificamos:
| Opção | Texto completo das reviews | Custo para 1 mil empresas e 200 mil reviews | Seu trabalho contínuo |
|---|---|---|---|
| Yelp Places API, plano Enhanced | Não, 3 trechos de cerca de 160 caracteres | $299 por mês, dentro das 30 mil chamadas incluídas | Seguir as regras de exibição e o limite de cache de 24 horas |
| Yelp Insights API, plano Premium | Sim | Orçamento personalizado da equipe de vendas do Yelp, a partir de $0,08 por local em base rotativa de 12 meses | Seguir os termos contratuais do Yelp |
| Seu próprio scraper no Web Unlocker | Sim, reviews recomendadas | $9 para 6 mil requisições (1 mil páginas de empresa e 5 mil chamadas GraphQL) a $1,5 por mil | Atualizar o ID de query persistida, variáveis e parsers quando o frontend do Yelp mudar |
| Yelp Scraper API da Bright Data | Sim, recomendadas e não recomendadas | $301,50 para 201 mil registros a $1,5 por mil | Gerenciar listas de entrada e entrega |
| Conjuntos de dados do Yelp da Bright Data | Sim, pré-coletados | Até $502,50 para 201 mil registros a até $0,0025 por registro (pedido mínimo de $250) | Nenhum trabalho de coleta, atualização mensal de dados |
O valor do Web Unlocker é baixo porque cada chamada GraphQL retornava até 49 reviews, e o Web Unlocker cobra apenas requisições bem-sucedidas. O Yelp Scraper API cobra por registro, então jobs com muitas reviews custam mais. Por esse preço, você não gasta tempo de engenharia com parsers ou IDs de query persistida.
A descoberta adiciona custo em ambas as opções. No Web Unlocker, você paga por páginas de busca, que mostravam 10 resultados cada. No Yelp Scraper API, você paga por registros de descoberta.
Os conjuntos de dados do Yelp da Bright Data funcionam bem para preenchimentos históricos. Eles incluem mais de 200 milhões de registros de reviews e mais de 9 milhões de registros de empresas. Um conjunto de dados de restaurantes do Yelp separado também está disponível.
Cada página de conjunto de dados no painel de controle mostra os campos, o preço e uma amostra de dados antes da compra:
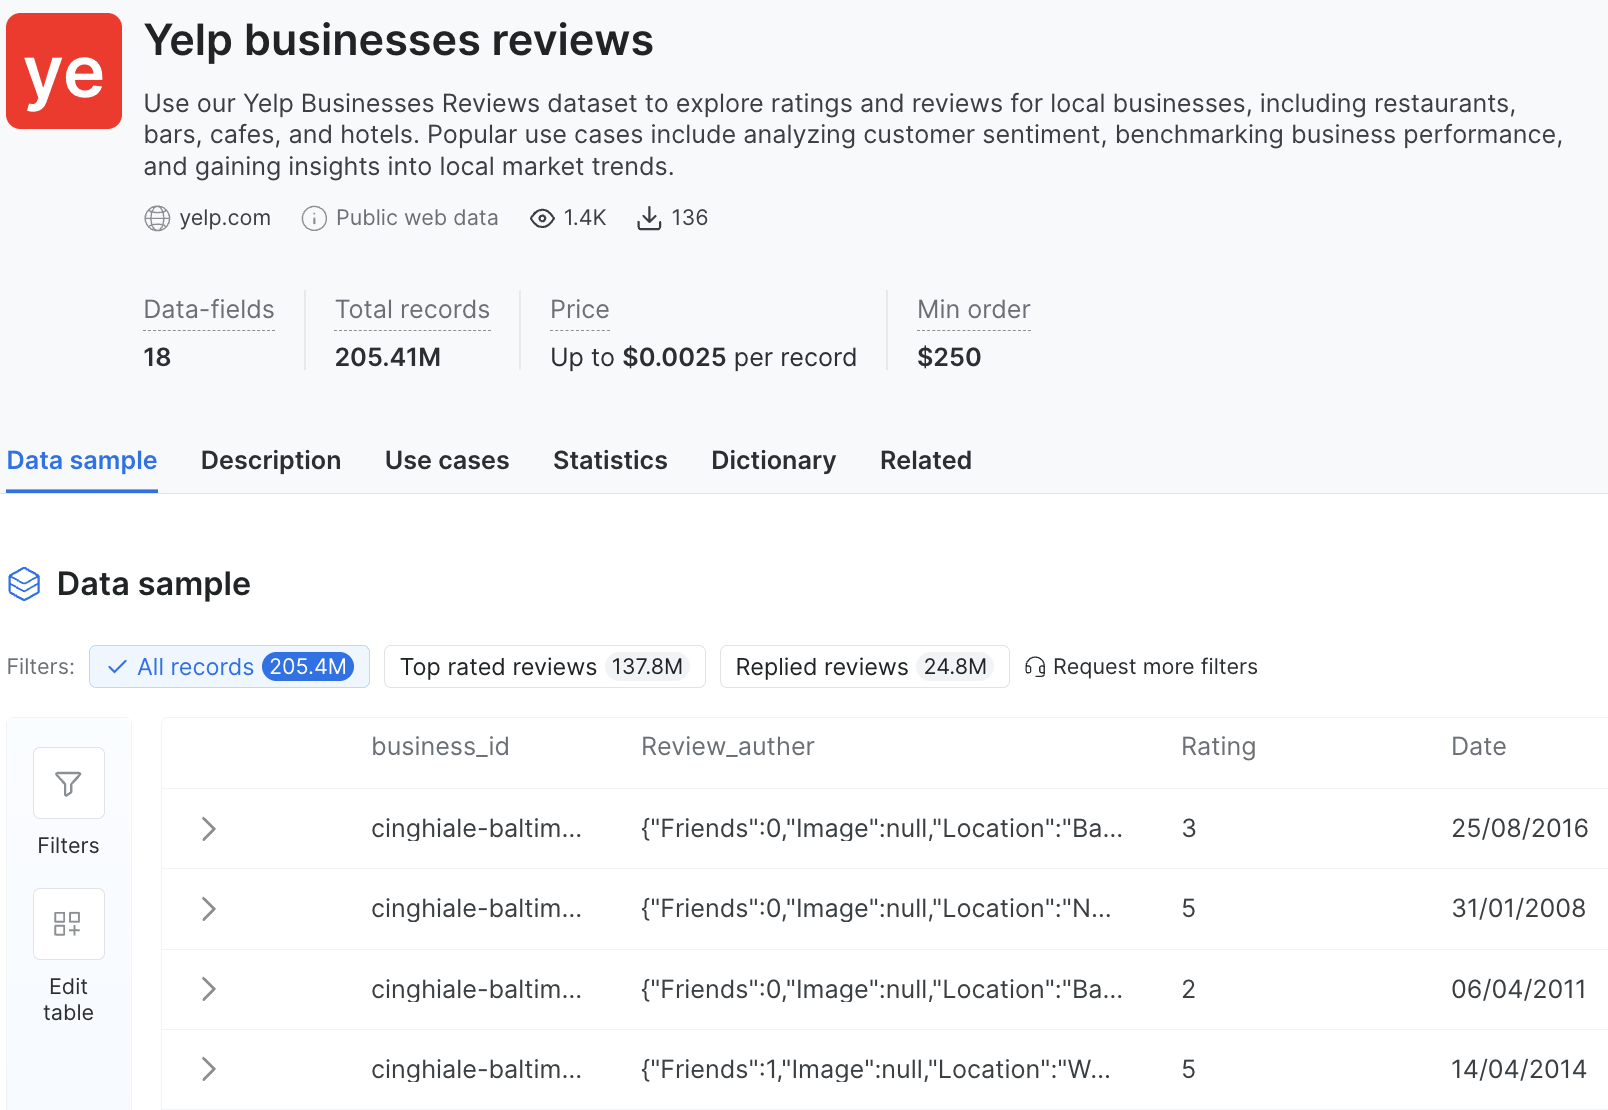
O conjunto de dados de reviews de empresas do Yelp. A até $0,0025 por registro, o pedido mínimo de $250 compra pelo menos 100 mil reviews.
Considerações finais
Fazer scraping do Yelp em Python funcionou em nossos testes assim que toda requisição usou o Web Unlocker e as reviews vieram da API GraphQL, não do HTML. O ID de query persistida pode mudar quando o Yelp faz deploy, então se as chamadas de review começarem a falhar, rode primeiro o refresh_doc_id.py. O Yelp Scraper API da Bright Data cuida da manutenção do parser e adiciona reviews não recomendadas, com um preço maior por review. Os conjuntos de dados do Yelp da Bright Data fornecem dados históricos para preenchimentos. Comece no plano gratuito da Bright Data com uma empresa que você conhece, e compare a contagem de linhas de yelp_scraper.py com totalCount antes de rodá-lo em mais empresas.
Perguntas frequentes
Como fazer scraping de reviews do Yelp?
Solicite-as do endpoint GraphQL do Yelp, /gql/batch, com o ID de query persistida GetBusinessReviewFeed, porque o HTML da página de empresa não tinha texto completo de review em nossos testes. Cada chamada retornava até 49 reviews. Direcione as chamadas através do Web Unlocker API da Bright Data, porque o DataDome, proteção contra bots do Yelp, bloqueou os clientes HTTP em Python que testamos.
A API do Yelp fornece todas as reviews?
Não, não quando verificamos. A documentação do Yelp listava 3 trechos de review da Places API no Enhanced e até 7 no Premium, cada um com cerca de 160 caracteres. O texto completo estava disponível no plano Premium da Insights API do Yelp ou na API GraphQL que o yelp.com usa, que retornava reviews recomendadas. O Yelp Scraper API da Bright Data também retorna texto completo, incluindo reviews não recomendadas.
Posso usar a API do Yelp de graça?
Apenas para avaliação. A documentação do Yelp listava 5 mil chamadas gratuitas da Places API durante um teste de 30 dias, e as chamadas de teste não eram para uso comercial. Os planos pagos começavam em $229 por mês para o plano Base, que não incluía trechos de review nem fotos.
Quanto custa a Yelp Fusion API?
A página de preços do Yelp listava a Places API (também chamada de Fusion) a $229 por mês para o Base, $299 para o Enhanced, e $643 para o Premium. Cada plano incluía 30 mil chamadas por mês por padrão, e chamadas extras custavam de $5,91 a $14,13 por mil, dependendo do plano.
Existe um scraper gratuito do Yelp?
Sim, scrapers open-source do Yelp são gratuitos, mas em nossos testes, o DataDome, proteção contra bots do Yelp, bloqueou clientes HTTP em Python. O plano gratuito da Bright Data inclui 5 mil créditos por mês, suficientes para 5 mil registros do Yelp Scraper API. Requisições do Web Unlocker ao Yelp precisam de uma conta com acesso total.
Sites conseguem detectar scraping?
Sim. Serviços de proteção contra bots podem verificar fingerprints TLS, IPs e execução de JavaScript, e o Yelp usava DataDome em nossos testes. Clientes HTTP em Python receberam páginas de desafio 403 em toda requisição de teste, mesmo com fingerprints TLS de navegador e IPs residenciais dos EUA. Todas as 30 páginas de teste de empresas carregaram através do Web Unlocker API da Bright Data.