Fazer scraping do Zillow significa coletar registros de anúncios, preços e imóveis das páginas públicas do Zillow para modelos de precificação, ferramentas de análise de investimentos e painéis de mercado. Cada página incorpora seus dados principais como JSON.
O Zillow bloqueia requisições Python padrão, mas esse é o problema mais fácil. O mais difícil é o dado que seu scraper perde sem avisar. A maioria das páginas de anúncios não inclui o histórico de preços no HTML, e uma busca para em 984 anúncios, apenas 6% das casas à venda em Houston.
Este guia mostra como fazer scraping do Zillow com Python, obter todo anúncio com seu histórico de preços, e decidir quando um scraper gerenciado custa menos.
Resumo
- Use a impressão digital TLS de um navegador. O Zillow bloqueia a impressão digital TLS padrão do Python, mesmo com cabeçalhos do Chrome.
curl_cffise passando por Chrome obteve 429 de 430 páginas. - Leia o JSON incorporado na página, e busque o histórico de preços separadamente. A maioria das páginas de anúncios o carrega com uma segunda requisição que scrapers somente-HTML nunca fazem.
- Uma busca para em 984 anúncios, então divida buscas grandes. Ou use a API Scraper do Zillow da Bright Data, que encontrou todos os 1.295 anúncios de Fort Wayne a partir de uma única URL.
- Verifique a integridade, não apenas códigos de status. Compare sua contagem de linhas com o total reportado pelo Zillow, repita linhas com falha, e sinalize casas vendidas anteriormente sem histórico de preços.
Quais dados do Zillow você pode fazer scraping e onde encontrá-los
Seu scraper pode obter dados do Zillow de 4 fontes principais, e o robots.txt do Zillow tratava cada uma de forma diferente:
| Dado | Fonte no Zillow | O que o robots.txt dizia |
|---|---|---|
| Campos do anúncio: preço, quartos, Zestimate, fotos, agente do anúncio | JSON __NEXT_DATA__ dentro do HTML da página do anúncio |
Permitido para páginas /homedetails/ |
| Histórico de preços, histórico de impostos, escolas | Geralmente uma requisição /graphql/ que a página enviava após carregar |
Não permitido para /graphql/ |
| Resultados de busca, 41 anúncios por página | Páginas de cidade como /fort-wayne-in/2_p/, ou o endpoint interno async-create-search-page-state |
Permitido para páginas de cidade, não permitido para o endpoint e URLs ?searchQueryState= |
| Anúncios alterados | Sitemaps vinculados no robots.txt, como latest.xml.gz |
Publicado para crawlers |
As páginas do Zillow foram construídas com Next.js, e cada página incorporava seus dados principais como JSON em uma tag de script __NEXT_DATA__. Você pode ler esse JSON sem renderizar a página. Nosso guia sobre scraping de sites Next.js explica como esses dados incorporados funcionam.
Suas requisições para um anúncio e uma busca seguem este caminho:
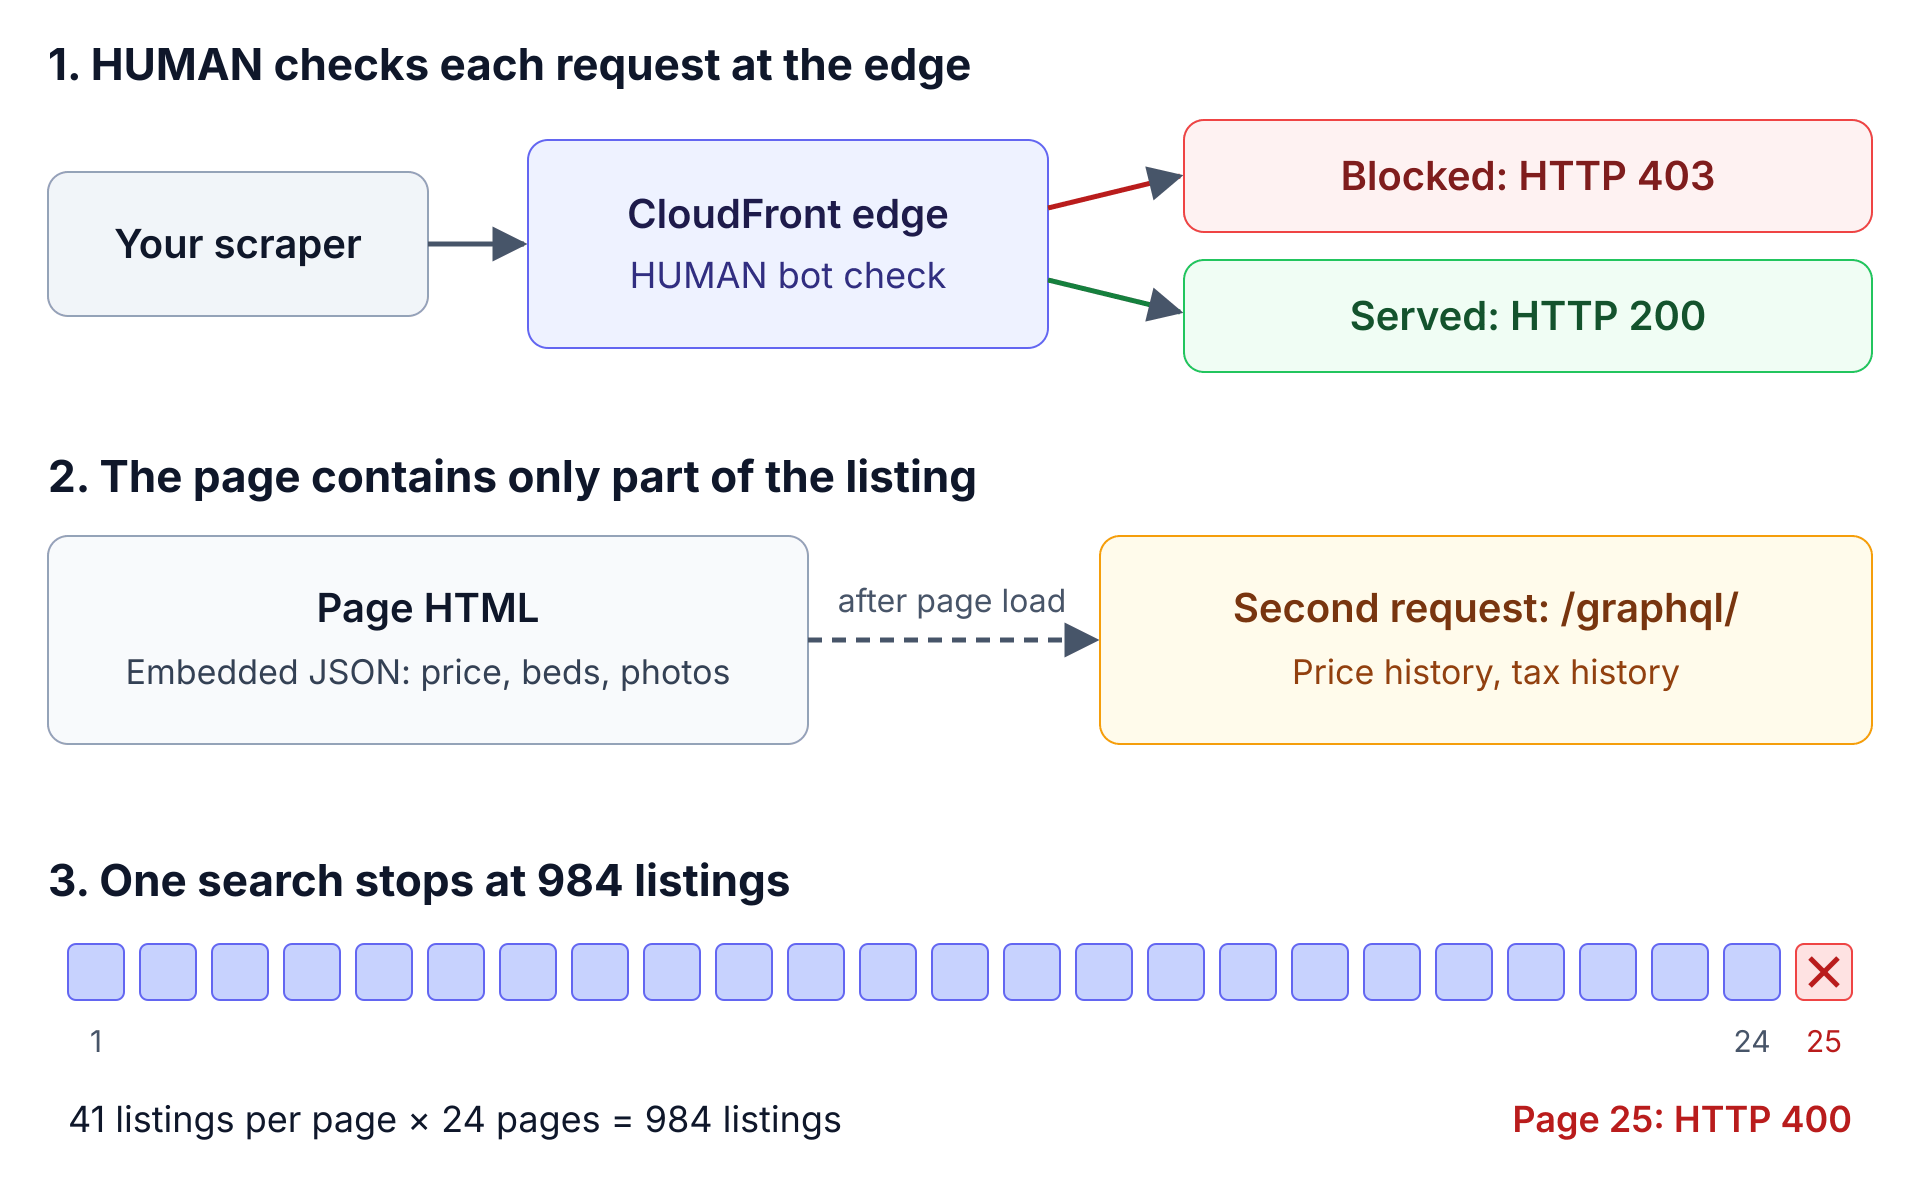
A verificação de bot da HUMAN roda na borda antes de qualquer HTML existir, e o histórico de preços carrega depois que a página carrega. Se seu parser lê apenas o HTML, ele pode confundir um bloqueio com uma página vazia, e perde o histórico de preços na maioria dos anúncios.
Páginas de anúncios e histórico de preços
Você precisa fazer parsing do JSON do anúncio duas vezes, porque ele era codificado duplamente. O campo props.pageProps.componentProps.gdpClientCache tinha um valor string, e essa string era ela mesma um objeto JSON. Suas chaves eram os nomes das queries GraphQL internas do Zillow.
Anúncios à venda, fora do mercado, e Zillow Showcase usavam cada um seu próprio nome de operação GraphQL. ForSalePriorityQuery tinha 101 campos, NotForSalePriorityQuery tinha 122, e ViewShowcasePriorityQuery tinha 78. Se seu parser espera um nome de operação, ele falha nos outros. Em vez disso, mescle cada entrada no cache, e um único parser trata os 3 tipos de anúncio.
O histórico de preços e impostos estava ausente desse JSON na maioria dos anúncios. Para 20 anúncios à venda, a API Scraper do Zillow da Bright Data retornou de 1 a 18 eventos de histórico de preços cada. O HTML das mesmas páginas não continha nenhum desses eventos. Se seu scraper lê apenas o HTML, ele registra essas casas como sem histórico de preços e não gera nenhum erro.
O navegador solicitava o histórico depois que a página carregava. Para uma casa à venda, essa requisição (ForSaleNonPriorityQuery) retornava 145 campos do imóvel, incluindo 21 anos de histórico de impostos. Uma página fora do mercado usava uma requisição diferente, uma query GraphQL persistida que a página chamava pelo seu hash.
Páginas de busca e o limite de 984 anúncios
Uma página completa de resultados de busca continha 41 anúncios em seu bloco __NEXT_DATA__, mas apenas 9 deles eram renderizados como cartões HTML. Se você faz parsing dos cartões com seletores CSS, perde os outros 32. Os seletores de cartão de tutoriais antigos do Zillow, como article.list-card, não correspondiam a nenhum elemento.
O Zillow também limitava cada busca. Sua própria paginação parava na página 20, mesmo para uma busca que reportava mais de 1 mil resultados:
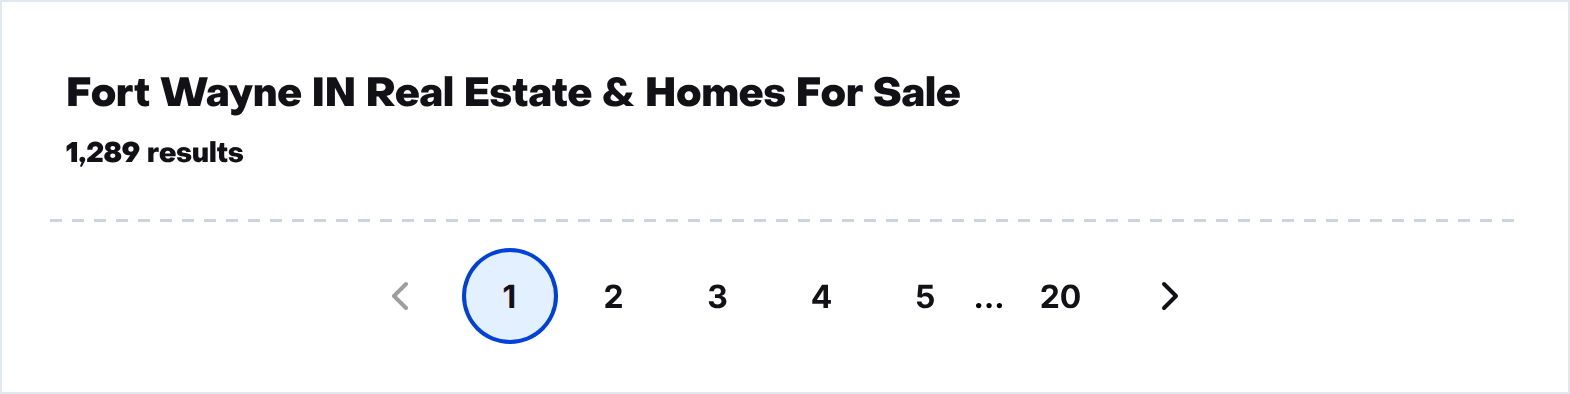
O topo e o final da lista de resultados do Zillow para Fort Wayne. O total (1.289 aqui) muda conforme anúncios são adicionados e removidos, mas os números de página ainda paravam em 20.
Vinte páginas de 41 anúncios resultam em 820, o limite que algumas ferramentas de scraping documentam. Mas as páginas 21 a 24 ainda retornavam mais 41 anúncios cada quando solicitadas por URL, e a página 25 retornava um erro HTTP 400. Uma busca, portanto, alcançava 984 anúncios, que era 76% dos 1.295 anúncios à venda de Fort Wayne e 6% dos 15.410 na cidade de Houston. Toda resposta ainda reportava o total completo, então compare esse número com o que você coleta.
Faça parsing do JSON em vez da marcação, e você obtém todos os 41 anúncios por página em vez de 9.
Por que o Zillow bloqueia requisições Python padrão
A proteção contra bots do Zillow vinha da HUMAN Security, anteriormente PerimeterX. Dois detalhes mostravam isso: a página de bloqueio nomeava o ID do app PerimeterX PXHYx10rg3, e o robots.txt não permitia /captchaPerimeterX/ e /HYx10rg3/.
A recusa vinha do CloudFront, a rede de entrega de conteúdo (CDN) na frente do Zillow, não dos próprios servidores do Zillow. Cada resposta bloqueada era um HTTP 403 com x-cache: LambdaGeneratedResponse e x-px-blocked: 1. Também faltava o cabeçalho x-envoy-upstream-service-time que páginas normais incluíam. Seu scraper pode verificar esse cabeçalho x-px-blocked para detectar um bloqueio sem fazer parsing da página.
Como é uma requisição bloqueada
Uma requisição curl com um User-Agent do Chrome foi recusada:
curl -s -o /dev/null -D - \
  -A "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36" \
  "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/"
A borda respondeu em 0,32 segundos com a página de 5.952 bytes “Press & Hold”:
HTTP/2 403
server: CloudFront
content-length: 5952
x-px-blocked: 1
x-cache: LambdaGeneratedResponse from cloudfront
Um Chromium headless lançado pelo Playwright recebeu o mesmo bloqueio, HTTP 403 com x-px-blocked: 1, e renderizou o desafio da HUMAN:
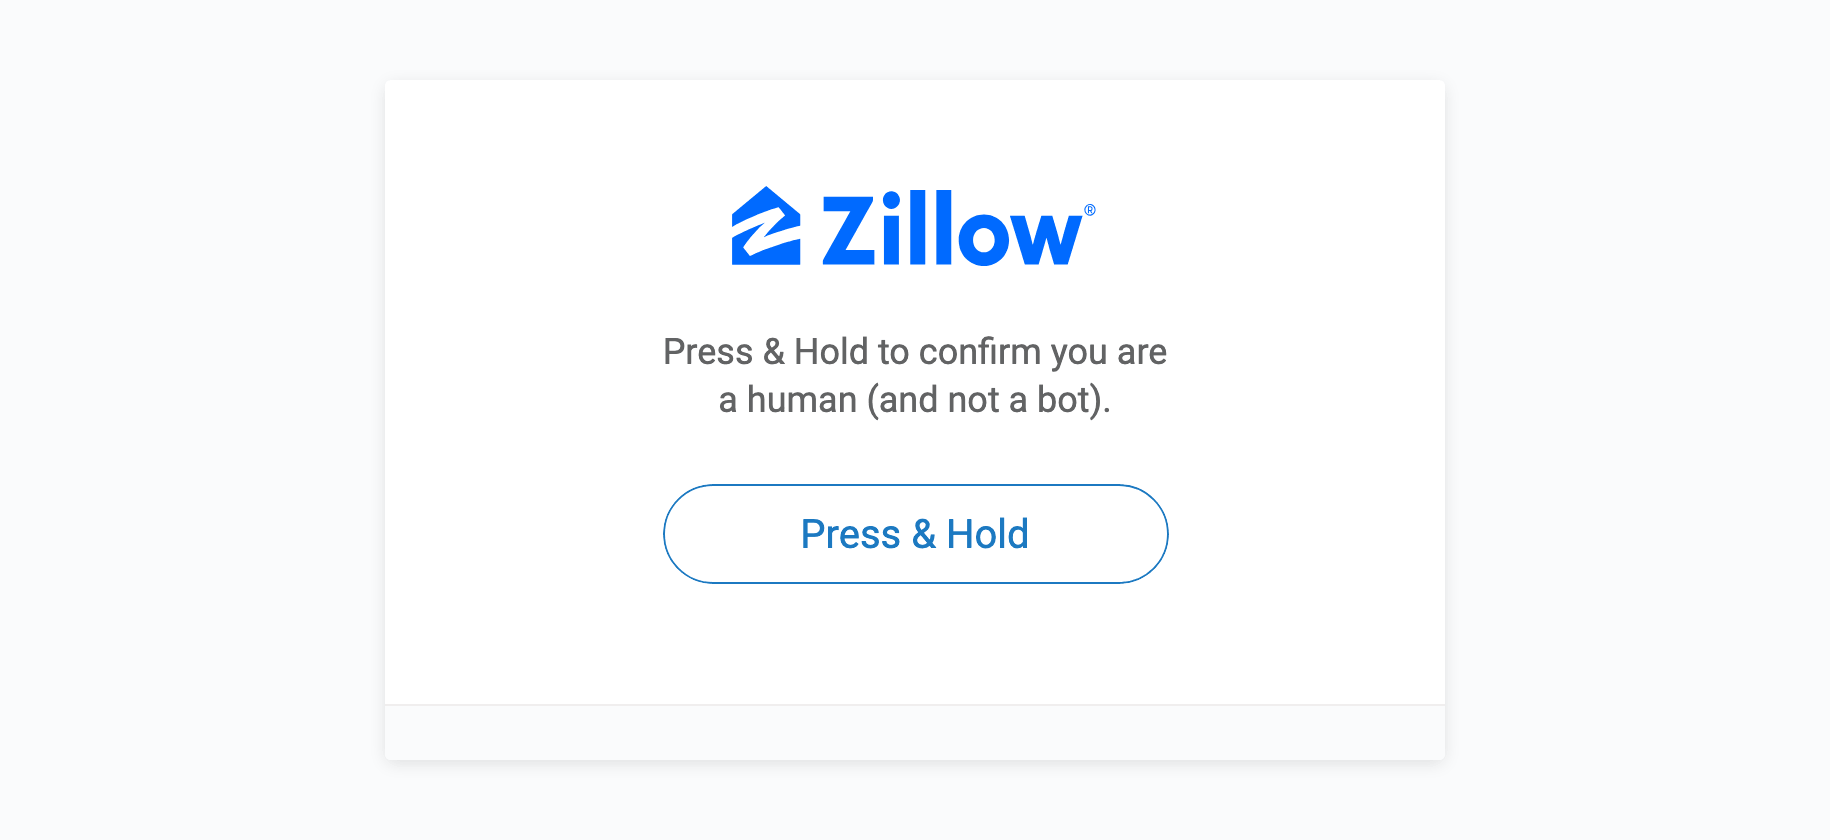
Se seu scraper recebe essa página, ele foi recusado na borda, e a página não contém dados de anúncio.
Para tratar essa página sem seu próprio código de desbloqueio, use o resolvedor de CAPTCHA do Zillow da Bright Data.
Quais clientes Python passam na verificação de bot do Zillow
Do mesmo IP, segundos após o curl ser recusado, o curl_cffi buscou o mesmo anúncio. Essa biblioteca imita o handshake TLS e os cabeçalhos do Chrome:
python - <<'EOF'
from curl_cffi import requests

url = "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/"
r = requests.get(url, impersonate="chrome")
print(r.status_code, len(r.content))
EOF
Imprimiu um HTTP 200 e 730.803 bytes de HTML:
200 730803Essas 2 requisições diferiam em seus cabeçalhos e em sua impressão digital TLS. Uma impressão digital TLS é o padrão de conjuntos de cifras e extensões que um cliente oferece ao abrir uma conexão. Nosso guia sobre impressão digital TLS explica como sites usam essas impressões digitais para detectar bots.
De um IP residencial que o Zillow não havia bloqueado, 6 clientes buscaram uma página de anúncio e uma página de busca cada, com o mesmo resultado em ambos:
| Cliente | Impressão digital TLS | Resultado |
|---|---|---|
Python requests, cabeçalhos padrão |
Python (OpenSSL) | 403 |
Python requests, User-Agent do Chrome e cabeçalhos de navegador |
Python (OpenSSL) | 403 |
httpx, cabeçalhos de navegador |
Python (OpenSSL) | 403 |
curl_cffi, impersonate="chrome" |
Chrome | 200 |
curl_cffi, impersonate="firefox" |
Firefox | 200 |
curl_cffi, impersonate="safari" |
Safari | 403 |
Se seu cliente usa a impressão digital TLS do Python, cabeçalhos de navegador não ajudam. O perfil Safari também foi recusado em ambas as páginas, então teste cada perfil de imitação contra o Zillow antes de confiar nele. O perfil Chrome também passou quando o HTTP/1.1 foi forçado, então as configurações do HTTP/2 não eram o fator decisivo.
Por que cabeçalhos e reputação de IP ainda importam
O Zillow também verifica se os cabeçalhos HTTP da sua requisição parecem os de um navegador real. Quando um proxy usava a impressão digital TLS do Chrome e um novo IP dos EUA para cada requisição, os cabeçalhos sozinhos decidiam o resultado.
O User-Agent padrão do Python foi recusado 5 de 5 vezes, e um User-Agent do Chrome sozinho passou 5 de 5. O conjunto completo de cabeçalhos do Chrome sem suas dicas de cliente sec-ch-ua foi recusado 4 de 10 vezes. Isso sugere que o Zillow dá a cada requisição uma pontuação de risco em vez de aplicar uma regra fixa.
A reputação do seu IP também importa. Cerca de 20 requisições foram enviadas de um IP residencial, e a maioria veio de clientes que o Zillow recusou. Depois disso, o Zillow recusou até o perfil Chrome que havia passado minutos antes, e o bloqueio terminou em 6 minutos.
Sessões com a impressão digital TLS do Chrome e cookies reutilizados se comportaram de forma diferente. Em 5 dessas sessões, 429 de 430 requisições de anúncios retornaram a página. A única falha foi um HTTP 502, não um bloqueio. A HUMAN não recusou nenhuma das 430, incluindo 250 requisições de um IP em 12 minutos.
Então trate uma recusa como um sinal para pausar esse IP, não para tentar novamente imediatamente. Meça a taxa de bloqueio por IP antes de decidir quantos IPs de proxy você precisa. Para rotação de IP e outras formas de manter baixa a taxa de bloqueio, veja nosso guia sobre scraping de dados sem ser bloqueado.
Fazendo scraping do Zillow com Python e curl_cffi
O scraper abaixo lê o mesmo JSON que a página usa. Ele precisa do Python 3.10 ou mais recente e do curl_cffi, que nosso guia sobre scraping de dados com curl_cffi apresenta. Instale a biblioteca em um ambiente virtual:
python3 -m venv .venv
source .venv/bin/activate  # no Windows: .venv\Scripts\activate
pip install curl_cffi
Este script, zillow_diy.py, busca uma página de busca de Fort Wayne, então lê 3 anúncios dela:
"""Faz scraping do Zillow com a impressão digital TLS de um navegador e o JSON incorporado na página."""
import json
import re
import time

from curl_cffi import requests

NEXT_DATA = re.compile(
    r'<script id="__NEXT_DATA__" type="application/json">(.*?)</script>', re.S
)
# TLS do Chrome + cabeçalhos correspondentes; mantenha uma sessão por IP
session = requests.Session(impersonate="chrome")


def next_data(url: str) -> dict:
    resp = session.get(url, timeout=30)
    match = NEXT_DATA.search(resp.text)
    # Um bloqueio pode ser um 403 ou uma página de captcha com 200,
    # então teste os dados, não o status
    if resp.headers.get("x-px-blocked") or not match:
        raise RuntimeError(f"sem dados de página para {url} (HTTP {resp.status_code})")
    resp.raise_for_status()  # a página 404 do Zillow também contém __NEXT_DATA__
    return json.loads(match.group(1))


def search_page(city: str, page: int) -> tuple[list[dict], int]:
    """Uma página de resultados renderizada no servidor, mais o total que o Zillow reporta."""
    url = f"https://www.zillow.com/{city}/{page}_p/"
    cat1 = next_data(url)["props"]["pageProps"]["searchPageState"]["cat1"]
    return cat1["searchResults"]["listResults"], cat1["searchList"]["totalResultCount"]


def listing(url: str) -> dict:
    """A parte renderizada no servidor de um anúncio: gdpClientCache é JSON codificado duplamente."""
    props = next_data(url)["props"]["pageProps"]["componentProps"]
    cache = json.loads(props["gdpClientCache"])
    record = {}
    for query_result in cache.values():  # ex.: ForSalePriorityQuery{...}
        record.update(query_result.get("property") or {})
    return record


if __name__ == "__main__":
    cards, total = search_page("fort-wayne-in", 1)
    print(f"página 1: {len(cards)} anúncios de {total} reportados")
    for card in cards[:3]:
        time.sleep(2)
        home = listing(card["detailUrl"])
        history = home.get("priceHistory") or []
        print(home["zpid"], home["homeStatus"], home["price"], home["bedrooms"], "qt",
              home["livingArea"], "m² | priceHistory:", len(history))
Quando executado com python zillow_diy.py, encontrou 41 anúncios na página 1, e 2 dos 3 anúncios abertos não tinham histórico de preços:
página 1: 41 anúncios de 1295 reportados
73145681 FOR_SALE 649900 4 qt 5124 m² | priceHistory: 3
73159210 FOR_SALE 699900 4 qt 4132 m² | priceHistory: 0
73110917 FOR_SALE 239900 3 qt 1468 m² | priceHistory: 0
O primeiro anúncio era um anúncio Showcase, que incluía seu histórico de preços no HTML. Para os outros 2, a API Scraper do Zillow retornou 2 e 3 eventos de histórico de preços, e o HTML tinha 0. A execução inteira levou cerca de 11 segundos, incluindo as pausas de 2 segundos.
Essa abordagem tinha 2 limites. Primeiro, a página 24 das páginas da cidade de Fort Wayne ainda retornava 41 anúncios, mas a página 25 retornava um erro HTTP 400. Se sua cidade tem mais anúncios do que uma busca consegue alcançar, você precisa de buscas menores. Segundo, o histórico de preços ausente vinha apenas de /graphql/.
Dividir uma cidade geralmente significa buscas por CEP ou filtradas, que usam URLs /homes/ e ?searchQueryState=, e o histórico de preços ausente precisa da requisição /graphql/. O robots.txt do Zillow não permitia os três, então chamá-los é uma decisão de conformidade para sua equipe. Nosso guia sobre robots.txt para scraping de dados explica como ler e respeitar essas regras.
Para executar este scraper a partir de muitos IPs, passe um proxy residencial da Bright Data para a sessão. Para conexões criptografadas ponta a ponta, carregue o certificado da Bright Data para a porta 44445 com verify="brightdata_root_ca_44445.crt".
IPs residenciais vêm de pessoas reais que optaram por participar, então proxies residenciais da Bright Data precisam primeiro de uma revisão KYC (conheça seu cliente) da empresa aprovada. A revisão aprova casos de uso específicos, então descreva seu pipeline do Zillow ao se inscrever. Sem a verificação KYC, a API Web Unlocker cuida do desbloqueio para você, e a API Scraper do Zillow na próxima seção retorna registros de anúncios com histórico de preços.
Fazendo scraping do Zillow com a API Scraper do Zillow
A API Scraper do Zillow executa a coleta na infraestrutura da Bright Data, cuida do desbloqueio e parsing para você, e retorna registros JSON. Você paga por registro entregue, e novas contas recebem 5 mil créditos grátis que renovam todo mês. Ela inclui estes scrapers do Zillow, que as seções abaixo chamam de scrapers de anúncio, histórico de preços, página de busca, e Full Properties:
| Scraper | ID do conjunto de dados | Entrada | Saída |
|---|---|---|---|
| Informações de listagem de imóveis do Zillow | gd_lfqkr8wm13ixtbd8f5 |
URL do anúncio, URL de busca, ou filtros de localização | 1 registro por anúncio, até 139 campos |
| Histórico de preços do Zillow | gd_lxu1cz9r88uiqsosl |
URL do anúncio | 1 linha por evento de histórico de preços |
| Página de busca de imóveis do Zillow | gd_m71oxpvxwr113ehqg |
URL de busca com searchQueryState |
1 linha por resultado de busca, 26 campos |
| Informações completas de imóveis do Zillow | gd_m794g571225l6vm7gh |
URL do anúncio ou URL de busca | 1 registro por anúncio, com nomes de campos em snake_case como price_history |
Todos os 4 coletam por URL através da mesma requisição de API, então você só muda o ID do conjunto de dados. A Bright Data também oferece uma API Scraper de Imagens do Zillow e scrapers para outros sites de imóveis em sua linha API Scraper de Imóveis. No Painel de Controle, o scraper de anúncios mostra seus 3 métodos de entrada e os modos síncrono e assíncrono:
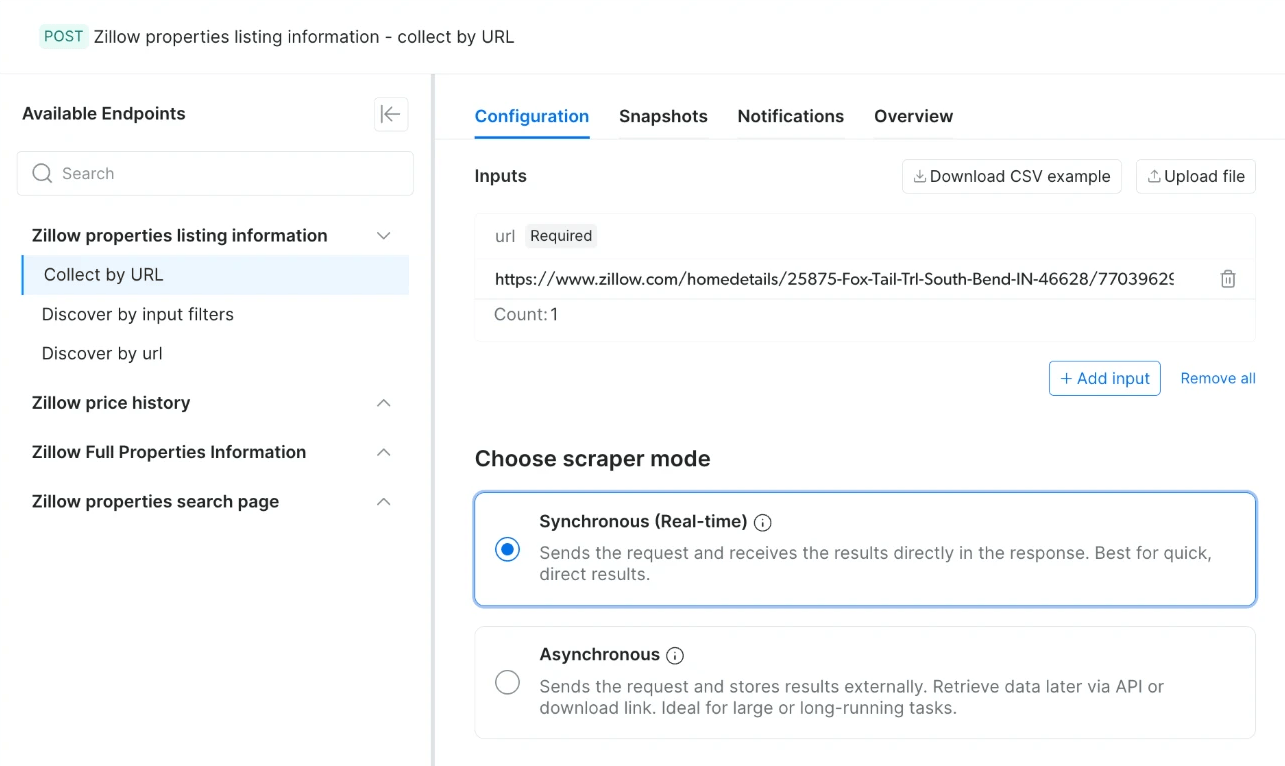
O painel esquerdo lista os mesmos 4 scrapers da tabela acima.
Coletando anúncios e histórico de preços
Para executar o script abaixo, zillow_api.py, você precisa do pacote requests (pip install requests) e de um token de API do Painel de Controle. Sua função collect() chama o endpoint síncrono e muda para polling quando um job leva mais de 1 minuto:
"""Anúncios, histórico de preços e descoberta com a API Scraper do Zillow da Bright Data."""
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}
LISTINGS = "gd_lfqkr8wm13ixtbd8f5"       # Informações de listagem de imóveis do Zillow
PRICE_HISTORY = "gd_lxu1cz9r88uiqsosl"   # Histórico de preços do Zillow, uma linha por evento


def collect(dataset_id: str, urls: list[str]) -> list[dict]:
    """Até 20 URLs por chamada síncrona; um job além de 1 minuto retorna 202."""
    params = {"dataset_id": dataset_id, "include_errors": "true", "format": "json"}
    resp = requests.post(f"{API}/scrape", headers=HEADERS, params=params, timeout=120,
                         json={"input": [{"url": u} for u in urls]})
    if resp.status_code == 202:
        return wait_and_download(resp.json()["snapshot_id"])
    resp.raise_for_status()
    return resp.json()


def discover(search_url: str) -> list[dict]:
    """Todo anúncio em uma busca do Zillow, coletado como registros completos (assíncrono)."""
    resp = requests.post(f"{API}/trigger", headers=HEADERS, timeout=60,
                         params={"dataset_id": LISTINGS, "include_errors": "true",
                                 "type": "discover_new", "discover_by": "url"},
                         json={"input": [{"url": search_url}]})
    resp.raise_for_status()
    return wait_and_download(resp.json()["snapshot_id"])


def wait_and_download(snapshot_id: str, poll_s: int = 15) -> list[dict]:
    while True:
        resp = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS,
                            timeout=60)
        resp.raise_for_status()
        status = resp.json()["status"]
        if status == "ready":
            break
        if status in ("failed", "canceled"):
            raise RuntimeError(f"snapshot {snapshot_id} terminou como {status}")
        time.sleep(poll_s)
    while True:  # o download retorna 202 enquanto o arquivo ainda está sendo preparado
        resp = requests.get(f"{API}/snapshot/{snapshot_id}", headers=HEADERS,
                            params={"format": "json"}, timeout=300)
        if resp.status_code != 202:
            resp.raise_for_status()
            return resp.json()
        time.sleep(10)


if __name__ == "__main__":
    homes = collect(LISTINGS, [
        "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/",
    ])
    for h in homes:
        print(h["zpid"], h["homeStatus"], h["price"], "| zestimate", h.get("zestimate"),
              "| priceHistory", len(h.get("priceHistory") or []),
              "| taxHistory", len(h.get("taxHistory") or []),
              "| coletado", h.get("timestamp"))
    events = collect(PRICE_HISTORY, [
        "https://www.zillow.com/homedetails/2506-Gordon-Cir-South-Bend-IN-46635/77050198_zpid/",
    ])
    for e in events:
        print(e["zpid"], e["date"][:10], e["event"], e["price"], e["source"])
Com BRIGHTDATA_API_TOKEN exportado, as duas chamadas levaram de 35 a 65 segundos juntas:
77039629 FOR_SALE 359000 | zestimate 351600 | priceHistory 1 | taxHistory 21 | coletado 2026-09-27T11:30:53.846Z
77050198 2023-03-03 Sold 265000 IRMLS
77050198 2023-02-03 Pending sale 264900 IRMLS
77050198 2023-02-01 Listed for sale 264900 IRMLS
O registro do anúncio correspondia ao que a própria página do Zillow carregava, com 1 evento de histórico de preços e 21 anos de histórico de impostos. Seu timestamp mostrava que a Bright Data o coletou ao vivo, durante a requisição.
Os 3 eventos para a segunda casa, 2506 Gordon Cir, correspondem à tabela de histórico de preços em sua página do Zillow:
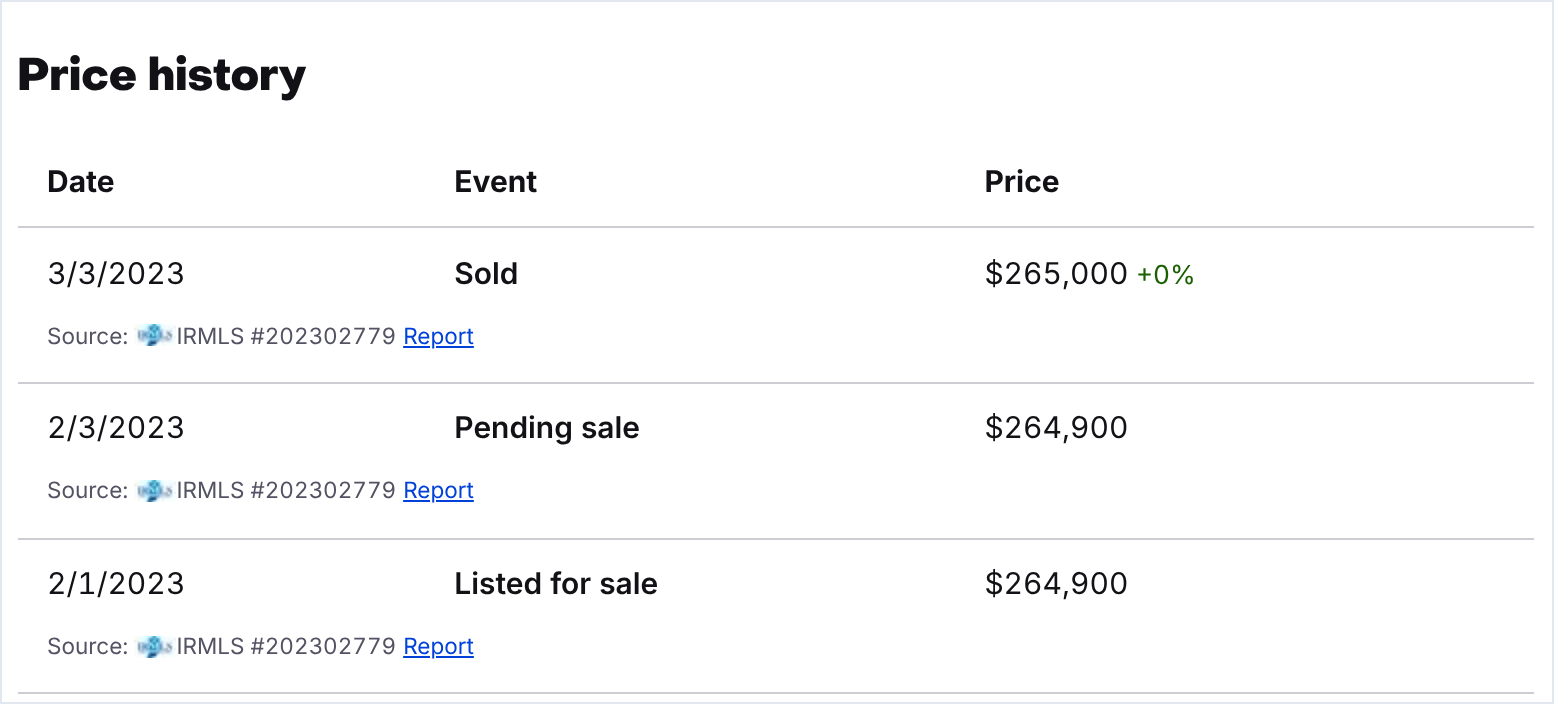
Cada linha nomeia sua fonte, um serviço de listagem múltipla (MLS) local, que a saída da API mantém no campo source.
O endpoint síncrono /scrape aceita até 20 URLs e retorna os dados diretamente se o job terminar dentro de 1 minuto. Para um job mais longo, ele responde com HTTP 202 e um ID de snapshot em vez disso. Um lote de 20 anúncios de Fort Wayne levou cerca de 4 minutos, então espere alguns minutos de polling antes que seu script imprima algo. Para lotes maiores, use o endpoint assíncrono /trigger, que a próxima seção usa para descoberta.
Descobrindo todo anúncio em uma busca
A descoberta coleta registros completos de anúncios de uma URL de busca e pode exceder o limite de 984 anúncios que parou o scraper faça-você-mesmo (DIY). A função discover() acima envia a URL da cidade de Fort Wayne, https://www.zillow.com/fort-wayne-in/, para o método de entrada Discover by URL do scraper de anúncios em uma requisição assíncrona /trigger. Em 13 a 17 minutos, retornou 1.295 linhas, uma para cada anúncio que o Zillow reportou. Para uma amostra pequena em vez disso, passe até 20 URLs de anúncio de search_page() em zillow_diy.py para collect().
Para limitar quantos registros cada URL de busca retorna, por exemplo em uma execução de teste, envie {"input": [...], "limit_per_input": 50} como o corpo JSON. Em vez de fazer polling, você pode fazer o /trigger entregar os resultados para um webhook ou S3, e cada snapshot permanece disponível para download por 30 dias.
Quando você só precisa de campos de resultado de busca, como preço, quartos e endereço, o scraper de página de busca é mais rápido. De uma URL de busca de Fort Wayne com searchQueryState, ele retornou 1.154 anúncios únicos em 65 segundos. Use a descoberta quando precisar de todo anúncio.
Obtendo histórico de preços para casas fora do mercado
Para casas à venda, o priceHistory do scraper de anúncios correspondia à própria página do Zillow em 4 de 4 anúncios. Para casas fora do mercado, use o scraper Full Properties. Em 6 de 6 casas fora do mercado, ele retornou o histórico de preços em um array price_history em snake_case, 1 registro por casa.
Para as mesmas 6 casas, o scraper de histórico de preços retornou 1 linha por evento: 28 linhas em 37 segundos. As duas saídas correspondiam exatamente.
A cobrança é por registro entregue, então uma casa com 5 eventos custa 5 registros do scraper de histórico de preços e 1 do Full Properties. Os anúncios de Fort Wayne tiveram em média 5 eventos, com um máximo de 29. Então envie URLs fora do mercado para o scraper Full Properties, e leia price_history em vez de priceHistory. Use o scraper de histórico de preços quando quiser 1 linha por evento.
Executando o mesmo scraper a partir de um terminal ou agente de IA
O CLI da Bright Data executa o scraper de anúncios como um comando de pipeline, o que convém a jobs únicos e agentes de codificação. Depois de instalá-lo com npm install -g @brightdata/cli e executar bdata login uma vez, um comando retorna um anúncio:
bdata pipelines zillow_properties_listing \
  "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/"
Dentro de 3 minutos, imprimiu o mesmo registro que a API, em uma linha de JSON que começa:
[{"zpid":77039629,"city":"South Bend","state":"IN","homeStatus":"FOR_SALE","address":{"city":"South Bend","streetAddress":"25875 Fox Tail Trl","zipcode":"46628","state":"IN"},"bedrooms":3,"bathrooms":2,"price":359000,"yearBuilt":1996,Se seu assistente de IA usa o Model Context Protocol (MCP), o servidor MCP da Bright Data expõe o mesmo scraper como a ferramenta web_data_zillow_properties_listing. Para usar a ferramenta, habilite o grupo de ferramentas business do servidor. Cada registro inclui um timestamp, então seu agente pode confirmar o quão atual um preço é antes de cotá-lo.
Para um agente completo construído no mesmo servidor, veja nosso guia sobre construindo um agente de IA imobiliário com CrewAI.
Mantendo os dados do Zillow completos e atualizados
Antes dos registros chegarem ao seu data warehouse, verifique cada execução contra o total reportado pelo Zillow. As verificações abaixo também sinalizam linhas com erro, anúncios duplicados, e histórico de preços ausente. Um sitemap de anúncios alterados então mantém pequenas suas execuções repetidas.
Validando cada registro
Uma resposta 200 confirma que a requisição foi bem-sucedida, não que os dados estão completos. Este validador, salvo como validate.py, separa linhas com erro, remove anúncios duplicados, e sinaliza casas que foram vendidas antes mas não têm histórico de preços. Também conta registros coletados há mais de 24 horas como desatualizados e compara sua contagem de registros com o total reportado pelo Zillow:
"""Verificações a serem executadas em registros do Zillow antes de chegarem ao warehouse."""
from datetime import datetime, timedelta, timezone


def validate(rows: list[dict], reported_total: int | None = None,
             max_age_h: int = 24) -> dict:
    errors = [r for r in rows if r.get("error_code") or r.get("error")]
    records, seen = [], set()
    for r in rows:
        if r in errors or r.get("zpid") in seen:
            continue
        seen.add(r.get("zpid"))
        records.append(r)
    # Uma casa vendida antes tem histórico de preços, então histórico ausente é uma lacuna, não um fato.
    history_gaps = [r["url"] for r in records
                    if (r.get("lastSoldPrice") or r.get("dateSoldString"))
                    and not r.get("priceHistory")]
    cutoff = datetime.now(timezone.utc) - timedelta(hours=max_age_h)
    stale = [r["url"] for r in records
             if datetime.fromisoformat(r["timestamp"].replace("Z", "+00:00")) < cutoff]
    report = {"records": len(records), "error_rows": len(errors),
              "duplicates": len(rows) - len(errors) - len(records),
              "history_gaps": history_gaps, "stale": len(stale),
              "retry": [e.get("input", {}).get("url") for e in errors]}
    if reported_total:
        report["coverage"] = round(len(records) / reported_total, 3)
    return report
O script run_pipeline.py executa a descoberta para Fort Wayne e então valida as linhas:
"""Descobre todo anúncio em uma busca do Zillow, depois valida o resultado."""
import json
import time

from validate import validate
from zillow_api import discover

start = time.time()
rows = discover("https://www.zillow.com/fort-wayne-in/")
report = validate(rows, reported_total=1295)  # total do Zillow, ex.: de search_page()
print(f"{len(rows)} linhas em {round((time.time() - start) / 60, 1)} min")
counts = {k: (len(v) if isinstance(v, list) else v) for k, v in report.items()}
print(json.dumps(counts))
json.dump(rows, open("fort_wayne.json", "w"))
A descoberta retornou 1.295 linhas, e o validador manteve 1.270 delas como registros:
1295 linhas em 12.9 min
{"records": 1270, "error_rows": 25, "duplicates": 0, "history_gaps": 0, "stale": 0, "retry": 25, "coverage": 0.981}
A cobertura foi de 98,1% dos 1.295 anúncios que o Zillow reportou. A execução não teve duplicatas, e nenhum registro falhou na verificação de histórico de preços. A verificação só sinaliza casas vendidas antes, então ignora casas que nunca tiveram histórico de preços, como plantas de nova construção.
Um preço de venda ausente nos seus dados nem sempre é um erro de scraping. Em 8 anúncios de Houston, nenhum dos 2 eventos de Venda tinha preço, como esperado no Texas, onde preços de venda não são registro público.
Envie quaisquer URLs que a verificação de histórico de preços sinalize para o scraper Full Properties, e reenvie as URLs de retry. Para qualquer anúncio que ainda não tenha um registro completo, os resultados do scraper de página de busca incluem preço, quartos, e endereço.
Atualizando apenas os anúncios que mudaram
O robots.txt do Zillow listava um índice de sitemap para cada status de anúncio. O índice para-venda-por-agente incluía um sitemap latest.xml.gz. Este script, changed_listings.py, o lê através da API Web Unlocker e mantém os anúncios de Indiana. Antes de executá-lo, crie uma zona Web Unlocker no Painel de Controle e coloque seu nome no script:
"""Lista anúncios do Zillow alterados recentemente em um estado, de um sitemap vinculado no robots.txt."""
import gzip
import os
import re

import requests

SITEMAP = "https://www.zillow.com/xml/sitemaps/us/hdp/for-sale-by-agent/latest.xml.gz"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}


def unlock(url: str, attempts: int = 2) -> bytes:
    # substitua "web_unlocker" pelo nome da sua zona Web Unlocker
    payload = {"zone": "web_unlocker", "url": url, "format": "raw", "country": "us"}
    for _ in range(attempts):  # tenta novamente uma vez em erro transitório
        resp = requests.post("https://api.brightdata.com/request", headers=HEADERS,
                             json=payload, timeout=180)
        # o Web Unlocker retorna o próprio código de status do alvo neste cabeçalho
        if resp.headers.get("x-brd-status-code") == "200":
            return resp.content
    raise RuntimeError(f"{url}: {resp.headers.get('x-brd-status-code')} "
                       f"{resp.headers.get('x-brd-error')}")


body = unlock(SITEMAP)
# o arquivo pode chegar já descompactado
xml = (gzip.decompress(body) if body[:2] == b"\x1f\x8b" else body).decode()
entries = re.findall(r"<loc>([^<]+)</loc>\s*<lastmod>([^<]+)</lastmod>", xml)
indiana = [(url, mod) for url, mod in entries if re.search(r"-IN-\d{5}/", url)]
dates = [mod for _, mod in entries]
print(f"{len(entries)} anúncios alterados nacionalmente, {len(indiana)} em Indiana")
print("mudança mais antiga:", min(dates), "| mais recente:", max(dates))
print(indiana[0][0])
O arquivo listava 50 mil anúncios alterados nacionalmente, 1.014 deles em Indiana:
50000 anúncios alterados nacionalmente, 1014 em Indiana
mudança mais antiga: 2026-09-24T14:08:00Z | mais recente: 2026-09-27T07:51:00Z
https://www.zillow.com/homedetails/600-W-Cyprus-Cir-Bloomington-IN-47403/94517948_zpid/
Um arquivo de sitemap pode listar no máximo 50 mil URLs, e essas 50 mil mudanças abrangeram cerca de 3 dias. Então uma execução diária pode recoletar apenas os anúncios na sua área que mudaram desde a última execução, o que mantém seu custo baixo. Envie-os para collect() 20 URLs de cada vez, ou em um único job /trigger. O arquivo lista o que mudou, não toda casa no Zillow.
Os sitemaps nos 4 índices para-venda listavam 749 dos 1.154 anúncios de Fort Wayne que o scraper de página de busca encontrou, ou 65%. Nenhum dos 217 anúncios de nova construção apareceu. Use sitemaps para decidir o que recoletar, e use a descoberta para encontrar o que existe.
Quanto cada abordagem custa em escala
A forma mais barata de buscar uma página geralmente não é a forma mais barata de obter um conjunto de dados completo. Cada abordagem abaixo retornou dados do Zillow, mas elas diferem em quão completos são e quanto trabalho ainda resta para você. Os preços são valores de tabela na publicação, e nossa página de preços tem valores atuais:
| Abordagem | O que você paga | Resultado | Trabalho que sobra para você |
|---|---|---|---|
curl_cffi em seus próprios IPs |
Seus servidores e tráfego de proxy | 429 de 430 páginas servidas; buscas limitadas a 984 anúncios; geralmente sem histórico de preços no HTML | Atualizações de impressão digital, reputação de IP, divisão de buscas, histórico de preços |
| API Web Unlocker | $1,50 por 1 mil requisições bem-sucedidas | 10 de 10 páginas de anúncio, mediana de 4,5 s | Parsing, divisão de buscas, histórico de preços |
| API Browser | $8 por GB | 3,97 MB por anúncio, cerca de $0,03; histórico de preços renderizado | Scripts de navegador, parsing |
| API Scraper do Zillow | $1,50 por 1 mil registros | Todos os 1.295 anúncios de Fort Wayne encontrados a partir de uma URL; histórico de preços para casas à venda e fora do mercado | Validação |
| Conjuntos de dados do Zillow | Até $2,50 por 1 mil registros, pedido mínimo de $250 | 137,42 milhões de registros de imóveis no marketplace, majoritariamente casas fora do mercado | Escolher um cronograma de atualização |
O Web Unlocker cobra apenas por requisições bem-sucedidas e retorna o código de status do site alvo no cabeçalho x-brd-status-code, então verifique esse cabeçalho no seu código. Uma requisição para um anúncio ausente, por exemplo, retornou x-brd-status-code: 404. A API Browser renderizou a tabela de histórico de preços sem código extra, o que convém a páginas que precisam de uma sessão de navegador completa.
A abordagem DIY também tem um custo de manutenção que nenhum preço na tabela mostra. Um desenvolvedor que executa um scraper diário do Zillow para clientes relatou que ele quebra a cada trimestre quando o Zillow lança atualizações. As páginas do Zillow mostram por quê. Cada tipo de anúncio usava seu próprio nome de operação GraphQL no JSON, e seletores de cartão de tutoriais antigos, como article.list-card, não correspondiam a nada.
Os conjuntos de dados têm um propósito diferente: o conjunto de dados de anúncios do Zillow da Bright Data contém mais de 137 milhões de registros de imóveis. A maioria desses registros são casas fora do mercado, o que convém a modelos de avaliação e pesquisas que precisam de todo imóvel, não apenas casas à venda. Compradores podem obter atualizações diárias, semanais, mensais, ou em um cronograma personalizado, e a API Scraper coleta anúncios atuais sob demanda.
Compare o custo do pipeline inteiro, incluindo descoberta, detalhes do anúncio, histórico de preços, e repetições, não o custo de uma única busca de página. Nosso guia sobre scraping de dados gerenciado vs. DIY estima o custo total de executar scrapers internamente.
Considerações finais
Para buscar uma página do Zillow, você precisa de um cliente com a impressão digital TLS de um navegador. Obter dados completos é mais difícil, porque cada busca para em 984 anúncios e a maioria das páginas de anúncio carrega o histórico de preços em uma segunda requisição. Para um job único em uma área pequena sem histórico de preços, o scraper curl_cffi é suficiente. Para todo anúncio com seu histórico de preços em um cronograma, a API Scraper do Zillow da Bright Data cuida de ambos para você.
Crie uma conta gratuita na Bright Data, execute a descoberta em uma URL de busca do seu mercado, e compare a contagem de linhas com o total reportado pelo Zillow.
Perguntas Frequentes
É possível fazer scraping de dados do Zillow?
Sim, se seu cliente usar a impressão digital TLS de um navegador. A biblioteca requests do Python recebe um HTTP 403, enquanto o curl_cffi se passando por Chrome recebe a página. Campos de anúncios estão em JSON incorporado em cada página, então um parser pode lê-los sem depender do layout HTML.
Por que o Zillow não mostra todos os anúncios?
O Zillow limita cada busca. Sua paginação mostra 20 páginas, mas o site serve 24 páginas de 41 anúncios cada, então uma busca alcança no máximo 984 anúncios. Divida áreas grandes em buscas menores, ou use a API Scraper do Zillow da Bright Data, que encontrou todos os 1.295 anúncios de Fort Wayne a partir de uma única URL.
Como obtenho dados de histórico de preços do Zillow?
Use a API Scraper do Zillow da Bright Data. Seus registros de anúncios à venda incluem histórico de preços, e seu scraper Full Properties o retorna para casas fora do mercado. A maioria das páginas de anúncio carrega o histórico de preços em uma segunda requisição, então scrapers somente-HTML o perdem. Para tendências de mercado por CEP, o Zillow Research publica CSVs gratuitos.
O Zillow tem uma API aberta?
Não. As APIs do Zillow Group para anúncios MLS, registros públicos, e Zestimates exigem aprovação, limitam chamadas diárias, e restringem o armazenamento de dados. O Zillow Research oferece CSVs gratuitos apenas de dados a nível de mercado. Para dados a nível de anúncio, a API Scraper do Zillow da Bright Data retorna anúncios e histórico de preços como JSON estruturado.
Como fazer scraping do Zillow gratuitamente?
Use o curl_cffi, um cliente HTTP Python gratuito que se passa por Chrome, para buscar páginas de anúncio lentamente, e faça parsing do JSON incorporado. Esse método para em 984 anúncios por busca e perde a maior parte do histórico de preços. Novas contas da Bright Data recebem 5 mil créditos grátis por mês sem cartão de crédito, suficiente para 5 mil registros da API Scraper do Zillow.
Como fazer scraping do Zillow sem programar?
Use o painel sem código de um scraper gerenciado. No Painel de Controle da Bright Data, abra a API Scraper do Zillow, cole URLs de anúncio ou busca, e inicie a execução. Depois baixe os registros como JSON ou CSV. Para um mercado inteiro, você pode comprar um conjunto de dados pronto do Zillow em vez de fazer scraping.
O ChatGPT consegue fazer scraping de dados?
O ChatGPT pode escrever código de scraper, mas não é construído para coletar dados do Zillow em escala sem outras ferramentas. Um agente de IA obtém anúncios estruturados chamando a ferramenta de anúncios do Zillow no servidor MCP da Bright Data, depois trabalha com o JSON retornado. Verifique o timestamp de cada registro antes que seu agente cote um preço.