Fazer scraping na Etsy significa coletar dados de anúncios, lojas e avaliações das páginas públicas da Etsy. A Etsy reportou mais de 100 milhões de itens e 5,6 milhões de vendedores ativos no relatório anual de 2025. A Etsy usa DataDome. Uma requisição direta retorna um 403 e uma página de bloqueio. As 2 soluções que normalmente vêm primeiro são um User-Agent do Chrome e personificação de TLS. Ambas ainda recebem um 403. Este guia mostra o que muda o 403, o que o robots.txt bloqueia e quais problemas de extração corrompem um dataset da Etsy sem gerar erro.
Resumo
- A Etsy usa DataDome atrás da Fastly. O DataDome coloca uma pontuação de risco em seu próprio cabeçalho de resposta. Você pode avaliar uma requisição antes de escrever um crawler.
- A Etsy recusou todos os 9 transportes que testamos. Um navegador com interface carregou a primeira página em 2,2 segundos. A Etsy recusou a segunda requisição.
- O robots.txt proíbe busca por palavra-chave e histórico de vendas e declara nenhum sitemap. Páginas de anúncios e lojas permaneceram abertas lá. Mas os termos da Etsy são mais rígidos.
- Moeda e preço seguem o IP de saída. Nossa amostra de dataset tinha 19 moedas. Uma média não filtrada dessa coluna estava 227x mais alta.
O que a Etsy retorna para uma requisição automatizada
Leia a recusa primeiro. Não tente novamente a requisição. Uma requisição simples te diz qual fornecedor roda na borda e como esse fornecedor te avaliou. Qualquer URL de anúncio funciona. Este pertence a um vendedor, então pode já ter sumido:
curl -sD - -o /dev/null https://www.etsy.com/listing/753913297/smoky-quartz-ring-rose-gold-ring-womenO servidor retorna um 403 com estes cabeçalhos:
HTTP/2 403
server: DataDome
x-datadome: protected
x-datadome-riskscore: 0.9230727100377928
accept-ch: Sec-CH-UA,Sec-CH-UA-Mobile,Sec-CH-UA-Platform,Sec-CH-UA-Arch,Sec-CH-UA-Full-Version-List,Sec-CH-UA-Model,Sec-CH-Device-Memory
set-cookie: datadome=ovuDEZ4S0taK1jDAOvZ9W3Uq2qUujN_iPPE3uXp7~r3msKXSvMFPp4j30em5IvR0...
via: 1.1 varnish
x-served-by: cache-del-vibw2260027-DEL
Esse bloqueio contém 3 fatos. A Etsy usa DataDome, não o Akamai Bot Manager que guias mais antigos ainda reportam, então planeje contra as camadas de detecção do DataDome. A Fastly roda na frente da Etsy, e os cabeçalhos Via e X-Served-By mostram esse salto. X-DataDome-riskscore é a pontuação do DataDome para o quão suspeita a requisição parecia, numa escala onde 1.0 é o pior. A Etsy pode trocar de fornecedor, então execute o comando novamente antes de planejar com base nesses 3 fatos.
Esse cabeçalho te dá um número para medir. Em nossos testes, a pontuação era determinística. Todas as 6 amostras intercaladas da mesma requisição retornaram 0.9230727100377928. A pontuação acompanha a assinatura da requisição, o IP que chama e o cookie datadome uma vez que você começa a retornar um, não uma contagem contínua de requisições. Então seus próprios números podem diferir, e em um endereço diferente a classificação entre configurações de cliente também pode diferir.
O corpo, 776 bytes em nossas execuções, é uma página de bloqueio do DataDome que carrega ct.captcha-delivery.com/c.js. Essa página de bloqueio contém um script de desafio, não dados de anúncio, então um parser que a lê retorna campos vazios em vez de um erro. A configuração embutida continha 't':'fe', a verificação de dispositivo do DataDome, então essa busca recebeu um desafio que um navegador real pode responder em vez de um banimento permanente. O campo 't' mostra a classificação atual e assume outros valores conforme essa classificação muda, então leia seu próprio valor em vez de assumir 'fe'.
Enviamos toda requisição de 1 cliente mínimo com 3 cabeçalhos e variamos apenas o caminho. Todo caminho de conteúdo que testamos retornou o mesmo 403 e a mesma pontuação 0,482, enquanto /robots.txt e uma URL que resolve para nada foram ao Apache desprotegido:
path                                       HTTP server     riskscore
/                                          403  DataDome   0.482
/listing/753913297/smoky-quartz-ring...    403  DataDome   0.482
/shop/AnemoneJewelry                       403  DataDome   0.482
/legal/terms/                              403  DataDome   0.482
/robots.txt                                200  Apache     -
/nonexistent-path-xyz                      404  Apache     -
Então, nos caminhos que o DataDome protege, ele avalia quem chama em vez da URL.
Uma requisição com um User-Agent do Googlebot pulou o DataDome e chegou a um limitador de taxa em vez disso. O Apache respondeu 429 Too Many Requests com uma string de referência nicki_. Pelo menos 1 agente declarado de mecanismo de busca alcança um limitador de taxa próprio, separado do DataDome.
Por que fingerprints de cabeçalho e TLS não são suficientes
A pontuação de risco permite testar o conselho usual sobre cabeçalhos, onde um número menor significa menos aparência de bot. Mantivemos o IP e a URL constantes, variamos apenas os cabeçalhos da requisição num cliente requests, e registramos a pontuação que o DataDome retornou:
headers sent                                         score    HTTP
requests, library default headers                    0.977    403
+ Chrome User-Agent only                             0.923    403
full 12-header Chrome set                            0.503    403
User-Agent + accept + sec-fetch-site (3 headers)     0.482    403
Essa tabela contém 2 resultados. Adicionar um User-Agent do Chrome quase não mudou a classificação, porque todo o resto da requisição ainda vinha do requests. E o conjunto de 3 cabeçalhos pontuou melhor que o conjunto completo de 12 cabeçalhos, então neste alvo a consistência importou mais que a quantidade de cabeçalhos.
Esses 3 cabeçalhos pontuaram 0,482, então copie o valor de accept exatamente:
User-Agent:      Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36
                 (KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36
accept:          text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,
                 image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7
sec-fetch-site:  none
Removemos 1 cabeçalho de cada vez do conjunto completo e registramos cada mudança, onde um sinal de mais significa que a pontuação piorou:
run                              score     change
full set (baseline)              0.503
minus accept                     0.845     +0.342
minus user-agent                 0.784     +0.281
minus sec-fetch-site             0.669     +0.166
minus every sec-ch-ua* header    0.503      0.000
O DataDome anuncia 7 dicas de cliente em seu próprio cabeçalho de resposta Accept-CH. Nosso conjunto completo tinha 3 delas, mas remover todos os cabeçalhos sec-ch-ua não mudou nada. O cabeçalho accept moveu a pontuação mais do que o User-Agent.
Personificação de TLS é o próximo passo usual, então testamos isso sozinho. Cada execução enviou os mesmos 3 cabeçalhos, e apenas o fingerprint de TLS e HTTP/2 mudou. Os valores JA4 abaixo vêm do curl_cffi em vez da Etsy, então mudam sempre que essa biblioteca atualiza um perfil:
transport                             JA4                      riskscore  HTTP
python requests (OpenSSL, HTTP/1.1)   t13d1712h1_ab0a1bf427ad  0.482      403
curl_cffi impersonate=chrome110       t13d1516h2_8daaf6152771  0.663      403
curl_cffi impersonate=chrome116       t13d1516h2_8daaf6152771  0.663      403
curl_cffi impersonate=chrome124       t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=chrome131       t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=chrome133a      t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=firefox133      t13d1716h2_5b57614c22b0  0.503      403
curl_cffi impersonate=safari17_0      t13d2014h2_a09f3c656075  0.663      403
curl_cffi impersonate=safari17_2_ios  t13d2014h2_a09f3c656075  0.663      403
Essa tabela contém 3 fingerprints diferentes, um para Chrome, Firefox e Safari. O requests simples em HTTP/1.1 ainda pontuou melhor que todos os 3. Essa coluna imprime apenas as 2 primeiras partes de um JA4. A terceira parte codifica a lista de extensões e difere entre os perfis Chrome que compartilham um prefixo aqui.
O transporte moveu a pontuação em 0,181 entre a melhor e a pior execução, mas nenhuma execução retornou uma página. Nenhum fingerprint que testamos foi suficiente sozinho.
Então fingerprints de TLS não valem o esforço neste alvo. Lemos os quadros HTTP/2 de volta de cada perfil, incluindo a ordem de pseudo-cabeçalhos que difere por engine:
profile      SETTINGS                       | window   | pri | pseudo-header order
chrome131    1:65536;2:0;4:6291456;6:262144 | 15663105 | 0   | m,a,s,p
firefox133   1:65536;2:0;4:131072;5:16384   | 12517377 | 0   | m,p,a,s
safari17_0   2:0;4:4194304;3:100            | 10485760 | 0   | m,s,p,a
Esses 3 handshakes são cópias corretas, e a Etsy recusou os 3. Então o DataDome decide com base em algo além do handshake.
O que realmente executa a verificação
Num navegador com interface, o desafio do DataDome aparece como um slider, e 2 de suas 4 razões são o IP que chama e o uso de ferramentas de desenvolvedor:
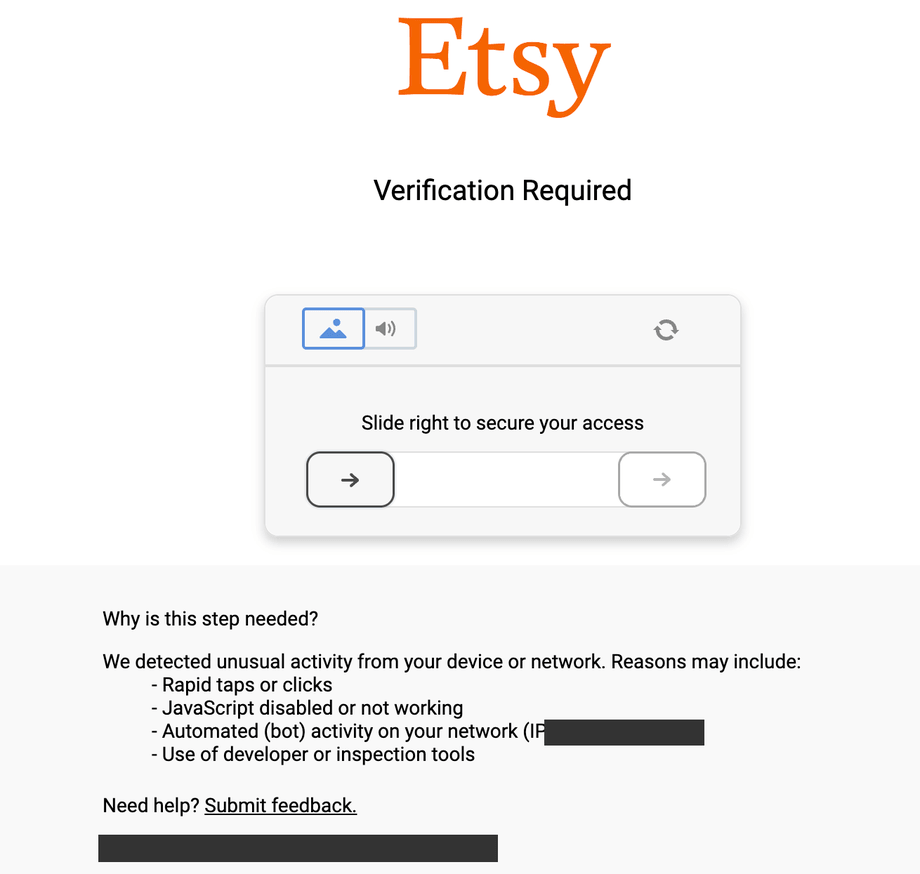
Esse carregador c.js tem 14 KB, constrói uma URL de iframe e busca uma segunda página. Essa segunda página continha um script inline de 596 KB no dia em que coletamos, e os nomes de seus módulos mostram o que você teria que reimplementar:
detection-js/dist/vm-obf.js     the detection engine, VM-obfuscated
detection-js/dist/captcha.js    challenge coordination
./picasso                       canvas-based device-class fingerprinting
./mouseMaths                    pointer-movement analysis
./slidercaptcha  ./hash  ./helpers  ./bean
O módulo de detecção é armazenado como bytecode para um interpretador incluído no mesmo arquivo. É por isso que uma busca de texto no pacote não encontra webdriver, cdc_, headless nem _phantom. Um pacote de bytecode esconde essas strings independentemente de as verificações rodarem ou não, então o resultado da busca não te diz nada.
A versão que coletamos se identificou como 1.34.0, cronometrou sua própria execução e enviou essa duração como um sinal. Essa versão também registrou um aviso no console pedindo para fechar as DevTools antes de continuar. Espere uma versão diferente e uma lista de módulos diferente até você verificar, já que esse motor segue o ciclo de lançamento do DataDome, não o da Etsy. A arquitetura por trás desses nomes muda bem mais devagar.
A requisição de verificação tem 16 campos e codifica o ambiente do navegador em userEnv, ddCaptchaEnv e plv3.
Então há 2 conclusões práticas. Reproduzir essa saída a partir do requests significa reimplementar uma VM ofuscada contra uma string de versão que incrementa. E o DataDome coleta saída de canvas e movimento de ponteiro, que só existem depois que um motor de navegador real renderizou a página. O desbloqueio específico para DataDome executa esse motor de navegador como um serviço e é construído para retornar a página renderizada em vez do bloqueio.
Essa segunda conclusão é testável, então executamos um Playwright Chromium simples sem patches furtivos e sem proxy. Cada modo rodou 3 vezes a partir do mesmo endereço no qual todo transporte acima foi recusado:
headless=True (default)        403  403  403     1,530 B    0.5s
headless=True --headless=new   403  403  403     1,530 B    0.4s
headless=False (headed)        200  200  200   532,049 B    2.2s   Product JSON-LD present
Ambas as janelas rodaram de 1 máquina sem proxy, então a janela com interface mostra preços na moeda local:
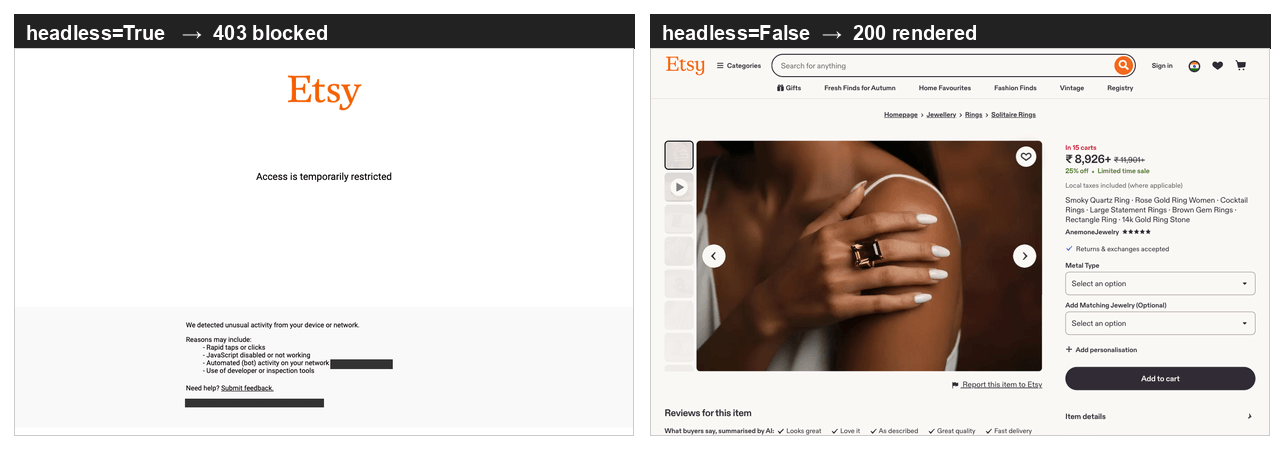
O Chromium headless inclui HeadlessChrome em seu próprio User-Agent, então essas linhas diferem em mais do que a janela. Para verificar uma página manualmente, ou puxar algumas páginas, um navegador com interface é a resposta mais simples. A infraestrutura de desbloqueio é construída para as requisições depois da primeira, e para uma única busca uma execução com interface é cerca de 10 vezes mais rápida do que rotear por ela.
Por que um navegador não é um crawler
Carregamos 12 anúncios um de cada vez numa única página de navegador, com 2 segundos de intervalo, e obtivemos 1 sucesso e 11 recusas:
#1   200   444,123 B
#2   403     1,527 B
#3-12 403   ~1,530 B each
Descartar o contexto de navegação entre as navegações restaurou o 200, então as recusas vieram do estado da sessão em vez do endereço. Mais tarde no mesmo período de teste, essa solução parou de funcionar. A Etsy então recusou toda requisição daquele endereço, independentemente de quão novo fosse o contexto.
A pontuação de risco não mudou enquanto a taxa de sucesso foi de toda requisição a nenhuma. A execução com 3 cabeçalhos ainda media 0.4822 com 4 casas decimais, horas e várias centenas de requisições depois da primeira leitura.
O cabeçalho X-DataDome-riskscore avalia 1 requisição por vez, então é útil para testar 1 mudança, mas não para monitorar um crawl. Um pipeline que o observa reportará sucesso enquanto não coleta nada.
Coletar mais do que algumas páginas precisa de 2 coisas, um novo contexto de navegação e um endereço que o DataDome ainda não tenha recusado. Descartar o contexto entre as navegações é barato, então comece por aí, mas essa solução dura apenas até o DataDome recusar o endereço. Proxies residenciais te dão um pool de endereços para alternar.
O Web Unlocker executa ambos, e o script mais abaixo permanece dentro da cota gratuita. A Browser API lida com ambos dentro de um navegador hospedado que seu código Playwright controla.
O que o robots.txt e os termos da Etsy não permitem
Antes de construir qualquer coisa, leia você mesmo o robots.txt da Etsy, porque o arquivo proíbe busca por palavra-chave e a Etsy o reescreve sem aviso. Quando lemos, esse arquivo tinha 1.818 linhas e declarava apenas 3 grupos de user-agent, *, AdsBot-Google-Mobile e Spinn3r:
User-agent: *
Disallow: /search?*q=
Disallow: /search/?*q=
Disallow: */shop/*/sold*
Disallow: */listing/*/favoriters*
Disallow: /api/
Allow:    /search/shops
O grupo curinga proíbe resultados de busca por palavra-chave em toda variante de localidade. Esse grupo cobre todo crawler que os outros 2 grupos não nomeiam. O histórico de anúncios vendidos e as contagens de favoritos também são proibidos, e estão entre os sinais de demanda mais claros que a Etsy publica. Páginas de anúncios e páginas de lojas não têm regra Disallow, então ambas permanecem abertas.
O arquivo não declara diretiva Sitemap:, e /sitemaps.xml responde 403 com corpo vazio. Essas 2 ausências importam tanto quanto as regras Disallow acima. Ambas são verificações de 1 linha que vale a pena repetir, porque a Etsy pode adicionar qualquer uma de volta sem aviso. Enquanto permanecerem ausentes, você precisa descobrir anúncios a partir das páginas que a Etsy deixa abertas.
A Etsy não nomeou nenhum crawler de IA em nenhum lugar do arquivo quando lemos, e não publicou nenhum llms.txt ou ai.txt. Essa ausência é a coisa mais provável nesta seção de ter mudado desde que verificamos.
O DataDome recusa esses crawlers na borda de qualquer forma. GPTBot e ClaudeBot receberam ambos um 403, e ambos pontuaram 0,9814 em nosso teste, mais alto que o 0,923 que o mesmo endereço pontuou com um User-Agent do Chrome. Strings de User-Agent sem sentido com os mesmos cabeçalhos tiveram a mesma pontuação, então o DataDome avalia a ausência de um navegador conhecido em vez do nome do crawler.
Os Termos de Uso da Etsy, atualizados pela última vez em 26 de agosto de 2025, declaram que você concorda em “não rastrear, fazer scraping ou spider em nenhuma página dos Serviços” sem permissão expressa.
Verifique se sua camada de coleta aplica o robots.txt para você, e em que ponto ela decide. O endpoint de desbloqueio residencial decide por requisição. Numa conta sem KYC concluído, uma requisição para o caminho de busca proibido retorna a regra e o formulário de KYC:
Residential Failed (bad_endpoint): Requested site is not available for immediate
residential (no KYC) access mode in accordance with robots.txt. To get full
residential access for targeting this site, fill in the KYC form:
https://brightdata.com/cp/kyc
A mesma conta buscou /shop/AnemoneJewelry sem erro, e a resposta teve 983.937 bytes. O endpoint lê o mesmo robots.txt que você leu, depois serve os caminhos permitidos e encaminha os caminhos proibidos para uma revisão de conformidade em vez de para um proxy. Decida se seu caso de uso precisa dos caminhos proibidos antes de começar a construir.
Se você construir a camada de busca por conta própria, você toma essa decisão no código, e você possui e mantém o tratamento do robots.txt por alvo.
O que a API oficial da Etsy retorna, e o que ela omite
A API é o caminho autorizado, então verifique o que ela faz antes de rejeitá-la. A escolha entre uma API oficial e scraping é geral, e na Etsy depende dos campos que a especificação omite. Puxamos a especificação OpenAPI diretamente e contamos 76 caminhos, dos quais 31 operações GET precisam apenas de uma chave de aplicação e nenhum OAuth de vendedor. Esses totais mudam sempre que a Etsy adiciona ou remove um endpoint, então recontabilize a partir desse arquivo em vez deste parágrafo.
Alegações comuns sobre a API v3 estão erradas em 3 pontos. findAllListingsActive não foi removido, e aceita keywords, min_price, max_price, taxonomy_id, shop_location, currency e buyer_country, com um limit máximo de 100 por chamada. getReviewsByListing e getReviewsByShop retornam texto de avaliação apenas com uma chave de aplicação. getShop retorna transaction_sold_count, review_count, review_average, num_favorers e listing_active_count para qualquer loja.
A especificação carrega 1 campo de demanda e omite o resto. getListing precisa apenas de uma chave de aplicação e retorna views, uma contagem de visualizações cumulativa atualizada uma vez por dia, no schema ShopListingWithAssociations. Buscar no documento inteiro não retorna nenhum campo para volume de busca, impressões, taxa de conversão ou vendas por anúncio. O schema ShopListing tinha 50 propriedades quando contamos, incluindo num_favorers, quantity e price, e nenhuma delas era uma contagem de vendas. Reverifique a contagem contra a especificação, mas nenhum campo de vendas apareceu ainda.
Transações por anúncio têm um endpoint próprio, getShopReceiptTransactionsByListing, mas precisa do escopo OAuth transactions_r, que apenas o dono da loja pode conceder para sua própria loja. Para qualquer loja que você não opera, a Etsy publica vendas vitalícias em nível de loja como um total atual sem histórico, e nada por anúncio.
Essa lacuna explica o mercado de ferramentas de terceiros em torno da Etsy. Alguns produtos vendem estimativas de vendas por anúncio ou volume de busca por palavra-chave para lojas que não operam. Nada na especificação que lemos retorna esses números para uma loja que você não possui, então esses dados devem vir de fora dessa API.
A Etsy aplica limites de taxa por chave de aplicação, por segundo e por dia. Os cabeçalhos de resposta x-limit-per-second e x-limit-per-day reportam ambos, e a Etsy retorna um 429 com retry-after quando você excede qualquer um deles.
A página de limites de taxa rotula seus números como “Valor de Exemplo” em vez de padrões. O antigo par “10.000 por dia, 10 por segundo” tinha sumido dessa página quando lemos. Leia seus próprios limites no Portal de Desenvolvedores.
Fazer scraping de páginas de anúncios e lojas da Etsy com Python
Páginas de anúncios da Etsy incorporam JSON-LD do schema.org, então a etapa de extração não precisa de seletores CSS e não quebra quando a Etsy reestiliza o markup ao redor. A etapa de busca precisa de infraestrutura, e você tem 2 formas de fazer isso. Uma API desbloqueada roda em qualquer lugar e precisa de uma conta. Um navegador local não precisa de conta e serve para algumas páginas.
O script abaixo precisa de 1 biblioteca e 2 variáveis de ambiente:
python3 -m venv .venv && source .venv/bin/activate
pip install requests
export BRIGHTDATA_API_KEY="your-api-token"
export BRIGHTDATA_ZONE="web_unlocker"
O token vem do painel de controle da Bright Data. Toda requisição com esse token gasta o saldo da sua conta, então mantenha-o numa variável de ambiente em vez de num script versionado.
Você cria o segundo valor em Web Access → Add API → Web Unlocker API. O payload da requisição a chama de zone, mas o painel de controle a rotulou como uma API quando configuramos isso, então buscar no painel por “zone” não encontrou nada. BRIGHTDATA_ZONE precisa corresponder ao nome que você digita lá, já que o script usa web_unlocker como padrão. O formulário avisa que o nome é permanente:
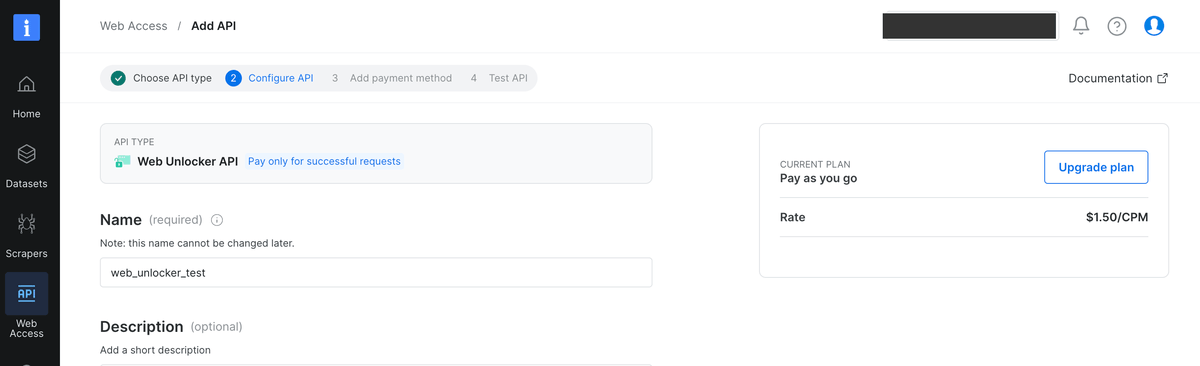
A zona nessa captura se chama web_unlocker_test, então o padrão do script não a encontraria. Ou defina BRIGHTDATA_ZONE para o nome que você digitou, ou use web_unlocker e deixe o padrão como está. O guia rápido do Web Unlocker documenta ambos, e começamos na cota gratuita sem cartão quando configuramos isso. A página de preços do Web Unlocker lista a cota gratuita atual e a taxa de pagamento por uso além dela, cotada por 1 mil requisições bem-sucedidas. O painel escreve essa taxa como um CPM.
Este script envia a requisição pelo endpoint do Web Unlocker e analisa o resultado:
import json
import os
import re
import requests

API_KEY = os.environ.get("BRIGHTDATA_API_KEY")
ZONE = os.environ.get("BRIGHTDATA_ZONE", "web_unlocker")
ENDPOINT = "https://api.brightdata.com/request"

LD_JSON = re.compile(
    r'<script[^>]*type\s*=\s*[\'"]application/ld\+json[\'"][^>]*>(.*?)</script\s*>',
    re.S | re.I,
)


def fetch_html(url, country="us"):
    """Return the rendered HTML for an Etsy URL, or raise on failure."""
    # Checked here rather than at import, so the browser path below runs
    # without an account.
    if not API_KEY:
        raise SystemExit("BRIGHTDATA_API_KEY is not set, see the exports above")
    response = requests.post(
        ENDPOINT,
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={"zone": ZONE, "url": url, "format": "raw", "country": country},
        timeout=90,
    )
    response.raise_for_status()
    body = response.text
    # A quota error arrives as HTTP 200 with a short text body, and a block page
    # arrives as HTTP 200 of valid HTML. Neither contains ld+json, which is the
    # content this actually wants, so test for that rather than for either error.
    if not LD_JSON.search(body):
        raise RuntimeError(f"no ld+json in response, most likely blocked: {body[:200]!r}")
    return body


def product_jsonld(html):
    """Pick the Product block by @type. Every listing we opened had four."""
    for block in LD_JSON.findall(html):
        try:
            parsed = json.loads(block.strip())
        except json.JSONDecodeError:
            continue
        for node in parsed if isinstance(parsed, list) else [parsed]:
            if node.get("@type") == "Product":
                return node
    return None


def parse_listing(node):
    """Flatten a Product node, keeping the offer's range rather than its lowest price."""
    offer = node.get("offers", {})
    # schema.org allows a list of offers and a single priceSpecification object,
    # and Etsy serves both, so normalize before indexing into them.
    if isinstance(offer, list):
        offer = offer[0] if offer else {}
    specs = offer.get("priceSpecification", [])
    if isinstance(specs, dict):
        specs = [specs]
    base = next((s for s in specs if "priceType" not in s), {})
    was = next(
        (s for s in specs if "Strikethrough" in str(s.get("priceType", ""))), {}
    )
    # Not every listing carries a priceSpecification. Without this fallback a
    # single-variant listing records a null price and raises nothing.
    # A range arrives three ways: nested in priceSpecification, as AggregateOffer's
    # own lowPrice and highPrice, or not at all. Try them in that order.
    low = base.get("minPrice") or offer.get("lowPrice") or offer.get("price")
    high = base.get("maxPrice") or offer.get("highPrice") or offer.get("price")
    # availability is the only field that marks a dead listing, and JSON-LD lets it
    # arrive as a bare term, an array, or an @id object. Normalize before comparing.
    avail = offer.get("availability") or ""
    if isinstance(avail, list):
        avail = avail[0] if avail else ""
    if isinstance(avail, dict):
        avail = avail.get("@id", "")
    rating = node.get("aggregateRating", {})
    return {
        "sku": node.get("sku"),
        "title": node.get("name"),
        # Etsy serves a dead listing as a full HTTP 200 page that still
        # carries a price, so availability is the only field that says so.
        "availability": str(avail).rsplit("/", 1)[-1],
        "currency": offer.get("priceCurrency"),
        "price_min": low,
        # high can be a bundle maximum rather than the item's, where a listing
        # has an add-on axis. Count the axes before trusting it as a maximum.
        "price_max": high,
        "list_price": was.get("price"),
        # True only where the variations differ in price. Same-price variants
        # read false, so this is a price-spread test, not a variation test.
        "has_variations": None if low is None else low != high,
        "rating": rating.get("ratingValue"),
        "review_count": rating.get("reviewCount"),
        "shop": node.get("brand", {}).get("name"),
    }


if __name__ == "__main__":
    url = (
        "https://www.etsy.com/listing/753913297/"
        "smoky-quartz-ring-rose-gold-ring-women"
    )
    node = product_jsonld(fetch_html(url, country="us"))
    if node is None:
        raise SystemExit("no Product block on page: blocked, or the layout changed")
    print(json.dumps(parse_listing(node), indent=2))
Executamos o script contra um anúncio ao vivo, e ele retornou um registro plano. A faixa de preço vem de 1 anúncio com muitas variações precificadas separadamente:
{
  "sku": "753913297",
  "title": "Smoky Quartz Ring · Rose Gold Ring Women · Cocktail Rings · ...",
  "availability": "InStock",
  "currency": "USD",
  "price_min": "89.25",
  "price_max": "5613.75",
  "list_price": "119.00",
  "has_variations": true,
  "rating": "4.5",
  "review_count": 99,
  "shop": "AnemoneJewelry"
}
Em 3 execuções contra o mesmo anúncio, as buscas levaram de 23 a 27 segundos e retornaram entre 540 KB e 750 KB. Esses números são o custo da etapa de desbloqueio. Faça orçamento para latência nessa faixa, não para o tempo abaixo de um segundo de um bloqueio.
Se você só precisa de algumas páginas e prefere não abrir uma conta, um navegador local alcança o mesmo resultado com mais ou menos a mesma quantidade de código. Esse navegador roda de um endereço que o DataDome ainda não recusou. Precisa de um display, então, num servidor, rode com interface sob um display virtual como o Xvfb em vez de modo headless. Instale o Playwright e o Chromium uma vez:
python3 -m venv .venv && source .venv/bin/activate   # skip if already active
pip install playwright requests
playwright install chromium
Depois troque a busca, mantendo as mesmas 2 funções de parsing. Coloque isto acima do bloco __main__, com as outras funções:
from playwright.sync_api import sync_playwright


def fetch_html_browser(url):
    """Fetch one page with a visible browser, since headless returns a 403."""
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=False)
        context = browser.new_context(locale="en-US")
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        html = page.content()
        browser.close()
        # Same rule as the guard above: test for the content you want. A block
        # page is valid HTML, so only the missing ld+json shows it.
        if not LD_JSON.search(html):
            raise RuntimeError("no ld+json on page, most likely a block page")
        return html
Mude 1 linha dentro do bloco __main__, e nada mais:
node = product_jsonld(fetch_html_browser(url)) # was: fetch_html(url, country="us")Nossa execução retornou 535.247 bytes e analisou corretamente pelas mesmas 2 funções. A página também estava precificada em INR, porque um navegador na sua máquina sai do seu próprio endereço, e o caminho do navegador não aceita argumento de country. Sem esse argumento você não consegue definir o país de saída, então esse caminho serve para algumas páginas em vez de um dataset.
O código acima analisa a página em vez de enviá-la a um modelo. A Etsy publica os campos como dados estruturados, então lê-los é determinístico e efetivamente gratuito. No anúncio que medimos, selecionar o bloco Product e achatá-lo leva uma mediana de 0,3 milissegundos.
Passar a mesma página para um modelo de linguagem em vez disso significa 179.599 tokens de HTML bruto, a maior parte de uma janela de contexto de 200 mil tokens para 1 produto. Remover o markup primeiro corta isso para 5.352 tokens, uma redução de 97%. Essa proporção importa mais do que a escolha do modelo.
Mas um parser que para de encontrar correspondência retorna um campo vazio em vez de um erro, enquanto um modelo produziria ao menos algo errado e visível. Então use o caminho determinístico num site que publica schema.org. Use o tempo que você economiza para verificar se o parser ainda retorna os campos esperados.
Páginas de loja também têm 4 desses blocos, sob tipos diferentes, e um deles mostra de onde vêm as URLs de anúncios. /shop/{shop_name} retorna um nó Organization descrevendo a loja e um nó ItemList cujo itemListElement contém URLs completas de anúncios. shop_itemlist seleciona o ItemList por @type, então a mesma função com Organization em seu lugar retorna os próprios campos da loja. Na loja que testamos, numberOfItems lia 1.842 enquanto uma única página retornava 36 URLs, e ?page=2 retornava mais 36 sem sobreposição.
O enumerador recebe um nome de loja como entrada, então você precisa de uma fonte para nomes de lojas, e 3 fontes funcionam sem tocar no caminho de busca proibido. Você pode usar lojas que já acompanha, o endpoint findAllListingsActive acima, ou um dataset preparado. Esse endpoint aceita keywords apenas com uma chave de aplicação, e inclui um shop_id em todo anúncio que retorna.
Buscamos páginas ao longo do intervalo e além do fim declarado:
page  2    36 items
page 25    36 items
page 51    36 items
page 52     6 items      51 x 36 + 6 = 1,842
page 53    no ItemList block
page 60    no ItemList block
O total corresponde aos 1.842 que a loja declara. Depois do fim, a Etsy continua respondendo com uma página completa de aproximadamente 420 KB e sem ItemList.
A Etsy não dá erro nem array vazio para terminar, então um loop que espera por qualquer um dos dois vai continuar paginando para sempre contra páginas que parecem normais. Termine com base no bloco ausente, e deixe a contagem declarada verificar seu trabalho. Os padrões usuais para coleta paginada assumem um desses 2 sinais, então eles não se aplicam aqui.
Ambas as funções pertencem ao mesmo arquivo das funções anteriores, já que usam LD_JSON e fetch_html. Comente o ponto de entrada que você não está executando, já que o enumerador leva 20 minutos:
def shop_itemlist(html):
    """Pick the ItemList block. The first block on a shop page is a video."""
    for block in LD_JSON.findall(html):
        try:
            parsed = json.loads(block.strip())
        except json.JSONDecodeError:
            continue
        for node in parsed if isinstance(parsed, list) else [parsed]:
            if node.get("@type") == "ItemList":
                return node
    return None


def enumerate_shop(shop_name, country="us"):
    """Page a shop until the ItemList stops appearing, and hand back the declared
    count so the caller can check it."""
    base = f"https://www.etsy.com/shop/{shop_name}"
    urls, declared, page = [], None, 1
    while True:
        suffix = "" if page == 1 else f"?page={page}"
        try:
            node = shop_itemlist(fetch_html(base + suffix, country=country))
            if node is None:
                break
            declared = node.get("numberOfItems", declared)
            urls += [item["item"]["url"] for item in node["itemListElement"]]
        except (RuntimeError, requests.RequestException, KeyError, TypeError,
            AttributeError) as err:
            print(f"stopped at page {page}: {err}", flush=True)
            break
        print(f"page {page}: {len(urls)} of {declared}", flush=True)
        # Breaking on the declared count here would make the comparison below
        # vacuous, so page until the ItemList block stops appearing.
        page += 1
    return urls, declared


if __name__ == "__main__":
    urls, declared = enumerate_shop("AnemoneJewelry")
    print(len(urls), "collected,", declared, "declared")
O enumerador faz 53 buscas contra as páginas medidas acima, retorna 1.842 URLs, e verifica o total contra a contagem que a loja declara. Compare esses 2 números a cada execução, porque uma leitura curta retorna menos URLs e não gera erro algum.
O try precisa cobrir o parsing além da busca. Um loop de 53 requisições é longo o suficiente para receber a resposta de limite de taxa, e um único itemListElement malformado causa o mesmo dano que uma requisição falha. Sem a proteção, qualquer um dos dois gera erro na página 30 e descarta toda URL coletada até ali. Capturar ambos deixa você com uma leitura curta em vez de uma execução perdida, e a comparação de contagem mostra isso. Tratar requisições falhas em Python segue um padrão comum, e a única parte específica da Etsy é colocar o parsing dentro da proteção.
Na latência medida acima, 53 buscas são 20 a 24 minutos e 53 requisições da cota mensal gratuita, para 1 loja. Execute o enumerador numa loja pequena primeiro e observe a contagem de páginas aumentar antes de usá-lo numa loja com 1.842 anúncios. Defina também um limite de uso na zona, para que uma execução que dá errado pare num teto em vez de no seu saldo.
Executamos a mesma descoberta pelo endpoint de loja da Etsy do Web Scraper API como um trabalho em lote. Executamos o trabalho na loja em vez de nas URLs de anúncios, e limitamos a 50 registros para a comparação. Retornou 50 anúncios em 168,9 segundos, ou aproximadamente 3,4 segundos por registro, sem duplicatas e sem URLs prefixadas por localidade nessa execução.
Coletar toda essa loja leva 53 buscas de enumeração mais 1.842 buscas de anúncios, ou 1.895 requisições e aproximadamente 13 horas com uma única thread. Verifique essas 1.895 contra a cota gratuita atual antes de começar. Além dessa cota, o mesmo trabalho é cobrado na taxa de pagamento por uso por 1 mil requisições bem-sucedidas.
Fixe country aqui também. Buscamos a mesma loja sem isso e obtivemos URLs /de/listing/ e títulos em alemão. Essas URLs entrariam num dataset como chaves diferentes para itens já armazenados sob sua forma /listing/.
Problemas de extração que corrompem silenciosamente um dataset da Etsy
Cada problema aqui retorna HTTP 200 e não gera exceção. Dos 5, 4 escrevem uma linha plausível mas errada e o quinto escreve uma linha vazia. Em vez disso, você encontra um número errado meses depois. Métricas de qualidade de dados pegam esse tipo de falha depois que os dados já estão armazenados, e não escrever a linha ruim é mais barato.
Uma página de anúncio tem 4 blocos JSON-LD, não 1. A Etsy incluiu Product, VideoObject, BreadcrumbList e FAQPage em 4 tags de script separadas em todo anúncio que abrimos, todas com o tipo application/ld+json. O código-fonte da página mostra-os em 4 linhas consecutivas:
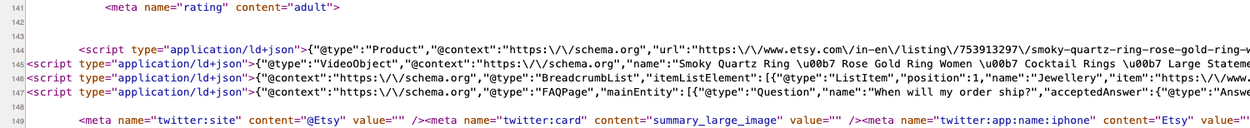
Código que chama find() e pega a primeira correspondência funciona em páginas de anúncios e retorna silenciosamente o bloco de vídeo em páginas de loja. Selecione por @type em vez de posição. Nada mais sobre a mecânica de analisar JSON em Python muda.
Uma página de loja tem 4 blocos próprios, em uma ordem diferente:
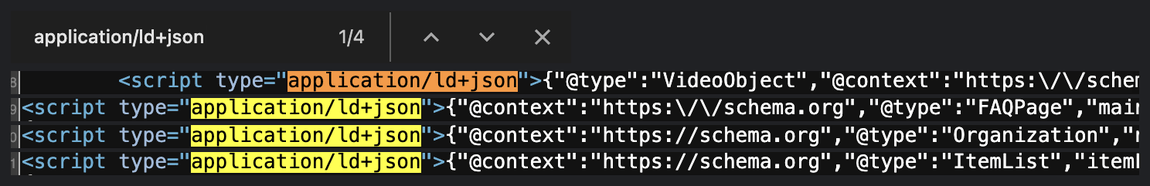
Na loja que testamos, o primeiro bloco é um vídeo e o ItemList desejado vem por último, então pegar a primeira correspondência falha. O script acima seleciona por @type em vez disso.
Num anúncio com variações, offers.price é o preço mais baixo da faixa, não a faixa inteira. No anúncio que testamos, offers.price lia 89.25 enquanto a entrada priceSpecification aninhada dentro de offers declarava minPrice 89.25 e maxPrice 5613.75. Um parser que lê offers.price registra a variação mais barata e descarta a faixa. Armazenar maxPrice em vez disso também não é a solução, porque neste anúncio maxPrice é o preço de um pacote em vez do item sozinho.
Coletamos a mesma URL com variações ativadas e obtivemos 61 registros separados, 1 por variante, precificados de 89,25 a 1.871,25. Uma única linha de anúncio na sua tabela representa 61 SKUs compráveis numa faixa de preço de 21x.
Um segundo menu suspenso na página multiplica essa faixa:
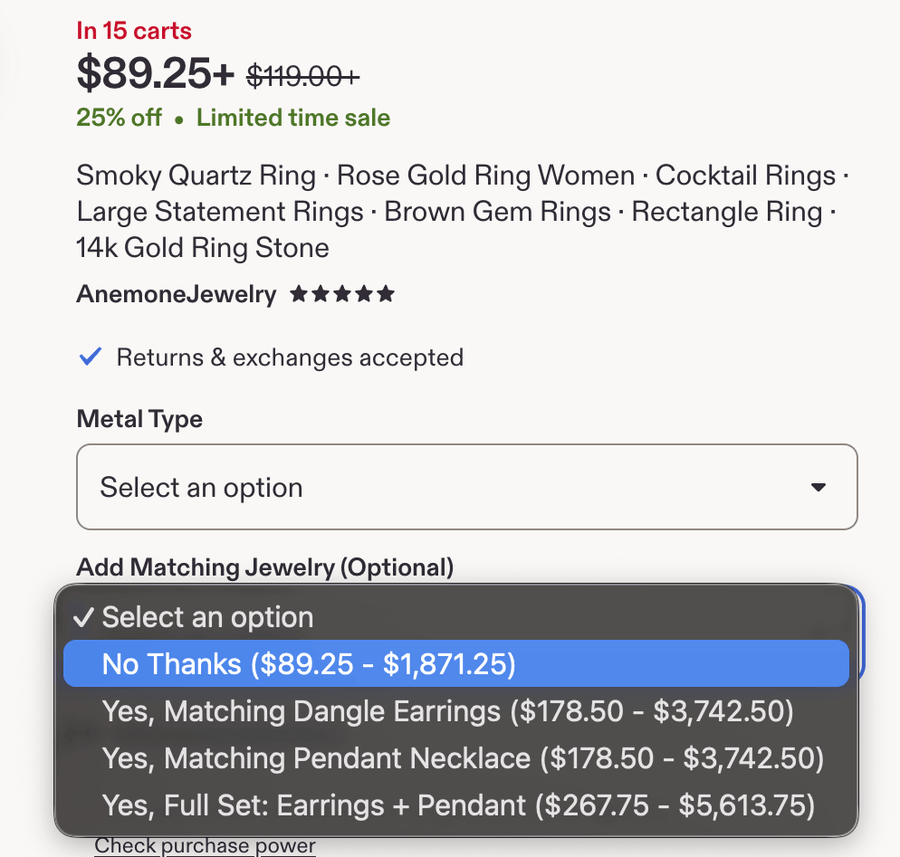
Esses 2 máximos medem coisas diferentes, e este anúncio tem 2 eixos de variação. Metal Type vai de 14k Gold Filled a 89,25 até as 3 opções de ouro maciço a 1.871,25. Add Matching Jewelry (Optional) então multiplica essa faixa. No Thanks vai de 89,25 a 1.871,25, qualquer peça combinando individual vai de 178,50 a 3.742,50, e Full Set: Earrings + Pendant vai de 267,75 a 5.613,75.
O maxPrice declarado é o anel de ouro maciço mais ambas as peças combinando, 3 itens em 1 preço. O extrato de variação retornou o anel sozinho e correspondeu à linha No Thanks com precisão de centavos.
Então, sempre que um anúncio tem um eixo adicional, maxPrice é o máximo de um pacote em vez do item. Uma série de preços construída sobre isso silenciosamente acompanha pacotes. Conte os eixos de variação antes de armazenar uma faixa como própria do produto. Eles não estão no JSON-LD, então leia-os da página renderizada ou extraia a variação.
O mesmo array priceSpecification também contém uma segunda entrada marcada StrikethroughPrice, então o preço promocional e o preço de tabela aparecem lado a lado, diferenciados apenas por uma URL de schema.org. Essa entrada tem seu próprio minPrice e maxPrice. O list_price que o script registra é o preço mais baixo na faixa de preço de tabela, assim como offers.price é o mais baixo na faixa atual.
A localidade segue o IP de saída, e muda mais do que o símbolo da moeda. Buscamos 1 anúncio 3 vezes na mesma hora, mudando apenas o país de saída:
country   currency   price    variation range      title
us        USD        89.25    89.25 - 5613.75      Smoky Quartz Ring, Rose Gold Ring Women
de        EUR        95.71    95.71 - 5058.76      Rauchquarzring, Damenring aus Roségold
gb        GBP        82.77    82.77 - 4338.22      Smoky Quartz Ring, Rose Gold Ring Women
O mesmo anúncio é renderizado de forma diferente a partir de cada país de saída:
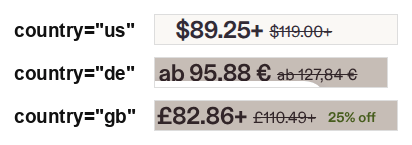
Essas capturas vêm de uma busca posterior às 3 linhas, e apenas o valor em dólar permaneceu o mesmo. A página alemã também escreve seu preço mais baixo como ab, ou “a partir de”, e o + marca a mesma coisa nas outras 2 páginas.
As 3 buscas retornaram o mesmo SKU, avaliação e contagem de avaliações, em 3 preços diferentes em 3 moedas. A proporção entre o preço mais baixo e mais alto difere nas 3 linhas, 62,9x na linha dos EUA contra 52,9x e 52,4x, então mais do que a taxa de câmbio mudou entre essas buscas. A saída alemã também retornou um título traduzido por máquina, enquanto as 2 localidades em inglês mantiveram o original.
Um pool rotativo que ignora geografia produz uma série de preços misturando 3 moedas e um corpus de texto misturando idiomas, e nada no pipeline reporta um problema. Fixe o país de saída por execução de coleta e armazene a moeda junto de cada preço.
O mesmo problema aparece em dados preparados. A amostra de 1.000 registros que baixamos tinha 19 moedas, com 109 linhas em uma moeda diferente de USD, 14 delas precificadas em dong vietnamita. Essa amostra se atualiza, então sua cópia vai diferir desses totais. Execute a mesma comparação na sua própria cópia.
Calcular a média da coluna de preço sem ler a coluna de moeda infla a média:
mean(final_price), all rows          31,238.84   n=991
mean(final_price), currency = USD       137.57   n=882
                                        ~227x
median(final_price), all rows            26.00
Nessa coluna, 14 linhas de 991 contribuem com 87% do total, mas 109 linhas não são em USD e todas precisam de tratamento. A consulta roda, a coluna é um float limpo, e a resposta está errada por 2 ordens de grandeza. A mediana quase não se move, porque as linhas não-USD são uma pequena fração da coluna. Uma média e mediana que discordam tanto só te dizem que há uma cauda pesada presente. Agrupar pela coluna de moeda separa unidades misturadas de assimetria comum.
Um artigo do arXiv de março de 2026 sobre anúncios de marketplace, citado novamente mais abaixo, restringiu sua amostra a anúncios precificados em USD antes de rodar qualquer análise. Isso resolve o problema depois da coleta em vez de durante ela. Filtrar dessa forma também muda a população que a média descreve, já que descarta anúncios em outras moedas em vez de convertê-los.
Esse problema é mais difícil de ver no caminho de agentes. Buscamos este anúncio por um servidor MCP cujo schema aceita apenas uma URL, e obtivemos a vitrine tcheca precificada em CZK. A chamada REST com país fixo reporta o mesmo anúncio a 89,25 USD.
A causa é a interface da ferramenta, não a busca. Sem parâmetro de país ou localidade para definir, você recebe qualquer saída que o servidor estiver usando. Verifique esse comportamento em qualquer servidor desse tipo antes de conectá-lo a um agente, porque a saída decide a moeda de toda resposta a jusante.
Então colete dados da Etsy no seu próprio armazenamento numa localidade fixa, e faça o agente ler esse armazenamento em vez de buscar ao vivo por pergunta. Um agente que silenciosamente responde numa moeda diferente a cada vez é pior do que um agente que não consegue responder.
Um anúncio morto é uma página completa com um preço nela. A Etsy não retorna um 404 para um anúncio expirado ou esgotado. Puxamos um anúncio de 2007 e obtivemos HTTP 200, 465.563 bytes, um bloco Product completo, e price 13.00 USD.
A página é renderizada por completo, e mostra tanto o banner de esgotado quanto o preço:
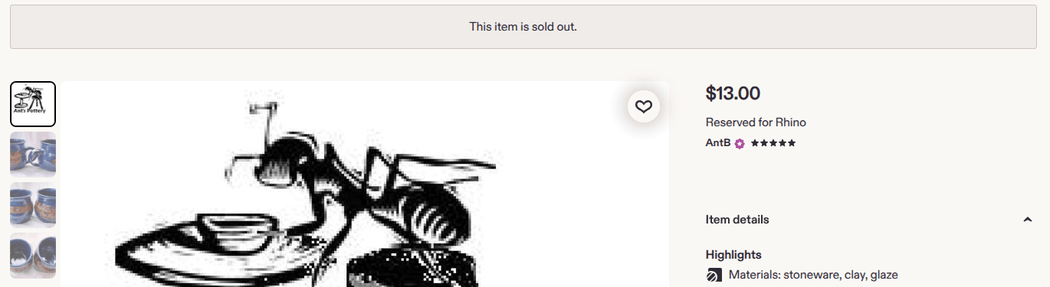
offers.availability é o único campo que contradiz o preço, e lê schema.org/OutOfStock. Um parser que o ignora registra um item morto a preço cheio, então o script acima lê esse campo.
Esse campo é menos confiável em dados preparados do que na página. Na mesma cópia, 74 de 1.000 linhas eram anúncios esgotados, availability estava vazio em todas as 74, e 65 ainda mostravam um preço numérico. O sinal ali é um parâmetro show_sold_out_detail na URL armazenada. Manter apenas as linhas cujo availability lê InStock descartaria 798 linhas ativas, porque o campo está ausente na maioria delas também.
Uma resposta 2xx não significa que você tem dados. Esse problema está na camada de coleta em vez do payload, e vimos isso com o script acima durante os testes. O endpoint de desbloqueio se explica no corpo. Quando a conta atingiu um limite de taxa de requisições, respondeu 200 com um corpo de texto simples de 111 bytes dizendo Your system is sending too many of this type of request. A linha de status continua sendo sucesso, então raise_for_status() passa, o parser não encontra nenhum bloco Product, e um loop escreve linhas vazias sem uma única exceção.
O Web Scraper API trata o mesmo caso por design. Seu endpoint de coleta síncrona retorna registros em até 1 minuto, e trabalhos mais longos continuam de forma assíncrona. O mesmo endpoint responde 202 com um snapshot_id e um retry-after quando um trabalho passa desse minuto, então você pode coletar o resultado quando estiver pronto, como documenta a referência da API. Ambas as respostas são status de sucesso, então faça a bifurcação pelo código de status antes de indexar numa lista de registros.
A proteção em fetch_html tem 2 linhas e testa por uma página contendo ld+json em vez de por qualquer um dos erros. Executar o enumerador contra uma loja ativa encontrou um terceiro caso, um 200 com corpo vazio, e a mesma proteção o pegou sem qualquer mudança. Então teste a resposta pelo conteúdo que você quer em vez dos erros que você já viu, já que o texto de erro do fornecedor não é uma interface estável. Escreva o equivalente para qualquer camada de busca que você usar, porque um status de sucesso não garante o payload.
Um exemplo testado prova que um problema existe, não que é comum. Verificamos os problemas de faixa de preço e preço riscado contra 100 anúncios de ambos os caminhos de descoberta. Variações estão presentes em 98 de 100, e initial_price difere de final_price nos mesmos 98. Nenhum dos dois problemas é um caso extremo que você pode adiar. Esses 100 vieram pelos 2 caminhos de descoberta acima em vez de uma amostra aleatória pelas categorias da Etsy. Então leia 98 como um mínimo para anúncios de joalheria em vez de uma taxa para o site.
A mesma verificação mostra que o anúncio usado acima é incomum em um aspecto. Esse anúncio tem 99 avaliações, enquanto a mediana é 1 nesse crawl e 0 na amostra de dataset publicada.
Quando comprar um dataset gerenciado em vez de manter um scraper
Você pode construir o scraper, e o código acima é a maior parte dele. A decisão é sobre quais falhas você quer tratar você mesmo.
Executamos o mesmo anúncio pelo Web Scraper API novamente, desta vez coletando por URL em vez de descobrir a partir de uma loja. Retornou 58 campos contra os 14 no bloco Product bruto, e os campos extras tratam da maioria dos problemas acima:
raw JSON-LD (geo=us)          Web Scraper API
-----------------------------------------------------
price 89.25 (range minimum)   final_price 89.25
119.00 (StrikethroughPrice)   initial_price 119
not present                   discount_percentage 25
not present                   listing_has_variations true
not present                   reviews_count_shop 15129
not present                   is_star_seller false
4 embedded reviews            6 top_reviews
14 fields                     58 fields
Você configura esse extrator por URL de entrada, e define all_variations como true para o problema da faixa de preço:
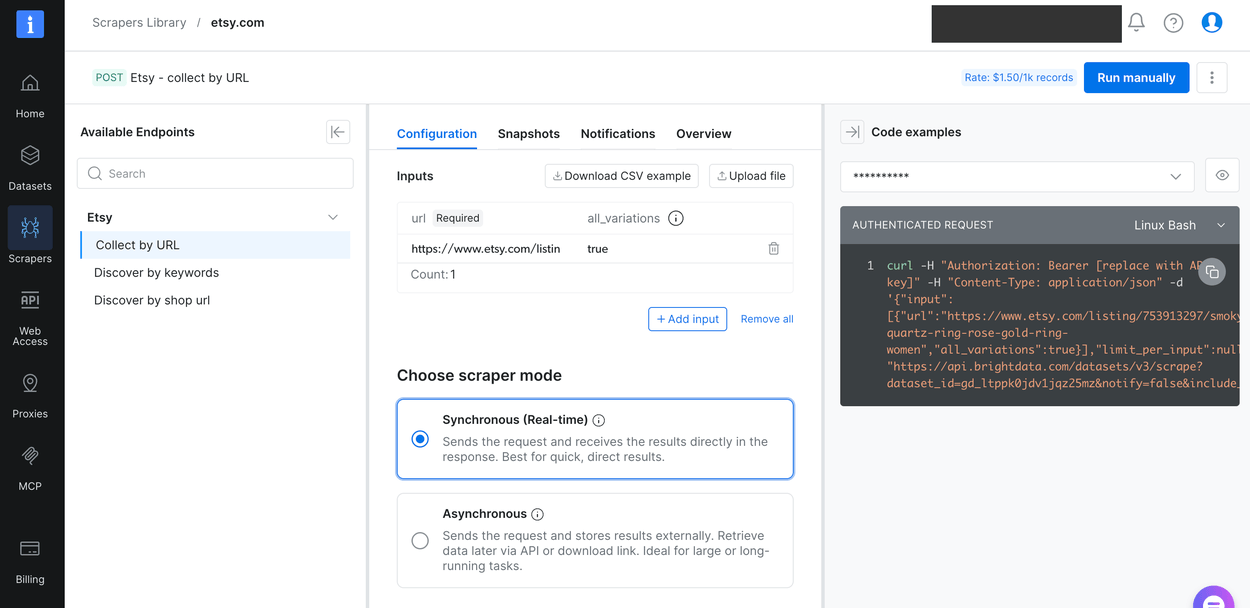
Os 6 campos que comparamos entre ambos os caminhos concordaram exatamente, e eram moeda, preço cobrado, preço de tabela, avaliação, contagem de avaliações do item e origem do envio. Execute essa verificação antes de confiar em qualquer um dos caminhos.
A comparação de tempo se inverte, e o modo decide por quanto. Pelo endpoint síncrono, a extração estruturada levou cerca de 50 segundos para um único registro, contra 27 segundos para a busca bruta. Ela renderiza e normaliza em vez de retornar bytes. Os 50 segundos deixam cerca de 10 segundos dentro do timeout de 1 minuto acima. O endpoint é construído para 1 URL e uma resposta agora.
Executamos o mesmo scraper como um trabalho em lote e obtivemos os 50 registros acima a 3,4 segundos cada. Cada registro custa aproximadamente 1/8 dos 27 segundos que uma busca bruta leva. No modo em lote, o 202 é a resposta esperada, não um erro para tratar.
Para um crawl recorrente, o caminho estruturado remove a manutenção de seletores, a fixação de localidade e o tratamento de faixa de preço da sua equipe, para os campos que retorna. Para 1 anúncio, é mais lento qualquer que seja o modo escolhido. A comparação acima mostra o tratamento de preço resolvido, e a execução de 50 registros não mostrou URLs prefixadas por localidade. A manutenção de seletores é a única parte que nenhuma execução única consegue testar. O caminho estruturado é cobrado da mesma forma que o Web Unlocker, com a cota gratuita atual e taxa por 1 mil registros na página de preços do Web Scraper API.
A mesma amostra contém 2 tipos de registro em vez de 1, então planeje para ambos no lado da compra. Das 1.000 linhas, 128 têm o conjunto completo de campos, e as outras 872 deixam 12 de seus campos vazios, incluindo description, product_category e store_country.
A divisão acompanha a idade do anúncio, com o registro completo em itens listados a partir do final de 2025. Um extrato em massa abrangendo anos, portanto, mistura ambos os tipos em 1 arquivo. Essa proporção deve mudar em direção ao registro completo conforme o corpus envelhece. Verifique a cobertura de campos contra suas próprias colunas necessárias antes de decidir o tamanho do pedido, não depois.
O volume de avaliações precisa da mesma verificação antes de pedir. Na cópia que coletamos, 753 de 1.000 anúncios não tinham avaliações, então a mediana é zero. Os 10% principais de anúncios têm 98% de todas as avaliações. A média de 52,5 por anúncio descreve o arquivo como um todo e nenhum anúncio que você vai abrir.
A assimetria de avaliações parece com o caso da moeda, mas é uma falha diferente com uma solução diferente. O caso da moeda acima é um erro de unidade, e a média está errada. O volume de avaliações é assimetria, e ali a média está certa para um total. Uma amostra aleatória de 1.000 anúncios deve retornar cerca de 52.500 avaliações, então use a média quando planejar um corpus em massa. Numa amostra do tamanho de um piloto, essa concentração torna a estimativa não confiável.
Cobertura é uma questão diferente. Com 753 das 1.000 em zero, apenas cerca de 25% das linhas que você compra têm alguma avaliação.
Se os dados que você precisa são históricos em vez de ao vivo, um dataset preparado pula o crawl. A página do dataset da Etsy lista a contagem atual de campos, total de registros, preço por registro e pedido mínimo, e esses 4 números são a aritmética do lado da compra.
O valor por registro nessa página é a taxa única, e cronogramas de atualização de semestral a diário vêm como assinaturas que a descontam. A atualidade dos dados também importa. A página descreve registros pré-coletados como tendo dias a meses de idade, enquanto a coleta sob demanda permite que você defina esse limite antes do checkout. Você seleciona o cronograma de atualização e o nível de volume na própria página do dataset.
Esses números mudam sem aviso, então leia-os da página antes de orçar, e trate as 2 páginas de preços da mesma forma. A página do dataset mostra uma amostra dos registros abaixo da linha de resumo, borrada até você solicitar acesso:
Um ponto de referência externo vale mais do que uma afirmação de fornecedor aqui. Esse mesmo artigo, Mecha-nudges for Machines, documenta de onde vieram seus dados no Apêndice B. Os autores afirmam que os dados brutos “foram obtidos da empresa Bright Data, que fornece datasets estruturados de anúncios de produtos da Etsy”. Seu extrato “foi coletado em 12 de novembro de 2025 e entregue no mesmo dia”. Eles descrevem 2 snapshots, de 5 milhões e 1,06 milhão de anúncios. Esse apêndice é verificável, e um estudo de caso de fornecedor não é.
A regra aqui é restrita. Construa o scraper quando precisar de alguns milhares de anúncios que você pode enumerar por URL, e você pode aceitar fixar 1 localidade. Compre a camada de coleta quando a lista de URLs for a parte difícil, ou quando o crawl precisar continuar rodando. Compre também quando o dataset alimenta trabalho de precificação, porque os campos de faixa de preço e preço riscado chegam já separados. A coluna de moeda ainda precisa de filtragem em qualquer um dos caminhos.
Na loja medida acima, construir custa 1.895 requisições e aproximadamente 13 horas com uma única thread para 1.842 anúncios. O lado da compra é um pedido mínimo de registros preparados. Esses 2 números não são diretamente comparáveis, porque o custo de construção é por loja e o custo de compra é um mínimo que você distribui entre lojas.
Considerações finais
A Etsy bloqueia buscas comuns enquanto publica JSON-LD do schema.org nessas mesmas páginas públicas, então a extração é um trabalho curto e o acesso é a maior parte do trabalho. O transporte não decide o acesso, porque um navegador com interface carregou uma página que 9 clientes HTTP ajustados não conseguiram carregar, e a Etsy recusou esse mesmo navegador na segunda requisição. Então o problema de engenharia é como continuar coletando, não como parecer um navegador. Qualquer que seja o caminho escolhido, as falhas de dados custam mais do que as falhas de acesso, porque uma coluna com moedas misturadas ou um anúncio morto a preço cheio é analisado sem problemas e você só percebe meses depois. Puxe 1 anúncio tanto por uma busca bruta quanto por um extrator estruturado, compare os campos, e deixe o resultado decidir entre construir ou comprar antes de escrever o crawler.
Perguntas frequentes
Existe uma API para a Etsy?
Sim. A Etsy Open API v3 listava 76 caminhos quando contamos, dos quais 31 operações GET precisam apenas de uma chave de aplicação. Ela retorna anúncios, lojas, avaliações e taxonomia. Para lojas que você não opera, ela omite vendas por anúncio, volume de busca por palavra-chave, taxa de conversão e histórico, que muitos projetos de dados precisam.
A API da Etsy é gratuita?
A API em si não tem preço publicado, mas o acesso depende de aprovação e de limites de taxa definidos por chave de aplicação. A Etsy decide quem recebe limites maiores, e pode anexar termos ou cobranças extras. O custo prático é o limite de taxa em vez de uma tarifa.
Por que meu scraper da Etsy está sendo bloqueado?
A Etsy usa DataDome, que retorna um 403 com uma página de bloqueio curta e um cabeçalho X-DataDome-riskscore avaliando sua requisição, onde 1.0 é o pior. A pontuação acompanha seu IP de chamada e assinatura de requisição. Em nossos testes, edições de cabeçalho baixaram a pontuação e a personificação de TLS do Chrome a elevou, e nenhuma das duas retornou uma página.
A Etsy permite web scraping?
Não sem permissão expressa da Etsy. Os termos são o documento mais rígido. O robots.txt proíbe busca por palavra-chave, histórico de vendas e favoritos em toda variante de localidade, e deixa páginas de anúncios e lojas abertas. A Etsy reescreve esse arquivo sem aviso, então leia a cópia ao vivo antes de construir.
Dá para fazer scraping na Etsy com Python?
Sim. Páginas de anúncios incorporam JSON-LD do schema.org, então a extração não precisa de seletores CSS. Escolha o bloco application/ld+json cujo @type é Product, depois achate o objeto offer. A busca é a metade difícil, e coletar em volume precisa de novos contextos de navegação e endereços rotativos.
Como consigo dados de vendas da Etsy?
Vendas são públicas apenas em nível de loja. O endpoint getShop retorna transaction_sold_count, um número vitalício para a loja inteira. Nada divide isso por anúncio para uma loja que você não opera, então os números por anúncio de uma ferramenta vêm de outro lugar. Trate-os como estimativas e verifique-os contra os totais da loja.
A Etsy tem um sitemap para rastreamento?
Nenhum em nossa última verificação. O arquivo robots.txt declara zero diretivas Sitemap:, e /sitemaps.xml retorna um 403 com corpo vazio. Sem sitemap, você precisa descobrir URLs a partir de páginas de loja, o endpoint findAllListingsActive da API, ou um dataset preparado. Nenhum dos 3 toca no caminho de busca proibido.
A Etsy bloqueia crawlers de IA como o GPTBot?
Não por nome quando verificamos. O arquivo robots.txt declara apenas 3 grupos de user-agent, nenhum deles um crawler de IA, e a Etsy não publica llms.txt nem ai.txt. O DataDome ainda assim recusou o GPTBot e o ClaudeBot, ambos pontuando um pior 0,9814 do que o 0,923 que um User-Agent do Chrome pontuou. Strings sem sentido pontuaram o mesmo.