O Google fechou sua Custom Search JSON API para novos clientes, com o acesso dos clientes existentes terminando em 1º de janeiro de 2027. Então, existe uma API de busca do Google na qual você ainda pode se inscrever? Não para resultados de toda a web, porque as opções públicas do Google buscam em sites escolhidos ou retornam respostas do Gemini baseadas na Busca do Google. A SERP API da Bright Data retorna resultados completos do Google como JSON.
A Custom Search JSON API retorna um 403 para novos projetos. Solicitações HTTP diretas ao google.com falharam silenciosamente nos testes, com status 200 e 0 resultados.
Este guia compara as opções do Google, explica por que as solicitações diretas falham e mostra como migrar.
TL;DR
- O Google não vende uma API de busca completa de autoatendimento para novos desenvolvedores. A data final da Custom Search JSON API é 1º de janeiro de 2027.
- O Grounding with Google Search retorna respostas do Gemini, não listas de resultados. Seus termos proíbem armazenar em cache ou analisar os resultados, ou indexar seus links.
- Solicitações HTTP diretas à Busca do Google não obtiveram resultados nos testes. Navegadores na mesma conexão então receberam um CAPTCHA.
- A SERP API da Bright Data retorna a página de resultados do Google como JSON. 5 mil solicitações por mês são gratuitas, depois $1,50 por 1.000 solicitações bem-sucedidas. Um adaptador plug-and-play converte chamadas
cse.list().
Qual substituto da Custom Search API combina com seu código
Descubra o que seu código precisa:
| Se o seu código precisa de | Use |
|---|---|
| Resultados de busca do Google para toda a web | SERP API da Bright Data |
| Busca limitada a uma lista fixa de sites | SERP API da Bright Data com filtros site:, ou Agent Search, do Google |
Manter os parâmetros existentes de cse.list() |
O adaptador na etapa 3 |
| Resultados do Google Imagens | O adaptador na etapa 3 com searchType="image" |
| Uma ferramenta de busca MCP (Model Context Protocol), LangChain ou n8n | Bright Data Web MCP, uma ferramenta LangChain, ou o nó n8n |
| Uma resposta do Gemini exibida ao usuário que perguntou | Grounding with Google Search |
| Uma correção para uma mensagem de erro | A tabela de solução de problemas |
O que aconteceu com a Google Custom Search JSON API
O Google anunciou o encerramento em 20 de janeiro de 2026. Sua visão geral da Custom Search JSON API marca a API como “fechada para novos clientes” e dá aos clientes existentes até 1º de janeiro de 2027.
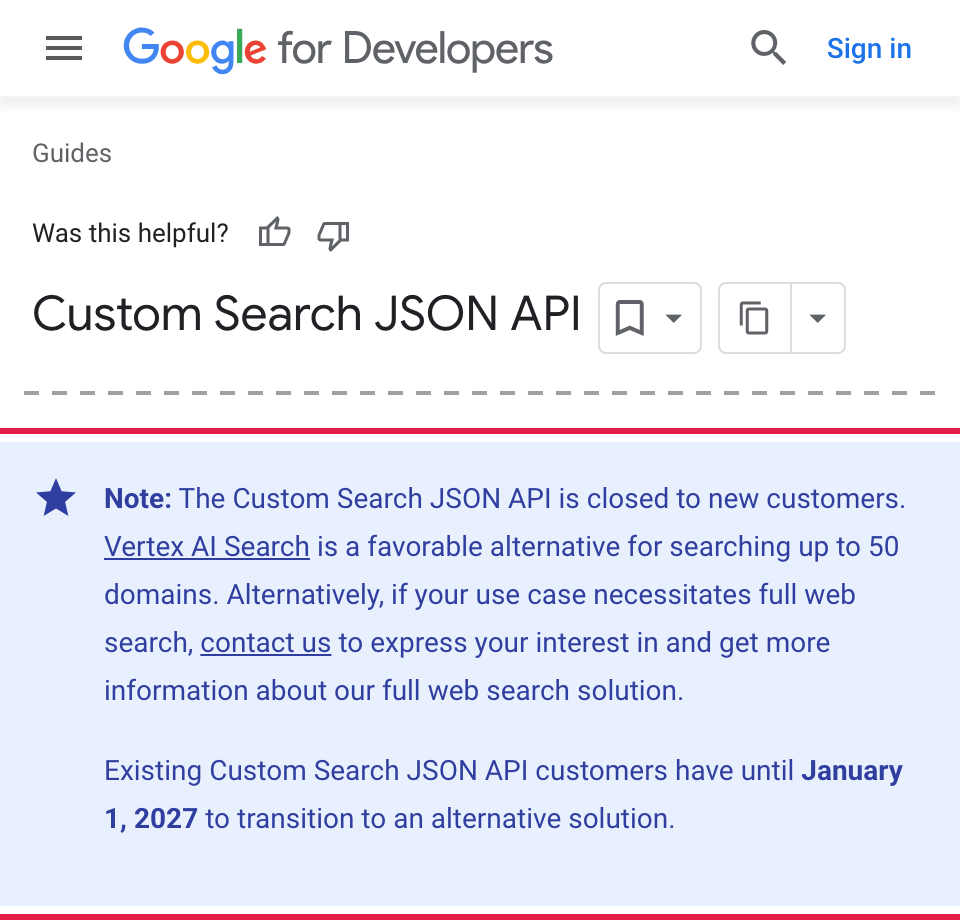
Novos projetos já recebem um 403 da Custom Search JSON API, mesmo antes do prazo de 2027. Esta é a resposta, reduzida aos seus campos principais.
{
  "error": {
    "code": 403,
    "message": "This project does not have the access to Custom Search JSON API.",
    "status": "PERMISSION_DENIED"
  }
}
No fórum de desenvolvedores do Google, um desenvolvedor relata esse 403 em um projeto existente após uma mudança de faturamento.
A tabela coloca os limites documentados do Google lado a lado com a SERP API da Bright Data:
| Custom Search JSON API | SERP API da Bright Data | |
|---|---|---|
| Uso gratuito | 100 consultas por dia, cerca de 3 mil por mês | 5 mil solicitações por mês, sem cartão de crédito |
| Uso pago | $5 por 1.000 consultas, até 10 mil por dia | $1,50 por 1.000 solicitações bem-sucedidas, concorrência ilimitada |
| Resultados por solicitação | Até 10 | Uma página completa de resultados do Google |
| Resultados por consulta | Até 100 | Pagine com start, ou obtenha as posições de 1 a 100 em uma chamada |
| Localização | gl aumenta resultados de um país |
Resultados como vistos por um usuário no país que você definir |
| O que a API retorna | Resultados de um Programmable Search Engine, que busca em um subconjunto do índice do Google | A página de resultados do Google, incluindo anúncios e People Also Ask quando o Google os exibe. Um parâmetro extra adiciona o AI Overview |
A migração é mais fácil do que parece, porque os resultados da Custom Search já diferiam dos resultados do google.com. A página de ajuda do Google diz que um mecanismo de busca completa pesquisa apenas “um subconjunto do corpus total de Busca na Web do Google” e exclui resultados em tempo real. Portanto, você não precisa reproduzir os resultados antigos exatamente. Verifique os novos resultados em relação ao google.com e use os resultados salvos da Custom Search para encontrar erros na sua migração.
As próprias alternativas do Google à Custom Search API
O Google direciona os usuários da Custom Search para o Agent Search e um formulário de interesse para busca completa. O Grounding with Google Search, um recurso da Gemini API, também aparece quando você procura por um substituto:
| Produto e escopo | O que retorna | Preço de tabela |
|---|---|---|
| Agent Search (também chamado Vertex AI Search), para até 50 domínios | Resultados e respostas desses sites | $4 por 1.000 consultas de busca em site |
| Grounding with Google Search (Gemini API), para a Busca do Google | Uma resposta do Gemini com links | $14 por 1.000 solicitações de busca |
| Solução de busca completa na web, para o índice completo do Google | Não documentado publicamente | Apenas formulário de interesse |
Se o seu mecanismo pesquisava uma lista fixa de sites, você tem 2 opções. A SERP API da Bright Data aceita a mesma lista como filtros site:, e o Agent Search suporta até 50 domínios.
O Grounding é o produto mais próximo da busca na web, mas seus termos limitam o que você pode construir. Os termos da Gemini API exigem que você mostre os resultados fundamentados ao usuário que perguntou. Eles proíbem você de “armazenar em cache, enquadrar, sindicalizar, revender, analisar, treinar com, ou de outra forma aprender com” esses resultados ou indexar seus links.
A Microsoft também aposentou suas Bing Search APIs em agosto de 2025. Nossos guias de alternativas à Bing Search API e as melhores SERP APIs comparam os outros provedores.
Nenhum dos produtos de autoatendimento do Google oferece a novos clientes resultados de busca completa na web. A SERP API da Bright Data oferece.
Por que solicitações diretas à Busca do Google falham
Com o fechamento da Custom Search, a alternativa óbvia é solicitar a página de resultados do Google diretamente. A Busca do Google exige JavaScript desde janeiro de 2025. Em testes a partir de uma conexão de banda larga residencial, 10 solicitações de clientes HTTP e depois vários navegadores reais não obtiveram resultados de busca:
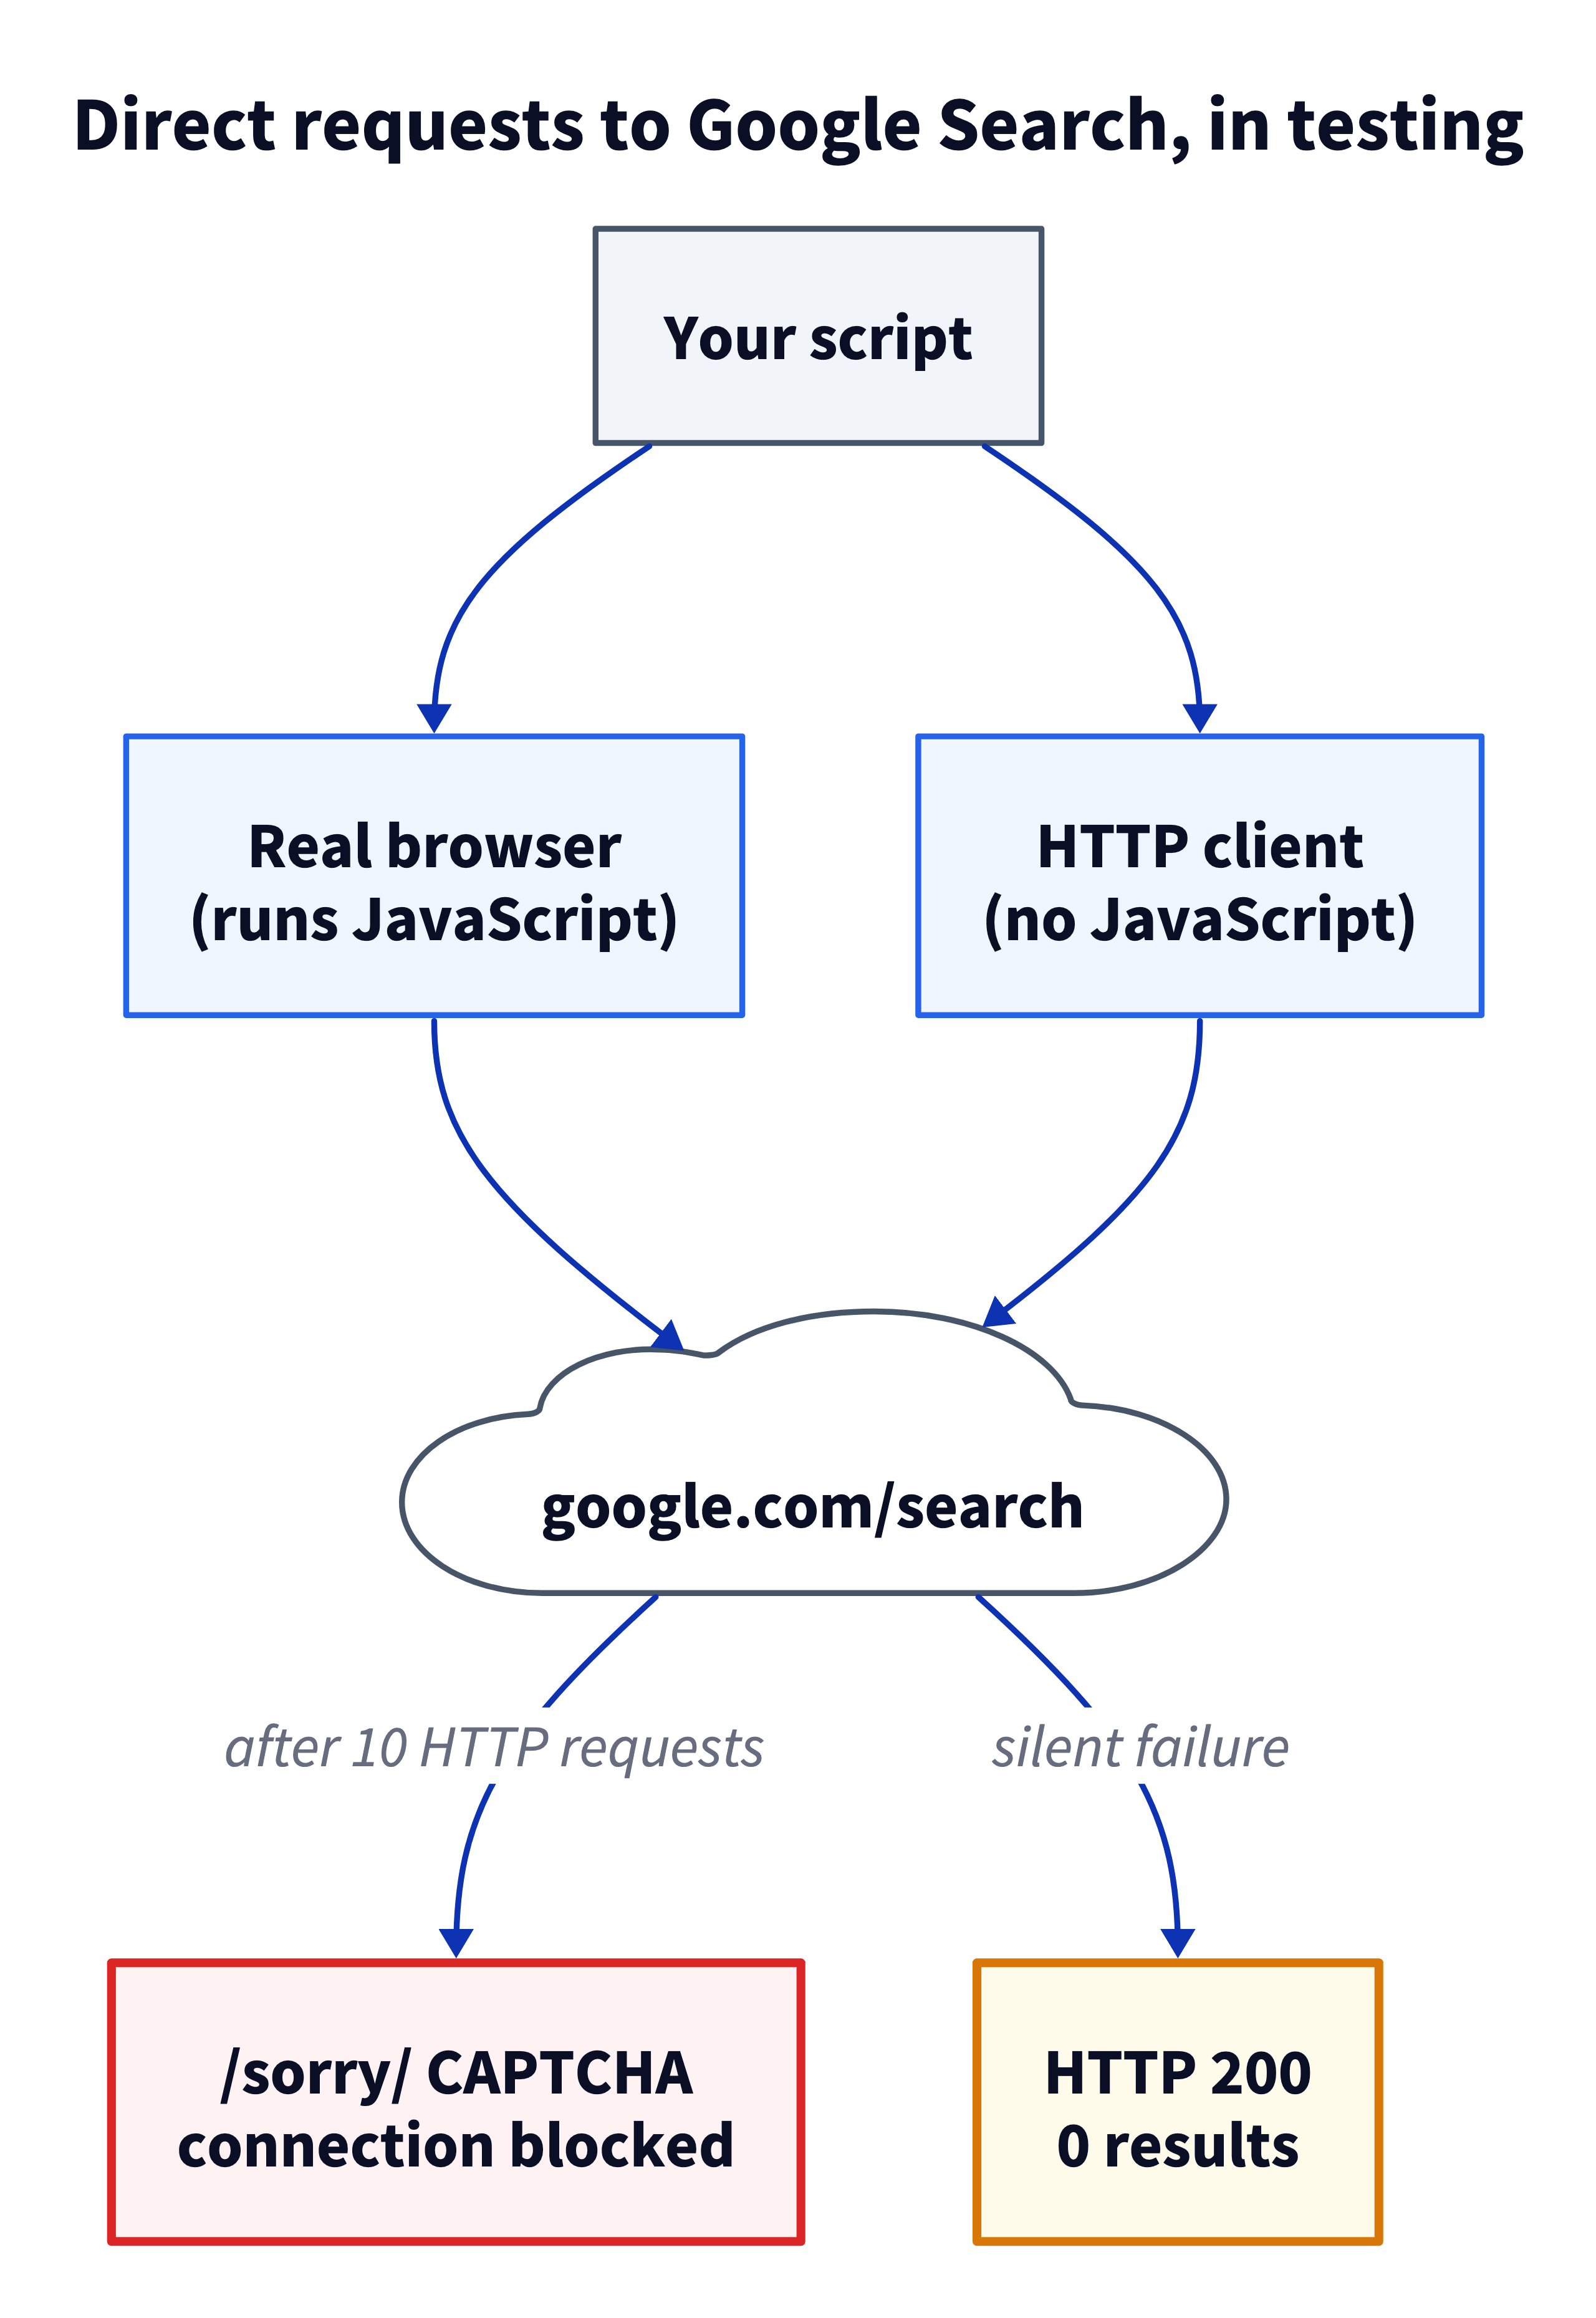
Os clientes HTTP falham da maneira mais difícil de detectar. As 10 solicitações vieram de 5 configurações comuns de cliente HTTP, incluindo curl e httpx do Python. Todas as 10 obtiveram status 200 e nenhum resultado, então um scraper que verifica apenas códigos de status registra um sucesso e não armazena nada. A página continha apenas um script que precisa ser executado em um motor JavaScript antes que qualquer resultado apareça.
Verifique cada resposta quanto a resultados, não apenas o código de status.
Todos os navegadores testados, incluindo Chromium e Chrome headless, executaram o JavaScript mas receberam a página de CAPTCHA /sorry/ do Google em sua primeira consulta. Eles foram executados após essas 10 solicitações HTTP, e o bloqueio se aplicou a toda a conexão por 40 minutos ou mais.
Em volume de produção, você teria que executar o JavaScript do Google para cada busca e manter parsers para markup em constante mudança. A SERP API da Bright Data cuida dos navegadores e parsers para você e retorna resultados já processados.
Como migrar código da Custom Search JSON API para a SERP API da Bright Data
Você envia uma URL normal de busca do Google, e a resposta é essa página como JSON. As etapas 1 a 3 são o núcleo da migração.
Etapa 1: Configurar e enviar a primeira solicitação
Você precisa de uma conta gratuita da Bright Data, uma chave de API e uma zona de SERP API. Uma zona é um conjunto nomeado de configurações que suas solicitações usam. Se sua equipe de segurança revisa novos fornecedores primeiro, envie à equipe o link do Bright Data Trust Center. Essa página lista relatórios SOC 2 e SOC 3, certificados ISO 27701 e documentação de conformidade com GDPR.
No painel de controle, uma zona é chamada de API. Abra Web Access, selecione Create API, escolha SERP API, e selecione Continue:
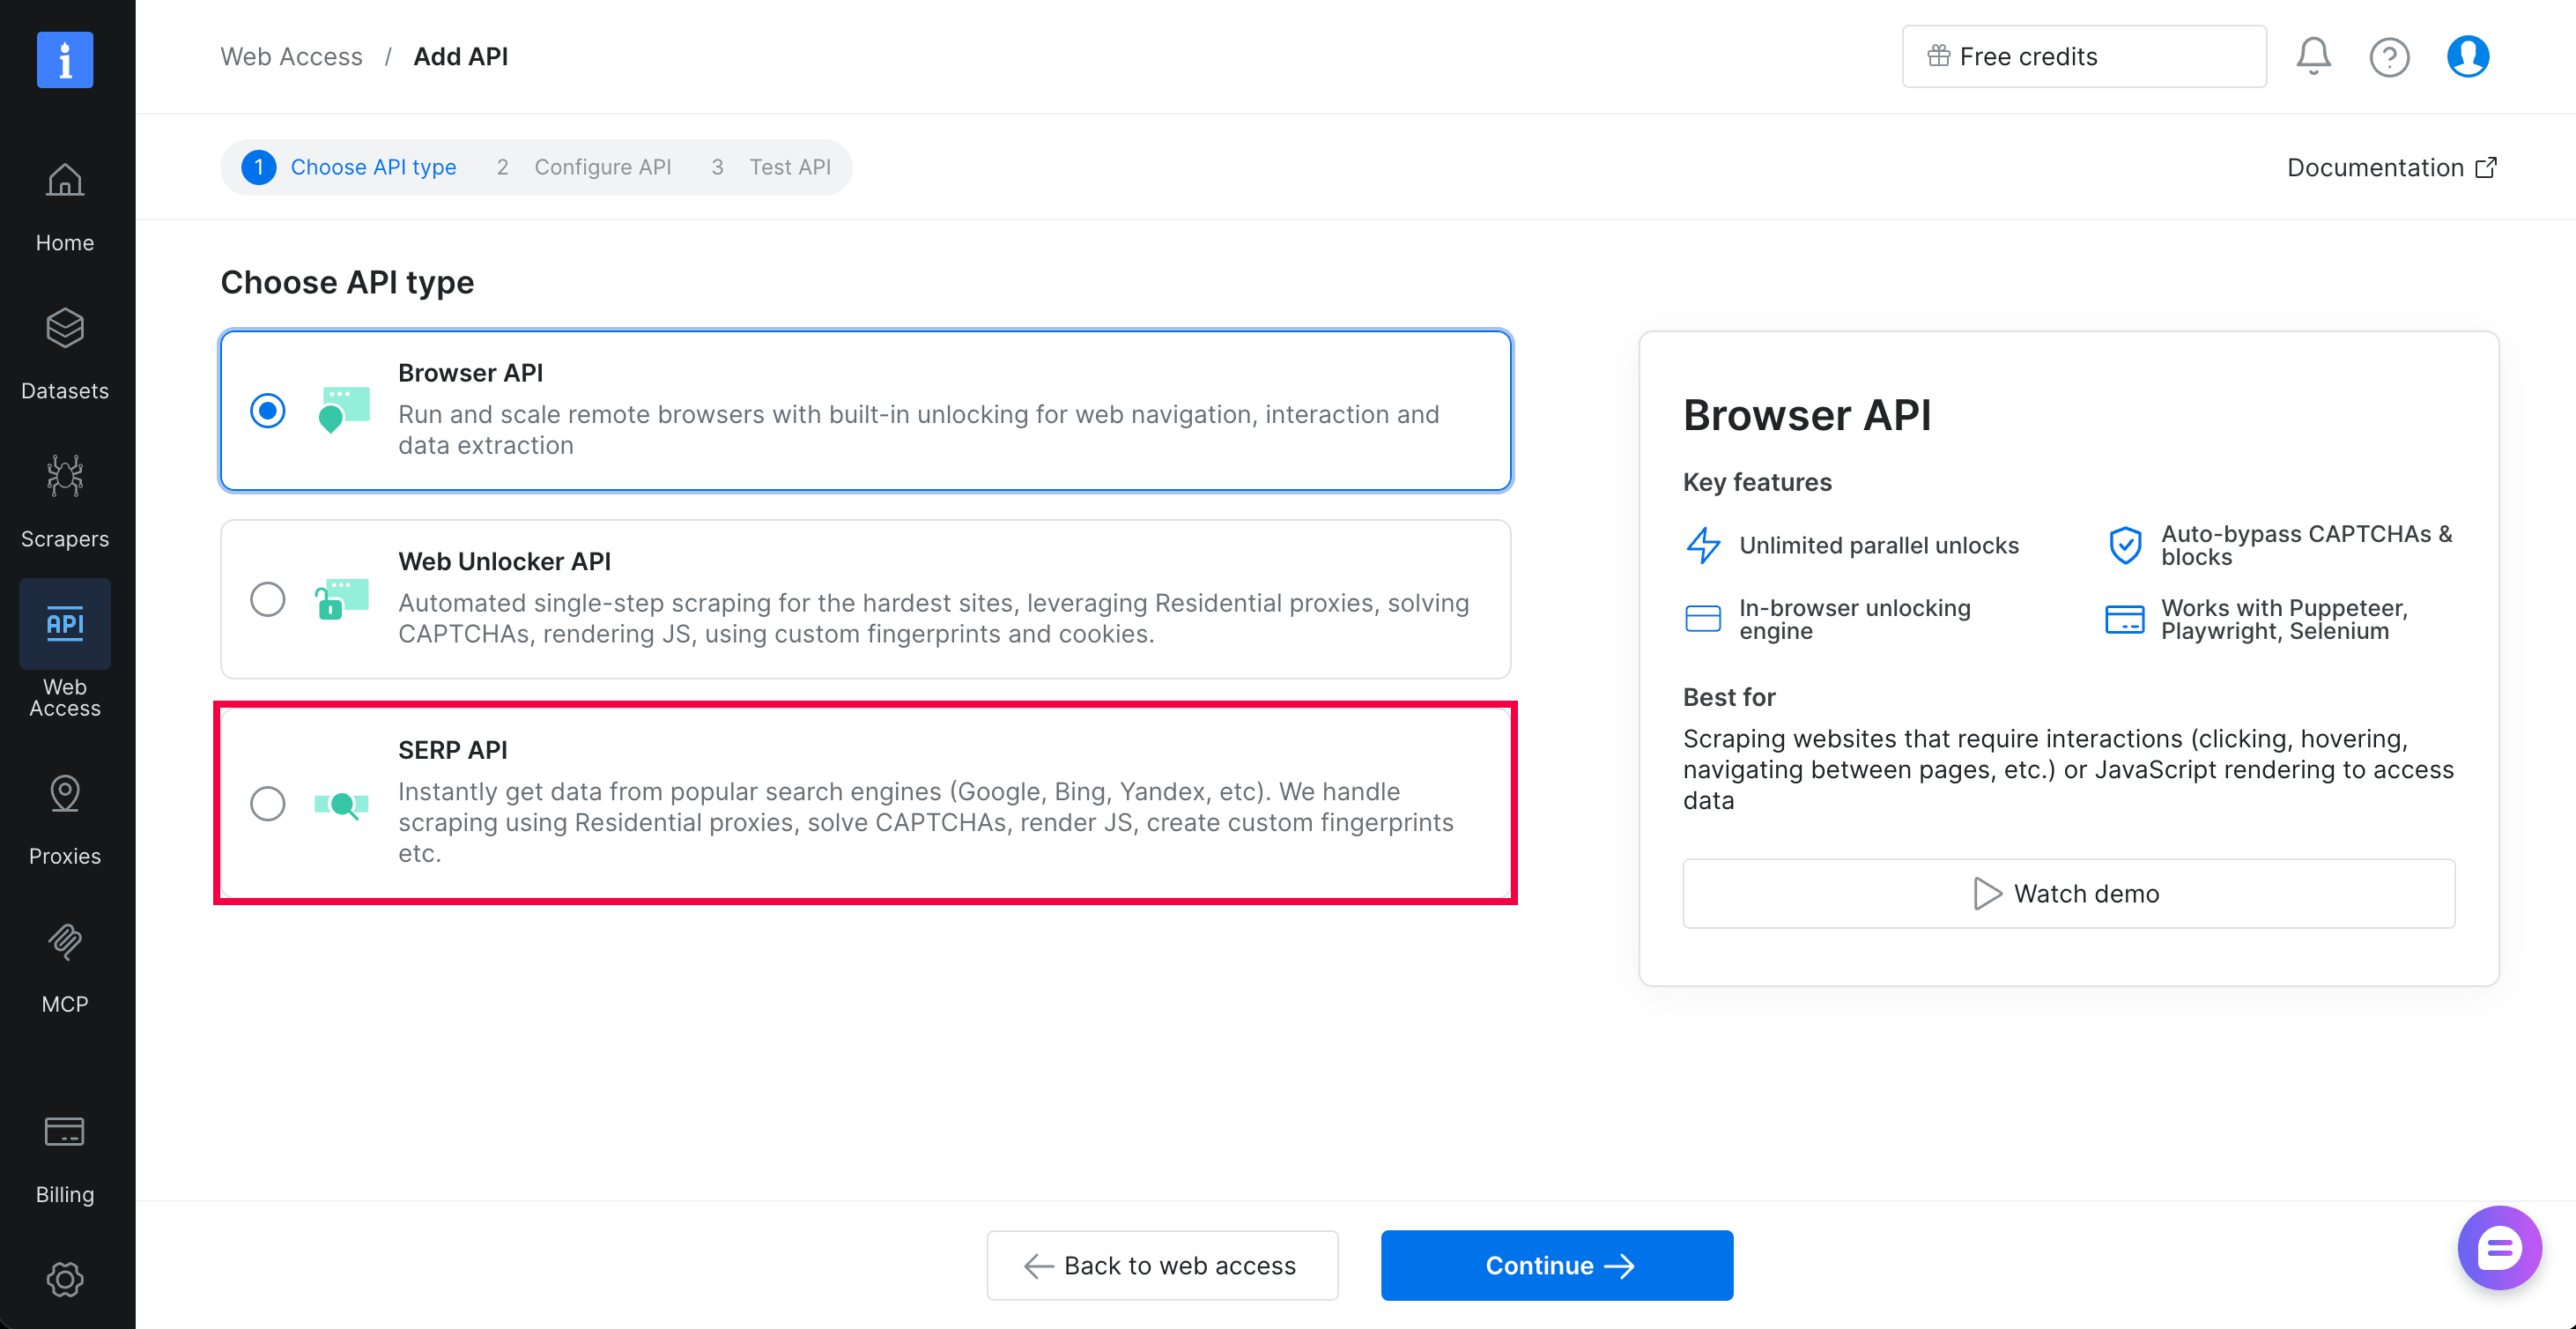
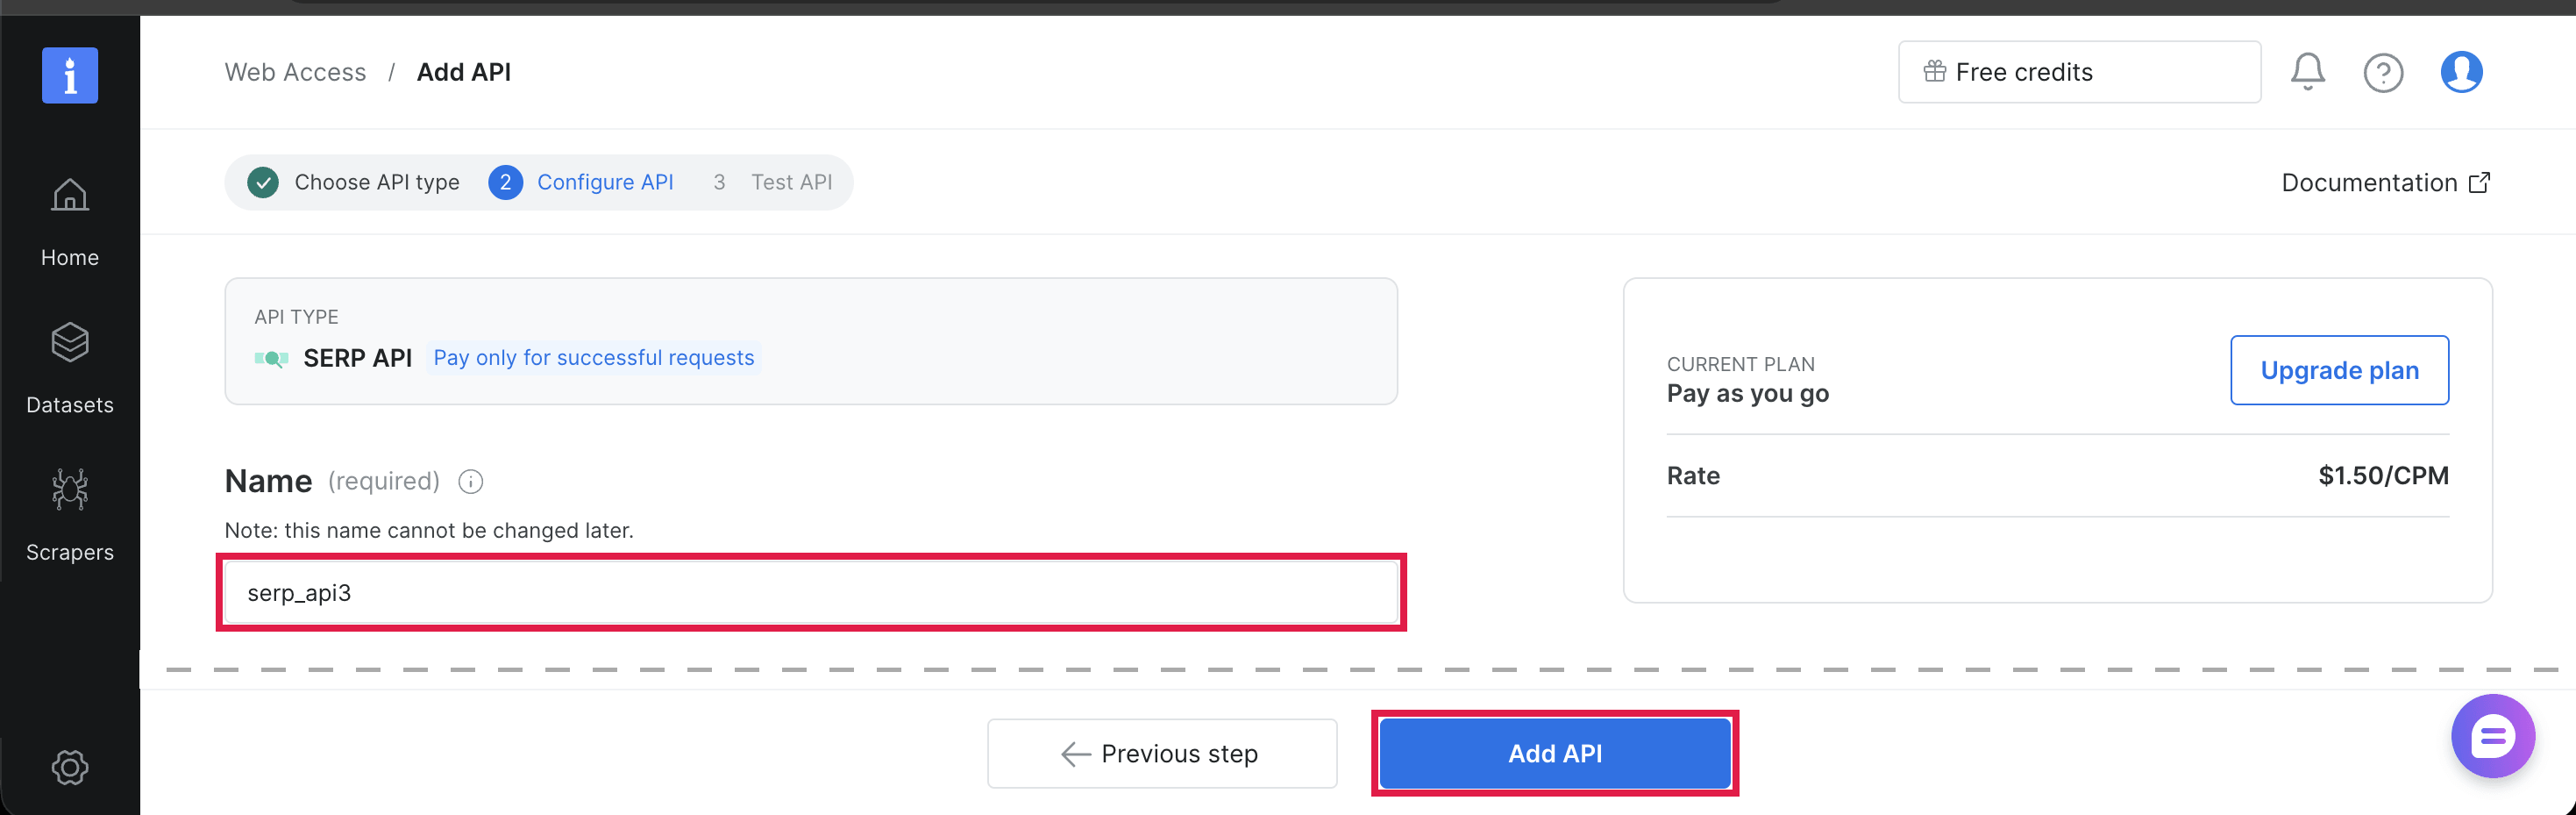
Dê um nome à API, certifique-se de que o formato de dados seja Raw HTML, e selecione Add API. O JSON vem de um parâmetro em cada solicitação, não dessa configuração. O nome da API que você escolheu é o nome da sua zona, que você define em BRIGHTDATA_SERP_ZONE abaixo:
A chave de API está na barra Quick start na parte inferior da página Home:
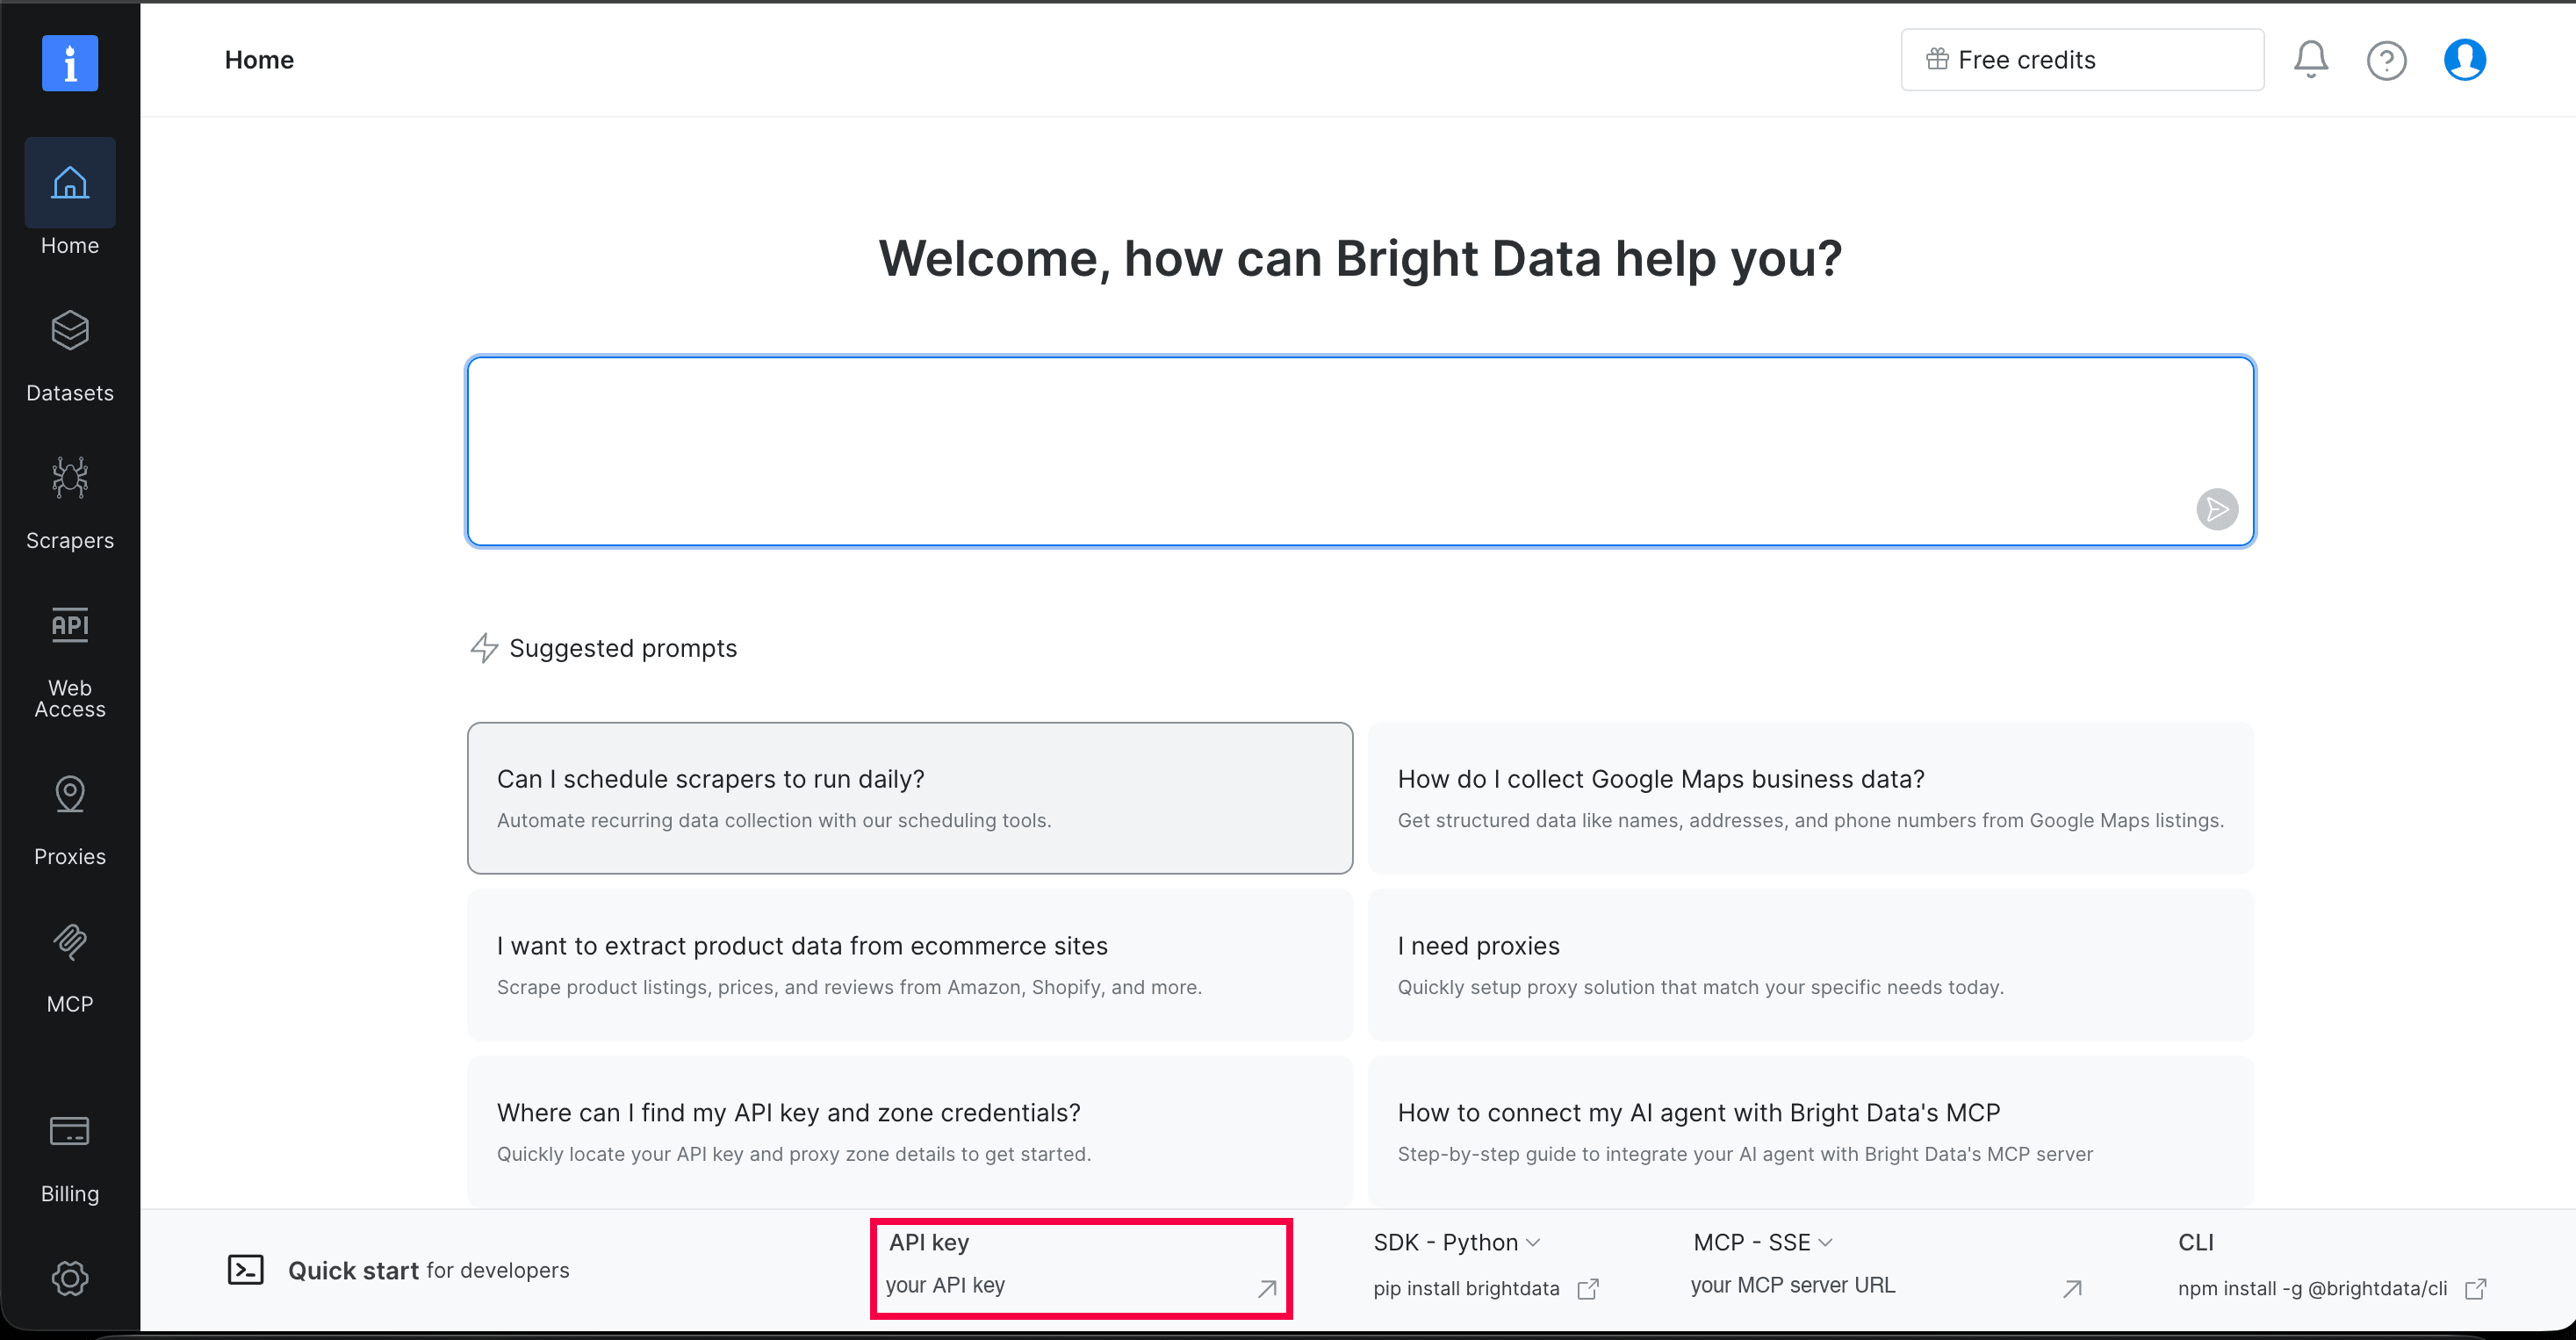
Crie um ambiente virtual, defina a chave e o nome da zona, e instale a única dependência Python. Substitua ambos os valores pela sua própria chave e nome de zona:
python3 -m venv .venv && source .venv/bin/activate
export BRIGHTDATA_API_KEY="your-api-key"
export BRIGHTDATA_SERP_ZONE="serp_api1"
python -m pip install "httpx>=0.27,<1"
No Windows PowerShell, use este bloco:
python -m venv .venv; .venv\Scripts\Activate.ps1
$env:BRIGHTDATA_API_KEY = "your-api-key"
$env:BRIGHTDATA_SERP_ZONE = "serp_api1"
python -m pip install "httpx>=0.27,<1"
Com o uv, pule o ambiente virtual e inicie cada script com uv run --with "httpx>=0.27,<1" python, seguido pelo nome do script.
Um único POST ao endpoint /request da Bright Data busca uma URL do Google através da sua zona e retorna uma página de resultados. Este comando curl envia essa solicitação e formata a resposta de forma legível:
curl https://api.brightdata.com/request \
  -H "Authorization: Bearer $BRIGHTDATA_API_KEY" \
  -H "Content-Type: application/json" \
  --data @- <<EOF | python -m json.tool
{
  "zone": "$BRIGHTDATA_SERP_ZONE",
  "url": "https://www.google.com/search?q=is+there+a+google+search+api&gl=us&hl=en&brd_json=1",
  "format": "raw"
}
EOF
O parâmetro brd_json=1 converte a página em JSON processado, e "format": "raw" retorna esse JSON inalterado. A resposta abaixo está resumida:
{
  "general": {
    "search_engine": "google",
    "query": "is there a google search api",
    "language": "en",
    "country_code": "US"
  },
  "organic": [
    {
      "link": "https://developers.google.com/custom-search/v1/overview",
      "title": "Custom Search JSON API | Google for Developers",
      "description": "The Custom Search JSON API lets you develop websites and applications to retrieve and display search results from Programmable Search Engine ...",
      "rank": 1
    }
  ],
  "pagination": {
    "current_page": 1,
    "next_page": 2,
    "next_page_start": 10
  }
}
A mesma resposta também continha 8 buscas relacionadas e 4 perguntas de People Also Ask. A resposta da Custom Search não tem campos para nenhum dos dois.
Etapa 2: Mapear parâmetros da Custom Search para parâmetros do Google
A referência de parâmetros de consulta do Google da Bright Data e sua lista de parâmetros e operadores de URL de busca do Google explicam os parâmetros do Google em detalhes. Os campos de resposta estão em items[] na Custom Search e em organic[] na resposta da SERP API:
| Custom Search JSON API | Google, através da SERP API |
|---|---|
q |
q |
num (máximo 10) |
Removido pelo Google. O adaptador solicita mais páginas |
start (conta a partir de 1) |
start (conta a partir de 0, em passos de 10) |
gl (aumenta resultados de um país) |
gl (executa a busca como um usuário nesse país) |
hl (idioma da interface) |
hl |
siteSearch=a.com |
site:a.com adicionado a q |
siteSearchFilter=e |
-site:a.com adicionado a q |
exactTerms=a b |
"a b" adicionado a q |
excludeTerms=a |
-"a" adicionado a q |
fileType=pdf |
filetype:pdf adicionado a q |
dateRestrict=d7 |
tbs=qdr:d7, e o mesmo para w, m, e y |
safe=active |
safe=active |
searchType=image |
udm=2 (Google Imagens) |
title, link |
title, link |
snippet |
description |
displayLink |
Nome do host de link |
queries.nextPage |
Calculado pelo adaptador |
No Google, 3 parâmetros funcionam de forma diferente:
O Google conta deslocamentos a partir de 0. A Custom Search trata start=11 como o topo da página 2, e o Google trata start=10 como a página 2. Envie start em passos de 10 e descarte os resultados antes da sua posição inicial no código, como faz o adaptador.
O Google removeu num. A documentação da SERP API diz que o Google descontinuou num em 11 de setembro de 2025. Cada página do Google contém cerca de 10 resultados, e o adaptador solicita quantas páginas num precisar. Para mais resultados por consulta, a Bright Data pode retornar os 100 principais resultados do Google, posições 1 a 100, em uma chamada.
No Google, gl define o país de busca. A consulta “cloud hosting pricing” retornou resultados principais do Reino Unido, Alemanha e Índia que não compartilhavam nenhuma URL com os resultados principais dos EUA. Defina gl em cada solicitação para o país de onde seus usuários pesquisam.
Etapa 3: Adicionar um adaptador plug-and-play para cse.list()
O adaptador envia chamadas cse.list() para a SERP API da Bright Data e funciona no Python 3.9 e posterior. Ele aceita os parâmetros da Custom Search na tabela e mantém os campos title, link, snippet, e displayLink em items. Ele ignora cx com um aviso, porque a busca do Google não tem ID de mecanismo, e adiciona configurações de attempts e timeout.
Em cada ponto de chamada, a mudança é assim:
# Antes, com o cliente da API do Google
res = service.cse().list(q=query, cx=CX, num=10).execute()

# Depois, com os mesmos campos principais de items, sem ID de mecanismo, e gl e hl definidos
from cse_to_serp import cse_list

res = cse_list(q=query, num=10, gl="us", hl="en")
Verifique mais 3 coisas em cada ponto de chamada:
- Se o seu mecanismo pesquisava uma lista fixa de sites, coloque-os na consulta como
(site:a.com OR site:b.com). Uma consulta restrita a 2 sites de documentação dessa forma retornou 10 resultados, todos desses 2 hosts. - Em um manipulador de solicitação web, passe
attempts=1e umtimeoutque se encaixe no orçamento de tempo do manipulador. - Onde você capturava
HttpError, capture(httpx.HTTPError, ValueError, RuntimeError)em vez disso.
Salve o adaptador como cse_to_serp.py, ou clone o repositório complementar no GitHub, que também contém os outros scripts abaixo e testes offline. Aqui está o arquivo completo:
"""Replace Google Custom Search JSON API calls with the Bright Data SERP API.

Same cse.list() parameters and core items fields.
"""

import math
import os
import time
import warnings
from urllib.parse import urlencode, urlparse

import httpx

API_URL = "https://api.brightdata.com/request"
API_KEY = os.environ.get("BRIGHTDATA_API_KEY")
if not API_KEY:
    raise RuntimeError("Set the BRIGHTDATA_API_KEY environment variable "
                       "to your Bright Data API key (step 1).")
ZONE = os.environ.get("BRIGHTDATA_SERP_ZONE", "serp_api1")
RETRY_STATUSES = {429, 500, 502, 503, 504}


def fetch_serp(params: dict, attempts: int = 4, timeout: float = 60) -> dict:
    """Fetch one Google results page as parsed JSON."""
    url = "https://www.google.com/search?" + urlencode(params)
    body = {"zone": ZONE, "url": url, "format": "raw"}
    headers = {"Authorization": f"Bearer {API_KEY}"}
    for attempt in range(attempts):
        try:
            resp = httpx.post(API_URL, json=body, headers=headers,
                              timeout=timeout)
        except httpx.TransportError:  # timeout or dropped connection
            if attempt == attempts - 1:
                raise
            time.sleep(16 + attempt * 10)
            continue
        error = (resp.headers.get("x-brd-error")  # API-level errors
                 or resp.headers.get("x-brd-err-msg"))  # proxy-level errors
        if resp.status_code == 200 and not error:
            page = resp.json()
            if "general" not in page:  # not a parsed results page
                raise ValueError("Unexpected response: " + resp.text[:200])
            return page
        if not error and resp.status_code not in RETRY_STATUSES:
            break  # wrong key, zone, or URL, so retrying will not help
        if attempt < attempts - 1:
            # Back off before resending the same query.
            time.sleep(16 + attempt * 10)
    resp.raise_for_status()
    code = (resp.headers.get("x-brd-error-code")  # maps to the error catalog
            or resp.headers.get("x-brd-err-code"))
    raise RuntimeError(f"SERP API error {code}: {error or resp.status_code}")


def cse_list(q, num=10, start=1, gl=None, hl=None, siteSearch=None,
             siteSearchFilter="i", exactTerms=None, excludeTerms=None,
             fileType=None, dateRestrict=None, safe="off", searchType=None,
             attempts=4, timeout=60, **extra):
    """Accept cse.list() parameters, return a dict in cse.list() format."""
    if extra.pop("cx", None):  # no engine ID, so every call searches Google
        warnings.warn("cx is ignored. Add (site:a.com OR site:b.com) to q "
                      "if your engine searched a fixed list of sites")
    if extra:  # fail loudly instead of ignoring a filter
        raise TypeError(f"No mapping for: {sorted(extra)}")
    if exactTerms:  # Custom Search filters become Google search operators
        q = f'{q} "{exactTerms}"'
    if excludeTerms:
        q = f'{q} -"{excludeTerms}"'
    if fileType:
        q = f"{q} filetype:{fileType}"
    if siteSearch:
        exclude = "-" if siteSearchFilter == "e" else ""
        q = f"{q} {exclude}site:{siteSearch}"
    params = {"q": q, "brd_json": 1}  # brd_json=1 returns parsed JSON
    if gl:
        params["gl"] = gl
    if hl:
        params["hl"] = hl
    if safe == "active":
        params["safe"] = "active"
    if dateRestrict:  # "d7" -> qdr:d7 (past 7 days), "m6" -> qdr:m6
        params["tbs"] = "qdr:" + dateRestrict
    if searchType == "image":
        return image_list(params, num, start, attempts, timeout)
    if searchType:
        raise ValueError(f"No mapping for: searchType={searchType}")

    # Custom Search counts from 1 (start=11 is page 2), Google from 0
    # (start=10 is page 2). Track each result's Google position.
    first = start - 1
    offset = first // 10 * 10  # the Google page that contains `start`
    items, next_start = [], None
    # Fetch the pages for positions first to first + num - 1, 1 request each
    for _ in range(math.ceil((num + first - offset) / 10)):
        params["start"] = offset
        page = fetch_serp(params, attempts, timeout)
        for i, result in enumerate(page.get("organic", [])):
            position = offset + i
            if position < first or not result.get("link"):
                continue
            if len(items) == num:
                next_start = position + 1  # convert to 1-based
                break
            items.append({
                "title": result.get("title", ""),
                "link": result["link"],
                "snippet": result.get("description", ""),
                "displayLink": urlparse(result["link"]).netloc,
            })
        if next_start:
            break
        offset = (page.get("pagination") or {}).get("next_page_start")
        if not offset:  # Google has no further pages for this query
            break
    else:
        next_start = offset + 1  # continue at the next Google page

    response = {"items": items, "queries": {}}
    if next_start:
        response["queries"]["nextPage"] = [{"startIndex": next_start}]
    return response


def image_list(params, num, start, attempts, timeout):
    """Google Images returns the whole image grid in one request."""
    params["udm"] = 2
    page = fetch_serp(params, attempts, timeout)
    images = [i for i in page.get("images") or [] if i.get("original_image")]
    items = [{
        "title": image.get("image_alt", ""),
        "link": image["original_image"],
        "snippet": image.get("image_alt", ""),
        "displayLink": urlparse(image["original_image"]).netloc,
    } for image in images[start - 1:start - 1 + num]]
    response = {"items": items, "queries": {}}
    if start - 1 + num < len(images):
        response["queries"]["nextPage"] = [{"startIndex": start + num}]
    return response


if __name__ == "__main__":
    res = cse_list("httpx timeout configuration", num=10,
                   gl="us", hl="en")
    for i, item in enumerate(res["items"], start=1):
        print(i, item["displayLink"], "|", item["title"][:60])
Executar python cse_to_serp.py imprimiu estes como seus primeiros 5 resultados. Os resultados vêm da página ao vivo do Google, então os seus podem diferir.
1 www.python-httpx.org | Timeouts
2 github.com | Proposal: Add a Global Timeout Setting in httpx #3356
3 www.python-httpx.org | QuickStart
4 stackoverflow.com | python - Httpx requests timing out when it shouldn't
5 oneuptime.com | How to Use httpx for Async HTTP Requests
Com num=10, cada chamada nextPage busca uma única página do Google, então custa 1 solicitação.
Com searchType="image", 1 solicitação para “ergonomic office chair” retornou 100 imagens, enquanto a Custom Search retornava no máximo 10 por solicitação. Cada chamada do adaptador busca a grade completa de imagens e retorna num imagens dela.
Substitua a ferramenta de busca em agentes MCP, LangChain e n8n
Agentes que se conectam a ferramentas via MCP não precisam de adaptador. O servidor Bright Data Web MCP expõe a busca do Google como sua ferramenta search_engine, e o servidor hospedado é uma única URL com um nível gratuito. No Claude Code, você o adiciona com um comando:
claude mcp add --transport http brightdata https://mcp.brightdata.com/mcpClientes MCP que suportam OAuth, como Claude Code e Cursor, fazem login pelo seu navegador, sem chave de API em um arquivo de configuração. Para jobs de CI e scripts, use https://mcp.brightdata.com/mcp?token=YOUR_API_KEY em vez disso. Adicione &tools=search_engine,scrape_as_markdown a essa URL para dar ao agente a busca mais uma ferramenta que lê cada página de resultado como Markdown.
Agentes de codificação também podem usar o CLI da Bright Data. Instale-o com npm install -g @brightdata/cli, depois execute brightdata login para fazer login pelo seu navegador. O agente recebe um comando brightdata search.
Para código que já chama o LangChain, o método GoogleSearchAPIWrapper.results() retorna dicionários com title, link, e snippet. Os itens do adaptador têm as mesmas chaves. Instale o pacote core do LangChain, que precisa do Python 3.10 ou posterior, com python -m pip install "langchain-core>=1.0,<2". Salve este arquivo como langchain_tool.py ao lado do adaptador cse_to_serp.py, e passe google_search na lista de ferramentas do seu agente.
"""LangChain tool that replaces GoogleSearchAPIWrapper.results()."""

from langchain_core.tools import ToolException, tool

from cse_to_serp import cse_list


@tool
def google_search(query: str) -> list[dict]:
    """Search Google and return the top results with title, link, snippet."""
    try:  # 2 attempts and a 20 s timeout limit each search
        return cse_list(q=query, num=10, gl="us", hl="en",
                        attempts=2, timeout=20)["items"]
    except Exception as exc:
        raise ToolException(f"Google search failed: {exc}") from exc


google_search.handle_tool_error = True  # the agent gets the error as text
Para um agente completo construído dessa forma, veja Usando LangChain e Bright Data para Busca na Web.
Fluxos de trabalho no-code que chamam a Custom Search recebem o mesmo 403, e o fórum da comunidade n8n tem um tópico sobre exatamente esse erro. O nó n8n oficial da Bright Data se instala como o nó da comunidade @brightdata/n8n-nodes-brightdata. Ele tem uma operação Web Search que envia a consulta ao Google através da zona que você selecionar, como sua zona de SERP API. Substitua a solicitação de Custom Search do fluxo de trabalho por essa operação.
Execute buscas em volume de produção
Jobs em lote, e agentes que enviam muitas buscas em uma única tarefa, precisam executar várias consultas ao mesmo tempo. O módulo serp_batch.py do repositório complementar executa uma versão assíncrona do loop de solicitação e repetição do adaptador em paralelo. Separadamente, a própria SERP API oferece um modo assíncrono para lotes de 1.000 consultas ou mais.
O bloco principal do arquivo envia as mesmas 10 consultas duas vezes, e a segunda execução é atendida pelo seu cache em memória.
{'queries': 20, 'cache_hits': 10, 'empty': 0, 'failed': 0}Sua função search_many() tem 3 configurações e um conjunto de contadores.
concurrencydefine quantas solicitações rodam ao mesmo tempo. A SERP API não tem limite de concorrência, então defina para a carga que seu próprio sistema aguenta.deadlinelimita o tempo total para uma consulta, então mantenha curto para uma ferramenta de agente e mais longo para um job em lote.ttldefine por quanto tempo uma página em cache permanece válida.- Contadores mostram acertos de cache, resultados vazios e falhas, então um filtro
site:ou valorglerrado aparece cedo como resultados vazios.
Uma chamada retorna um dicionário que mapeia cada consulta à sua página processada, ou a None se a consulta falhou.
import asyncio

from serp_batch import search_many

pages = asyncio.run(search_many(["redis cache ttl", "nginx rate limiting"],
                                concurrency=20, gl="us", hl="en"))
Obtenha o AI Overview e as perguntas de People Also Ask
Agentes, pipelines RAG e equipes de SEO podem precisar de mais do que uma lista de 10 links. A página do Google para “what is retrieval augmented generation” mostra um AI Overview e perguntas de People Also Ask, que a Custom Search nunca retornou.
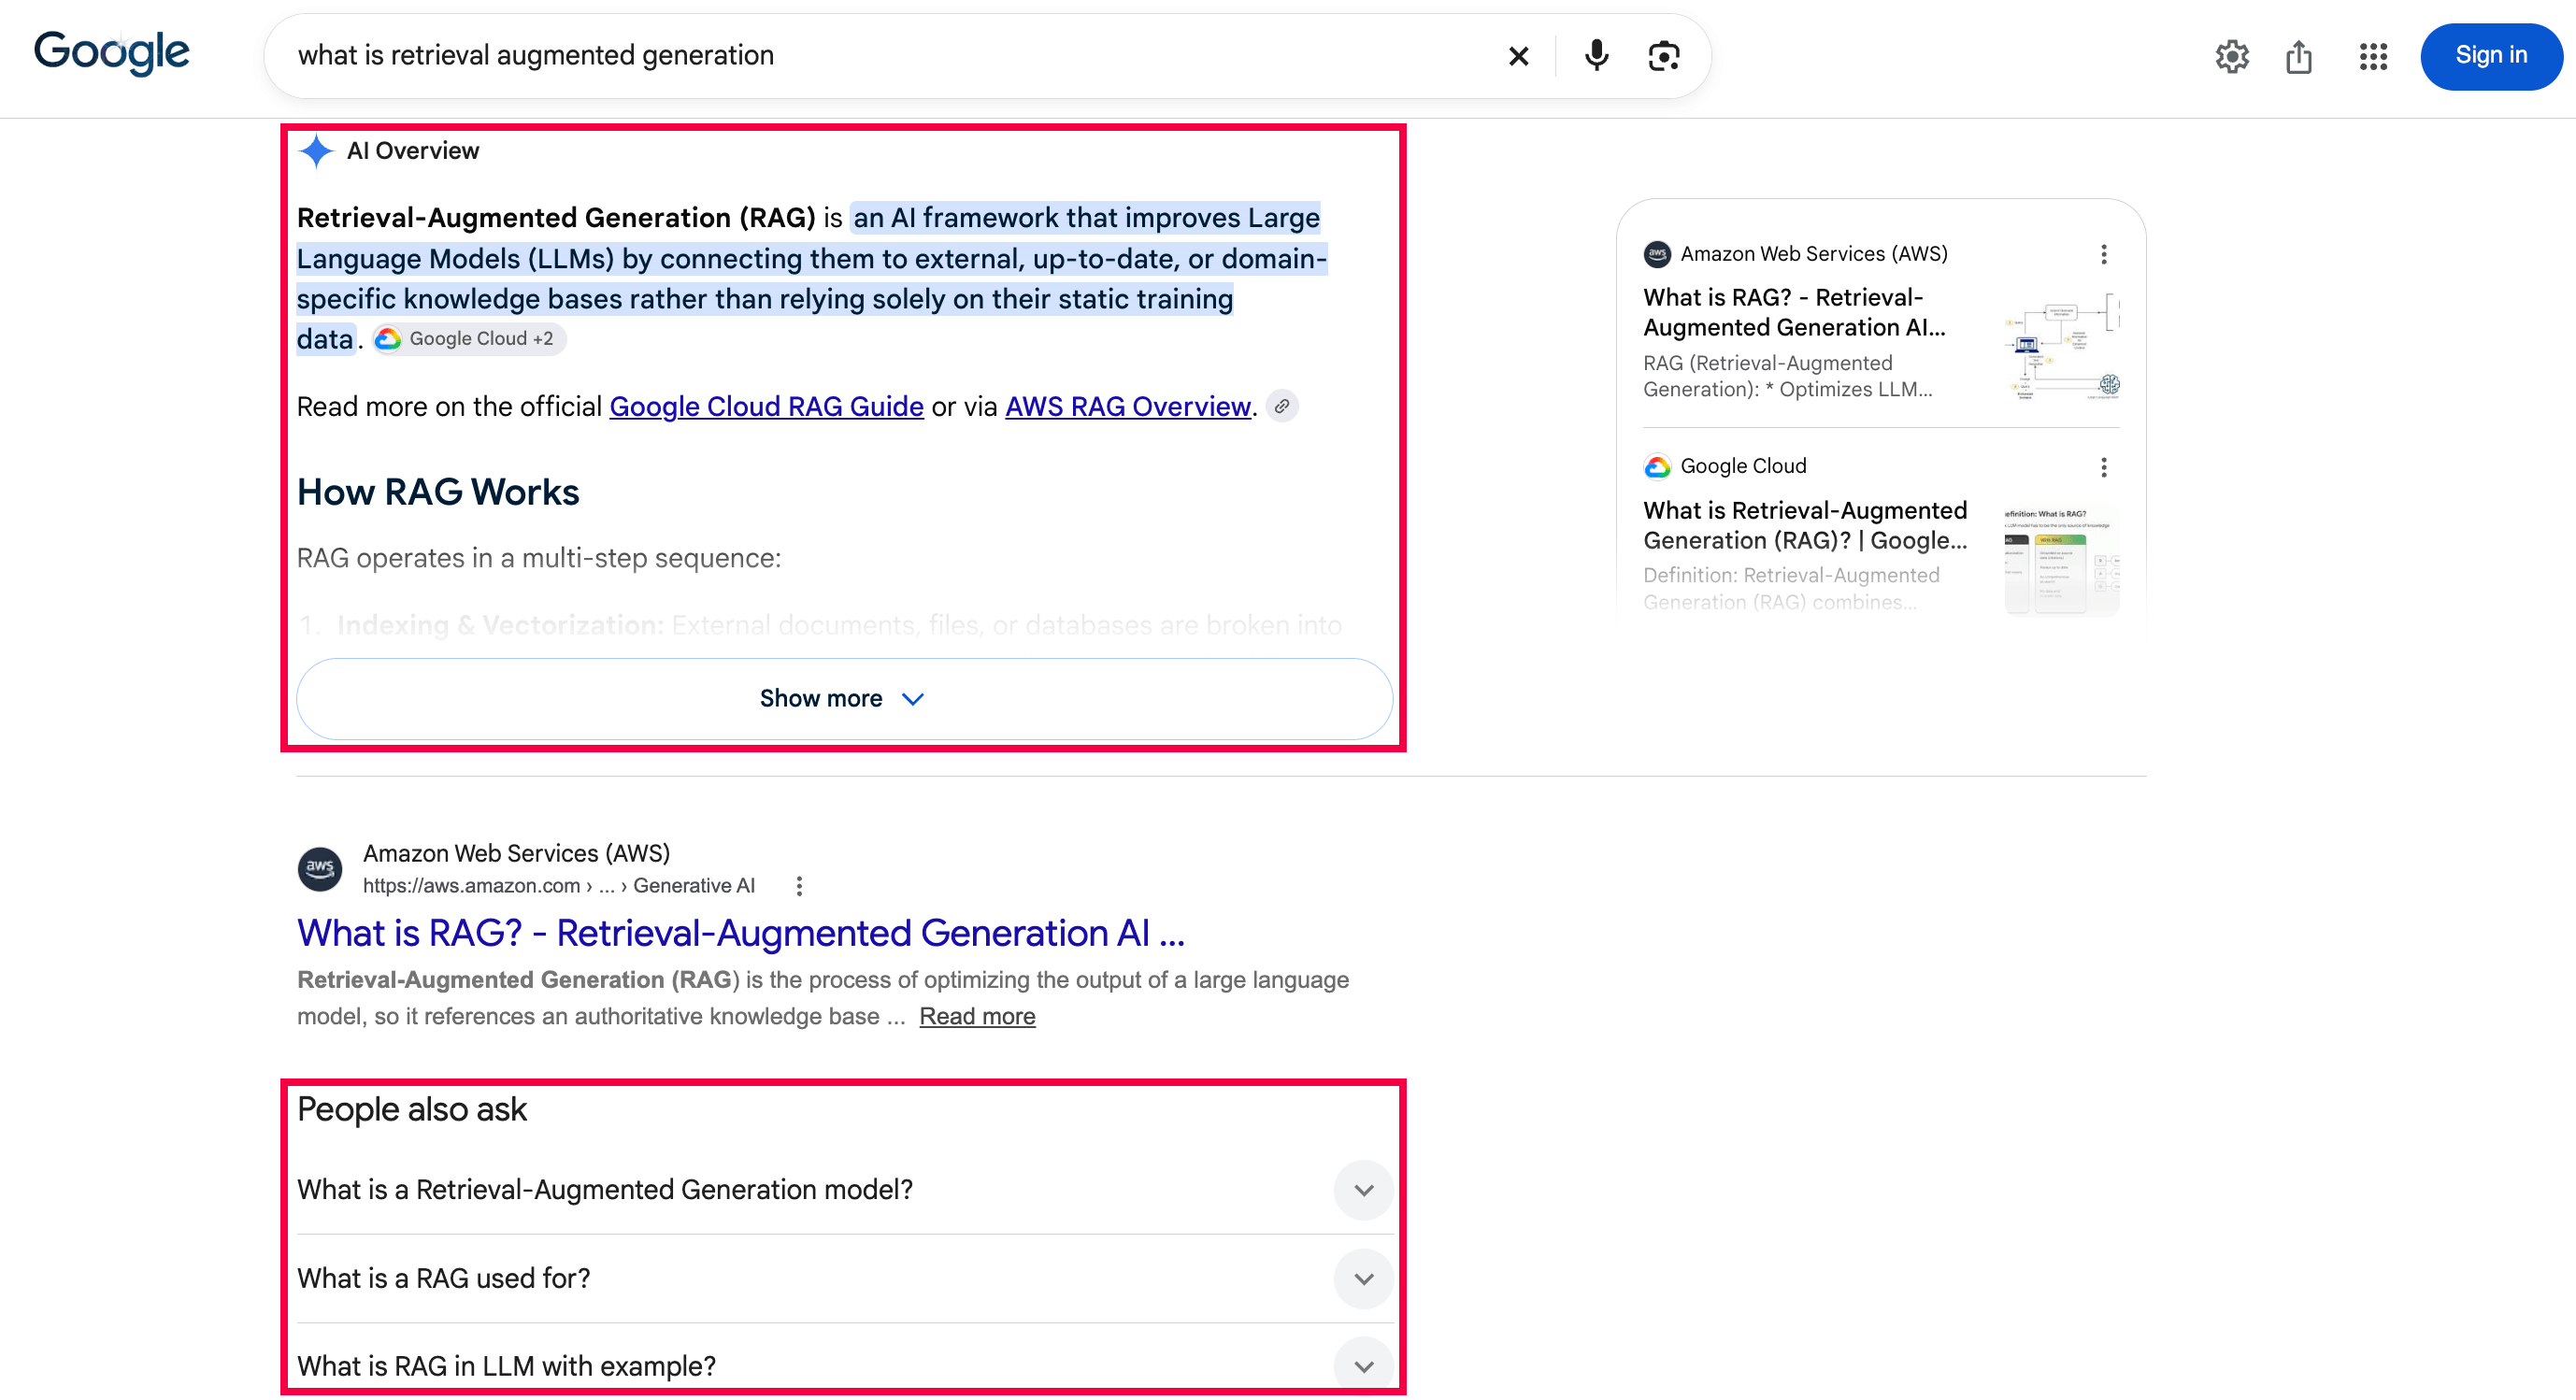
Um parâmetro extra solicita o AI Overview, e a mesma resposta contém quaisquer perguntas de People Also Ask. Salve este script ao lado do adaptador cse_to_serp.py da etapa 3.
"""Read the AI Overview and People Also Ask questions from one Google query."""

from cse_to_serp import fetch_serp

page = fetch_serp({
    "q": "what is retrieval augmented generation",
    "gl": "us",
    "hl": "en",
    "brd_json": 1,
    "brd_ai_overview": 2,  # requests the AI Overview
})

overview = page.get("ai_overview") or {}
print("AI Overview text blocks:", len(overview.get("texts", [])))
print("AI Overview sources:", len(overview.get("references", [])))
questions = dict.fromkeys(  # keeps each question once, in order
    item["question"] for item in page.get("people_also_ask", [])
    if item.get("question")
)
for question in list(questions)[:2]:
    print("People also ask:", question)
O script imprimiu esta saída. A página do Google está ao vivo, então suas perguntas podem diferir da captura de tela.
AI Overview text blocks: 3
AI Overview sources: 8
People also ask: Does ChatGPT use Retrieval-Augmented Generation?
People also ask: What is RAG in LLM with example?
Cada entrada de references contém o href e o title da página citada, para que equipes de SEO possam rastrear quais sites o AI Overview cita. A página da Bright Data sobre a Google AI Overview API explica o parâmetro em detalhes. Para o AI Mode do Google, a Google Scraper API retorna resultados de AI Mode Search como JSON.
Um pipeline RAG que lê as páginas de resultado pode buscá-las através do mesmo endpoint /request. Use uma zona Web Unlocker e a mesma chave de API.
Checklist de migração antes de 1º de janeiro de 2027
Execute estas etapas enquanto sua chave da Custom Search ainda funciona, porque o item 2 precisa dela.
- Encontre todos os pontos de chamada. Pesquise seu código por
customsearch/v1,cse().list, e wrappers comoGoogleSearchAPIWrapper. Em uma base de código grande, um agente de codificação pode executar essa busca e fazer a mudança da etapa 3 em cada ponto de chamada. - Salve os resultados da Custom Search para uma amostra de consultas reais de produção, para manter uma referência depois que a chave parar de funcionar. Se a chave já parou de funcionar, salve resultados do google.com para os mesmos
glehlem vez disso. - Comece no nível gratuito, depois reserve orçamento de 1 solicitação de SERP API por página de resultados.
- Deixe o adaptador converter valores de
startbaseados em 1 para os valores baseados em 0 do Google, ou converta-os você mesmo e solicite páginas inteiras. - Defina
glehlem cada solicitação. - Compare resultados antigos e novos como conjuntos de URLs, não por posição exata. Para agentes, também reexecute suas avaliações de tarefa e pontue as respostas finais. Espere algumas diferenças, porque os novos resultados vêm da página de resultados completa do Google, não do subconjunto do índice da Custom Search.
- Alterne atrás de um feature flag, execute os dois caminhos em paralelo por alguns dias, depois exclua a chave do Google.
Para o item 6, o auxiliar compare_baseline.py pontua cada consulta de 0 a 1. A pontuação é a proporção das URLs top 10 salvas que ainda aparecem no novo top 10.
Primeiro, execute cada consulta duas vezes através da SERP API e pontue as 2 execuções uma contra a outra. A classificação do Google pode mudar entre chamadas, então uma pontuação logo abaixo de 1,0 pode ser normal. Em testes, 2 execuções de uma consulta com o mesmo gl pontuaram 1,0, e uma execução nos EUA contra uma no Reino Unido pontuou 0,0. Depois pontue todas as consultas salvas, revise as pontuações mais baixas manualmente, e verifique os filtros gl e site: para qualquer pontuação próxima de 0.
Solucione erros de migração
Estes são problemas de configuração da primeira execução ou comportamento do Google.
| Sintoma | Causa | Correção |
|---|---|---|
| O Google retorna 403 em chamadas da Custom Search | API fechada para novos clientes | Uma nova chave não ajudará. Migre para a SERP API da Bright Data |
RuntimeError: Set the BRIGHTDATA_API_KEY environment variable… |
Variável não definida neste terminal | Defina BRIGHTDATA_API_KEY como na etapa 1 |
| 401 “Invalid token” | Chave de API da Bright Data errada | Copie a chave da barra Quick start na Home |
400 zone "..." not found |
Nome de zona errado | Use o nome que você deu à API na etapa 1 |
UserWarning: cx is ignored… |
A busca do Google não tem ID de mecanismo | Remova cx. Se o mecanismo pesquisava uma lista fixa de sites, adicione (site:a.com OR site:b.com) a q |
TypeError: No mapping for: [...] |
Um parâmetro não presente na tabela da etapa 2 | Adicione o equivalente do Google a q ou aos params do adaptador, ou remova o parâmetro |
KeyError em pagemap ou searchInformation |
O adaptador retorna 4 campos principais | Remova o código que lê o campo, ou mapeie-o a partir da resposta da SERP API |
items tem menos de num resultados |
A página do Google continha menos resultados orgânicos | Siga queries.nextPage |
items está vazio |
Nenhuma correspondência, ou filtro site: ou valor gl errado |
Tente a consulta no google.com |
| Resultados diferem da Custom Search | A Custom Search pesquisava um subconjunto do índice do Google | Compare conjuntos de URLs. Execute cada consulta duas vezes primeiro para ver a variação normal |
Uma mensagem RuntimeError: SERP API error… inclui o valor de x-brd-error-code ou x-brd-err-code. Encontre o código no catálogo de erros da SERP API.
Considerações finais
O produto de busca completa na web do Google não é público, e a data final da Custom Search JSON API é 1º de janeiro de 2027. As opções públicas do Google pesquisam uma lista fixa de domínios ou retornam respostas do Gemini, e os termos do Gemini proíbem armazenar em cache ou analisar os resultados. Solicitações HTTP diretas não obtiveram resultados nos testes, então a SERP API da Bright Data é a substituta prática quando seu código precisa da página de resultados.
O adaptador na etapa 3 cuida do start baseado em 0 do Google e do num removido, então seu código principalmente precisa de gl em cada chamada. Execute suas consultas salvas através do nível gratuito da SERP API da Bright Data, sem cartão de crédito, e compare-as com sua referência da Custom Search ou com o google.com.
Perguntas Frequentes
A Google Custom Search API foi descontinuada?
Sim, em 2 etapas. O Google fechou a Custom Search JSON API para novos clientes em janeiro de 2026, com o acesso dos clientes existentes terminando em 1º de janeiro de 2027. O Google sugere o Agent Search para até 50 domínios. A SERP API da Bright Data retorna resultados completos do Google como JSON.
O Google tem uma API de busca?
Não uma API de busca completa na web que novos desenvolvedores possam contratar. O Google oferece o Agent Search para até 50 domínios e o Grounding with Google Search, que retorna respostas do Gemini com links. O produto de busca completa na web do Google não é público. Para resultados do Google como JSON, use a Google Search API da Bright Data, parte de sua SERP API.
A API de busca do Google é gratuita?
Não para novos desenvolvedores que precisam de resultados completos da web. A Custom Search JSON API dá aos clientes existentes 100 consultas gratuitas por dia, depois cobra $5 por 1.000, até 1º de janeiro de 2027. A SERP API da Bright Data retorna resultados do Google como JSON, com 5 mil solicitações gratuitas por mês.
O que pode substituir a Google Custom Search API?
A SERP API da Bright Data substitui diretamente a Custom Search JSON API, porque retorna a página completa de resultados do Google como JSON. As próprias opções do Google retornam respostas de IA ou pesquisam uma lista fixa de domínios. Um adaptador Python plug-and-play de código aberto converte suas chamadas cse.list() em parâmetros do Google.
Como posso fazer scraping dos resultados de busca do Google?
Não apenas com um cliente HTTP. A Busca do Google exige JavaScript, então nos testes, clientes HTTP receberam uma página 200 sem resultados. Navegadores na mesma conexão então receberam uma página de CAPTCHA. A SERP API da Bright Data retorna a página de resultados do Google como JSON já processado, sem navegadores ou parsers para você manter.
Por que a Custom Search API retorna 403?
O Google fechou a Custom Search JSON API para novos clientes em janeiro de 2026, então uma nova chave ou projeto não corrigirá o erro 403. No fórum de desenvolvedores do Google, um desenvolvedor também relata um projeto existente perdendo o acesso após uma mudança de faturamento. Mova as chamadas para a SERP API da Bright Data, que retorna resultados do Google como JSON.