Neste tutorial, você verá:
- O cenário de análise de dados para explorar o mercado imobiliário de San Diego.
- Por que o SDK Python da Bright Data simplifica o acesso a conjuntos de dados estruturados e prontos para uso.
- Como filtrar, recuperar e exportar dados de vendas de imóveis do Zillow.
- Como limpar os dados, padronizar unidades e calcular métricas úteis.
- Como visualizar preços de venda, tendências geográficas, precisão do Zestimate e rendimentos estimados de aluguel.
Vamos começar!
Apresentando o Cenário
Imagine que você é um analista de dados encarregado de entender o mercado imobiliário de San Diego. Você quer responder questões-chave, como: Por quais preços as casas realmente são vendidas? Quais bairros têm os preços mais altos por metro quadrado? E quão precisas são as estimativas do Zillow na previsão dos preços finais de venda?
Para isso, você precisa de um conjunto de dados recente, confiável e rico sobre casas vendidas. Para tarefas semelhantes, a Bright Data oferece acesso a um conjunto de dados de informações de propriedades do Zillow contendo mais de 137 milhões de registros.
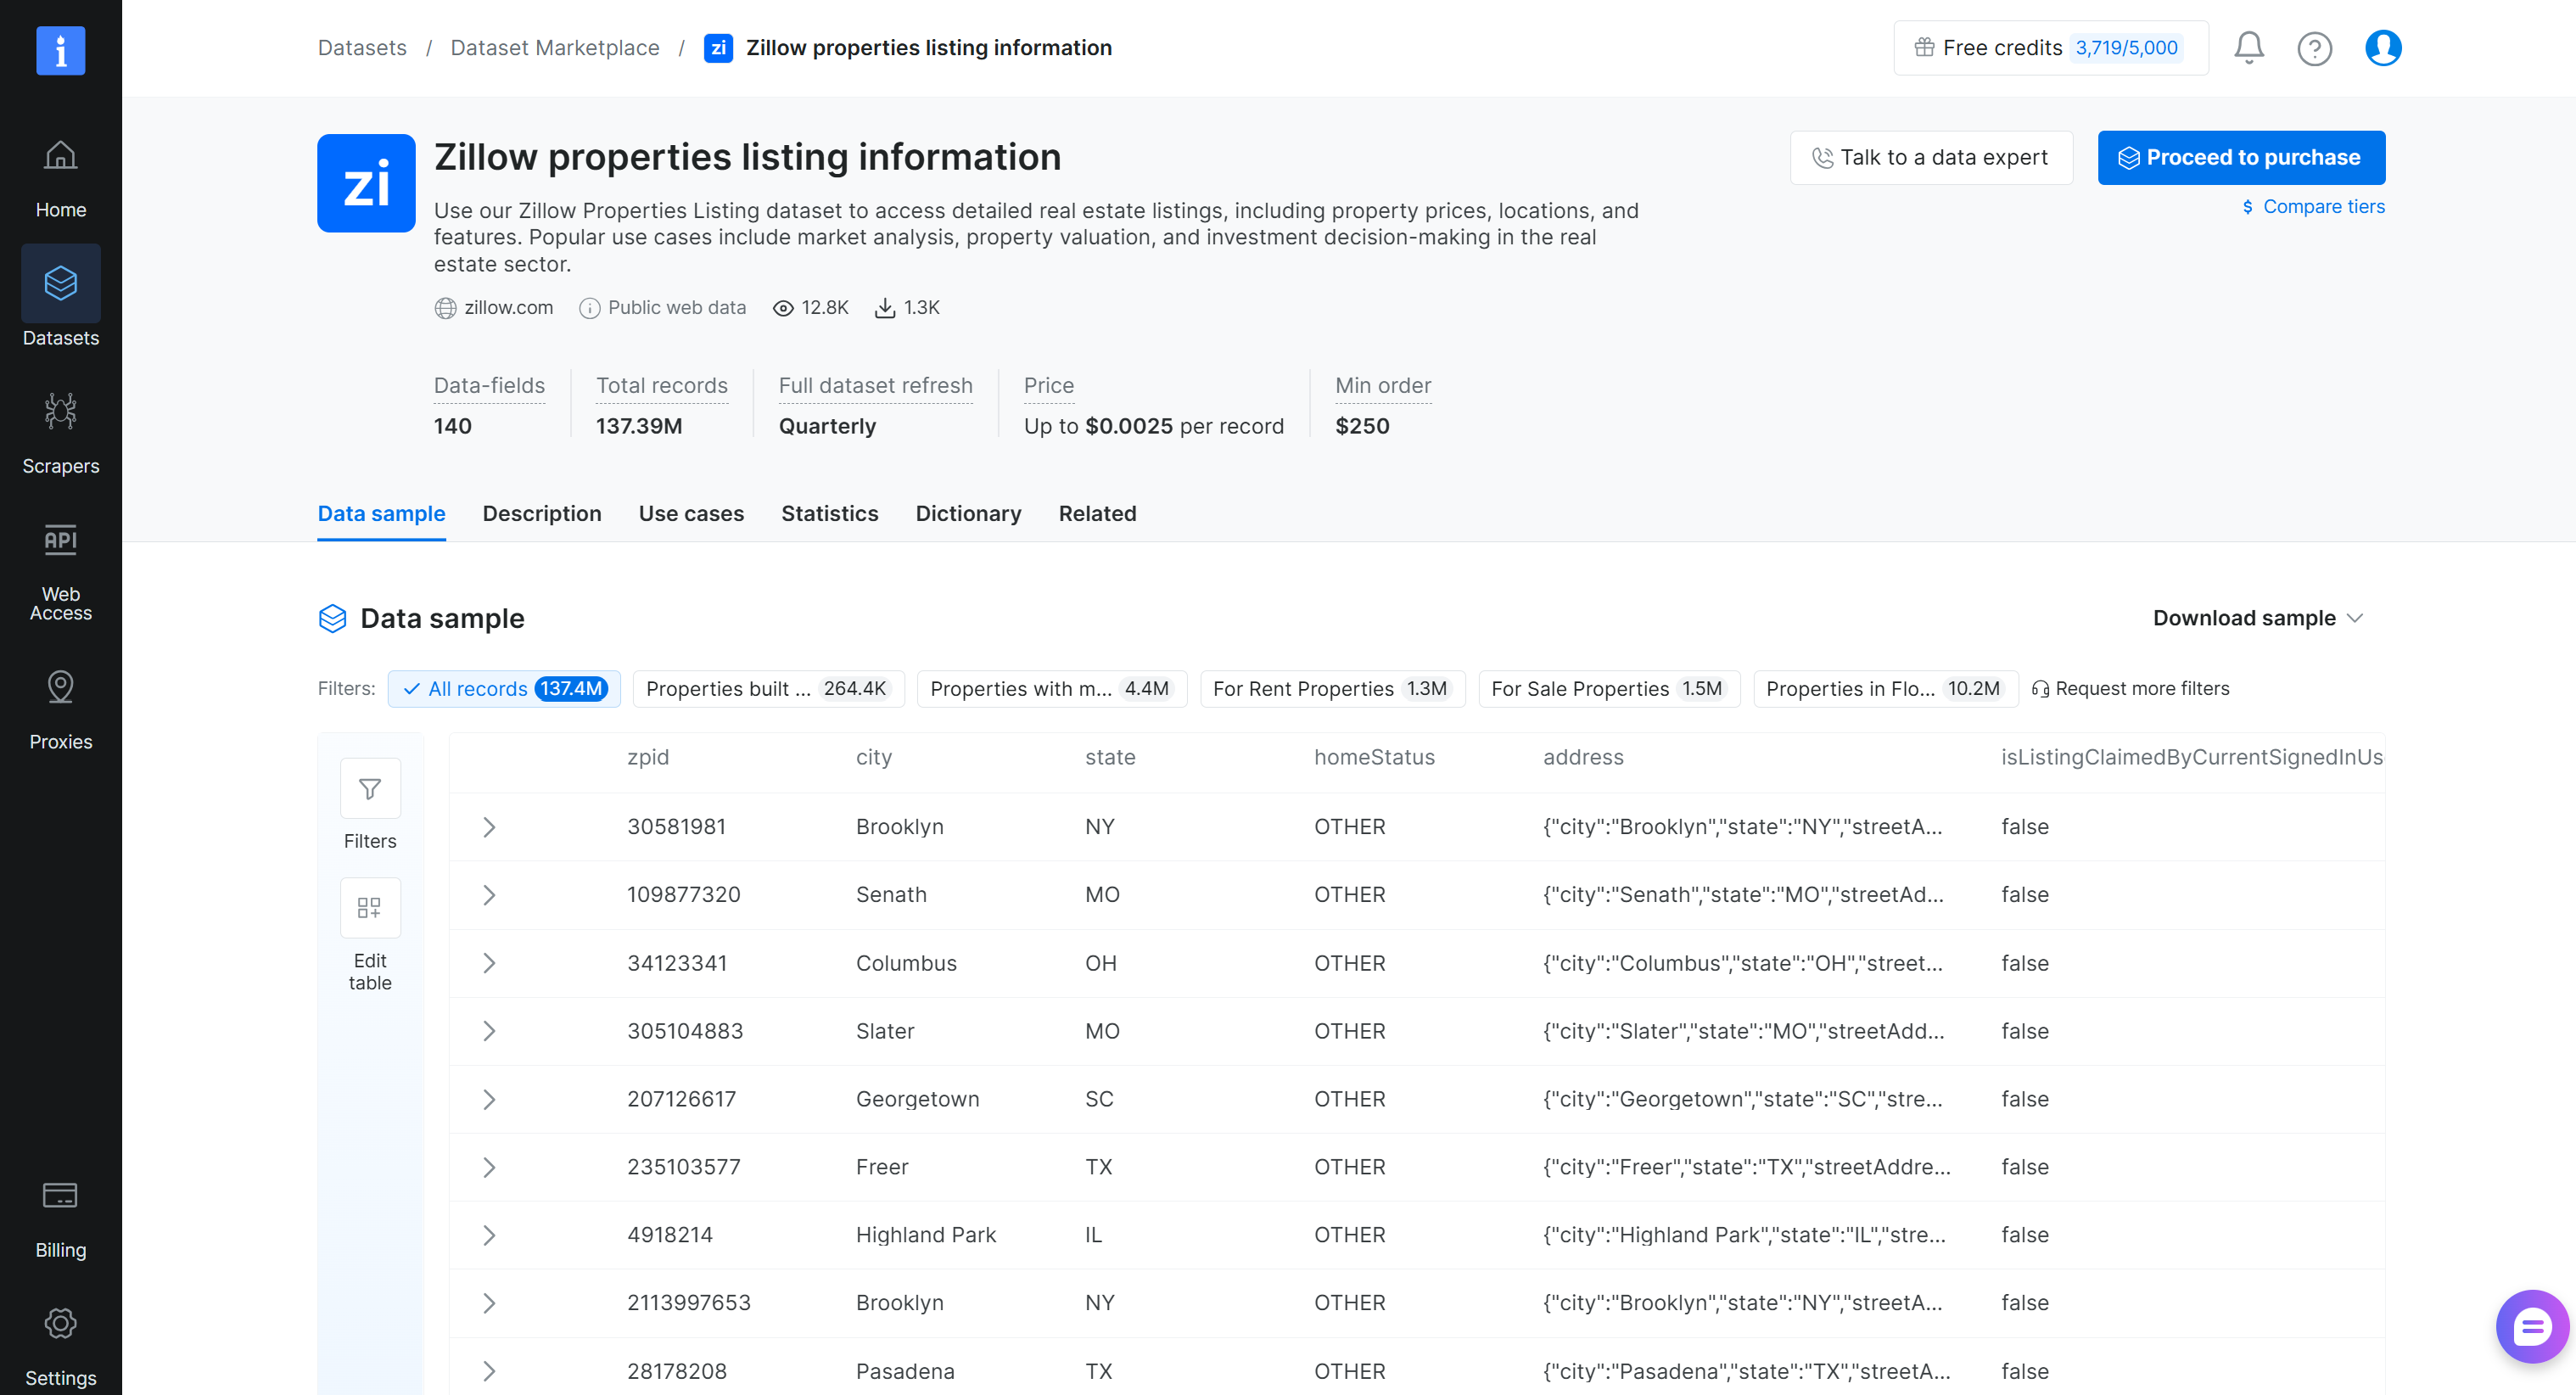
Nas etapas a seguir, você aprenderá a usar o SDK Python da Bright Data para obter um snapshot filtrado desse conjunto de dados, contendo apenas os registros relevantes para o cenário. Em seguida, você carregará os dados no pandas e construirá um Jupyter Notebook com os gráficos e análises necessários para responder às suas perguntas.
Ao longo do caminho, você também verá como limpar os dados, padronizar unidades de medida e calcular métricas derivadas para garantir comparações justas e significativas entre bairros.
Por Que Usar o SDK Python da Bright Data?
A Bright Data é um site líder em conjuntos de dados, especialmente como fornecedora de dados imobiliários. Ela oferece uma extensa coleção de conjuntos de dados estruturados e atualizados com frequência, contendo bilhões de registros de dados públicos da web.
Ao trabalhar em um projeto de análise e/ou visualização de dados, o primeiro passo é obter os dados de que você precisa. Existem duas abordagens principais:
- Coletar dados sob demanda: Construa e execute fluxos de scraping de dados para extrair as informações de que você precisa diretamente de sites.
- Usar conjuntos de dados existentes: Obtenha conjuntos de dados filtrados e pré-coletados, prontos para análise.
O SDK Python da Bright Data oferece suporte a ambas as abordagens. Ele fornece uma interface Python simplificada e tipada para acessar as soluções de coleta de dados web da Bright Data e oferece métodos convenientes para coletar conjuntos de dados estruturados diretamente do marketplace da Bright Data.
Para mais informações, consulte os seguintes recursos:
- Documentação do SDK Python
- Repositório do SDK Python
- Conheça o SDK Python da Bright Data: Faça Scraping, Pesquise e Obtenha Dados da Web
Recupere os Dados para Análise e Visualização
Siga as etapas abaixo para começar seu projeto de análise e visualização de dados, iniciando pela recuperação dos dados.
Pré-requisitos
Certifique-se de ter:
- Python 3.10+ instalado em sua máquina local.
- Uma conta Bright Data com uma chave de API configurada. Veja como obter sua chave de API da Bright Data.
Execute o seguinte comando para instalar os pacotes Python usados ao longo deste guia:
pip install brightdata-sdk jupyter pandas numpy matplotlib seaborn plotlyEssas bibliotecas fornecem as ferramentas necessárias para acessar os conjuntos de dados da Bright Data, manipular e analisar dados e lidar com visualizações em um Jupyter Notebook.
Para autenticar o SDK Python da Bright Data, defina sua chave de API na variável de ambiente BRIGHTDATA_API_KEY. No macOS ou Linux, execute:
export BRIGHTDATA_API_KEY="<YOUR_BRIGHT_DATA_API_KEY>"No Windows, execute o seguinte comando no PowerShell:
$env:BRIGHTDATA_API_KEY="<YOUR_BRIGHT_DATA_API_KEY>"Substitua <YOUR_BRIGHT_DATA_API_KEY> pela sua chave de API real da Bright Data.
Para simplificar, vamos supor que você já tenha um projeto Python local com um Jupyter Notebook configurado.
Obtenha os Dados Desejados
Os dados de interesse vêm do conjunto de dados de informações de listagem de propriedades do Zillow na Bright Data.
Neste cenário, suponha que você esteja interessado apenas em propriedades vendidas em San Diego no último ano.
No seu projeto Python, crie um script que use o SDK da Bright Data para solicitar um snapshot do conjunto de dados com os filtros escolhidos, aguarde o snapshot ficar disponível e exporte os registros resultantes:
import asyncio
from datetime import date, timedelta
from brightdata import BrightDataClient
from brightdata.datasets import export

async def main():
    # Obtém a data atual
    today = date.today()
    # Calcula o início da janela de vendas de interesse (último ano)
    one_year_ago = today - timedelta(days=365)

    # Define os filtros que cada imóvel retornado deve corresponder
    filters = {
        "operator": "and",
        "filters": [
            {
                # Mantém apenas imóveis em San Diego
                "name": "city",
                "operator": "=",
                "value": "San Diego",
            },
            {
                # Mantém apenas imóveis na Califórnia
                "name": "state",
                "operator": "=",
                "value": "CA",
            },
            {
                # Mantém apenas listagens vendidas
                "name": "homeStatus",
                "operator": "includes",
                "value": "SOLD",
            },
            {
                # Mantém apenas vendas do último ano
                "name": "dateSold",
                "operator": ">=",
                "value": one_year_ago.isoformat(),
            },
        ],
    }

    async with BrightDataClient() as client:
        # Solicita até 1.000 registros do conjunto de dados filtrado
        snapshot_id = await client.datasets.zillow_properties(
            filter=filters,
            records_limit=1000,
        )

        # Aguarda o snapshot terminar e baixa os registros
        data = await client.datasets.zillow_properties.download(
            snapshot_id,
            timeout=600 # Aguarda até 10 minutos
        )

        # Confirma quantos registros foram baixados
        print(f"Downloaded {len(data)} records")

        # Salva os registros em um arquivo CSV
        export(data, "properties.csv")

if __name__ == "__main__":
    asyncio.run(main())
O script acima solicita de forma assíncrona um snapshot do conjunto de dados, aguarda até 10 minutos pela conclusão, baixa os registros, relata o número recuperado e os exporta para properties.csv, pronto para análise no pandas.
Ele emprega o SDK da Bright Data para buscar registros de propriedades do Zillow que correspondam aos filtros especificados: casas em San Diego, Califórnia, vendidas nos últimos 365 dias. Nos bastidores, o SDK chama a API de Filtro da Bright Data, que permite obter snapshots filtrados dos conjuntos de dados da Bright Data.
Tenha em mente que o limite de registros está definido como 1.000, mas você pode ajustá-lo para qualquer número que atenda às suas necessidades. Você também pode adicionar novos filtros ou modificar os existentes para refinar o conjunto de dados e recuperar apenas os registros relevantes para sua análise.
Nota: A função auxiliar export() detecta o formato de saída pela extensão do arquivo, então .csv produz um arquivo CSV. Outras exportações de dados suportadas incluem JSON, NDJSON e JSONL.
Explore o Conjunto de Dados Recuperado
Execute o script de recuperação de dados. Um arquivo properties.csv aparecerá no diretório do seu projeto:
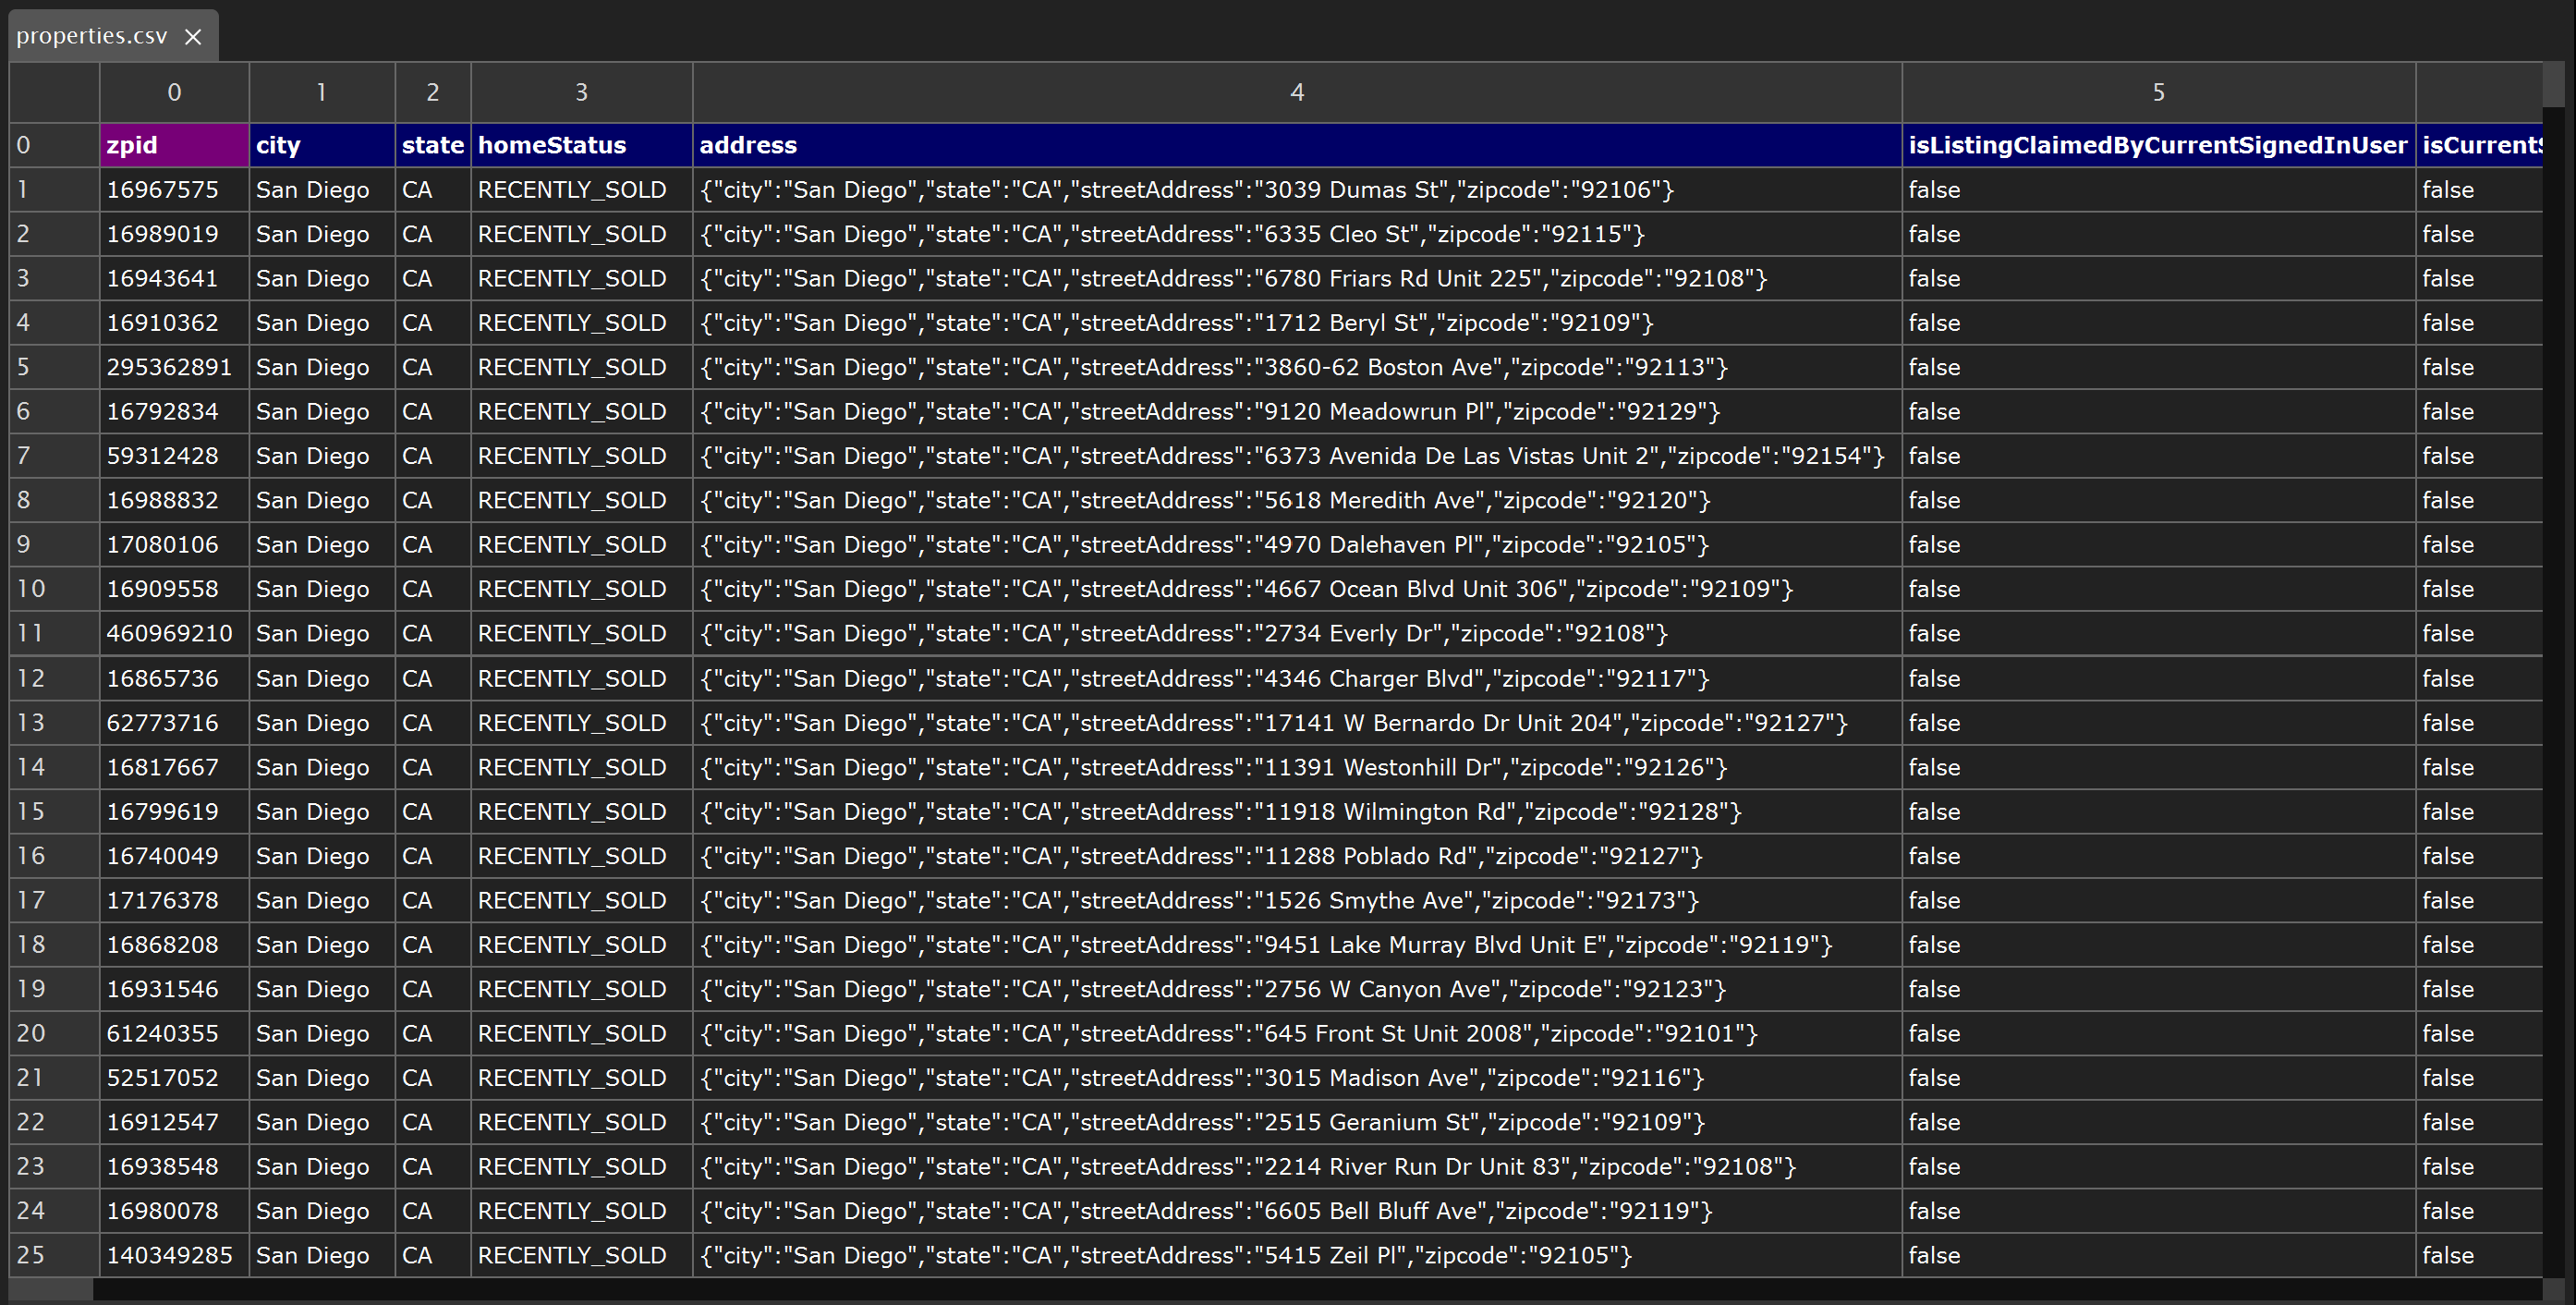
Abra o arquivo, e você notará os 1.000 registros de propriedades do Zillow retornados em formato CSV estruturado. Cada registro contém aproximadamente 140 colunas. As mais relevantes são:
| Coluna | Descrição |
|---|---|
zipcode, latitude, longitude |
Localização do imóvel |
homeType |
Tipo de propriedade, como SINGLE_FAMILY ou CONDO |
bedrooms, bathrooms |
Número de quartos e banheiros |
price |
Preço de venda em USD |
livingAreaValue, livingAreaUnits |
Área interna e sua unidade |
lotAreaValue, lotAreaUnits |
Tamanho do lote, em pés quadrados ou acres |
yearBuilt |
Ano de construção |
dateSoldString |
Data da venda (YYYY-MM-DD) |
daysOnZillow |
Tempo que a listagem ficou ativa |
zestimate, rentZestimate |
Valor estimado e aluguel mensal do Zillow |
taxAssessedValue |
Valor usado para impostos sobre a propriedade |
Descubra todas elas na seção “Dictionary” da página do painel de controle da Bright Data para o conjunto de dados de listagem de propriedades do Zillow:
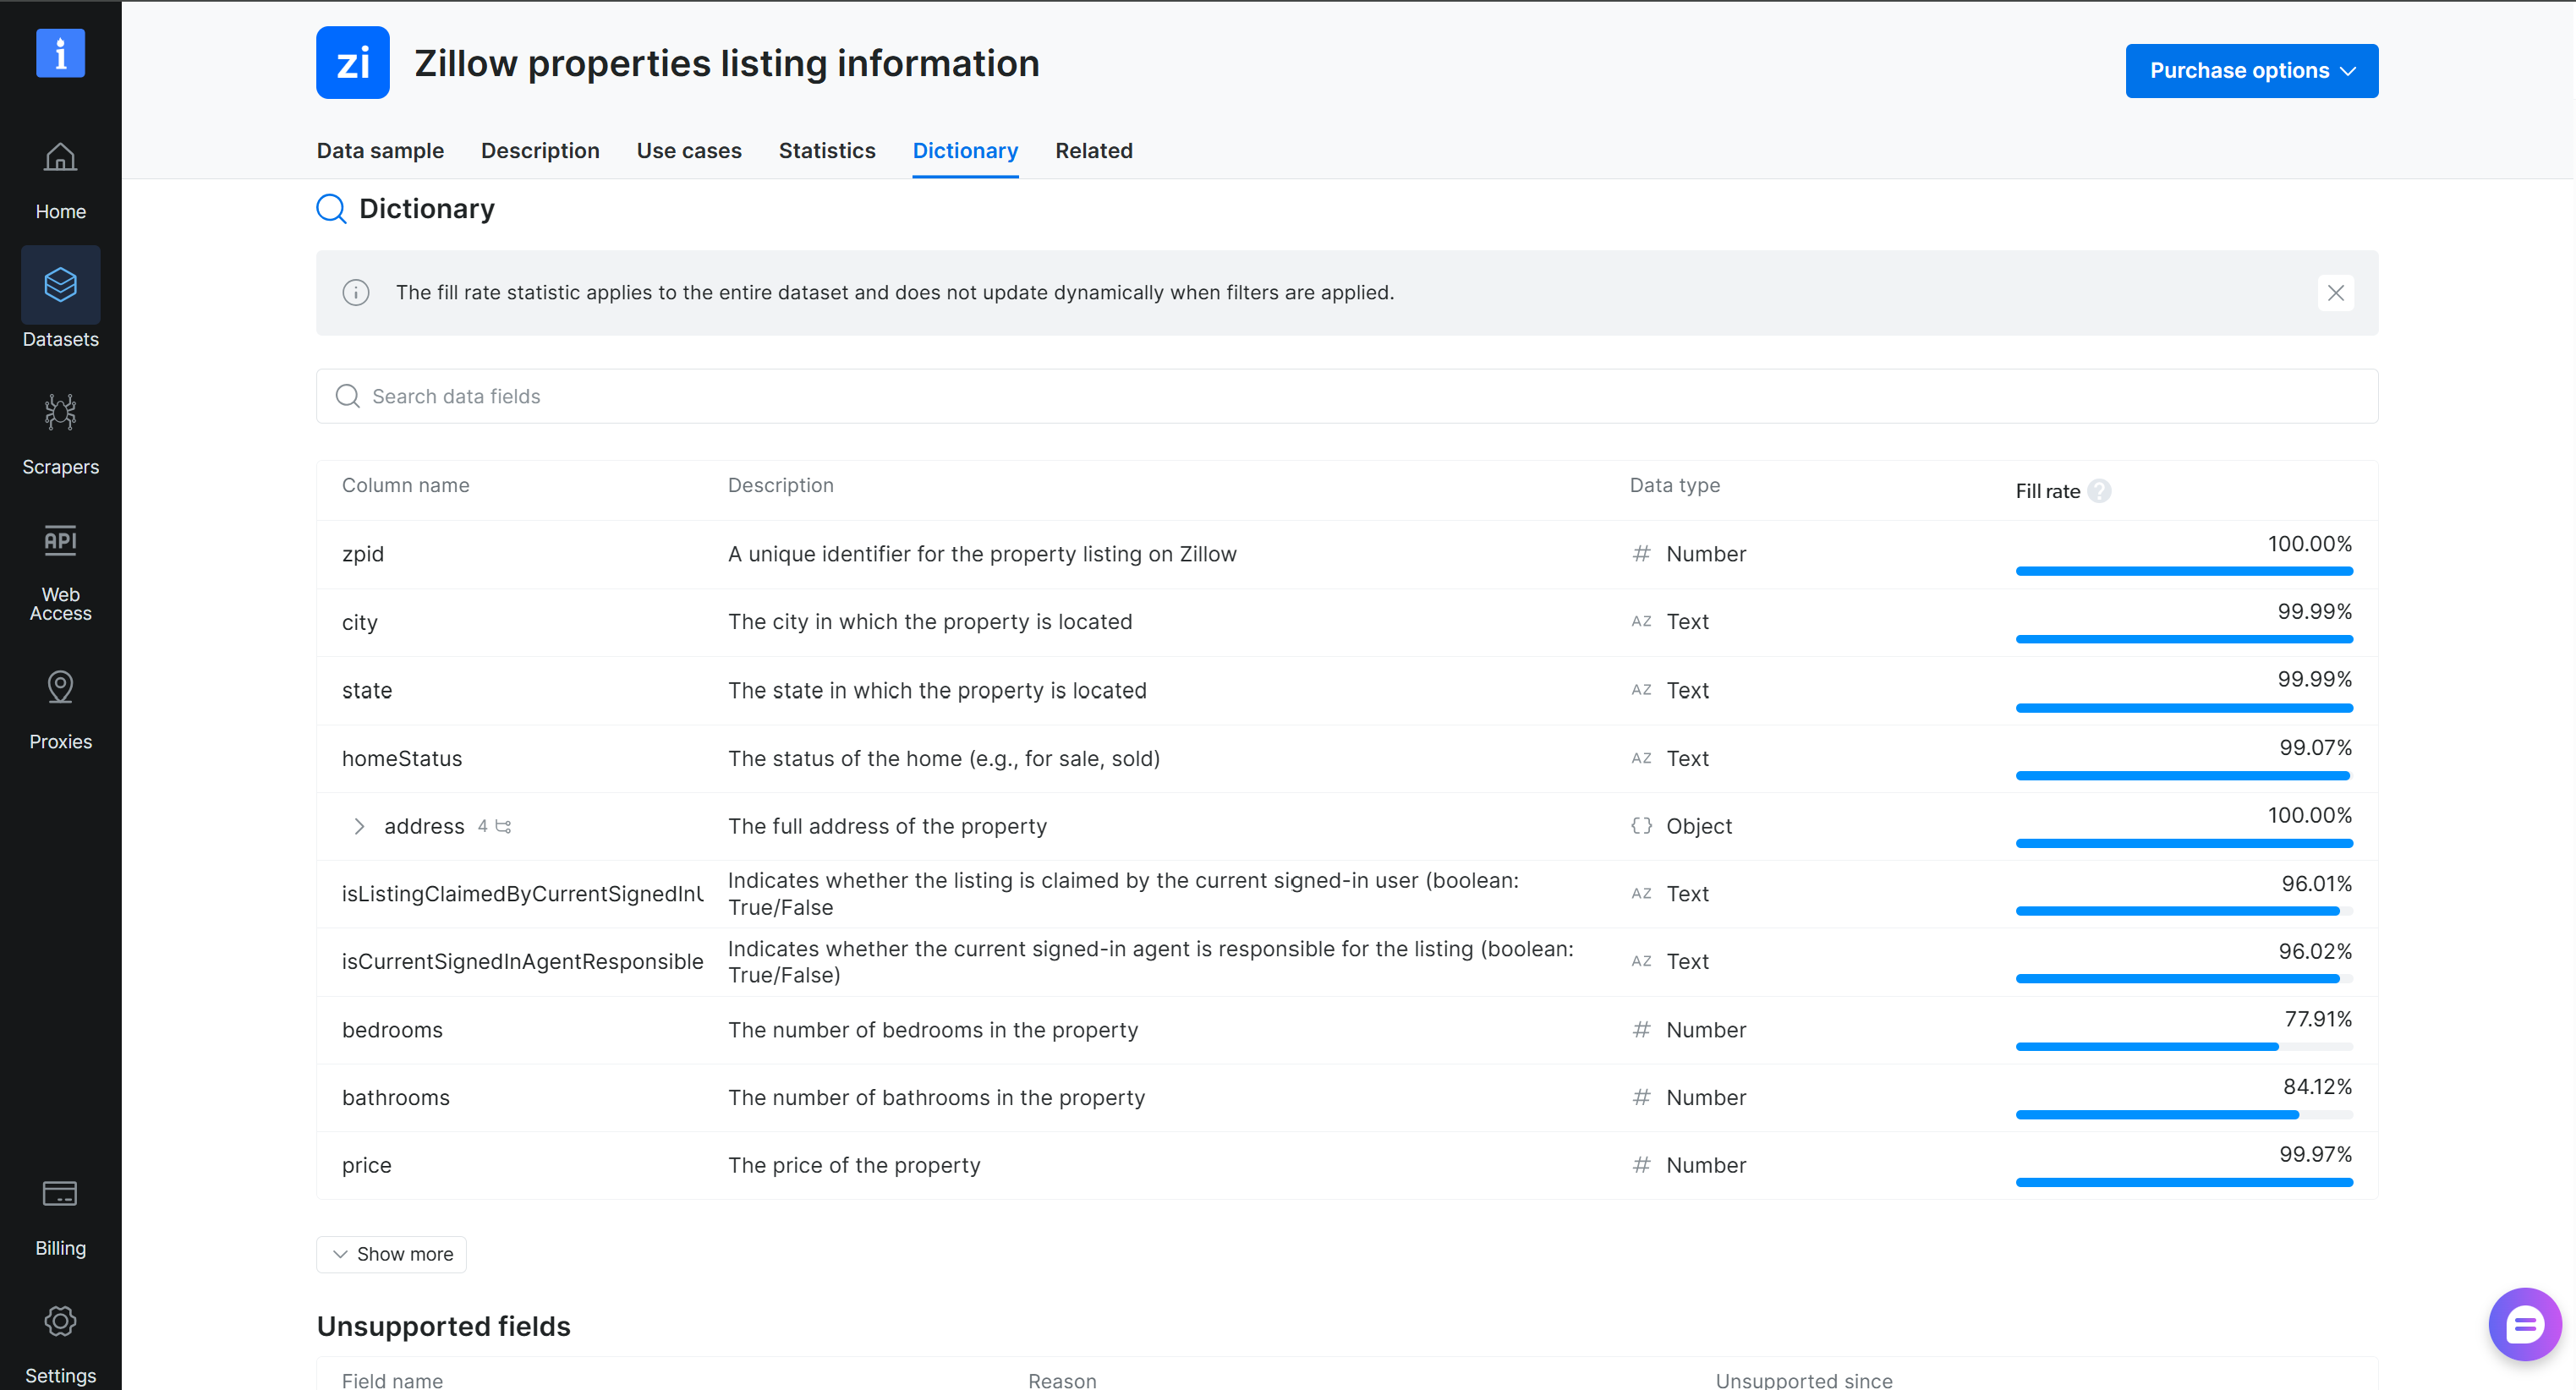
Missão cumprida! Agora você tem os dados brutos e estruturados.
A seguir, você aprenderá a limpar e prepará-los para análise e visualização. Depois, você definirá mais de 10 cenários para explorar o mercado imobiliário de San Diego e responder às suas principais perguntas sobre preços de venda de imóveis, acessibilidade por bairro e a precisão das estimativas do Zillow.
Prepare os Dados para Análise e Visualização
Agora que você recuperou o conjunto de dados, abra seu notebook e prepare o conjunto de dados para análise de dados. Em uma célula dedicada, execute estas tarefas:
- Importe as bibliotecas necessárias para manipulação de dados, análise estatística e visualização.
- Configure as definições de plotagem de dados.
- Carregue o conjunto de dados importando
properties.csvem um DataFrame do pandas. - Limpe e padronize os dados, tratando valores ausentes, corrigindo tipos de dados e convertendo campos em formatos consistentes.
- Crie variáveis adicionais para apoiar análises, comparações e visualizações mais eficazes.
Complete essas etapas com:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import plotly.express as px
from matplotlib.ticker import FuncFormatter
from IPython.display import display

# Mostra os preços no eixo como números completos, por exemplo 1.000.000
usd_fmt = FuncFormatter(lambda x, _: f"{x:,.0f}")

# Usa um estilo de grade limpo para todos os gráficos
sns.set_theme(style="whitegrid")

# Fator de conversão de pés quadrados para metros quadrados
SQFT_TO_M2 = 0.092903
# Fator de conversão de acres para pés quadrados
ACRE_TO_SQFT = 43560
# Ignora CEPs com menos vendas do que este número
MIN_SALES = 3

# Formata as colunas de um DataFrame como texto e depois o exibe como tabela
def show_table(frame, formats, title=""):
    # Trabalha em uma cópia para que os dados originais não sejam alterados
    out = frame.copy()
    # Aplica cada formato à sua coluna, mostrando valores ausentes como um traço
    for col, fmt in formats.items():
        out[col] = out[col].map(lambda v, f=fmt: f.format(v) if pd.notna(v) else "-")
    # Imprime um título acima da tabela quando fornecido
    if title:
        print(title)
    # Mostra a tabela formatada
    display(out)

# Carrega o CSV, mantendo os CEPs como texto
df = pd.read_csv("properties.csv", dtype={"zipcode": str})

# Lista as colunas que devem ser números
numeric_cols = ["price", "bedrooms", "bathrooms", "livingAreaValue", "lotAreaValue",
                "yearBuilt", "daysOnZillow", "zestimate", "rentZestimate",
                "taxAssessedValue", "latitude", "longitude"]
# Converte essas colunas em números, transformando valores inválidos em NaN
df[numeric_cols] = df[numeric_cols].apply(pd.to_numeric, errors="coerce")

# Preenche os CEPs com 5 dígitos
df["zipcode"] = df["zipcode"].str.zfill(5)
# Converte o texto da data de venda em um datetime
df["dateSold"] = pd.to_datetime(df["dateSoldString"])

# Encontra as linhas onde a área útil está em pés quadrados
is_sqft = df["livingAreaUnits"].eq("Square Feet")
# Converte pés quadrados para m², e deixa NaN para outras unidades
df["living_area_m2"] = np.where(is_sqft, df["livingAreaValue"] * SQFT_TO_M2, np.nan)

# Converte o tamanho do lote para pés quadrados, seja em acres ou já em pés quadrados
lot_sqft = np.where(df["lotAreaUnits"].eq("Acres"),
                    df["lotAreaValue"] * ACRE_TO_SQFT,
                    df["lotAreaValue"])
# Converte o tamanho do lote para metros quadrados
df["lot_m2"] = lot_sqft * SQFT_TO_M2

# Remove linhas sem preço de venda válido
df = df[df["price"] > 0].copy()
# Calcula o preço de venda por metro quadrado
df["price_per_m2"] = df["price"] / df["living_area_m2"]
# Calcula a diferença entre o preço de venda e o Zestimate em porcentagem
df["zestimate_error_pct"] = ((df["price"] - df["zestimate"])
                             / df["zestimate"].where(df["zestimate"] > 0) * 100)
# Calcula o aluguel anual como porcentagem do preço de venda
df["rent_yield_pct"] = df["rentZestimate"] * 12 / df["price"] * 100
# Agrupa os preços em faixas, rotuladas com números completos em USD
df["price_band"] = pd.cut(df["price"], bins=[0, 500_000, 1_000_000, 1_500_000, np.inf],
                          labels=["<500.000", "500.000-1.000.000",
                                  "1.000.000-1.500.000", ">1.500.000"])
# Agrupa os imóveis por era de construção
df["age_band"] = pd.cut(df["yearBuilt"], bins=[0, 1949, 1979, 1999, np.inf],
                        labels=["<1950", "1950-1979", "1980-1999", "2000+"])

# Resume quantos imóveis e CEPs estão no conjunto de dados limpo
print(f"{len(df)} sold homes across {df['zipcode'].nunique()} ZIP codes")

# Pré-visualiza as colunas principais com preços e áreas formatados
show_table(
    # Seleciona as colunas principais para a pré-visualização
    df[["zpid", "streetAddress", "zipcode", "homeType", "bedrooms", "bathrooms",
        "price", "living_area_m2", "dateSold"]].head(),
    # Formata preços como números completos e áreas com uma casa decimal
    formats={"price": "{:,.0f}", "living_area_m2": "{:,.1f} m²"},
    title="Sample of sold homes",
)
Execute-o, e você obterá este resultado:
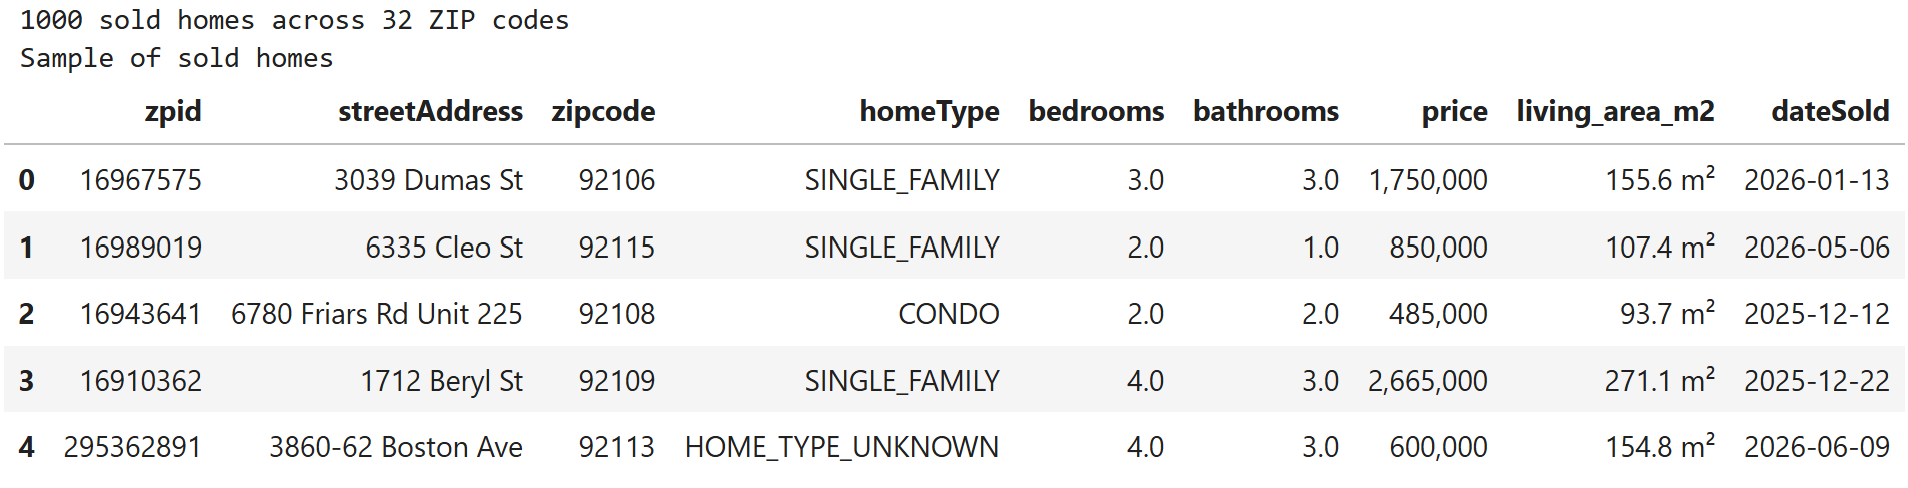
Note que a célula acima cuida de:
- Normalizar unidades de medida: As áreas úteis e tamanhos de lote são convertidos para metros quadrados, de modo que cada métrica baseada em tamanho use a mesma unidade.
- Tratar valores ausentes: Os erros do Zestimate só são calculados quando o Zestimate é maior que zero, o que evita divisão por zero.
- Adicionar campos derivados: Preço por m², rendimento de aluguel, faixas de preço e faixas de idade são adicionados como colunas para simplificar a visualização de dados.
Fantástico! Você está pronto para seguir com a análise e visualização de dados.
Análise e Visualização
Aqui, você verá mais de 10 formas práticas de examinar e visualizar o conjunto de dados, descobrindo padrões e insights sobre o mercado imobiliário de San Diego. Cada seção inclui uma breve visão geral, o código da célula, o resultado obtido e uma interpretação das descobertas.
Distribuição dos Preços de Venda
Descrição: Explore onde a maioria dos preços de venda se concentra, com a mediana marcada para que você veja o quão assimétrico é o mercado.
Célula:
plt.figure(figsize=(10, 6))

# Desenha um histograma dos preços com uma curva de densidade suavizada
sns.histplot(df["price"], bins=30, kde=True, color="steelblue")

# Calcula o preço de venda mediano
median = df["price"].median()

# Desenha uma linha vermelha tracejada na mediana, rotulada com o número completo
plt.axvline(median, color="red", linestyle="--", label=f"Median: {median:,.0f} USD")
# Mostra os preços no eixo x como números completos
plt.gca().xaxis.set_major_formatter(usd_fmt)

plt.title("Distribution of Sold Prices in San Diego")
plt.xlabel("Sold price (USD)")
# Remove a passagem automática no eixo x
plt.xlim(left=0)
plt.ylabel("Number of homes")
plt.legend()
plt.show()Resultado:
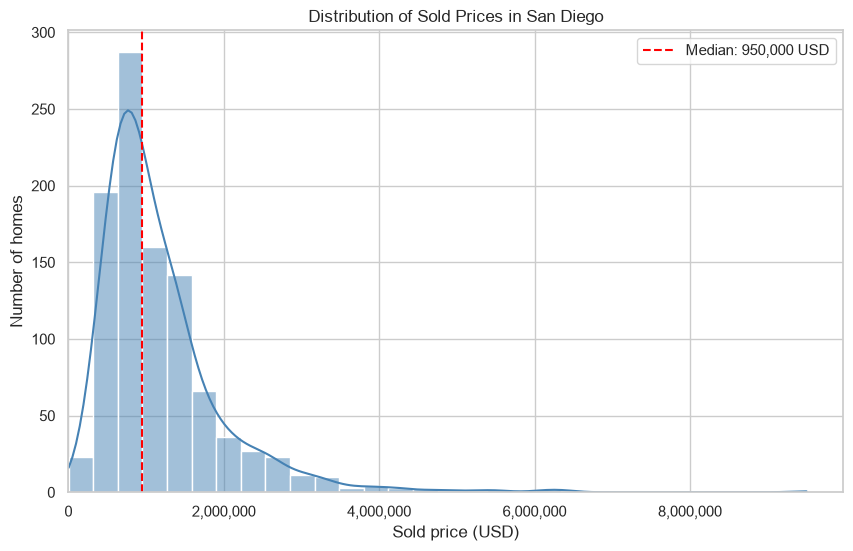
Comentário: A maioria das vendas se concentra entre aproximadamente 500.000 e 1.500.000 USD, com pico perto de 750.000 USD, enquanto a mediana de 950.000 USD fica mais alta. Uma longa cauda chega a quase 9.500.000 USD. A distribuição é assimétrica à direita, puxando a média acima da mediana.
Preço Mediano por Tipo de Imóvel
Descrição: Compare o preço mediano e médio de venda entre os tipos de propriedade para ver quais tipos de imóveis impulsionam o mercado.
Célula:
# Agrupa as vendas por tipo de imóvel e calcula estatísticas resumidas
by_type = (df.groupby("homeType")
             # Conta os imóveis e obtém a mediana e a média do preço para cada tipo
             .agg(homes=("zpid", "count"),
                  median_price=("price", "median"),
                  mean_price=("price", "mean"))
             # Ordena os tipos do maior para o menor preço mediano
             .sort_values("median_price", ascending=False))

show_table(by_type.reset_index(),
           formats={"median_price": "{:,.0f}", "mean_price": "{:,.0f}"},
           title="Sold price by home type (USD)")

plt.figure(figsize=(10, 6))
sns.barplot(data=by_type.reset_index(), x="homeType", y="median_price", color="steelblue")
plt.gca().yaxis.set_major_formatter(usd_fmt)
plt.xticks(rotation=30)
plt.title("Median Sold Price by Home Type")
plt.xlabel("Home type")
plt.ylabel("Median price (USD)")
plt.show()Resultado:
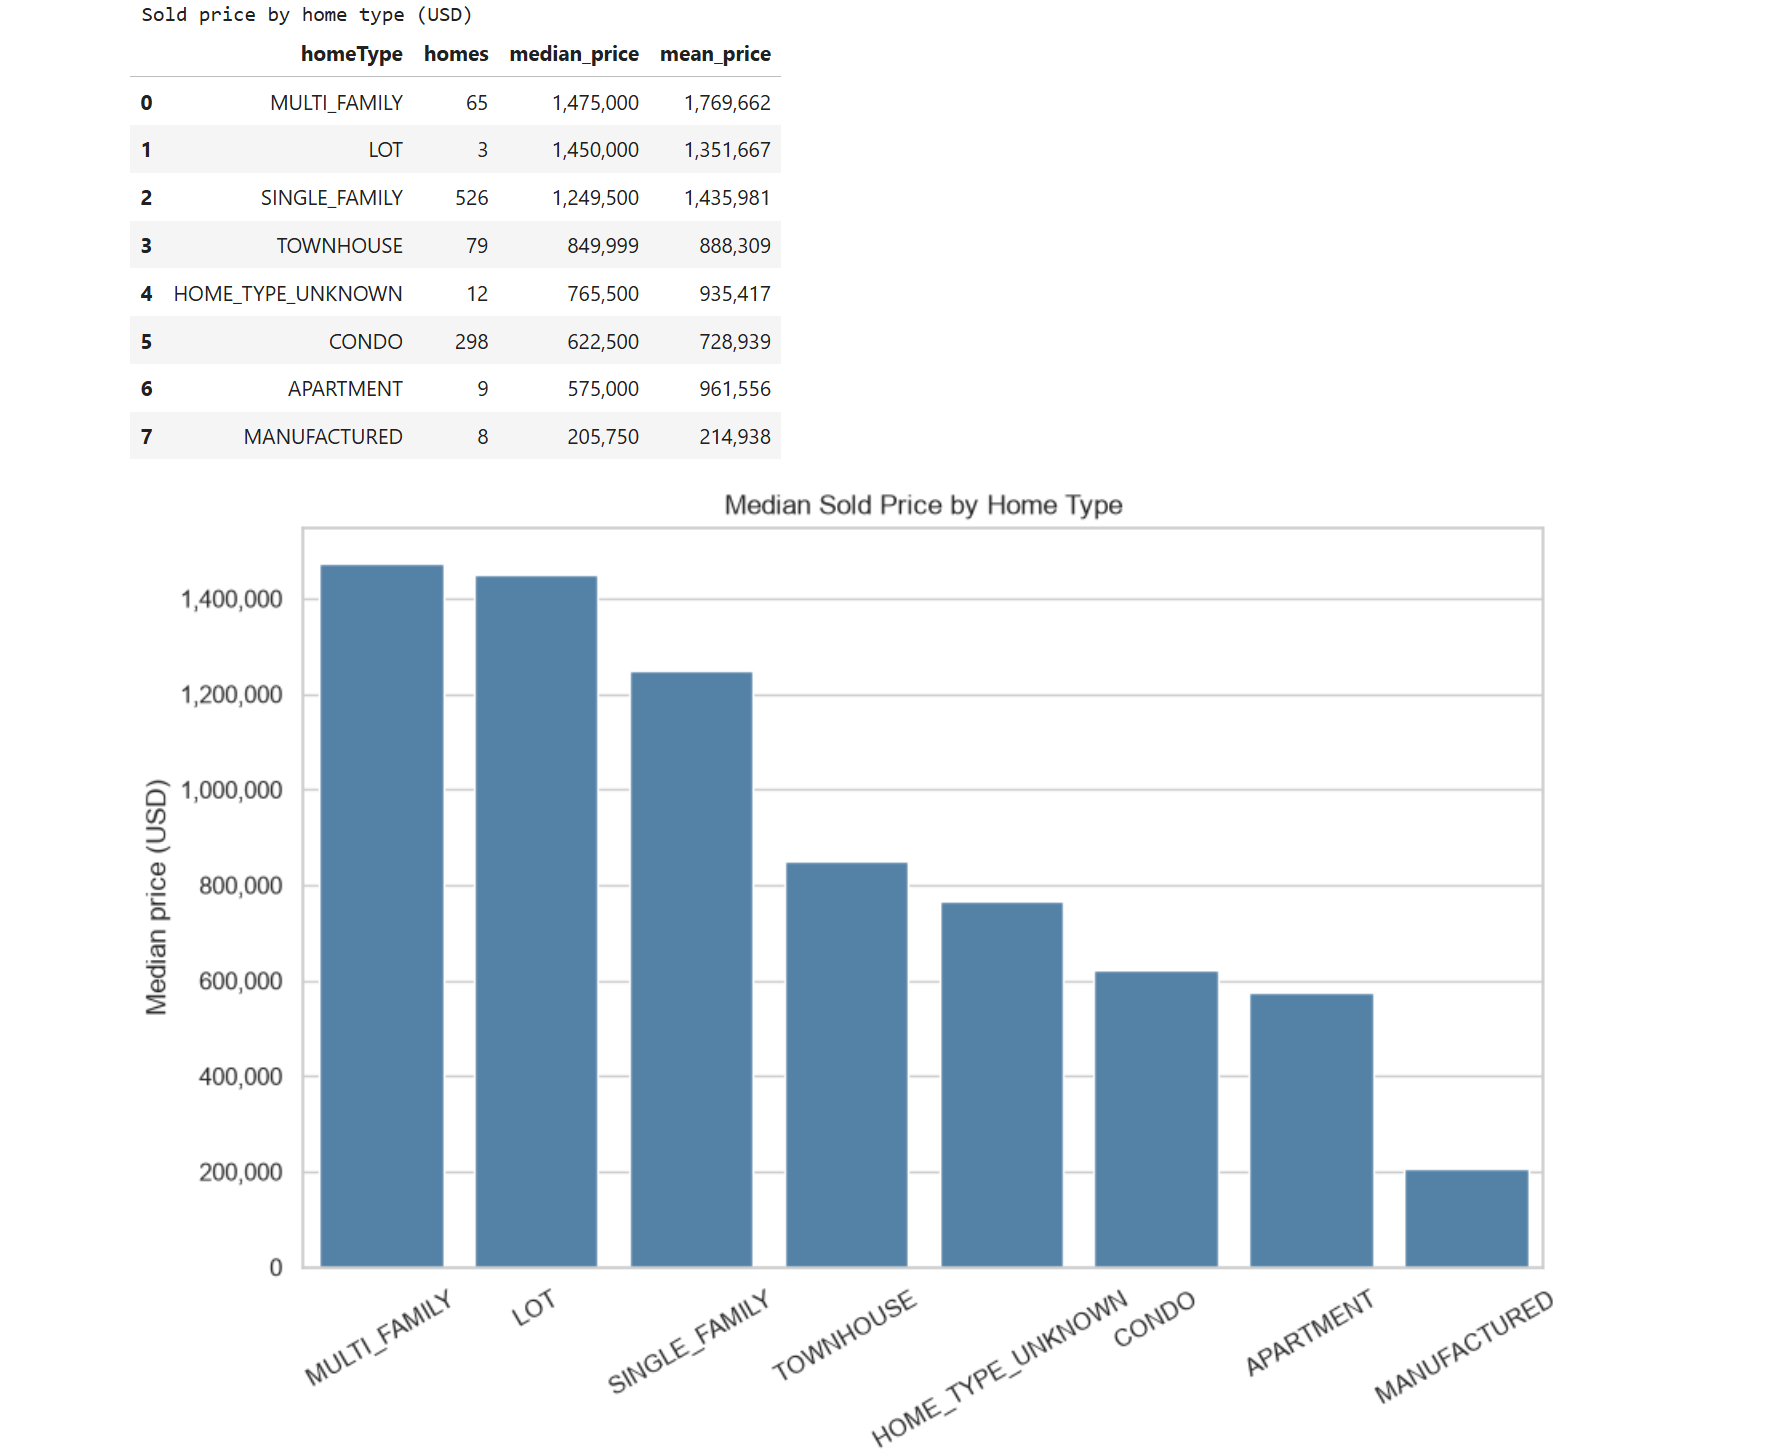
Comentário: Casas unifamiliares são o indicador mais confiável, com uma mediana de 1.249.500 USD em 526 vendas. As medianas de imóveis multifamiliares e lotes parecem mais altas, mas se baseiam em muito menos vendas (65 e 3), enquanto casas manufaturadas são as mais baratas, a 205.750 USD, e condomínios ficam em 622.500 USD.
Principais CEPs por Preço Mediano de Venda
Descrição: Classifique os 15 CEPs mais caros por preço mediano de venda. CEPs com poucas vendas são excluídos para evitar medianas enganosas.
Célula:
# Agrupa as vendas por CEP e calcula a contagem de vendas e o preço mediano
zip_stats = (df.groupby("zipcode")
               .agg(sales=("zpid", "count"), median_price=("price", "median"))
               # Remove CEPs com poucas vendas
               .query("sales >= @MIN_SALES")
               # Ordena do mais caro para o mais barato
               .sort_values("median_price", ascending=False)
               # Mantém apenas os 15 primeiros
               .head(15)
               # Transforma o índice do CEP de volta em coluna
               .reset_index())

show_table(zip_stats,
           formats={"median_price": "{:,.0f}"},
           title=f"Top 15 ZIP codes by median sold price (min. {MIN_SALES} sales)")

plt.figure(figsize=(10, 7))
sns.barplot(data=zip_stats, x="median_price", y="zipcode", color="steelblue")
plt.gca().xaxis.set_major_formatter(usd_fmt)
plt.title(f"Top 15 ZIP Codes by Median Sold Price (min. {MIN_SALES} sales)")
plt.xlabel("Median price (USD)")
plt.ylabel("ZIP code")
plt.show()Resultados:
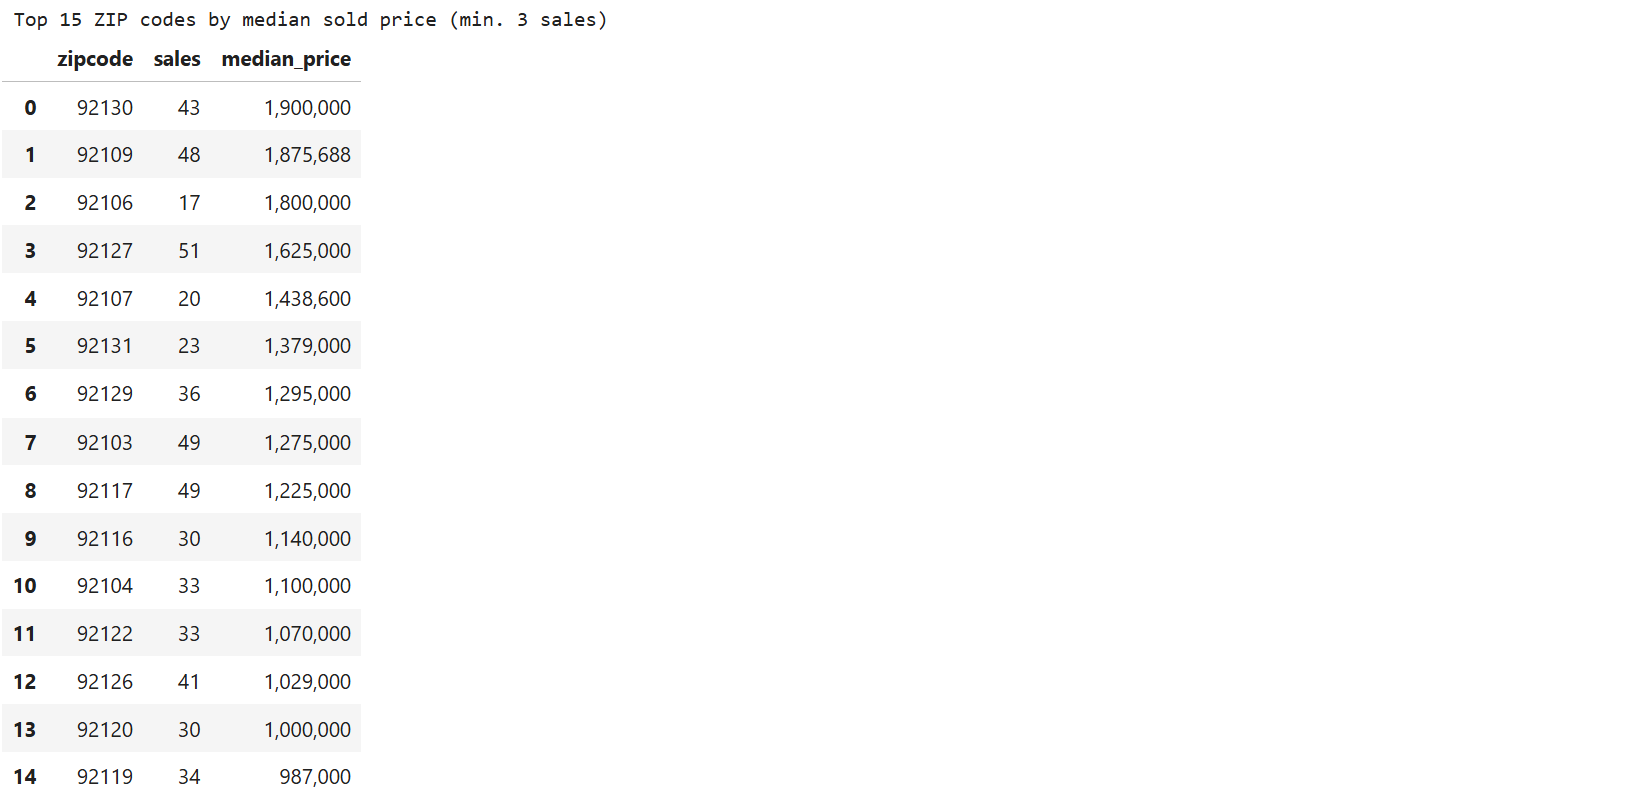
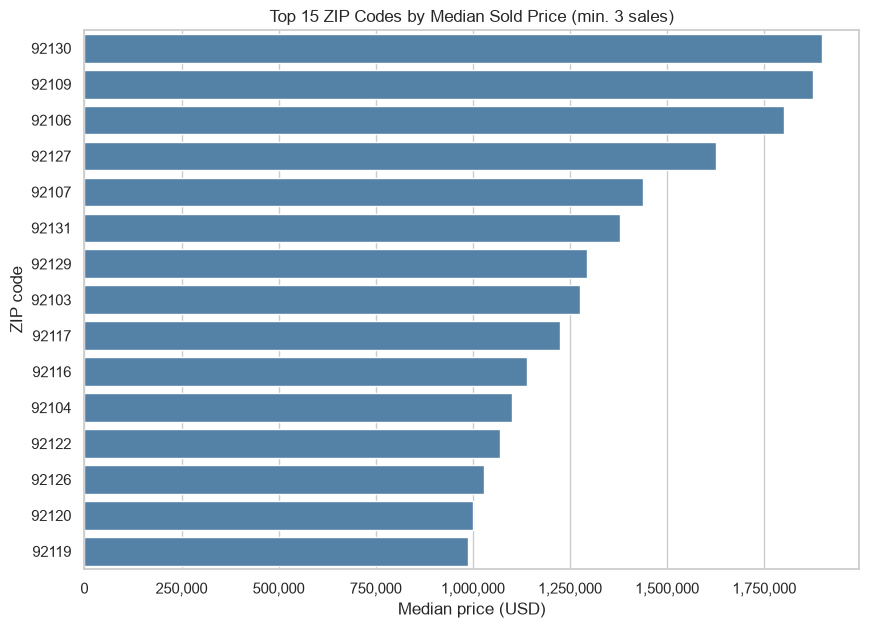
Comentário: 92130, 92109 e 92106 lideram, com medianas de pelo menos 1.800.000 USD. 92118 (Coronado) tem a mediana mais alta, acima de 3.300.000 USD, mas poucas vendas para entrar no ranking. 92106 se baseia em apenas 17 vendas, então sua posição pode mudar.
Mapa de Onde os Imóveis Foram Vendidos
Descrição: Plote cada venda em um mapa, colorida pelo preço de venda, para ver onde estão os imóveis mais caros.
Célula:
# Copia os dados originais
map_df = df.copy()

for col in ["latitude", "longitude", "price"]:
    map_df[col] = pd.to_numeric(map_df[col], errors="coerce")

# Mantém linhas com coordenadas e preços de venda válidos
map_df = map_df.dropna(subset=["latitude", "longitude", "price"])

fig = px.scatter_map(
    map_df,
    lat="latitude",
    lon="longitude",
    color="price",
    hover_name="streetAddress",
    hover_data={
        "zipcode": True,
        "homeType": True,
        "bedrooms": True,
        "price": ":,.0f",
        "latitude": False,
        "longitude": False,
    },
    labels={
        "price": "Sold price (USD)",
    },
    color_continuous_scale="Viridis",

    center={"lat": 32.8157, "lon": -117.1611},
    zoom=8.8,
    height=650,
    map_style="open-street-map",
    title="Where Homes Sold in San Diego (color = sold price in USD)",
)

fig.show(renderer="notebook")

# Define os limites geográficos
longitude_cutoff = -117.2
latitude_cutoff = 32.8

# Divide as propriedades em grupos ocidental e oriental
west = geo_df[geo_df["longitude"] < longitude_cutoff]
east = geo_df[geo_df["longitude"] >= longitude_cutoff]

# Divide as propriedades em grupos norte e sul
north = geo_df[geo_df["latitude"] >= latitude_cutoff]
south = geo_df[geo_df["latitude"] < latitude_cutoff]

# Exibe os preços medianos e os tamanhos das amostras
print("WESTERN VS. EASTERN PROPERTIES")
print("-" * 40)
print(f"West of longitude {longitude_cutoff}:")
print(f"  Median sold price: ${west['price'].median():,.0f}")
print(f"  Number of properties: {len(west):,}")

print(f"\nEast of or at longitude {longitude_cutoff}:")
print(f"  Median sold price: ${east['price'].median():,.0f}")
print(f"  Number of properties: {len(east):,}")

print("\nNORTHERN VS. SOUTHERN PROPERTIES")
print("-" * 40)
print(f"North of or at latitude {latitude_cutoff}:")
print(f"  Median sold price: ${north['price'].median():,.0f}")
print(f"  Number of properties: {len(north):,}")

print(f"\nSouth of latitude {latitude_cutoff}:")
print(f"  Median sold price: ${south['price'].median():,.0f}")
print(f" Number of properties: {len(south):,}")Resultados:
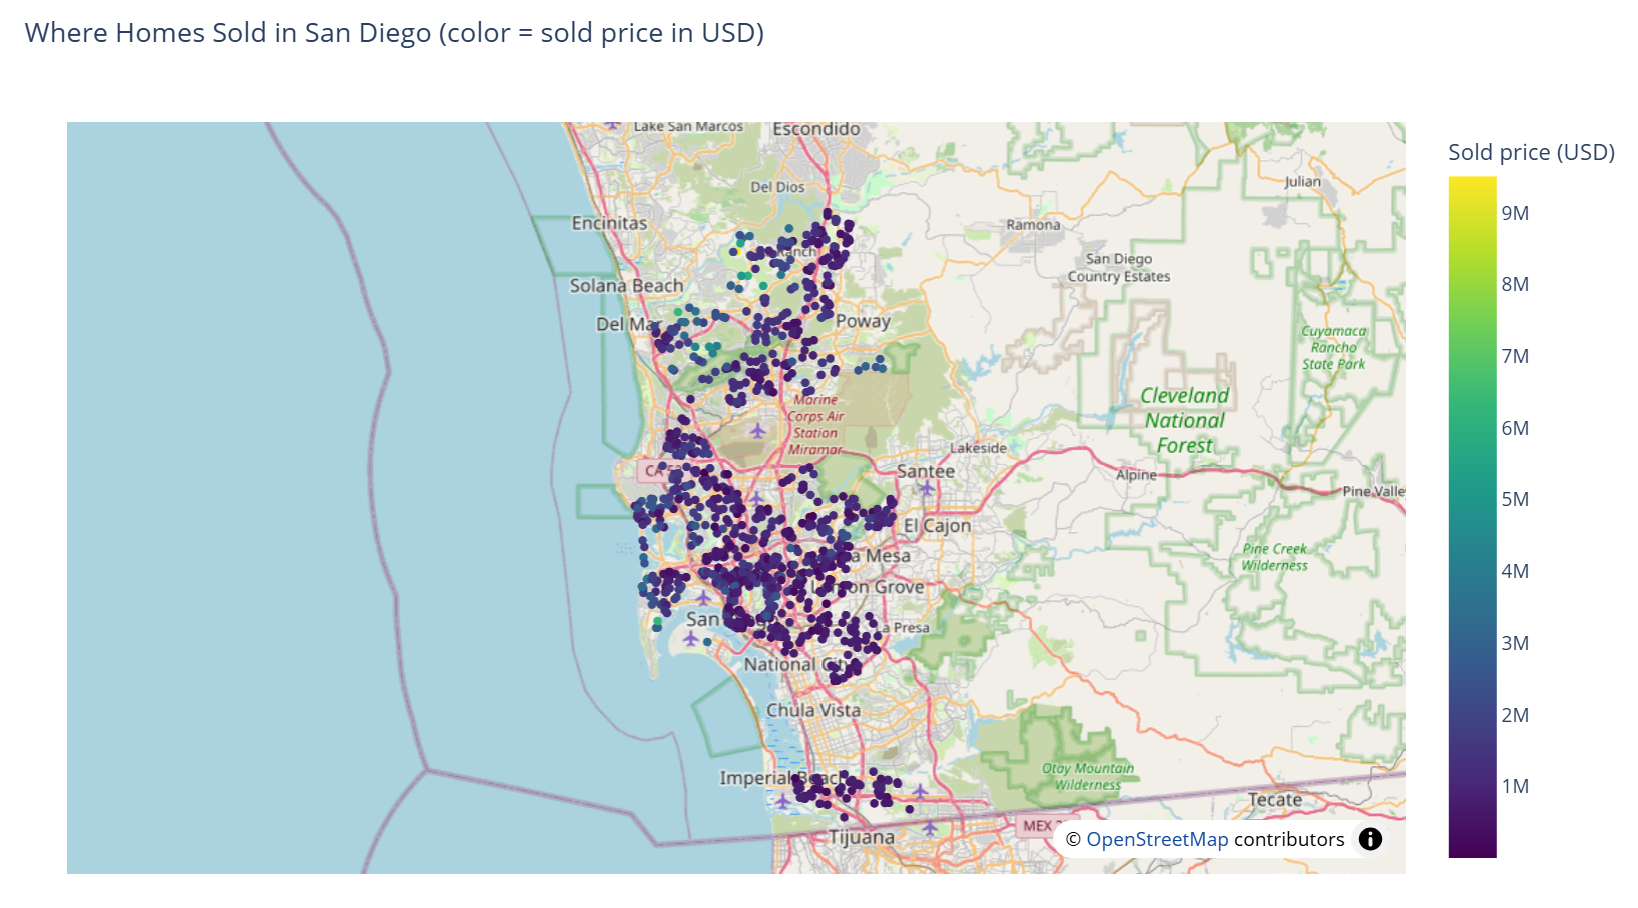
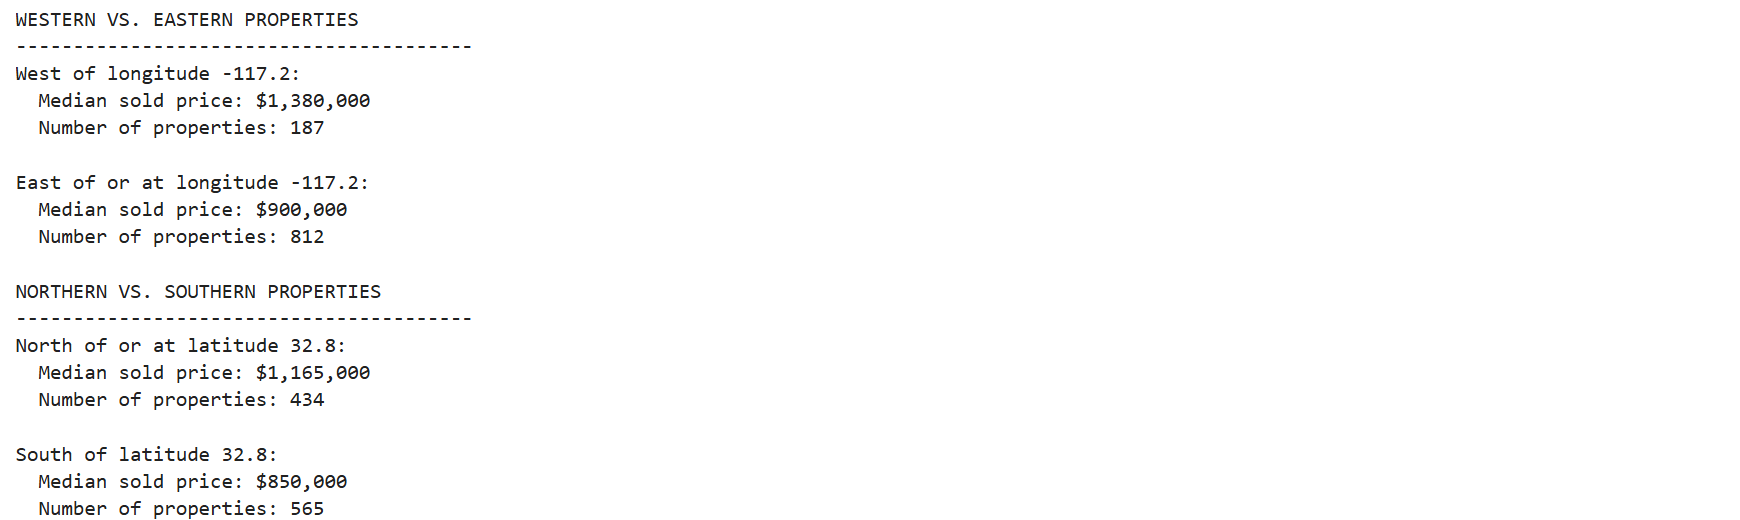
Comentário: Imóveis a oeste da longitude -117.2 têm uma mediana de cerca de 1.380.000 USD, contra 900.000 USD no interior. As vendas no norte (mediana de 1.165.000 USD) são muito mais caras do que no sul (850.000 USD).
Preço por m² por CEP
Descrição: Compare a dispersão do preço por metro quadrado entre os 10 CEPs com mais vendas.
Célula:
# Encontra os 10 CEPs com mais vendas
top_zips = df["zipcode"].value_counts().head(10).index
# Mantém as vendas nesses CEPs que têm um preço por m² válido
zip_m2 = df[df["zipcode"].isin(top_zips)].dropna(subset=["price_per_m2"])
# Ordena os CEPs pelo preço mediano por m², do maior para o menor
order = (zip_m2.groupby("zipcode")["price_per_m2"]
               # Obtém o preço mediano por m² para cada CEP
               .median()
               # Ordena do maior para o menor
               .sort_values(ascending=False)
               # Mantém os CEPs nessa ordem
               .index)

plt.figure(figsize=(12, 6))
sns.boxplot(data=zip_m2, x="zipcode", y="price_per_m2", order=order,
            hue="zipcode", legend=False, palette="Set2", showfliers=False)
plt.gca().yaxis.set_major_formatter(usd_fmt)
plt.title("Sold Price per m² in the 10 Most Active ZIP Codes")
plt.xlabel("ZIP code")
plt.ylabel("Price per m² (USD)")
plt.show()Resultado:
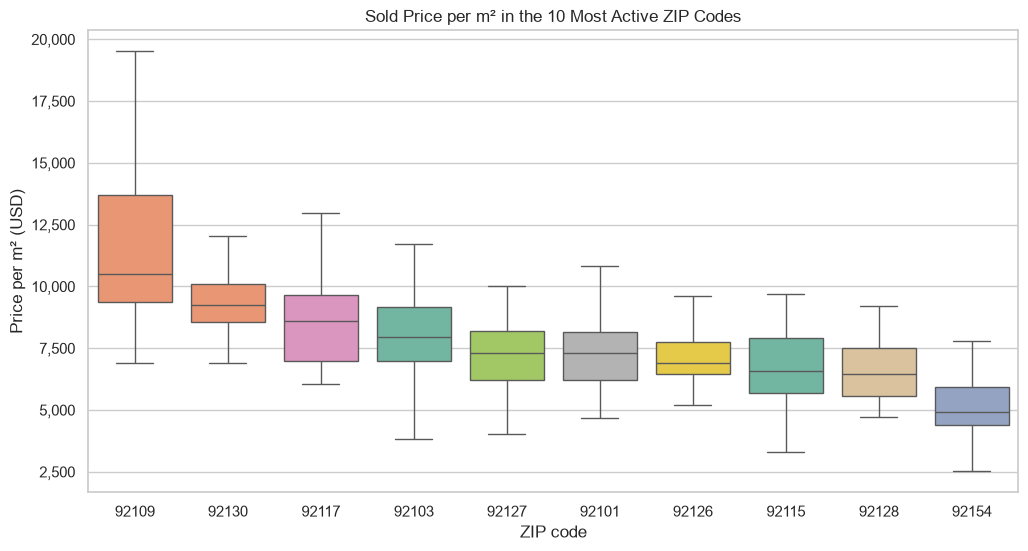
Comentário: 92109 tem o maior preço mediano por m² (cerca de 10.500 USD) e a maior dispersão. 92154 é o mais barato, com cerca de 4.900 USD.
Preço por m² vs. Área Útil por CEP para Casas Unifamiliares
Descrição: Teste se casas unifamiliares maiores vendem por menos por metro quadrado de acordo com o CEP.
Célula:
# Mantém apenas casas unifamiliares com preço por m² e área útil
d = df[
    (df["homeType"] == "SINGLE_FAMILY")
].dropna(subset=["price_per_m2", "living_area_m2"]).copy()

# Mantém os 10 CEPs mais ativos como seus próprios grupos e coloca o resto em "Other"
d["zip_group"] = np.where(d["zipcode"].isin(top_zips), d["zipcode"], "Other")

zip_order = list(top_zips) + ["Other"]

fig = px.scatter(
    d,
    x="living_area_m2",
    y="price_per_m2",
    facet_col="zip_group",
    facet_col_wrap=4,
    category_orders={"zip_group": zip_order},
    hover_data={
        "zipcode": True,
        "price": ":,.0f",
        "living_area_m2": ":,.1f",
        "zip_group": False,
    },
    labels={
        "living_area_m2": "Living area (m²)",
        "price_per_m2": "Price per m² (USD)",
        "price": "Sold price (USD)",
    },
    height=1200,
    title="Price per m² vs. Living Area for Single-Family Homes by ZIP Code",
)

fig.for_each_annotation(
    lambda a: a.update(text=a.text.split("=")[-1])
)

fig.update_xaxes(
    matches=None,
    showticklabels=True,
    showline=True,
    tickformat=",.0f",
    title_text="Living area (m²)",
)

fig.update_yaxes(
    tickformat=",.0f",
    title_text="Price per m² (USD)",
)

fig.show(renderer="notebook")Resultado:
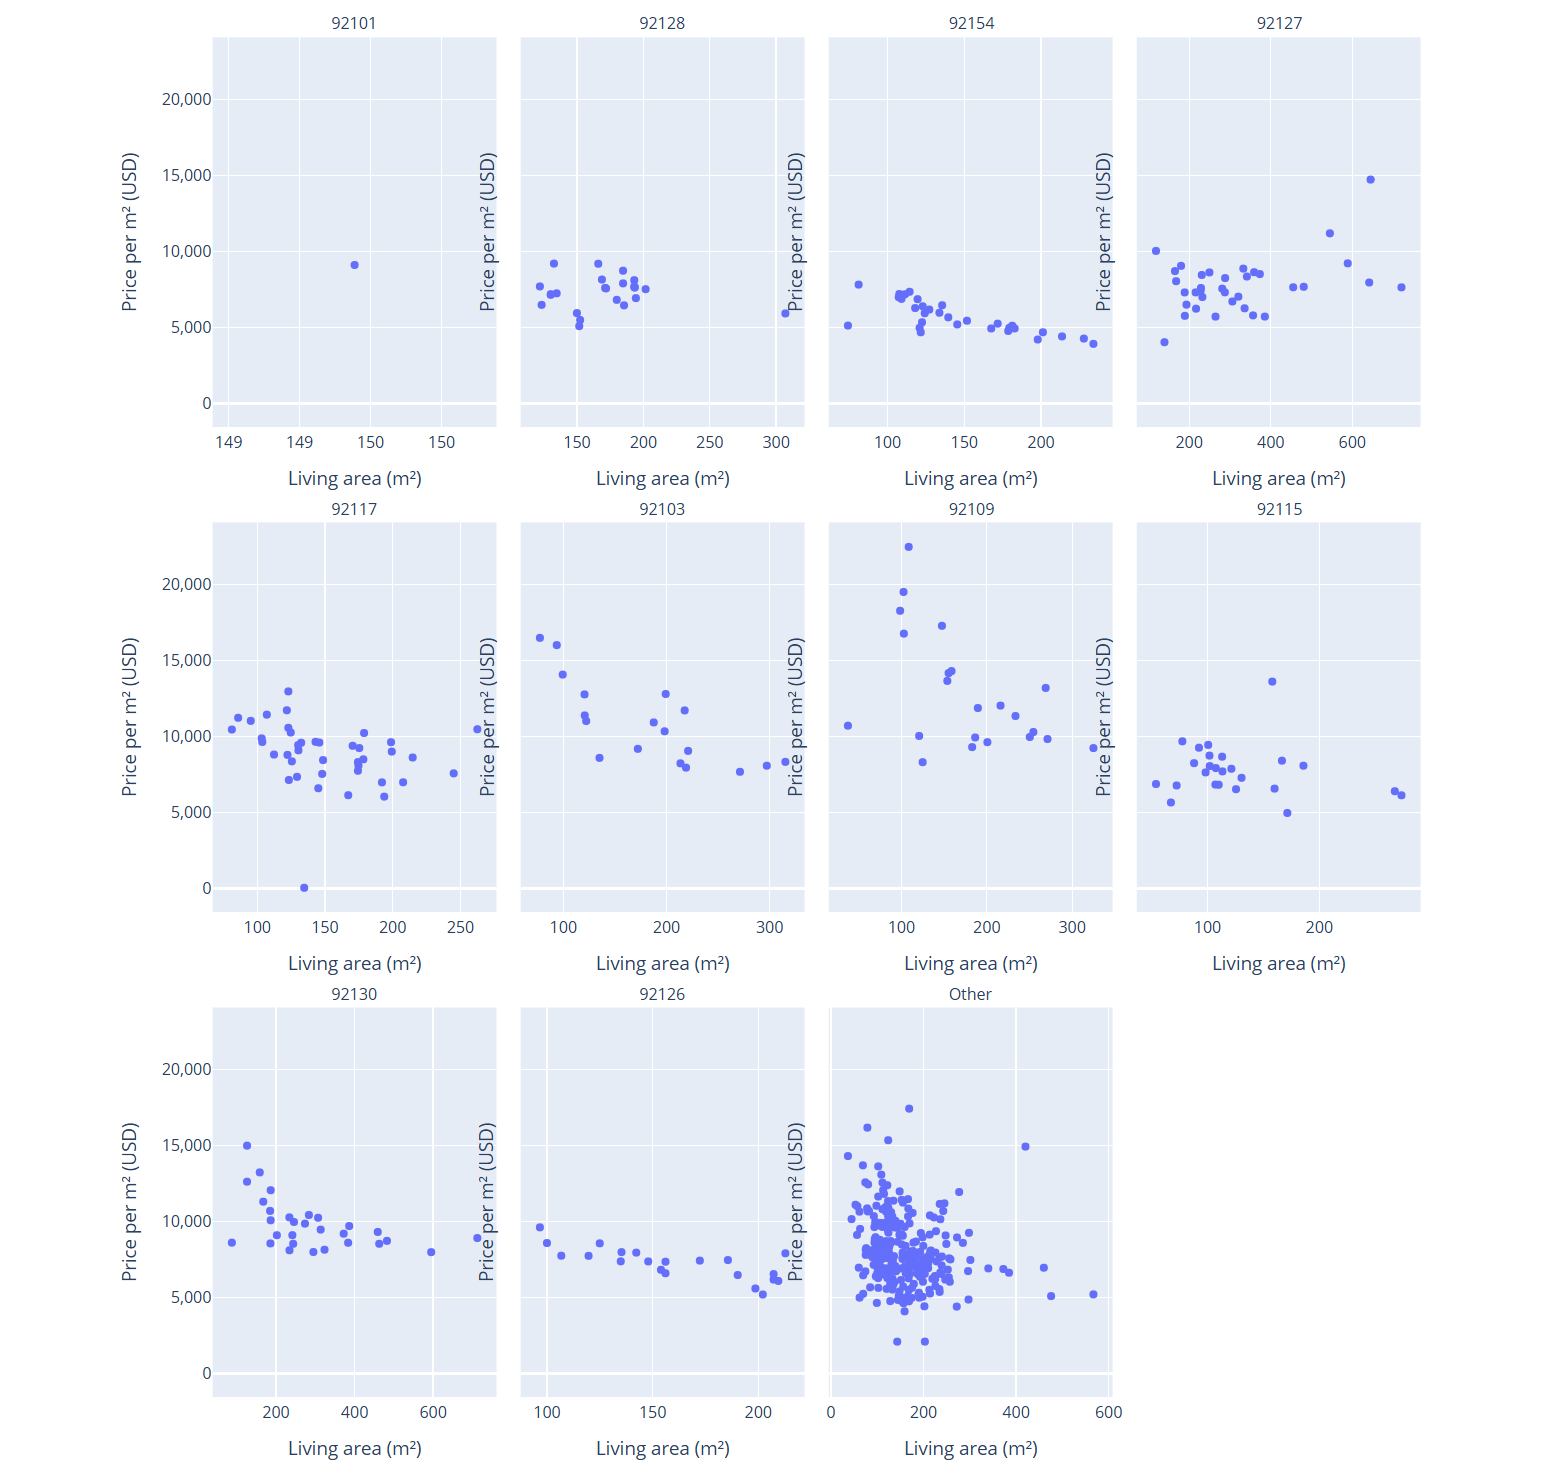
Comentário: Alguns CEPs (por exemplo, 92154, 92126, 92103) mostram casas maiores custando menos por m². 92127 é a exceção, com tendência de alta. Em geral, a correlação parece ser quase zero, então o bairro importa mais do que o tamanho.
Matriz de Correlação das Características do Imóvel
Descrição: Verifique a correlação de Pearson entre o preço e as principais características físicas e de listagem.
Célula:
corr_cols = {
    # Preço de venda em USD
    "price": "Price",
    # Número de quartos
    "bedrooms": "Bedrooms",
    # Número de banheiros
    "bathrooms": "Bathrooms",
    "living_area_m2": "Living area",
    "lot_m2": "Lot size",
    # Ano de construção
    "yearBuilt": "Year built",
    # Valor estimado pelo Zillow
    "zestimate": "Zestimate",
    # Valor avaliado para impostos
    "taxAssessedValue": "Tax assessed value",
}
# Calcula correlações de Pearson entre as colunas renomeadas
corr = df[list(corr_cols)].rename(columns=corr_cols).corr()

plt.figure(figsize=(10, 8))
sns.heatmap(corr, annot=True, fmt=".2f", cmap="coolwarm", vmin=-1, vmax=1, linewidths=0.5)
plt.title("Correlation Matrix of Sold Home Features (Pearson)")
plt.show()Resultado:
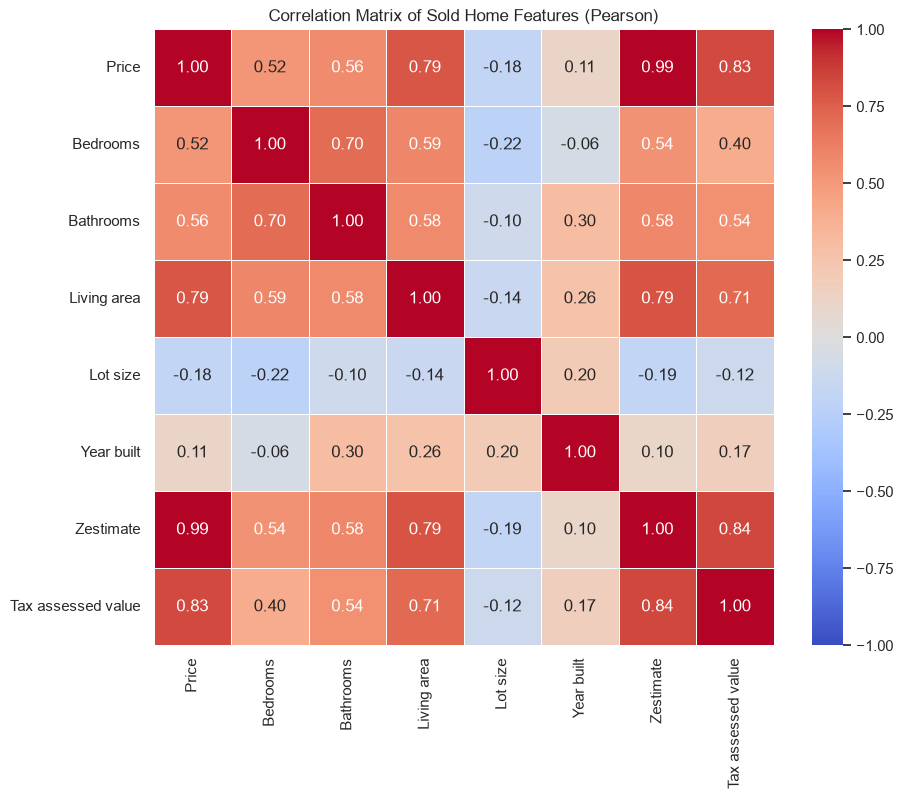
Comentário: O Zestimate (0,99) funciona quase como uma cópia do preço. Área útil (0,79), banheiros (0,56) e quartos (0,52) são os sinais de preço mais úteis, enquanto o ano de construção quase não afeta o preço (0,11).
Mix de Faixas de Preço nos CEPs Mais Ativos
Descrição: Mostre como a parcela de vendas em cada faixa de preço varia entre os 10 CEPs mais ativos.
Célula:
# Mantém as vendas dos 10 CEPs mais ativos
top_df = df[df["zipcode"].isin(top_zips)]
# Calcula a porcentagem de cada faixa de preço dentro de cada CEP
mix = pd.crosstab(top_df["zipcode"], top_df["price_band"], normalize="index") * 100

ax = mix.plot(kind="barh", stacked=True, figsize=(10, 6),
              colormap="RdYlGn_r", width=0.8)
ax.set_xlabel("Share of sales (%)")
ax.set_ylabel("ZIP code")
ax.set_title("Price Band Mix in the 10 Most Active ZIP Codes")
ax.legend(title="Price band (USD)", bbox_to_anchor=(1.02, 1), loc="upper left")
plt.tight_layout()
plt.show()Resultado:
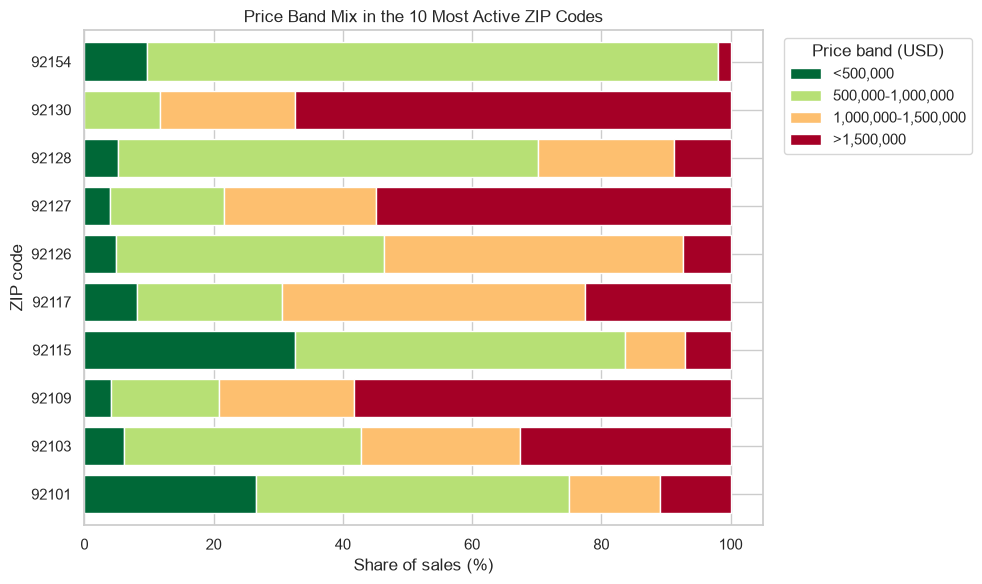
Comentário: O CEP 92154 é o mais intermediário, com cerca de 88% das vendas entre 500.000 e 1.000.000 USD. Os CEPs 92130, 92109 e 92127 estão majoritariamente acima de 1.500.000 USD. Vendas acessíveis são mais comuns em 92115, com cerca de um terço abaixo de 500.000 USD.
Dias no Zillow por Faixa de Preço
Descrição: Verifique se imóveis mais caros levam mais tempo para vender, usando os dias no Zillow por faixa de preço.
Célula:
# Mantém imóveis com dias no mercado e faixa de preço
d = df.dropna(subset=["daysOnZillow", "price_band"])
# Calcula a correlação de Spearman, que é a correlação de Pearson sobre os rankings
rho = d["price"].rank().corr(d["daysOnZillow"].rank())

plt.figure(figsize=(10, 6))
sns.boxplot(data=d, x="price_band", y="daysOnZillow", hue="price_band",
            legend=False, palette="Oranges")
plt.title(f"Days on Zillow by Price Band (Spearman ρ with price = {rho:.2f})")
plt.xlabel("Price band (USD)")
plt.ylabel("Days on Zillow")
plt.show()Resultado:
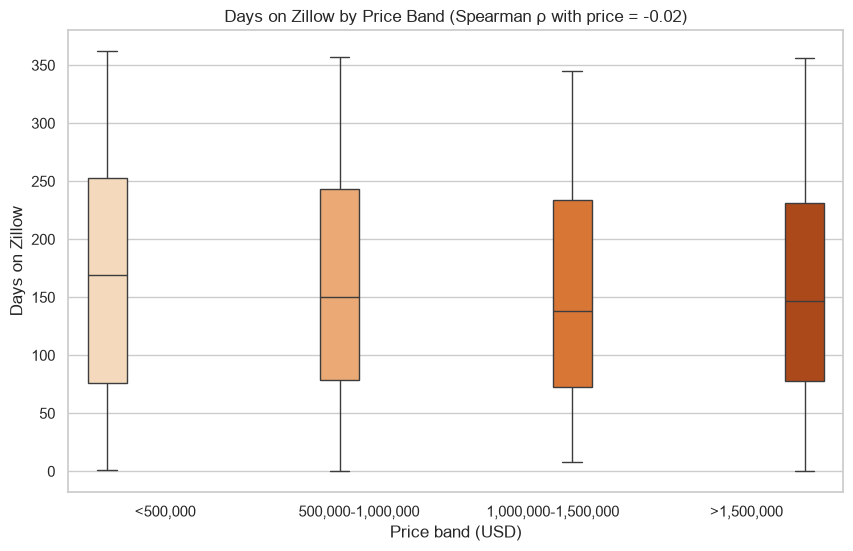
Comentário: Os dias no Zillow quase não mudam com o preço (Spearman ρ = -0,02). O tempo mediano de listagem fica entre cerca de 140 e 170 dias em todas as faixas, com uma dispersão ampla, de quase zero a mais de 350 dias. Portanto, o preço sozinho não explica a rapidez com que um imóvel é vendido.
Quão Preciso é o Zestimate?
Descrição: Meça a diferença entre cada preço de venda e o Zestimate do Zillow para ver quão precisas são as estimativas.
Célula:
# Mantém imóveis onde o erro pôde ser calculado
d = df.dropna(subset=["zestimate_error_pct"])
median_abs_error = d["zestimate_error_pct"].abs().median()

plt.figure(figsize=(10, 6))
sns.histplot(d["zestimate_error_pct"], bins=40, kde=True, color="purple")
# Marca o erro zero, onde a estimativa corresponde ao preço de venda
plt.axvline(0, color="black", linestyle="--")
# Foca em erros entre -20% e +20%
plt.xlim(-20, 20)
plt.title(f"Sold Price vs. Zestimate (median absolute error: {median_abs_error:.1f}%)")
plt.xlabel("(Sold price - Zestimate) / Zestimate (%)")
plt.ylabel("Number of homes")
plt.show()Resultado:
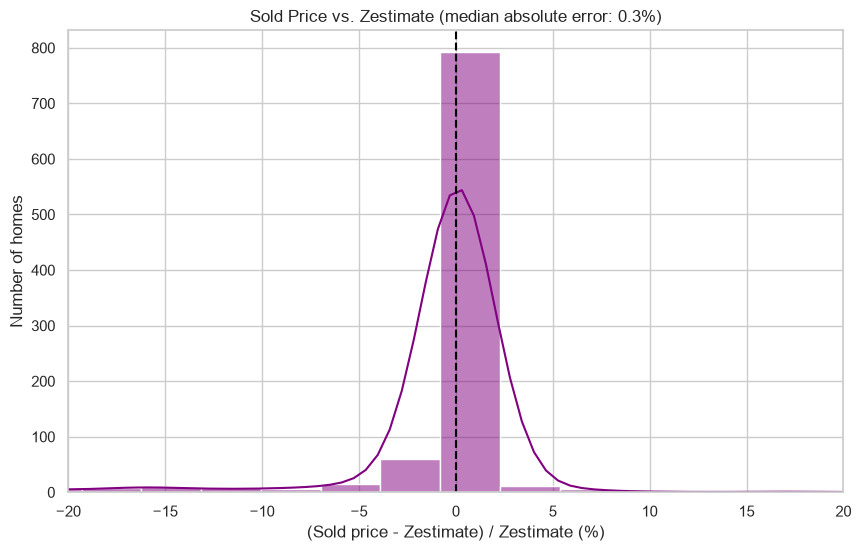
Comentário: O erro absoluto mediano é de apenas 0,3%, então o Zestimate é preciso para a maioria dos imóveis. Algumas poucas vendas ficam 20% ou mais distantes da estimativa.
Rendimento Bruto Estimado de Aluguel por CEP
Descrição: Estime o aluguel anual como parcela do preço de venda para cada CEP, para comparar os retornos de aluguel.
Célula:
# Agrupa as vendas por CEP e calcula a contagem de vendas e o rendimento mediano
yield_stats = (df.groupby("zipcode")
                 .agg(sales=("zpid", "count"), median_yield=("rent_yield_pct", "median"))
                 # Remove CEPs com poucas vendas
                 .query("sales >= @MIN_SALES")
                 # Ordena do maior para o menor rendimento
                 .sort_values("median_yield", ascending=False)
                 # Mantém apenas os 15 primeiros
                 .head(15)
                 # Transforma o índice do CEP de volta em coluna
                 .reset_index())

show_table(yield_stats,
           formats={"median_yield": "{:.1f}%"},
           title="Top 15 ZIP codes by estimated gross rental yield")

plt.figure(figsize=(10, 7))
sns.barplot(data=yield_stats, x="median_yield", y="zipcode", color="seagreen")
plt.title("Estimated Gross Rental Yield by ZIP Code (Top 15)")
plt.xlabel("Gross yield (%) = rent Zestimate × 12 / sold price")
plt.ylabel("ZIP code")
plt.show()Resultado:
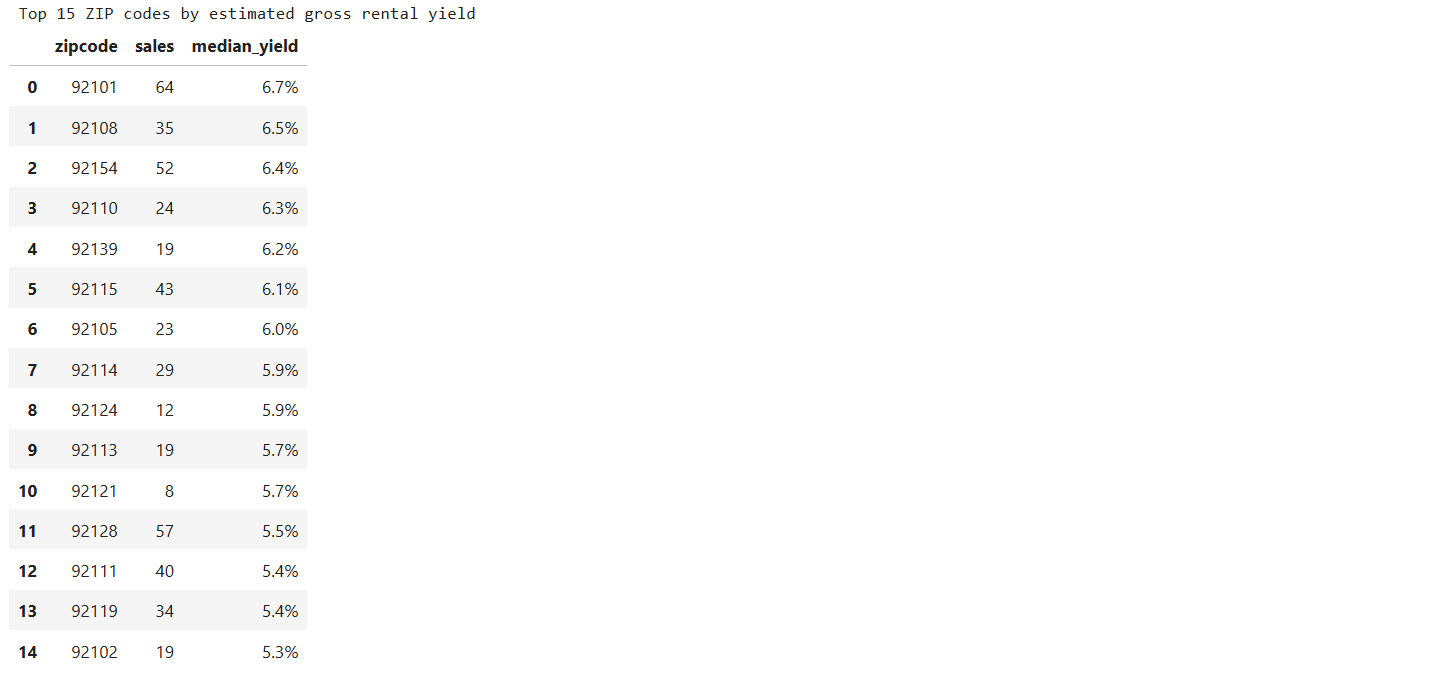
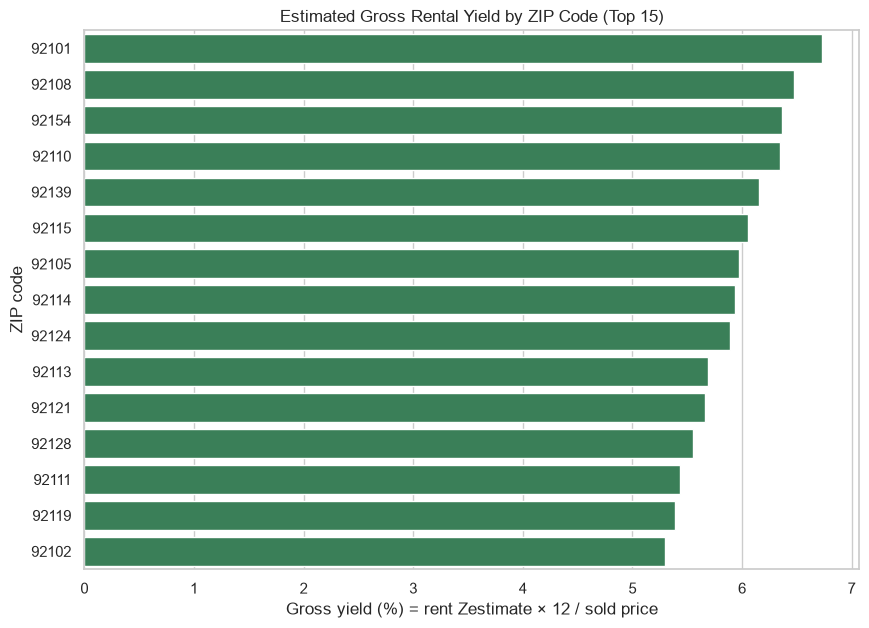
Comentário: Os 15 principais CEPs rendem entre 5,3% e 6,7% brutos, uma faixa estreita. O 92101 lidera com 6,7%, seguido pelo 92108 (6,5%) e 92154 (6,4%). Como os valores de aluguel são estimativas do Zillow, trate-os como indicativos e não como retornos exatos.
Leitura Complementar
Se você está interessado em abordagens semelhantes para análise e visualização de dados da web, usando gráficos ou IA, confira estes guias:
- Filtre um Conjunto de Dados do Crunchbase e Processe-o com IA para Prospecção de Novos Clientes
- Análise dos Produtos Mais Vendidos da Amazon
- Análise de Dados do Crunchbase para Prospecção de Clientes
Para expandir este exemplo, você poderia treinar um modelo de regressão para prever preços de venda, comparar mercados imobiliários entre duas cidades, ou analisar tendências históricas de preços de imóveis individuais.
Conclusão
Neste artigo, você aprendeu a usar o SDK Python da Bright Data para recuperar conjuntos de dados estruturados e prontos para análise, adaptados às suas necessidades. Especificamente, você viu como obter dados do Zillow sobre imóveis vendidos em San Diego, limpar e preparar os dados, e criar mais de 10 visualizações cobrindo preços de venda, localizações, tamanhos de propriedades, avaliações e rendimentos de aluguel.
O SDK Python da Bright Data fornece acesso programático aos produtos da Bright Data, incluindo seu rico marketplace de conjuntos de dados. O SDK simplifica o processo de coleta de dados, para que você possa se concentrar na análise em vez de coletar e preparar dados.
Obtenha seus resultados em CSV, JSON, JSONL ou outros formatos suportados, depois carregue-os diretamente em um Jupyter Notebook para análise e visualização, ou passe-os para ferramentas de IA para análises adicionais.
Crie uma conta Bright Data para acessar os dados públicos da web de que você precisa para seus projetos de análise de dados!