Neste guia, você verá:
- O que é uma ferramenta de scraping de dados com IA
- Fatores-chave para escolher a melhor ferramenta de scraping com IA para o seu caso de uso
- As 9 principais ferramentas de scraping de dados com IA disponíveis em 2026
- Uma tabela comparativa resumida para avaliar cada solução de forma rápida
Vamos começar!
O Que É uma Ferramenta de Scraping de Dados com IA?
Uma ferramenta de scraping de dados com IA utiliza inteligência artificial para automatizar a extração de dados de sites. Pode ser uma plataforma em nuvem que oferece APIs de scraping com IA, uma biblioteca Python ou JavaScript, ou um produto completo sem código baseado em um fluxo de trabalho visual.
A vantagem do scraping de dados com IA em relação aos scrapers tradicionais é a capacidade de se adaptar a mudanças de layout sem atualizações constantes de código, reduzindo a manutenção e melhorando a precisão. A desvantagem é que o processamento por IA adiciona latência e pode ocasionalmente produzir resultados alucinados quando a extração baseada em LLM está envolvida.
Em geral, as ferramentas modernas de scraping de dados com IA incluem recursos como:
- Prompts em linguagem natural para identificar campos de dados específicos
- Integração com provedores de LLM (OpenAI, Anthropic, Gemini e outros)
- Conectores pré-criados para sites e marketplaces populares
- Renderização de JavaScript para aplicações dinâmicas de página única
- Bypass de anti-bot e gerenciamento de Proxy para evitar bloqueios de scraping
Como Selecionamos as Principais Ferramentas de Scraping com IA
Ao avaliar as principais soluções de scraping de dados com IA, estes são os elementos-chave a considerar:
- Capacidades: O conjunto de recursos e funcionalidades que a ferramenta suporta, desde a extração simples de páginas até o rastreamento completo de sites e pipelines de dados estruturados.
- Natureza: Se a ferramenta é um produto SaaS comercial, de código aberto ou uma oferta híbrida que combina ambos.
- Linguagens de programação suportadas: As linguagens e frameworks com os quais a solução se integra e se existe uma opção sem código.
- Provedores de IA suportados: Os modelos de IA aos quais a ferramenta se conecta, ou se ela utiliza IA proprietária internamente.
- Preços: Planos e preços diretamente do site de cada ferramenta, verificados no momento da publicação.
- Estrelas no GitHub: Adoção pela comunidade em projetos de código aberto, como sinal de maturidade e crescimento.
Top 9 Ferramentas de Scraping de Dados com IA
Aqui está uma tabela comparativa resumida das 9 principais ferramentas de scraping com IA, seguida de análises detalhadas de cada uma:
| Ferramenta | Tipo | Código Aberto | Sem Código | Preço Inicial | Estrelas no GitHub |
|---|---|---|---|---|---|
| Bright Data | Infraestrutura completa | ✔️ (integrações MCP, LangChain) | ✔️ | A partir de $0,75/1k registros | N/A |
| Firecrawl | API para desenvolvedores | ✔️ | ❌ | Grátis a $599/mês | 125k+ |
| Crawl4AI | Biblioteca de código aberto | ✔️ | ❌ | Grátis | 66,7k+ |
| Browse AI | Plataforma sem código | ❌ | ✔️ | $19/mês (anual) | N/A |
| Apify | Marketplace de Actors | ✔️ (actors) | ✔️ | Grátis a $999/mês | N/A |
| ScrapeGraphAI | Código aberto + API | ✔️ | ❌ | Grátis a $425/mês | 26,3k+ |
| Diffbot | IA empresarial | ❌ | ✔️ | Grátis a $899/mês | N/A |
| Browserbase | Infraestrutura de navegador em nuvem | ✔️ (Stagehand SDK) | ❌ | Grátis a $99/mês | N/A |
| Octoparse | Desktop sem código + nuvem | ❌ | ✔️ | Grátis a $69/mês | N/A |
1. Bright Data
Bright Data é uma infraestrutura de scraping de dados criada para desempenho, escala e conformidade. Com a confiança de 50,000+ clientes, oferece um conjunto completo de ferramentas de scraping com IA respaldado por uma das maiores redes de Proxy do mundo: mais de 100 milhões de IPs em pools residenciais, de datacenter e ISP.
A infraestrutura foi projetada para fornecer dados da web em tempo real e prontos para LLM para agentes de IA, pipelines RAG, treinamento de modelos e coleta de inteligência por setor. Cada produto de scraping conta com tecnologia líder de bypass de anti-bot, para que você concentre seu tempo na aplicação em vez de gerenciar bloqueios.
As ferramentas de scraping com IA disponíveis na Bright Data incluem:
- API SERP: Resultados de mecanismos de busca em tempo real e prontos para LLM no Google, Bing e outros, otimizados para agentes de IA e sistemas RAG.
- API Unlocker: Contorna CAPTCHAs e sistemas de detecção de bots em escala, permitindo acesso contínuo a qualquer página pública da web.
- Agent Browser: Navegadores stealth serverless projetados para fluxos de trabalho de agentes com múltiplas etapas, carregamento de conteúdo dinâmico e desbloqueio integrado.
- AI Scraper Studio: Crie e implante endpoints de scraping personalizados para qualquer site com um construtor visual sem código, entregando dados estruturados sob demanda em escala.
- Dataset Marketplace: Conjuntos de dados estruturados prontos para uso e continuamente atualizados para treinamento de modelos, desenvolvimento de grafos de conhecimento e implantação imediata.
As integrações de código aberto incluem langchain-brightdata para pipelines LangChain e @brightdata/mcp para agentes de IA baseados em Model Context Protocol.
Preços:
- AI Scraper Studio: A partir de $0,75/1.000 registros (desconto promocional de 25%, preço regular $1/1k)
- API Unlocker: A partir de $1/1.000 solicitações
- Agent Browser: A partir de $5/GB
- Proxies residenciais: A partir de $2,50/GB (desconto promocional de 50%, preço regular $5/GB)
- Proxies de datacenter: A partir de $0,90/IP
- Teste grátis disponível sem necessidade de cartão de crédito
2. Firecrawl
Firecrawl é uma API de scraping de dados voltada para desenvolvedores que converte qualquer URL em Markdown limpo e pronto para LLM ou JSON estruturado. Com mais de 125.000 estrelas no GitHub, tornou-se uma das ferramentas de scraping com IA mais amplamente adotadas pela comunidade de desenvolvedores desde seu lançamento.
O Firecrawl lida automaticamente com renderização de JavaScript, desafios de CAPTCHA e conteúdo dinâmico, facilitando a integração em pipelines de IA e aplicações LLM. Sua API está disponível para Python, Node.js, Go, Rust e qualquer linguagem via REST. Para comparações com as ferramentas da Bright Data, consulte Bright Data vs. Firecrawl.
Principais capacidades incluem:
- Scrape: Converta qualquer URL para Markdown, HTML ou JSON estruturado com uma única chamada de API
- Crawl: Faça scraping recursivo de sites inteiros, seguindo links em subpáginas
- Search: Busca na web com extração instantânea de conteúdo dos resultados
- Extract: Extração de dados estruturados com LLM usando esquemas em linguagem natural
- Renderização de JavaScript: Suporte completo a navegador headless para SPAs e páginas dinâmicas
Preços:
- Grátis: 1.000 créditos/mês (1 crédito = 1 página)
- Hobby: $16/mês (cobrado anualmente): 5.000 créditos/mês
- Standard: $83/mês (cobrado anualmente): 100.000 créditos/mês
- Growth: $333/mês (cobrado anualmente): 500.000 créditos/mês
- Scale: $599/mês: 1.000.000 créditos/mês
- Enterprise: Créditos e limites de taxa personalizados
3. Crawl4AI
Crawl4AI é uma biblioteca Python de código aberto projetada especificamente para scraping de dados compatível com LLM. Com mais de 66.700 estrelas no GitHub, é um dos projetos de scraping de código aberto com crescimento mais rápido disponíveis hoje.
Diferente dos scrapers de uso geral, o Crawl4AI foi criado do zero para fluxos de trabalho de IA: gera Markdown limpo otimizado para eficiência de tokens, suporta estratégias de chunking para ingestão RAG e se integra diretamente com provedores de LLM populares por meio de seu pipeline de extração.
Principais capacidades incluem:
- Arquitetura async-first: Baseado em asyncio e Playwright para scraping concorrente de alto desempenho
- Saída Markdown otimizada para LLM: Remove navegação, anúncios e conteúdo redundante para produzir conteúdo limpo para ingestão por IA
- Estratégias de extração: Seletores CSS, XPath, extração baseada em LLM e filtragem de conteúdo por similaridade de cosseno
- Suporte a múltiplos navegadores: Chromium, Firefox e WebKit via Playwright
- Execução de JavaScript: Executa JS personalizado antes da extração, lida com conteúdo dinâmico e páginas com carregamento lazy
- Integrações com provedores de IA: OpenAI, Anthropic, Gemini, Ollama, Groq e outros via pipeline de extração
Preços: O Crawl4AI é totalmente gratuito e de código aberto sob a licença Apache 2.0. Camadas opcionais de nuvem e suporte estão disponíveis para equipes que desejam infraestrutura gerenciada ou suporte dedicado.
4. Browse AI
Browse AI é uma plataforma de scraping de dados e monitoramento sem código que permite aos usuários extrair e rastrear dados de qualquer site sem escrever uma única linha de código. É confiável para equipes de grandes empresas que automatizam fluxos de trabalho repetitivos de coleta de dados.
O modo de treinamento visual do Browse AI permite apontar e clicar para ensinar sua IA quais campos de dados extrair. Uma vez configurado, o robô é executado em um cronograma e envia os resultados diretamente para o Google Sheets, Airtable ou qualquer uma de suas mais de 7.000 integrações via Zapier, Make e webhooks.
Principais capacidades incluem:
- 250+ robôs pré-criados: Scrapers prontos para LinkedIn, Amazon, Twitter/X e outros sites populares
- Monitoramento de sites: Detecção de alterações com IA e notificações quando o conteúdo é atualizado
- 7.000+ integrações: Conexões nativas com Google Sheets, Airtable, Zapier, Make, Slack e mais
- Scraping em massa: Execute múltiplas URLs em uma única tarefa usando uma lista de URLs ou entrada CSV
- Acesso via API: Acione e recupere execuções de robôs programaticamente via API REST
Preços:
- Starter: $19/mês: 12.000 créditos/ano
- Professional: $69/mês: 60.000 créditos/ano
- Team: $500/mês: créditos e limites de equipe personalizados
- Cobrança mensal disponível a taxas ligeiramente mais altas
5. Apify
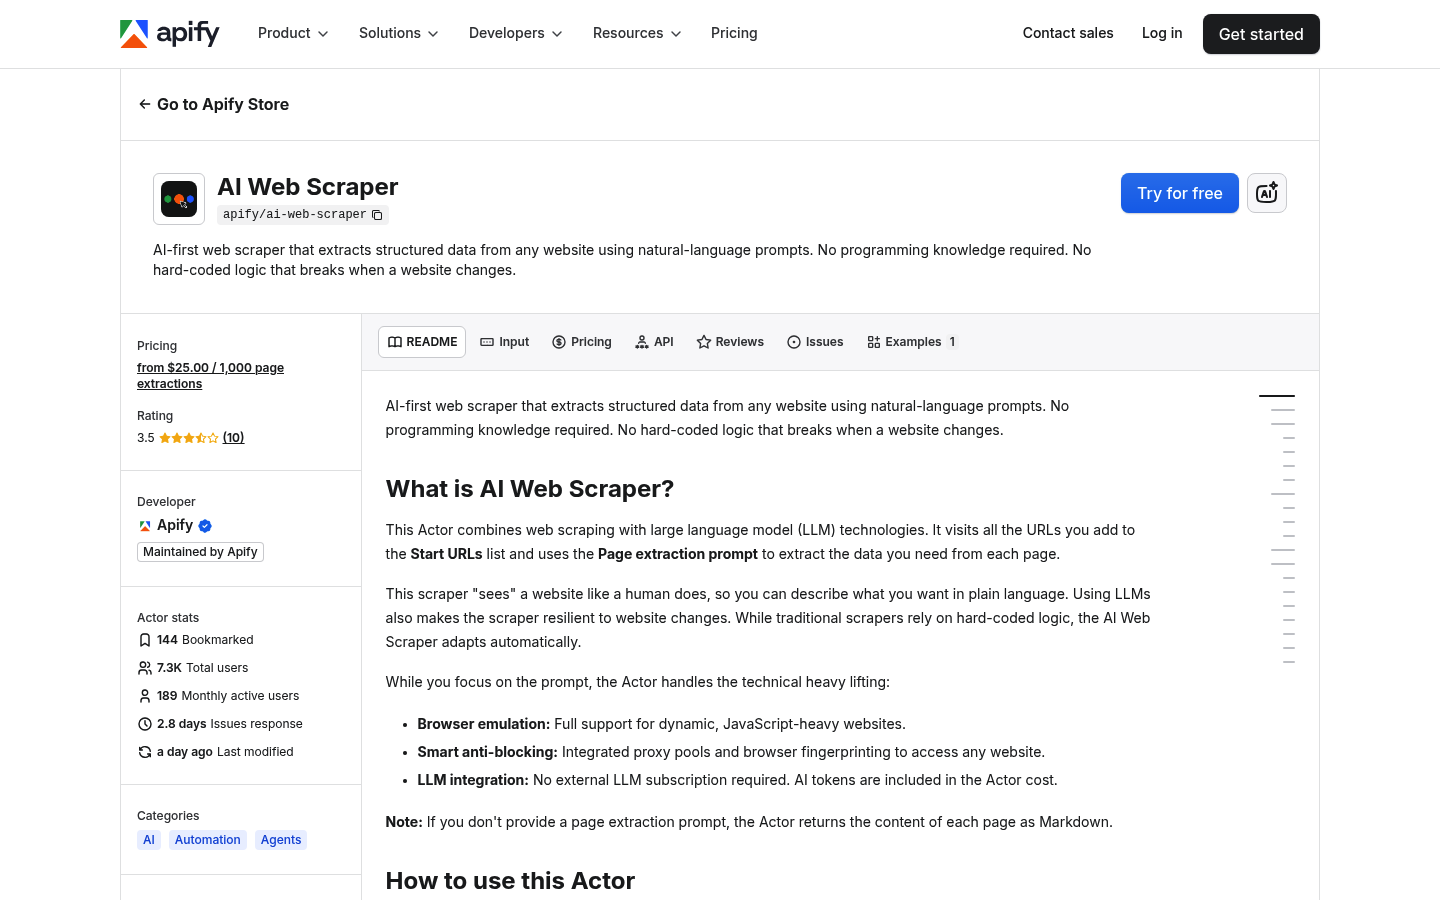
Apify é uma plataforma completa de scraping de dados e automação centrada em um marketplace com mais de 33.000 “Actors” reutilizáveis (programas serverless executados na nuvem) que podem ser agendados, acionados via API ou encadeados em pipelines.
Seu principal recurso de IA é o AI Web Scraper Actor, que aceita um prompt em linguagem natural (por exemplo, “extraia nomes de produtos e preços desta página”) e retorna JSON estruturado sem exigir código ou seletores CSS. Isso torna o Apify acessível a usuários não técnicos, mantendo-se altamente extensível para desenvolvedores que criam Actors personalizados em JavaScript ou Python.
Principais capacidades incluem:
- 33.000+ Actors: Scrapers pré-criados para todas as principais plataformas, de redes sociais a e-commerce e imóveis
- AI Web Scraper: Extração orientada por linguagem natural sem necessidade de código
- Agendador e webhooks: Execute Actors em um cronograma cron ou acione-os programaticamente
- Armazenamento de conjuntos de dados: Armazenamentos de chave-valor e conjuntos de dados integrados para persistir e exportar resultados
- Gerenciamento de Proxy: Rotação integrada de Proxy residencial e de datacenter em todas as execuções
Preços:
- Grátis: $0: $5 em créditos de plataforma, $0,20/unidade de computação
- Starter: $29/mês: $29 em créditos de plataforma, $0,20/unidade de computação
- Scale: $199/mês: $199 em créditos de plataforma, $0,16/unidade de computação (taxa com desconto)
- Business: $999/mês: $999 em créditos de plataforma
6. ScrapeGraphAI
ScrapeGraphAI é uma biblioteca de scraping de dados nativa de IA e API em nuvem que usa LLMs para extrair dados estruturados de qualquer página web usando um prompt em linguagem natural. A biblioteca de código aberto acumulou mais de 26.300 estrelas no GitHub e a API comercial possui certificação SOC 2 Tipo II.
Um dos recursos distintivos do ScrapeGraphAI é sua flexibilidade de provedores de LLM: suporta OpenAI, Anthropic, Google Gemini, Azure, Groq, Ollama (modelos locais) e vários outros. Isso o torna prático para equipes com preferências específicas de modelo ou requisitos on-premise.
Principais capacidades incluem:
- Scrape: Converta qualquer URL em Markdown limpo, HTML ou capturas de tela com modo stealth opcional
- Extract: Extração de dados estruturados com LLM de páginas web usando esquemas em linguagem natural
- Search: Busca na web com extração de conteúdo integrada em uma única chamada
- Crawl: Rastreamento completo de sites com extração por página em profundidade configurável
- Monitor: Rastreie páginas web para detectar alterações e receba notificações via webhook
- Múltiplos provedores de IA: OpenAI, Anthropic, Gemini, Azure, Groq, Ollama e outros
Preços:
- Grátis: $0: 500 créditos/mês
- Starter: $17/mês: 10.000 créditos/mês
- Growth: $85/mês: 100.000 créditos/mês
- Pro: $425/mês: 750.000 créditos/mês
- Enterprise: Créditos personalizados e suporte dedicado
7. Diffbot
Diffbot é uma plataforma de extração com IA de nível empresarial que identifica automaticamente o tipo de qualquer página web (artigo, produto, pessoa, organização, avaliação, evento) e retorna JSON totalmente estruturado, sem nenhuma configuração de template. Fundada em 2012, é uma das empresas de dados da web com IA mais estabelecidas do mercado.
Além da extração em nível de página, o Diffbot opera um Knowledge Graph contendo mais de 31 bilhões de entidades do mundo real, tornando-o adequado para casos de uso que envolvem resolução de entidades, mapeamento de relacionamentos e construção de bases de conhecimento em larga escala.
Principais capacidades incluem:
- Detecção automática de tipo: Identifica artigos, produtos, pessoas, eventos e outros tipos de página sem configuração
- Knowledge Graph: Mais de 31 bilhões de entidades com dados de relacionamento para resolução de entidades e consultas semânticas
- API de Crawl: Rastreie domínios inteiros e aplique regras de extração em todas as páginas descobertas
- API de Linguagem Natural: Extração de fatos e relacionamentos de textos com NLP
- Sem necessidade de código: API REST sem configuração de seletores para tipos de página suportados
Preços:
- Grátis: $0: 10.000 créditos/mês (1 crédito = 1 extração de página)
- Startup: $299/mês: 250.000 créditos/mês ($0,001 por crédito)
- Scale: $899/mês: 1.000.000 créditos/mês ($0,0009 por crédito)
- Enterprise: Alocação de créditos e preços personalizados
8. Browserbase
Browserbase é uma infraestrutura de navegador headless hospedada na nuvem projetada para agentes de IA e fluxos de trabalho automatizados. Em vez de uma API de scraping no sentido tradicional, fornece navegadores remotos escaláveis que seu agente ou script controla via Playwright, Puppeteer ou Selenium, com modo stealth e rotação de Proxy integrados na camada de infraestrutura.
O Browserbase é particularmente útil para desenvolvedores de agentes de IA que precisam de sessões de navegador confiáveis e observáveis em escala. Suas ferramentas de replay de sessão e depuração oferecem visibilidade total sobre o que cada sessão de navegador realizou, o que é essencial para diagnosticar falhas em fluxos de trabalho complexos de múltiplas etapas.
Principais capacidades incluem:
- Navegadores stealth: Navegadores em nuvem com gerenciamento integrado de fingerprint e evasão de detecção de bots
- Compatível com Playwright/Puppeteer/Selenium: Substituto direto para navegadores headless locais, sem alterações de código necessárias
- Replay de sessão: Replay visual completo de cada sessão de navegador para depuração e auditoria
- Proxies integrados: Rotação de Proxy residencial com cobrança por GB, incluída em todos os planos pagos
- Stagehand SDK: Framework de agente de IA de código aberto construído sobre o Browserbase para automação de navegador em linguagem natural
Preços:
- Grátis: $0: sessões limitadas para prototipagem
- Developer: $20/mês: depois $0,12/hora de navegador
- Production: $99/mês: depois $0,10/hora de navegador, 5 GB de Proxy incluídos
- Enterprise: Preços personalizados com infraestrutura dedicada
9. Octoparse
Octoparse é uma plataforma de scraping de dados sem código consolidada, disponível como aplicativo desktop para Windows/Mac e como serviço em nuvem. Está no mercado desde 2014 e é amplamente utilizado por analistas de negócios, pesquisadores de mercado e equipes de operações que precisam de dados estruturados sem escrever código.
O Octoparse usa IA para detectar automaticamente campos de dados e padrões de paginação quando você carrega uma página em seu scraper visual, reduzindo significativamente o tempo de configuração em comparação à configuração manual de seletores. Sua biblioteca de mais de 250 templates cobre muitos sites e tipos de dados populares prontos para uso.
Principais capacidades incluem:
- Scraper visual de apontar e clicar: Sem seletores CSS ou XPath: clique nos dados que deseja na página ao vivo
- 250+ templates: Scrapers pré-criados para Amazon, LinkedIn, Tripadvisor e outros grandes sites
- Detecção automática de paginação: A IA identifica e lida automaticamente com conjuntos de dados de múltiplas páginas
- Extração em nuvem: Execute tarefas nos servidores em nuvem do Octoparse 24/7, exporte para Excel, CSV, JSON ou bancos de dados
- Rotação de IP: Rotação integrada de Proxy para reduzir bloqueios durante execuções em larga escala
- Execuções agendadas: Configure scrapers para executar em um cronograma fixo sem intervenção manual
Preços:
- Grátis: $0: 10 tarefas de scraping, 50.000 linhas/mês exportadas, execução local
- Standard: A partir de $69/mês: 100 tarefas, extração em nuvem, 3 execuções simultâneas em nuvem
- Enterprise: A partir de $399: limites de tarefas personalizados, recursos de nuvem dedicados, suporte prioritário
- Garantia de reembolso de 5 dias em todos os planos pagos
Conclusão
O cenário de scraping de dados com IA em 2026 se diversificou significativamente, com opções sólidas em todos os níveis: desde bibliotecas Python de código aberto como Crawl4AI e ScrapeGraphAI até plataformas empresariais completas como Bright Data e Diffbot, e ferramentas sem código como Browse AI e Octoparse para usuários não técnicos.
A ferramenta certa depende das suas prioridades. Se você precisa de escala máxima, confiabilidade e acesso à infraestrutura de Proxy mais ampla, o conjunto da Bright Data — cobrindo a API Unlocker, Agent Browser e Web Scraper API — é a opção mais completa disponível. Para pipelines LLM voltados a desenvolvedores, Firecrawl e Crawl4AI oferecem a melhor experiência de integração com frameworks modernos de IA. Para equipes que precisam de um marketplace de actors pronto para uso, os mais de 33.000 scrapers pré-criados do Apify reduzem significativamente o tempo até os dados.
Independentemente da ferramenta escolhida, certifique-se de que ela lida com rotação de Proxy e bypass de anti-bot de forma nativa: eles não são mais opcionais para nenhum fluxo de trabalho de scraping em produção.