


Conjuntos de Dados Rakuten
Use nosso conjunto de dados Rakuten para acessar informações detalhadas sobre o catálogo de produtos do marketplace em suas lojas japonesa, taiwanesa e francesa, incluindo títulos de produtos, descrições, nomes de marcas, categorias de produtos, árvores completas de categorias, identificadores de itens e variantes, e URLs diretas dos produtos.


Conjuntos de Dados Rakuten Disponíveis

Aprovado por 50,000+ clientes em todo o mundo.


Precisa de dados do Rakuten em tempo real? Use nossa API Scraper do Rakuten
Preços dos Conjuntos de Dados do Rakuten
- Limpos e validados
- Atualizados mensalmente
- JSON/CSV/Parquet
Filtre o conjunto de dados do Rakuten com um único prompt
Descreva exatamente o que você precisa e deixe a IA aplicar os filtros perfeitos em segundos.
- Descreva as necessidades de dados em linguagem simples
- A IA aplica filtros precisos automaticamente
- Reduza grandes conjuntos de dados apenas ao que importa para você
- Reduza custos evitando dados irrelevantes
- Exporte dados filtrados no formato de sua preferência

Maximize o valor com economias estratégicas de custo

Atualizações inteligentes de dados
Acesse apenas "Novos Registros" ou "Registros Atualizados", garantindo que você pague apenas pelo que precisa".

Pacotes de conjuntos de dados
Obtenha mais valor comprando dois ou mais conjuntos de dados juntos, com descontos exclusivos.

Descontos por volume
Obtenha mais por menos com economias significativas na compra de grandes conjuntos de dados ou assinaturas de atualizações.

Conjuntos de Dados Enriquecidos
Economize tempo e recursos com conjuntos de dados pré-criados que combinam múltiplas fontes em um único conjunto de dados limpo.
Amostra do conjunto de dados Rakuten
Este conjunto de dados inclui URLs de produtos, identificadores de itens, IDs de variantes, títulos de produtos, descrições detalhadas, informações de marca, categorias de produtos e árvores de categorias para o catálogo da Rakuten. Cada registro fornece metadados abrangentes do produto, permitindo análise de mercado, benchmarking competitivo e pesquisa de catálogo. Os campos de dados incluem detalhes em nível de variante e informações hierárquicas de categoria para classificação detalhada de produtos e análise da estrutura de navegação.
Potencialize Agentes de IA Instantaneamente
Nossos conjuntos de dados Rakuten são otimizados para IA/LLM: claramente estruturados, bem documentados, com código e receitas para fácil integração com LLM/chatbot.

Estruturado e Limpo
Dados pré-processados com esquemas consistentes, perfeitos para treinamento e inferência de modelos de IA.

Exemplos de Código
Trechos prontos para uso em Python, Node.js, cURL, PHP, Go, Java e Ruby para fácil integração com fluxos de trabalho de IA.

Documentação
                              curl --request GET
--url https://api.brightdata.com/datasets/snapshots/{id}/download
--header 'Authorization: Bearer '
                              import requests
url = "https://api.brightdata.com/datasets/snapshots/{id}/download"
headers = {"Authorization": "Bearer "}
response = requests.get(url, headers=headers)
print(response.json())
                              const url = 'https://api.brightdata.com/datasets/snapshots/{id}/download';
const options = {method: 'GET', headers: {Authorization: 'Bearer '}, body: undefined};

try {
const response = await fetch(url, options);
const data = await response.json();
console.log(data);
} catch (error) {
console.error(error);
}
                              HttpResponse response = Unirest.get("https://api.brightdata.com/datasets/snapshots/{id}/download")
.header("Authorization", "Bearer ")
.asString();
                              require 'uri'
require 'net/http'

url = URI("https://api.brightdata.com/datasets/snapshots/{id}/download")

http = Net::HTTP.new(url.host, url.port)
http.use_ssl = true

request = Net::HTTP::Get.new(url)
request["Authorization"] = 'Bearer '

response = http.request(request)
puts response.read_body
Conjuntos de dados Rakuten adaptados às suas necessidades

Assinatura de dados
Assine para acessar conjuntos de dados a um custo significativamente reduzido.

Formatos de saída de arquivos
JSON, NDJSON, linhas JSON, CSV, Parquet. Compactação .gz opcional.

Entrega flexível
Snowflake, bucket do Amazon S3, Google Cloud, Azure e SFTP.

Dados escalonáveis
Dimensione sem se preocupar com infraestrutura, servidores proxy ou bloqueios.

Economia de custos
Personalize qualquer conjunto de dados usando filtros e opções de formatação.

Manutenção do código
Os conjuntos de dados são mantidos com base nas alterações da estrutura do site.

Integrações simplificadas
Beneficie-se das integrações com Snowflake e AWS.

Suporte 24 horas por dia, 7 dias por semana
Uma equipe dedicada de profissionais de dados está aqui para ajudar.

Líderes em conformidade
Os dados são obtidos de forma ética e estão em conformidade com todas as leis de privacidade.
Obtenha dados Rakuten estruturados e confiáveis
Nós fornecemos os dados enquanto você foca no resto
Dados da web de alto volume
Com nossos recursos de desbloqueio e rotação de IP 24 horas por dia, garantimos acesso a todos os pontos de dados de um site.
Dados para uso imediato
Cada aspecto do processo de coleta de dados é minuciosamente validado como parte do nosso robusto processo de validação de dados.
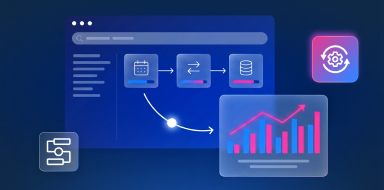
Fluxo de dados automatizado
Crie cronogramas personalizados para automatizar a entrega de dados e veja o fluxo de dados integrar-se perfeitamente ao seu armazenamento.
Casos de uso do conjunto de dados Rakuten
Monitoramento de preços no marketplace
Análise de vendedores e lojas
Insights de demanda de produtos
Sentimento do consumidor


Perguntas Frequentes sobre o Conjunto de Dados Rakuten
Com que frequência o conjunto de dados Rakuten é atualizado?
O conjunto de dados Rakuten está disponível com cronogramas de atualização flexíveis: único, semestral, trimestral, mensal, semanal ou diário - com descontos maiores para assinaturas de maior frequência (até 80% de desconto em planos mensais). Você também pode escolher entre dados pré-coletados (disponíveis instantaneamente, coletados nos últimos dias a meses) ou dados coletados recentemente obtidos sob demanda no momento do seu pedido. A janela de atualização pode ser definida antes do checkout.
Posso comprar um subconjunto do conjunto de dados Rakuten?
Sim. Você pode filtrar o conjunto de dados Rakuten para incluir apenas os registros e campos de dados que você precisa - por geografia, período, categoria ou qualquer campo suportado - usando a ferramenta de filtro com IA da Bright Data ou a Filter Dataset API. Você paga apenas pelos registros no seu snapshot filtrado, o que pode reduzir substancialmente o custo. Os filtros suportam operadores como igual a, inclui, maior que, é nulo e mais, com até 3 níveis de lógica aninhada.
Quais formatos e opções de entrega estão disponíveis para o conjunto de dados Rakuten?
O conjunto de dados Rakuten é entregue no formato de sua escolha: JSON, NDJSON, JSON Lines, CSV, XLSX ou Parquet, com compressão .gz opcional. Os destinos de entrega incluem: Amazon S3, Google Cloud Storage, Microsoft Azure Blob, Snowflake, Google PubSub, SFTP, Webhook ou E-mail. Você também pode baixar diretamente pelo Painel de Controle (até 5 GB) ou obter programaticamente via Snapshot Download API. Para snapshots maiores que 5 GB, os links de download são enviados por e-mail.
Posso obter uma amostra gratuita do conjunto de dados Rakuten antes de comprar?
Sim. Todo conjunto de dados no Bright Data Marketplace - incluindo o conjunto de dados Rakuten - oferece uma amostra de dados para download sem custo. Você pode visualizar o esquema de dados, as definições de campo e um conjunto representativo de registros para avaliar qualidade, cobertura e relevância antes de se comprometer com a compra. As amostras estão disponíveis diretamente na página do conjunto de dados no Bright Data Marketplace.
Posso solicitar campos de dados específicos ou uma versão personalizada do conjunto de dados Rakuten?
Sim. Você pode personalizar o conjunto de dados Rakuten para incluir apenas os campos específicos que você precisa, ocultando colunas irrelevantes para reduzir custos e simplificar a integração. Para necessidades mais avançadas - como um esquema de dados proprietário, campos enriquecidos ou uma fonte que não está atualmente no marketplace - a equipe da Bright Data pode criar um conjunto de dados personalizado adaptado aos seus requisitos. Entre em contato com a equipe de vendas para discutir seu caso de uso.
Como o conjunto de dados Rakuten se integra aos meus sistemas e fluxos de trabalho existentes?
O conjunto de dados Rakuten foi construído para integração perfeita. Você pode extrair dados programaticamente usando a Marketplace Dataset API (com SDKs disponíveis para Python e JavaScript), enviar resultados diretamente para seu data warehouse ou armazenamento em nuvem, ou conectar via integrações nativas com ferramentas como Snowflake, AWS, Google Cloud, Databricks e plataformas de automação como Zapier, Make.com e n8n. O fluxo de trabalho assíncrono (acionar - consultar - baixar) facilita a incorporação em qualquer pipeline.
O conjunto de dados Rakuten é obtido de forma ética e em conformidade legal?
Sim. Todos os conjuntos de dados da Bright Data - incluindo Rakuten - são coletados exclusivamente de fontes online publicamente disponíveis em conformidade com as leis e regulamentos aplicáveis, incluindo GDPR, CCPA, e o próprio Código de Ética da Bright Data. A Bright Data possui certificação ISO 27001 e está em conformidade com SOC 2. Os dados passam por rigoroso controle de qualidade antes da entrega. Você pode revisar a postura completa de conformidade da Bright Data no Trust Center.
Quanto custa o conjunto de dados Rakuten, e há descontos por volume?
Os preços do conjunto de dados Rakuten começam em US$ 250 para 100 mil registros (aproximadamente US$ 0,0025 por registro) para uma compra única. Os planos de assinatura desbloqueiam economias significativas: até 25% de desconto semestral, 50% de desconto trimestral e 80% de desconto em planos de atualização mensal. Faixas de volume estão disponíveis para 100 mil, 500 mil, 1 milhão, 5 milhões e mais de 20 milhões de registros. Pacotes de conjuntos de dados (comprando dois ou mais conjuntos juntos) e opções de atualização inteligente (pagando apenas por registros novos ou alterados) proporcionam economias adicionais. Para preços em escala empresarial, entre em contato com a equipe de vendas da Bright Data.
O que é um snapshot, e como funciona o processo de entrega do conjunto de dados Rakuten?
Quando você solicita o conjunto de dados Rakuten - ou o filtra via API - a Bright Data gera um snapshot: uma exportação pontual dos registros selecionados. O fluxo de trabalho assíncrono funciona da seguinte forma: (1) seu pedido ou chamada de API aciona o trabalho de coleta; (2) você pode consultar o status do trabalho usando o ID do snapshot; (3) uma vez concluído, você baixa o snapshot via API ou seu destino de entrega configurado. Os metadados do snapshot (incluindo códigos de erro e tipo de iniciação) são acessíveis via Snapshot Metadata API.
Posso usar o conjunto de dados Rakuten para projetos de IA e aprendizado de máquina?
Sim. O conjunto de dados Rakuten é estruturado e validado para uso imediato em fluxos de trabalho de IA e ML, incluindo ajuste fino de LLM, treinamento de modelos, pipelines RAG e bases de conhecimento de agentes. Os dados são entregues em formatos padrão prontos para ML (JSON, Parquet, NDJSON) com esquemas consistentes e definições de campo documentadas, acessíveis via Dataset Metadata API. A Bright Data também oferece pacotes especializados de dados para IA e um arquivo web com mais de 50 PB de dados históricos para pré-treinamento em larga escala.
Quais campos um registro do Rakuten inclui?
Um registro no conjunto de dados Rakuten corresponde a uma única entidade — por exemplo, um perfil de pessoa, uma listagem de produto, uma postagem ou uma empresa — dependendo do tipo de conjunto de dados. Cada registro contém todos os campos de dados coletados para aquela entidade em uma única linha ou objeto JSON. Os campos exatos variam conforme o conjunto de dados: por exemplo, um registro de perfil do LinkedIn inclui campos como nome, cargo atual, empresa, localização, histórico de experiência, formação, habilidades e número de conexões (42 campos no total), enquanto um registro de produto da Amazon inclui título, marca, ASIN, preço, disponibilidade, avaliações, número de avaliações e detalhes do vendedor. Você pode visualizar a lista completa de campos - junto com descrições e tipos de dados - na aba Dicionário de Dados nesta página, ou baixar uma amostra gratuita para inspecionar um conjunto representativo de registros reais antes de comprar. Se você precisar apenas de um subconjunto de campos, pode ocultar colunas irrelevantes no checkout para reduzir custos e simplificar a integração.
Quantos registros do Rakuten eu preciso?
O número de registros que você precisa depende do seu caso de uso. Como regra geral, um registro equivale a uma entidade (uma pessoa, um produto, uma postagem, uma empresa, etc.). Aqui estão pontos de referência comuns para ajudá-lo a estimar:
- Prova de conceito / MVP: 100 mil registros (US$ 250 compra única) geralmente é suficiente para validar um modelo, testar um pipeline ou construir um conjunto de dados inicial.
- Análise em média escala: de 500 mil a 1 milhão de registros cobre a maioria dos projetos de pesquisa de mercado, inteligência competitiva ou dados de treinamento.
- Pipelines de produção: de 5 milhões a mais de 20 milhões de registros são adequados para treinamento de IA em larga escala, enriquecimento empresarial ou cobertura total de mercado.
Se você não tiver certeza, baixe a amostra gratuita desta página para entender a densidade de registros e a cobertura de campos, então use a ferramenta de filtro com IA para delimitar seu conjunto de dados por geografia, categoria, período ou outros critérios. Você verá uma contagem estimada de registros antes de se comprometer com a compra. Para casos de uso complexos ou grandes volumes, entre em contato com a equipe de vendas para obter uma recomendação delimitada.