Arquitetura de pipeline de dados é o design do sistema que move dados de fontes para pessoas, modelos e agentes. Ela define como os dados são coletados, armazenados, verificados, transformados e servidos.
Quando sites públicos são uma fonte, um pipeline pode registrar um sucesso enquanto um varejista exibe uma página de seleção de país em vez de preços. De uma única conexão doméstica, cada um dos 4 clientes de código aberto buscou 13 páginas de busca e listagem 3 vezes. Das 88 respostas de sucesso, 39 não tinham dados utilizáveis.
Este guia mostra como projetar cada etapa, escolher um padrão, detectar essas falhas e decidir o que construir ou comprar.
TL;DR
- Verifique os dados que você espera, não páginas de bloqueio. Um detector de páginas de bloqueio sinalizou apenas 8 das 39 respostas de sucesso que não tinham dados.
- Modele cada campo em sua própria granularidade. A Amazon compartilha um total de avaliações entre as variantes de uma listagem, então somar linhas superestimou a contagem de avaliações de 20 produtos em 23%.
- Em alto volume, deixe uma LLM escrever o parser, não ler cada página. O conteúdo principal de uma página da Amazon usou 19 vezes mais tokens do que seu registro de 12 campos.
- Compare coletores pelo custo por registro aceito. No teste de busca, 39 de 88 respostas de sucesso não tinham dados, então conte apenas linhas que passam no seu contrato de dados.
Diagrama e etapas da arquitetura de pipeline de dados
Uma arquitetura de pipeline de dados típica tem 5 etapas. Cada etapa faz um trabalho, e a próxima etapa pode verificar sua saída:
- Coletar. Extrair dados de cada fonte, usando captura de dados de alteração para bancos de dados, chamadas de API para ferramentas SaaS, e solicitações HTTP ou de navegador para sites.
- Armazenar bruto. Gravar os dados no armazenamento de objetos exatamente como chegaram, antes de qualquer análise. Em uma arquitetura medallion, esses dados brutos formam a camada bronze.
- Validar. Verificar cada registro contra um contrato de dados que lista campos obrigatórios, tipos e intervalos. Enviar registros que falham para quarentena, com um código de motivo.
- Transformar. Deduplicar, unir e modelar os dados em um warehouse ou lakehouse. As tabelas silver contêm linhas validadas, e as tabelas gold estão prontas para uso.
- Servir. Entregar o resultado a dashboards, aplicativos, modelos e agentes de IA.
Um orquestrador como Airflow, Dagster ou Prefect programa as etapas. O monitoramento rastreia atualidade, volume, taxas de preenchimento de campos e custo por registro aceito em todas elas.
Pipelining de dados é o termo geral para construir e executar pipelines, e “data pipes” é um nome informal para os próprios pipelines. ETL (extrair, transformar, carregar) é um padrão dentro dele, e ELT é outro, que carrega dados brutos primeiro e os transforma no warehouse.
Uma arquitetura de pipeline de big data usa as mesmas 5 etapas em um volume onde armazenamento e computação devem escalar separadamente. Então ela geralmente mantém os dados em armazenamento de objetos e formatos de tabela abertos.
Dados públicos da web adicionam uma etapa de descoberta que encontra as URLs que valem a pena coletar, e a API SERP pode executá-la a partir de resultados de busca. Para coleta, a Web Scraper API da Bright Data retorna registros estruturados de sites públicos. O Web Unlocker lida com defesas anti-bot e retorna a página bruta para equipes que escrevem seus próprios parsers.
Este diagrama de arquitetura de pipeline de dados mostra como as etapas se conectam quando sites públicos são uma das fontes:
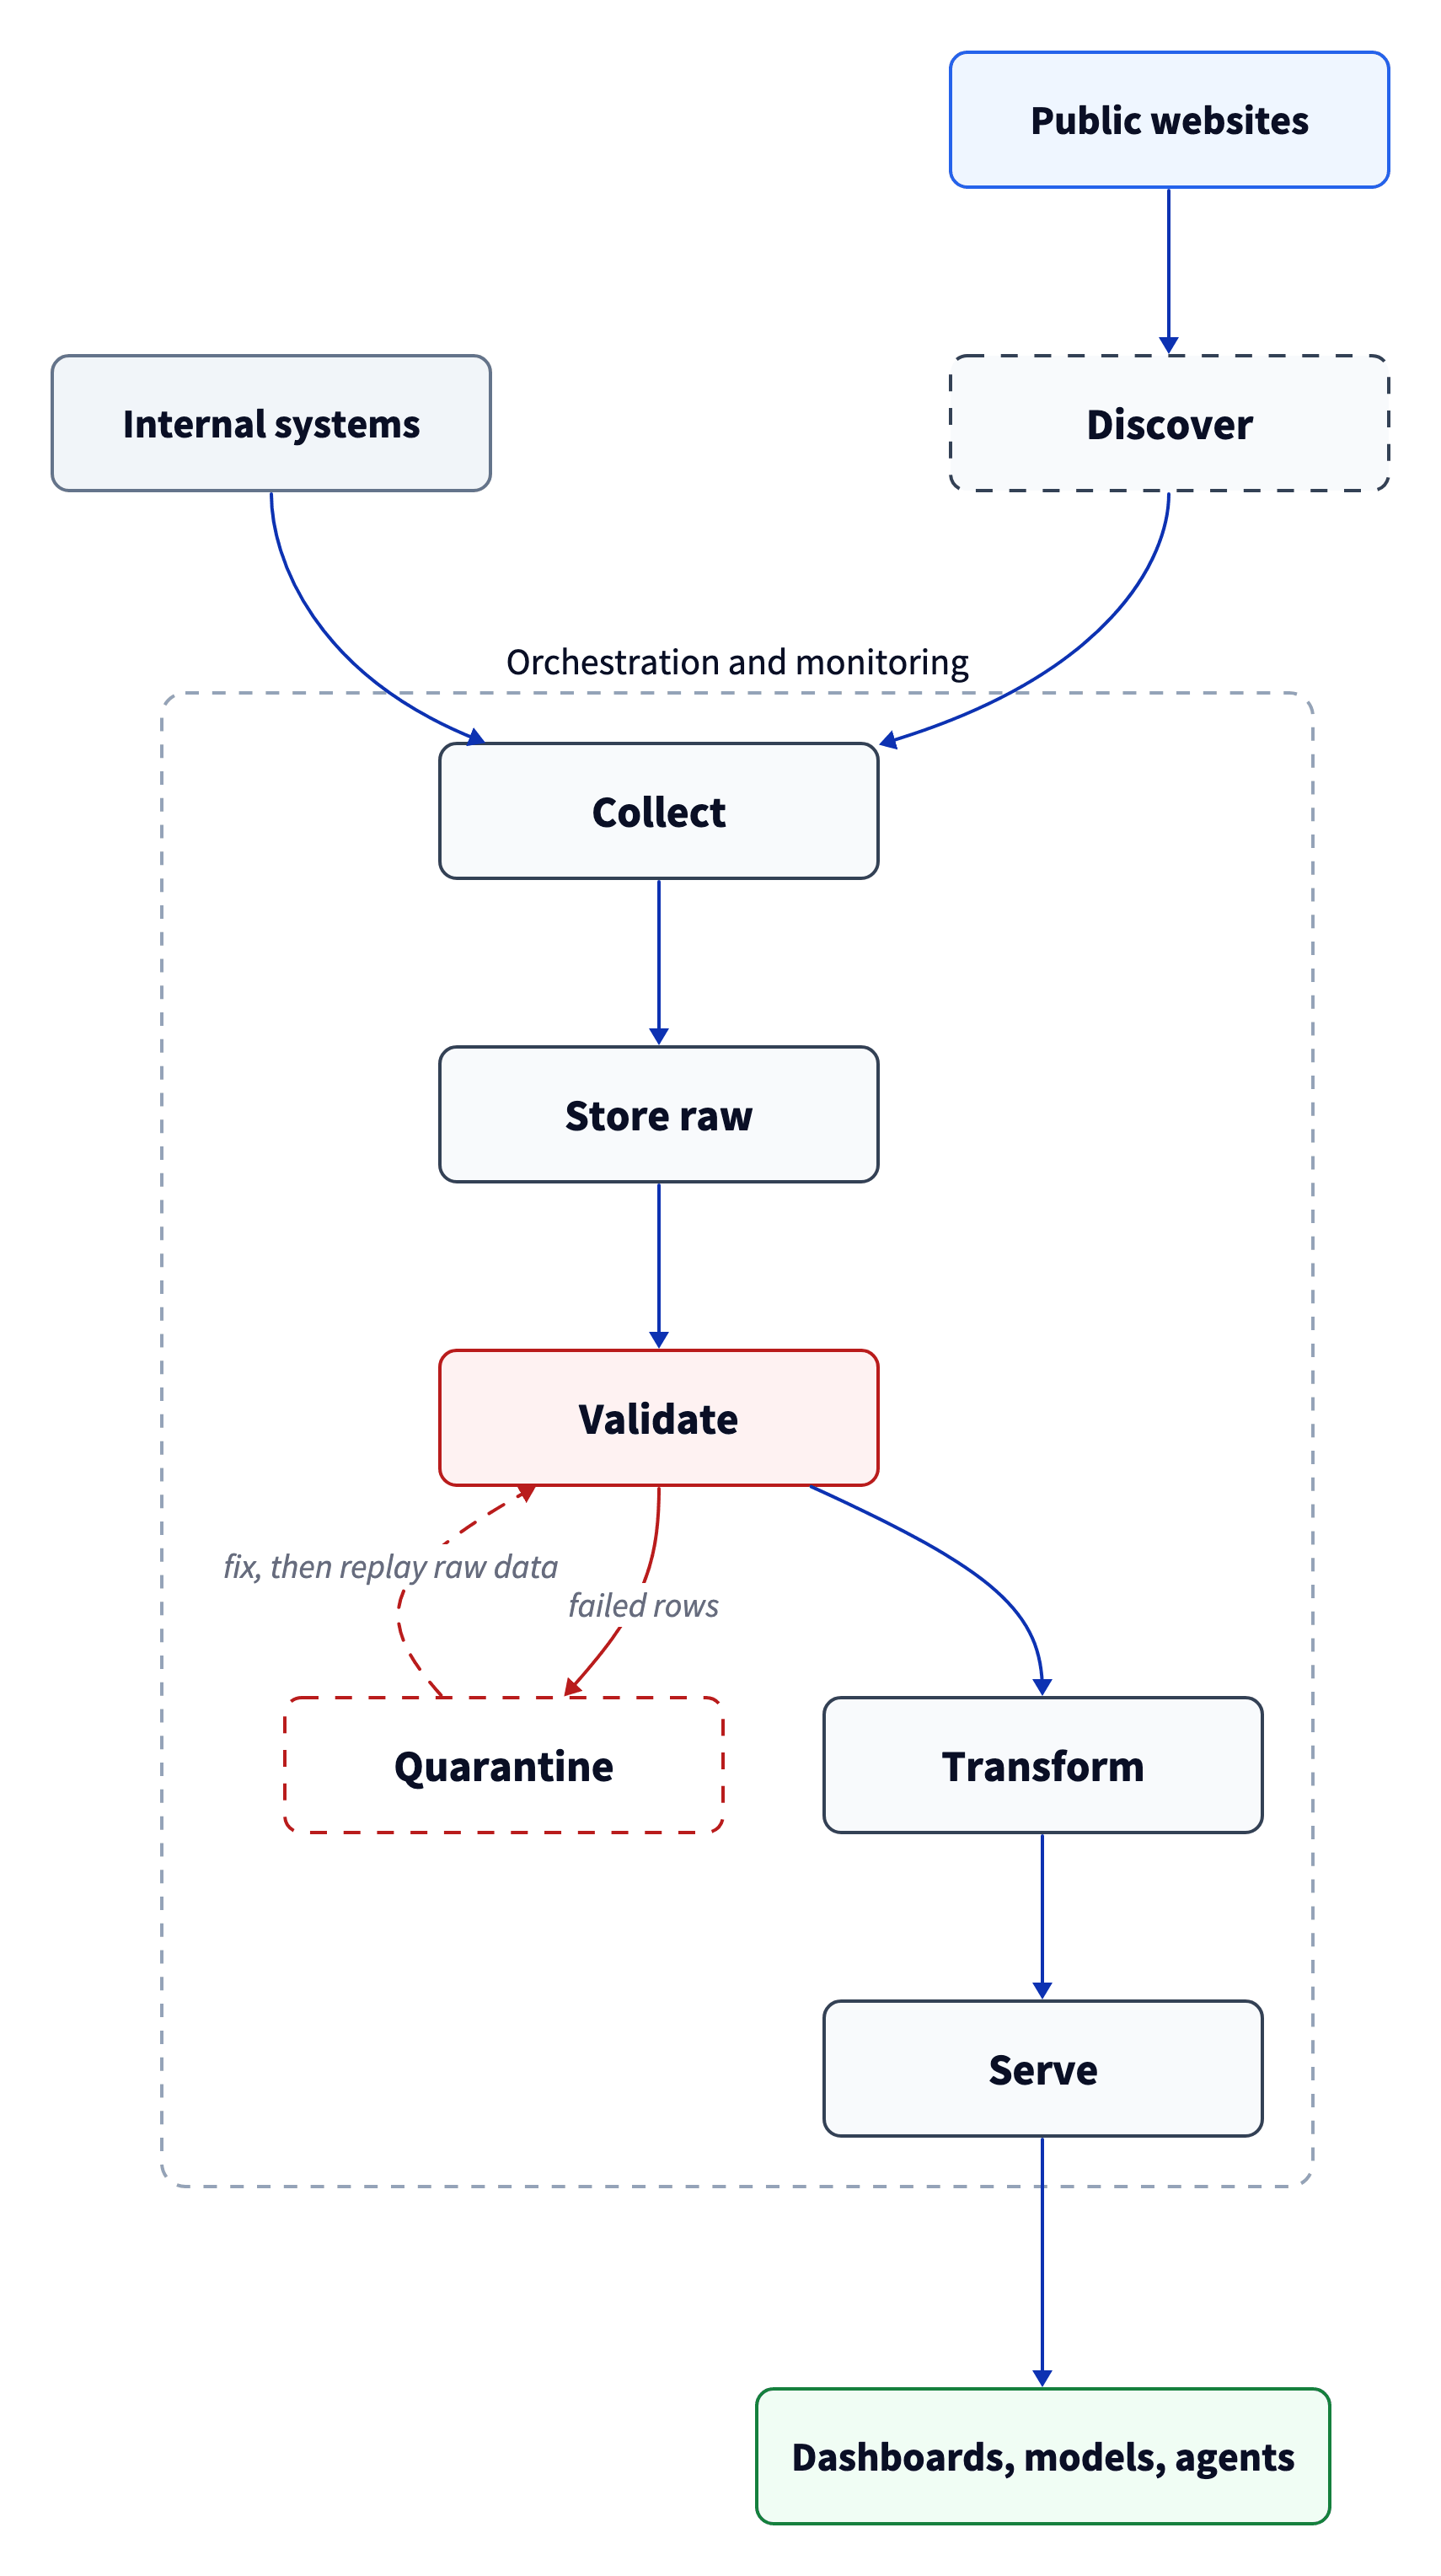
Fontes web adicionam a maior parte do trabalho na etapa de validação e no caminho de quarentena.
Exemplos de arquitetura de pipeline de dados em batch, streaming, híbrida e sob demanda
O padrão certo depende da rapidez com que a decisão precisa de novos dados.
Batch. Um varejista coleta preços de concorrentes para 50 mil produtos todas as noites, e um agente de reprecificação os lê pela manhã. A Web Scraper API pode entregar cada execução diretamente a destinos como Amazon S3, Google Cloud Storage ou Snowflake.
Streaming. Uma equipe de marca monitora postagens sociais e notícias, porque uma menção pode perder valor em poucas horas. O Kafka carrega os eventos, um processador de stream como o Flink calcula contagens em janelas de tempo, e um conector grava os resultados em uma tabela Iceberg. Para um exemplo prático com Spark, veja o guia de Spark Structured Streaming com dados da web.
Híbrida. Uma equipe de pesquisa de investimentos mantém um lote diário de vagas de emprego para histórico e transmite mudanças de preço para uma lista curta de produtos monitorados. Designs mais antigos executavam isso como 2 caminhos separados, conhecidos como arquitetura Lambda. Muitas pilhas mais novas gravam o stream em uma tabela Iceberg, então os trabalhos de batch e streaming leem os mesmos dados.
Sob demanda. Um agente de compras verifica o preço e estoque ao vivo de um produto quando um usuário pergunta. O pipeline serve a linha validada mais recente, a menos que seja mais antiga do que a decisão permite. Se for, uma solicitação síncrona da Web Scraper API retorna um registro atualizado em uma chamada, e o pipeline o verifica contra o mesmo contrato. Dê à busca ao vivo um tempo limite que o usuário possa aceitar, e se expirar, responda com a linha armazenada e sua idade.
Padrões para uma arquitetura de pipeline de dados moderna
Comece um novo design de pipeline de dados a partir destes padrões para cada camada:
| Camada | Padrão | Por quê |
|---|---|---|
| Armazenamento e tabelas | Arquivos brutos em armazenamento de objetos, tabelas em um formato aberto como o Apache Iceberg | Snowflake, Databricks e mecanismos de código aberto leem as mesmas tabelas Iceberg, então uma cópia dos dados pode servir a todos eles |
| Transformação | Modelos SQL em controle de versão, construídos com uma ferramenta como o dbt | Modelos recebem revisão de código e testes como qualquer outro código |
| Orquestração | Uma versão suportada do Airflow, Dagster ou Prefect | Verifique a janela de suporte antes de começar. O Airflow 2 atingiu seu fim de vida em abril de 2026 |
| Contratos de dados | Um arquivo de contrato para cada tabela, em um formato como o Open Data Contract Standard (ODCS) | O ODCS também pode declarar como agentes de IA podem usar os dados, então as regras de uso são armazenadas junto com tipos e proprietários |
| Acesso de agentes | Uma interface Model Context Protocol (MCP) sobre tabelas governadas | A maioria das estruturas de agentes suporta MCP, e um projeto da Linux Foundation o mantém |
Se você ainda executa o AWS Data Pipeline, planeje uma migração, porque a AWS o fechou para novos clientes em 2024.
Por que dados públicos da web precisam de um pipeline de ingestão de dados diferente
Ao contrário de fontes internas, sites públicos não coordenam suas mudanças com sua equipe. Eles podem alterar marcação e defesas anti-bot sem aviso, variar conteúdo por localização ou cliente, e retornar um status de sucesso sem dados. Fontes internas geralmente mudam de maneiras planejadas, como uma migração de esquema ou uma nova versão de API.
Um status de sucesso não garante que os dados chegaram
Um status 2xx apenas mostra que um servidor respondeu. Um teste de busca em 13 páginas de busca e listagem mostra o que um status 2xx pode esconder. As páginas vieram de sites de varejo, viagem, empregos, imóveis, avaliações e busca.
Cada um dos 4 clientes de código aberto comuns buscou cada página 3 vezes, de uma conexão de internet doméstica na Índia, sem proxies. Uma resposta foi contada como dados apenas se continha os padrões HTML que marcam as listagens daquele site. Sua parcela de respostas de sucesso vazias será diferente por cliente e rede, então meça com uma verificação de conteúdo como a abaixo.
| Cliente | Respostas 2xx | Respostas 2xx sem dados | Sites com dados em qualquer uma das 3 buscas (de 13) |
|---|---|---|---|
Python requests, cabeçalhos padrão |
15 | 9 | 2 |
Python requests, cabeçalhos Chrome |
24 | 10 | 5 |
curl_cffi imitando o Chrome |
29 | 9 | 7 |
| Chrome headless (Playwright) | 20 | 11 | 3 (8 em uma nova execução com um User-Agent normal) |
Em todos os clientes, 39 das 88 respostas de sucesso não tinham dados utilizáveis, 27 com HTTP 200 e 12 com HTTP 202. Um código de status poderia sinalizar uma busca falha, mas não poderia confirmar uma boa.
Uma das 39 foi esta página, que um varejista serviu com HTTP 200 para a conexão doméstica na Índia em vez de resultados de busca:
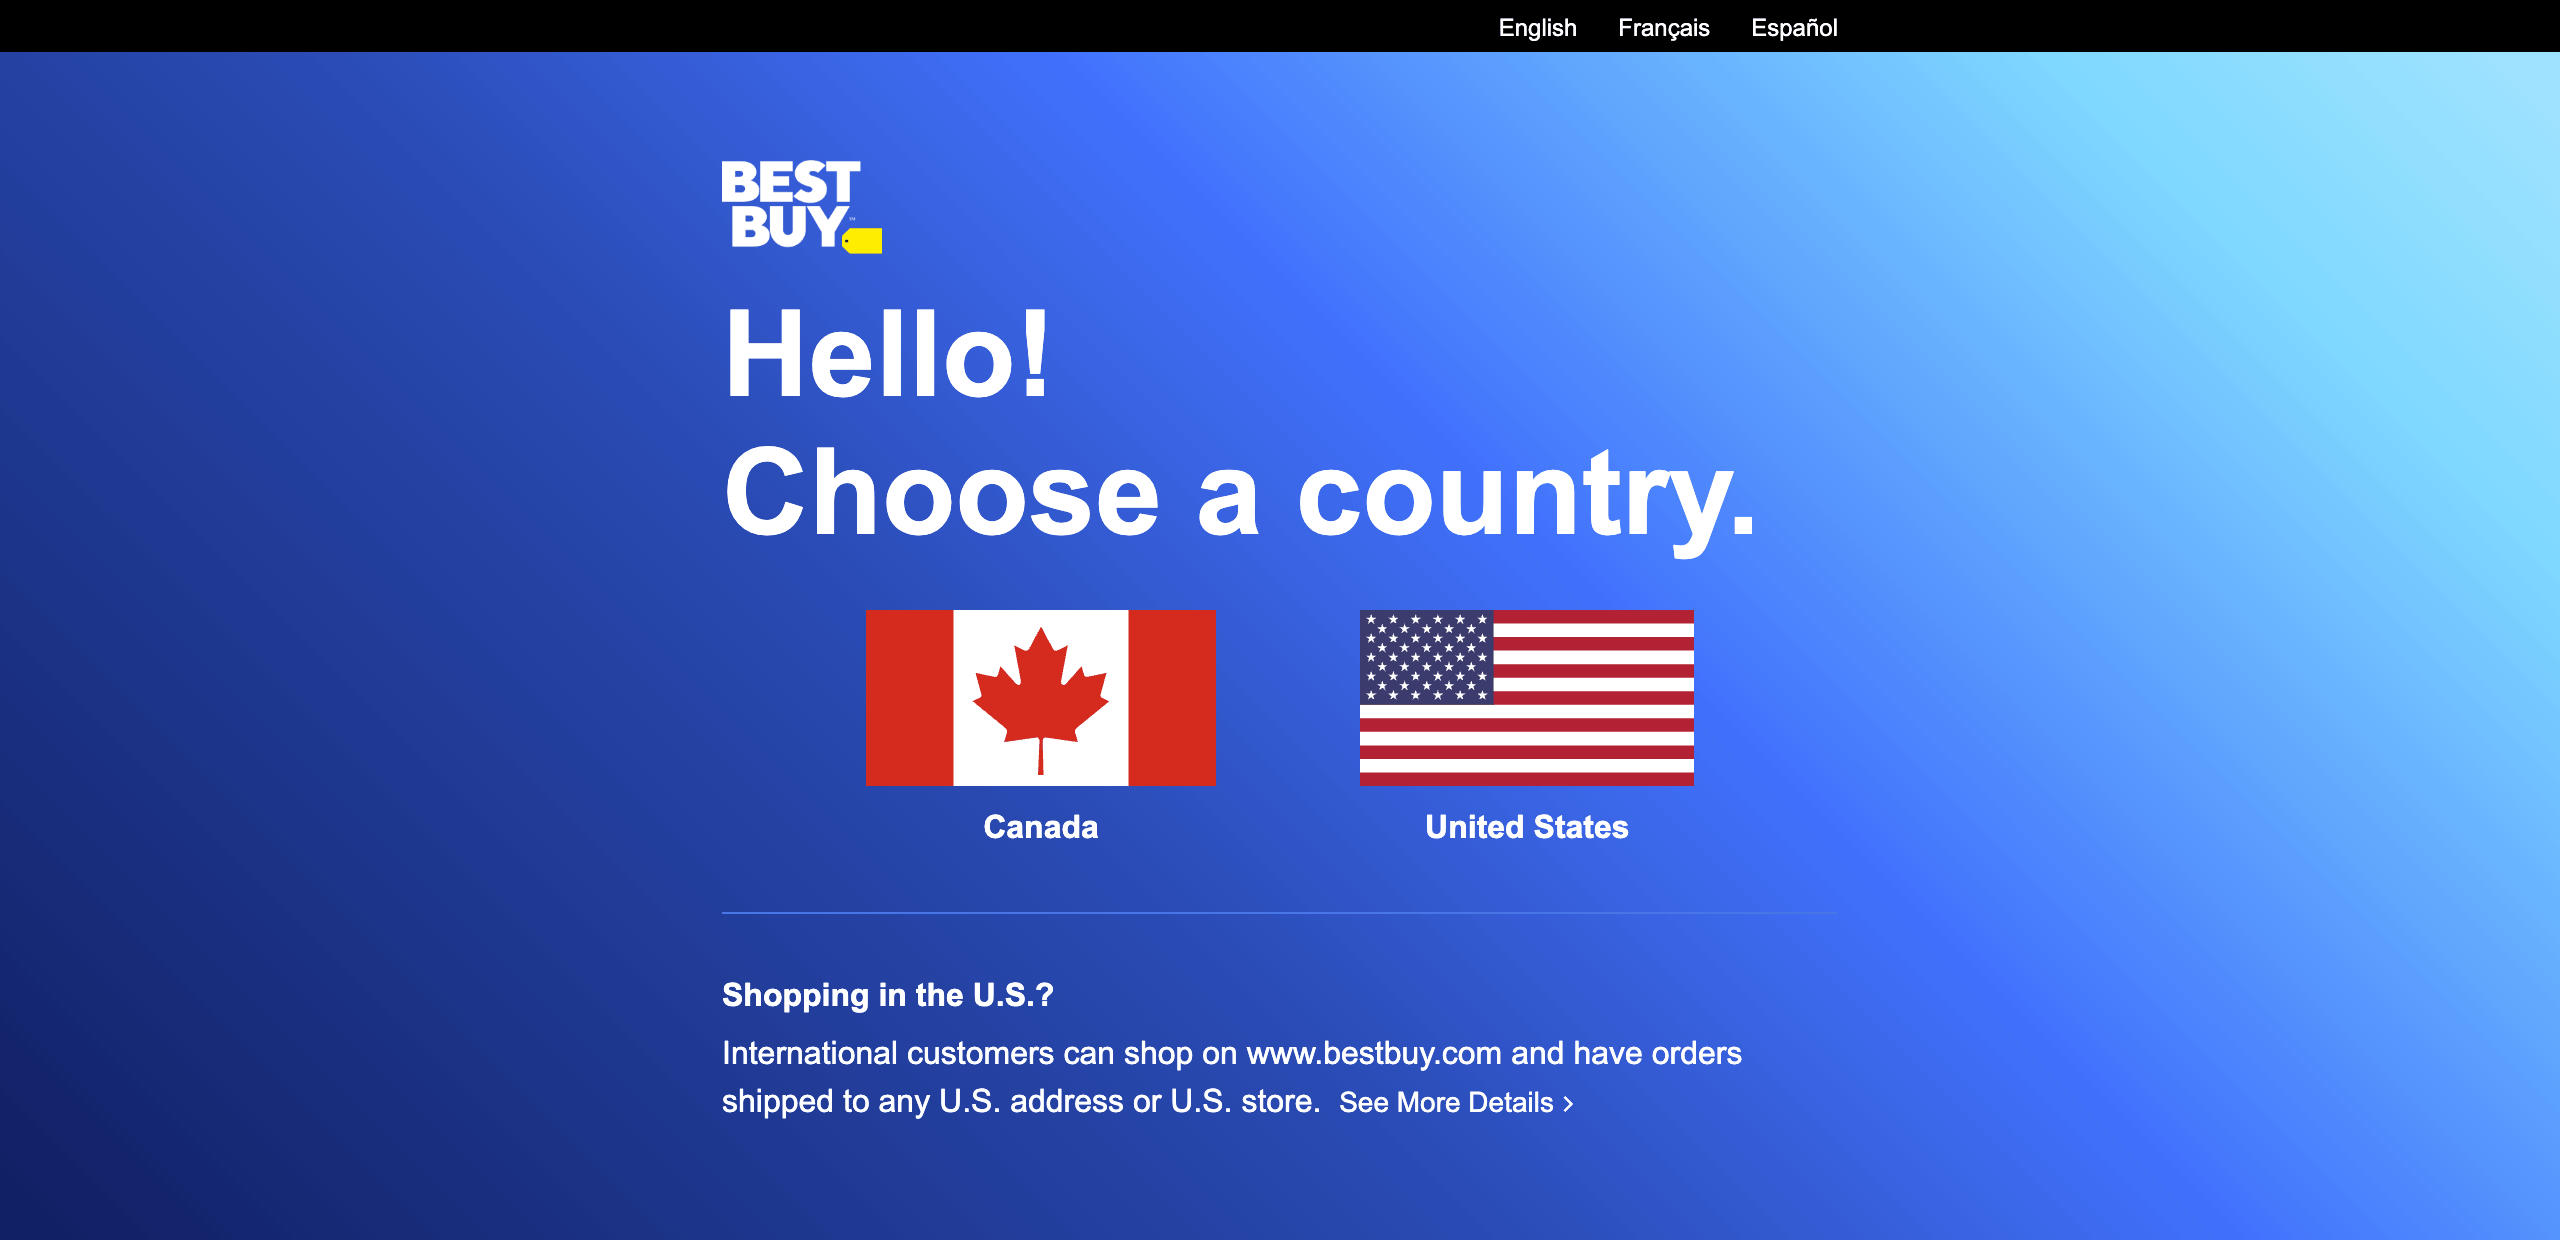
Renderizado a partir do HTML salvo dessa resposta.
As falhas não pareciam erros. Um detector construído a partir de 8 assinaturas comuns de páginas de bloqueio, como páginas de pressionar-e-segurar e tráfego incomum, sinalizou apenas 8 das 39. O restante eram páginas de desafio que a lista não cobria, uma página de seleção de país de um varejista, páginas somente JavaScript e páginas de 670 KB com resultados vazios.
As páginas de 670 KB pareciam completas, exceto por uma área de resultados vazia:
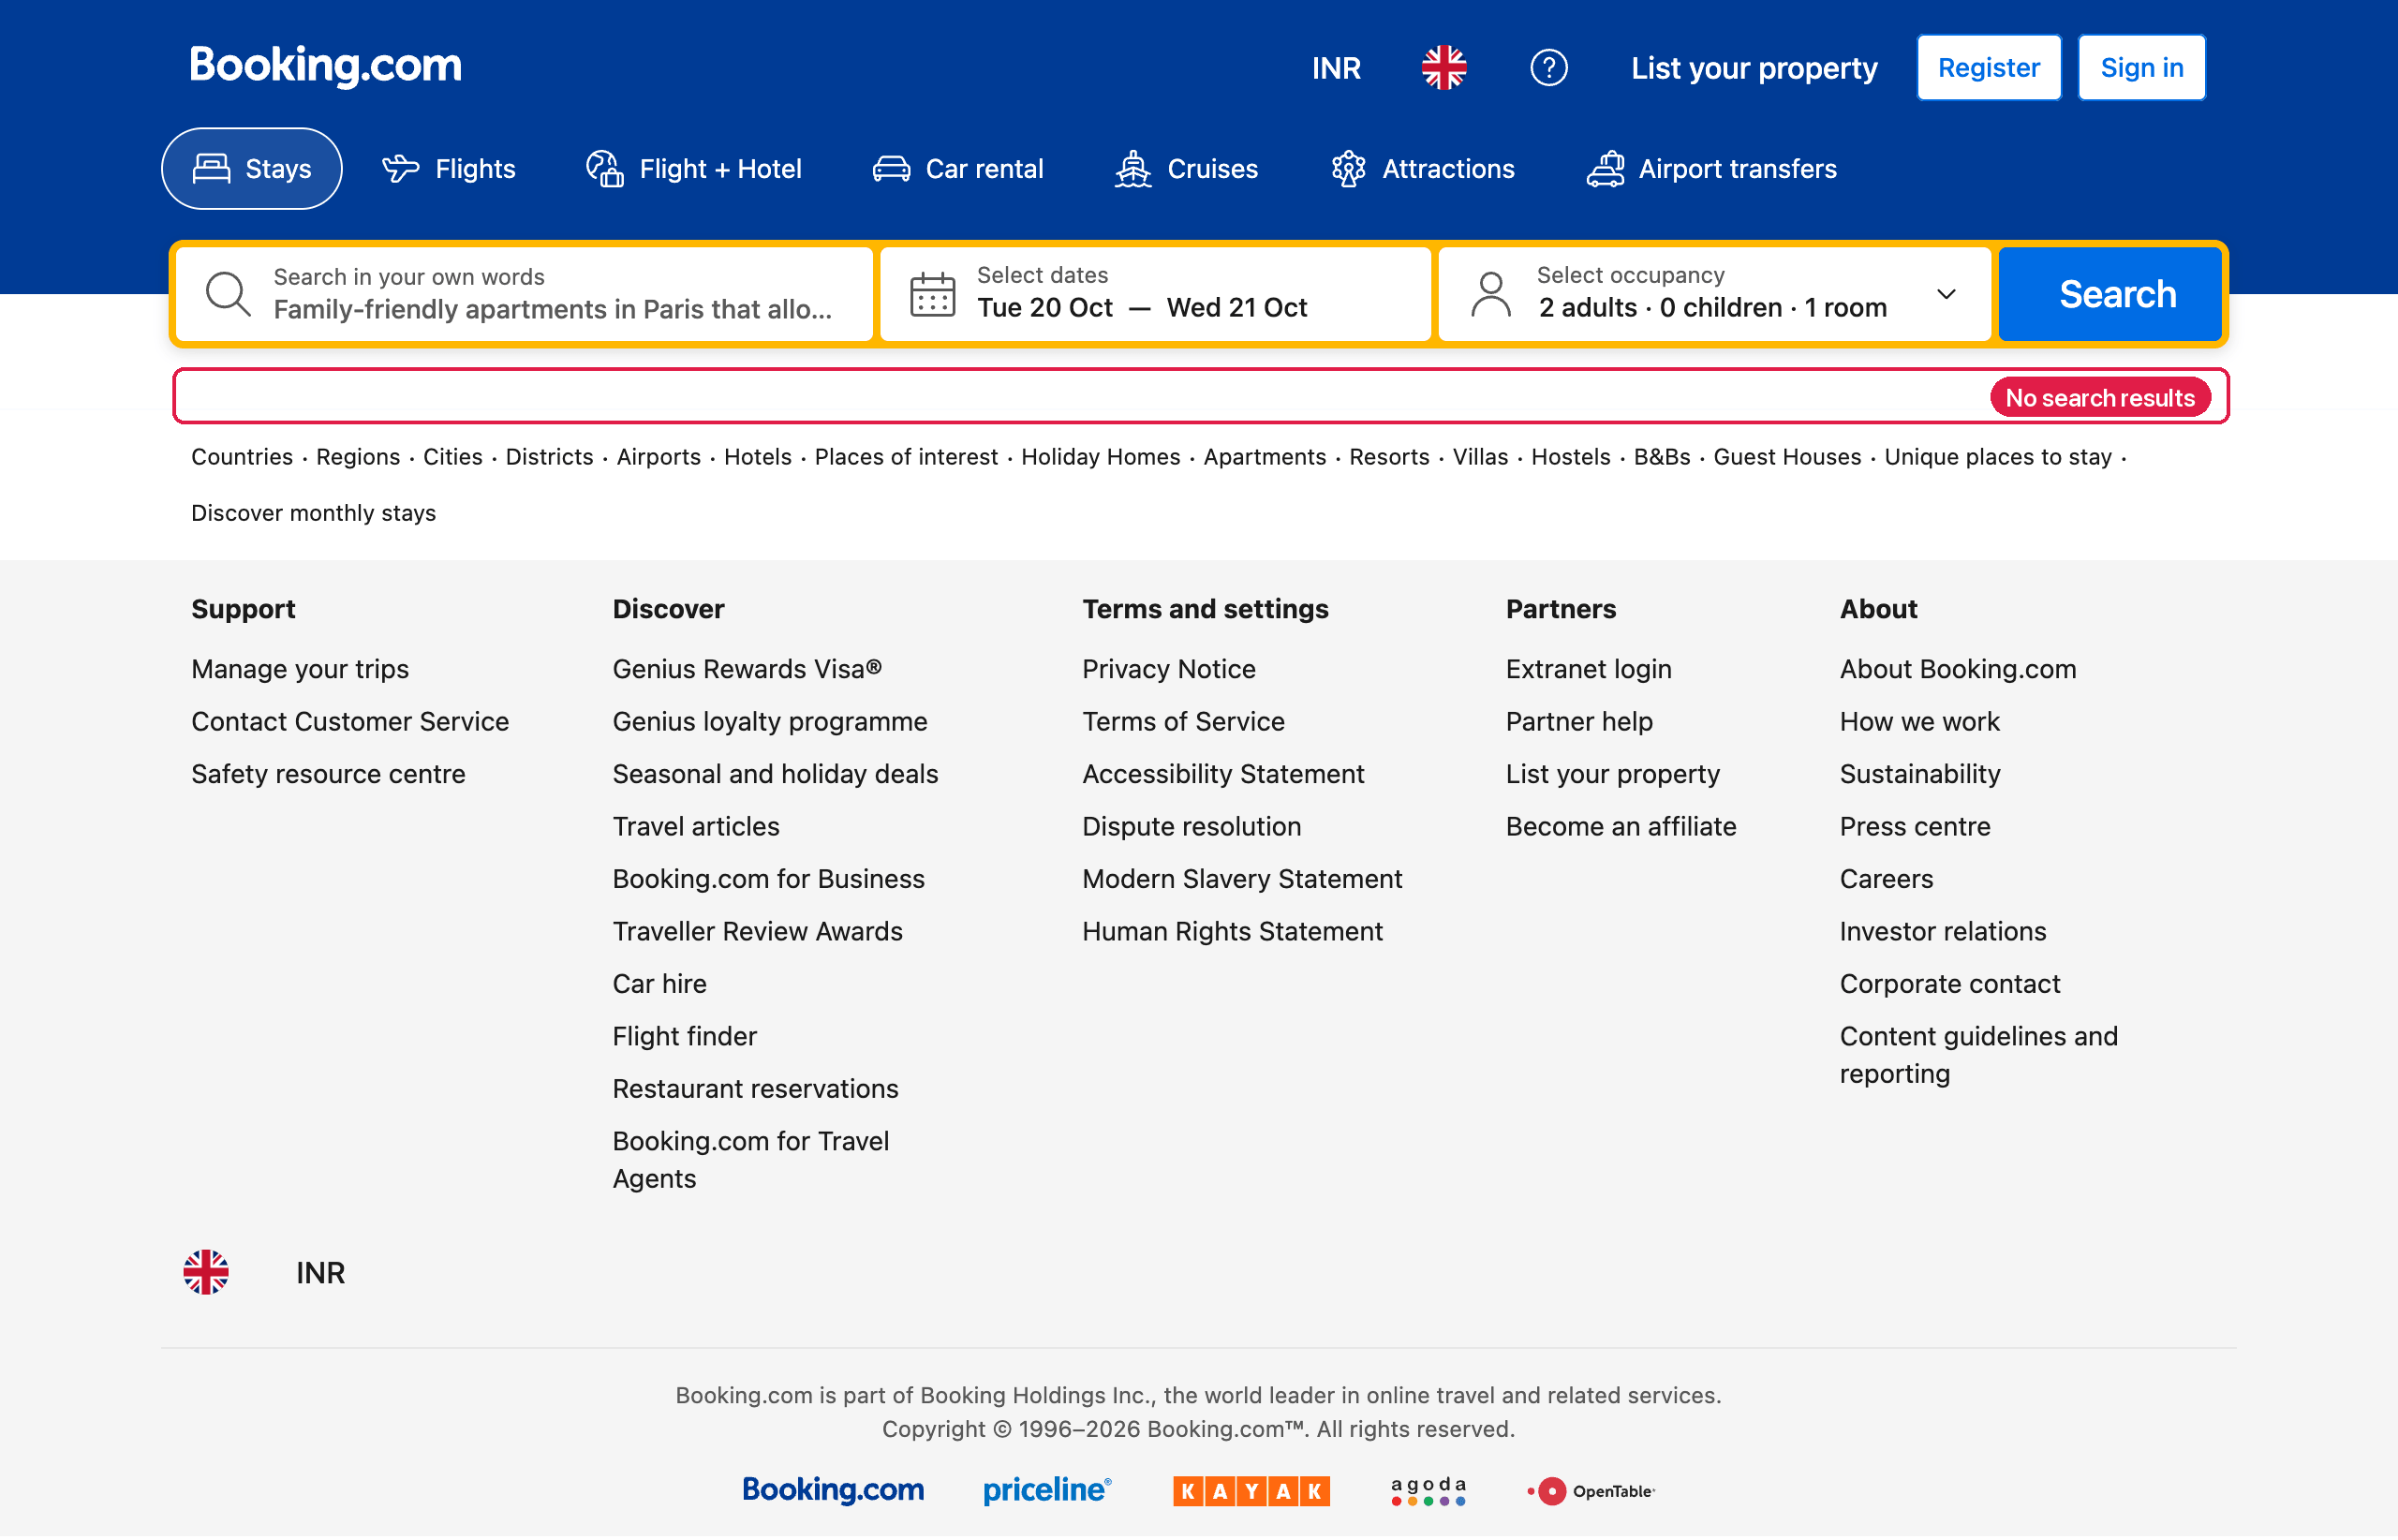
A página que o Chrome headless recebeu com HTTP 202, renderizada a partir de seu HTML salvo. Uma verificação do tamanho da resposta a teria aprovado.
O mesmo detector sinalizou 12 das 49 respostas boas como bloqueadas. Em 2 dos sites, um script de defesa anti-bot é carregado em páginas de listagem normais, e sua tag correspondeu a uma das assinaturas. Teste os dados que você espera, não uma página de bloqueio.
Defesas anti-bot comparam clientes com navegadores reais
Sites podem identificar um cliente antes de qualquer HTML ser enviado, comparando sua impressão digital TLS e cabeçalhos com os de navegadores reais. Em uma verificação de impressão digital, a impressão digital TLS do Web Unlocker correspondeu à de um Chrome instalado e atualizado. No momento do teste, o alvo Chrome mais recente na biblioteca de imitação curl_cffi estava 5 versões principais atrás do Chrome instalado. O Chrome headless obteve dados de apenas 3 dos 13 sites enquanto seu User-Agent continha HeadlessChrome, e de 8 com um User-Agent normal.
Daquela conexão doméstica, 5 de 13 sites não retornaram dados para nenhum cliente de código aberto, mas o teste não separou o cliente da rede. Manter o acesso funcionando significa rastrear lançamentos de navegadores, impressões digitais, cabeçalhos e reputação de IP conforme eles mudam. Você contrata pessoas para esse trabalho ou o compra, através do Web Unlocker para páginas ou da Browser API para sessões de navegador completas.
Agentes enfrentam as mesmas defesas
Nas 13 URLs do teste de busca, a ferramenta WebFetch do Claude Code retornou listagens de 2 delas em uma única execução. Das outras 11 solicitações, 7 retornaram um status de erro.
As 4 restantes retornaram uma página de desafio, uma página de seleção de país, uma página vazia e uma mensagem de erro, todas com um status de sucesso. O agente precisa verificar o conteúdo por si mesmo.
Para acesso ao vivo, agentes podem usar o Bright Data MCP Server, que executa buscas e buscas de páginas através da API SERP e do Web Unlocker.
Alguns sites também permitem que agentes se identifiquem e obtenham acesso em termos acordados. Sites na Cloudflare podem verificar agentes que assinam suas solicitações com Web Bot Auth. O padrão Really Simple Licensing (RSL) permite que um site publique termos de licenciamento. Onde um site oferece qualquer um deles, planeje usá-lo.
Verifique o que o coletor relata, não apenas o status HTTP
O Web Unlocker relata o resultado de cada busca em 2 cabeçalhos de resposta. x-brd-status-code contém o status do site de destino. x-brd-error contém o motivo quando uma busca falha, conforme listado nos códigos de erro do Web Unlocker. Seu código de ingestão deve decidir o que fazer com base nesses cabeçalhos, no próprio status da chamada de API e no conteúdo.
Salve esta verificação como content_check.py. Ela gera um erro para uma chave ou zona inválida, e caso contrário retorna accept, retry, ou quarantine em seu campo action:
import os, re, requests

# Um marcador por fonte, um padrão que aparece apenas quando registros reais estão presentes.
MARKERS = {
    "amazon_search": r'data-component-type="s-search-result"',
    "walmart_search": r'"usItemId"',
}


def fetch_and_check(source: str, url: str, min_hits: int = 5) -> dict:
    r = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"},
        json={"zone": "web_unlocker", "url": url, "format": "raw", "country": "us"},
        timeout=(15, 240),
    )
    # Uma chave ou nome de zona inválido. Uma nova tentativa não resolverá.
    if r.status_code in (400, 401, 403):
        r.raise_for_status()
    # A busca falhou ou atingiu um limite de taxa. Tente novamente mais tarde.
    if r.headers.get("x-brd-error") or r.status_code == 429 or r.status_code >= 500:
        reason = r.headers.get("x-brd-error") or f"HTTP {r.status_code}"
        return {"source": source, "action": "retry", "reason": reason[:60]}
    hits = len(re.findall(MARKERS[source], r.text))
    action = "accept" if hits >= min_hits else "quarantine"
    return {
        "source": source,
        "action": action,
        "target_status": r.headers.get("x-brd-status-code"),
        "marker_hits": hits,
        "bytes": len(r.content),
    }


if __name__ == "__main__":
    amazon = "https://www.amazon.com/s?k=noise+cancelling+headphones"
    walmart = "https://www.walmart.com/search?q=noise+cancelling+headphones"
    print(fetch_and_check("amazon_search", amazon))
    print(fetch_and_check("walmart_search", walmart))
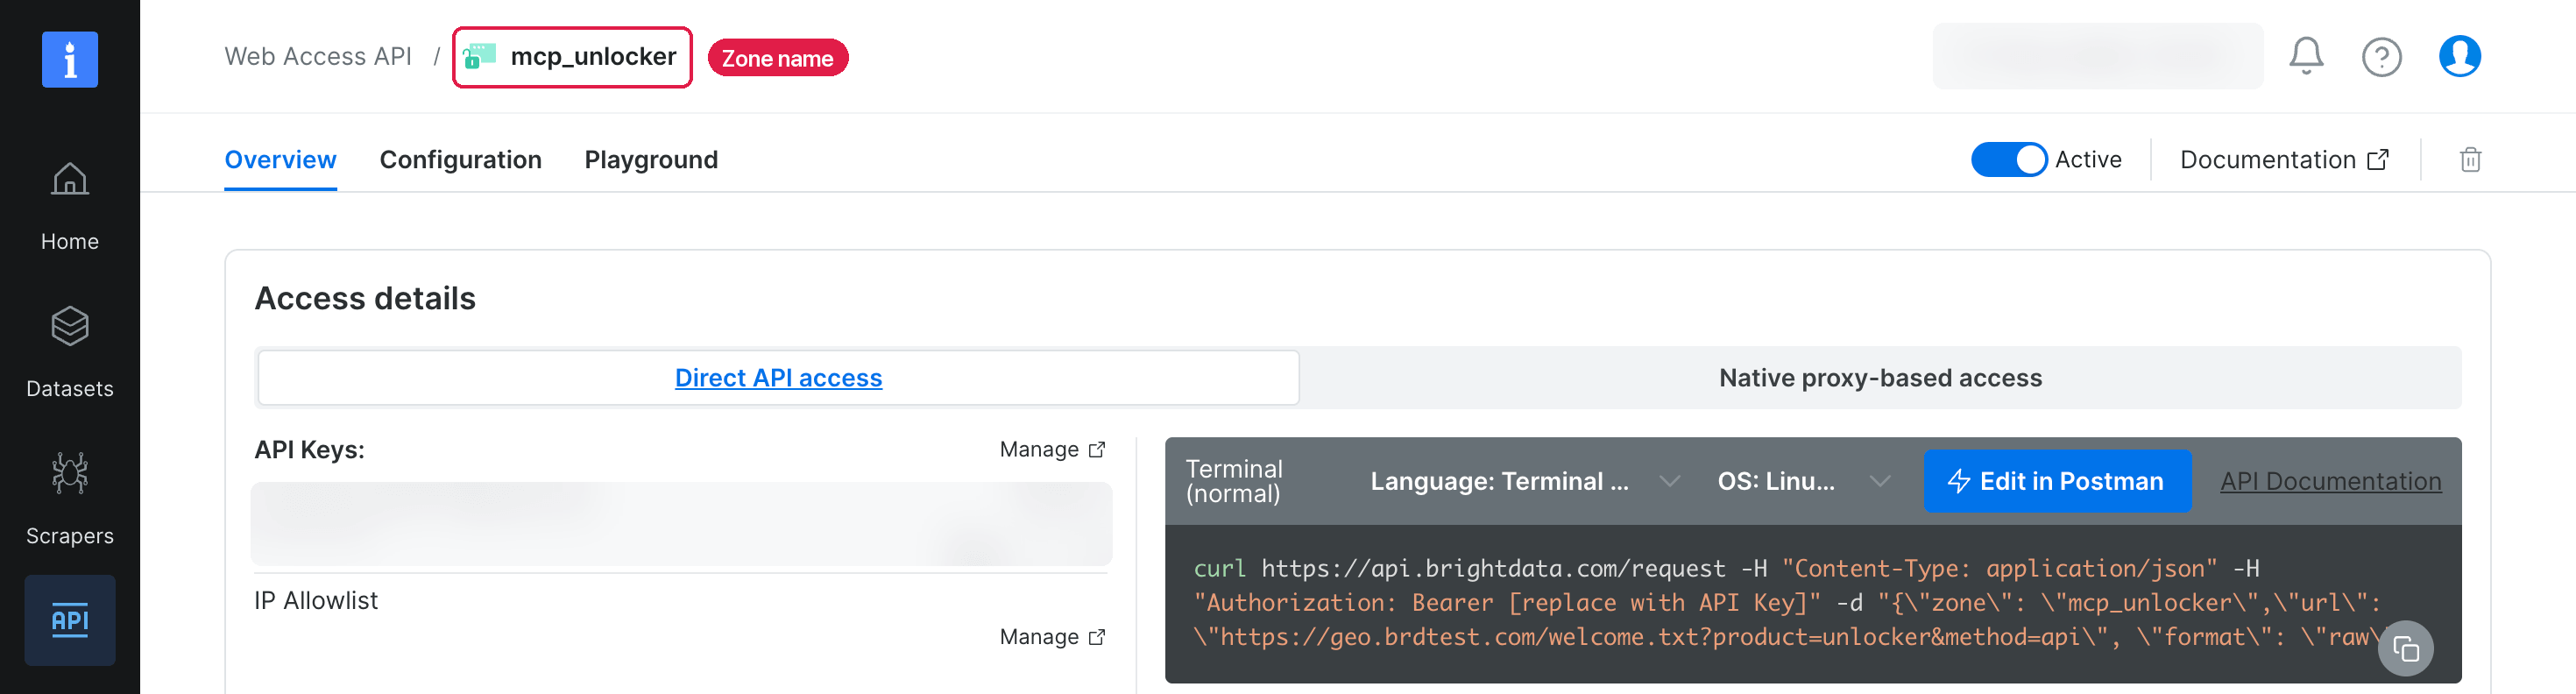
Para executá-lo, crie uma zona Web Unlocker, uma configuração nomeada para esse produto, em Web Access no painel de controle Bright Data. Novas contas recebem créditos gratuitos mensais, suficientes para executar os scripts deste guia.
Crie uma chave de API em Account settings no painel de controle, e salve-a em uma variável de ambiente chamada BRIGHTDATA_API_KEY. Substitua web_unlocker pelo nome da sua zona. O nome aparece no topo da página da zona, e o exemplo de solicitação da página o usa:
Após pip install requests, execute python content_check.py. Uma execução de amostra aceitou ambas as páginas:
{'source': 'amazon_search', 'action': 'accept', 'target_status': '200', 'marker_hits': 16, 'bytes': 1516805}
{'source': 'walmart_search', 'action': 'accept', 'target_status': '200', 'marker_hits': 395, 'bytes': 1535496}
Seu pipeline repete uma busca retry com backoff, esperando mais tempo após cada falha. Uma página quarantine vai para uma pessoa ou um classificador, porque a fonte pode ter mudado. Front ends podem mudar sem aviso, então quando uma fonte subitamente não retorna dados, primeiro verifique se seu marcador ainda aparece no HTML da página.
Um pipeline de ingestão de dados de referência para fontes web
O pipeline de referência abaixo usa a Web Scraper API, que retorna registros estruturados, então as verificações de validação checam campos em vez de analisar páginas.
Filtre o que a descoberta retorna
Para uma busca de um modelo de fone de ouvido, a API SERP retornou os 7 resultados orgânicos do Google, a Visão Geral de IA, vídeos e Perguntas Relacionadas como campos JSON separados. O Google classificou apenas 3 páginas de varejistas entre os 7, e uma delas vendia um produto diferente, a versão de fones intra-auriculares do mesmo modelo. A declaração da Visão Geral de IA sobre preço citou uma avaliação do YouTube, não um varejista, como sua primeira fonte. Trate respostas de IA como afirmações a verificar, e filtre resultados por domínio e por um identificador como um número de modelo.
Construa e execute o pipeline
O pipeline recebe uma lista de URLs de produtos, como resultados de descoberta filtrados. Ele inicia um trabalho com o endpoint /trigger da Web Scraper API, o rastreia com /progress, e baixa os registros com /snapshot. Com include_errors=true, a API relata cada entrada falha como seu próprio registro com um error_code.
Em Python, o SDK Bright Data substitui essas 3 chamadas por uma chamada por scraper. O script abaixo chama os endpoints diretamente, então cada etapa permanece visível, e o script funciona com qualquer orquestrador. Salve-o como pipeline.py. Suas funções seguem as etapas no diagrama, com collect(), store_raw(), validate(), e model() para as tabelas, depois domain_checks() para as sinalizações:
"""Pipeline de dados web de referência que coleta, armazena bruto, valida, modela e verifica.

Coleta: Bright Data Web Scraper API (trigger assíncrono + download de snapshot).
Armazenamento: uma pasta local no lugar do armazenamento de objetos (bronze), DuckDB para silver e gold.
"""
import json, os, sys, time, pathlib, datetime as dt
import duckdb, requests
from pydantic import BaseModel, Field, ValidationError

API = "https://api.brightdata.com/datasets/v3"
# Reprocessamento não precisa de chave.
HEADERS = {"Authorization": f"Bearer {os.environ.get('BRIGHTDATA_API_KEY', '')}"}
DATASET = "gd_l7q7dkf244hwjntr0"  # Produtos Amazon, coletar por URL
LAKE = pathlib.Path("lake")


def collect(inputs: list[dict]) -> str:
    """Dispara uma coleta assíncrona e aguarda. Retorna o ID do snapshot."""
    params = {"dataset_id": DATASET, "include_errors": "true"}
    r = requests.post(
        f"{API}/trigger", headers=HEADERS, json=inputs, params=params, timeout=60
    )
    r.raise_for_status()
    snapshot_id = r.json()["snapshot_id"]
    deadline = time.time() + 3600  # falha após uma hora, para o orquestrador alertar
    while time.time() < deadline:
        url = f"{API}/progress/{snapshot_id}"
        p = requests.get(url, headers=HEADERS, timeout=60).json()
        if p["status"] == "ready":
            summary = {k: p.get(k) for k in ("records", "errors", "error_codes")}
            print("progress:", summary)
            return snapshot_id
        if p["status"] in ("failed", "canceled"):
            raise RuntimeError(f"snapshot {snapshot_id} ended as {p['status']}")
        time.sleep(15)
    raise TimeoutError(f"snapshot {snapshot_id} not ready after 1 hour")


def store_raw(snapshot_id: str) -> pathlib.Path:
    """Grava o snapshot inalterado em um caminho imutável e particionado."""
    url = f"{API}/snapshot/{snapshot_id}"
    r = requests.get(url, headers=HEADERS, params={"format": "ndjson"}, timeout=300)
    # Qualquer coisa além de 200, como 202 enquanto o snapshot é construído, não são dados.
    if r.status_code != 200:
        raise RuntimeError(
            f"snapshot {snapshot_id} not downloadable: HTTP {r.status_code}"
        )
    day = dt.datetime.now(dt.timezone.utc).date()
    path = LAKE / "bronze/amazon_products" / f"dt={day}" / f"{snapshot_id}.ndjson"
    path.parent.mkdir(parents=True, exist_ok=True)
    if not path.exists():  # um snapshot armazenado nunca é regravado
        path.write_bytes(r.content)
    return path


class Product(BaseModel):
    """O contrato de dados, que define o que as tabelas downstream podem receber."""
    asin: str = Field(pattern=r"^[A-Z0-9]{10}$")
    parent_asin: str | None = None
    title: str = Field(min_length=3)
    final_price: float = Field(gt=0, lt=100_000)
    currency: str = Field(pattern=r"^[A-Z]{3}$")
    rating: float | None = Field(default=None, ge=0, le=5)
    reviews_count: int | None = Field(default=None, ge=0)
    buybox_seller: str | None = None
    timestamp: dt.datetime


def validate(path: pathlib.Path) -> tuple[list[dict], list[dict]]:
    """Divide um arquivo bruto em linhas aceitas e linhas em quarentena com um motivo."""
    accepted, quarantined = [], []
    for line in path.read_text().splitlines():
        rec = json.loads(line)
        if rec.get("error_code"):  # entrada falha, relatada por registro
            quarantined.append({"input": rec.get("input"), "reason": rec["error_code"]})
            continue
        try:
            row = Product(**rec).model_dump()
            row["snapshot_file"] = path.name  # linhagem de volta aos bytes brutos
            accepted.append(row)
        except ValidationError as e:
            fields = ",".join(str(x["loc"][0]) for x in e.errors())
            reason = f"contract:{fields}"
            quarantined.append({"input": rec.get("url"), "reason": reason})
    return accepted, quarantined


def model(accepted: list[dict]) -> duckdb.DuckDBPyConnection:
    """Carrega silver de forma idempotente, depois constrói tabelas gold na granularidade certa."""
    con = duckdb.connect(str(LAKE / "warehouse.duckdb"))
    con.execute("SET TimeZone = 'UTC'")  # armazena e mostra cada observação em UTC
    con.execute("""CREATE TABLE IF NOT EXISTS silver_prices (
        asin TEXT, parent_asin TEXT, title TEXT, final_price DOUBLE,
        currency TEXT, rating DOUBLE, reviews_count BIGINT, buybox_seller TEXT,
        observed_at TIMESTAMPTZ, snapshot_file TEXT,
        PRIMARY KEY (asin, observed_at))""")
    # A chave primária torna uma nova execução uma não-operação em vez de uma duplicata.
    for r in accepted:
        con.execute(
            "INSERT OR IGNORE INTO silver_prices VALUES (?,?,?,?,?,?,?,?,?,?)",
            [r["asin"], r["parent_asin"] or r["asin"], r["title"], r["final_price"],
             r["currency"], r["rating"], r["reviews_count"], r["buybox_seller"],
             r["timestamp"], r["snapshot_file"]],
        )
    con.execute("""CREATE OR REPLACE VIEW latest_prices AS
        SELECT * FROM silver_prices
        QUALIFY row_number() OVER (PARTITION BY asin ORDER BY observed_at DESC) = 1""")
    # O preço pertence à variante. As avaliações pertencem à listagem pai.
    con.execute("""CREATE OR REPLACE VIEW gold_parent_reviews AS
        SELECT parent_asin, max(reviews_count) AS reviews_count, max(rating) AS rating,
               count(DISTINCT asin) AS variants_seen
        FROM latest_prices GROUP BY parent_asin""")
    return con


def domain_checks(con: duckdb.DuckDBPyConnection) -> None:
    """Compara cada produto com sua observação anterior. Sinaliza, nunca descarta."""
    con.execute("""CREATE OR REPLACE TABLE flags AS
        WITH obs AS (
            SELECT *,
                lag(final_price) OVER w AS prev_price,
                lag(currency) OVER w AS prev_currency,
                lag(reviews_count) OVER w AS prev_reviews,
                lag(buybox_seller) OVER w AS prev_seller
            FROM silver_prices WINDOW w AS (PARTITION BY asin ORDER BY observed_at))
        SELECT asin, observed_at, 'price_moved_over_30pct' AS flag FROM obs
            WHERE abs(final_price - prev_price) / prev_price > 0.3
        UNION ALL SELECT asin, observed_at, 'currency_changed' FROM obs
            WHERE currency <> prev_currency
        UNION ALL SELECT asin, observed_at, 'reviews_went_down' FROM obs
            WHERE reviews_count < prev_reviews
        UNION ALL SELECT asin, observed_at, 'reviews_jumped_over_50pct' FROM obs
            WHERE reviews_count > prev_reviews * 1.5
        UNION ALL SELECT asin, observed_at, 'buybox_seller_changed' FROM obs
            WHERE buybox_seller <> prev_seller""")


if __name__ == "__main__":
    # --replay carrega cada arquivo bronze nas tabelas novamente, sem nova coleta.
    if sys.argv[1] == "--replay":
        raws = sorted(LAKE.glob("bronze/amazon_products/*/*.ndjson"))
    else:
        inputs = json.load(open(sys.argv[1]))
        snapshot_id = sys.argv[2] if len(sys.argv) > 2 else collect(inputs)
        raws = [store_raw(snapshot_id)]
    for raw in raws:
        ok, bad = validate(raw)
        con = model(ok)
        print(f"{raw.name}: accepted={len(ok)} quarantined={len(bad)}")
        for q in bad:
            print("quarantine:", q)
    domain_checks(con)
    print(con.sql(
        "SELECT count(*) AS rows, count(DISTINCT asin) AS asins FROM silver_prices"
    ))
    print(con.sql(
        "SELECT * FROM gold_parent_reviews WHERE variants_seen > 1 ORDER BY parent_asin"
    ))
    print(con.sql("SELECT * FROM flags ORDER BY asin"))
O valor DATASET no script é o ID do scraper de produtos Amazon, um dos scrapers pré-construídos que a Bright Data mantém. Sua página no painel de controle mostra esse ID em seu exemplo de solicitação, ao lado de um campo de entrada zipcode:
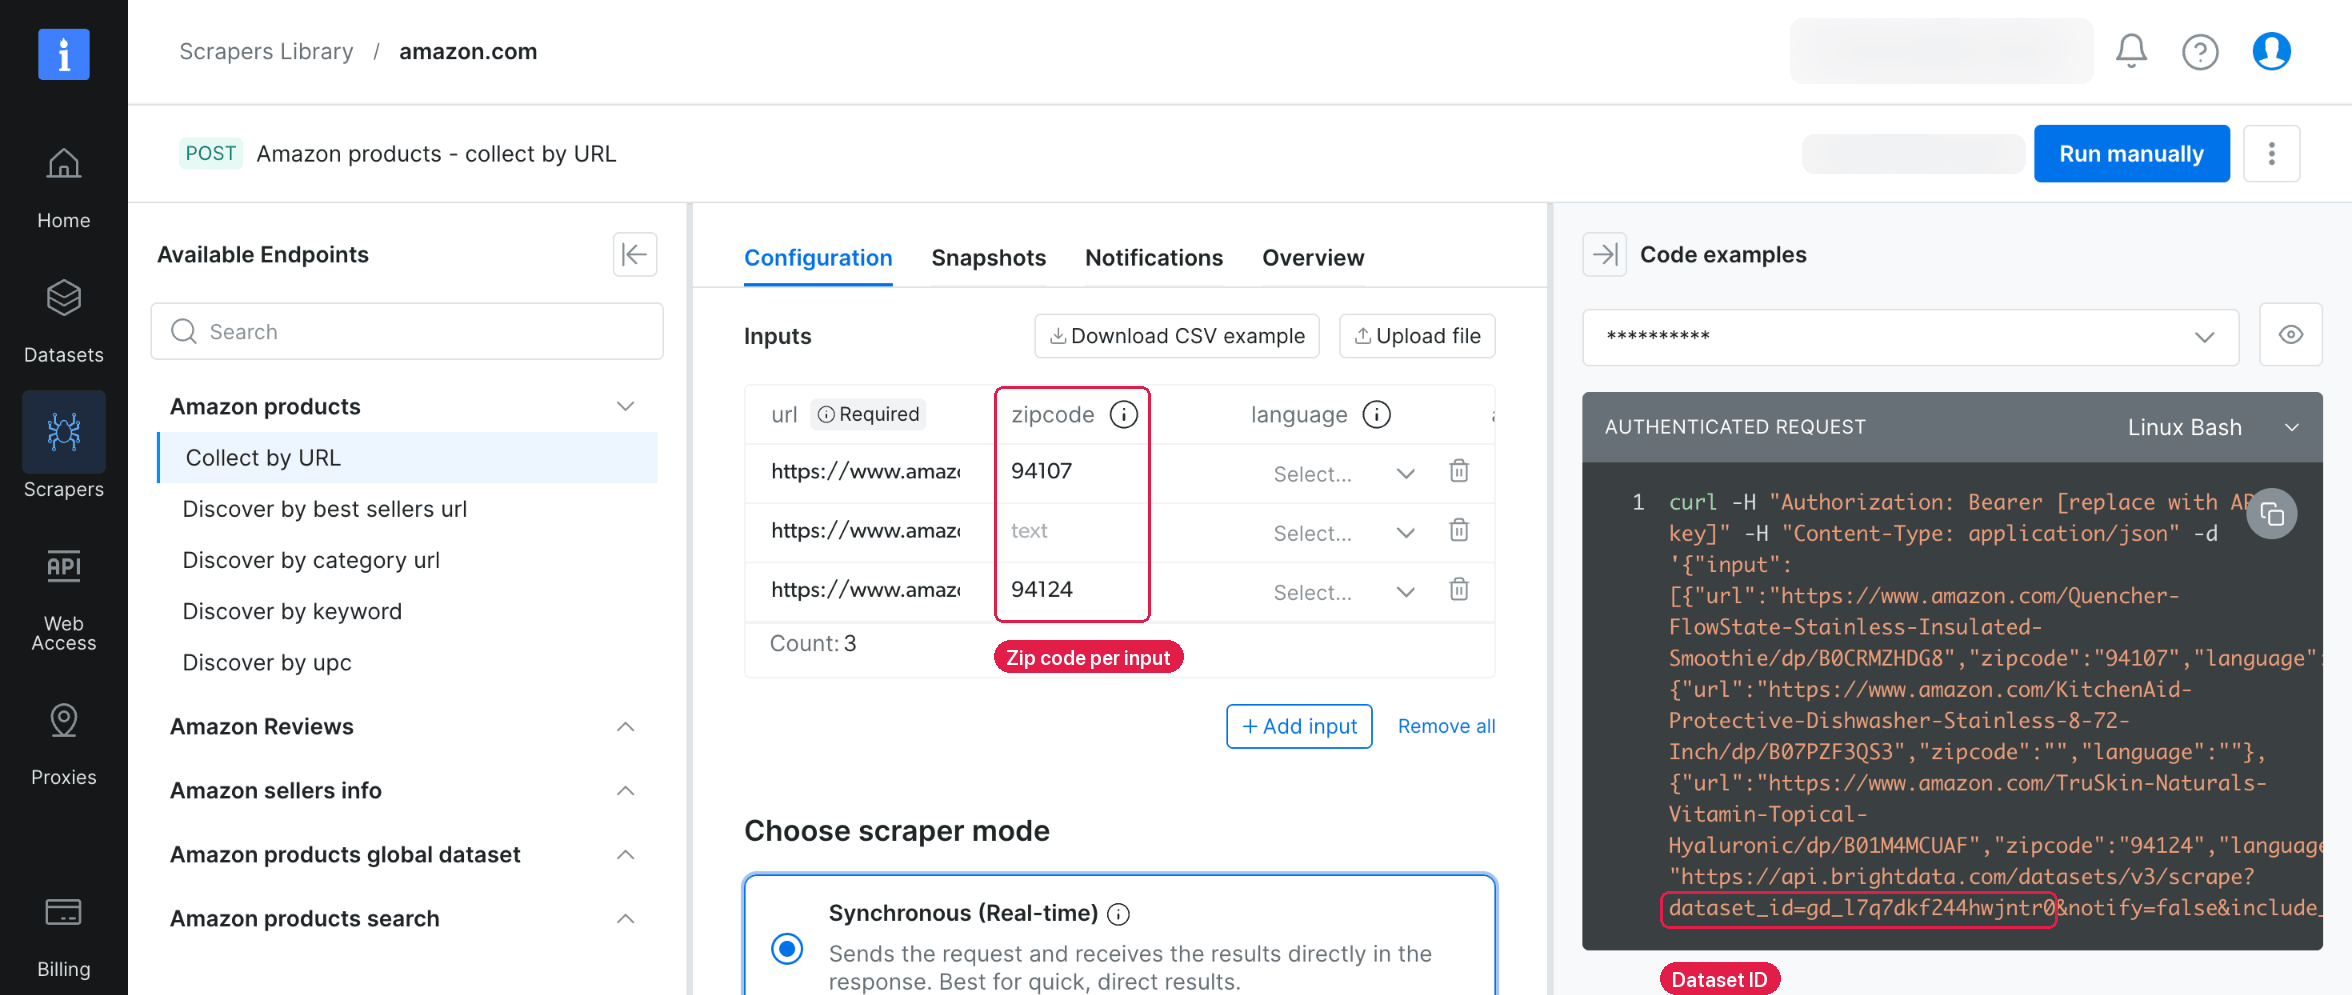
O exemplo de solicitação da página usa o endpoint síncrono /scrape, que retorna registros na mesma chamada. O script usa /trigger em vez disso, que executa grandes lotes em segundo plano e entrega os resultados como um snapshot.
No Python 3.10 ou posterior, salve suas entradas como inputs.json no formato [{"url": "https://www.amazon.com/dp/<ASIN>", "zipcode": "<ZIP>"}], onde <ASIN> é o ID do produto Amazon. Então execute:
pip install requests pydantic duckdb
export BRIGHTDATA_API_KEY="your_api_key"
python pipeline.py inputs.json
python pipeline.py --replay
O primeiro comando python coleta e carrega uma execução. O comando --replay carrega cada arquivo bruto salvo nas tabelas novamente, sem chamar a API. A saída abaixo vem de uma lista de monitoramento de 20 produtos Amazon e 1 ID deliberadamente inválido, coletados duas vezes com cerca de 2 horas de diferença e depois reprocessados:
sd_mvgo38o997m0dxre9.ndjson: accepted=20 quarantined=1
quarantine: {'input': {'url': 'https://www.amazon.com/dp/B0ZZZZZZZZ', 'asin': '', 'zipcode': '', 'language': ''}, 'reason': 'dead_page'}
sd_mvgsyvcx1fcvvspadf.ndjson: accepted=20 quarantined=1
quarantine: {'input': {'url': 'https://www.amazon.com/dp/B0ZZZZZZZZ', 'asin': '', 'zipcode': '', 'language': ''}, 'reason': 'dead_page'}
┌───────┬───────┐
│ rows  │ asins │
│ int64 │ int64 │
├───────┼───────┤
│    40 │    20 │
└───────┴───────┘

┌─────────────┬───────────────┬────────┬───────────────┐
│ parent_asin │ reviews_count │ rating │ variants_seen │
│   varchar   │     int64     │ double │     int64     │
├─────────────┼───────────────┼────────┼───────────────┤
│ B0FMZYMXNR  │          3015 │    4.2 │             3 │
│ B0GKGDTLG2  │           668 │    4.5 │             6 │
│ B0H1QVR9JS  │         17115 │    4.3 │             2 │
└─────────────┴───────────────┴────────┴───────────────┘

┌────────────┬────────────────────────────┬───────────────────────────┐
│    asin    │        observed_at         │           flag            │
│  varchar   │  timestamp with time zone  │          varchar          │
├────────────┼────────────────────────────┼───────────────────────────┤
│ B0FDKQZ18F │ 2026-10-20 14:53:09.044+00 │ buybox_seller_changed     │
│ B0HJ5K8WN4 │ 2026-10-20 14:53:11.293+00 │ reviews_jumped_over_50pct │
└────────────┴────────────────────────────┴───────────────────────────┘
Para manter a demonstração simples, essas execuções não definiram um CEP, mas execuções de produção devem definir um. A tabela silver manteve ambas as observações dos 20 produtos. Reprocessar novamente deixou a tabela com 40 linhas, porque a chave primária bloqueia linhas duplicadas.
Escolhas de design que encontram problemas cedo
- Grave dados brutos uma vez e nunca os edite. Com o arquivo bruto mantido, adicionar um campo não requer nova coleta. Adicione-o ao contrato
Producte à tabelasilver_prices, exclualake/warehouse.duckdb, e execute--replay. O campo de vendedor da buy-box do script, que registra o comerciante que vence o botão padrão Add to Cart, foi adicionado desta forma. - Rejeite qualquer download que não seja HTTP 200. O endpoint de snapshot retorna HTTP 202 enquanto o trabalho ainda está em execução, como muitas APIs assíncronas fazem. Código que pula essa verificação salva a mensagem de espera como dados. O contrato então a coloca em quarentena, porque a mensagem não tem nenhum dos campos obrigatórios.
- Adicione sinalizações após a verificação do contrato, e nunca descarte linhas sinalizadas. Uma verificação de esquema detecta um preço ausente, não um preço combinado com o tamanho de pacote errado. Na saída acima, as verificações de domínio sinalizaram uma mudança de vendedor da buy-box e uma contagem de avaliações que subiu de 27 para 52. Contagens também podem cair, como de 15 para 14 em uma terceira execução, o que parece com avaliações que o site removeu.
- Mantenha um código de motivo na quarentena. Uma linha
dead_pagesignifica que a URL de entrada desapareceu, então quem possui a lista de entrada a remove. Uma linhacontract:significa que um campo estava ausente ou fora do intervalo, então um engenheiro de dados verifica a fonte. - Mantenha o fuso horário em cada carimbo de data/hora. Uma coluna sem um armazenou uma observação de 14:53 UTC como 20:23 hora local, o que quebra comparações entre fontes. Use
TIMESTAMPTZe UTC.
Antes de executar o pipeline em produção
Quem quer que use seus dados, dentro ou fora da empresa, geralmente julga cada entrega pela cobertura, atualidade, procedência e reprodutibilidade. Estas práticas sustentam essas 4 medidas:
- Envie um resumo de execução com cada entrega. Liste entradas, linhas aceitas, motivos de quarentena e sinalizações, para que os usuários possam ver exatamente o que o conjunto de dados cobre. Verifique a cobertura também contra uma referência independente, como o sitemap do site, porque as métricas de uma execução cobrem apenas as entradas que você enviou.
- Alerte contra a linha de base de cada fonte. Envie um alerta quando a taxa de aceitação de uma execução ou a taxa de preenchimento de um campo cair abaixo de sua linha de base. Cada campo precisa de sua própria linha de base, definida a partir de seu histórico recente, como uma mediana móvel das últimas 7 execuções.
- Defina uma gravidade para cada sinalização. Um agente pode usar um preço errado antes que um analista o veja. Bloqueie agentes de ler linhas com sinalizações de preço ou moeda, e envie sinalizações menos sérias, como uma pequena queda de avaliações, para uma pessoa. Verifique por amostragem uma amostra diária de linhas aceitas contra suas páginas de origem também, porque regras só detectam os erros que você previu.
- Meça as próprias verificações. Rastreie falsos positivos, falsos negativos, taxa de revisão manual e incidentes por fonte. O detector de páginas de bloqueio no teste de busca sinalizou páginas boas como bloqueadas, então cada verificação precisa de sua própria taxa de erro.
- Mantenha um único arquivo de contrato. O código de ingestão e os testes de tabela devem ler o mesmo arquivo. Ferramentas como a
datacontract-clide código aberto testam um arquivo ODCS contra tabelas diretamente. - Deixe o coletor notificá-lo. O trigger da Web Scraper API aceita uma URL de webhook em
endpointcomnotifydefinido comotrue, para que o orquestrador possa iniciar a validação quando o snapshot estiver pronto. - Orce para armazenamento bruto. Uma página Amazon de 2,4 MB foi compactada com gzip para 449 KB, então coletar 100 mil páginas brutas por dia adiciona cerca de 45 GB de armazenamento a cada dia. O registro JSON completo do mesmo produto tinha 24 KB antes da compactação, cerca de 100 vezes menor que a página. Armazene cada corpo de resposta bruto com seu status e cabeçalhos em JSON ou em um arquivo de arquivamento WARC, depois mova arquivos antigos para armazenamento frio.
Modele cada campo na granularidade que o site usa
A granularidade de uma tabela é o que uma linha representa, como uma variante de produto ou uma listagem pai. Um registro coletado parece ser uma linha, mas seus campos podem descrever coisas diferentes. Em um marketplace, o preço geralmente pertence à variante exata. Avaliações e contagens de avaliações geralmente pertencem à listagem pai que agrupa todas as cores e tamanhos.
Na listagem Amazon de um dos fones de ouvido na lista de monitoramento, o total de avaliações aparece acima das opções de cor que ele cobre:
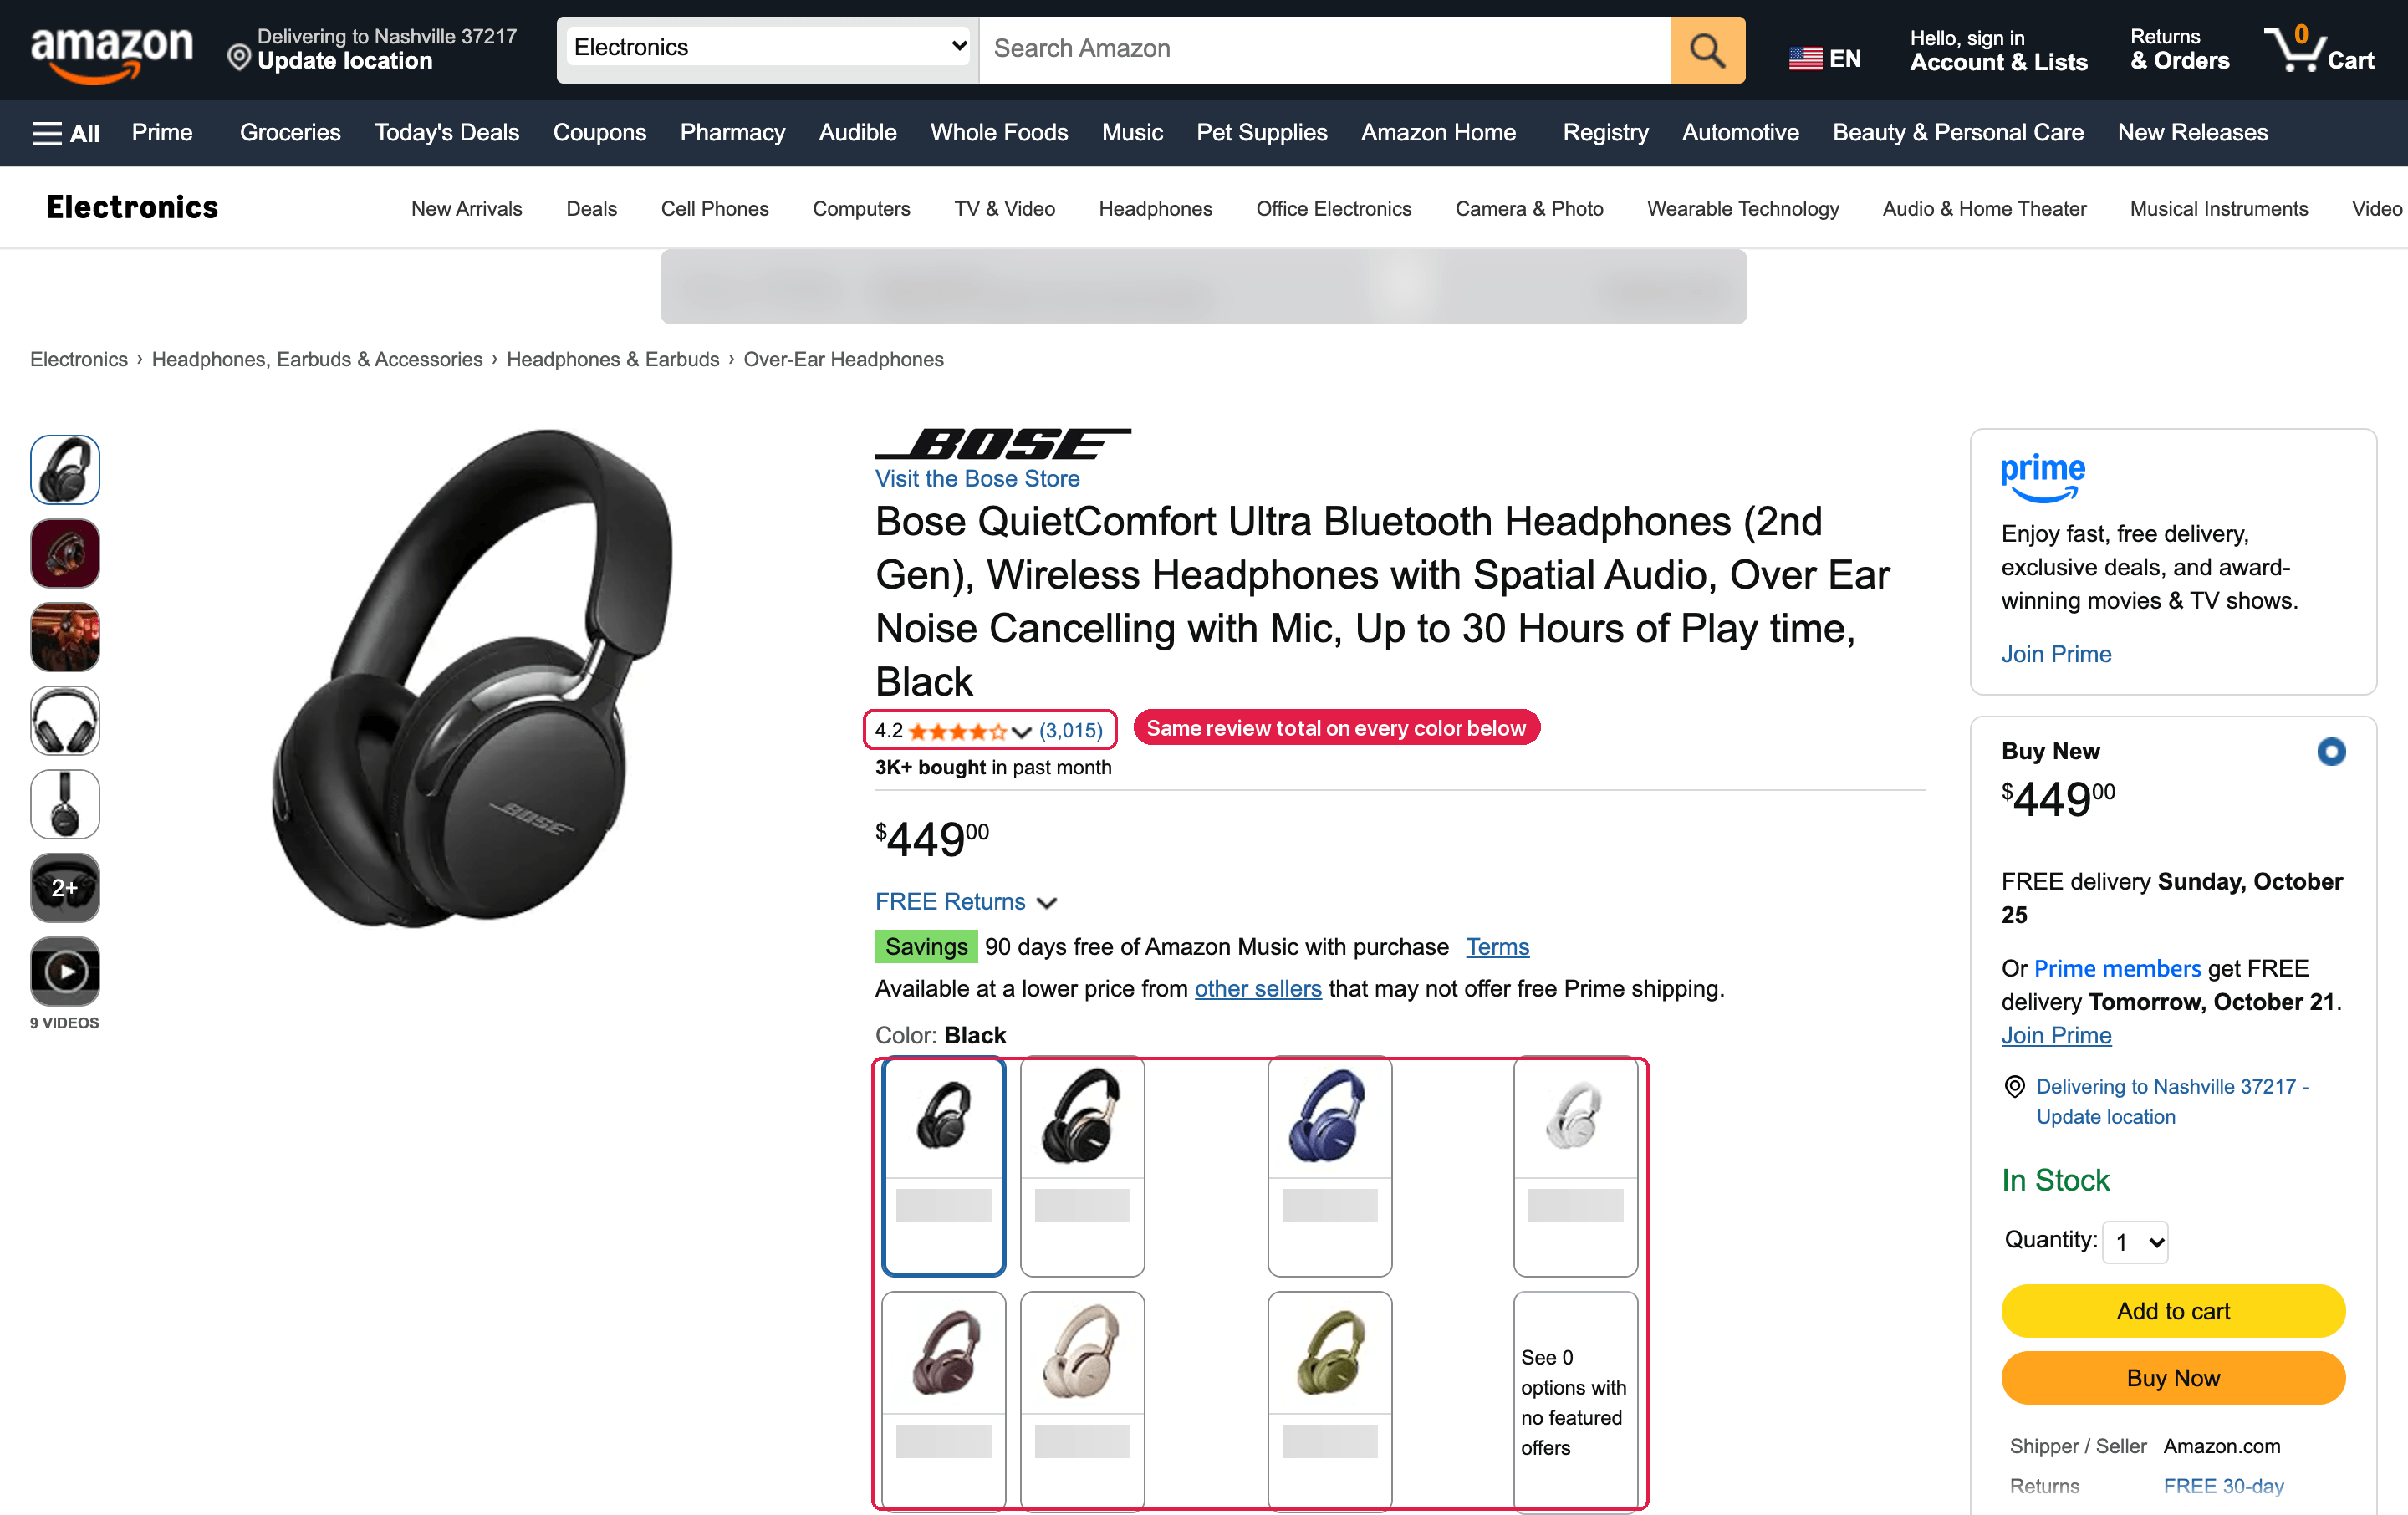
A listagem como coletada, renderizada a partir de seu HTML salvo. As 3 cores na lista de monitoramento relataram cada uma as mesmas 3.015 avaliações.
Na lista de monitoramento de 20 produtos, 11 produtos eram variantes de apenas 3 listagens pai, como 6 versões de um par de protetores auriculares. Então os 20 produtos pertenciam a apenas 12 listagens pai. Uma soma linha por linha então conta as 3.015 avaliações dos fones de ouvido Bose 3 vezes, uma vez por cor. Cada registro da Web Scraper API inclui um parent_asin, então um GROUP BY nele conta cada total de avaliações uma vez:
-- Granularidade errada: um total de avaliações por linha de variante
SELECT sum(reviews_count) AS naive_variant_sum FROM latest_prices;

-- Granularidade certa: um total de avaliações por listagem pai
SELECT sum(reviews_count) AS parent_grain_sum, count(*) AS parents
FROM gold_parent_reviews;
Em lake/warehouse.duckdb, as 2 consultas retornaram:
┌───────────────────┐
│ naive_variant_sum │
│      int128       │
├───────────────────┤
│            139537 │
└───────────────────┘

┌──────────────────┬─────────┐
│ parent_grain_sum │ parents │
│      int128      │  int64  │
├──────────────────┼─────────┤
│           113052 │      12 │
└──────────────────┴─────────┘
A soma no nível de linha superestimou a contagem de avaliações em 23%. Você também não pode armazenar o preço no nível pai, porque as variantes de protetores auriculares variaram de $12,95 a $14,99. Escreva a granularidade de cada campo no contrato de dados, e construa uma tabela gold por granularidade.
Localização também faz parte da granularidade. Ofertas e estimativas de entrega podem mudar com a localização do comprador. Defina o CEP ou país em cada entrada, e armazene-o com cada registro. O scraper de produtos Amazon recebe um zipcode em cada entrada.
O preço é frequentemente vários campos. O campo coupon_description, por exemplo, continha uma oferta de compra múltipla em 1 dos 20 produtos. Em outros 5, continha um teste gratuito do Amazon Music, que não é um desconto de preço. O selo Savings na captura de tela da Bose acima é um desses testes.
Armazene preço de lista, preço de venda, tipo de oferta e texto de cupom separadamente, e analise um cupom antes de contá-lo como um desconto. Declare os tipos também, porque JSON escreve $449 como 449, e um carregador que infere tipos de uma amostra pode tornar o preço um número inteiro.
Combine produtos entre varejistas
Uma correspondência de título pode unir um par de fones de ouvido com os fones intra-auriculares que compartilham seu nome de produto, então combine por identificadores. Mas identificadores estão frequentemente ausentes ou inconsistentes. Apenas 7 das 20 listagens Amazon exibiam um UPC (Universal Product Code) na página. A Sony também escreveu um modelo base de 2 maneiras, como WH-CH720N/P e WHCH720N/W.
Então combine em ordem de confiança. Comece com um GTIN (Global Trade Item Number), como um UPC. Em seguida, tente marca mais um número de modelo normalizado, depois uma correspondência de título com um limite de confiança. Normalize números de modelo removendo separadores e sufixos de cor.
Dos 20 produtos, apenas 6 não tinham UPC nem número de modelo, e todos os 6 eram variantes de um produto. Então apenas as correspondências de título daquele produto precisaram de revisão humana.
Defina cronogramas de atualização pela velocidade com que os dados mudam
Dados da web perdem valor em velocidades diferentes, e o cronograma de atualização deve corresponder. Até os campos de um registro mudam em velocidades diferentes. As execuções horárias da lista de monitoramento mostram o quanto:
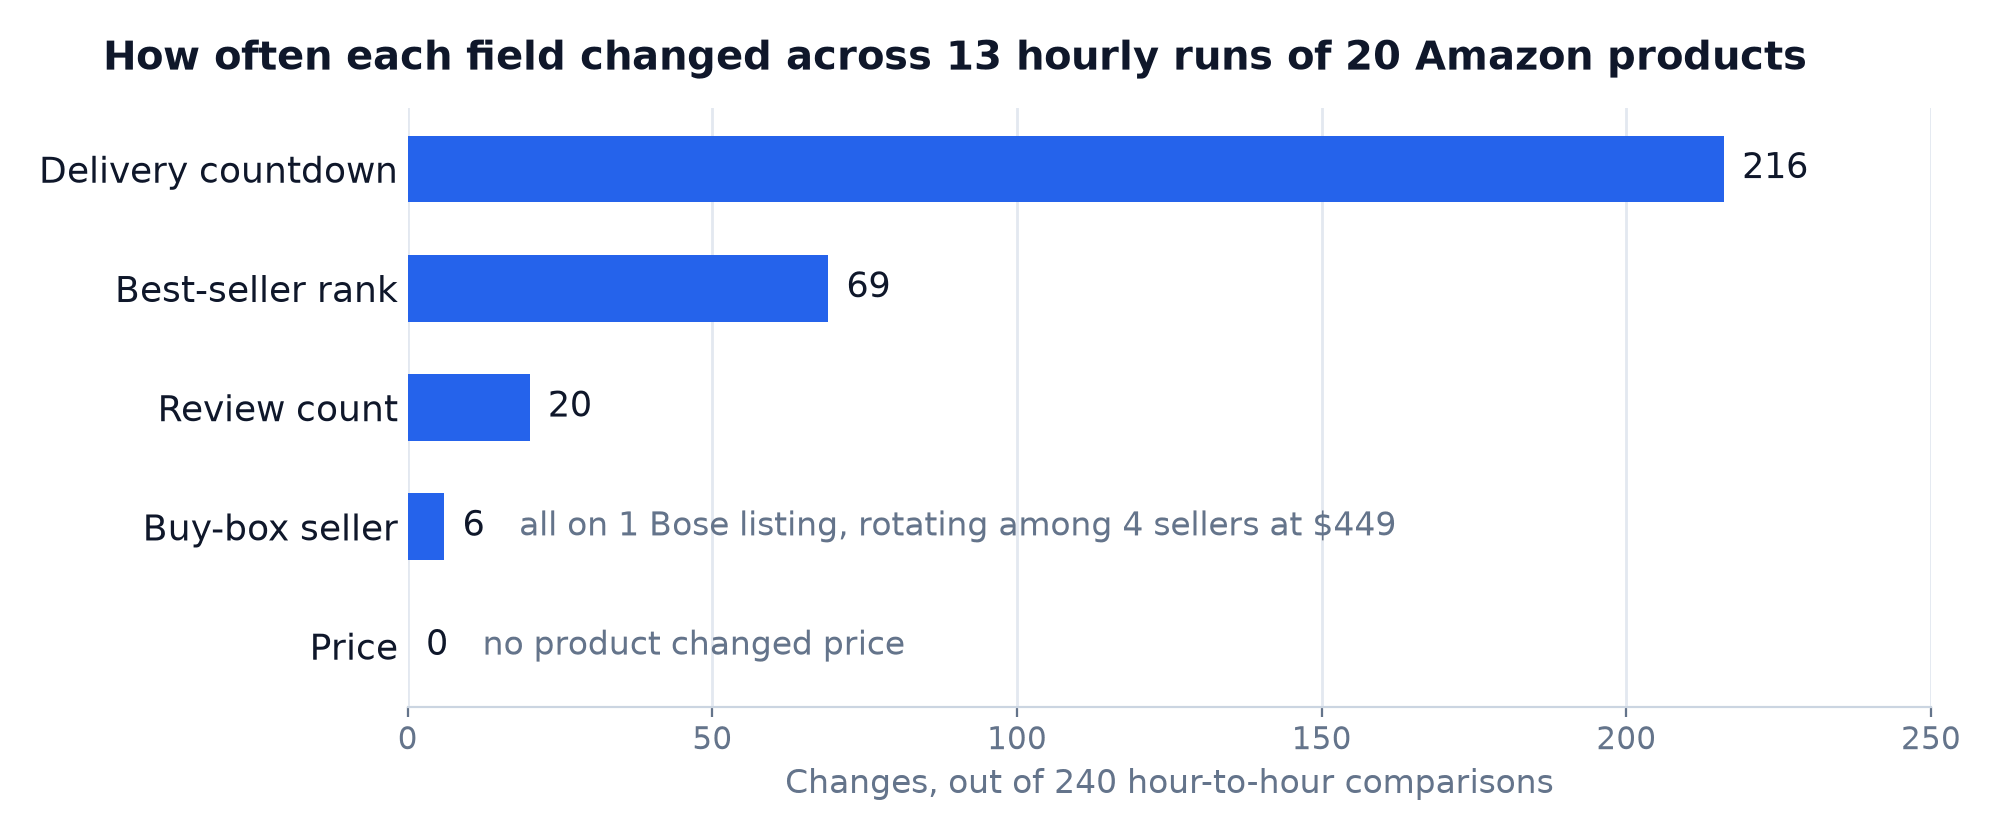
Coletado com a Web Scraper API. A contagem regressiva de entrega é a mensagem “Pedir dentro de 2 h 44 min” da Amazon.
Em uma listagem Bose, a buy box se moveu entre 4 vendedores 6 vezes enquanto o preço permaneceu em $449. Um monitor que rastreasse apenas o preço teria perdido cada mudança.
Agrupe produtos pela velocidade com que seus campos principais mudam, e dê a cada grupo seu próprio cronograma de coleta, para que o gasto vá para onde os dados mudam. Execute um pequeno trabalho várias vezes ao dia, em horários variados, em produtos onde a buy box importa, e um trabalho diário para o restante.
O crawling incremental reduz o custo da atualidade ao recoletar apenas páginas provavelmente alteradas, usando sinais como as datas lastmod em sitemaps. Após a coleta, compare um hash dos campos que seu contrato usa, para que etapas posteriores reprocessem apenas registros alterados.
No teste de busca, o hash HTML bruto diferiu em cada busca repetida. Nas 240 comparações hora a hora das execuções horárias, um hash de registro completo mudou em 239. A maioria dessas mudanças veio da contagem regressiva de entrega. Um hash dos 8 campos do contrato além do carimbo de data/hora mudou apenas 26 vezes, cada uma uma mudança real na contagem de avaliações ou vendedor da buy-box.
Uma mediana baixa de idade pode esconder alguns registros muito antigos. Então meça a atualidade como uma distribuição, com idade p50 e p99 por fonte, e alerte sobre o p99.
Arquitetura de pipeline de dados para IA e agentes
Um pipeline de IA usa as mesmas 5 etapas, geralmente com um modelo ou um agente na etapa de serviço.
Deixe uma LLM escrever parsers para fontes de alto volume
A principal questão é se um modelo de linguagem grande deve extrair dados de cada página. Uma página de produto Amazon, contada com o tokenizador o200k_base, ajuda a responder isso:
| Forma da mesma página de produto | Bytes | Tokens |
|---|---|---|
| Página completa como HTML bruto | 2.446.738 | 911.129 |
| Página completa como markdown | 236.088 | 97.977 |
| Apenas conteúdo principal, extraído do HTML bruto | 17.339 | 3.252 |
| Registro JSON completo, todos os campos | 23.923 | 7.692 |
| Registro JSON reduzido (12 campos) | 501 | 171 |
Markdown de página completa serve para um agente lendo uma página, mas em alto volume, equipes geralmente reduzem páginas ao seu conteúdo principal antes da extração. Reduzida desta forma, a página ainda usou 19 vezes mais tokens que o registro de 12 campos. A um exemplo de $0,10 por 1 milhão de tokens de entrada, 100 mil dessas páginas por dia custam cerca de $33 em entrada de modelo. Ler os registros de 12 campos em vez disso custaria cerca de $2.
Ambos os números excluem a coleta, que cada caminho paga a uma taxa diferente. Então compare o custo total, não apenas o custo de tokens. O conteúdo principal extraído abria com uma venda adicional de garantia, e um modelo lendo-o ainda pode escolher o preço ou variante errado. Um registro da Web Scraper API entrega preço e variante como campos separados, então nenhum modelo precisa escolhê-los do texto da página.
Escolha a abordagem pelo volume e risco. Para uma fonte coletada milhares de vezes por dia, use o modelo para escrever o parser e corrigi-lo quando quebrar. Código comum então executa esse parser em cada página e retorna a mesma saída para a mesma página. O Scraper Studio executa este padrão como um serviço, construindo um scraper a partir de um prompt em linguagem natural, com autocorreção de um clique quando o site muda.
Para sites de baixo volume cujos layouts mudam frequentemente, a extração por LLM por página pode custar menos do que manter um parser. De qualquer forma, verifique a saída contra o mesmo contrato.
Quando a validação falha, um agente de codificação pode propor uma correção de parser e reprocessá-la nas páginas brutas na camada bronze. O reprocessamento mostra quantas linhas em quarentena a correção recupera e se alguma linha aceita mudou, e um humano revisa ambas antes de mesclar.
Sirva agentes a partir de tabelas validadas
Para agentes, uma busca ao vivo é mais arriscada do que uma leitura de tabela, porque uma busca bloqueada pode interromper a tarefa de um agente enquanto um usuário espera. Em setembro de 2026, por exemplo, a Cloudflare mudou os padrões para domínios recém-adicionados para bloquear agentes de IA e bots de treinamento em páginas que exibem anúncios. Então sirva agentes a partir de tabelas validadas primeiro, através de uma interface MCP que inclui as regras de uso do contrato.
Agentes também precisam de uma verificação de injeção de prompt, porque o texto da página, incluindo campos de avaliação e título em suas tabelas, pode conter instruções direcionadas a um agente. Para leituras ao vivo, o MCP Server da Bright Data tem um portão de conteúdo, ativado por padrão. Ele pede ao usuário para confirmar antes de retornar texto de página que parece instruções para mudar a configuração do servidor.
Rastreie respostas de IA como uma fonte de dados
Assistentes de IA também são uma fonte de dados, porque suas respostas podem chegar a um comprador antes de qualquer resultado de busca. Em um teste, a primeira recomendação do ChatGPT para a mesma pergunta de compra foi Bose em 3 de 5 execuções e Sony em 2. Então amostre cada prompt várias vezes, e mantenha o país o mesmo em cada execução para que os resultados permaneçam comparáveis. Os scrapers de chat de IA da Web Scraper API coletam respostas do ChatGPT, Copilot, Gemini, Perplexity e Grok, com suas citações como JSON estruturado.
Construir ou comprar a camada de coleta
A maioria da infraestrutura de pipeline de dados, incluindo armazenamento, transformação e orquestração, roda em ferramentas bem estabelecidas. Coleta de sites protegidos é diferente, porque precisa mudar sempre que navegadores e defesas anti-bot mudam.
Compare custos por registro aceito, não por solicitação. O Web Unlocker cobra apenas por resultados bem-sucedidos, e a Web Scraper API apenas por registros entregues. Divida o gasto total pelos registros que passam no seu contrato.
No lado da construção, inclua as horas de engenheiro gastas em proxies, correções de parser e desbloqueio. Em ambos os lados, conte o que uma entrega ruim custa, como uma decisão de reprecificação baseada em preços errados.
Compare coletores em suas próprias URLs
Obtenha esses custos de um benchmark, da maneira como muitas equipes de compra avaliam fornecedores em uma prova de conceito. Execute seu coletor atual e cada candidato nas mesmas URLs por vários dias, da rede e na concorrência que seu pipeline realmente usa. Compare cada candidato nas mesmas medidas:
| Medida | Como contá-la |
|---|---|
| Registros aceitos | Linhas que passam no seu contrato de dados, por fonte |
| Falhas por motivo | Bloqueios, desafios e respostas de sucesso que falham na sua verificação de conteúdo, como páginas vazias ou de região errada |
| Custo por 1.000 registros aceitos | Todo o gasto, incluindo novas tentativas, proxies e as horas de engenheiro abaixo, por 1.000 linhas aceitas |
| Latência | Tempo p50 e p95 de entrega, para trabalhos em batch e buscas ao vivo |
| Horas de engenheiro | Tempo gasto em bloqueios, correções de parser e alertas durante o teste |
Os créditos gratuitos mensais da Bright Data podem cobrir um primeiro teste em uma amostra das suas URLs.
Decida por fonte
Decida para cada fonte separadamente, porque um pipeline geralmente mistura sites não protegidos e protegidos. Conte um site como protegido quando seu próprio cliente falha na verificação de conteúdo durante o benchmark:
| Situação | Construir | Comprar |
|---|---|---|
| Alguns sites não protegidos, coletados ocasionalmente | Sim | Comece com créditos gratuitos, depois mude para pagamento conforme o uso conforme o volume cresce |
| Sites protegidos, coletados em um cronograma | Apenas com uma equipe que rastreia lançamentos de navegadores, e geralmente com proxies residenciais | Web Unlocker ou Browser API lida com o acesso, então sua equipe apenas escreve os parsers |
| Sites onde você precisa de registros, não páginas | Frequentemente não vale a pena, a menos que o site seja central ao seu produto | A Web Scraper API retorna JSON estruturado, e o Scraper Studio constrói scrapers personalizados a partir de um prompt |
| Dados que você precisa mas não precisa coletar você mesmo | Não | Conjuntos de dados, atualizados em um cronograma apenas com registros novos ou atualizados, ou a Web Archive API para páginas já coletadas |
| Agentes que navegam ou buscam ao vivo | Apenas para pequenas ferramentas internas | MCP Server, que usa a API SERP e o Web Unlocker |
Um contrato de dados também torna fácil mudar o coletor, então experimentar um novo é de baixo risco. Tabelas downstream, sinalizações e alertas dependem apenas dos campos do contrato. Mudar significa conectar a etapa de coleta a um novo coletor e reexecutar o benchmark em suas próprias URLs. Continue rastreando a taxa de aceitação de cada fonte, porque sites mudam suas defesas ao longo do tempo.
Para planejamento de orçamento, a página de preços da Web Scraper API lista as taxas atuais de pagamento conforme o uso e planos de volume. O guia de métricas de qualidade de dados ajuda a definir “aceito” antes de comparar custos.
Conformidade e procedência
Colete apenas dados públicos, sem fazer login e em taxas de solicitação que cada site possa suportar. Colete dados pessoais apenas onde você tem uma base legal, e verifique o status de direitos autorais de qualquer coisa que você republique ou use para treinamento.
Mantenha a procedência com cada registro, incluindo URL de origem, hora de coleta, método, versão de código e os termos de serviço que se aplicavam. Então você pode mostrar onde e como qualquer registro foi coletado.
A Bright Data possui certificação ISO 27001 e um relatório SOC 2 Type II, ambos listados em sua visão geral de segurança.
Como os testes foram executados
Todo teste rodou contra sites e serviços ao vivo, que mudam com o tempo:
| Teste | Configuração |
|---|---|
| Teste de busca | Cada um dos 4 clientes de código aberto buscou 13 páginas de busca e listagem 3 vezes. Os clientes foram Python requests com cabeçalhos padrão, requests com cabeçalhos Chrome, curl_cffi com seu alvo Chrome 150, e Chrome headless 155 através do Playwright. Todos rodaram de uma conexão de internet doméstica na Índia, sem proxies. Uma resposta foi contada como dados quando tinha os padrões HTML que marcam as listagens do site, e um detector separado verificou 8 assinaturas de página de bloqueio. Uma nova execução headless com um User-Agent normal buscou cada página 2 vezes. |
| Verificação de impressão digital | Handshakes TLS do Web Unlocker, Python requests, curl_cffi (alvo Chrome 150), e Chrome 155 instalado, comparados em tls.peet.ws |
| Busca de agente | As mesmas 13 URLs, uma execução através da ferramenta WebFetch que agentes Claude Code usam |
| Pipeline de referência | 20 produtos Amazon mais 1 ID deliberadamente inválido, Web Scraper API, 2 execuções com cerca de 2 horas de diferença e uma terceira cerca de 17 horas depois |
| Execuções horárias | Os mesmos 20 produtos, 13 execuções com uma hora de diferença, 240 comparações hora a hora |
| Descoberta | Uma busca no Google por um modelo de fone de ouvido através da API SERP |
| Contagens de tokens | Uma página de produto Amazon através do Web Unlocker (HTML e markdown) e da Web Scraper API (JSON), tokenizador o200k_base, conteúdo principal extraído com trafilatura 2.3 |
| Respostas de IA | Uma pergunta de compra ao ChatGPT através da Web Scraper API, 5 execuções sem país definido |
Considerações finais
Quando um pipeline de dados coleta de sites públicos, uma resposta pode ter um status de sucesso e nenhum dado, e um registro pode misturar várias granularidades.
Armazene dados brutos inalterados, verifique o conteúdo contra um contrato de dados, sinalize mudanças incomuns, e reprocesse qualquer correção de parser que um agente propõe antes de mesclá-la. Se a camada de coleta custar mais em tempo de engenheiro do que em solicitações, a Web Scraper API pode executar essa etapa para sua equipe. Comece executando uma verificação de conteúdo em sua fonte menos confiável, e conte quantas de suas respostas de sucesso contêm registros utilizáveis. Então execute as mesmas URLs através do Web Unlocker ou da Web Scraper API em uma conta gratuita Bright Data, e compare o custo por registro aceito.
Perguntas frequentes
O que são data pipes?
“Data pipes” é um nome informal para pipelines de dados, os sistemas que movem dados de suas fontes para as ferramentas que os usam. Um típico coleta, armazena, verifica, transforma e serve dados. A arquitetura de pipeline de dados é seu design, que define as etapas, as ferramentas e as verificações entre elas.
O que é pipelining de dados?
Pipelining de dados é a prática de construir e executar pipelines de dados, que movem dados de fontes para as ferramentas que os usam. O trabalho cobre coletar, armazenar, verificar, transformar e servir dados, além de programar e monitorar cada etapa. Não é o mesmo que pipelining de instruções em CPUs, que sobrepõe etapas do processador dentro de um chip.
Quais são as 5 etapas de um pipeline de dados?
As 5 etapas de um pipeline de dados típico são coletar, armazenar bruto, validar, transformar e servir. A coleta extrai dados de fontes, e o armazenamento bruto os mantém inalterados. A validação os verifica contra um contrato de dados, a transformação os modela em tabelas, e o serviço os entrega a dashboards, modelos ou agentes.
O que é uma arquitetura de pipeline de dados moderna?
Uma arquitetura de pipeline de dados moderna geralmente armazena dados brutos em armazenamento de objetos e mantém tabelas em um formato aberto como o Apache Iceberg. Ela transforma dados com uma ferramenta como o dbt e programa etapas com um orquestrador como o Airflow. Um contrato de dados controla o que entra nas tabelas, e agentes podem lê-las através do Model Context Protocol (MCP).
Quais são alguns exemplos de pipelines de dados?
Um lote noturno de preços de concorrentes carregado em um warehouse é um exemplo comum. Um stream de postagens sociais processado em minutos para monitoramento de marca é outro. Um híbrido mantém histórico diário e transmite mudanças para uma lista curta de monitoramento, e um pipeline sob demanda busca dados ao vivo quando um agente pergunta. Todos os 4 usam as mesmas 5 etapas.
A IA pode criar pipelines de dados?
Sim, um agente de codificação pode escrever a maior parte do código de um pipeline enquanto um humano revisa cada mudança. Para coleta, o Scraper Studio da Bright Data constrói um scraper a partir de um prompt em linguagem natural. A extração por LLM por página funciona se cada saída passar no contrato de dados, mas usa mais tokens. O conteúdo principal de uma página Amazon tinha 3.252 tokens, contra 171 para um registro de 12 campos.
O que é um pipeline de ingestão de dados?
Um pipeline de ingestão de dados, a primeira parte de um pipeline de dados, coleta e armazena dados de fontes. Fontes web precisam de uma verificação de conteúdo. Em um teste de clientes de código aberto em 13 sites, 39 de 88 respostas de sucesso não tinham dados. Para sites com defesas anti-bot, o Web Unlocker da Bright Data retorna a página, ou a Web Scraper API retorna registros estruturados.
O que é um pipeline de big data?
Um pipeline de big data é um pipeline de dados construído para volumes onde armazenamento e computação devem escalar separadamente. Geralmente armazena dados em armazenamento de objetos e os mantém em formatos de tabela abertos como o Apache Iceberg ou o Delta Lake. Mecanismos distribuídos como o Spark ou o Flink os processam.