O Yahoo Finance oferece cotações gratuitas, histórico de preços, demonstrações financeiras e estimativas de analistas, mas não tem API oficial. Suas páginas de cotação contêm esses dados como JSON dentro do HTML, então um pipeline Python pode lê-los sem um navegador.
Código de muitos tutoriais antigos falhava de 2 formas. Com seu User-Agent padrão, a biblioteca requests do Python recebia 429 Too Many Requests na primeira solicitação. Quando uma solicitação tinha sucesso, os seletores antigos não encontravam nada ou retornavam o preço do S&P 500 em vez do da ação.
Este guia mostra como fazer scraping do Yahoo Finance a partir desse JSON, evitar o 429 e migrar para um servidor.
Resumo
- O 429 do Yahoo na primeira solicitação depende do cliente, não da taxa de solicitações. Personificando o Chrome, o curl_cffi solicitou 503 páginas de cotação do S&P 500 sem um 429.
- Uma única solicitação retorna o histórico completo de preços de um ticker. Com period1=0, a aba de dados históricos da MSFT retornou cada barra diária desde 1986.
- Valide cada página, mesmo quando retorna 200. FB, o antigo símbolo da Meta, retornou um ETF da ProShares, e o preço de Londres da Vodafone estava em pence.
- Migre para um servidor trocando a função de busca. O Web Unlocker API da Bright Data adiciona rotação de IP e novas tentativas automáticas. Ou a Yahoo Finance Scraper API da Bright Data retorna registros estruturados.
Onde o Yahoo Finance guarda seus dados
Os números em uma página de cotação estão embutidos como JSON dentro do seu HTML. O Yahoo renderiza as páginas no servidor com SvelteKit, um framework JavaScript, e chama suas próprias APIs JSON durante a renderização. O SvelteKit insere cada resposta no HTML, para que o navegador possa reutilizá-la sem buscá-la novamente. Cada resposta está em sua própria tag script, que tem um atributo data-sveltekit-fetched e a URL da API de origem em data-url.
Uma tag da aba de resumo da MSFT se parece com isto, com seu corpo JSON abreviado:
<script type="application/json" data-sveltekit-fetched
data-url="https://query1.finance.yahoo.com/v1/finance/quoteType/MSFT?formatted=true&enablePrivateCompany=true&overnightPrice=true&lang=en-US&region=US"
data-hash="1ibomen" data-ttl="1800">
{"status":200,"statusText":"","headers":{"cache-control":"public, max-age=1800, stale-while-revalidate=1800"},"body":"{\"quoteType\":{\"result\":[{\"symbol\":\"MSFT\",\"quoteType\":\"EQUITY\",\"exchange\":\"NMS\",\"longName\":\"Microsoft Corporation\"}],\"error\":null}}"}
</script>O campo body contém a resposta da API como uma string JSON. Fazer o parsing de uma tag precisa de 2 chamadas json.loads(). A primeira chamada faz o parsing do invólucro, e a segunda faz o parsing da string body. Cada aba de uma página de cotação embute um conjunto diferente de respostas de API:
| Aba | Resposta da API embutida | O que você pode ler dela |
|---|---|---|
/quote/MSFT/ |
v10/finance/quoteSummary e v7/finance/spark |
Preço, capitalização de mercado, P/L, dividendo, faixa de 52 semanas, metas de preço de analistas, até 24 horas de fechamentos de 5 minutos |
/quote/MSFT/history/ |
v8/finance/chart |
Preços diários, semanais ou mensais, fechamento ajustado, desdobramentos, dividendos |
/quote/MSFT/financials/, balance-sheet/, cash-flow/ |
ws/fundamentals-timeseries |
Itens anuais e dos últimos 12 meses |
/quote/MSFT/analysis/ |
v10/finance/quoteSummary com earningsTrend |
Estimativas de LPA e receita, contagem de analistas, surpresas de lucros |
/quote/MSFT/key-statistics/ |
ws/fundamentals-timeseries |
Capitalização de mercado trimestral, valor da empresa e índices de avaliação |
/quote/MSFT/profile/ |
v10/finance/quoteSummary com assetProfile |
Principais executivos, número de funcionários, setor, registros na SEC |
/quote/MSFT/holders/ |
v10/finance/quoteSummary com módulos de propriedade |
Detentores institucionais, de fundos e internos |
/quote/MSFT/options/ |
v7/finance/options |
A cadeia de opções para o vencimento mais próximo, além da lista de datas de vencimento |
Os hosts de API do Yahoo, query1.finance.yahoo.com e query2.finance.yahoo.com, servem o mesmo JSON, e a biblioteca de código aberto yfinance os chama diretamente. Nesses hosts, os endpoints quote, quoteSummary e options retornaram 401 quando uma solicitação não tinha crumb. Um crumb é um token que o Yahoo emite com cada cookie de sessão e espera como parâmetro de consulta crumb=.
O antigo download CSV retornou 401 User is not logged in. Em ambos os hosts de API, o robots.txt desautoriza todos os caminhos (Disallow: /). As respostas embutidas na página de cotação não precisam de cookie, crumb ou acesso ao host de API:
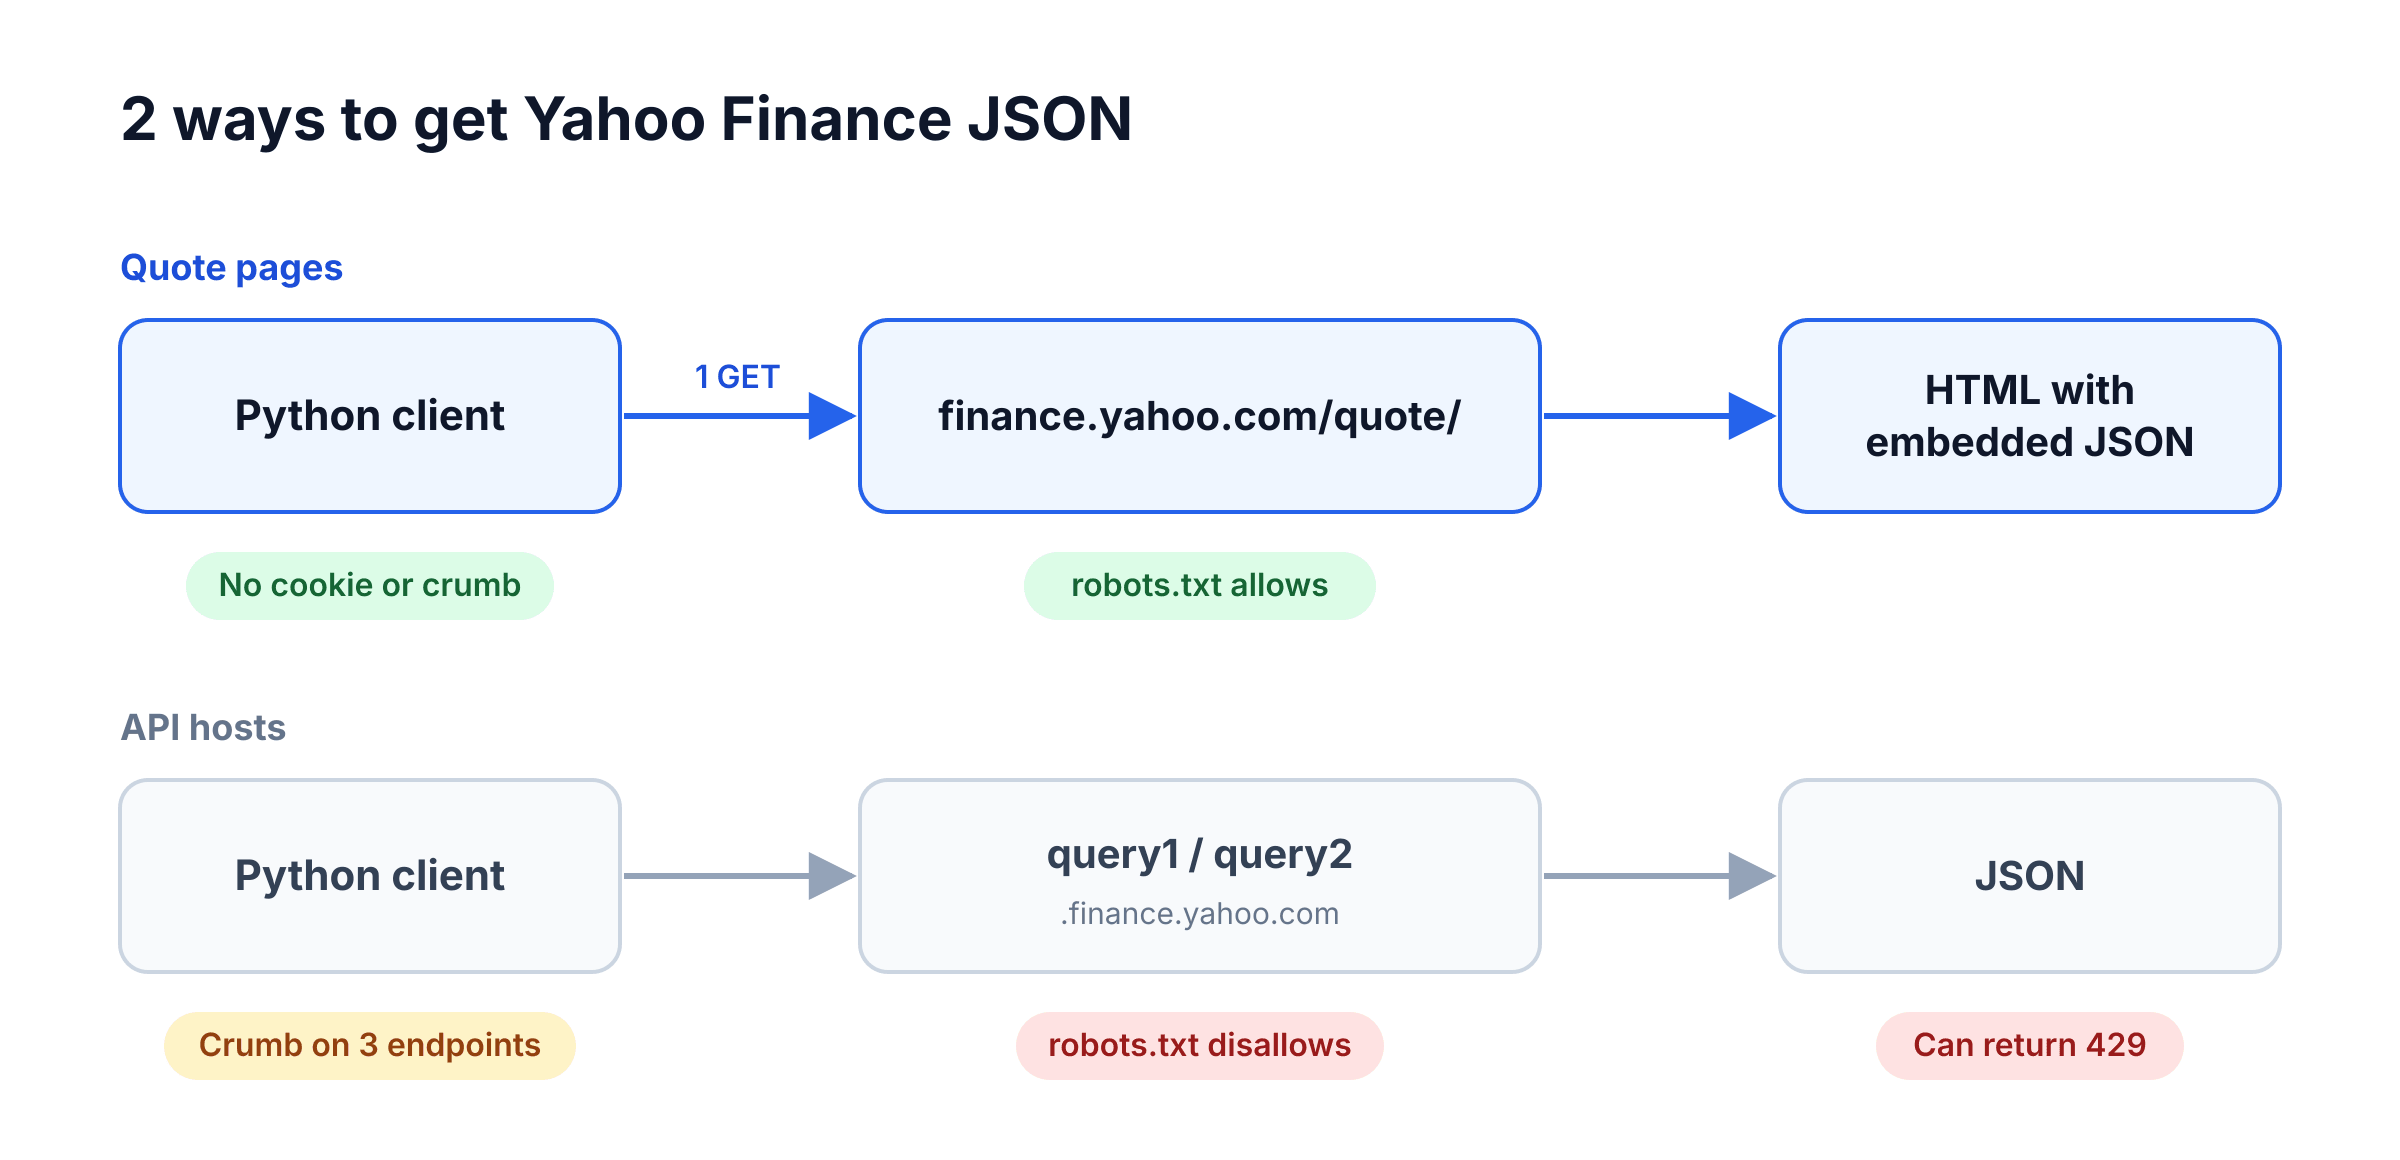
Os scripts leem apenas as páginas de cotação, então nunca chamam os hosts de API.
Muitos tutoriais antigos lêem preços com seletores CSS que não funcionam mais. Na página da MSFT, [data-symbol="MSFT"][data-field="regularMarketPrice"] e #quote-summary [data-test="PREV_CLOSE-value"] não encontraram nenhum elemento. O seletor menos específico fin-streamer[data-field="regularMarketPrice"] encontrou 9, e o primeiro resultado continha o preço do S&P 500 do resumo de mercado da página.
Outros tutoriais automatizam um navegador. O JSON embutido torna um navegador desnecessário para cotações, histórico diário, demonstrações anuais e estimativas, porque 1 solicitação HTTP por aba retorna os mesmos dados.
Se você usar um navegador, leia a resposta HTML bruta, porque o código do lado do cliente do SvelteKit remove cada tag script após lê-la. Em 2 de 4 carregamentos de página testados, page.content() retornou a página sem as tags. Em 1 deles, o scraper leu a página assim que o DOMContentLoaded disparou.
Por que o Yahoo Finance pode retornar 429 na primeira solicitação
As respostas do Yahoo dependiam do User-Agent do cliente e do handshake TLS, então um cliente pode receber um 429 na primeira solicitação. O cabeçalho server: ATS nas respostas identifica o Apache Traffic Server. Com suas configurações padrão, a biblioteca requests do Python recebeu um 429 na primeira solicitação. As respostas 429 tinham 2 formas:
- Com o User-Agent padrão
python-requests/2.34.2, toda pilha TLS na tabela abaixo recebeu uma respostaEdge: Too Many Requestsde 23 bytes. A biblioteca requests do Python recebeu a mesma resposta emfinance.yahoo.com. - Nos hosts de API, alguns User-Agents de navegador sobre a pilha TLS do Python receberam uma resposta
Too Many Requestsde 19 bytes.
A tabela mostra como o query1, o host de API que o yfinance usa, respondeu a solicitações de gráfico enviadas de 1 conexão residencial com pelo menos 1,5 segundo de intervalo. A biblioteca curl_cffi, um cliente HTTP Python, pode personificar o handshake TLS de um navegador. Cada linha combina uma pilha TLS com um cabeçalho User-Agent:
| Pilha TLS | Cabeçalho User-Agent | Recebeu 429 |
|---|---|---|
| Python requests (OpenSSL) | python-requests/2.34.2, o padrão |
5 de 5 |
| Python requests (OpenSSL) | Chrome 140 no macOS | 26 de 26 |
| Python requests (OpenSSL) | Firefox 147 no Windows | 16 de 17 |
| Python requests (OpenSSL) | Safari 26 no macOS | 8 de 11 |
| Python requests (OpenSSL) | Chrome 150 no macOS | 3 de 6 |
| Python requests (OpenSSL) | Chrome 150 no Windows | 0 de 11 |
| Python requests (OpenSSL) | Mozilla/5.0 sozinho |
0 de 11 |
| curl_cffi (handshake Chrome, Firefox ou Safari) | Chrome 140 ou 150, Firefox 147, Safari 26, ou Mozilla/5.0 |
0 de 80 |
| curl_cffi (mesmos 3 handshakes) | python-requests/2.34.2 |
15 de 15 |
Por que o handshake TLS importa?
A resposta do Yahoo dependia da pilha TLS, mesmo quando o User-Agent era o mesmo. Em um teste controlado, requests e curl_cffi enviaram o mesmo User-Agent (Chrome 140 no macOS) e cabeçalho Accept sobre HTTP/1.1 do mesmo endereço IP. Apenas o cliente HTTP e sua pilha TLS mudaram. Através da biblioteca requests do Python, 0 de 8 solicitações tiveram sucesso, e através da pilha TLS Chrome do curl_cffi, 8 de 8 tiveram.
As 2 pilhas já diferem antes de qualquer cabeçalho ser enviado. Uma impressão digital JA4, uma forma comum de fingerprinting TLS, resume o ClientHello, a primeira mensagem que um cliente envia em um handshake TLS. O handshake OpenSSL do Python produziu t13d1812h1_85036bcba153_b26ce05bbdd6, e o alvo chrome do curl_cffi produziu t13d1516h2_8daaf6152771_806a8c22fdea, que corresponde aos conjuntos de cifras do Chrome. Solicite https://tls.peet.ws/api/all do seu próprio cliente para ver o que ele envia.
Cada resultado dependia da combinação de pilha TLS e User-Agent. A string Mozilla/5.0 sozinha teve sucesso 11 de 11 vezes sobre o TLS do Python. O Chrome 140 no macOS falhou 26 de 26 vezes, e o Firefox 147 falhou 16 de 17 vezes. Então um User-Agent de navegador realista pode fazer a biblioteca requests do Python falhar com mais frequência.
Com um handshake TLS de navegador do curl_cffi, os User-Agents de navegador na tabela tiveram sucesso em 80 de 80 solicitações. Em um teste menor, o próprio finance.yahoo.com aceitou a string Chrome 140 sobre o TLS do Python e bloqueou a string padrão python-requests. O código do scraper usa curl_cffi em finance.yahoo.com também, então o User-Agent e o handshake TLS correspondem ao Chrome.
Se você enviar um User-Agent de navegador, envie um handshake TLS de navegador junto.
A taxa de solicitações importa?
Não para os 429s nas primeiras solicitações, que dependem do cliente. Com 8 threads, o curl_cffi solicitou todas as 503 páginas de cotação do S&P 500, depois 501 páginas de dados históricos, sem um 429. Esse é o volume de uma atualização diária do S&P 500. Se um 429 aparecer com volume maior, o código do scraper recua e tenta novamente.
Um trecho de limitação de taxa postado no rastreador de issues do yfinance limita o tráfego a 60 solicitações por minuto, 360 solicitações por hora e 8.000 solicitações por dia. Esses números vêm da página de limite de taxa da API DSP Traffic do Yahoo. Yahoo DSP é uma plataforma do lado da demanda para comprar anúncios, então o trecho usa os limites de outro produto.
A biblioteca yfinance também recebeu erros 429 do Yahoo, que levantou como YFRateLimitError('Too Many Requests. Rate limited. Try after a while.'). Após uma thread de issue sobre erros 429 receber mais de 140 comentários, os mantenedores do yfinance adotaram a mesma correção: um handshake TLS de navegador. A versão 0.2.58 (2025) migrou a biblioteca para curl_cffi, e a versão 1.7.0 cria sua sessão padrão com impersonate="chrome".
O código funciona a partir de um servidor em nuvem?
Sim, em 3 executores do GitHub Actions com endereços IP da Microsoft Azure. Em cada executor, a primeira solicitação do curl_cffi retornou uma página de cotação para cada um dos 20 símbolos, de ações e ETFs dos EUA a criptomoedas e listagens estrangeiras. Em uma segunda execução, cada executor solicitou todas as 503 páginas de cotação do S&P 500 sem um 429.
Os scripts retornaram o mesmo histórico, demonstrações e estimativas que retornaram em casa. Nos executores, a biblioteca requests do Python com seu User-Agent padrão recebeu a mesma resposta 429 de 23 bytes, enquanto o yfinance buscou o histórico diário completo da MSFT.
Falhas relatadas em nuvem envolveram clientes mais antigos e faixas de IP compartilhadas, então teste os scripts a partir do seu próprio servidor antes de agendar uma tarefa. Em 2025, antes de o yfinance migrar para curl_cffi, seus mantenedores removeram sua tarefa de teste do GitHub Actions após ela falhar ao buscar dados do Yahoo. Outro desenvolvedor rastreou respostas 401 “Invalid Crumb” até a faixa de IP compartilhada do nível gratuito do Render, uma plataforma em nuvem. As mesmas chamadas funcionaram a partir de um IP residencial.
Extraia o JSON embutido de uma página de cotação
Você precisa do Python 3.11 ou posterior e 5 pacotes. O código foi testado no Python 3.11, 3.13 e 3.14 com curl_cffi 0.16.3, beautifulsoup4 4.15.0, lxml 6.1.3, pandas 3.0.6 e requests 2.34.2. Instale-os com pip:
pip install curl_cffi beautifulsoup4 lxml pandas requestsPara fundamentos de scraping em Python, veja nosso guia de scraping de dados com Python. O módulo principal busca uma única aba, verifica se o Yahoo retornou uma página de cotação e retorna as respostas embutidas indexadas pela URL de sua API. Salve-o como yahoo_embedded.py, porque os scripts que leem as páginas do Yahoo dependem dele:
import json
import random
import threading
import time
from urllib.parse import quote

from bs4 import BeautifulSoup
from curl_cffi import requests

QUOTE_URL = "https://finance.yahoo.com/quote"
_local = threading.local()


class SymbolNotFound(Exception):
    """O Yahoo retornou sua página de busca ou um soft 404 em vez de uma página de cotação."""


def page_url(symbol: str, tab: str = "") -> str:
    return (
        f"{QUOTE_URL}/{quote(symbol.upper(), safe='')}/{tab}"  # ^GSPC vira %5EGSPC
    )


def embedded(html: str) -> dict[str, dict]:
    """Mapeia as URLs de API a partir das quais a página foi renderizada para seus corpos JSON."""
    soup = BeautifulSoup(html, "lxml")
    found = {}
    for tag in soup.select('script[type="application/json"][data-sveltekit-fetched]'):
        try:
            wrapper = json.loads(tag.string)
            found[tag["data-url"]] = json.loads(wrapper["body"])
        except (TypeError, KeyError, ValueError):
            continue  # uma resposta embutida cujo corpo não é JSON
    return found


def pick(found: dict[str, dict], path: str) -> dict:
    """Retorna a primeira resposta embutida cuja URL contém `path`."""
    for url, body in found.items():
        if path in url:
            return body
    raise LookupError(f"nenhuma resposta embutida para {path}")


def is_quote_page(html: str, symbol: str) -> bool:
    """True para uma página de cotação, False caso contrário, SymbolNotFound para um símbolo desconhecido."""
    found = embedded(html)
    if any("/v1/finance/lookup" in url for url in found):
        raise SymbolNotFound(symbol)
    for url, body in found.items():
        if "/v1/finance/quoteType/" in url:
            result = (body.get("quoteType") or {}).get("result") or [{}]
            if not result[0].get("exchange"):
                # Um soft 404, como para BRK.B (o Yahoo escreve BRK-B)
                raise SymbolNotFound(symbol)
            return True
    return False


def _session() -> requests.Session:
    # Uma sessão personificando o Chrome por thread, como o curl_cffi recomenda.
    if not hasattr(_local, "session"):
        _local.session = requests.Session(impersonate="chrome")
    return _local.session


def fetch_page(
    symbol: str, tab: str = "", params: dict | None = None, attempts: int = 4
) -> str:
    """Retorna o HTML de uma página de cotação, por exemplo tab="history/"."""
    for attempt in range(attempts):
        if attempt:
            time.sleep(2**attempt + random.random())  # recua antes de cada nova tentativa
        try:
            response = _session().get(
                page_url(symbol, tab), params=params, timeout=30, allow_redirects=False
            )
        except requests.RequestException:
            continue  # timeout ou conexão interrompida
        if response.is_redirect:
            location = response.headers.get("location", "")
            if "/lookup" in location:
                raise SymbolNotFound(symbol)
            # Por exemplo, uma aba que não existe
            raise LookupError(f"{symbol} {tab}: Yahoo redirecionou para {location}")
        if response.status_code == 200 and is_quote_page(response.text, symbol):
            return response.text
        if 400 <= response.status_code < 500 and response.status_code != 429:
            response.raise_for_status()
    # Toda tentativa expirou ou recebeu um 429, um 5xx, ou uma página sem dados de cotação
    raise RuntimeError(f"{symbol} {tab}: sem dados de cotação após {attempts} tentativas")


if __name__ == "__main__":
    from urllib.parse import urlsplit

    found = embedded(fetch_page("MSFT"))
    print(len(found), "respostas embutidas")
    for url in found:
        if url.startswith("https://"):
            print(urlsplit(url).netloc, urlsplit(url).path)
O módulo lida com 3 casos extremos:
allow_redirects=Falsepara o cliente em um redirecionamento em vez de segui-lo. Um 302 para/lookup/significa um símbolo desconhecido, então o módulo levantaSymbolNotFound. Ele não busca a página de busca, que o robots.txt desautoriza. Qualquer outro redirecionamento, como uma aba que um ETF não tem, levantaLookupErrorna primeira tentativa.is_quote_page()verifica a respostaquoteType, porque um status 200 sozinho não prova que a página tem dados. Todas as 11 abas da MSFT a embutiram, incluindonews/. UmquoteTypesem uma bolsa significa um soft 404, uma página com status 200 mas sem dados de cotação. O Yahoo retornou esse tipo de página paraBRK.B, porque escreve o símbolo comoBRK-B.quote(symbol.upper(), safe='')coloca o símbolo em maiúsculas e codifica em percentual símbolos de índice como^GSPC, porque^não é um caractere de URL válido até ser codificado.
Para MSFT, o módulo lista as APIs do Yahoo que a página chama:
23 respostas embutidas
query1.finance.yahoo.com /ws/obi-integration/v1/premiumTiersMeta
query1.finance.yahoo.com /v1/finance/quoteType/MSFT
query1.finance.yahoo.com /v7/finance/spark
query1.finance.yahoo.com /v6/finance/quote/marketSummary
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v6/finance/recommendationsbysymbol/MSFT
query1.finance.yahoo.com /v6/finance/markettime
query1.finance.yahoo.com /v7/finance/spark
query1.finance.yahoo.com /v10/finance/quoteSummary/MSFT
query1.finance.yahoo.com /v1/finance/trending/US
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v1/finance/screener/predefined/saved
As estatísticas da aba de resumo vêm de v10/finance/quoteSummary, que continha cerca de 223 KB de JSON em 17 módulos para a MSFT. A listagem mostra as 13 URLs absolutas de API, e as outras 10 respostas vieram dos próprios endpoints /xhr/ do Yahoo. A maioria das 23 fornece dados para widgets da página, como tickers em alta e resumos de mercado. A contagem varia: de executores em nuvem dos EUA, a mesma página embutiu 26 respostas, e as extras incluíram price-insights.
Faça o parsing dos campos de preço, avaliação e classificação
Muitos números dentro de quoteSummary são pares {"raw": 516.17, "fmt": "516.17"}, então um auxiliar mantém o valor bruto. Esta função retorna 20 campos de cotação. Salve-a como quote_summary.py, porque os scripts de estimativas e em lote a reutilizam:
import json

from yahoo_embedded import embedded, fetch_page, pick


def raw(module: dict, key: str):
    """Muitos números são pares {"raw": 516.17, "fmt": "516.17"}. Mantenha o valor bruto."""
    value = module.get(key)
    return value.get("raw") if isinstance(value, dict) else value


def quote_summary(symbol: str, fetch=fetch_page) -> dict:
    found = embedded(fetch(symbol))
    result = pick(found, "/v10/finance/quoteSummary/")["quoteSummary"]["result"][0]
    price = result.get("price", {})
    detail = result.get("summaryDetail", {})
    stats = result.get("defaultKeyStatistics", {})
    analysts = result.get("financialData", {})
    return {
        "symbol": price.get("symbol"),
        "name": price.get("longName") or price.get("shortName"),
        "quote_type": price.get("quoteType"),
        "currency": price.get("currency"),
        "price": raw(price, "regularMarketPrice"),
        "change_pct": raw(price, "regularMarketChangePercent"),
        "market_time": raw(price, "regularMarketTime"),
        "market_state": price.get("marketState"),
        "delay_minutes": price.get("exchangeDataDelayedBy"),
        "market_cap": raw(price, "marketCap"),
        "trailing_pe": raw(detail, "trailingPE"),
        "forward_pe": raw(detail, "forwardPE"),
        "dividend_yield": raw(detail, "dividendYield"),
        "beta": raw(detail, "beta"),
        "week52_low": raw(detail, "fiftyTwoWeekLow"),
        "week52_high": raw(detail, "fiftyTwoWeekHigh"),
        "eps_ttm": raw(stats, "trailingEps"),
        "target_mean": raw(analysts, "targetMeanPrice"),
        "recommendation": analysts.get("recommendationKey"),
        "reporting_currency": analysts.get("financialCurrency"),
    }


if __name__ == "__main__":
    print(json.dumps(quote_summary("MSFT"), indent=2))
Para MSFT, a função imprimiu valores brutos para todos os 20 campos após o fechamento do mercado:
{
  "symbol": "MSFT",
  "name": "Microsoft Corporation",
  "quote_type": "EQUITY",
  "currency": "USD",
  "price": 516.17,
  "change_pct": 0.0366316,
  "market_time": 1790366401,
  "market_state": "CLOSED",
  "delay_minutes": 0,
  "market_cap": 3832843862016,
  "trailing_pe": 28.739979,
  "forward_pe": 21.801512,
  "dividend_yield": 0.0076,
  "beta": 1.108,
  "week52_low": 349.2,
  "week52_high": 553.72,
  "eps_ttm": 17.96,
  "target_mean": 577.26135,
  "recommendation": "strong_buy",
  "reporting_currency": "USD"
}
A aba de resumo mostrou os mesmos números formatados, como uma capitalização de mercado de 3,833T, um P/L de 28,74 e um dividend yield de 0,76%:
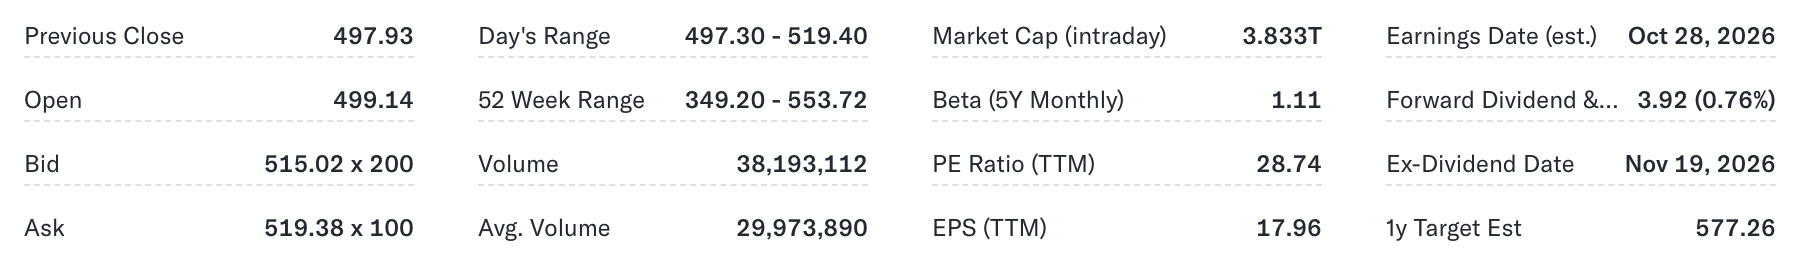
O JSON contém os valores brutos em vez disso, como 3832843862016 para a capitalização de mercado de 3,833T.
Nos valores brutos, porcentagens são frações, então um change_pct de 0,0366316 é um movimento de 3,66%, e um dividend_yield de 0,0076 é 0,76%. A função lê cada módulo com .get() porque os módulos embutidos diferem por tipo de ativo. SPY, ^GSPC, BTC-USD e EURUSD=X retornaram preços sem o módulo financialData, então seus campos de analistas eram None. SPY incluiu fundProfile e topHoldings em vez disso.
Baixe o histórico completo de preços em 1 solicitação
A aba de dados históricos (history/) passa os parâmetros period1, period2 e frequency de sua própria URL para a solicitação de gráfico que embute. Ambos os parâmetros de período são timestamps Unix, então um period1 de 0 pede cada barra desde 1º de janeiro de 1970. O seletor de data então começa nessa data, e frequency=1d mostra linhas diárias:
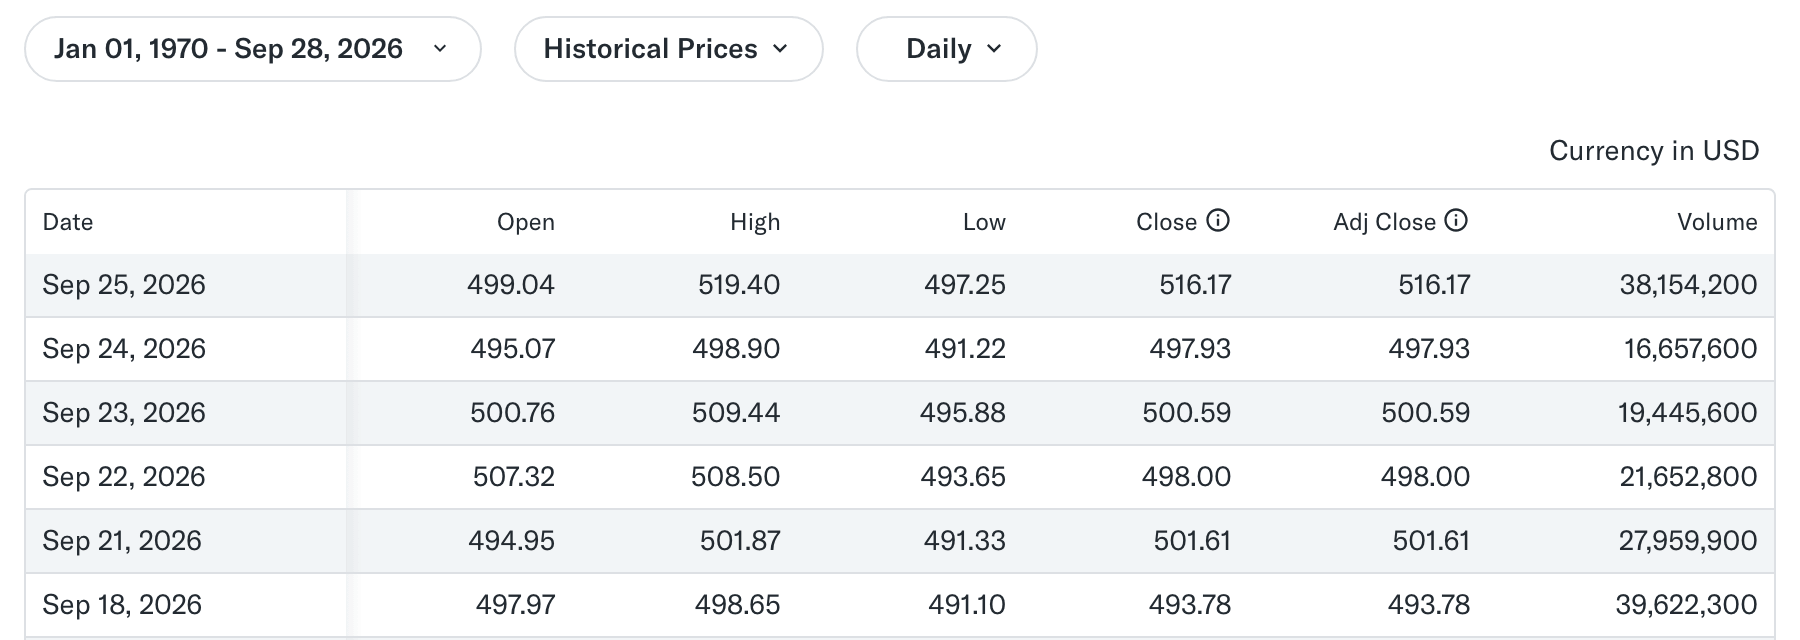
A linha mais recente da tabela corresponde à última linha que price_history() imprime abaixo.
A função price_history() converte a resposta de gráfico embutida em um DataFrame indexado por datas no fuso horário da bolsa. Salve-a como price_history.py:
import time

import pandas as pd

from yahoo_embedded import embedded, fetch_page, pick


def price_history(
    symbol: str, frequency: str = "1d", fetch=fetch_page
) -> tuple[pd.DataFrame, dict]:
    """Cada barra desde 1970 em 1d, 1wk ou 1mo, mais eventos de desdobramento e dividendo."""
    params = {"period1": 0, "period2": int(time.time()), "frequency": frequency}
    found = embedded(fetch(symbol, "history/", params))
    result = pick(found, "/v8/finance/chart/")["chart"]["result"][0]
    bars, meta = result["indicators"]["quote"][0], result["meta"]
    utc = pd.to_datetime(result["timestamp"], unit="s", utc=True)
    index = utc.tz_convert(meta["exchangeTimezoneName"]).tz_localize(None).normalize()
    frame = pd.DataFrame(
        {
            "open": bars["open"],
            "high": bars["high"],
            "low": bars["low"],
            "close": bars["close"],
            "adj_close": result["indicators"]["adjclose"][0]["adjclose"],
            "volume": bars["volume"],
        },
        index=index,
    )
    if frequency != "1d" and result["timestamp"][-1] == meta.get("regularMarketTime"):
        frame = frame.iloc[:-1]  # o Yahoo anexa a última sessão como uma barra extra
    return frame.dropna(how="all"), result.get("events", {})


if __name__ == "__main__":
    history, events = price_history("MSFT")
    print(history.tail(3).round(2).to_string())
    print(
        f"{len(history):,} barras diárias de {history.index[0]:%Y-%m-%d} "
        f"até {history.index[-1]:%Y-%m-%d}"
    )
    splits = sorted(
        pd.Timestamp(s["date"], unit="s").date()
        for s in events.get("splits", {}).values()
    )
    if splits:
        print(f"{len(splits)} desdobramentos, o último em {splits[-1]}")
Uma única solicitação retornou o histórico completo da MSFT:
              open    high     low   close  adj_close    volume
2026-09-23  500.76  509.44  495.88  500.59     500.59  19445600
2026-09-24  495.07  498.90  491.22  497.93     497.93  16657600
2026-09-25  499.04  519.40  497.25  516.17     516.17  38154200
10.213 barras diárias de 1986-03-13 até 2026-09-25
9 desdobramentos, o último em 2003-02-18
Através do host de API, o yfinance retornou as mesmas 10.213 barras para esse intervalo. Lide com estes 5 detalhes em um pipeline de histórico:
- Nos testes, o histórico não começou antes de 1970. A página de ajuda do Yahoo sobre dados históricos diz que os preços geralmente não começam antes disso. A Coca-Cola é negociada desde 1919, mas seu histórico completo começou em 1970-01-02. Um
period1negativo retornou 404. frequencysuporta1d,1wke1mo. Em1wke1mo, o Yahoo anexou a última sessão como uma barra extra, e a função a remove. Com essa barra removida, a última barra semanal ou mensal pode excluir a última sessão de negociação, então tire fechamentos recentes de barras diárias.- Valores intradiários como
1h,5me1mretornaram barras diárias em vez disso. A aba de resumo embute até 24 horas de fechamentos de 5 minutos de/v7/finance/spark. Ela também embute uma segunda resposta spark para o resumo de mercado, então escolha a resposta cujo parâmetrosymbolscorresponde ao seu ticker. As páginas de cotação contêm apenas essas 24 horas de dados intradiários, porque o histórico intradiário mais longo vem dos hosts de API, que o robots.txt desautoriza. - O Yahoo ajusta
closepara desdobramentos eadj_closepara desdobramentos e dividendos. Barras antigas mudam após cada novo desdobramento ou dividendo, então armazene os eventos de desdobramento e dividendo com cada download. - O tamanho da página cresce com o intervalo de datas. Com o intervalo de datas completo, a aba de dados históricos da MSFT tinha 4,9 MB de HTML, e a aba de resumo tinha cerca de 1,1 MB. Para uma atualização diária, defina
period1para um timestamp recente, e baixe o intervalo completo novamente após cada novo desdobramento ou dividendo.
Busque demonstrações financeiras e estimativas de analistas
Demonstrações e estimativas estão em abas diferentes, então cada uma recebe sua própria função.
Obtenha demonstrações financeiras anuais
As demonstrações financeiras vêm da resposta fundamentals-timeseries nas abas de demonstrações, balanço patrimonial e fluxo de caixa. Na aba de demonstrações da MSFT, essa resposta continha 96 séries anuais e 96 séries dos últimos 12 meses. statement() mantém as séries anuais e as organiza em uma tabela com 1 coluna por ano fiscal. Salve-a como statements.py:
import pandas as pd

from yahoo_embedded import embedded, fetch_page, pick


def statement(symbol: str, tab: str = "financials/", fetch=fetch_page) -> pd.DataFrame:
    """Itens anuais das abas financials/, balance-sheet/ ou cash-flow/."""
    found = embedded(fetch(symbol, tab))
    series = pick(found, "/fundamentals-timeseries/")["timeseries"]["result"]
    rows = []
    for item in series:
        name = item["meta"]["type"][0]  # por exemplo "annualTotalRevenue"
        if not name.startswith("annual"):
            continue  # ignora séries não anuais, como últimos 12 meses
        for point in item.get(name) or []:
            if point:
                rows.append(
                    {
                        "line_item": name.removeprefix("annual"),
                        "fiscal_year_end": point["asOfDate"],
                        "value": point["reportedValue"]["raw"],
                    }
                )
    table = pd.DataFrame(rows).pivot(
        index="line_item", columns="fiscal_year_end", values="value"
    )
    return table.sort_index(axis=1)


if __name__ == "__main__":
    income = statement("MSFT")
    billions = (
        income.loc[["TotalRevenue", "GrossProfit", "OperatingIncome", "NetIncome"]].T
        / 1e9
    )
    billions["DilutedEPS"] = income.loc["DilutedEPS"]
    print(billions.round(2).to_string())
    print(f"{len(income)} itens de linha")
O script imprimiu 4 anos fiscais da demonstração de resultados, em bilhões de dólares exceto LPA:
line_item        TotalRevenue  GrossProfit  OperatingIncome  NetIncome  DilutedEPS
fiscal_year_end
2023-06-30             211.92       146.05            88.52      72.36        9.68
2024-06-30             245.12       171.01           109.43      88.14       11.80
2025-06-30             281.72       193.89           128.53     101.83       13.64
2026-06-30             331.84       225.46           155.24     133.75       17.95
47 itens de linha
Na aba de demonstrações, o Yahoo mostra os mesmos valores em milhares, então a receita de 331,84B na saída aparece como 331.839.000:
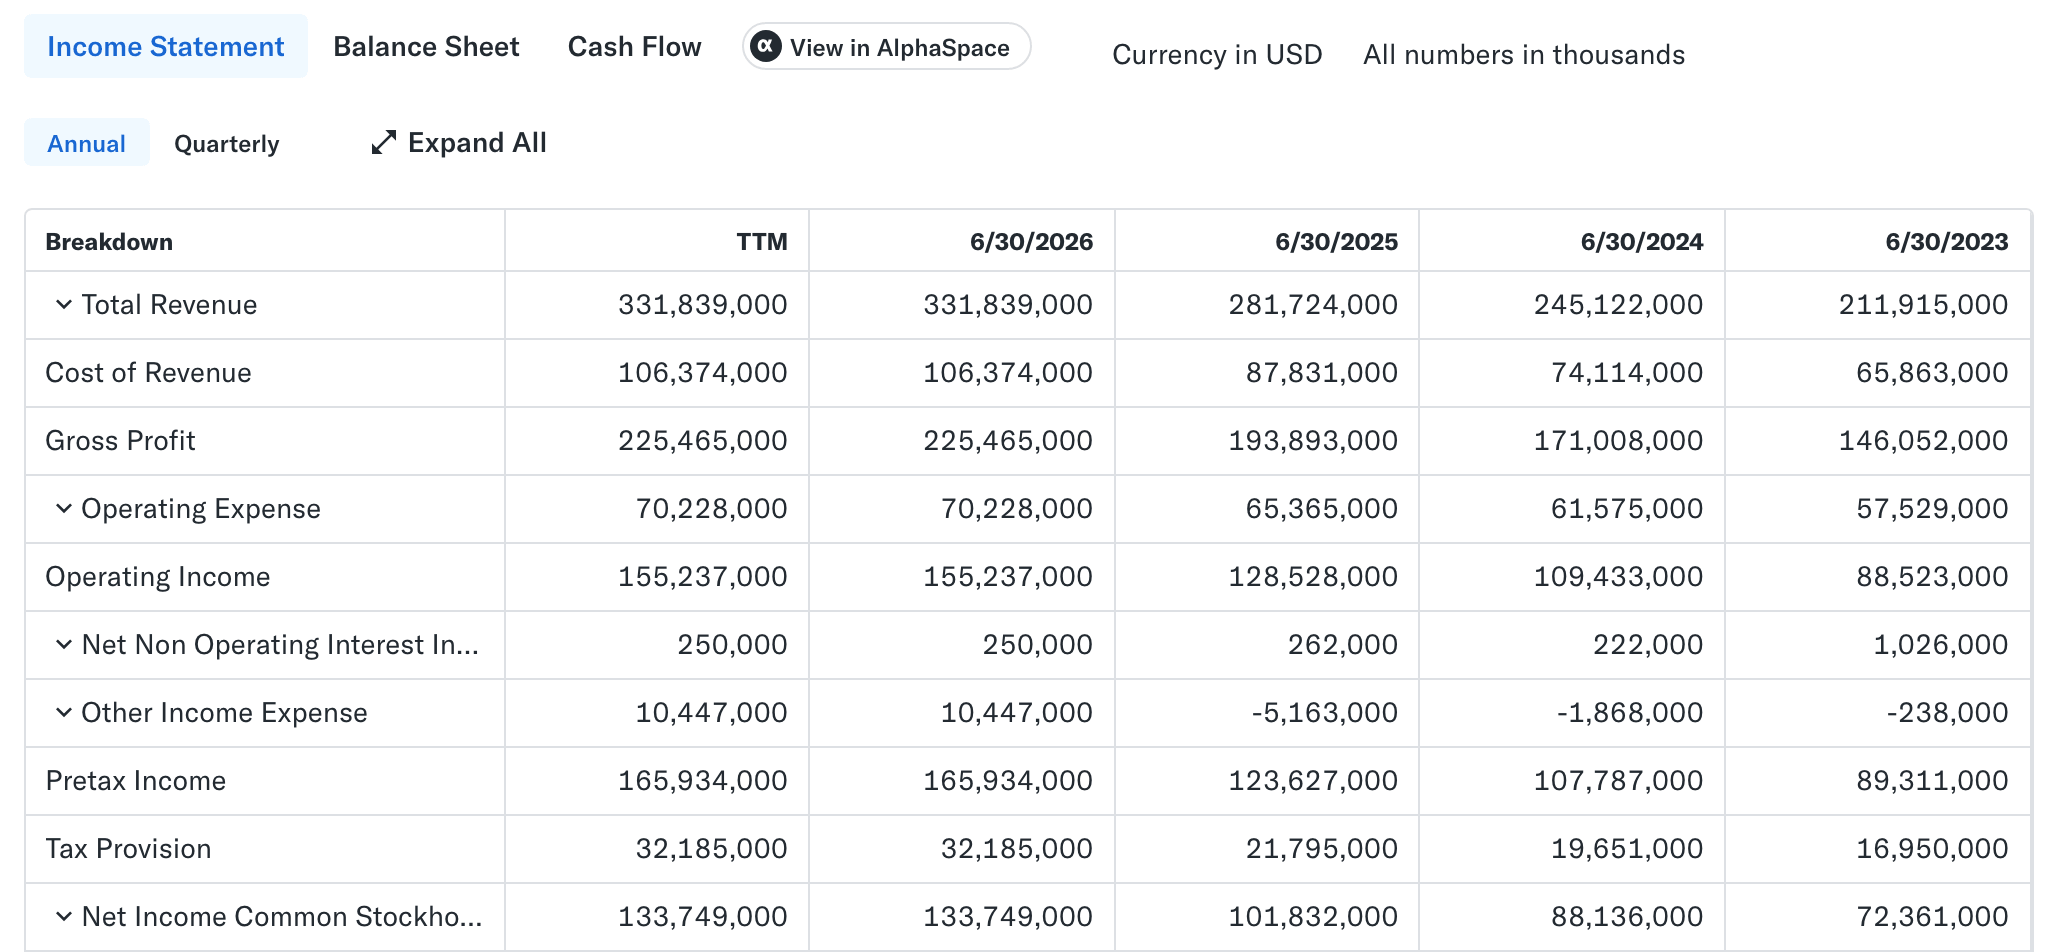
As visões de Demonstração de Resultados, Balanço Patrimonial e Fluxo de Caixa são as abas financials/, balance-sheet/ e cash-flow/ que statement() lê.
Para MSFT, 47 das 96 séries anuais tinham valores. As séries vazias eram itens de linha como sinistros de seguro, dividendos preferenciais e impostos especiais. Para esses 4 anos, a função retornou 79 itens de linha de balance-sheet/ e 59 itens de linha de cash-flow/. Demonstrações trimestrais carregam apenas depois de você selecionar a opção Trimestral, e nenhum parâmetro de URL testado mudou isso.
Ignore os módulos incomeStatementHistory e balanceSheetHistory em quoteSummary. Suas linhas de receita tinham valores reais apenas para receita total e lucro líquido, tanto na versão anual quanto na trimestral. As linhas do balanço patrimonial tinham apenas datas. Outros campos de receita continham 0 como marcador de posição, então um parser que confia neles armazenaria um lucro bruto de 0.
Obtenha estimativas de analistas
A aba de análise embute earningsTrend, que contém LPA e receita de consenso para o trimestre atual, o próximo trimestre, o ano atual e o próximo ano. estimates() achata isso em 1 linha por período. Salve-a como estimates.py:
import pandas as pd

from quote_summary import raw
from yahoo_embedded import embedded, fetch_page, pick


def estimates(symbol: str, fetch=fetch_page) -> pd.DataFrame:
    """LPA e receita de consenso para o trimestre e ano atual e próximo."""
    found = embedded(fetch(symbol, "analysis/"))
    result = pick(found, "/v10/finance/quoteSummary/")["quoteSummary"]["result"][0]
    rows = []
    for period in result["earningsTrend"]["trend"]:
        eps, revenue = period["earningsEstimate"], period["revenueEstimate"]
        revenue_avg = raw(revenue, "avg")
        rows.append(
            {
                "period": period["period"],  # 0q, +1q, 0y, +1y
                "ends": period["endDate"],
                "eps_avg": raw(eps, "avg"),
                "eps_low": raw(eps, "low"),
                "eps_high": raw(eps, "high"),
                "eps_analysts": raw(eps, "numberOfAnalysts"),
                "revenue_avg_bn": None if revenue_avg is None else revenue_avg / 1e9,
                "revenue_analysts": raw(revenue, "numberOfAnalysts"),
            }
        )
    return pd.DataFrame(rows).set_index("period")


if __name__ == "__main__":
    print(estimates("MSFT").round(2).to_string())
Para MSFT, cada estimativa veio de 25 a 51 analistas:
              ends  eps_avg  eps_low  eps_high  eps_analysts  revenue_avg_bn  revenue_analysts
period
0q      2026-09-30     4.72     4.43      4.83            25           90.66                38
+1q     2026-12-31     4.82     4.72      5.02            25           95.49                37
0y      2027-06-30    19.76    19.21     20.70            33          391.04                50
+1y     2028-06-30    23.68    22.08     26.00            32          467.27                51
Na aba de análise, a tabela de Estimativa de Lucros mostra os mesmos números de LPA. Suas colunas Trim. Atual, Próx. Trim., Ano Atual e Próx. Ano correspondem às linhas 0q, +1q, 0y e +1y:
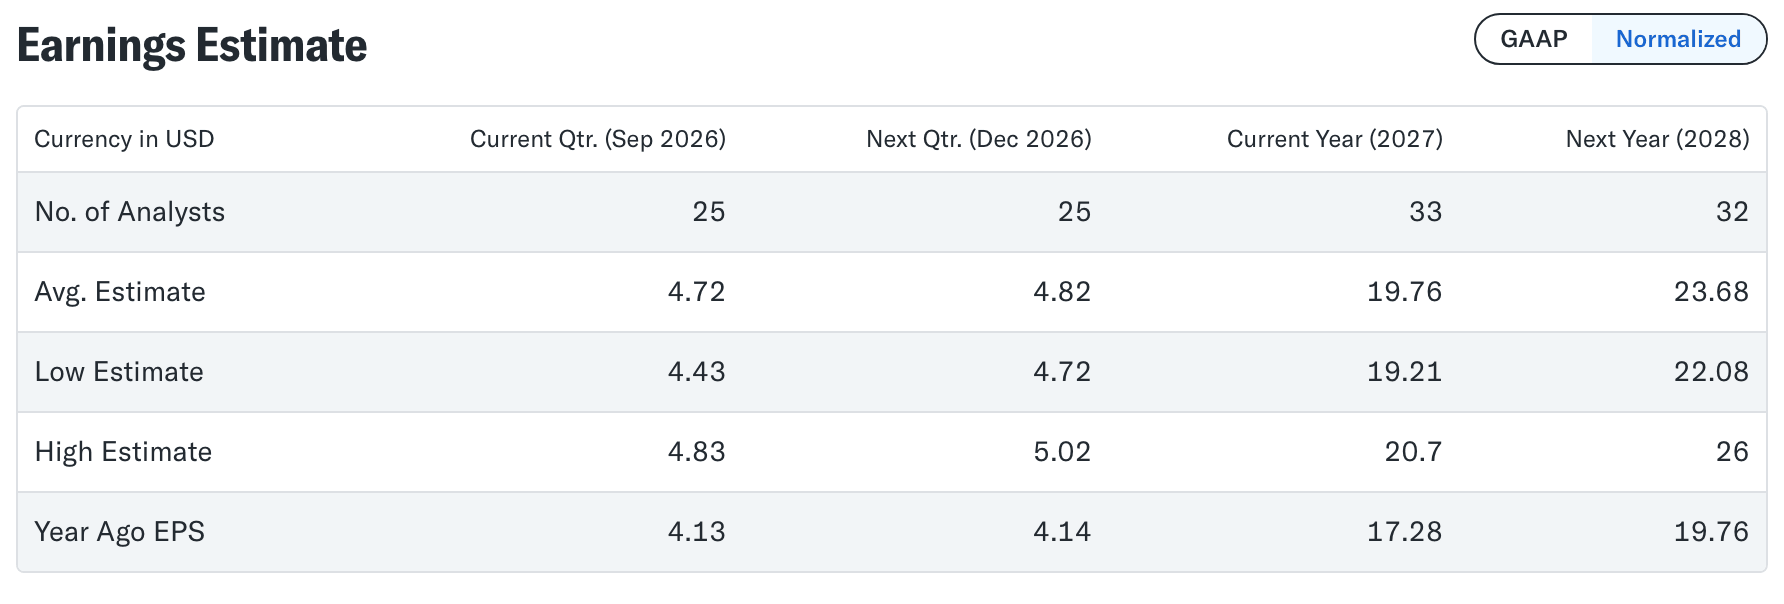
A visão Normalizada da tabela mostra os mesmos números que earningsTrend contém.
A mesma solicitação também retorna epsTrend e epsRevisions para cada período, e earningsHistory com os últimos 4 trimestres reportados e suas porcentagens de surpresa.
Faça scraping do Yahoo Finance para centenas de tickers
Muitas listas de tickers em produção incluem símbolos antigos, índices e listagens estrangeiras, então seu script em lote precisa relatar problemas e continuar. Salve o próximo script como batch.py. Ele executa 8 threads por padrão, coleta símbolos ausentes e com falha separadamente, e converte unidades monetárias menores:
from concurrent.futures import ThreadPoolExecutor

import pandas as pd

from quote_summary import quote_summary
from yahoo_embedded import SymbolNotFound, fetch_page

# O Yahoo cota muitos preços de Londres, Johanesburgo e Tel Aviv em unidades menores.
# A capitalização de mercado permanece em unidades maiores.
MINOR_UNITS = {"GBp": ("GBP", 100), "ZAc": ("ZAR", 100), "ILA": ("ILS", 100)}
PRICE_FIELDS = ("price", "week52_low", "week52_high", "target_mean")


def to_major_units(row: dict) -> dict:
    unit = MINOR_UNITS.get(row["currency"])
    if unit is None:
        return row
    currency, divisor = unit
    prices = {key: row[key] / divisor for key in PRICE_FIELDS if row[key] is not None}
    return {**row, **prices, "currency": currency}


def collect(symbols: list[str], fetch=fetch_page, workers: int = 8):
    """Linhas de cotação para muitos símbolos, mais os símbolos ausentes ou com falha."""
    # " msft" e "MSFT" são o mesmo ticker
    symbols = list(dict.fromkeys(s.strip().upper() for s in symbols))
    missing, failed = [], {}

    def one(symbol: str) -> dict | None:
        try:
            return to_major_units(quote_summary(symbol, fetch=fetch))
        except SymbolNotFound:
            missing.append(symbol)
        except Exception as error:  # mantém o lote rodando, relata no final
            failed[symbol] = repr(error)
        return None

    with ThreadPoolExecutor(max_workers=workers) as pool:
        rows = [row for row in pool.map(one, symbols) if row]
    return pd.DataFrame(rows), missing, failed


if __name__ == "__main__":
    tickers = "AAPL MSFT SQ ^GSPC SPY BTC-USD 7203.T SAP.DE VOD.L NPN.JO".split()
    table, missing, failed = collect(tickers)
    cols = "symbol price currency market_cap delay_minutes reporting_currency".split()
    print(table[cols].to_string(index=False))
    print("ausentes:", missing, "| falhas:", failed)
Uma lista mista de 10 símbolos terminou em 2,5 segundos:
 symbol     price currency   market_cap  delay_minutes reporting_currency
   AAPL   341.070      USD 4.977637e+12              0                USD
   MSFT   516.170      USD 3.832844e+12              0                USD
  ^GSPC  7743.410      USD          NaN              0                NaN
    SPY   771.350      USD          NaN              0                NaN
BTC-USD 85011.320      USD 1.707212e+12              0                NaN
 7203.T  2989.500      JPY 3.540116e+13             20                JPY
 SAP.DE   185.920      EUR 2.145897e+11             15                EUR
  VOD.L     1.258      GBP 2.907280e+10             15                EUR
 NPN.JO   709.380      ZAR 5.307029e+11             15                USD
ausentes: ['SQ'] | falhas: {}
O lote relatou SQ como ausente porque a Block, Inc. mudou seu símbolo para XYZ. O Yahoo redireciona o símbolo antigo para sua página de busca, mas um símbolo reutilizado falha silenciosamente. FB, o antigo símbolo da Meta, retornou um ETF da ProShares com status 200, então compare cada name com sua lista de tickers. A página de cotação da FB parece qualquer outra página de cotação:
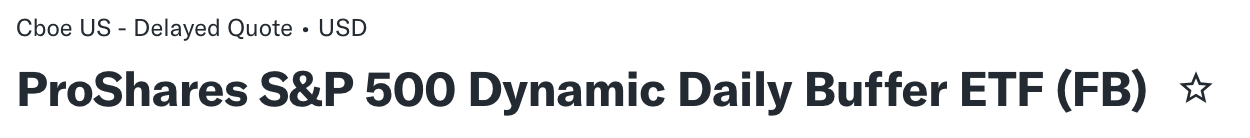
Um símbolo reutilizado retorna uma página de cotação normal, então o nome é o sinal mais claro da mudança.
Verifique unidades, moedas e atrasos
Uma verificação de código de status não detectará mais 3 problemas:
- Unidades monetárias menores. O Yahoo reportou o preço da VOD.L como 125,8 em
GBp(pence) e sua capitalização de mercado como 29,07B em libras. O preço da NPN.JO era 70.938 emZAc(centavos).to_major_units()divide apenas os campos de preço, então a capitalização de mercado mantém suas unidades maiores. - Moeda de relatório. Os valores das demonstrações usam a moeda de relatório da empresa, e os pontos de dados da série temporal incluem essa moeda em um campo
currencyCode. A Vodafone (VOD.L) é negociada em pence mas reporta em euros, e a Naspers (NPN.JO) é negociada em rand mas reporta em dólares americanos. Índices podem misturar as 2 moedas. O P/L futuro da TEVA.TA era 43,5, enquanto a TEVA, sua listagem em Nova York, tinha 12,9. O Yahoo tinha dividido o preço em shekel da TEVA.TA por uma estimativa de LPA em dólares. - Atraso da bolsa.
delay_minutesera 0 para as listagens dos EUA e Bitcoin. As cotações da Xetra, Londres e Johanesburgo tinham um atraso de 15 minutos, e a cotação de Tóquio tinha um atraso de 20 minutos. Mantenhadelay_minutesemarket_timecom cada linha antes de comparar preços entre bolsas.
Execute lotes maiores
Com suas 8 threads padrão, collect() processou todos os 503 símbolos do S&P 500 em 74 segundos a partir da conexão residencial sem um 429 ou uma nova tentativa. Apenas BRK.B e BF.B estavam ausentes, porque a lista do S&P 500 da Wikipedia os escreve com pontos e o Yahoo usa BRK-B e BF-B. Com period1 definido para 7 dias atrás, todos os 501 históricos foram atualizados em 48 segundos. A página mediana tinha menos de 1 MB, comparado com 4,9 MB para o histórico completo da MSFT.
Com recuo exponencial, fetch_page() já tenta novamente timeouts, 429s, respostas 5xx e páginas sem dados de cotação. Nosso guia sobre como tentar novamente solicitações com falha em Python explica o recuo com o Retry do urllib3 e o Tenacity.
Se você migrar para asyncio, verifique primeiro o limite do seu cliente para o tamanho do cabeçalho de resposta. A resposta para a aba de resumo da MSFT tinha cerca de 37 KB de cabeçalhos, incluindo um Content-Security-Policy de 8.765 bytes e um cabeçalho Link de 27.039 bytes. Com configurações padrão, o aiohttp 3.14.3 levantou um ClientResponseError em uma página que o Yahoo havia servido com status 200. Sua mensagem começava com 400, message='Got more than 8190 bytes when reading.
Passar max_field_size=65536 para aiohttp.ClientSession corrigiu o erro. Tanto o httpx quanto o AsyncSession do curl_cffi lidaram com a página com configurações padrão. Nossa comparação entre requests, httpx e aiohttp explica as outras compensações entre eles.
Execute o mesmo parser a partir de um servidor com a Web Unlocker API
Nossa Web Unlocker API recebe uma URL e retorna a página. Ela lida com rotação de IP, resolução de CAPTCHA e novas tentativas automáticas em nossos servidores, então o mesmo parser roda a partir do seu servidor enquanto mantemos o desbloqueio. fetch_page_unlocker() recebe os mesmos argumentos symbol, tab e params que fetch_page(), então quote_summary(), price_history(), statement() e estimates() aceitam ambos através de seu parâmetro fetch. Salve-o como unlocker.py:
import os
from urllib.parse import urlencode

import requests

from yahoo_embedded import page_url

API_URL = "https://api.brightdata.com/request"


def fetch_page_unlocker(symbol: str, tab: str = "", params: dict | None = None) -> str:
    """Recebe os mesmos symbol, tab e params que fetch_page(), via Web Unlocker API."""
    url = page_url(symbol, tab) + (f"?{urlencode(params)}" if params else "")
    response = requests.post(
        API_URL,
        headers={"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"},
        json={
            "zone": os.environ["BRIGHTDATA_UNLOCKER_ZONE"],
            "url": url,
            "format": "json",  # status, cabeçalhos e HTML do Yahoo, envolvidos em JSON
            "country": "us",
        },
        timeout=120,
    )
    response.raise_for_status()
    return response.json()["body"]
Ele lê sua chave de API e o nome da zona da Web Unlocker API em 2 variáveis de ambiente. Uma zona é uma configuração de produto nomeada em sua conta. Você encontrará a chave na página de configurações da conta e os passos para criar uma zona no guia rápido da Web Unlocker API. Assim que a zona existir, sua aba Visão Geral mostra ambos os valores:
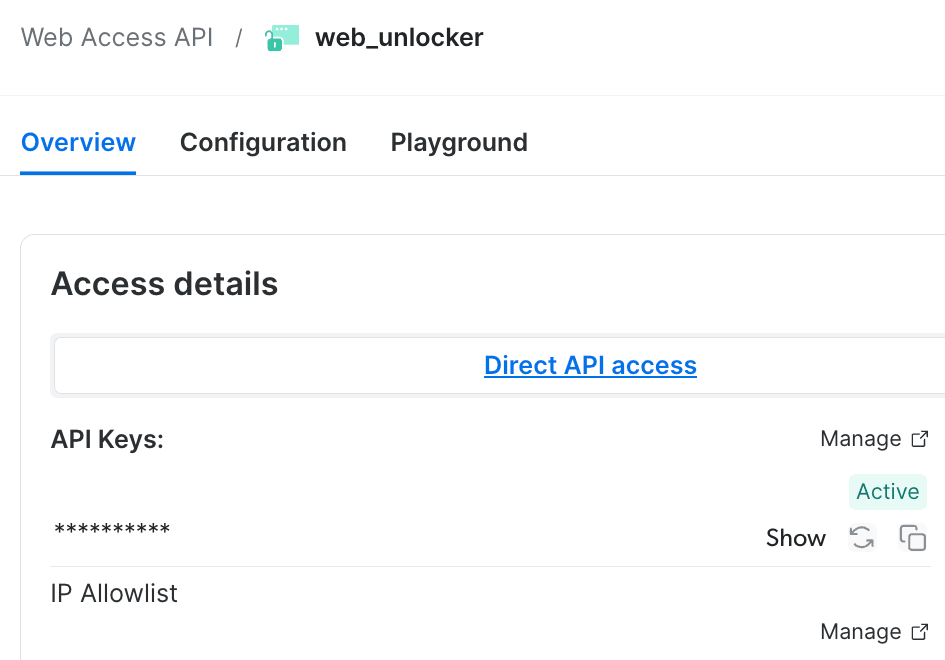
O nome da zona, aqui web_unlocker, está no topo, e o botão de copiar embaixo de API Keys copia sua chave.
Defina ambos no seu shell antes de executar o próximo script:
export BRIGHTDATA_API_KEY="sua-chave-api"
export BRIGHTDATA_UNLOCKER_ZONE="nome-da-sua-zona"
Para rotear quote_summary(), price_history(), statement() ou estimates() através da Web Unlocker API, passe fetch_page_unlocker como o argumento fetch. Salve este script como unlocker_demo.py:
from price_history import price_history
from unlocker import fetch_page_unlocker

history, events = price_history("MSFT", fetch=fetch_page_unlocker)
print(
    f"{len(history):,} barras diárias de {history.index[0]:%Y-%m-%d} "
    f"até {history.index[-1]:%Y-%m-%d}"
)
Ele imprimiu o mesmo histórico que price_history.py:
10.213 barras diárias de 1986-03-13 até 2026-09-25Uma única solicitação retornou a página completa de dados históricos, e o parser não precisou de mudanças para lê-la. O script em lote aceita a mesma função através de collect(tickers, fetch=fetch_page_unlocker).
Observe estes 3 detalhes:
- Use
"format": "json". A resposta então contém o código de status, cabeçalhos e HTML completo do Yahoo em um único objeto JSON. A função retorna o HTML de seu campobody. - Codifique caracteres especiais.
page_url()já codifica em percentual símbolos de índice como^GSPCcomo%5EGSPC, então toda URL que constrói é válida. - Ou use nosso SDK Python. Instale o
brightdata-sdkcompip install brightdata-sdk, e passeresponse_format="json"parascrape_url()para obter o código de status do Yahoo junto com a página.
Cada aba é uma solicitação separada, e você paga apenas por solicitações bem-sucedidas.
Obtenha registros estruturados da Yahoo Finance Scraper API
Nossa Yahoo Finance Scraper API retorna um registro estruturado por ticker, e proxies, desbloqueio e novas tentativas já estão incluídos. É um scraper pré-construído em nossa Web Scraper API. Um registro combina os campos de resumo, perfil da empresa, principais executivos, demonstrações financeiras anuais e metas de preço de analistas, que a página do produto do scraper lista campo por campo. O Painel de Controle mostra os modos síncrono e assíncrono do scraper e o endpoint que o código abaixo chama:
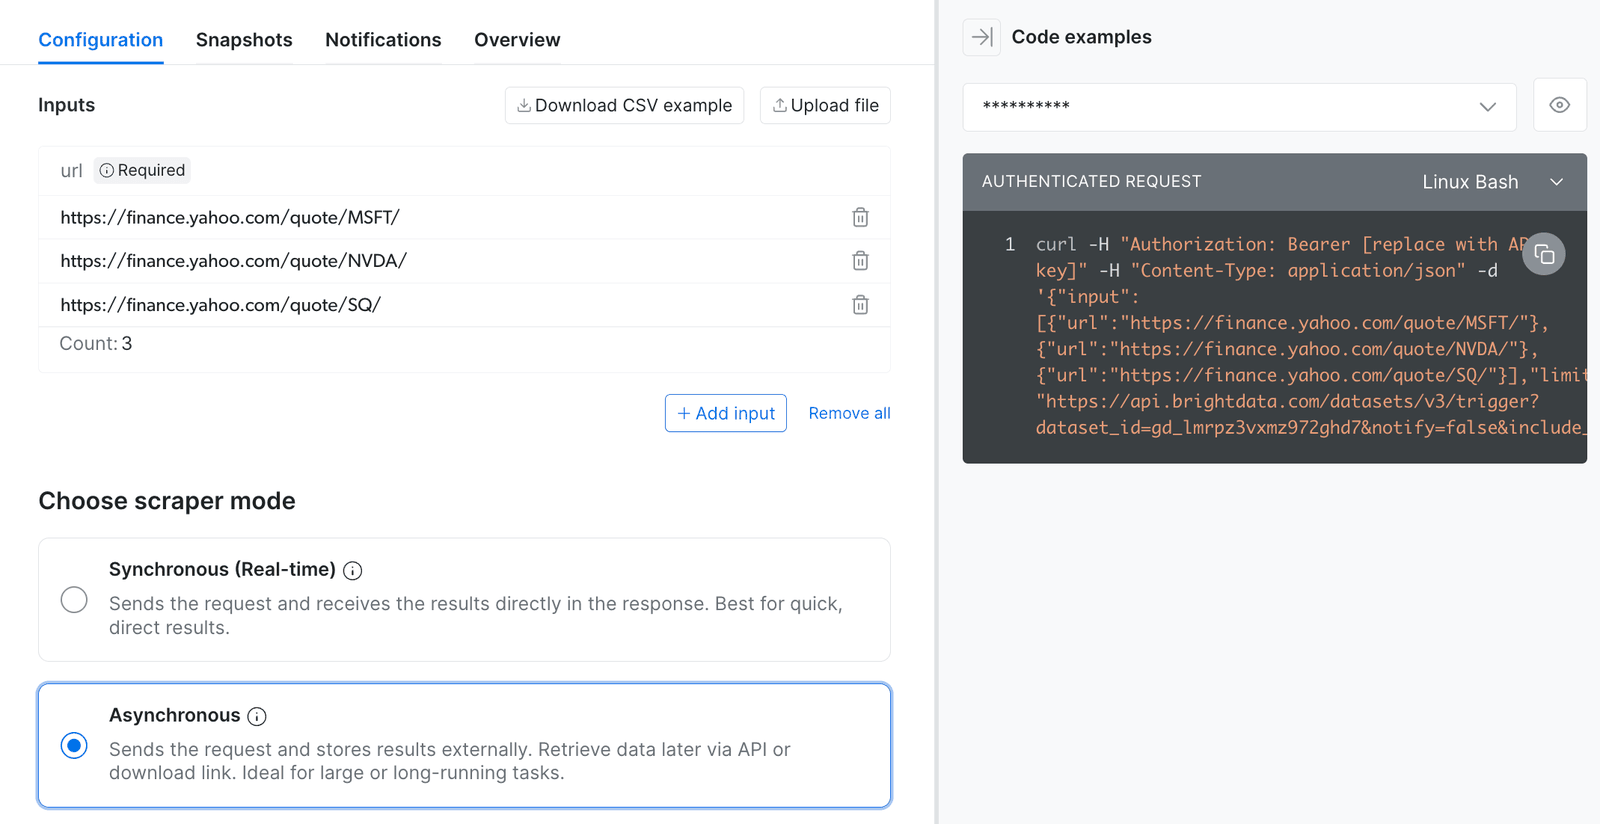
O exemplo curl do painel usa as mesmas URLs de cotação, endpoint de disparo e ID de dataset que scraper_api.py, e o modo Assíncrono funciona melhor para tarefas em lote agendadas.
Dispare uma tarefa e baixe os registros
Salve o próximo script como scraper_api.py. Ele dispara uma tarefa para uma lista de URLs, consulta seu progresso, baixa os registros e relata os símbolos que o Yahoo não lista mais:
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_lmrpz3vxmz972ghd7"  # informações comerciais do Yahoo Finance
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
# A API retorna apenas estes campos, então a lista mantém input, error e error_code.
FIELDS = (
    "input|error|error_code|stock_ticker|closing_price|"
    "market_cap|pe_ratio|currency|timestamp"
)


def job_status(snapshot_id: str) -> str:
    progress = requests.get(
        f"{API}/progress/{snapshot_id}", headers=HEADERS, timeout=60
    )
    return progress.json()["status"]


def run_batch(urls: list[str], poll_seconds: int = 30) -> list[dict]:
    """Dispara uma tarefa de coleta, espera até ficar pronta e retorna seus registros."""
    trigger = requests.post(
        f"{API}/trigger",
        params={
            "dataset_id": DATASET_ID,
            "include_errors": "true",
            "custom_output_fields": FIELDS,
        },
        headers=HEADERS,
        json={"input": [{"url": url} for url in urls]},
        timeout=60,
    )
    trigger.raise_for_status()
    snapshot_id = trigger.json()["snapshot_id"]

    while job_status(snapshot_id) != "ready":
        time.sleep(poll_seconds)

    records = requests.get(
        f"{API}/snapshot/{snapshot_id}",
        params={"format": "json"},
        headers=HEADERS,
        timeout=300,
    )
    records.raise_for_status()
    return records.json()


def collect_records(urls: list[str]) -> tuple[list[dict], dict[str, str]]:
    """Executa uma tarefa e divide seus registros em resultados e erros por URL."""
    records = run_batch(list(dict.fromkeys(urls)))  # remove URLs duplicadas
    done = [record for record in records if not record.get("error")]
    errors = {
        record["input"]["url"]: f'{record.get("error_code")}: {record["error"]}'
        for record in records
        if record.get("error")
    }
    return done, errors


if __name__ == "__main__":
    urls = [f"https://finance.yahoo.com/quote/{s}/" for s in ("MSFT", "NVDA", "SQ")]
    records, errors = collect_records(urls)
    for record in records:
        print(record)
    print("erros:", errors)
Ele imprimiu 2 registros e um erro para SQ:
{'input': {'url': 'https://finance.yahoo.com/quote/MSFT/'}, 'stock_ticker': 'MSFT', 'closing_price': 516.17, 'market_cap': 3832843862016, 'pe_ratio': 28.739979, 'currency': 'USD', 'timestamp': '2026-09-27T16:15:44.789Z'}
{'input': {'url': 'https://finance.yahoo.com/quote/NVDA/'}, 'stock_ticker': 'NVDA', 'closing_price': 225.07, 'market_cap': 5434765213696, 'pe_ratio': 28.489874, 'currency': 'USD', 'timestamp': '2026-09-27T16:16:02.513Z'}
erros: {'https://finance.yahoo.com/quote/SQ/': 'dead_page: Target quote not found on lookup page'}
O scraper sinalizou SQ como dead_page porque o Yahoo redireciona SQ para sua página de busca, e fetch_page() levanta SymbolNotFound no mesmo caso.
Configure um pipeline agendado
Execute a Scraper API como uma tarefa em lote. Envie muitos tickers em cada chamada de disparo, depois consulte o endpoint de progresso ou espere por um webhook.
O endpoint síncrono /scrape retorna registros diretamente em sua resposta. Para uma tarefa mais longa, o endpoint retorna um snapshot_id para consultar em vez disso, como a referência da API síncrona descreve.
A chamada de disparo aceita algumas configurações que importam para um pipeline agendado. A referência da API assíncrona as lista, e o Painel de Controle oferece as mesmas opções em Configurações do scraper:
- Relatório de erros.
include_errors=trueadiciona umerrore umerror_codea qualquer entrada sem resultado, como um símbolo que o Yahoo não lista mais.collect_records()relata essas entradas por URL. - Campos de saída.
custom_output_fieldsmantém apenas os campos que você lista, separados por|, então adicioneinput,erroreerror_codepara manter o relatório de erros. - Limites de registros.
limit_per_inputlimita os registros por entrada, elimit_multiple_resultslimita os registros por tarefa. Ambos os limites controlam o custo de uma busca Descobrir por palavra-chave. - Entrega e webhooks.
endpointentrega os registros para sua URL de webhook.notify=trueenvia uma notificação quando a tarefa termina, então um agendador não precisa consultar/progress. Passeuncompressed_webhook=truepara receber payloads de webhook não comprimidos. Configurações de entrega no painel também podem escrever resultados no Amazon S3, Google Cloud Storage ou Snowflake, como a documentação de entrega de dados descreve. - Agendamentos. O Painel de Controle pode executar a mesma coleta em uma programação recorrente, como uma atualização diária de tickers.
Em uma lista de tickers mais longa, o scraper também sinalizou MMC, BK e FI como dead_page. Essas empresas haviam mudado seus símbolos para MRSH, BNY e FISV. Você paga apenas por registros entregues com sucesso.
Busque por palavra-chave ou execute pela CLI
O modo Descobrir por palavra-chave encontra listagens que correspondem a uma palavra-chave em bolsas e tipos de ativos. Uma busca por WIX encontrou a Wix.com, Wickes Group (WIX.L) e contratos de opções WIX, e uma busca por MSFT também encontrou a listagem da Microsoft em Toronto e ETFs de ação única. Filtre em entity_type e stock_ticker para manter as listagens que deseja.
A Yahoo Finance Scraper API também roda de um terminal como brightdata pipelines yahoo_finance_business <url> na Bright Data CLI. Através da ferramenta web_data_yahoo_finance_business, um agente de IA pode buscar o registro para uma URL de cotação que você fornecer. A ferramenta roda em nosso Yahoo Finance MCP Server, depois de você ativar seu grupo de ferramentas finance.
Escolha a abordagem certa para seu pipeline
Comece lendo as páginas de cotação gratuitamente, e adicione a Web Unlocker API para tarefas de servidor agendadas. Para registros estruturados, use a Scraper API ou o Yahoo Finance Dataset:
| Opção | Melhor para | Você lida com | Preços |
|---|---|---|---|
| yfinance | Pesquisa pessoal, como seu README afirma | Atualizações de biblioteca, IPs bloqueados | Gratuito |
| Páginas de cotação com curl_cffi | Centenas de tickers por dia de casa ou um executor do GitHub Actions | Parser, novas tentativas, IPs bloqueados | Gratuito |
| Páginas de cotação com Web Unlocker API | Tarefas de servidor agendadas que leem qualquer aba | Parser | Por solicitação bem-sucedida |
| Playwright com Browser API | Demonstrações trimestrais e outros dados que aparecem após selecionar uma opção | Script de navegador, parser | Por GB de tráfego |
| Yahoo Finance Scraper API | Registros analisados entregues em uma programação | Lista de campos de saída | Por registro entregue |
| Yahoo Finance Dataset | Arquivos prontos de empresas, fundos e índices | Configurações de entrega | Por registro |
Para estimar um orçamento mensal, conte 1 solicitação da Web Unlocker API por aba, por ticker, por atualização. A Yahoo Finance Scraper API precisa de 1 registro por ticker por atualização. Multiplique qualquer volume pelo preço atual na página de preços da Web Unlocker API ou na página de preços da Web Scraper API.
Para demonstrações trimestrais, um script Playwright ou Puppeteer pode selecionar a opção Trimestral da aba de demonstrações em nossa Browser API. Ela roda o Chromium na nuvem, e a resolução de CAPTCHA e a renderização de JavaScript já estão incluídas. Nosso guia sobre como fazer scraping de sites dinâmicos com Python mostra esse fluxo de trabalho passo a passo.
Nosso Yahoo Finance Dataset empacota o mesmo tipo de registros que a Scraper API em arquivos prontos JSON, NDJSON, CSV ou Parquet. Ele inclui ações, fundos mútuos, índices, ETFs, moedas e fundos do mercado monetário, então filtre em entity_type para manter as classes de ativos que deseja.
Você pode comprar um subconjunto com apenas os pontos de dados que precisa e obter atualizações em uma programação diária, semanal, mensal ou personalizada. Cada entrega pode conter apenas registros novos ou atualizados e ir diretamente para Amazon S3, Google Cloud, Azure, Snowflake ou SFTP. A página do dataset mostra a contagem atual de registros e preços, e você pode baixar um arquivo de amostra em JSON ou CSV antes de comprar.
Para outras fontes de dados de mercado, veja nossos guias sobre scraping de dados financeiros e scraping do Google Finance. Nossos outros scrapers e datasets oferecem mais dados de ações e outros resultados do Yahoo:
- Stock Market Scraper coleta dados de ações de sites como Yahoo Finance, Google Finance e TradingView.
- Google Finance Scraper e TradingView Scraper coletam preços de ações e tendências de mercado desses 2 sites.
- Nasdaq Scraper coleta dados da Nasdaq como preço de abertura, preço de fechamento e volume de ações.
- Stocktwits Scraper coleta posts, sentimento e símbolos em alta do Stocktwits.
- Financial Data Scraper API retorna campos como nome da empresa, ticker da ação, bolsa e preço de fechamento.
- Stock Market Dataset, Stock Prices Dataset, e Financial Dataset entregam perfis de empresas, tickers de ações e preços como arquivos prontos.
- Google Finance Datasets, Historical Financial Data, e Financial News Dataset entregam dados do Google Finance, dados financeiros históricos e notícias financeiras como arquivos prontos.
- Yahoo News API e Yahoo Search API retornam resultados do Yahoo News e da busca Yahoo.
Considerações finais
As páginas de cotação do Yahoo Finance contêm suas próprias respostas de API como JSON, então 1 solicitação por aba retorna os dados sem navegador, cookie ou crumb. Corrija o cliente antes de adicionar atrasos, porque os 429s do Yahoo nas primeiras solicitações dependiam do handshake TLS e User-Agent do cliente. Faça o parsing das respostas embutidas, valide cada página, compare cada nome com sua lista de tickers, e converta unidades monetárias menores dentro do parser.
Para tarefas de servidor agendadas, roteie o mesmo parser através da Web Unlocker API, ou deixe a Yahoo Finance Scraper API retornar registros estruturados. Nossos créditos gratuitos mensais se aplicam a ambos, então você pode testar qualquer um com sua própria lista de tickers.
Perguntas frequentes
Existe uma API oficial do Yahoo Finance?
Não. O Yahoo diz que desativou o acesso via API aos dados de cotação porque seus fornecedores de dados “não autorizam atualmente” a redistribuição em forma de API. Os hosts de API internos que o yfinance usa não são documentados e são desautorizados no robots.txt. As páginas de cotação do Yahoo embutem os mesmos dados como JSON.
O yfinance ainda é utilizável?
Sim, de casa e 3 executores do GitHub Actions, o yfinance buscou o histórico diário completo da MSFT em menos de 1,5 segundos. Ele usa o handshake TLS do Chrome do curl_cffi. Seu README chama a API do Yahoo de “destinada apenas para uso pessoal”. Desenvolvedores relataram 401s e falhas de busca de alguns hosts em nuvem, então teste a partir do seu próprio servidor.
O Yahoo Finance bloqueia web scraping?
Sim, para alguns clientes. O Yahoo bloqueou o cliente requests padrão do Python na primeira solicitação. Com o handshake TLS do Chrome, o curl_cffi não recebeu 429s em uma conexão residencial ou 3 executores do GitHub Actions. Para tarefas agendadas, a Web Unlocker API da Bright Data busca as mesmas páginas com rotação de IP e novas tentativas automáticas.
É possível baixar dados do Yahoo Finance?
Sim, mas a página de ajuda do Yahoo limita o download CSV a assinantes pagos do Yahoo Finance. Em código, uma única solicitação à aba de dados históricos retornou cada barra diária da MSFT desde 1986. Para arquivos em massa, o Yahoo Finance Dataset da Bright Data entrega registros de empresas, fundos e índices na programação que você escolher.
A API do Yahoo Finance é gratuita?
Não oficialmente. Os endpoints internos do Yahoo não custam nada para chamar, mas não são documentados e são desautorizados para crawlers. A página de ajuda do Yahoo limita downloads CSV a assinantes pagos. A Yahoo Finance Scraper API da Bright Data retorna registros estruturados, e novas contas recebem créditos gratuitos mensais para testá-la.