Fazer scraping do Walmart em escala dá às equipes de preços os preços, estoque e avaliações que os compradores veem, coletados de milhares de páginas de forma programada.
A verificação de bots do Walmart é apenas o primeiro problema. Quando busquei páginas de produtos com IPs rotativos, o Walmart precificou cada página para uma loja diferente. Se seu scraper não define um CEP ou loja, o Walmart escolhe uma loja com base no endereço IP. Sua tabela de preços então mistura lojas, e nenhum erro avisa você.
Este guia explica as defesas e limites de listagem do Walmart, qual método escolher, e como coletar preços por loja em Python.
Resumo
- A loja pode mudar o preço. Em 8 CEPs, o mesmo galão de leite variou de $2,42 a $6,28.
- Definir a loja por requisição funcionou. Com um ID de loja, a Walmart Scraper API da Bright Data retornou os preços exatos que o navegador mostrou em ambas as lojas comparadas.
- Uma listagem de categoria do Walmart parou perto de 390 produtos únicos. Ela alegava cerca de 2.450 itens mas mostrava 389, e dividi-la em 9 faixas de preço encontrou 2.069.
- Um status 200 não significava sucesso. O Walmart serviu seu desafio “Robô ou humano?” com HTTP 200, então verifique o conteúdo e o ID da loja de cada registro.
Como o Walmart detecta scrapers
As páginas de produtos do Walmart eram protegidas por Akamai, HUMAN e um firewall de aplicação web (WAF) F5. Os cabeçalhos, cookies e configuração em tempo de execução da resposta de uma única página de produto mostraram os 3:
| Camada | Como eu reconheci | O que os scripts recebiam |
|---|---|---|
| Akamai edge | Cabeçalhos x-ak-protocol e server-timing: ak_p, o cookie akavpau_p2, e os cookies do Bot Manager ak_bmsc e bm_sv em sessões de navegador |
418 Access Denied para chamadas GraphQL sem os cabeçalhos de cliente do Walmart |
| HUMAN, antigo PerimeterX | Um sensor próprio em /px/PXu6b0qd2S/init.js e os cookies _pxhd, _px3 e _pxvid |
Um redirecionamento 307 para /blocked, depois uma página “Robô ou humano?” de pressionar e segurar com status 200 |
| F5 WAF | 6 cookies com prefixo TS em uma sessão de navegador, como TS012768cf |
Nenhuma resposta de bloqueio rastreada até ele |
O Chrome headless simples, lançado com Playwright, recebeu o CAPTCHA de pressionar e segurar da HUMAN nas duas vezes que testei. A página de desafio parecia uma página normal do Walmart e retornou status 200:
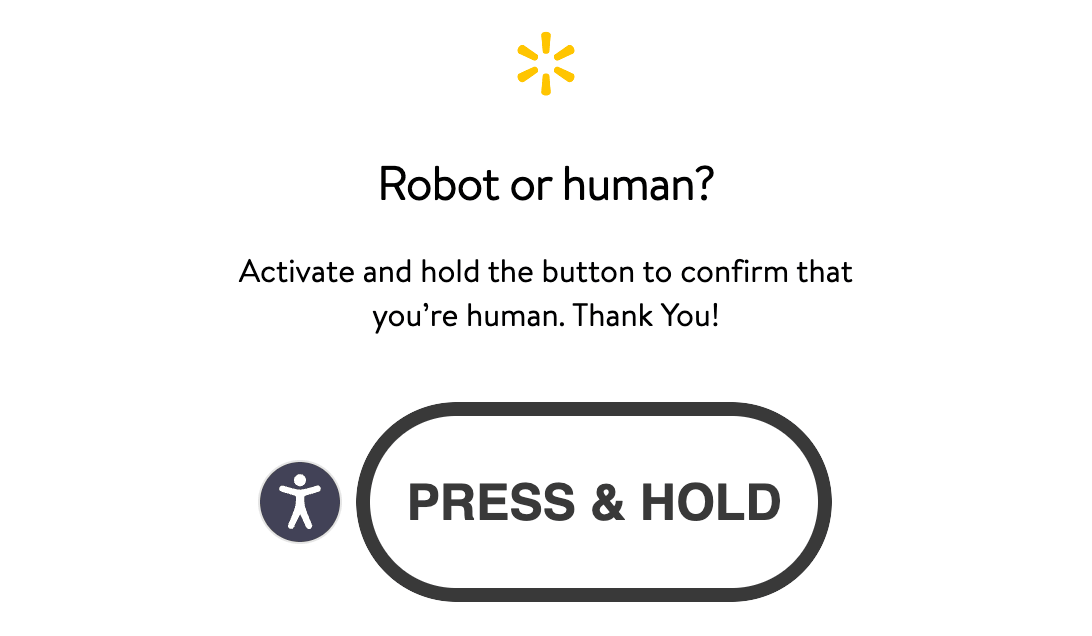
Um scraper que verifica apenas o código de status salvaria esta página como sucesso.
A mesma configuração em tempo de execução habilitou o ThreatMetrix, um serviço de perfilamento de dispositivos, apenas em páginas de conta como carrinho, pedidos, carteira e assinaturas. Essa lista não incluía páginas de produto, categoria ou avaliação, as que o monitoramento de preços precisa.
A própria flag de bot do Walmart não mostrava se uma requisição passou. Cada página de produto incorporava um objeto psych com campos como isAkamaiBot. Esse campo era "1" mesmo em páginas que o Walmart servia por completo, então julgue uma resposta pelo seu conteúdo e pelo ID da loja.
Quais clientes HTTP foram desafiados
No mesmo IP, se o Walmart mostrava um desafio dependia do cliente HTTP. Solicitei as mesmas 5 URLs de produtos do Walmart com 6 clientes HTTP de um IP de banda larga residencial fora dos EUA, 1 URL por rodada. Em cada rodada, os clientes solicitaram essa URL um de cada vez, com 2 segundos de intervalo, e cada um mantinha seu próprio conjunto de cookies.
Das 5 URLs, 3 estavam inativas, e ainda assim deram um sinal claro. Um cliente que passou recebeu a página 404 do Walmart, enquanto um cliente desafiado recebeu a página de desafio:
| Cliente | Páginas de desafio em 5 requisições |
|---|---|
| curl com LibreSSL | 4 |
Python requests |
2 |
httpx com HTTP/2 |
1 |
curl_cffi personificando Firefox |
2 |
curl_cffi personificando Chrome |
0 |
curl_cffi personificando Safari |
0 |
Nas 2 rodadas com URLs de produtos ativos, curl, requests e o perfil Firefox receberam o desafio. Nas mesmas rodadas, segundos depois, os perfis Chrome e Safari receberam a página do produto.
Nosso guia de curl_cffi cobre a configuração de personificação, e nosso artigo sobre fingerprinting TLS cobre o que o handshake expõe.
Através de uma sessão dos EUA nos proxies residenciais da Bright Data, os mesmos 6 clientes fizeram 30 requisições sem uma única página de desafio. Cada cliente recebeu um IP residencial dos EUA. Os resultados dependem de cada combinação de cliente e proxy, então teste o seu contra o Walmart na concorrência que você planeja executar.
Onde as páginas do Walmart mantêm seus dados
O Walmart renderizou páginas de produto, busca, categoria e avaliação com o roteador de páginas Next.js. Cada página incorporava seu modelo de dados como JSON em uma tag de script __NEXT_DATA__. Em uma página de produto de doce, esse JSON era 401 KB dos 592 KB de HTML. Esses caminhos JSON continham os campos que importam:
- Páginas de produto:
props.pageProps.initialData.data.product, incluindo preço, disponibilidade, vendedor e um objetolocation - Páginas de busca e categoria:
props.pageProps.initialData.searchResult.itemStacks[].items, com o total reportado emsearchResult.aggregatedCount - Páginas de avaliação:
props.pageProps.initialData.data.reviews, com seu próprio bloco de paginação
A tag tinha um atributo nonce, então combine por id com um padrão que permita atributos extras.
No navegador, a API GraphQL do Walmart servia dados que a página não incorporava, como detalhes de itens mais abaixo na página. A API usava consultas persistidas, que são consultas salvas que o cliente chama por um hash SHA-256 na URL:
/orchestra/pdp/graphql/ItemByIdBtf/<sha256-hash>/ip/<item-id>O Walmart bloqueou reproduções programadas dessas chamadas GraphQL. Sem os cabeçalhos de cliente x-o-* do Walmart, uma chamada programada para /orchestra/home/graphql recebia o 418 da Akamai. Com os cabeçalhos, recebia um bloqueio da HUMAN como JSON com status 412.
Esses cabeçalhos também incluíam a versão do aplicativo web, que muda com os lançamentos do Walmart, então valores fixos em scrapers de código aberto mais antigos ficam desatualizados.
O script abaixo busca uma página de produto através da Web Unlocker API da Bright Data, depois lê os dados do produto e a loja para a qual foi precificado. Precisa de Python 3.9 ou posterior e requests, sua chave API em BRIGHTDATA_API_TOKEN, e o nome da sua zona Web Unlocker em BRIGHTDATA_UNLOCKER_ZONE:
import json
import os
import re

import requests

API_KEY = os.environ["BRIGHTDATA_API_TOKEN"]
ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]  # nome da sua zona Web Unlocker
NEXT_DATA = re.compile(r'<script id="__NEXT_DATA__"[^>]*>(.*?)</script>', re.S)


def fetch(url: str) -> tuple[str, str]:
    """Retorna o código de status e o HTML da página."""
    r = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={"zone": ZONE, "url": url, "format": "raw", "country": "us"},
        timeout=180,
    )
    r.raise_for_status()
    # O Web Unlocker reporta o código de status da página alvo neste cabeçalho.
    return r.headers.get("x-brd-status-code", ""), r.text


def parse_product(html: str) -> dict:
    if "Robot or human" in html:
        raise RuntimeError("página de desafio, não uma página de produto")
    match = NEXT_DATA.search(html)
    if match is None:
        raise RuntimeError("nenhum bloco __NEXT_DATA__ na página")
    data = json.loads(match.group(1))["props"]["pageProps"]["initialData"]
    product = data["data"]["product"]
    location = product.get("location") or {}
    price = (product.get("priceInfo") or {}).get("currentPrice") or {}
    return {
        "us_item_id": product.get("usItemId"),
        "name": product.get("name"),
        "price": price.get("price"),
        "availability": product.get("availabilityStatus"),
        "seller": product.get("sellerName"),
        "store_id": (location.get("storeIds") or [None])[0],
        "zip": location.get("postalCode"),
    }


status, html = fetch("https://www.walmart.com/ip/10450114")
if status != "200":
    raise RuntimeError(f"status da página {status}, não 200")
print(status, json.dumps(parse_product(html), indent=2))
Uma execução retornou um produto ativo precificado para uma loja que o script nunca solicitou. Sua execução provavelmente mostrará outra loja:
200 {
  "us_item_id": "10450114",
  "name": "Great Value Whole Vitamin D Milk, Gallon",
  "price": 3.32,
  "availability": "IN_STOCK",
  "seller": "Walmart.com",
  "store_id": "3081",
  "zip": "95829"
}
A Web Unlocker API reporta o próprio código de status do Walmart no cabeçalho x-brd-status-code, como sua página de códigos de erro descreve. O script verifica esse cabeçalho antes de analisar a página.
Analise o JSON incorporado primeiro. Para dados que a página não incorpora, chame o GraphQL de uma sessão de navegador, pois chamadas programadas foram bloqueadas.
Por que um preço do Walmart depende da loja
A documentação da Affiliate Marketing API do Walmart dizia que o preço e disponibilidade de um item dependem do CEP e ID da loja da requisição. Sobre preços na loja física, um porta-voz do Walmart disse à CNBC que “o preço que você vê é o mesmo para todos em qualquer loja específica.” Cada página de produto era precificada para uma loja específica.
A página nomeava essa loja em seu texto “Retirada de”, e o preço variava por loja. O mesmo galão de leite custava $3,32 na loja de Sacramento que o Walmart atribuiu e $3,03 em uma loja de Atlanta que escolhi manualmente:
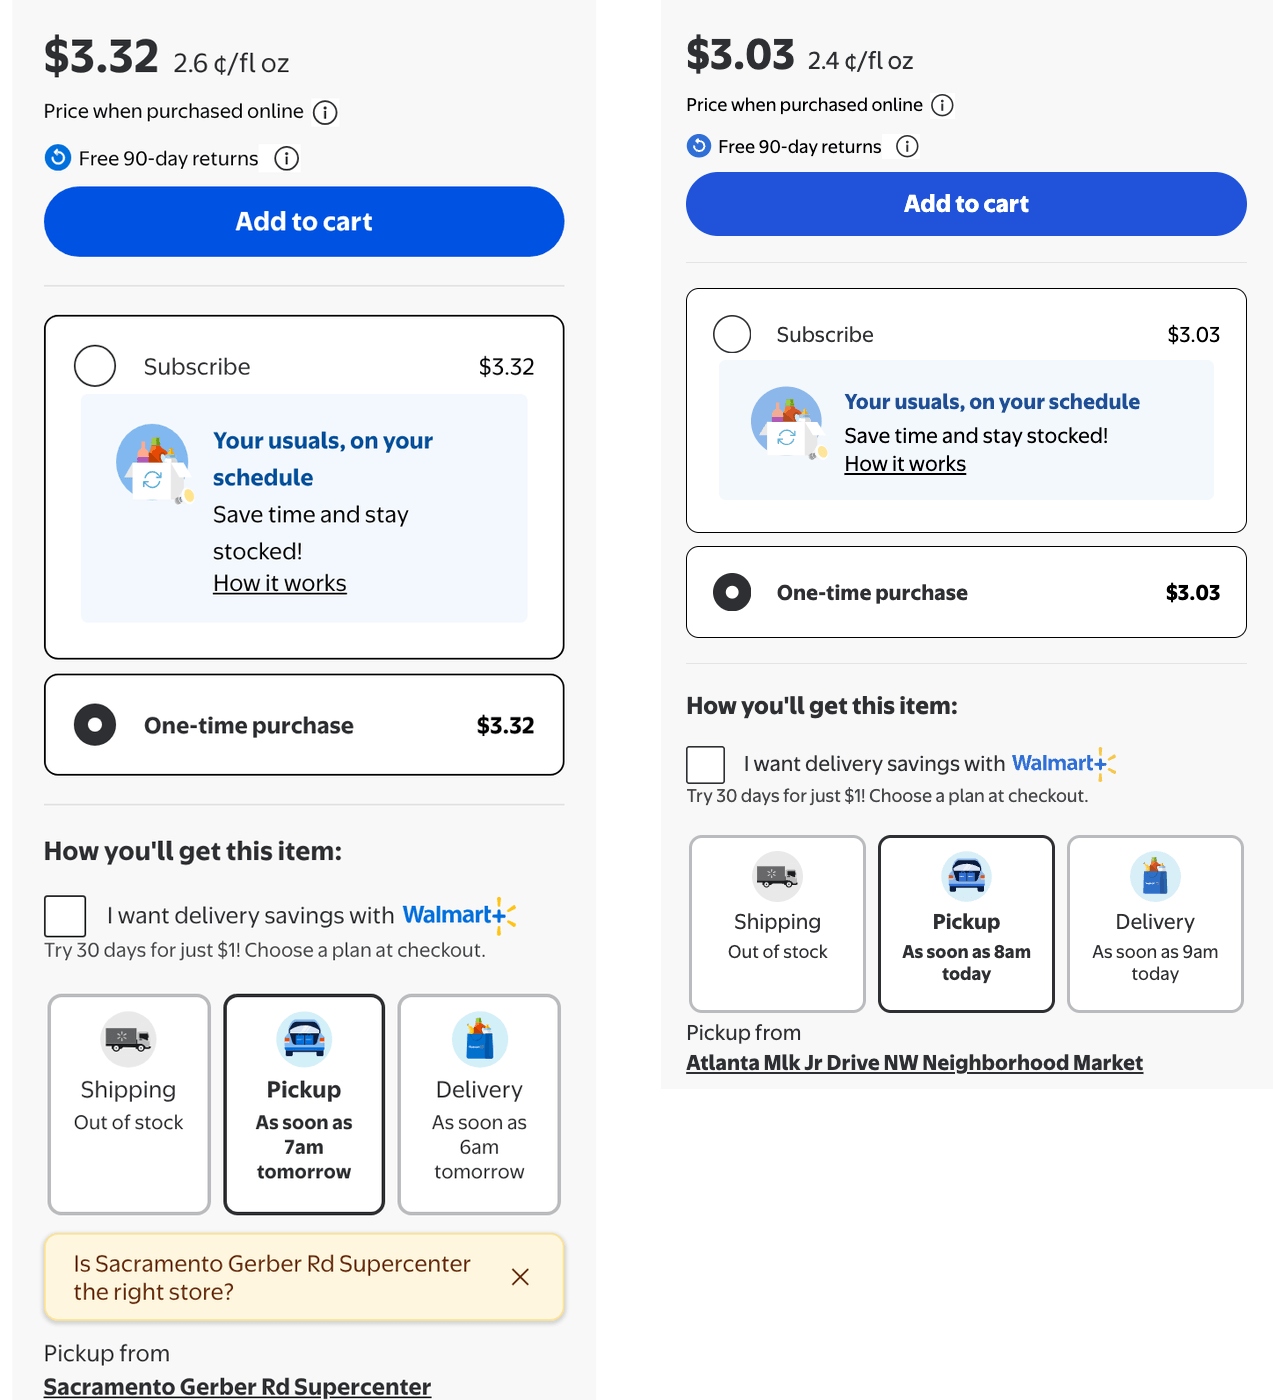
Sem a loja em cada registro, esses 2 preços para o mesmo leite pareceriam uma mudança de preço.
Quando uma requisição não incluía localização, o Walmart escolhia uma loja, registrava no objeto location da página, e marcava a escolha como IMPLICIT. Algumas conexões recebiam uma loja padrão, loja 3081 em Sacramento, CEP 95829, que é a loja na saída do script. O Walmart baseava a loja no IP de saída, então IPs rotativos também mudavam a loja:
- IPs rotativos: cada uma das 48 páginas de produto foi precificada para uma loja diferente.
- Outras conexões: um IP de banda larga fora dos EUA e um IP via satélite receberam ambos a loja padrão. O Walmart localizou outra sessão em Big Water, Utah, CEP 84741, e deu a ela a loja padrão também.
Por que definir a loja via script não era confiável
Testei 2 formas, e ambas deixaram a escolha da loja para o Walmart:
- Cookies de localização: Defini
assortmentStoreIde um cookielocGuestDataconstruído manualmente. De 9 requisições com os cookies, 6 receberam a página de desafio, enquanto 0 de 3 requisições sem eles receberam. As 3 que passaram mantiveram a loja do IP. - Escolher o IP de saída: O Walmart usava sua própria geolocalização de IP. Essa geolocalização correspondeu ao CEP de uma busca de IP padrão em apenas 5 de 11 páginas, então o CEP de um IP não previa a loja.
Como um CEP ou ID de loja define a loja
O input zipcode da Walmart Scraper API da Bright Data define a localização para cada requisição. Coletei 4 itens de mercearia em cada um de 8 CEPs, e o mesmo galão de leite integral Great Value mostrou 8 preços diferentes:
| CEP | ID da loja no registro | Preço |
|---|---|---|
| 60614, Chicago, IL | 5402 | $2,42 |
| 75201, Dallas, TX | 5823 | $2,46 |
| 72712, Bentonville, AR | 100 | $2,72 |
| 33177, área de Miami, FL | 6397 | $2,92 |
| 94103, São Francisco, CA | 2648 | $3,32 |
| 10001, Nova York, NY | 3520, Secaucus Supercenter, NJ | $4,07 |
| 99504, Anchorage, AK | 4359 | $4,98 |
| 96813, Honolulu, HI | 3478 | $6,28 |
As bananas variaram de $0,13 em Bentonville a $0,42 em Honolulu. Os ovos custavam $1,67 em todos os 8 CEPs, mas a retirada estava indisponível em 3 deles. Registre a disponibilidade por loja, da mesma forma que o preço.
Definir a loja ainda importava para o whey protein, que variou menos que o leite. Coletei 387 de seus produtos duas vezes, primeiro sem CEP e depois com o CEP de Bentonville. Os registros da primeira execução vieram de 170 lojas diferentes, e 24 produtos mudaram de preço entre as 2 execuções.
Um CEP não é uma loja. O CEP 10001 em Manhattan resolveu para o Secaucus Supercenter em Nova Jersey, loja 3520. O seletor de loja do Walmart listou várias lojas para o CEP 30303 em Atlanta:
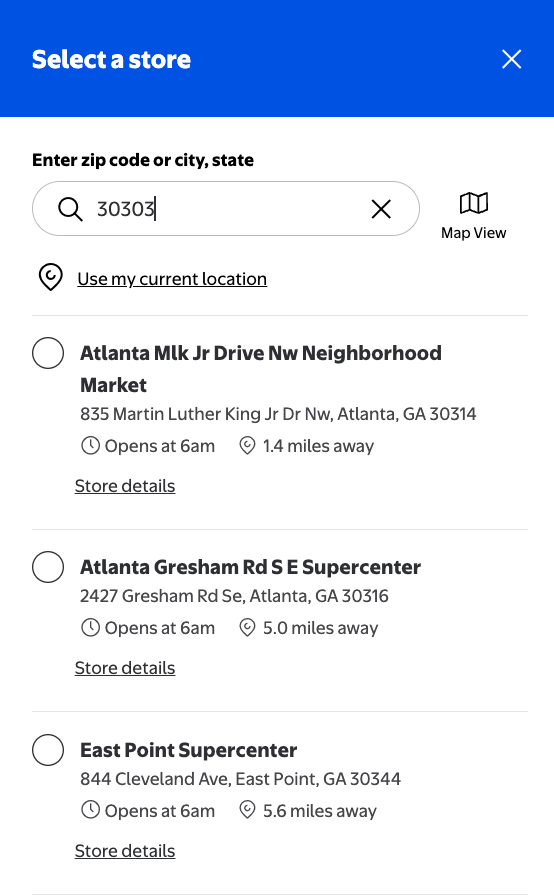
As primeiras 3 lojas listadas para o CEP 30303. Um CEP aponta para uma área, e um ID de loja aponta para uma loja.
Quando você precisa de uma loja específica, a Walmart Scraper API também aceita um store_id. A URL da página de cada loja no walmart.com continha seu ID, como 100 em walmart.com/store/100-bentonville-ar. O sitemap de lojas do Walmart, walmart.com/sitemap_store_main.xml, listava essas URLs por tipo de loja, incluindo páginas para 3.582 Supercenters e 675 Neighborhood Markets. Quando defini as 2 lojas das capturas de tela do leite, a API retornou os preços que o navegador mostrou, $3,32 em Sacramento e $3,03 em Atlanta.
Execuções repetidas para o mesmo CEP retornaram os mesmos preços. O leite em Chicago custou $2,42 novamente em 2 execuções posteriores dentro de 90 minutos. Em Bentonville, 2 jobs que rodaram ao mesmo tempo retornaram os mesmos preços para todos os 39 produtos que ambos os jobs coletaram. Um dia depois, o CEP 72712 ainda resolvia para a loja 100, e o leite lá ainda custava $2,72.
O que registrar com cada preço
Ambos os preços do leite nas capturas de tela tinham o rótulo do Walmart “Preço quando comprado online”, então trate os preços coletados como os preços online de cada loja.
A disponibilidade também depende do método de atendimento. Na página do leite, o envio mostrava fora de estoque enquanto a retirada e entrega da mesma loja mostravam em estoque. Os registros da Walmart Scraper API tinham flags separadas de retirada e entrega para isso. Seu campo Fulfillment_type nomeava quem atendeu o pedido, como o vendedor ou os Walmart Fulfillment Services.
Os preços unitários do Walmart também usavam unidades diferentes. O mesmo galão mostrou um unit_price de 0,023 por onça líquida em Miami e 1,02 por quarto em Nova York. Recalcule os preços unitários a partir do tamanho da embalagem. Para o leite, o registro completo listava o tamanho da embalagem em specifications como 128 onças líquidas.
Os preços também mudam ao longo do tempo. O Walmart reportou mais de 11.000 rollbacks, seu termo para cortes temporários de preço, em um único trimestre.
Chaveie cada preço por ID da loja, CEP e carimbo de tempo, e registre a disponibilidade para cada método de atendimento. Rejeite qualquer registro precificado para uma localização que você não solicitou.
Como trabalhar dentro dos limites de listagem e avaliação do Walmart
A página de categoria de whey protein do Walmart reportava cerca de 2.450 itens e um maxPage de 25. As páginas 1 a 10 continham cerca de 50 slots de produto cada, dos quais cerca de 10 eram patrocinados. Páginas após a página 11 não tinham produtos:
| Página de categoria | Slots de produto retornados |
|---|---|
| 1 a 10 | 47 a 50 por página |
| 11 | 13 em uma execução, 0 em outra |
| 12 a 25 | 0 |
As páginas 1 a 11 tinham 501 slots no total, e continham 389 produtos únicos. Esse limite de paginação vinha da própria listagem do Walmart, então apareceu da mesma forma em cada sessão que executei.
Em um navegador desktop, os números de página ainda alcançavam 25, e a página 12 retornava a página de não encontrado do Walmart:
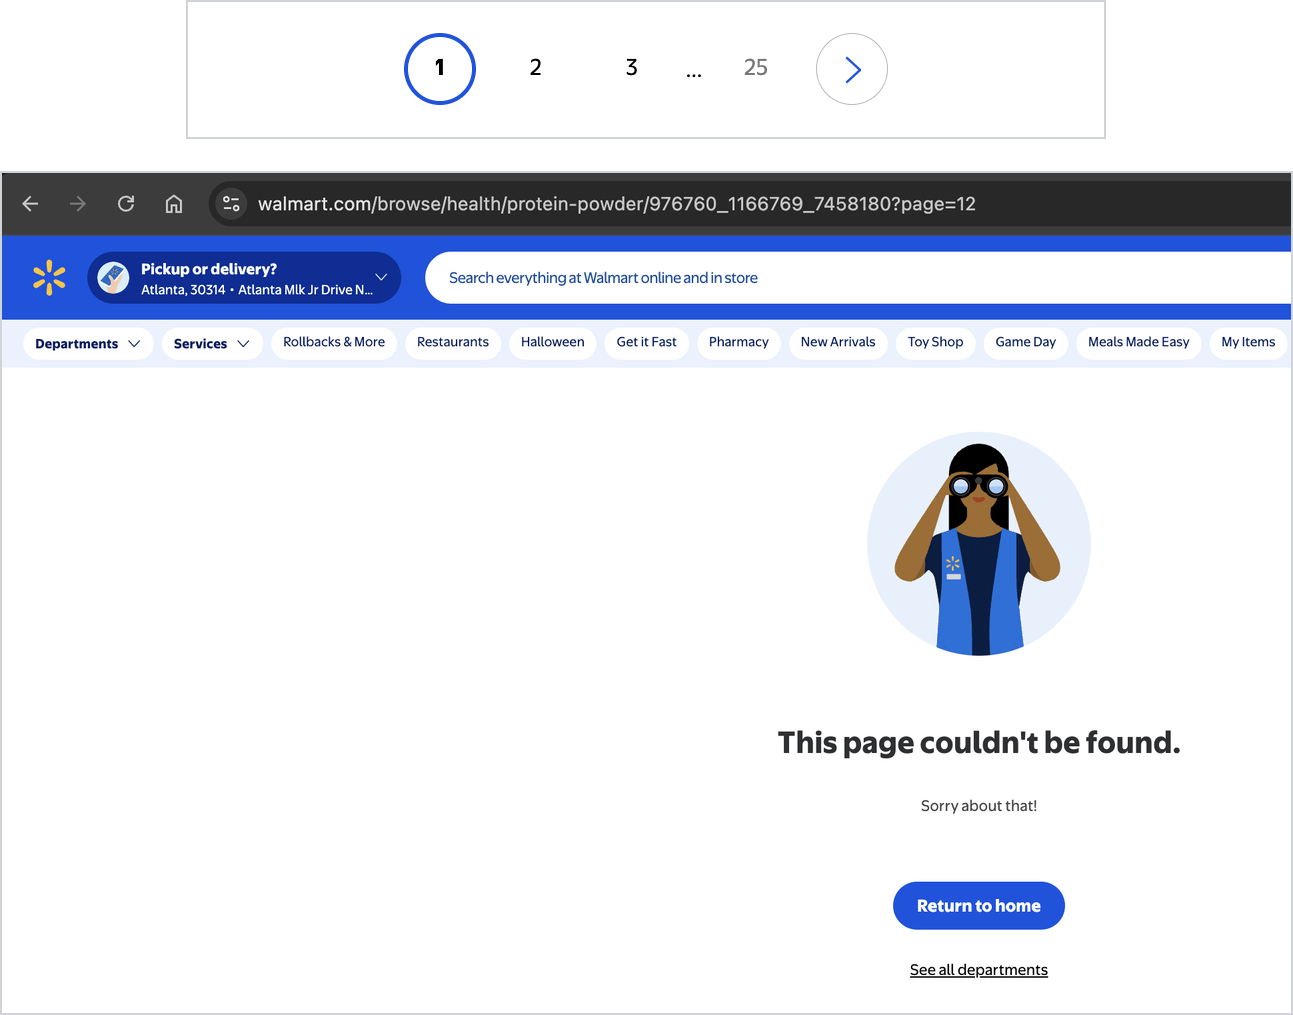
Um scraper que seguisse os números de página até 25 não obteria nada após a página 11.
Como dividir uma categoria em faixas de preço
A descoberta de categorias da Walmart Scraper API aceita URLs de categoria com os filtros de preço do Walmart, para que você possa coletar uma categoria faixa por faixa. Como base, a URL de categoria sem filtro retornou 393 produtos únicos, próximo dos 389 que a listagem mostrava.
Os parâmetros de URL min_price e max_price do Walmart dividem a categoria em faixas de preço, e cada faixa reportava sua própria contagem. Primeiro dividi a categoria em $15, $25, $35, $50 e $75. Depois dividi as 3 faixas que reportaram mais de 500 produtos, em $42, $62 e $100, e executei a descoberta em todas as 9 faixas:
| Faixa de preço | Produtos reportados pelo Walmart | Produtos únicos descobertos |
|---|---|---|
| $0 a $15 | 75 | 60 |
| $15 a $25 | 230 | 189 |
| $25 a $35 | 429 | 330 |
| $35 a $50, em 2 faixas | 718 | 569 |
| $50 a $75, em 2 faixas | 592 | 484 |
| $75 e acima, em 2 faixas | 519 | 444 |
As 9 faixas retornaram 2.069 produtos únicos, cerca de 5 vezes a base. A soma da coluna dá 2.076 porque alguns produtos apareceram em 2 faixas. Nenhuma faixa retornou mais de 330 produtos únicos, então cada uma ficou abaixo do limite de paginação.
As contagens reportadas pelo Walmart foram de 17% a 30% maiores que os produtos únicos que cada linha retornou. Na faixa de $0 a $15, as 2 páginas de listagem mostraram apenas 62 produtos únicos, não os 75 que o Walmart reportou. A descoberta retornou 60, próximo dos 62 nas páginas. Trate a contagem reportada pelo Walmart como um limite superior.
Divida cada categoria em faixas de preço até que cada faixa retorne menos produtos únicos que seu limite de paginação, que foi cerca de 390 para whey protein.
Os sitemaps de produtos do Walmart listavam muito mais produtos que uma listagem de categoria. Através da Web Unlocker API, busquei um índice de sitemap de produtos que apontava para 5.916 arquivos de sitemap. O primeiro arquivo sozinho continha 50.000 URLs de produtos de categorias mistas, e cada URL tinha apenas uma data de última modificação. Use sitemaps para listas de URLs em todo o catálogo, e use faixas de preço para as categorias que você acompanha.
Onde resultados de busca e avaliações param
A busca tinha seu próprio limite de página. Uma busca por “notebook” reportou 20.251 resultados mas um maxPage de 14, a 40 resultados por página, então no máximo 560 resultados eram alcançáveis. Onde puder, descubra produtos através de categorias ou sitemaps.
Quando você precisa dos próprios resultados de busca, como em rastreamento de share-of-shelf, use o scraper de busca de produtos do Walmart, cujos registros sinalizavam resultados patrocinados. Uma busca por “whey protein” retornou 568 registros, incluindo 164 patrocinados. Entre esses registros, 55 IDs de item apareceram mais de uma vez, e 52 deles eram resultados patrocinados e orgânicos ao mesmo tempo. Mantenha ambos os posicionamentos para share-of-shelf, e remova duplicatas por ID de item para uma lista de produtos.
As avaliações tinham seu próprio limite de paginação. A página do leite mostrava 399.133 avaliações, das quais 27.412 tinham texto escrito. Na ordenação padrão, sua paginação mostrava 10 avaliações por página e parava em 10.000. A página 1001 não falhava mas retornava a página 1 novamente, então pare na contagem de páginas que o Walmart reporta em vez de esperar uma página vazia.
O scraper de avaliações do Walmart aceita um input sort_by para a ordem das avaliações. Para um produto de doce com 127 avaliações, ele retornou todas as 41 avaliações escritas.
Por que sua lista de URLs precisa de atualizações regulares
Cerca de 1 em cada 7 URLs de produtos antigas estava inativa. De 150 URLs de produtos com cerca de 2 anos, 22 retornaram 404 ou 410, e outras 37 páginas ativas não tinham preço.
Execute a descoberta novamente com frequência suficiente para manter sua lista de URLs atualizada, para que cada job colete produtos ativos.
Como escolher um método para fazer scraping do Walmart
Cada método abaixo faz uma quantidade diferente do trabalho para você, desde acesso bruto à página até registros finalizados. A página de precificação de cada produto lista seus preços atuais:
| Método | O que ele trata para você | Base de cobrança | Seleção de loja | Precificação atual |
|---|---|---|---|---|
| Proxies residenciais rotativos com seu próprio parser | IPs residenciais rotativos para seu próprio cliente e parser | Por GB de tráfego | Definido pelo Walmart a partir do IP de saída | Preços de proxies residenciais |
| Web Unlocker API com seu próprio parser | Desbloqueio, com o código de status do Walmart em um cabeçalho de resposta | Por requisição bem-sucedida | Definido pelo Walmart a partir do IP de saída | Preços do Web Unlocker |
| Walmart Scraper API | Descoberta, coleta e registros analisados com campos de loja | Por registro entregue | Definido por requisição com zipcode e store_id |
Preços da Web Scraper API |
| Browser API | Um navegador completo com solucionador de CAPTCHA integrado, para fluxos interativos | Por GB de tráfego | Definido ao escolher uma loja na página | Preços do Browser API |
| Conjuntos de dados do Walmart | Dados prontos de produtos, avaliações e vendedores do Walmart | Por registro | Definido no momento da coleta | Preços de conjuntos de dados |
Proxies residenciais e a Web Unlocker API entregam a página bruta, então sua equipe executa o parsing e a validação de loja. A Walmart Scraper API retorna registros analisados que você pode validar diretamente.
Os proxies residenciais dão a você controle total de cada requisição. Você escolhe o cliente, cabeçalhos e parser, o que se adequa a equipes que já operam sua própria infraestrutura.
A Web Unlocker API trata do acesso para que você possa focar no parsing. Ela também buscou os sitemaps de produtos do Walmart para listas de URLs em todo o catálogo.
A Walmart Scraper API se encaixa em trabalho por loja em volume. Seus inputs zipcode e store_id definem a localização, e seus registros reportam a loja para a qual foram precificados, então seu pipeline pode verificar cada registro.
Use a Browser API para fluxos interativos. Ela executa um navegador completo, o que se adequa a explorar uma página e capturar novos endpoints. Para volume em escala de catálogo, combine-a com a Walmart Scraper API ou a Web Unlocker API.
Conjuntos de dados se encaixam em preenchimentos retroativos e análise em todo o catálogo. Os conjuntos de dados do Walmart oferecem uma escolha de cronogramas de atualização.
Agentes podem executar consultas de produto único. O Bright Data CLI tem um pipeline walmart_product, e o servidor MCP da Bright Data tem uma ferramenta web_data_walmart_product. A partir de uma URL de produto, o pipeline CLI retornou um registro com o mesmo esquema dos registros da Walmart Scraper API.
Compare todos os métodos pelo custo por registro válido, porque uma página precificada para a loja errada não é um registro utilizável por loja.
Como construir um pipeline de preços por loja com a Walmart Scraper API
Para fazer scraping do Walmart em escala, descubra URLs por faixa de preço, defina um CEP ou ID de loja em cada uma, e verifique o ID da loja de cada registro. A Walmart Scraper API tem scrapers separados para produtos, avaliações, vendedores e busca, todos disponíveis através da mesma API REST. Novas contas podem começar no nível gratuito. Cada scraper tem seu próprio ID de conjunto de dados e inputs:
| Scraper | ID do conjunto de dados | Principais inputs | Use para |
|---|---|---|---|
| Produtos do Walmart | gd_l95fol7l1ru6rlo116 |
url com zipcode e store_id opcional, ou descoberta por category_url, keyword ou sku |
Preços por loja, detalhes do produto e imagens |
| Produtos do Walmart por CEP | gd_m693oc1r1gebnayxq |
url com zip_code e store_id opcional, ou descoberta por categoria ou palavra-chave |
Loja de retirada, quantidade em estoque e ETA de entrega |
| Avaliações do Walmart | gd_mpql1v8g2o8o6l1wzd |
url com sort_by opcional |
Avaliações escritas |
| Informações de vendedores do Walmart | gd_m7ke48w81ocyu4hhz0 |
url da página do vendedor |
Perfis de vendedores |
| Busca de produtos do Walmart | gd_m7khey0wb7wviejgj |
url da página de busca |
Resultados de busca com flags de patrocínio |
No painel de controle, o scraper de produtos do Walmart aceitava um zipcode e um store_id com cada URL:
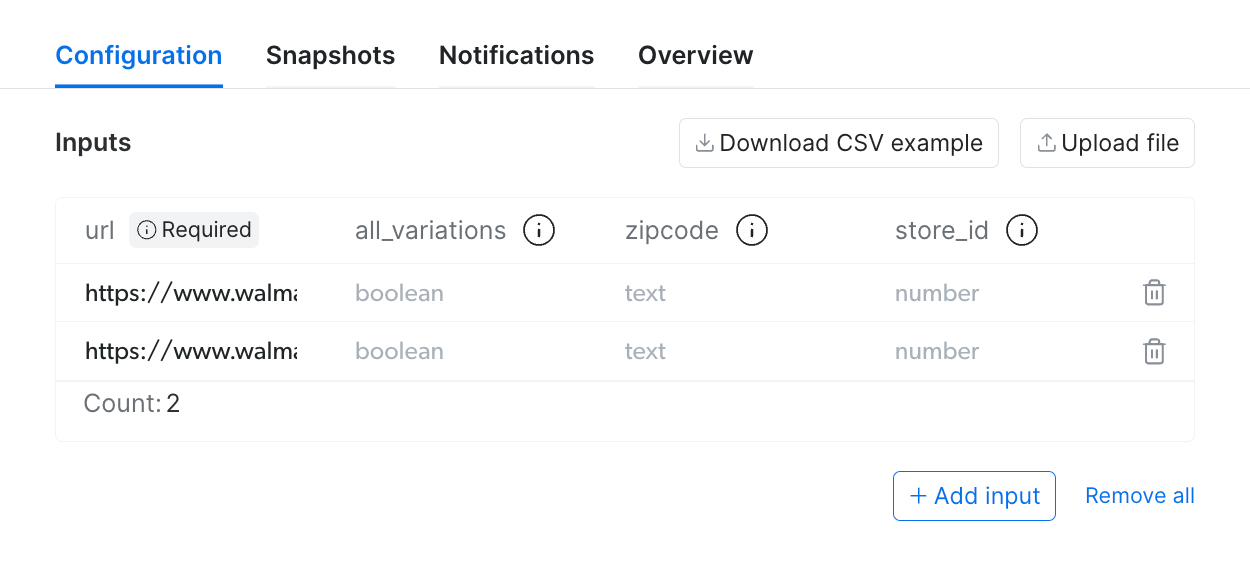
As colunas zipcode e store_id solicitam uma loja para cada registro.
Crie os auxiliares compartilhados
Esses auxiliares precisam de uma chave API em BRIGHTDATA_API_TOKEN. A função post respeita o Retry-After, então seu cliente espera e tenta novamente quando atinge os limites de requisições assíncronas:
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}
WALMART_PRODUCTS = "gd_l95fol7l1ru6rlo116"


def post(url, **kwargs):
    """POST que respeita Retry-After para ficar dentro dos limites de taxa."""
    for attempt in range(6):
        r = requests.post(url, headers=HEADERS, timeout=120, **kwargs)
        if r.status_code != 429:
            r.raise_for_status()
            return r
        time.sleep(int(r.headers.get("Retry-After") or 2 ** (attempt + 1)))
    r.raise_for_status()


def wait_and_download(snapshot_id, every=30):
    while True:
        r = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS,
                         timeout=60)
        r.raise_for_status()
        status = r.json()["status"]
        if status == "ready":
            break
        if status in ("failed", "canceled"):
            raise RuntimeError(f"{snapshot_id} terminou como {status}")
        time.sleep(every)
    while True:  # 202 significa que o arquivo ainda está sendo montado
        r = requests.get(f"{API}/snapshot/{snapshot_id}", headers=HEADERS,
                         params={"format": "json"}, timeout=300)
        if r.status_code == 200:
            return r.json()
        r.raise_for_status()
        time.sleep(10)
Os blocos de descoberta e coleta abaixo reutilizam post, wait_and_download, API e HEADERS, então mantenha os 3 blocos no mesmo arquivo.
Descubra URLs de produtos por faixa de preço
Essas funções dividem uma categoria em faixas de preço e retornam uma lista ordenada de URLs únicas:
def price_ranges(category_url, edges):
    """Um input de descoberta por faixa de preço.

    Escolha limites que mantenham cada faixa abaixo do limite de paginação.
    """
    sep = "&" if "?" in category_url else "?"
    urls = [f"{category_url}{sep}min_price={lo}&max_price={hi}"
            for lo, hi in zip(edges, edges[1:])]
    return [{"category_url": u, "all_variations": False} for u in urls]


def discover(category_url, edges, per_range=600):
    body = {"input": price_ranges(category_url, edges),
            "limit_per_input": per_range}
    params = {"dataset_id": WALMART_PRODUCTS, "type": "discover_new",
              "discover_by": "category_url", "include_errors": "true"}
    job = post(f"{API}/trigger", params=params, json=body)
    records = wait_and_download(job.json()["snapshot_id"])
    urls = {r["url"].split("?")[0] for r in records if r.get("url")}
    return sorted(urls)
Com per_range=600, um único job de descoberta nas 9 faixas de preço de whey protein retornou 2.069 URLs de produtos únicas.
Registros de erro tinham uma mensagem error descritiva junto com seu error_code, como o status 410 Gone que o Walmart retornou para produtos removidos. discover mantém apenas registros com um url, então leia registros de erro do snapshot bruto ao verificar uma execução.
Colete e valide registros por loja
Depois colete cada URL com um CEP, e valide cada registro antes que ele chegue ao seu data warehouse. Inclua input, error e error_code na lista de campos, para que cada registro mantenha seu input e quaisquer detalhes de erro. Adicione specifications se você recalcular preços unitários a partir do tamanho da embalagem:
FIELDS = "|".join([
    "product_id", "product_name", "final_price", "currency", "unit_price",
    "available_for_pickup", "available_for_delivery", "store_id",
    "store_name", "store_location", "seller", "timestamp",
    "input", "error", "error_code",  # mantém input e detalhes de erro
])


def collect(urls, zipcode, store_id=None, webhook=None):
    """Inicia um job assíncrono para um CEP. Retorna o ID do snapshot."""
    params = {"dataset_id": WALMART_PRODUCTS, "include_errors": "true",
              "format": "json", "custom_output_fields": FIELDS}
    if webhook:  # A Bright Data faz POST dos registros finalizados para esta URL
        params |= {"endpoint": webhook, "uncompressed_webhook": "true",
                   "auth_header": os.environ["WEBHOOK_AUTH_HEADER"]}
    row = {"zipcode": zipcode} | ({"store_id": store_id} if store_id else {})
    body = {"input": [{"url": u, **row} for u in urls]}
    job = post(f"{API}/trigger", params=params, json=body)
    return job.json()["snapshot_id"]


def validate(records, zipcode, store_id=None):
    """Mantém registros precificados para a loja solicitada. Encaminha o resto por motivo."""
    valid, rejected, seen = [], [], set()
    for rec in records:
        url = rec["input"]["url"]
        if rec.get("error_code"):
            rejected.append((url, rec["error_code"]))
            continue
        where = rec.get("store_location") or ""
        if store_id:  # store_location então mostra o próprio CEP da loja
            matched = bool(where) and str(rec.get("store_id")) == str(store_id)
        else:  # store_location deve mostrar o CEP solicitado
            matched = where.endswith(", " + zipcode)
        if not matched:
            rejected.append((url, f"precificado para {where or 'sem loja'}"))
            continue
        try:
            price = float(rec["final_price"])
        except (KeyError, TypeError, ValueError):
            rejected.append((url, "sem preço, verificar disponibilidade"))
            continue
        key = (rec["product_id"], rec["store_id"])
        if key not in seen:
            seen.add(key)
            valid.append(rec | {"final_price": price})
    return valid, rejected


if __name__ == "__main__":
    category = ("https://www.walmart.com/browse/health/protein-powder/"
                "976760_1166769_7458180")
    edges = [0, 15, 25, 35, 42, 50, 62, 75, 100, 100000]
    urls = discover(category, edges, per_range=5)
    print(len(urls), "URLs de produtos descobertas")
    records = wait_and_download(collect(urls, zipcode="72712"))
    valid, rejected = validate(records, "72712")
    print(len(valid), "registros válidos,", len(rejected), "rejeitados")
Uma execução com 5 produtos por faixa e o CEP de Bentonville, 72712, imprimiu as contagens abaixo. Enquanto os jobs de descoberta e coleta rodam, o script consulta por seus resultados. Suas contagens serão diferentes, porque dependem das listagens do Walmart no dia em que você executa o pipeline:
42 URLs de produtos descobertas
41 registros válidos, 1 rejeitado
Todos os 41 registros válidos foram precificados para a loja 100 em Bentonville. O Walmart listou o produto restante sem preço. A lista rejected registra por que cada registro foi rejeitado.
Com apenas um CEP, store_location mostrava o CEP solicitado, então validate confirma cada registro contra esse CEP. Para uma loja específica, envie seu store_id com um CEP onde essa loja está disponível, como o próprio CEP da loja. O registro então mostrava o próprio CEP da loja, então passe o mesmo store_id para validate, que compara IDs de loja. A API verificou o pareamento, então a loja 3520 em Secaucus, enviada com o 72712 de Bentonville, produziu um registro de erro que nomeou a incompatibilidade.
Em escala de catálogo, um único job com o CEP 72712 executou todas as 2.069 URLs descobertas, e validate verificou a localização reportada de cada registro.
Execute o pipeline em volume
Em volume, 4 práticas tornam o pipeline mais previsível.
Agrupe URLs em jobs. Os jobs rodam de forma assíncrona, então deixe wait_and_download consultar o resultado. Use o trigger assíncrono para cada job. Quando um job precisa de mais tempo, o endpoint síncrono retorna um ID de snapshot para consultar, então iniciar de forma assíncrona mantém um único caminho de código.
Conte inputs únicos. A API removeu duplicatas de inputs repetidos, então um job de 34 inputs com 2 repetições retornou 32 registros. A mesma URL enviada com 3 CEPs contou como 3 inputs, e cada um foi precificado para sua própria loja.
Verifique registros de erro antes de tentar novamente. Os registros de erro nomeavam sua causa, então remova URLs de produtos inativas de sua lista e reenvie o resto.
Entregue ao seu armazenamento. Chame collect(urls, zipcode, webhook=URL), e coloque o valor completo do cabeçalho, como Bearer <secret>, em WEBHOOK_AUTH_HEADER. A Bright Data faz POST dos registros finalizados para a URL do webhook com esse valor como o cabeçalho Authorization. O guia de entrega cobre a confirmação que seu endpoint envia, os IPs de origem para permitir, e destinos como Amazon S3, Google Cloud Storage e Snowflake.
Mantenha a validação de loja em seu pipeline, para que cada registro em seu warehouse tenha uma localização verificada.
Considerações finais
Fazer scraping do Walmart em escala é um problema de localização de loja tanto quanto um problema de acesso. Cada preço pertence à loja para a qual foi precificado, e um status de sucesso não diz qual loja foi essa. Defina um CEP ou ID de loja em cada requisição de coleta, e divida a descoberta em faixas de preço que fiquem cada uma abaixo do limite de paginação.
Quando você precisa de um preenchimento retroativo em vez de preços diários por loja, comece com um conjunto de dados do Walmart. Caso contrário, execute algumas faixas de preço e CEPs através da Walmart Scraper API no nível gratuito, depois escale assim que a validação de loja for aprovada.
Perguntas frequentes
Como fazer scraping de preços do Walmart por CEP?
Envie um CEP com cada URL de produto em vez de depender do IP de saída, que o Walmart usa para escolher uma loja. Um CEP pode resolver para uma loja em outro estado, então adicione um ID de loja quando precisar de uma loja específica. A Walmart Scraper API da Bright Data aceita ambos e reporta a loja para cada registro.
O Walmart tem uma API pública?
Quando verifiquei, as APIs do Walmart eram para parceiros. A Affiliate Marketing API retornava preço e disponibilidade por CEP para aplicativos que ganham comissões de referência. Consultas de loja precisavam de aprovação extra. As Marketplace APIs cobriam apenas os próprios catálogos dos vendedores, então rastreadores de preço por loja coletam páginas de produtos públicas.
É possível fazer scraping de avaliações do Walmart?
Sim. Em uma página de produto de leite, a paginação de avaliações do Walmart mostrava 10 avaliações por página e parava em 10.000 na ordenação padrão. A página 1001 retornava a página 1 novamente, então pare na contagem de páginas que o Walmart reporta. O scraper de avaliações do Walmart da Bright Data coleta avaliações escritas e aceita um input sort_by para a ordem das avaliações.
Existe um conjunto de dados de produtos do Walmart?
Sim. A Bright Data oferece conjuntos de dados prontos do Walmart para produtos, avaliações e vendedores em um cronograma de atualização que você escolhe. Eles se encaixam em preenchimentos retroativos e análise em todo o catálogo. Para preços diários por loja, colete registros atuais para um CEP ou ID de loja com a Walmart Scraper API.