Proxies são endereços IP de um servidor que se conectam à internet em seu nome. Em vez de transmitir diretamente suas solicitações para sites, os proxies as encaminham através de um servidor, ocultando seu endereço IP e localização originais. Isso protege sua privacidade, evita rastreamento e impede bloqueios. Os proxies também criptografam seus dados para segurança adicional.
Neste artigo, você aprenderá sobre o uso de proxies com Python requests, particularmente para scraping de dados. O scraping de dados envolve extrair dados de sites, mas muitos sites têm restrições. Os proxies ajudam a contornar isso alterando seu IP e localização, dificultando que os sites detectem e bloqueiem você. Você também pode usar múltiplos proxies para distribuir solicitações e acelerar o processo.
A seguir, você aprenderá como implementar um proxy em seu projeto usando o pacote Python Requests.
Como Usar um Proxy com uma Solicitação Python
Para usar um proxy com uma solicitação Python, você precisa estabelecer um novo projeto Python em seu computador para escrever e executar os scripts Python para scraping de dados. Crie um diretório (ex. web_scrape_project) onde você armazenará seus arquivos de código-fonte.
Todos os códigos deste tutorial estão disponíveis neste repositório do GitHub.
Instalar Pacotes
Depois de criar seu diretório, você precisa instalar os seguintes pacotes Python para enviar solicitações à página web e coletar os links:
- Página web da Bright Data
Componentes do Endereço IP do Proxy
Antes de usar um proxy, é melhor entender seus componentes. A seguir estão os três componentes principais de um servidor proxy:
- Protocolo mostra o tipo de conteúdo que você pode acessar na internet. Os protocolos mais comuns são HTTP e HTTPS.
- Endereço mostra onde o servidor proxy está localizado. O endereço pode ser um IP (ex.
192.167.0.1) ou um nome de host DNS (ex.proxyprovider.com). - Porta usada para direcionar o tráfego ao processo de servidor correto quando vários serviços são executados em uma única máquina (ex. número de porta
2000).
Usando todos esses três componentes, um endereço IP de proxy ficaria assim: 192.167.0.1:2000 ou proxyprovider.com:2000.
Como Configurar Proxies Diretamente nas Requisições
Existem várias maneiras de configurar proxies em requisições Python, e neste artigo, você verá três cenários diferentes. Neste primeiro exemplo, você aprenderá como configurar proxies diretamente no módulo requests.
Para começar, você precisa importar os pacotes Requests e Beautiful Soup em seu arquivo Python para scraping de dados. Em seguida, crie um diretório chamado proxies que contém informações do servidor proxy para ocultar seu endereço IP ao fazer scraping da página web. Aqui, você precisa definir as conexões HTTP e HTTPS para a URL do proxy.
Você também precisa definir a variável Python para configurar a URL da página web da qual deseja extrair os dados. Para este tutorial, a URL é https://brightdata.com/
Em seguida, você precisa enviar uma solicitação GET para a página web usando o método request.get(). O método recebe dois argumentos: a URL do site e os proxies. Depois, a resposta da página web é armazenada na variável response.
Para coletar os links, use o pacote Beautiful Soup para fazer parsing do conteúdo HTML da página web passando response.content e html.parser como argumentos para o método BeautifulSoup().
Em seguida, use o método find_all() com a como argumento para encontrar todos os links na página web. Por fim, extraia o atributo href de cada link usando o método get().
A seguir está o código-fonte completo para configurar proxies diretamente nas requisições:
# import packages.
import requests
from bs4 import BeautifulSoup

# Define proxies to use.
proxies = {
    'http': 'http://proxyprovider.com:2000',
    'https': 'http://proxyprovider.com:2000',
}

# Define a link to the web page.
url = "https://brightdata.com/"

# Send a GET request to the website.
response = requests.get(url, proxies=proxies)

# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website.
links = soup.find_all("a")

# Print all the links.
for link in links:
    print(link.get("href"))
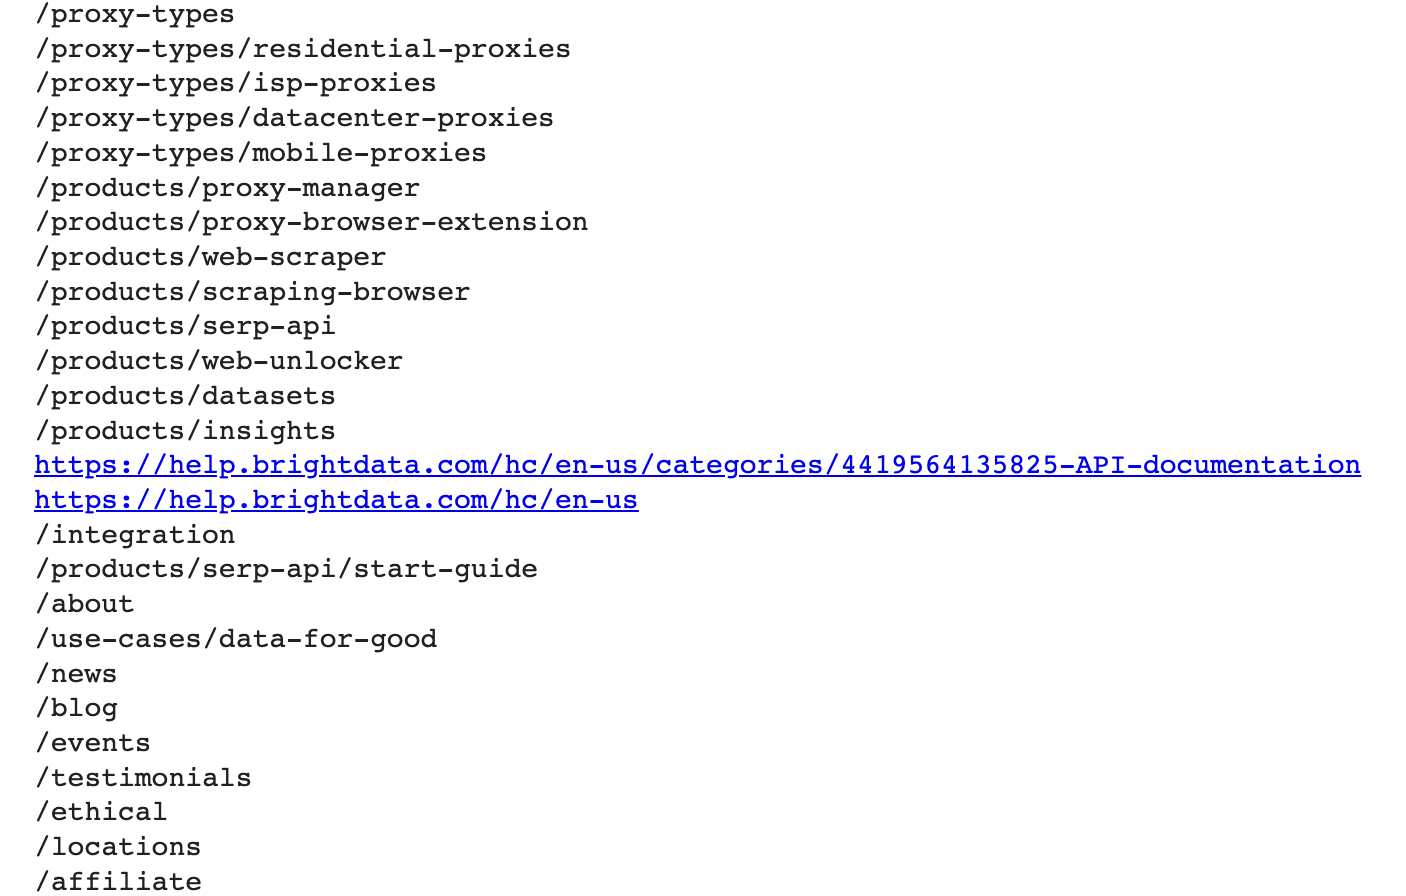
Quando você executa esse bloco de código, ele envia uma solicitação à página web definida usando o endereço IP do proxy e, em seguida, retorna a resposta que contém todos os links dessa página web:
Como Configurar Proxies via Variáveis de Ambiente
Às vezes, você precisa usar o mesmo proxy para todas as suas solicitações para diferentes páginas web. Nesse caso, faz sentido configurar variáveis de ambiente para seu proxy.
Para tornar as variáveis de ambiente do proxy disponíveis sempre que você executar scripts no shell, execute o seguinte comando em seu terminal:
export HTTP_PROXY='http://proxyprovider.com:2000'
export HTTPS_PROXY='https://proxyprovider.com:2000'
Aqui, a variável HTTP_PROXY configura o servidor proxy para solicitações HTTP, e a variável HTTPS_PROXY configura o servidor proxy para solicitações HTTPS.
Neste ponto, seu código Python tem algumas linhas de código e usa as variáveis de ambiente sempre que você faz uma solicitação à página web:
# import packages.
import requests
from bs4 import BeautifulSoup

# Define a link to the web page.
url = "https://brightdata.com/"

# Send a GET request to the website.
response = requests.get(url)

# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website.
links = soup.find_all("a")

# Print all the links.
for link in links:
    print(link.get("href"))
Como Rotacionar Proxies Usando um Método Personalizado e uma Matriz de Proxies
Rotacionar proxies é crucial porque os sites frequentemente bloqueiam ou restringem o acesso a bots e scrapers quando recebem um grande número de solicitações do mesmo endereço IP. Quando isso acontece, os sites podem suspeitar de atividade maliciosa de scraping e, consequentemente, implementar medidas para bloquear ou limitar o acesso.
Ao rotacionar entre diferentes endereços IP de proxy, você pode evitar ser detectado, parecer múltiplos usuários orgânicos e contornar a maioria das medidas anti-scraping implementadas no site.
Para rotacionar proxies, você precisa importar algumas bibliotecas Python: Requests, Beautiful Soup e Random.
Em seguida, crie uma lista de proxies para usar durante o processo de rotação. Essa lista deve conter as URLs dos servidores proxy neste formato: http://proxyserver.com:port:
# List of proxies
proxies = [
    "http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
    "http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
    "http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
    "http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
    "http://proxyprovider3.com:2090"
]
Em seguida, crie um método personalizado chamado get_proxy(). Esse método seleciona aleatoriamente um proxy da lista de proxies usando o método random.choice() e retorna o proxy selecionado em formato de dicionário (ambas as chaves HTTP e HTTPS). Você usará esse método sempre que enviar uma nova solicitação:
# Custom method to rotate proxies
def get_proxy():
    # Choose a random proxy from the list
    proxy = random.choice(proxies)
    # Return a dictionary with the proxy for both http and https protocols
    return {'http': proxy, 'https': proxy}
Depois de criar o método get_proxy(), você precisa criar um loop que envia um certo número de solicitações GET usando os proxies rotacionados. Em cada solicitação, o método get() usa um proxy escolhido aleatoriamente especificado pelo método get_proxy().
Em seguida, você precisa coletar os links do conteúdo HTML da página web usando o pacote Beautiful Soup, conforme explicado no primeiro exemplo.
Por fim, o código Python captura quaisquer exceções que ocorram durante o processo de solicitação e imprime a mensagem de erro no console.
Aqui está o código-fonte completo para este exemplo:
# import packages
import requests
from bs4 import BeautifulSoup
import random

# List of proxies
proxies = [
    "http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
    "http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
    "http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
    "http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
    "http://proxyprovider3.com:2090"
]


# Custom method to rotate proxies
def get_proxy():
    # Choose a random proxy from the list
    proxy = random.choice(proxies)
    # Return a dictionary with the proxy for both http and https protocols
    return {'http': proxy, 'https': proxy}


# Send requests using rotated proxies
for i in range(10):
    # Set the URL to scrape
    url = 'https://brightdata.com/'
    try:
        # Send a GET request with a randomly chosen proxy
        response = requests.get(url, proxies=get_proxy())

        # Use BeautifulSoup to parse the HTML content of the website.
        soup = BeautifulSoup(response.content, "html.parser")

        # Find all the links on the website.
        links = soup.find_all("a")

        # Print all the links.
        for link in links:
            print(link.get("href"))
    except requests.exceptions.RequestException as e:
        # Handle any exceptions that may occur during the request
        print(e)
Usando o Serviço de Proxy da Bright Data com Python
Se você está procurando um proxy confiável, rápido e estável para suas tarefas de scraping de dados, não procure mais do que a Bright Data, uma infraestrutura de dados web que oferece diferentes tipos de proxies para uma ampla gama de casos de uso.
A Bright Data possui uma grande rede com mais de 400M+ monthly IPs de proxy residencial e mais de 770.000 proxies de datacenter que os ajudam a fornecer soluções de proxy confiáveis e rápidas. Suas ofertas de proxy são projetadas para ajudá-lo a superar os desafios de scraping de dados, verificação de anúncios e outras atividades online que exigem coleta de dados web anônima e eficiente.
Integrar os proxies da Bright Data em suas requisições Python é fácil. Por exemplo, use os proxies de datacenter para enviar uma solicitação para a URL usada nos exemplos anteriores.
Se você ainda não tem uma conta, cadastre-se na Bright Data e adicione seus dados para registrar sua conta.
Depois de concluído, siga estas etapas para criar seu primeiro proxy:
Clique em Ver produto de proxy na página de boas-vindas para ver os diferentes tipos de proxy oferecidos pela Bright Data:

Selecione Proxies de Datacenter para criar um novo proxy e, na página seguinte, adicione seus dados e salve:

Depois que seu proxy for criado, você pode visualizar os parâmetros importantes (ex. host, porta, nome de usuário e senha) para começar a acessá-lo e usá-lo:
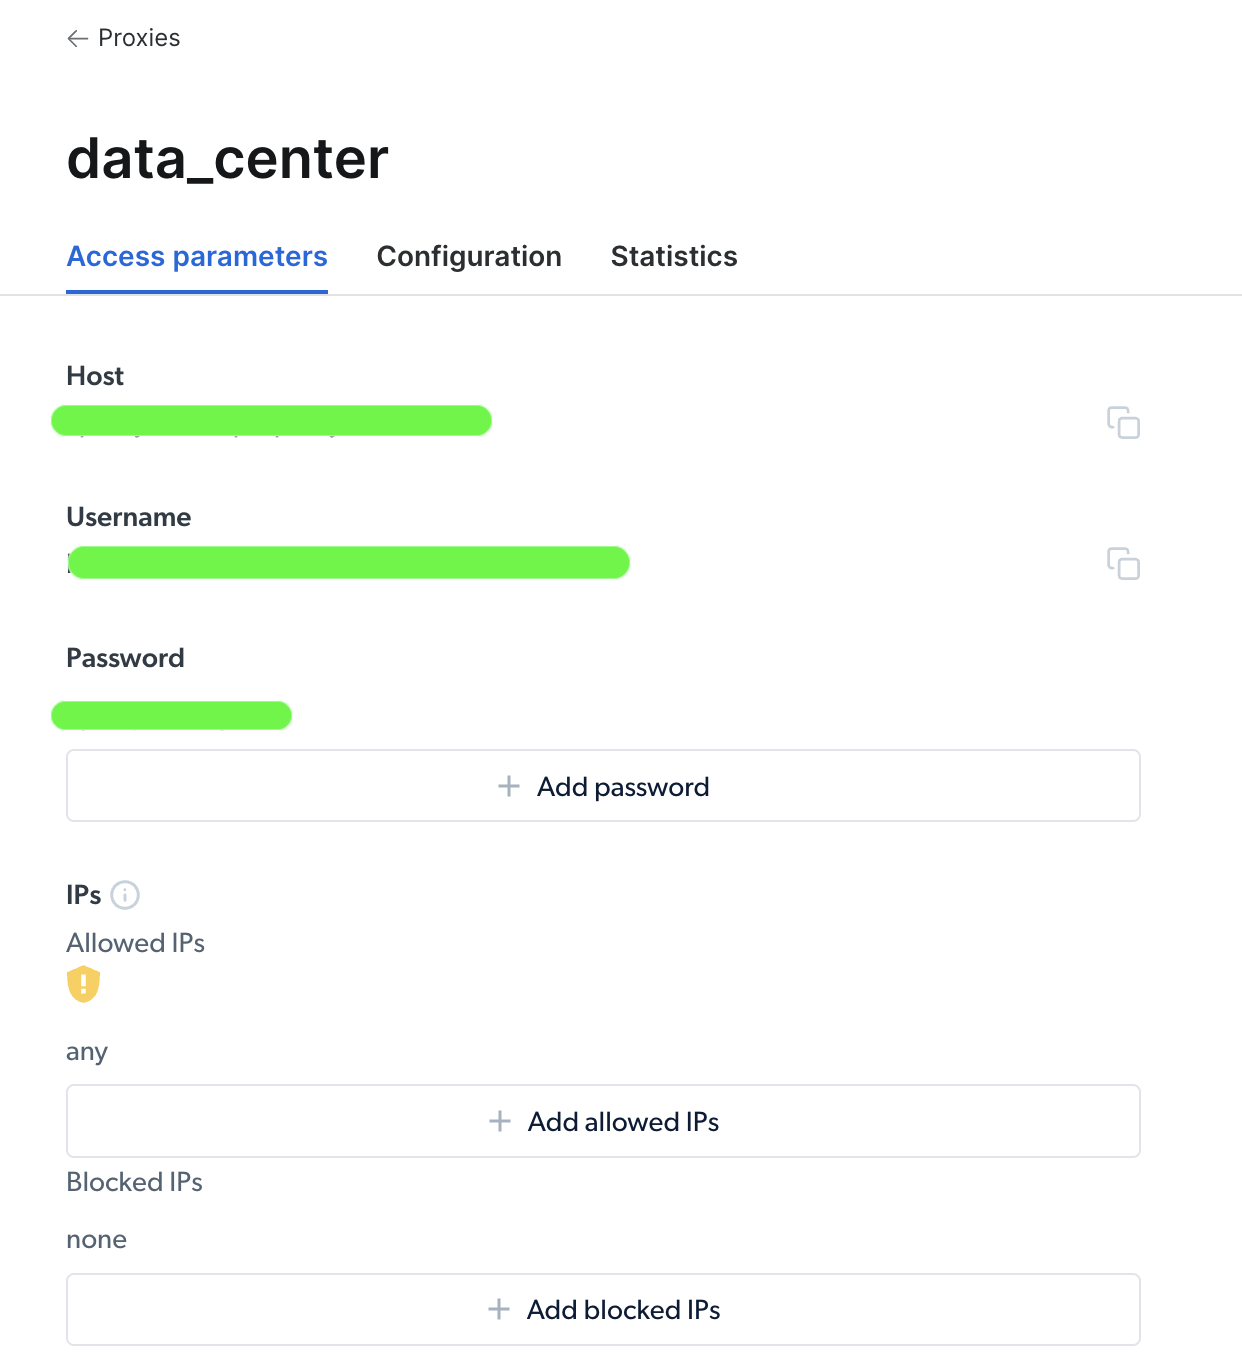
Depois de acessar seu proxy, você pode usar as informações de parâmetros para configurar a URL do seu proxy e enviar uma solicitação usando o pacote Python Requests. O formato da URL do proxy é username-(session-id)-password@host:port.
Observação: O
session-idé um número aleatório criado usando um pacote Python chamadorandom.
A seguir está como seu exemplo de código ficaria para configurar seu proxy da Bright Data em uma solicitação Python:
import requests
from bs4 import BeautifulSoup
import random

# Define parameters provided by Brightdata
host = 'brd.superproxy.io'
port = 33335
username = 'username'
password = 'password'
session_id = random.random()

# format your proxy
proxy_url = ('http://{}-session-{}:{}@{}:{}'.format(username, session_id,
                                                     password, host, port))

# define your proxies in dictionary
proxies = {'http': proxy_url, 'https': proxy_url}

# Send a GET request to the website
url = "https://brightdata.com/"
response = requests.get(url, proxies=proxies)

# Use BeautifulSoup to parse the HTML content of the website
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website
links = soup.find_all("a")

# Print all the links
for link in links:
    print(link.get("href"))
Aqui, você importa os pacotes e define as variáveis de host, porta, nome de usuário, senha e session_id do proxy. Em seguida, crie um dicionário proxies com as chaves http e https e as credenciais do proxy. Por fim, passe o parâmetro proxies para a função requests.get() para fazer a solicitação HTTP e coletar os links da URL.
E é isso! Você acabou de fazer uma solicitação bem-sucedida usando o serviço de proxy da Bright Data.
Conclusão
Neste artigo, você aprendeu por que precisa de proxies, bem como as diferentes formas de usá-los para enviar uma solicitação a uma página web usando o pacote Python Requests.
Com a infraestrutura web da Bright Data, você pode obter proxies confiáveis para seu projeto que cobrem qualquer país ou cidade do mundo. Eles oferecem várias maneiras de obter os dados que você precisa por meio de vários tipos de proxies e ferramentas de scraping de dados para atender às suas necessidades específicas.
Seja para coletar dados de pesquisa de mercado, monitorar avaliações online ou rastrear preços de concorrentes, a Bright Data tem os recursos necessários para realizar o trabalho de forma rápida e eficiente.