


Treinar um modelo de IA envolve ensiná-lo a reconhecer padrões em dados para tomada de decisões. O ajuste fino é uma estratégia que adapta modelos treinados em grandes conjuntos de dados como o GPT-4 da OpenAI, a conjuntos de dados menores e específicos para tarefas, continuando o processo de treinamento.
Nas seções a seguir, vamos nos aprofundar no processo de treinamento de um modelo de IA personalizado usando o ajuste fino da OpenAI, guiando você por cada etapa do processo de ajuste fino.
Entendendo IA e Treinamento de Modelos
A Inteligência Artificial (IA) envolve o desenvolvimento de sistemas capazes de realizar tarefas que normalmente exigem inteligência humana, como aprendizado, resolução de problemas e tomada de decisões. Um modelo de IA, em sua essência, é um conjunto de algoritmos que fazem previsões com base em dados de entrada. O aprendizado de máquina (ML), um subconjunto da IA, permite que as máquinas aprendam com dados e melhorem o desempenho de forma autônoma.
Os modelos de IA aprendem como uma criança que distingue gatos de cachorros, observando características, fazendo suposições, corrigindo erros e tentando novamente. Esse processo, conhecido como treinamento de modelo, envolve o processamento de dados de entrada, análise de padrões e uso desse conhecimento para fazer previsões. O desempenho do modelo é avaliado comparando sua saída com o resultado esperado, e ajustes são feitos para melhorar o desempenho. Com treinamento suficiente, o conjunto de algoritmos dentro do modelo representará um previsor matemático preciso para uma determinada situação que pode lidar com diferentes variações dos dados de entrada.
Treinar um modelo do zero envolve ensinar um modelo a aprender padrões nos dados sem nenhum conhecimento prévio. Isso requer uma grande quantidade de dados e recursos computacionais, e o modelo pode não ter bom desempenho com dados limitados.
O ajuste fino, por outro lado, começa com um modelo pré-treinado que aprendeu padrões gerais de um grande conjunto de dados. O modelo é então treinado em um conjunto de dados menor e específico, permitindo que ele aplique seu conhecimento previamente aprendido à nova tarefa, geralmente levando a um melhor desempenho com menos dados e recursos computacionais. O ajuste fino é particularmente útil quando o conjunto de dados específico da tarefa é relativamente pequeno.
Preparando-se para o Ajuste Fino
Embora o ajuste fino de um modelo existente com treinamento adicional em um conjunto de dados selecionado possa parecer uma opção atraente em relação à construção e treinamento de um modelo de IA do zero, o sucesso do processo de ajuste fino depende de vários fatores-chave.
Escolhendo o modelo certo
Ao selecionar um modelo base para ajuste fino, considere o seguinte:
Alinhamento de Tarefas: É importante definir claramente o escopo do seu problema e a funcionalidade esperada do modelo. Escolha modelos que se destacam em tarefas semelhantes às suas, pois a dissimilaridade entre as tarefas de origem e destino durante o processo de ajuste fino pode levar a um desempenho reduzido. Por exemplo, para tarefas de geração de texto, o GPT-3 pode ser adequado, enquanto para tarefas de classificação de texto, o BERT ou o RoBERTa podem ser melhores.
Tamanho e Complexidade do Modelo: Equilibre desempenho e eficiência conforme necessário, pois embora modelos maiores capturem padrões complexos melhor, eles exigem mais recursos.
Métricas de Avaliação: Escolha métricas de avaliação relevantes para sua tarefa. Por exemplo, a precisão pode ser importante para classificação, enquanto BLEU ou ROUGE podem ser benéficos para tarefas de geração de linguagem.
Comunidade e Recursos: Escolha modelos com uma grande comunidade e amplos recursos para solução de problemas e implementação. Priorize modelos com diretrizes claras de ajuste fino para sua tarefa e busque fontes confiáveis para checkpoints de modelos pré-treinados.
Coleta e preparação de dados
Ao fazer o ajuste fino, a qualidade e a diversidade dos seus dados podem impactar significativamente o desempenho do seu modelo. Aqui estão algumas considerações importantes:
Tipos de Dados Necessários: O tipo de dado depende da sua tarefa específica e dos dados em que o modelo foi pré-treinado. Para tarefas de PLN, você normalmente precisa de dados de texto de fontes como livros, artigos, postagens de mídia social ou transcrições de fala. Use métodos como scraping de dados, pesquisas ou APIs de plataformas de mídia social para coletar dados. Por exemplo, o scraping de dados com IA pode ser particularmente útil quando você precisa de uma grande quantidade de dados diversos e atualizados.
Limpeza e Anotação de Dados: A limpeza de dados envolve a remoção de dados irrelevantes, o tratamento de dados ausentes ou inconsistentes e a normalização. A anotação envolve rotular os dados para que o modelo possa aprender com eles. A utilização de ferramentas automatizadas como a Bright Data pode agilizar esses processos e melhorar a eficiência.
Incorporação de um conjunto de dados diverso e representativo: Durante o ajuste fino do modelo, um conjunto de dados diverso e representativo garante que o modelo aprenda com várias perspectivas, levando a previsões mais generalizadas e confiáveis. Por exemplo, se você estiver fazendo o ajuste fino de um modelo de análise de sentimentos para críticas de filmes, seu conjunto de dados deve incluir críticas de uma ampla variedade de filmes, gêneros e sentimentos, espelhando a distribuição de classes do mundo real.
Configurando o ambiente de treinamento
Certifique-se de ter o hardware e o software necessários para o modelo de IA e o framework escolhidos. Por exemplo, os Modelos de Linguagem de Grande Escala (LLMs) geralmente requerem poder computacional substancial, normalmente fornecido por GPUs.
Frameworks como TensorFlow ou PyTorch são comumente usados para treinamento de modelos de IA. A instalação de bibliotecas e ferramentas relevantes, juntamente com quaisquer dependências adicionais, é essencial para integração perfeita no fluxo de trabalho de treinamento. Por exemplo, ferramentas como a API da OpenAI podem ser necessárias para o ajuste fino de modelos específicos desenvolvidos pela OpenAI.
O Processo de Ajuste Fino
Tendo compreendido os fundamentos do ajuste fino, vamos ver uma aplicação no processamento de linguagem natural.
Usarei a API da OpenAI para fazer o ajuste fino de um modelo pré-treinado. O ajuste fino é atualmente possível para modelos como gpt-3.5-turbo-0125 (recomendado), gpt-3.5-turbo-1106, gpt-3.5-turbo-0613, babbage-002, davinci-002 e o experimental gpt-4-0613. O ajuste fino do GPT-4 está em fase experimental e usuários elegíveis podem solicitar acesso na interface de ajuste fino.
1. Preparação do conjunto de dados
De acordo com um estudo, foi constatado que o GPT-3.5 carece de raciocínio analítico. Então, vamos tentar fazer o ajuste fino do modelo gpt-3.5-turbo para aprimorar seu raciocínio analítico usando um conjunto de dados de questões de raciocínio analítico do Teste de Admissão à Escola de Direito (AR-LSAT), lançado em 2022. O conjunto de dados disponível publicamente pode ser encontrado aqui.
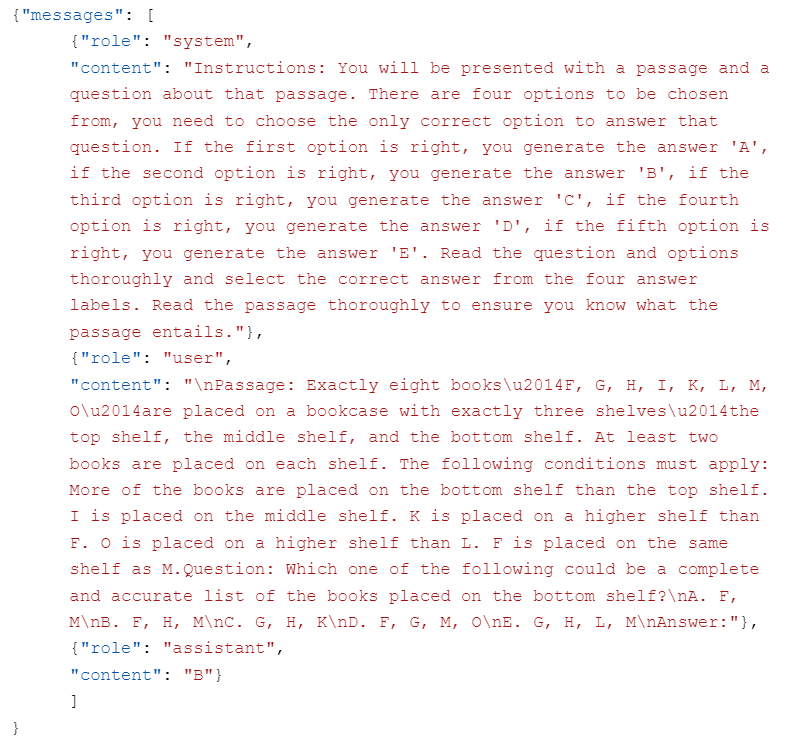
A qualidade de um modelo com ajuste fino depende diretamente dos dados usados para o ajuste fino. Cada exemplo no conjunto de dados deve ser uma conversa formatada de acordo com a API de Completações de Chat da OpenAI, com uma lista de mensagens onde cada mensagem tem uma função, conteúdo e nome opcional, e armazenada como um arquivo JSONL.
O formato de chat conversacional necessário para o ajuste fino do gpt-3.5-turbo é o seguinte:
{"messages": [{"role": "system", "content": ""}, {"role": "user", "content": ""}, {"role": "assistant", "content": ""}]}
Neste formato, "messages" é uma lista de mensagens formando uma conversa entre três "roles": system, user e assistant. O "content" do papel "system" deve especificar o comportamento do sistema com ajuste fino.
Abaixo está um exemplo formatado retirado do conjunto de dados AR-LSAT que usaremos neste guia:
Aqui estão as principais considerações ao criar o conjunto de dados:
- Página de preços da OpenAI
- Notebook de contagem de tokens
- Script Python
2. Gerando a chave de API e instalando a biblioteca OpenAI
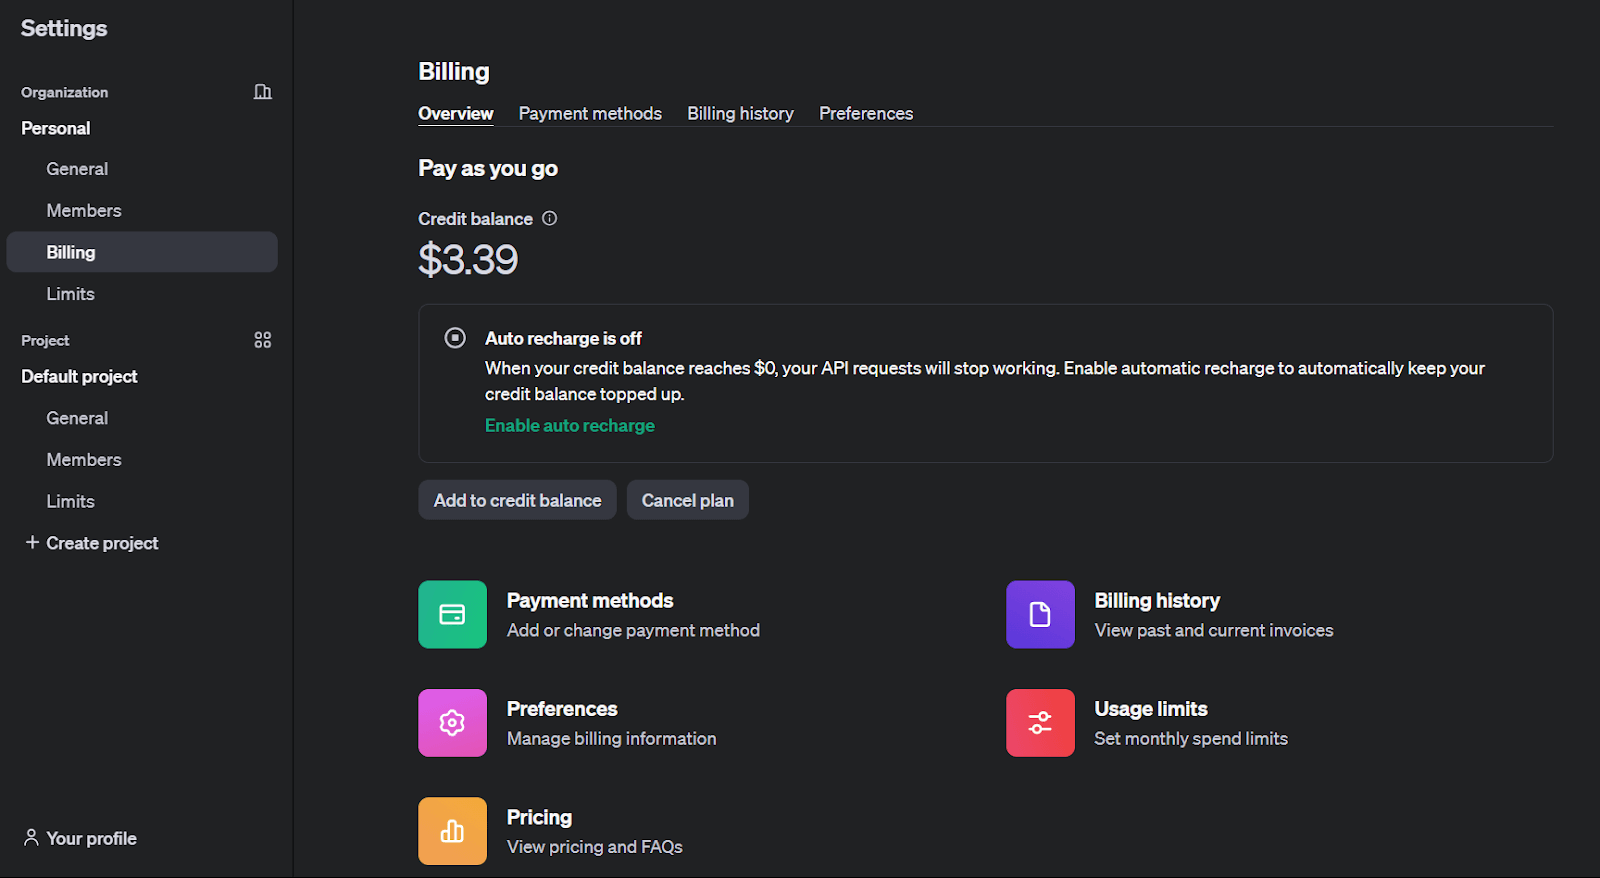
Para fazer o ajuste fino de um modelo OpenAI, ter uma conta de desenvolvedor OpenAI com saldo de crédito suficiente é obrigatório.
Para gerar a chave de API e instalar a biblioteca OpenAI, siga estas etapas:
1. Cadastre-se no site oficial da OpenAI.
2. Para habilitar o ajuste fino, recarregue seu saldo de crédito na aba ‘Faturamento’ em ‘Configurações’.
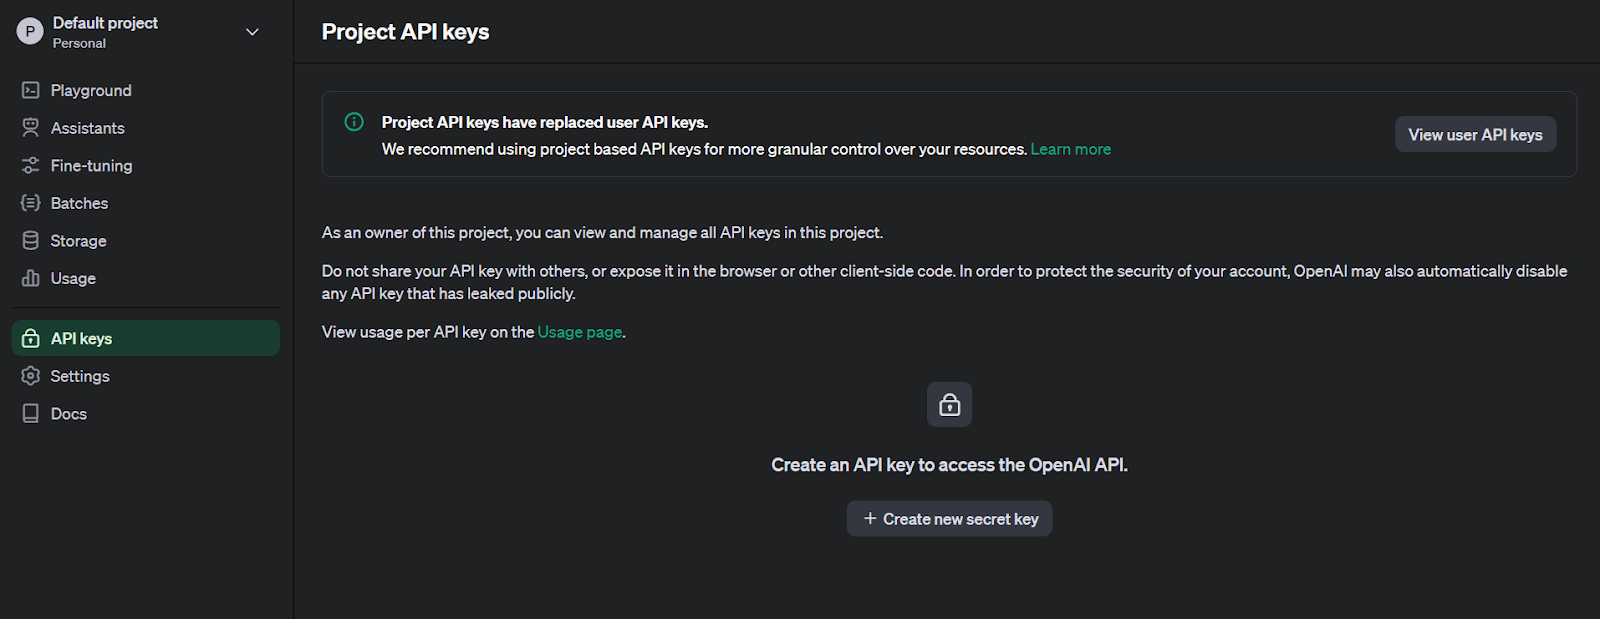
3. Clique no ícone de perfil do usuário no canto superior esquerdo e selecione “Chaves de API” para acessar a página de criação de chaves.
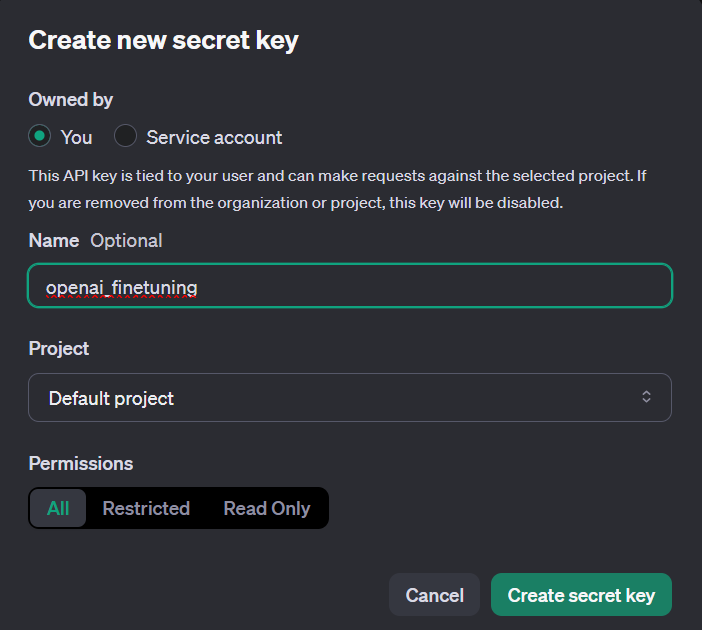
4. Gere uma nova chave secreta fornecendo um nome.
5. Instale a biblioteca Python OpenAI para ajuste fino.
pip install openai
6. Use a biblioteca os para definir o token como uma variável de ambiente e estabelecer comunicação com a API.
import os
from openai import OpenAI

# Set the OPENAI_API_KEY environment variable
os.environ['OPENAI_API_KEY'] = 'The key generated in step 4'
client = OpenAI(api_key=os.environ['OPENAI_API_KEY'])
3. Enviando os arquivos de treinamento e validação
Após validar seus dados, envie os arquivos usando a API de Arquivos para trabalhos de ajuste fino.
training_file_id = client.files.create(
  file=open(training_file_name, "rb"),
  purpose="fine-tune"
)
validation_file_id = client.files.create(
  file=open(validation_file_name, "rb"),
  purpose="fine-tune"
)
print(f"Training File ID: {training_file_id}")
print(f"Validation File ID: {validation_file_id}")
Os identificadores únicos para os dados de treinamento e validação são exibidos após a execução bem-sucedida.

4. Criando um trabalho de ajuste fino
Após enviar os arquivos, crie um trabalho de ajuste fino por meio da interface ou programaticamente.
Veja como iniciar um trabalho de ajuste fino usando o SDK da OpenAI:
response = client.fine_tuning.jobs.create(
  training_file=training_file_id.id,
  validation_file=validation_file_id.id,
  model="gpt-3.5-turbo",
  hyperparameters={
    "n_epochs": 10,
    "batch_size": 3,
    "learning_rate_multiplier": 0.3
  }
)
job_id = response.id
status = response.status

print(f'Fine-tunning model with jobID: {job_id}.')
print(f"Training Response: {response}")
print(f"Training Status: {status}")
model: o nome do modelo para ajuste fino (gpt-3.5-turbo,babbage-002,davinci-002, ou um modelo com ajuste fino existente).training_fileevalidation_file: os IDs de arquivo retornados quando os arquivos foram enviados.n_epochs,batch_sizeelearning_rate_multiplier: Hiperparâmetros que podem ser personalizados.
Para definir parâmetros adicionais de ajuste fino, consulte a especificação da API para ajuste fino.
O código acima gera as seguintes informações para o jobID (`ftjob-0EVPunnseZ6Xnd0oGcnWBZA7`):
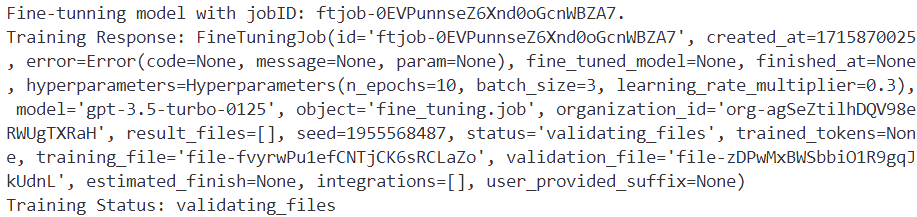
Um trabalho de ajuste fino pode levar tempo para ser concluído. Ele pode estar na fila atrás de outros trabalhos, e a duração do treinamento pode variar de minutos a horas dependendo do modelo e do tamanho do conjunto de dados.
Quando o treinamento for concluído, uma confirmação por e-mail será enviada ao usuário que iniciou o trabalho de ajuste fino.
Você pode monitorar o status do seu trabalho de ajuste fino por meio da interface de ajuste fino:
5. Analisando o modelo com ajuste fino
A OpenAI calcula as seguintes métricas durante o treinamento:
- Perda de treinamento
- Precisão de token de treinamento
- Perda de validação
- Precisão de token de validação
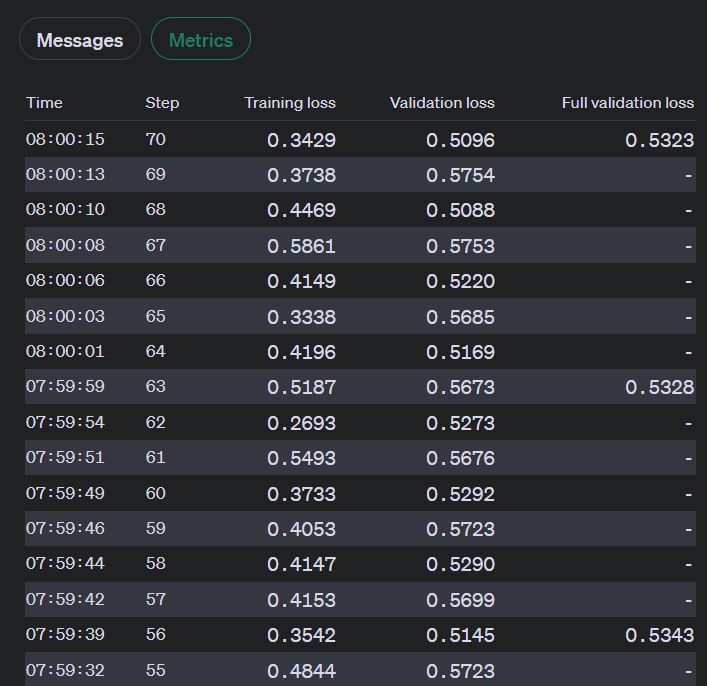
A perda de validação e a precisão de token de validação são calculadas de duas formas: em um pequeno lote de dados a cada etapa e no conjunto de validação completo ao final de cada época. A perda de validação completa e a precisão de token de validação completa são as métricas mais precisas para acompanhar o desempenho do seu modelo e servem como verificação para garantir um treinamento tranquilo (a perda deve diminuir, a precisão do token deve aumentar).
Enquanto um trabalho de ajuste fino está ativo, você pode visualizar essas métricas por meio de
1. A interface:
2. A API:
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ['OPENAI_API_KEY'],)
jobid = 'jobid you want to monitor'

print(f"Streaming events for the fine-tuning job: {jobid}")

# signal.signal(signal.SIGINT, signal_handler)

events = client.fine_tuning.jobs.list_events(fine_tuning_job_id=jobid)
try:
    for event in events:
        print(
            f'{event.data}'
        )
except Exception:
    print("Stream interrupted (client disconnected).")
O código acima produzirá os eventos de streaming para o trabalho de ajuste fino, incluindo o número da etapa, perda de treinamento, perda de validação, total de etapas e precisão média de token para treinamento e validação:
Streaming events for the fine-tuning job: ftjob-0EVPunnseZ6Xnd0oGcnWBZA7
{'step': 67, 'train_loss': 0.30375099182128906, 'valid_loss': 0.49169286092122394, 'total_steps': 67, 'train_mean_token_accuracy': 0.8333333134651184, 'valid_mean_token_accuracy': 0.8888888888888888}
6. Ajustando parâmetros e o conjunto de dados para melhorar o desempenho
Se os resultados de um trabalho de ajuste fino não forem tão bons quanto o esperado, considere as seguintes formas de melhorar o desempenho:
1. Ajustar o conjunto de dados de treinamento:
- Para refinar seu conjunto de dados de treinamento, considere adicionar exemplos que abordem as fraquezas do modelo e garanta que a distribuição de respostas em seus dados corresponda à distribuição esperada.
- Também é importante verificar seus dados em busca de problemas que o modelo está replicando e garantir que seus exemplos contenham todas as informações necessárias para a resposta.
- Mantenha a consistência nos dados criados por várias pessoas e padronize o formato de todos os exemplos de treinamento para corresponder ao que é esperado na inferência.
- Em geral, dados de alta qualidade são mais eficazes do que uma quantidade maior de dados de baixa qualidade.
2. Ajustando os hiperparâmetros:
- A OpenAI permite que você especifique três hiperparâmetros: épocas, multiplicador de taxa de aprendizado e tamanho do lote.
- Comece com valores padrão escolhidos pelas funções integradas com base no tamanho do conjunto de dados, depois ajuste se necessário.
- Se o modelo não seguir os dados de treinamento conforme o esperado, aumente o número de épocas.
- Se o modelo se tornar menos diverso do que o esperado, diminua o número de épocas em 1 ou 2.
- Se o modelo não parecer estar convergindo, aumente o multiplicador de taxa de aprendizado.
7. Usando um modelo com checkpoint
Atualmente, a OpenAI fornece acesso aos checkpoints das últimas três épocas de um trabalho de ajuste fino. Esses checkpoints são modelos completos que podem ser usados para inferência e ajuste fino adicional.
Para acessar esses checkpoints, aguarde a conclusão de um trabalho e, em seguida, consulte o endpoint de checkpoints com o ID do seu trabalho de ajuste fino. Cada objeto de checkpoint terá o campo fine_tuned_model_checkpoint preenchido com o nome do checkpoint do modelo. Você também pode obter o nome do modelo de checkpoint por meio da interface de ajuste fino.
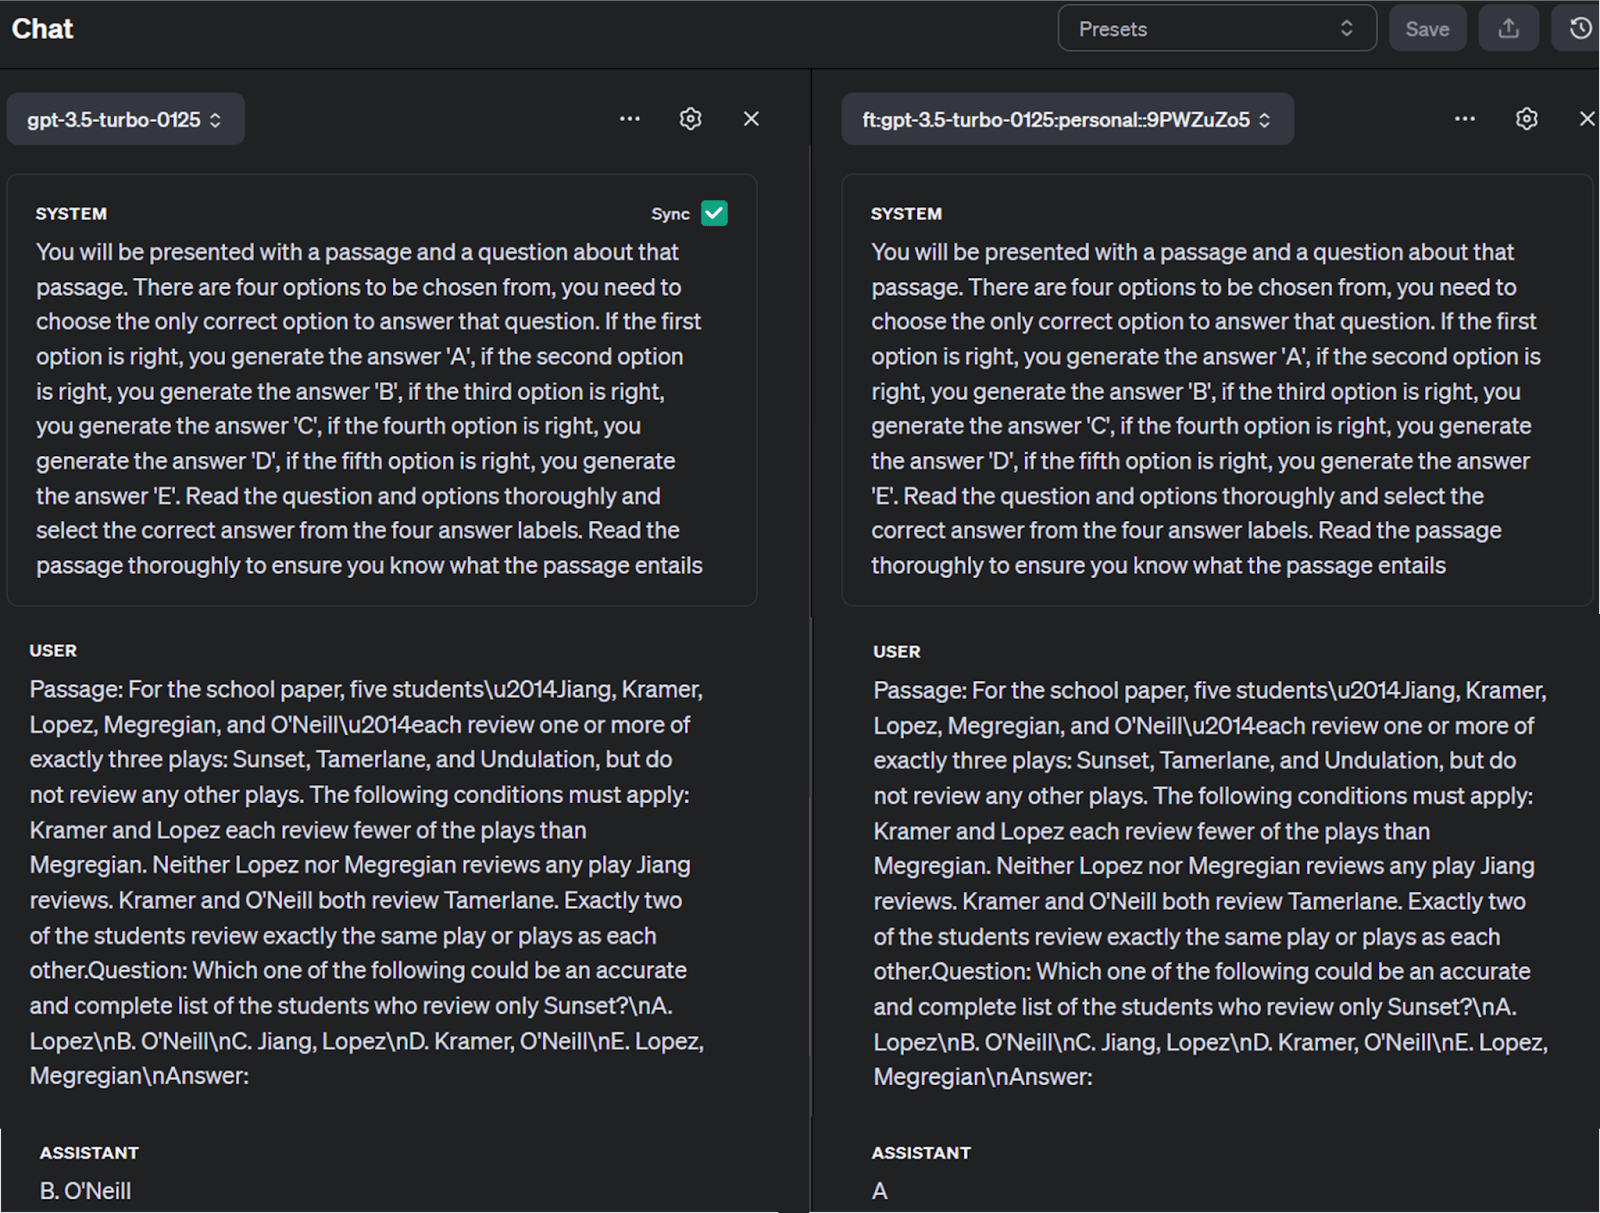
Você pode validar os resultados do modelo de checkpoint executando consultas com um prompt e o nome do modelo usando a função openai.chat.completions.create():
completion = client.chat.completions.create(
  model="ft:gpt-3.5-turbo-0125:personal::9PWZuZo5",
  messages=[
    {"role": "system", "content": "Instructions: You will be presented with a passage and a question about that passage. There are four options to be chosen from, you need to choose the only correct option to answer that question. If the first option is right, you generate the answer 'A', if the second option is right, you generate the answer 'B', if the third option is right, you generate the answer 'C', if the fourth option is right, you generate the answer 'D', if the fifth option is right, you generate the answer 'E'. Read the question and options thoroughly and select the correct answer from the four answer labels. Read the passage thoroughly to ensure you know what the passage entails"},
    {"role": "user", "content": "Passage: For the school paper, five studentsu2014Jiang, Kramer, Lopez, Megregian, and O'Neillu2014each review one or more of exactly three plays: Sunset, Tamerlane, and Undulation, but do not review any other plays. The following conditions must apply: Kramer and Lopez each review fewer of the plays than Megregian. Neither Lopez nor Megregian reviews any play Jiang reviews. Kramer and O'Neill both review Tamerlane. Exactly two of the students review exactly the same play or plays as each other.Question: Which one of the following could be an accurate and complete list of the students who review only Sunset?nA. LopeznB. O'NeillnC. Jiang, LopeznD. Kramer, O'NeillnE. Lopez, MegregiannAnswer:"}
  ]
)
print(completion.choices[0].message)
O resultado recuperado do dicionário de respostas é:

Você também pode comparar o modelo com ajuste fino com outros modelos no playground da OpenAI conforme mostrado abaixo:
Dicas e Melhores Práticas
Para um ajuste fino bem-sucedido, considere estas dicas:
Qualidade dos dados: Certifique-se de que seus dados específicos da tarefa sejam limpos, diversos e representativos para evitar overfitting, onde o modelo tem bom desempenho nos dados de treinamento, mas desempenho ruim em dados não vistos.
Seleção de hiperparâmetros: Escolha hiperparâmetros apropriados para evitar convergência lenta ou desempenho abaixo do ideal. Isso pode ser complexo e demorado, mas é crucial para um treinamento eficaz.
Gerenciamento de recursos: Esteja ciente de que o ajuste fino de modelos grandes requer recursos computacionais e tempo substanciais.
Evitando Armadilhas
Overfitting e underfitting: Equilibre a complexidade do seu modelo e a quantidade de treinamento para evitar overfitting (alta variância) e underfitting (alto viés).
Esquecimento catastrófico: Durante o ajuste fino, o modelo pode esquecer o conhecimento geral aprendido anteriormente. Avalie regularmente o desempenho do seu modelo em uma variedade de tarefas para mitigar isso.
Sensibilidade à mudança de domínio: Se seus dados de ajuste fino diferem significativamente dos dados de pré-treinamento, você pode encontrar problemas de mudança de domínio. Use técnicas de adaptação de domínio para preencher essa lacuna.
Salvando e Reutilizando Modelos
Após o treinamento, salve o estado do seu modelo para reutilizá-lo posteriormente. Isso inclui os parâmetros do modelo e qualquer estado do otimizador que foi usado. Isso permite que você retome o treinamento posteriormente a partir do mesmo estado.
Considerações Éticas
Amplificação de viés: Modelos pré-treinados podem herdar vieses, que podem ser amplificados durante o ajuste fino. Sempre tente optar por modelos pré-treinados testados para viés e imparcialidade se previsões imparciais forem necessárias.
Saídas não intencionais: Modelos com ajuste fino podem gerar saídas plausíveis, mas incorretas. Implemente mecanismos robustos de pós-processamento e validação para lidar com isso.
Deriva do modelo: O desempenho de um modelo pode se deteriorar ao longo do tempo devido a mudanças no ambiente ou na distribuição de dados. Monitore o desempenho do seu modelo regularmente e refaça o ajuste fino conforme necessário.
Técnicas Avançadas e Aprendizado Adicional
Técnicas avançadas no ajuste fino de LLMs incluem Adaptação de Baixo Ranking (LoRA) e LoRA Quantizado (QLoRA), que reduzem os custos computacionais e financeiros mantendo o desempenho. O Ajuste Fino Eficiente em Parâmetros (PEFT) adapta modelos de forma eficiente com parâmetros treináveis mínimos. DeepSpeed e ZeRO otimizam o uso de memória para treinamento em grande escala. Essas técnicas abordam desafios como overfitting, esquecimento catastrófico e sensibilidade à mudança de domínio, aumentando a eficiência e eficácia do ajuste fino de LLMs.
Além do ajuste fino, existem outras técnicas avançadas de treinamento, como aprendizado por transferência e aprendizado por reforço. O aprendizado por transferência envolve aplicar o conhecimento aprendido de um problema a outro problema relacionado, enquanto o aprendizado por reforço é um tipo de aprendizado de máquina onde um agente aprende a tomar decisões executando ações em um ambiente para maximizar uma recompensa.
Para aqueles interessados em se aprofundar no treinamento de modelos de IA, os recursos abaixo podem ser úteis:
- Attention is all you need por Ashish Vaswani et al.
- O livro “Deep Learning” por Ian Goodfellow, Yoshua Bengio e Aaron Courville
- O livro “Speech and Language Processing” por Daniel Jurafsky e James H. Martin
- Diferentes formas de treinar LLMs
- Dominando Técnicas de LLM: Treinamento
- Curso de PLN do Hugging Face
Conclusão
Treinar um modelo de IA é um processo que requer uma quantidade significativa de dados de alta qualidade. Embora definir o problema, selecionar um modelo e refiná-lo por meio de iterações sejam essenciais, o verdadeiro diferencial é a qualidade e o volume de dados usados. Em vez de criar e manter scrapers de dados, você pode simplificar a coleta de dados usando conjuntos de dados pré-criados ou personalizados disponíveis na infraestrutura da Bright Data.
Com o Marketplace de Conjuntos de Dados, você pode acessar conjuntos de dados validados e prontos para uso de sites populares, ou pode gerar conjuntos de dados personalizados para atender às suas necessidades específicas usando a infraestrutura automatizada. Dessa forma, você pode se concentrar no treinamento eficiente dos seus modelos com dados precisos e em conformidade, permitindo resultados mais rápidos e confiáveis em vários setores.
Explore as soluções de conjuntos de dados da Bright Data e integre-as facilmente ao seu fluxo de trabalho para coleta de dados sem interrupções.
Cadastre-se agora e inicie seu período de teste grátis da infraestrutura de scraping de dados da Bright Data, incluindo amostras gratuitas de conjuntos de dados.





