---
title: "Como usar Proxies com o CloudScraper"
slug: cloudscraper-with-proxies
date: 2026-02-17T09:11:19+00:00
modified: 2026-04-20T11:20:09+00:00
permalink: https://brightdata.com.br/blog/proxies-101/cloudscraper-with-proxies
type: blog
---
[ Blog ](https://brightdata.com.br/blog "Blog") / [Proxy 101](https://brightdata.com.br/blog/proxies-101)
[Proxy 101](https://brightdata.com.br/blog/proxies-101)
# Como usar Proxies com o CloudScraper
Domine a integração do Proxy CloudScraper com este guia: configure, alterne IPs e use proxies autenticados para uma extração perfeita.
9 min de leitura
[  ](https://brightdata.com/blog/authors/antonello-zanini)
[Antonello Zanini
Technical Writer
](https://brightdata.com/blog/authors/antonello-zanini)
Neste guia, você aprenderá:
- O que é o CloudScraper e para que serve
- Por que você deve integrar Proxies no Cloudscraper
- Como fazer isso em um guia passo a passo
- Como implementar a rotação de Proxy no Cloudscraper
- Como lidar com proxies autenticados
- Como usar um provedor de Proxy premium como o Bright Data
Vamos começar!
## O que é o CloudScraper?
[O CloudScraper](https://github.com/VeNoMouS/cloudscraper) é um módulo Python projetado para contornar a página anti-bot do Cloudflare (comumente conhecida como[“I’m Under Attack Mode”](https://developers.cloudflare.com/fundamentals/reference/under-attack-mode/) ou IUAM). Nos bastidores, ele é implementado usando o Requests, um dos clientes HTTP Python mais populares.
Essa biblioteca é particularmente útil para [raspar ou rastrear sites protegidos pelo Cloudflare](/blog/web-data/bypass-cloudflare-for-web-scraping). Atualmente, a página anti-bot verifica se o cliente suporta JavaScript, mas o Cloudflare pode introduzir técnicas adicionais no futuro.
Como a Cloudflare atualiza periodicamente suas soluções anti-bot, a biblioteca é atualizada periodicamente para permanecer funcional.
## Por que usar Proxies com o CloudScraper?
O Cloudflare pode bloquear seu IP se você fizer muitas solicitações. Da mesma forma, isso pode acionar defesas mais sofisticadas que são difíceis de contornar, mesmo com ferramentas como o CloudScraper. Para mitigar isso, você precisa de um método confiável para [alternar seu endereço IP](/blog/how-tos/how-to-rotate-an-ip-address).
É aí que entra um [Proxy](/blog/proxy-101/what-is-proxy-server). Os Proxies atuam como intermediários entre o seu Scraper e o site de destino, mascarando o seu endereço IP real com o IP do Proxy. Se um IP for bloqueado, você pode mudar rapidamente para um novo Proxy, garantindo acesso ininterrupto.
Os proxies oferecem dois benefícios principais para o Scraping de dados da web com o CloudScraper:
1. **Maior segurança e anonimato**: ao encaminhar as solicitações por meio de um Proxy, sua identidade verdadeira permanece oculta, reduzindo o risco de detecção.
2. **Evitar bloqueios e interrupções**: os Proxy permitem que você alterne endereços IP dinamicamente, o que ajuda a contornar bloqueios e limitadores de taxa.
Ao combinar Proxies com ferramentas como o CloudScraper, você pode criar uma configuração robusta de Scraping de dados que minimiza os riscos e maximiza a eficiência. Essa abordagem em duas camadas garante a extração segura e contínua de dados, mesmo de sites com [medidas](/blog/web-data/anti-scraping-techniques) avançadas [anti-scraping](/blog/web-data/anti-scraping-techniques).
## Configurar um Proxy com o CloudScraper: guia passo a passo
Aprenda a usar Proxy com o CloudScraper nesta seção guiada!
### Etapa 1: instale o CloudScraper
Você pode instalar o CloudScraper através do pacote pip [`cloudscraper`](https://pypi.org/project/cloudscraper/) usando este comando:
```none
pip install -U cloudscraper
```
Lembre-se de que o Cloudflare atualiza constantemente seu mecanismo anti-bot. Portanto, inclua a opção [`-U`](https://pip.pypa.io/en/stable/cli/pip_install/#cmdoption-U) ao instalar o pacote para garantir que você esteja obtendo a versão mais recente.
### Passo 2: Inicialize o Cloudscraper
Para começar, primeiro importe o CloudScraper:
```none
import cloudscraper
```
Em seguida, crie uma instância do CloudScraper usando o método [`create_scraper()`](https://github.com/VeNoMouS/cloudscraper?tab=readme-ov-file#usage):
```none
Scraper = cloudscraper.create_scraper()
```
O objeto `Scraper` funciona de maneira semelhante ao objeto [`Session`](https://requests.readthedocs.io/en/latest/user/advanced/#session-objects) da biblioteca `requests`. Em particular, ele permite que você faça solicitações HTTP contornando as medidas antibot do Cloudflare.
### Etapa 3: integrar um Proxy
Como o CloudScraper é construído sobre o Requests, a integração de proxies funciona da mesma forma que`no Requests`. Se você não estiver familiarizado com esse procedimento, leia nosso tutorial para [configurar um Proxy no Requests](/blog/proxy-101/proxy-with-python-requests).
Para usar um Proxy com o CloudScraper, você precisa definir um dicionário `de Proxies` e passá-lo para o método `get()` conforme abaixo:
```none
proxies = {
"http": "",
"https": ""
}
# Realize uma solicitação através do Proxy especificado
response = scraper.get("", proxies=proxies)
```
O parâmetro `Proxy` no método `get()` é passado para Requests. Isso permite que o cliente HTTP encaminhe sua solicitação através do servidor Proxy HTTP ou HTTPS especificado, dependendo do protocolo do seu URL de destino.
### Etapa 4: Teste a configuração da integração do Proxy CloudScraper
Para fins de demonstração, vamos direcionar o endpoint [`/ip`](https://httpbin.io/ip) do projeto HTTPBin. Esse endpoint retorna o endereço IP do chamador. Se tudo funcionar conforme o esperado, a resposta deverá exibir o endereço IP do Proxy.
Para testar a configuração, você pode obter um IP de Proxy em uma [lista de Proxies gratuitos](/solutions/free-proxies).
**Aviso**: proxies gratuitos costumam ser pouco confiáveis, coletam dados e são potencialmente inseguros, especialmente se não forem fornecidos por um dos [melhores provedores de Proxy do mercado](/blog/proxy-101/best-proxy-providers). Tente usá-los apenas para fins educacionais.
Suponha que esta seja a URL do seu servidor Proxy:
```none
http://202.159.35.121:443
```
Veja como você pode integrá-lo ao CloudScraper:
```none
import cloudscraper
# Crie uma instância do CloudScraper
scraper = cloudscraper.create_scraper()
# Especifique seu Proxy
proxies = {
"http": "http://202.159.35.121:443",
"https": "http://202.159.35.121:443"
}
# Faça uma solicitação através do Proxy
response = Scraper.get("https://httpbin.io/ip", proxies=proxies)
# Imprima a resposta do endpoint "/ip"
print(response.text)
```
Se configurado corretamente, você deverá ver uma resposta como esta:
```none
{
"origin": "202.159.35.121:1819"
}
```
Observe como o IP na resposta corresponde ao IP do Proxy, como esperado.
**Observação:** servidores Proxy gratuitos geralmente têm vida útil curta. Como resultado, o Proxy usado no exemplo abaixo pode não funcionar mais quando você ler este artigo.
Parabéns! Você concluiu uma integração simples do Proxy CloudScraper.
## Como implementar a rotação de Proxy
Usar um Proxy com o Cloudscraper ajuda a ocultar seu endereço IP. No entanto, os sites de destino ainda podem bloquear IPs. Isso ocorre se muitas solicitações vierem do mesmo endereço, seja ele o seu próprio IP ou o do Proxy.
Para [evitar bloqueios de IP](/blog/proxy-101/how-to-bypass-an-ip-ban), é essencial alternar seus IPs Proxy regularmente. Ao distribuir suas solicitações por vários endereços IP, você pode fazer com que seu tráfego pareça vir de diferentes usuários. Isso reduz a probabilidade de detecção.
Para implementar a rotação de proxy, comece recuperando uma lista de proxies de um provedor confiável. Armazene-os em uma matriz:
```none
proxy_list = [
{"http": "", "https": ""},
# ...
{"http": "", "https": ""},
]
```
Em seguida, use o método [`random.choice()`](https://docs.python.org/3/library/random.html#random.choice) para selecionar aleatoriamente um Proxy da lista:
```none
random_proxy = random.choice(proxy_list)
```
Não se esqueça de importar `random` da biblioteca padrão do Python:
```none
import random
```
Depois disso, basta definir o Proxy selecionado aleatoriamente na solicitação `get()`:
```none
response = Scraper.get("", proxies=random_proxy)
```
Se tudo estiver configurado corretamente, a solicitação usará um Proxy diferente da lista a cada execução. Aqui está o código completo:
```none
import cloudscraper
import random
# Crie uma instância do Cloudscraper
scraper = cloudscraper.create_scraper()
# Lista de URLs de Proxy (substitua pelas URLs de Proxy reais)
proxy_list = [
{"http": "", "https": ""},
# ...
{"http": "", "https": ""},
]
# Selecione aleatoriamente um Proxy da lista
random_proxy = random.choice(proxy_list)
# Faça uma solicitação usando o Proxy selecionado aleatoriamente
# (substitua pela URL de destino real)
response = Scraper.get("", proxies=random_proxy)
```
Parabéns! Você integrou a rotação de proxies ao Cloudscraper.
## Use Autenticar Proxies no CloudScraper
A maioria dos provedores oferece servidores Proxy autenticados, de modo que apenas usuários pagantes podem acessá-los. Normalmente, você precisa especificar um nome de usuário e uma senha para acessar esses servidores Proxy.
Para autenticar um Proxy no CloudScraper, você deve incluir as credenciais necessárias diretamente na URL do Proxy. O formato para autenticação de nome de usuário e senha é o seguinte:
```none
://:@:
```
Com esse formato, sua configuração de Proxy do CloudScraper ficaria assim:
```none
import cloudscraper
# Crie uma instância do Cloudscraper
scraper = cloudscraper.create_scraper()
# Defina seu Proxy autenticado
proxies = {
"http": "://:@:",
"https": "://:@:"
}
# Realize uma solicitação através do Proxy autenticado especificado
response = Scraper.get("", proxies=proxies)
```
Excelente! Você está pronto para ver como usar proxies premium no Cloudflare.
## Integre proxies premium no Cloudscraper
Para obter resultados confiáveis em ambientes de scraping de produção, você deve usar Proxies de provedores de primeira linha, como [a Bright Data](/). A Bright Data possui uma rede de alta qualidade com mais de 150 milhões de IPs [em 195 países](/locations), com suporte para os quatro principais tipos de Proxies:
- Proxies de data center
- Proxies residenciais
- Proxy móvel
- Proxy ISP
Com recursos como rotação automática de IP, [100% de tempo de atividade](/blog/products-updates/100-percent-uptime) e sessões de IP fixas, a Bright Data se posiciona como o provedor líder de proxies no mercado.
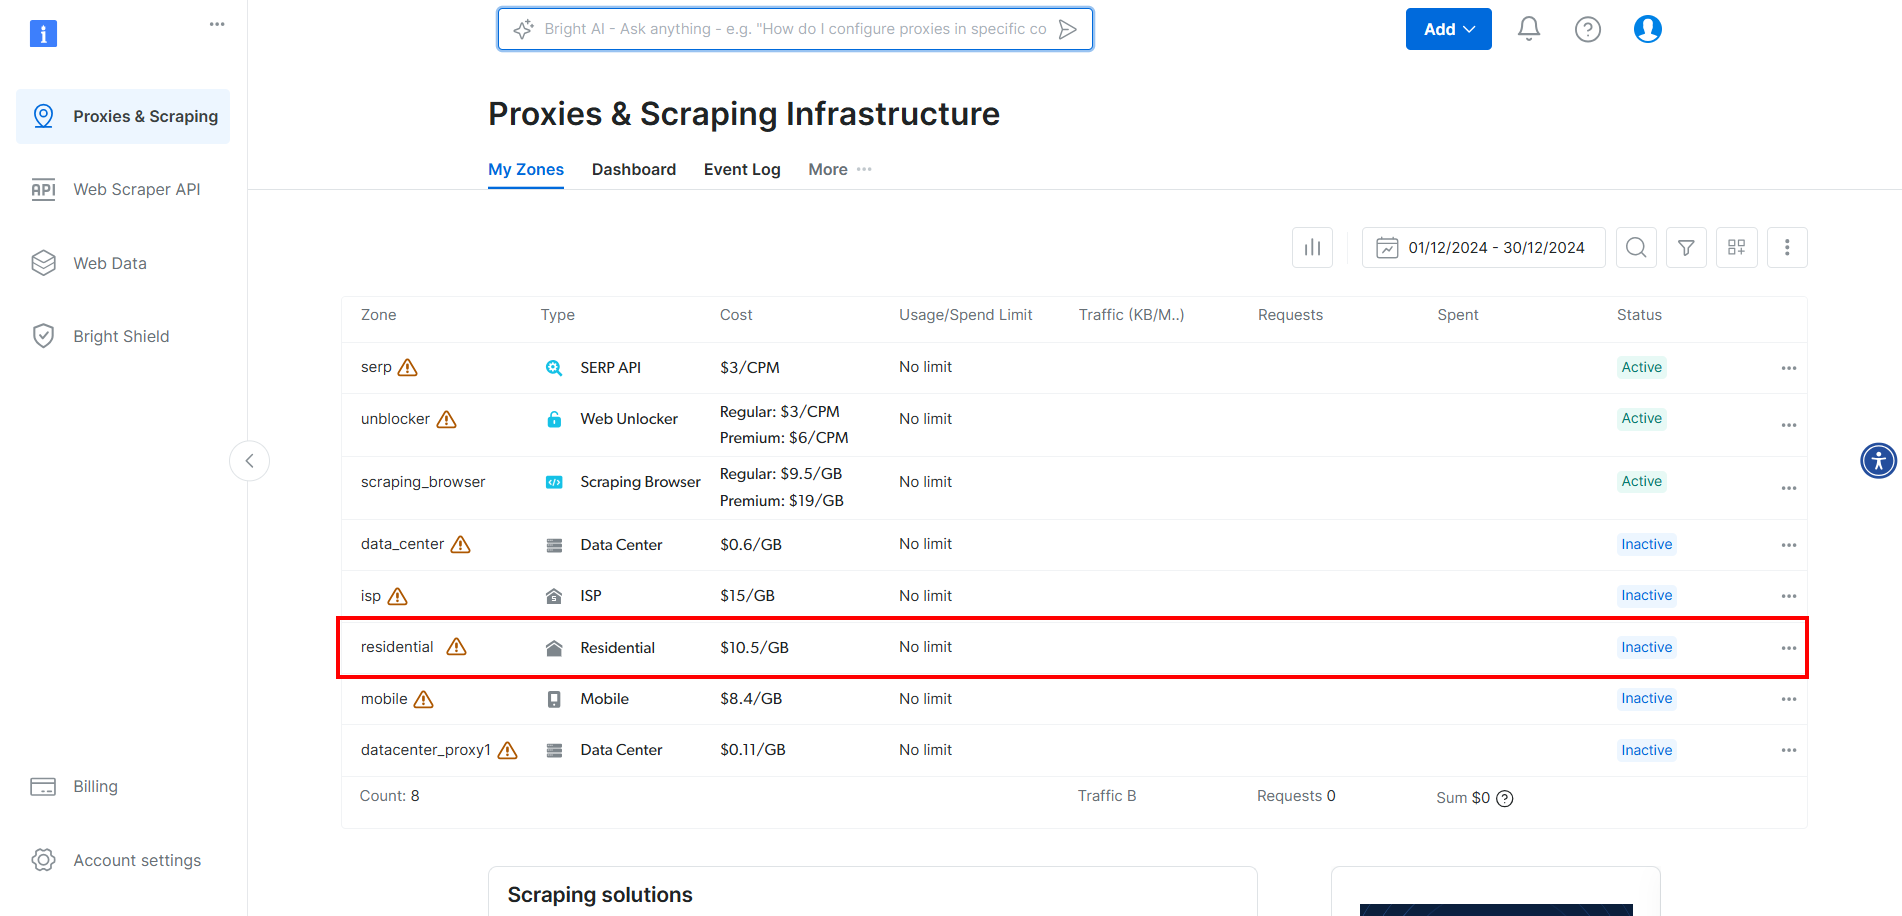
Para integrar os proxies da Bright Data no CloudScraper, crie uma conta ou faça login. Acesse o painel e clique na zona “Residencial” na tabela:
Aqui, ative os Proxies clicando no botão:
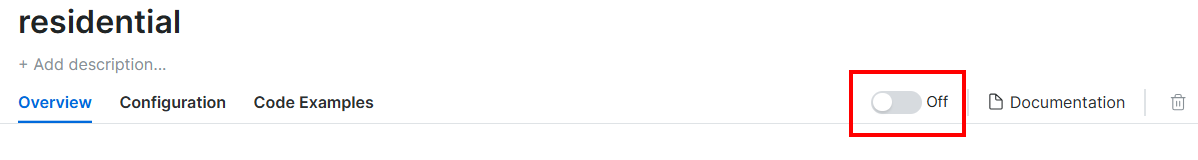Agora você deverá ver o seguinte:
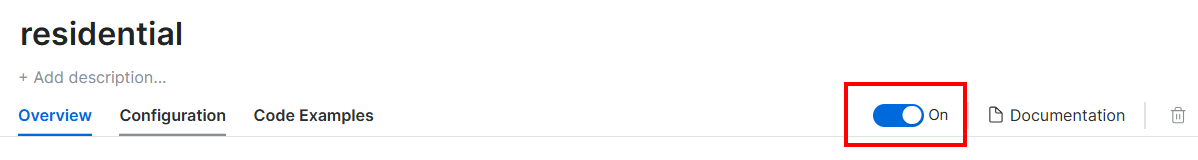Na seção “Detalhes de acesso”, copie o host do Proxy, o nome de usuário e a senha:
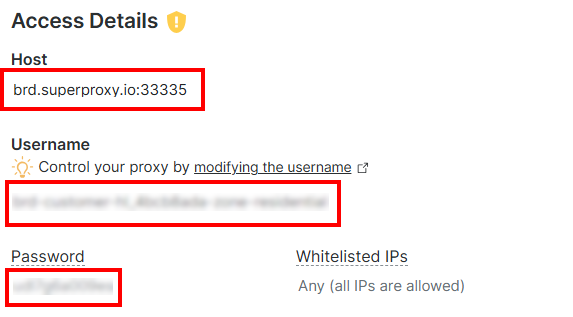A URL do seu Proxy Bright Data ficará assim:
```none
http://:@brd.superproxy.io:33335
```
Agora, integre o Proxy ao Cloudscraper da seguinte maneira:
```none
import cloudscraper
# Criar instância do CloudScraper
scraper = cloudscraper.create_scraper()
# Definir o Proxy Bright Data
proxies = {
"http": "http://:@brd.superproxy.io:33335",
"https": "http://:@brd.superproxy.io:33335"
}
# Realizar uma solicitação usando o Proxy
response = Scraper.get("https://httpbin.io/ip", proxies=proxies)
# Imprimir a resposta
print(response.text)
```
Lembre-se de que os Proxies residenciais da Bright Data são alternados automaticamente. Portanto, você receberá um IP diferente cada vez que executar o script.
Et voilà! Integração do Proxy CloudScraper concluída.
## Conclusão
Neste tutorial, você viu como usar o Cloudscraper com proxies para obter a máxima eficácia. Você aprendeu o básico sobre integração de proxy com a ferramenta Python Cloudflare-bypass e também explorou técnicas mais avançadas, como Proxy rotativo.
É muito mais fácil obter melhores resultados ao usar servidores Proxy IP de alta qualidade de um provedor de primeira linha como a Bright Data.
A Bright Data controla os melhores servidores Proxy do mundo, atendendo empresas da Fortune 500 e mais de 20.000 clientes. Sua rede mundial de Proxy envolve:
- [Proxies de datacenter](/proxy-types/datacenter-proxies) – Mais de 770.000 IPs de datacenter.
- [Proxies residenciais](/proxy-types/residential-proxies)– Mais de 150 milhões de IPs residencialis em mais de 195 países.
- [Proxies ISP](/proxy-types/isp-proxies) – Mais de 700.000 IPs de ISP.
No geral, esta é uma das maiores e mais confiáveis redes de Proxy disponíveis.
Crie uma conta gratuita na Bright Data hoje mesmo para experimentar nossos servidores Proxy.
Teste grátis[Registro no Google](# "Start free with Google")
Índice
400M+ Residential Proxies
**Get 50% off** on residential proxies for 6 months! Use code **RESIGB50**.
[See pricing](/pricing/proxy-network/residential-proxies "See pricing")
1.3M+ Datacenter Proxies
Pay only for the IP, starting from $0.90.
[See pricing](/pricing/proxy-network/datacenter-proxies "See pricing")
[ ](https://news.ycombinator.com/submitlink?t=Como+usar+Proxies+com+o+CloudScraper&u=https://brightdata.com.br/blog/proxies-101/cloudscraper-with-proxies) [ ](https://www.linkedin.com/shareArticle?mini=true&title=Como+usar+Proxies+com+o+CloudScraper&url=https://brightdata.com.br/blog/proxies-101/cloudscraper-with-proxies) [ ](http://www.reddit.com/submit?title=Como+usar+Proxies+com+o+CloudScraper&url=https://brightdata.com.br/blog/proxies-101/cloudscraper-with-proxies)
## Você também pode estar interessado em
[  ](https://brightdata.com.br/blog/ai/web-scraping-with-glm "Web Scraping with GLM: Text and Visual Data Extraction")
[AI

Antonello Zanini
Technical Writer
### Web Scraping with GLM: Text and Visual Data Extraction
Use o GLM-5.3 com o Web Unlocker da Bright Data para scraping de dados com IA. Extraia dados de texto e visuais automaticamente, contornando barreiras comuns.
16-Sep-2026
6 min de leitura
](https://brightdata.com.br/blog/ai/web-scraping-with-glm)
[  ](https://brightdata.com.br/blog/dados-do-site/containers-as-a-service "Containers as a Service (CaaS): Como Usar para Pipelines de Dados Web e Agentes de IA")
[Dados do site

Antonello Zanini
Technical Writer
### Containers as a Service (CaaS): Como Usar para Pipelines de Dados Web e Agentes de IA
Como o Containers as a Service funciona e como escalar um pipeline de scraping de dados da Bright Data entre containers para agentes de IA.
16-Sep-2026
15 min de leitura
](https://brightdata.com.br/blog/dados-do-site/containers-as-a-service)
[  ](https://brightdata.com.br/blog/ai/cursor-bright-data-vs-default-coding-agent "Cursor + Bright Data vs a configuração padrão de agente de codificação: construindo um rastreador de preços real")
[AI

Satyam Tripathi
Technical Writer
### Cursor + Bright Data vs a configuração padrão de agente de codificação: construindo um rastreador de preços real
Uma tarefa de rastreador de preços, 41 páginas de varejistas congeladas, dois agentes de codificação, mesmo prompt e modelo. Com o MCP da Bright Data por baixo: 89% de precisão de campo e 40 de 41 páginas lidas. Sem ele: 72% e 34.
16-Sep-2026
32 min de leitura
](https://brightdata.com.br/blog/ai/cursor-bright-data-vs-default-coding-agent)