---
title: "Web scraping em C++: um guia passo a passo"
slug: web-scraping-in-c-plus-plus
date: 2023-05-24T10:05:27+00:00
modified: 2025-11-04T08:56:30+00:00
permalink: https://brightdata.com.br/blog/procedimentos/web-scraping-in-c-plus-plus
type: blog
---

[ Blog ](https://brightdata.com.br/blog "Blog") / [procedimentos](https://brightdata.com.br/blog/procedimentos)


 [procedimentos](https://brightdata.com.br/blog/procedimentos)

# Web scraping em C++: um guia passo a passo

Aprenda a extrair dados de sites usando C++ neste guia passo a passo.

 7 min de leitura


 [ ![The letter 'A' on a blue background.](https://media.brightdata.com.br/2023/04/Alen-Kalac-50x50.png) ](https://brightdata.com/blog/authors/alen-kalac)

 [Alen Kalac

 ](https://brightdata.com/blog/authors/alen-kalac)


 ![web scraping with C++ hero image](https://media.brightdata.com.br/2023/05/web-scraping-with-C-hero-image.svg)


Resumo: este tutorial mostrará como extrair dados de um site em C++ e por que essa é uma das linguagens mais eficientes para extração de dados.

**Este guia abordará:**

- O C++ é uma boa linguagem para web scraping?
- Melhores bibliotecas de web scraping em C++
- Como criar um web scraper em C++

## O C++ é uma boa linguagem para web scraping?

[C++](https://en.wikipedia.org/wiki/C%2B%2B) é uma linguagem de programação de tipo estático que é amplamente usada para desenvolver aplicativos de alto desempenho. Isso ocorre porque ele é bem conhecido pela sua velocidade, eficiência e recursos de gerenciamento de memória. C++ é uma linguagem versátil que é útil em uma ampla variedade de aplicações, incluindo web scraping.

C++ é uma linguagem compilada e é inerentemente mais rápida do que linguagens interpretadas, como Python. Isso o torna uma excelente opção para criar scrapers rápidos. No entanto, o C++ não foi projetado para desenvolvimento web e não há muitas bibliotecas disponíveis para web scraping. Embora existam alguns pacotes de terceiros, as opções não são tão extensas quanto em Python, Ruby ou Java.

Em resumo, o web scraping em C++ é possível e eficiente, mas exige mais programação de baixo nível em comparação com outras linguagens. Vamos descobrir quais ferramentas podem facilitar esse processo!

## **Melhores bibliotecas de web scraping em C++**

**Eis algumas bibliotecas populares de web scraping em C++:**

- [CPR](https://github.com/libcpr/cpr): uma biblioteca moderna de cliente HTTP em C++, inspirada no projeto [Python Requests](https://github.com/kennethreitz/requests). Ela é um wrapper de [libcurl ](http://curl.haxx.se/libcurl)que fornece uma interface fácil de entender, recursos de autenticação integrados e suporte para chamadas assíncronas.
- [libxml2](https://gitlab.gnome.org/GNOME/libxml2/-/wikis/home): uma biblioteca poderosa e completa para fazer o parsing de documentos XML e HTML, originalmente desenvolvida para o Gnome. Ela suporta manipulação de DOM por meio de seletores XPath.
- [Lexbor](https://github.com/lexbor/lexbor): uma biblioteca de parsing de HTML rápida e leve, inteiramente escrita em C com suporte para seletores CSS. Ela está disponível somente para Linux.

Durante anos, o parser de HTML mais usado para C++ foi o [Gumbo](https://github.com/google/gumbo-parser). Ele não recebe manutenção desde 2016 e até mesmo [o README oficial](https://github.com/google/gumbo-parser#gumbo---a-pure-c-html5-parser) agora desaconselha seu uso.

## Pré-requisitos

**Antes de mergulhar nos códigos, você precisa:**

1. Ter um compilador de C++
2. Configurar o gerenciador de pacotes C++ `<a href="https://github.com/microsoft/vcpkg" rel="noreferrer noopener nofollow" target="_blank">vcpkg</a>`
3. Instalar o [CMake](https://cmake.org/)

Siga o guia abaixo para seu sistema operacional e saiba como cumprir esses pré-requisitos.

## Configurar o C++ no macOS

No macOS, o compilador de C, C++ e Objective-C mais popular é o [Clang](https://clang.llvm.org/). Tenha em mente que muitos Macs vêm com o Clang pré-instalado. Para verificar isso, abra um terminal e execute o comando abaixo:

```none
clang --version

```

Se você receber o erro `command not found: clang` (comando não encontrado), significa que o Clang não está instalado ou configurado corretamente. Nesse caso, você pode instalá-lo por meio das ferramentas de linha de comando do Xcode:

```none
xcode-select --install

```

Isso pode demorar um pouco, então seja paciente.

Para configurar o `vcpkg`, você precisará primeiro das ferramentas de desenvolvedor do macOS. Adicione-as ao seu Mac com:

```none
xcode-select --install

```

Então, você precisará instalar o `vcpkg` globalmente. Crie uma pasta `/dev` , insira-a no terminal e execute:

```none
git clone https://github.com/microsoft/vcpkg

```

O diretório agora conterá o código-fonte. Crie o gerenciador de pacotes com:

```none
./vcpkg/bootstrap-vcpkg.sh

```

Para executar este comando, talvez você precise de privilégios elevados.

Por fim, adicione `/dev/vcpkg` ao seu `$PATH` seguindo [este guia](https://techpp.com/2021/09/08/set-path-variable-in-macos-guide/).

Para instalar o CMake, baixe o[ instalador do site oficial](https://cmake.org/download/), inicialize-o e siga o assistente de instalação.

## Configurar o C++ no Windows

Baixe o instalador [MinGW-x64](https://www.mingw-w64.org/) do [MSYS2](https://www.msys2.org/), inicialize-o e siga as instruções. Esse pacote fornece compilações nativas atualizadas do GCC, MinGW-w64 e outras ferramentas e bibliotecas úteis de C++.

No terminal do MSYS2 aberto no final do processo de instalação, execute o comando abaixo para instalar a cadeia de ferramentas MinGW-w64:

```none
pacman -S --needed base-devel mingw-w64-x86_64-toolchain

```

Aguarde o término do processo e adicione o MinGW ao ambiente `PATH` , conforme explicado [aqui](https://code.visualstudio.com/docs/languages/cpp#_add-the-mingw-compiler-to-your-path).

Em seguida, você precisará instalar o `vcpkg` globalmente. Crie uma pasta `C:/dev` , abra-a no PowerShell e execute:

```none
git clone https://github.com/microsoft/vcpkg

```

Crie o código-fonte do gerenciador de pacotes contido na subpasta `vcpkg` com:

```none
./vcpkg/bootstrap-vcpkg.bat

```

Agora, adicione `C:/dev/vcpkg` ao seu `PATH` como feito antes.

Só resta instalar o CMake. Baixe o [instalador](https://cmake.org/download/), clique duas vezes nele e certifique-se de marcar a opção abaixo durante a configuração.

![](https://media.brightdata.com/2023/05/s_6776990FE039C8E1A28F1E7FBFD04057B1476FA3238B76E106F58F360C5E72CC_1684013632284_Screenshot2023-05-13182756.png)

Configurar o C++ no Linux
Em distribuições baseadas em Debian, instale o [GCC ](https://gcc.gnu.org/)(GNU Compiler Collection), CMake e outros pacotes úteis para desenvolvimento com:

```none
sudo apt install build-essential cmake

```

Isso pode levar algum tempo, então seja paciente.

Em seguida, você precisará instalar o `vcpkg` globalmente. Crie um diretório `/dev` , abra-o no terminal e digite:

```none
git clone https://github.com/microsoft/vcpkg

```

O subdiretório `vcpkg` agora conterá o código-fonte do gerenciador de pacotes. Crie a ferramenta com:

```none
./vcpkg/bootstrap-vcpkg.sh

```

Note que esse comando pode exigir privilégios de administrador.

Em seguida, adicione `/dev/vcpkg` à sua variável de ambiente `$PATH` seguindo [este ](https://phoenixnap.com/kb/linux-add-to-path)guia.

Perfeito! Agora você tem tudo o que precisa para começar a usar o web scraping em C++!

## **Como criar um web scraper em C++**

Neste capítulo, você aprenderá a codificar um rastreador web em C++. O site de destino será a página inicial da [Bright Data](/) e o script cuidará da:

- Conexão com a página web
- Seleção dos elementos HTML de interesse do DOM
- Recuperação dos dados deles
- Exportação dos dados copiados para CSV

No momento, isso é o que os visitantes veem ao explorar a página de destino:

![](https://media.brightdata.com/2023/05/s_6776990FE039C8E1A28F1E7FBFD04057B1476FA3238B76E106F58F360C5E72CC_1684161750992_chrome-capture-2023-4-15.gif)Lembre-se de que a página inicial da BrightData muda com frequência. Então, isso pode ter mudado quando você estiver lendo este artigo.

Alguns dados interessantes para extrair da página são as informações do setor contidas nestes cartões:
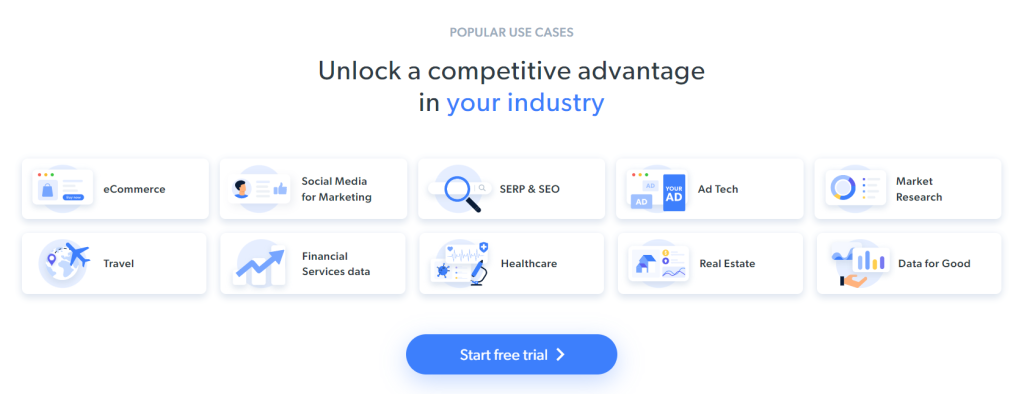
![](https://media.brightdata.com/2023/05/s_AFE13B4772D3F4335FE29C87FF7F9F7EC3D58E63BD6E7F8A7D0D66DA3F5A487A_1682521439443_image-1-1024x394.png)A meta de extração de dados para este tutorial passo a passo foi definida. Vamos ver como fazer web scraping com C++!

## Etapa 1: inicialize um projeto de extração de dados em C++

Primeiro, você precisa de uma pasta onde colocar seu projeto C++. Abra o terminal e crie o diretório do projeto com:

```none
mkdir c++-web-scraper

```

Isso conterá seu script de extração de dados.

Ao criar software em C++, você deve optar por um IDE do Visual Studio. Em detalhes, você está prestes a ver como configurar o [Visual Studio Code](https://code.visualstudio.com/) (VS Code) para desenvolvimento em C++ com o `vcpkg` como gerenciador de pacotes. Note que procedimentos similares podem ser aplicados a outros IDEs de C++.

O VS Code não oferece suporte integrado para C++, então primeiro você precisa adicionar o plugin [C/C++](https://code.visualstudio.com/docs/languages/cpp) . Inicie o Visual Studio Code, clique no ícone “Extensions” (extensões) na barra esquerda e digite “C++” no campo de pesquisa na parte superior.
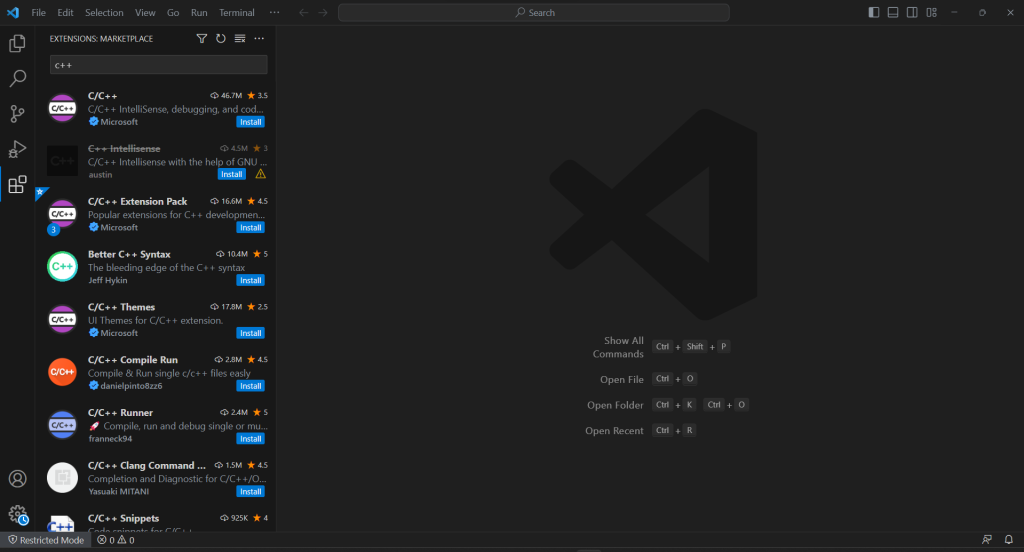
![](https://media.brightdata.com/2023/05/s_6776990FE039C8E1A28F1E7FBFD04057B1476FA3238B76E106F58F360C5E72CC_1683983021150_image-1024x552.png)Clique no botão “Install” (instalar) no primeiro elemento para adicionar a funcionalidade de desenvolvimento de C++ ao VS Code. Aguarde a configuração da extensão e abra a pasta `c++-web-scraper` com `“``<strong>File</strong>``”` `>` `“``Open Folder... ``”`(arquivo &gt; abrir pasta…).

Clique com o botão direito na seção “**EXPLORER**” (explorador), selecione “New File…” (novo arquivo) e inicialize um arquivo `scraper.cpp` da seguinte forma:

```none
#include <iostream>

int main()
{
    std::cout << "Hello World" << std::endl;
}

```
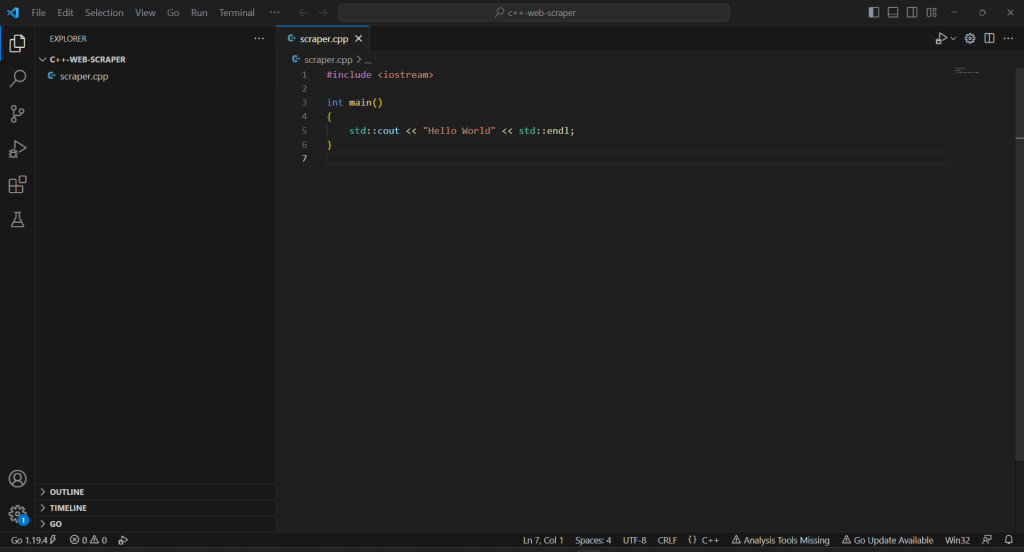
![](https://media.brightdata.com/2023/05/s_6776990FE039C8E1A28F1E7FBFD04057B1476FA3238B76E106F58F360C5E72CC_1683983847858_image-1024x552.png)Agora você tem um projeto em C++!

## Etapa 2: instale as bibliotecas de scraping

A sintaxe complicada do C++ e seus recursos web limitados podem representar um obstáculo ao criar um web scraper. Para facilitar tudo, você deve adotar algumas bibliotecas C++ de web scraping. Como mencionado anteriormente, a escolha é bastante limitada. Portanto, você deve escolher as mais populares: `cpr` e `libxml2`.

Você pode instalá-los no Windows por meio do `vcpkg` com:

```none
vcpkg install cpr libxml2 --triplet=x64-windows

```

No macOS, substitua a [opção triplet](https://learn.microsoft.com/en-us/vcpkg/users/triplets) por `x64-osx` . No Linux, use `x64-linux`.

No terminal do Visual Studio Code, você também precisa executar o seguinte comando no diretório raiz do seu projeto:

```none
vcpkg integrate install

```

Isso permitirá a vinculação de pacotes `vcpkg` ao projeto.

Reinicie o VS Code e então você poderá importar qualquer biblioteca instalada com `#include`. Então, adicione as três linhas a seguir no topo do seu arquivo `scraper.cpp` :

```none
#include "cpr/cpr.h"
#include "libxml/HTMLparser.h"
#include "libxml/xpath.h"

```

Certifique-se de que o IDE não relate nenhum erro.

## Etapa 3: finalize a inicialização do projeto C++

Para criar o script de scraping em C++ e concluir o processo de inicialização do projeto, você precisará adicionar a extensão [CMake ](https://marketplace.visualstudio.com/items?itemName=ms-vscode.cmake-tools)Tools ao VS Code:
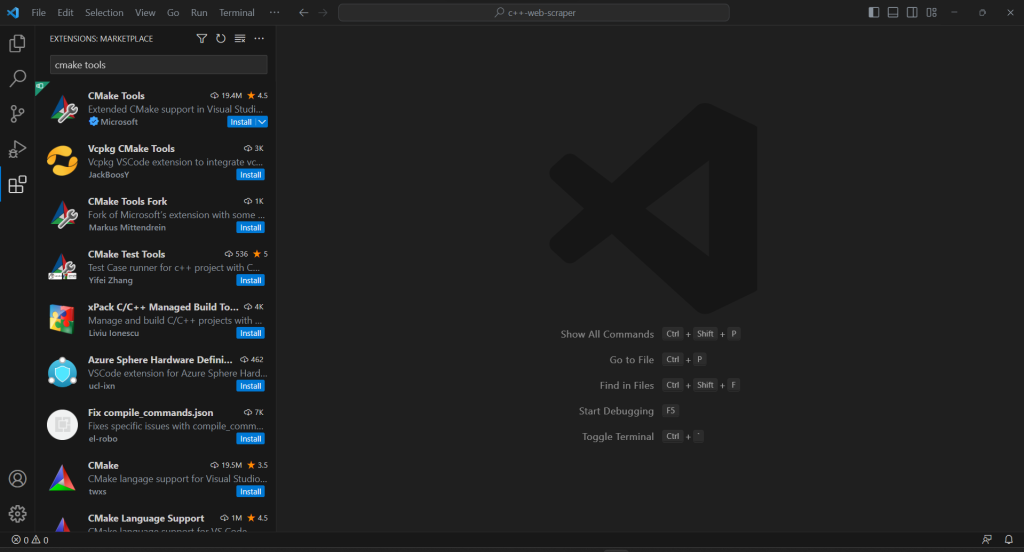
![](https://media.brightdata.com/2023/05/s_6776990FE039C8E1A28F1E7FBFD04057B1476FA3238B76E106F58F360C5E72CC_1684013838397_Screenshot2023-05-13200042-1024x552.png)Se o seu projeto não tiver uma pasta `.vscode` , crie-a. É aí que o VS Code procura configurações relacionadas ao projeto atual.

Configure o CMake Tools para usar o `vcpkg` como uma cadeia de ferramentas criando um arquivo `settings.json` dentro da pasta `.vscode` da seguinte forma:

```none
{
  "cmake.configureSettings": {
    "CMAKE_TOOLCHAIN_FILE": "c:/dev/vcpkg/scripts/buildsystems/vcpkg.cmake"
  }
}

```

No macOS e no Linux, corrija o campo `CMAKE_TOOLCHAIN_FILE` de acordo com o caminho em que você instalou o `vcpkg`. Se você seguiu o guia de configuração acima, ele deve ser `/dev/vcpkg/scripts/buildsystems/vcpkg.cmake`.

Na barra de pesquisa principal do VS Code, digite “&gt;cmake” e selecione a opção “CMake: Configure”:

![](https://media.brightdata.com/2023/05/s_6776990FE039C8E1A28F1E7FBFD04057B1476FA3238B76E106F58F360C5E72CC_1684013971518_image.png)Isso permitirá que você selecione a plataforma de compilação de destino. No Windows, opte por “Visual Studio Build Tools 2019 Release – x86\_amd64″:

![](https://media.brightdata.com/2023/05/s_6776990FE039C8E1A28F1E7FBFD04057B1476FA3238B76E106F58F360C5E72CC_1684014083449_image.png)Adicione o arquivo `<a href="https://cmake.org/cmake/help/book/mastering-cmake/chapter/Writing%20CMakeLists%20Files.html" rel="noreferrer noopener nofollow" target="_blank">CMakeLists.txt</a>` à pasta raiz do seu projeto para configurar o CMake:

```none
cmake_minimum_required(VERSION 3.0.0)
project(main VERSION 0.1.0)

INCLUDE_DIRECTORIES(
  C:/dev/vcpkg/installed/x86-windows/include
)

LINK_DIRECTORIES(
   C:/dev/vcpkg/installed/x86-windows/lib
)

add_executable(main scraper.cpp)
target_compile_features(main PRIVATE cxx_std_20)

find_package(cpr CONFIG REQUIRED)
target_link_libraries(main PRIVATE cpr::cpr)

find_package(LibXml2 REQUIRED)
target_link_libraries(main PRIVATE LibXml2::LibXml2)

```

Note que isso envolve os dois pacotes instalados anteriormente. Certifique-se de atualizar `INCLUDE_DIRECTORIES` e `LINK_DIRECTORIES` de acordo com sua pasta de instalação do `vcpkg` .

Para permitir que o Visual Studio Code execute o programa C++, você precisa de um arquivo de configuração de inicialização. Na pasta `.vscode` , inicialize `launch.json` conforme abaixo:

```none
{
  "configurations": [
    {
      "name": "C++ Launch (Windows)",
      "type": "cppvsdbg",
      "request": "launch",
      "program": "${workspaceFolder}/build/Debug/main.exe",
      "args": [],
      "stopAtEntry": false,
      "cwd": "${workspaceFolder}",
      "environment": []
    }
  ]
}

```

Ao inicializar o comando de execução ou depuração, o VS Code então executará o arquivo no caminho do `programa` produzido pelo CMake. Observe que no macOS e no Linux, não será um arquivo `.exe` .

A configuração está pronta!

Toda vez que você quiser depurar ou compilar seu aplicativo, digite “&gt;cmake: Build” no campo de entrada no topo e selecione a opção “CMake: Build”.

![](https://media.brightdata.com/2023/05/s_6776990FE039C8E1A28F1E7FBFD04057B1476FA3238B76E106F58F360C5E72CC_1684147211980_image.png)Aguarde o término do processo de compilação e execute o programa compilado na seção “Run &amp; Debug” (executar e depurar), ou pressionando F5. Você verá o resultado do seu aplicativo no console de depuração do VSC.
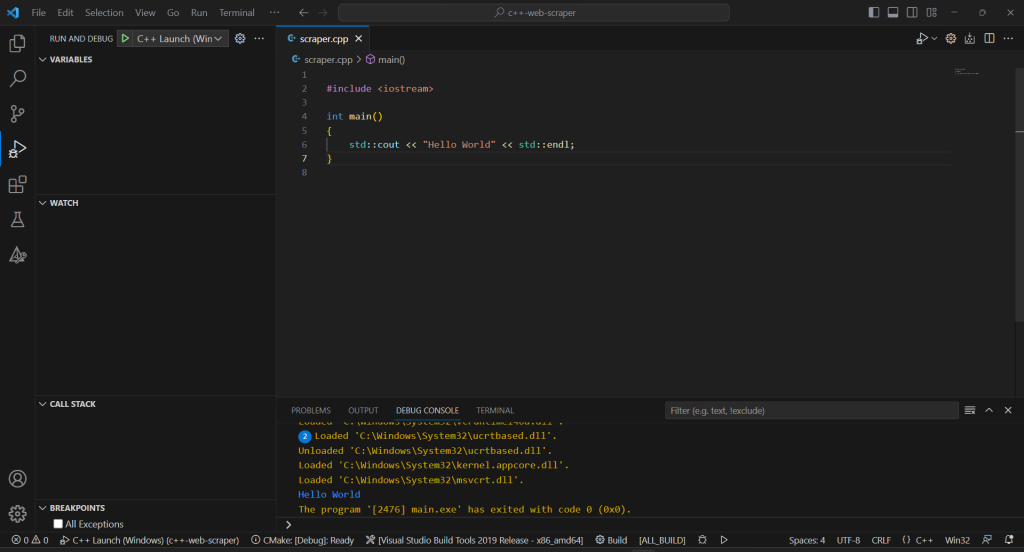
![](https://media.brightdata.com/2023/05/s_6776990FE039C8E1A28F1E7FBFD04057B1476FA3238B76E106F58F360C5E72CC_1684147525940_image-1024x552.png)Ótimo! É hora de começar a extrair alguns dados em C++!

## Etapa 4: baixe a página de destino com a CPR

Se você quiser extrair dados de uma página, primeiro você precisa recuperar seu documento HTML por meio de uma solicitação HTTP `<a href="https://developer.mozilla.org/en-US/docs/Web/HTTP/Methods/GET" rel="noreferrer noopener nofollow" target="_blank">GET</a>` .

Use o CPR para baixar a página de destino com:

```none
cpr::Response response = cpr::Get(cpr::Url{"https://brightdata.com/"});

```

Nos bastidores, o método `<a href="https://docs.libcpr.org/introduction.html#get-requests" rel="noreferrer noopener nofollow" target="_blank">Get()</a>` executa uma solicitação `GET` para o URL passado como parâmetro. `response.text` conterá a representação em string do código HTML retornado pelo servidor.

Observe que a realização de solicitações HTTP automatizadas pode acionar tecnologias antibot. Elas podem interceptar suas solicitações, impedindo que seu script acesse o site de destino. Especificamente, as soluções antiscraping mais básicas bloqueiam as solicitações recebidas sem um cabeçalho HTTP `<a href="https://developer.mozilla.org/en-US/docs/Web/HTTP/Headers/User-Agent" rel="noreferrer noopener nofollow" target="_blank">User-Agent</a>` válido. Saiba mais sobre `User-`[Agent`s` para web scraping](/blog/procedimentos/user-agents-for-web-scraping-101).

Assim como qualquer outro cliente HTTP, a CPR usa um valor de exemplo para `User-Agent`. Como ele é muito diferente dos agentes usados pelos navegadores populares, os sistemas antibot podem identificá-lo facilmente. Para evitar ser bloqueado por esse motivo, você pode definir um `User-Agent` válido na CPR com:

```none
cpr::Header headers = {{"User-Agent", "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/113.0.0.0 Safari/537.36"}};
cpr::Response response = cpr::Get(cpr::Url{"https://brightdata.com/121.21.21.da/31/3das/32/1"}, headers);

```

A solicitação HTTP feita por meio desse `Get()` agora aparecerá como proveniente do Google Chrome 113.

Isso é o que o `scraper.cpp` contém atualmente:

```none
#include <iostream>
#include "cpr/cpr.h"
#include "libxml/HTMLparser.h"
#include "libxml/xpath.h"

int main()
{
    // define the user agent for the GET request
    cpr::Header headers = {{"User-Agent", "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/113.0.0.0 Safari/537.36"}};
    // make the HTTP request to retrieve the target page
    cpr::Response response = cpr::Get(cpr::Url{"https://brightdata.com/"}, headers);

    // scraping logic...
}

```

## Etapa 5: faça o parsing do conteúdo HTML com a libxml2

Para que o documento HTML retornado pelo servidor se torne facilmente explorável, você deve primeiro fazer seu parsing.
Passe sua representação de string em C para a função `<a href="https://gnome.pages.gitlab.gnome.org/libxml2/devhelp/libxml2-HTMLparser.html#htmlReadMemory" rel="noreferrer noopener nofollow" target="_blank">htmlReadMemory()</a>` da libxml2 para conseguir isso:

```none
htmlDocPtr doc = htmlReadMemory(response.text.c_str(), response.text.length(), nullptr, nullptr, HTML_PARSE_NOWARNING | HTML_PARSE_NOERROR);

```

A variável `doc` agora expõe a API de exploração DOM oferecida pela libxml2. Em detalhes, você pode recuperar elementos HTML na página por meio de seletores XPath. No momento em que este artigo foi escrito, a libxml2 não dava suporte a seletores CSS.

## Etapa 6: defina os seletores XPath para obter os elementos HTML desejados

Para definir uma estratégia eficaz de seleção de XPath para os nós HTML de interesse, você precisa analisar o DOM da página de destino. Abra a página inicial da Bright Data no navegador, clique com o botão direito em um dos cartões de setor e escolha “Inspecionar”. Isso abrirá a seção DevTools:
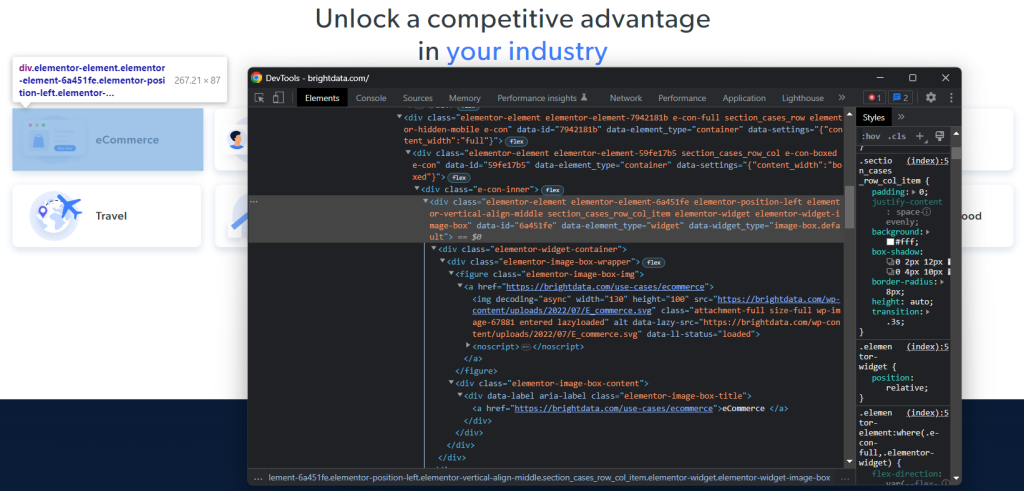
![](https://media.brightdata.com/2023/05/s_AFE13B4772D3F4335FE29C87FF7F9F7EC3D58E63BD6E7F8A7D0D66DA3F5A487A_1682521993140_image-1-1024x491.png)Explore o código HTML e você notará que cada cartão de setor é um elemento `<div>` que contém:

1. Um elemento `<figure>` com um `<img>` representando a imagem do setor e um `<a>` contendo o URL para a página do setor.
2. Um elemento `<div>` HTML que armazena o nome do setor em um `<a>`.

Para cada cartão, o objetivo do scraper em C++ é extrair:

- O URL da imagem do setor
- O URL da página do setor
- O nome do setor

Para definir seletores XPath adequados, volte sua atenção para a estrutura DOM dos elementos de interesse. Você notará que pode obter todos os cartões do setor com o seletor XPath abaixo:

```none
//div[contains(@class, 'section_cases_row_col_item')]

```

Se você tiver alguma dúvida, teste as instruções do XPath no console do navegador com `$x()`:

![](https://media.brightdata.com/2023/05/s_6776990FE039C8E1A28F1E7FBFD04057B1476FA3238B76E106F58F360C5E72CC_1684154947978_image-1024x480.png)Com um cartão, você pode obter os nós desejados com:

1. `.//figura/a/img`
2. `.//figura/a`
3. `.//div[contains(@class, 'elementor-image-box-title')]/a`

Etapa 7: extraia dados de uma página web com a libxml2
Agora você poderá usar a libxml2 para aplicar os seletores XPath definidos anteriormente e obter os dados desejados da página HTML de destino.

Primeiro, você precisa de uma estrutura de dados cujas instâncias armazenem os dados extraídos:

```none
struct IndustryCard
{
    std::string image;
    std::string url;
    std::string name;
};

```

Em C++, uma `struct` permite agrupar vários atributos de dados com o mesmo nome em um bloco de memória.

Em seguida, inicialize um array de `IndustryCard`s na função `main()`:

```none
std::vector<IndustryCard> industry_cards;

```

Isso armazenará todos os objetos de dados de extração.

Preencha esse `vetor` com a seguinte lógica de web scraping em C++:

```none
// define an array to store all retrieved data
std::vector<IndustryCard> industry_cards;
// set the libxml2 context to the current document
xmlXPathContextPtr context = xmlXPathNewContext(doc);

// select all industry card HTML elements
// with an XPath selector
xmlXPathObjectPtr industry_card_html_elements = xmlXPathEvalExpression((xmlChar *)"//div[contains(@class, 'section_cases_row_col_item')]", context);

// iterate over the list of industry card elements
for (int i = 0; i < industry_card_html_elements->nodesetval->nodeNr; ++i)
{
    // get the current element of the loop
    xmlNodePtr industry_card_html_element = industry_card_html_elements->nodesetval->nodeTab[i];

    // set the libxml2 context to the current element
    // to limit the XPath selectors to its children
    xmlXPathSetContextNode(industry_card_html_element, context);

    xmlNodePtr image_html_element = xmlXPathEvalExpression((xmlChar *)".//figure/a/img", context)->nodesetval->nodeTab[0];
    std::string image = std::string(reinterpret_cast<char *>(xmlGetProp(image_html_element, (xmlChar *)"data-lazy-src")));

    xmlNodePtr url_html_element = xmlXPathEvalExpression((xmlChar *)".//figure/a", context)->nodesetval->nodeTab[0];
    std::string url = std::string(reinterpret_cast<char *>(xmlGetProp(url_html_element, (xmlChar *)"href")));

    xmlNodePtr name_html_element = xmlXPathEvalExpression((xmlChar *)".//div[contains(@class, 'elementor-image-box-title')]/a", context)->nodesetval->nodeTab[0];
    std::string name = std::string(reinterpret_cast<char *>(xmlNodeGetContent(name_html_element)));

    // instantiate an IndustryCard struct with the collected data
    IndustryCard industry_card = {image, url, name};
    // add the object with the scraped data to the vector
    industry_cards.push_back(industry_card);
}

// free up the resource allocated by libxml2
xmlXPathFreeObject(industry_card_html_elements);
xmlXPathFreeContext(context);
xmlFreeDoc(doc);

```

O trecho acima seleciona os cartões de setor aplicando o seletor XPath definido anteriormente com `<a href="https://gnome.pages.gitlab.gnome.org/libxml2/devhelp/libxml2-xpath.html#xmlXPathEvalExpression" rel="noreferrer noopener nofollow" target="_blank">xmlXPathEvalExpression()</a>`. Em seguida, ele itera sobre eles e implementa uma abordagem semelhante para obter os elementos filhos de interesse de cada cartão. Em seguida, ele extrai o URL da imagem do setor, o URL da página e o nome deles. Por fim, ele libera os recursos alocados pela libxml2.

Como você pode ver, o web scraping usando C++ com libxml2 não é tão complexo. Graças ao `<a href="https://gnome.pages.gitlab.gnome.org/libxml2/devhelp/libxml2-tree.html#xmlGetProp" rel="noreferrer noopener nofollow" target="_blank">xmlGetProp()</a>` e `<a href="https://gnome.pages.gitlab.gnome.org/libxml2/devhelp/libxml2-tree.html#xmlNodeGetContent" rel="noreferrer noopener nofollow" target="_blank">xmlNodeGetContent()</a>` , você pode obter o valor de um atributo HTML e o conteúdo de um nó, respectivamente.

Agora que você sabe como funciona a extração de dados em C++, você tem as ferramentas para dar um passo adiante e também extrair dados das páginas do setor. Você só precisa seguir os links descobertos aqui e criar uma nova lógica de scraping. É disso que se trata o [rastreamento e extração de dados da web](https://brightdata.com.br/blog/lideranca/rastejamento-vs-raspagem-da-web)!

Incrível! Você acabou de atingir seus objetivos. No entanto, o tutorial ainda não acabou.

## Etapa 8: exporte os dados extraídos para CSV

Ao final do loop `for()` , `industry_cards` armazenará os dados extraídos em instâncias `struct`. Como você pode imaginar, esse não é o melhor formato para fornecer dados para outras equipes. Veja por que você deve converter os dados recuperados para CSV.

**Você pode exportar um `vetor` para um arquivo CSV com funções C++ integradas, da seguinte forma:**

```none
// initialize the CSV output file
std::ofstream csv_file("output.csv");
// write the CSV header
csv_file << "url,image,name" << std::endl;
// poupulate the CSV output file
for (IndustryCard industry_card : industry_cards)
{
    // transfrom each industry card record to a CSV record
    csv_file << industry_card.url << "," << industry_card.image << "," << industry_card.name << std::endl;
}
// free up the file resources
csv_file.close();

```

O código acima cria um arquivo `output.csv` e o inicializa com o registro do cabeçalho. Em seguida, ele itera sobre o array `industry_cards` , converte cada elemento em uma string no formato CSV e o anexa ao arquivo de saída.

Crie seu script de scraping em C++, execute-o e você verá o seguinte arquivo `output.csv` no diretório raiz do seu projeto:

![](https://media.brightdata.com/2023/05/s_AFE13B4772D3F4335FE29C87FF7F9F7EC3D58E63BD6E7F8A7D0D66DA3F5A487A_1682525940173_image-1-1024x215.png)**Muito bem! Agora você sabe como exportar para CSV dados extraídos em C++!**

## Etapa 9: junte tudo

**Eis o scraper inteiro em C++:**

```none
// scraper.cpp

#include <iostream>
#include "cpr/cpr.h"
#include "libxml/HTMLparser.h"
#include "libxml/xpath.h"
#include <vector>

// define a struct where to store the scraped data
struct IndustryCard
{
    std::string image;
    std::string url;
    std::string name;
};

int main()
{
    // define the user agent for the GET request
    cpr::Header headers = {{"User-Agent", "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/113.0.0.0 Safari/537.36"}};
    // make an HTTP GET request to retrieve the target page
    cpr::Response response = cpr::Get(cpr::Url{"https://brightdata.com/"}, headers);

    // parse the HTML document returned by the server
    htmlDocPtr doc = htmlReadMemory(response.text.c_str(), response.text.length(), nullptr, nullptr, HTML_PARSE_NOWARNING | HTML_PARSE_NOERROR);

    // define an array to store all retrieved data
    std::vector<IndustryCard> industry_cards;
    // set the libxml2 context to the current document
    xmlXPathContextPtr context = xmlXPathNewContext(doc);
    // select all industry card HTML elements
    // with an XPath selector
    xmlXPathObjectPtr industry_card_html_elements = xmlXPathEvalExpression((xmlChar *)"//div[contains(@class, 'section_cases_row_col_item')]", context);

    // iterate over the list of industry card elements
    for (int i = 0; i < industry_card_html_elements->nodesetval->nodeNr; ++i)
    {
        // get the current element of the loop
        xmlNodePtr industry_card_html_element = industry_card_html_elements->nodesetval->nodeTab[i];
        // set the libxml2 context to the current element
        // to limit the XPath selectors to its children
        xmlXPathSetContextNode(industry_card_html_element, context);

        xmlNodePtr image_html_element = xmlXPathEvalExpression((xmlChar *)".//figure/a/img", context)->nodesetval->nodeTab[0];
        std::string image = std::string(reinterpret_cast<char *>(xmlGetProp(image_html_element, (xmlChar *)"data-lazy-src")));

        xmlNodePtr url_html_element = xmlXPathEvalExpression((xmlChar *)".//figure/a", context)->nodesetval->nodeTab[0];
        std::string url = std::string(reinterpret_cast<char *>(xmlGetProp(url_html_element, (xmlChar *)"href")));

        xmlNodePtr name_html_element = xmlXPathEvalExpression((xmlChar *)".//div[contains(@class, 'elementor-image-box-title')]/a", context)->nodesetval->nodeTab[0];
        std::string name = std::string(reinterpret_cast<char *>(xmlNodeGetContent(name_html_element)));

        // instantiate an IndustryCard struct with the collected data
        IndustryCard industry_card = {image, url, name};
        // add the object with the scraped data to the vector
        industry_cards.push_back(industry_card);
    }

    // free up the resource allocated by libxml2
    xmlXPathFreeObject(industry_card_html_elements);
    xmlXPathFreeContext(context);
    xmlFreeDoc(doc);

    // initialize the CSV output file
    std::ofstream csv_file("output.csv");
    // write the CSV header
    csv_file << "url,image,name" << std::endl;

    // poupulate the CSV output file
    for (IndustryCard industry_card : industry_cards)
    {
        // transfrom each industry card record to a CSV record
        csv_file << industry_card.url << "," << industry_card.image << "," << industry_card.name << std::endl;
    }

    // free up the file resources
    csv_file.close();

    return 0;
}

```

**E pronto! Em cerca de 80 linhas de código, você pode criar um script de extração de dados em C++!**

## Conclusão

Neste tutorial, aprendemos por que o C++ é uma linguagem eficiente para extrair dados da web. Embora não haja tantas bibliotecas de scraping quanto em outras linguagens, existem algumas. E aqui você teve a oportunidade de ver quais são as mais populares. Em seguida, você viu como usar CPR e libxml2 para criar um rastreador em C++ que pode coletar dados de um alvo real.

No entanto, muitos desafios surgem com [web scraping](/blog/procedimentos/what-is-web-scraping). Na verdade, um número cada vez maior de sites vem implementando tecnologias antibot e antiscraping para proteger seus dados. Essas ferramentas são capazes de detectar as solicitações automatizadas realizadas pelo seu script de scraping em C++ e bani-las. Felizmente, existem muitas soluções automatizadas para suas necessidades de coleta de dados. Entre em contato conosco para descobrir qual é a melhor solução para o seu caso de uso.

**Não quer lidar de forma alguma com web scraping, mas tem interesse em dados web?** [Explore nossos datasets prontos para uso](https://brightdata.com.br/products/datasets).


Contate-nosTeste grátis![google social icon](/wp-content/themes/brightdata/assets/images/ic_google.svg)


 Índice


Dedicated Scraper APIs &amp; No-Code Scrapers

Over 1000 scrapers for all popular domains. Simplify your web scraping.

[See pricing](/pricing/web-scraper "See pricing")

Just want data? Skip scraping.

Hundreds of ready-to-use datasets from all popular domains.

[See pricing](/pricing/datasets "See pricing")


 [ ](https://news.ycombinator.com/submitlink?t=Web+scraping+em+C%2B%2B%3A+um+guia+passo+a+passo&u=https://brightdata.com.br/blog/procedimentos/web-scraping-in-c-plus-plus) [ ](https://www.linkedin.com/shareArticle?mini=true&title=Web+scraping+em+C%2B%2B%3A+um+guia+passo+a+passo&url=https://brightdata.com.br/blog/procedimentos/web-scraping-in-c-plus-plus) [ ](http://www.reddit.com/submit?title=Web+scraping+em+C%2B%2B%3A+um+guia+passo+a+passo&url=https://brightdata.com.br/blog/procedimentos/web-scraping-in-c-plus-plus)


##  Você também pode estar interessado em

 [ ![OpenHuman with Bright Data](https://media.brightdata.com.br/2026/09/OpenHuman-with-Bright-Data.png) ](https://brightdata.com.br/blog/ai/openhuman-with-bright-data "Acesso à Web Pronto para Produção no OpenHuman Através do Bright Data CLI")

 [AI


 ![Antonello Zanini](https://media.brightdata.com.br/2022/12/Antonello-Zanini-2-50x50.jpg)

Antonello Zanini

Technical Writer


### Acesso à Web Pronto para Produção no OpenHuman Através do Bright Data CLI

Integre o Bright Data CLI ao OpenHuman para habilitar acesso à web pronto para produção e coleta de dados para agentes de IA.


 09-Sep-2026

 14 min de leitura

 ](https://brightdata.com.br/blog/ai/openhuman-with-bright-data)

 [ ![Multimodal Web Scraping with MiniMax](https://media.brightdata.com.br/2026/09/Multimodal-Web-Scraping-with-MiniMax.png) ](https://brightdata.com.br/blog/dados-do-site/multimodal-web-scraping-with-minimax "Scraping de Dados Multimodal com MiniMax")

 [Dados do site


 ![Antonello Zanini](https://media.brightdata.com.br/2022/12/Antonello-Zanini-2-50x50.jpg)

Antonello Zanini

Technical Writer


### Scraping de Dados Multimodal com MiniMax

Combine a API Web Unlocker da Bright Data com a visão MiniMax M3 para extrair dados estruturados de imagens e capturas de tela de páginas web.


 09-Sep-2026

 5 min de leitura

 ](https://brightdata.com.br/blog/dados-do-site/multimodal-web-scraping-with-minimax)

 [ ![The 10 Best CLI Tools for Codex in 2026](https://media.brightdata.com.br/2026/08/The-10-Best-CLI-Tools-for-Codex-in-2026.png) ](https://brightdata.com.br/blog/ai/best-cli-tools-for-codex "As 10 Melhores Ferramentas CLI para Codex em 2026 – Testadas & Classificadas")

 [AI


 ![Daniel Shashko](https://media.brightdata.com.br/2022/04/Daniel-Shashko-2-50x50.png)

Daniel Shashko

Web Data &amp; AI Expert


### As 10 Melhores Ferramentas CLI para Codex em 2026 – Testadas &amp; Classificadas

As 10 ferramentas CLI que tornam o Codex mais rápido e capaz, começando com o Bright Data CLI para acesso real à web de dentro do sandbox.


 06-Sep-2026

 24 min de leitura

 ](https://brightdata.com.br/blog/ai/best-cli-tools-for-codex)
