---
title: "Servidores proxy Rust: como configurar Proxy no Rust"
slug: rust-proxy-servers
date: 2026-02-22T07:23:55+00:00
modified: 2026-02-22T07:23:57+00:00
permalink: https://brightdata.com.br/blog/procedimentos/rust-proxy-servers
type: blog
---
[ Blog ](https://brightdata.com.br/blog "Blog") / [procedimentos](https://brightdata.com.br/blog/procedimentos)
[procedimentos](https://brightdata.com.br/blog/procedimentos)
# Servidores proxy Rust: como configurar Proxy no Rust
Aprenda a configurar um Proxy no Rust com este guia conciso. Perfeito para iniciantes e desenvolvedores experientes, este tutorial fornece instruções passo a passo para integrar Proxies em suas aplicações Rust.
15 min de leitura
[  ](https://brightdata.com/blog/authors/kumar-harsh)
[Kumar Harsh
February 22, 2026
](https://brightdata.com/blog/authors/kumar-harsh)

Se você já faz Scraping de dados há algum tempo, pode ter se deparado com um site bloqueado por uma geofence ou um banimento de IP. Os servidores Proxy ajudam a navegar nessas situações, mascarando sua verdadeira identidade e concedendo acesso a recursos proibidos.
Os servidores Proxy[Rust](https://www.rust-lang.org/) facilitam o seguinte:
- **Evite proibições de IP:** um novo Proxy permite que você contorne a proibição e retome a coleta.
- **Contornar bloqueios geográficos:** se você estiver interessado em conteúdo de outro país, um Proxy local concede a você cidadania online temporária, tornando o conteúdo restrito acessível.
- **Abrace o anonimato:** um servidor Proxy oculta seu endereço IP real, protegendo sua privacidade de olhares curiosos.
E isso é apenas a ponta do iceberg! As poderosas bibliotecas e a sintaxe robusta do Rust tornam a configuração e o gerenciamento de proxies uma tarefa fácil. Neste artigo, você aprenderá tudo sobre servidores Proxy e como usar um servidor Proxy no Rust para Scraping de dados.
## Usando um Proxy no Rust
Antes de usar um Proxy no Rust, você precisa configurar um. Neste tutorial, você configurará um Proxy em um servidor Nginx em sua máquina local e o usará para enviar solicitações de scraping para uma sandbox de scraping (como ) a partir de um binário Rust.
Comece [instalando o Nginx](https://www.nginx.com/resources/wiki/start/topics/tutorials/install/) em seu sistema local. Para Linux, você pode instalá-lo usando o Homebrew com o seguinte comando:
```none
sudo apt install nginx
```
Em seguida, inicie o servidor com o seguinte comando:
```none
nginx
```
Em seguida, você precisa configurar o servidor para atuar como um Proxy para determinados locais. Por exemplo, você pode configurá-lo para funcionar como um Proxy para o local `/` e adicionar um cabeçalho (*ou seja,* `X-Proxy-Server`) a cada solicitação que ele processa. Para fazer isso, você precisa editar o arquivo `nginx.conf`.
A localização do arquivo difere de acordo com o sistema operacional do seu host. Consulte a [documentação do Nginx](https://nginx.org/en/docs/beginners_guide.html#:~:text=By%20default%2C%20the%20configuration%20file%20is%20named%20nginx.conf%20and%20placed%20in%20the%20directory%20/usr/local/nginx/conf%2C%20/etc/nginx%2C%20or%20/usr/local/etc/nginx.) para obter ajuda. No Linux, você pode encontrar `o nginx.conf` em` /etc/nginx/nginx.conf`. Abra-o e adicione o seguinte bloco de código ao objeto `http.server` no arquivo:
```none
http {
server {
# Adicione o seguinte bloco
location / {
resolver 8.8.8.8;
Proxy_Pass http://$http_host$request_uri;
Proxy_Set_Header 'X-Proxy-Server' 'Nginx';
}
}
}
```
Isso configura o Proxy para encaminhar todas as solicitações recebidas para a URL original, adicionando um cabeçalho à solicitação. Se você tivesse acesso aos logs no servidor de destino, poderia verificar esse cabeçalho para confirmar se a solicitação veio através do Proxy ou diretamente do cliente.
Agora, execute o seguinte comando para reiniciar o servidor Nginx:
```none
nginx -s reload
```
Este servidor agora está pronto para ser usado como um Proxy de encaminhamento para scraping.
### Criando um projeto de Scraping de dados em Rust
Para configurar um novo projeto de scraping, crie um novo binário Rust usando [o Cargo](https://doc.rust-lang.org/cargo/), executando o seguinte comando:
```none
cargo new rust-scraper
```
Depois que o projeto for criado, você precisará adicionar três crates. Para começar, adicione `reqwest` e `Scraper`. Você usa `reqwest` para enviar solicitações ao recurso de destino e `Scraper` para extrair os dados necessários do HTML recebido por `reqwest`. Em seguida, adicione o terceiro crate, `tokio`, para lidar com chamadas de rede assíncronas por meio `do reqwest`.
Para instalá-los, execute o seguinte comando dentro do diretório do projeto:
```none
cargo add Scraper reqwest tokio --features "reqwest/blocking tokio/full"
```
Em seguida, abra o arquivo `src/main.rs` e adicione o seguinte código:
```none
use reqwest;
use std::error::Error;
#[tokio::main]
async fn main() -> Result<(), Box>{
let url = "http://books.toscrape.com/";
let client = reqwest::Client::new();
let response = client
.get(url)
.send()
.await?;
let html_content = response.text().await?;
extract_products(&html_content);
Ok(())
}
fn extract_products(html_content: &str) {
let document = Scraper::Html::parse_document(&html_content);
let html_product_selector = Scraper::Selector::parse("article.product_pod").unwrap();
let html_products = document.select(&html_product_selector);
let mut products: Vec = Vec::new();
para html_product em html_products {
let url = html_product
.select(&Scraper::Selector::parse("a").unwrap())
.next()
.and_then(|a| a.value().attr("href"))
.map(str::to_owned);
let image = html_product
.select(&Scraper::Selector::parse("img").unwrap())
.next()
.and_then(|img| img.value().attr("src"))
.map(str::to_owned);
let name = html_product
.select(&Scraper::Selector::parse("h3").unwrap())
.next()
.map(|title| title.text().collect::());
let price = html_product
.select(&Scraper::Selector::parse(".price_color").unwrap())
.next()
.map(|price| price.text().collect::());
let product = Product {
url,
image,
name,
price,
};
products.push(product);
}
println!("{:?}", products);
}
#[derive(Debug)]
struct Product {
url: Option,
image: Option,
name: Option,
price: Option,
}
```
Este código usa o crate `reqwest` para criar um cliente e obter a página da web no URL `https://books.toscrape.com`. Em seguida, ele processa o HTML da página dentro de uma função chamada `extract_products` para extrair uma lista de produtos da página. A lógica de extração é implementada usando o crate `Scraper` e permanece inalterada, independentemente de você usar um Proxy ou não.
Agora, é hora de tentar executar este binário para ver se ele extrai a lista de produtos corretamente. Para fazer isso, execute o seguinte comando:
```none
cargo run
```
Você deve ver uma saída semelhante a esta no seu terminal:
```none
Concluído dev [não otimizado + debuginfo] alvo(s) em 0,80 s.
Executando `target/debug/rust_scraper`
[Produto { url: Some("catalogue/a-light-in-the-attic_1000/index.html"), image: Some("media/cache/2c/da/2cdad67c44b002e7ead0cc35693c0e8b.jpg"), name: Some("A Light in the ..."), price: Some("£51.77") }, Produto { url: Some("catalogue/tipping-the-velvet_999/index.html"), imagem: Some("media/cache/26/0c/260c6ae16bce31c8f8c95daddd9f4a1c.jpg"), nome: Some("Tipping the Velvet"), preço: Some("£53,74") }, Produto { url: Some("catalogue/soumission_998/index.html"), imagem: Some("media/cache/3e/ef/3eef99c9d9adef34639f510662022830.jpg"), nome: Some("Soumission"), preço: Some("£50,10") }, Produto { url: Some("catalogue/sharp-objects_997/index.html"), imagem: Some("media/cache/32/51/3251cf3a3412f53f339e42cac2134093.jpg"), nome: Some("Objetos Afiados"), preço: Some("£47,82") }, Produto { url: Some("catalogue/sapiens-a-brief-history-of-humankind_996/index.html"), image: Some("media/cache/be/a5/bea5697f2534a2f86a3ef27b5a8c12a6.jpg"), nome: Some("Sapiens: Uma Breve História ..."), preço: Some("£54,23") }, Produto { url: Some("catalogue/the-requiem-red_995/index.html"), image: Some("media/cache/68/33/68339b4c9bc034267e1da611ab3b34f8.jpg"), name: Some("The Requiem Red"), price: Some("£22,65") }, Produto { url: Some("catalogue/the-dirty-little-secrets-of-getting-your-dream-job_994/index.html"), imagem: Some("media/cache/92/27/92274a95b7c251fea59a2b8a78275ab4.jpg"), nome: Some("Os Pequenos Segredos Sujos ..."), preço: Some("£33,34") }, Produto { url: Alguns("catálogo/a-mulher-que-está-por-vir-um-romance-baseado-na-vida-da-infame-feminista-victoria-woodhull_993/index.html"), imagem: Some("media/cache/3d/54/3d54940e57e662c4dd1f3ff00c78cc64.jpg"), nome: Some("A Mulher que Chega: Um ..."), preço: Some("£17,93") }, Produto { url: Alguns("catalogue/the-boys-in-the-boat-nine-americans-and-their-epic-quest-for-gold-at-the-1936-berlin-olympics_992/index.html"), imagem: Some("media/cache/66/88/66883b91f6804b2323c8369331cb7dd1.jpg"), nome: Some("Os Meninos no ..."), preço: Some("£22,60") }, Produto { url: Alguns("catalogue/the-black-maria_991/index.html"), imagem: Alguns("media/cache/58/46/5846057e28022268153beff6d352b06c.jpg"), nome: Alguns("The Black Maria"), preço: Some("£52,15") }, Produto { url: Some("catalogue/starving-hearts-triangular-trade-trilogy-1_990/index.html"), imagem: Some("media/cache/be/f4/bef44da28c98f905a3ebec0b87be8530.jpg"), nome: Some("Starving Hearts (Triangular Trade ..."), preço: Some("£13,99") }, Produto { url: Some("catalogue/shakespeares-sonnets_989/index.html"), image: Some("media/cache/10/48/1048f63d3b5061cd2f424d20b3f9b666.jpg"), name: Some("Shakespeare's Sonnets"), price: Some("£20,66") }, Produto { url: Some("catalogue/set-me-free_988/index.html"), imagem: Some("media/cache/5b/88/5b88c52633f53cacf162c15f4f823153.jpg"), nome: Some("Set Me Free"), preço: Some("£17,46") }, Produto { url: Some("catalogue/scott-pilgrims-precious-little-life-scott-pilgrim-1_987/index.html"), image: Some("media/cache/94/b1/94b1b8b244bce9677c2f29ccc890d4d2.jpg"), nome: Some("Scott Pilgrim's Precious Little ..."), preço: Some("£52,29") }, Produto { url: Some("catalogue/rip-it-up-and-start-again_986/index.html"), image: Some("media/cache/81/c4/81c4a973364e17d01f217e1188253d5e.jpg"), name: Some("Rip it Up and ..."), price: Some("£35,02") }, Produto { url: Some("catalogue/our-band-could-be-your-life-scenes-from-the-american-indie-underground-1981-1991_985/index.html"), imagem: Some("media/cache/54/60/54607fe8945897cdcced0044103b10b6.jpg"), nome: Some("Our Band Could Be ..."), preço: Some("£57,25") }, Produto { url: Alguns("catalogue/olio_984/index.html"), imagem: Alguns("media/cache/55/33/553310a7162dfbc2c6d19a84da0df9e1.jpg"), nome: Alguns("Olio"), preço: Alguns("£23,88") }, Produto { url: Some("catalogue/mesaerion-the-best-science-fiction-stories-1800-1849_983/index.html"), image: Some("media/cache/09/a3/09a3aef48557576e1a85ba7efea8ecb7.jpg"), nome: Some("Mesaerion: The Best Science ..."), preço: Some("£37,59") }, Produto { url: Alguns("catalogue/libertarianism-for-beginners_982/index.html"), imagem: Alguns("media/cache/0b/bc/0bbcd0a6f4bcd81ccb1049a52736406e.jpg"), nome: Alguns("Libertarianismo para Iniciantes"), preço: Some("£51,33") }, Produto { url: Some("catalogue/its-only-the-himalayas_981/index.html"), image: Some("media/cache/27/a5/27a53d0bb95bdd88288eaf66c9230d7e.jpg"), nome: Some("É só o Himalaia"), preço: Some("£45,17") }]
```
Isso significa que a lógica de scraping funciona corretamente. Agora, você está pronto para adicionar seu Proxy Nginx a este Scraper.
### Utilizando seu Proxy
Você notará que a solicitação de scraping é enviada por meio de um cliente `reqwest` completo na função `main()` (em vez de usar uma chamada `get` única). Isso significa que você pode configurar facilmente um Proxy ao criar o cliente.
Para configurar o cliente, atualize a seguinte linha de código:
```none
async fn main() -> Result<(), Box>{
let url = "https://books.toscrape.com/";
# Substitua esta linha
let client = reqwest::Client::new();
# Por esta
let client = reqwest::Client::builder()
.Proxy(reqwest::Proxy::https("http://localhost:8080")?)
.build()?;
//...
Ok(())
}
```
> Ao configurar o Proxy usando `o reqwest`, é importante entender que alguns provedores de Proxy (incluindo o Bright Data) funcionam com configurações `http` e `https`, mas podem exigir alguma configuração extra. Se você enfrentar problemas ao usar `https`, tente mudar para `http` para executar o aplicativo.
Agora, tente executar o binário novamente usando o comando `cargo run`. Você deve receber uma resposta semelhante à anterior. No entanto, certifique-se de verificar os logs do seu servidor Nginx para ver se uma solicitação foi Proxy através dele.
Localize [os logs do](https://docs.nginx.com/nginx/admin-guide/monitoring/logging/) seu [servidor Nginx](https://docs.nginx.com/nginx/admin-guide/monitoring/logging/) com base nas instruções do seu sistema operacional. Para uma instalação baseada em Homebrew no Mac, os arquivos de log de acesso e erros estão na pasta `/opt/homebrew/var/log/nginx`. Abra o arquivo `access.log` e você deverá ver uma linha como esta na parte inferior do arquivo:
```none
127.0.0.1 - - [07/Jan/2024:05:19:54 +0530] "GET https://books.toscrape.com/ HTTP/1.1" 200 18 "-" "-"
```
Isso indica que a solicitação foi encaminhada pelo servidor Nginx por meio de Proxy. Agora, você pode configurar o servidor em um host remoto para usá-lo para contornar restrições geográficas ou bloqueios de IP.
### Proxy rotativo
Ao trabalhar em projetos de Scraping de dados, talvez seja necessário alternar entre um conjunto de proxies. Isso permite distribuir sua carga de trabalho de scraping entre vários IPs e evitar ser detectado devido ao alto tráfego de uma única fonte ou localização.
Para implementar Proxy rotativo, você precisa adicionar as seguintes funções ao seu arquivo `main.rs`:
```none
#[derive(Debug)]
struct Proxy {
ip: String,
port: String,
}
fn get_proxies() -> Vec {
let mut proxies = Vec::new();
proxies.push(Proxy {
ip: "http://localhost".to_string(),
port: "8082".to_string(),
});
// Adicione mais instruções proxies.push aqui para criar um conjunto maior de proxies.
proxies
}
```
Isso ajuda a definir o conjunto de Proxies facilmente. Em seguida, é necessário atualizar a função `principal` desta forma para utilizar um Proxy aleatório:
```none
#[tokio::main]
async fn main() -> Result<(), Box> {
let url = "https://books.toscrape.com/";
// Adicione estas duas linhas
let proxies = get_proxies();
let random_proxy = proxies.choose(&mut rand::thread_rng()).unwrap();
let client = reqwest::Client::builder()
// Atualize a linha a seguir para corresponder a esta
.proxy(reqwest::Proxy::http(format!("{0}:{1}", random_proxy.ip, random_proxy.port))?)
.build()?;
// O restante permanece igual
let response = client
.get(url)
.send()
.await?;
let html_content = response.text().await?;
extract_products(&html_content);
Ok(())
}
```
Agora, você precisa instalar o crate `rand` para poder randomizar a escolha de um Proxy a partir da matriz de Proxies. Você pode fazer isso executando o seguinte comando:
```none
cargo add rand
```
Em seguida, adicione a seguinte linha no topo do seu arquivo `main.rs` para importar o crate `rand`:
```none
use rand::seq::SliceRandom;
```
Agora, tente executar o binário novamente para ver se funciona usando o comando `cargo run`. Ele deve imprimir a mesma saída de antes, indicando que a lista de Proxies aleatórios está configurada corretamente.
## Servidor Proxy Bright Data
Como você viu, configurar manualmente um Proxy pode dar muito trabalho. Além disso, você precisa hospedar o servidor Proxy em um servidor remoto para poder aproveitar todos os benefícios de um novo endereço IP e localização. Se você quiser evitar todo esse trabalho, considere usar um dos[servidores Proxy](/proxy-types/residential-proxies) da[Bright Data](/proxy-types/residential-proxies).
Embora existam inúmeros provedores de proxy, a Bright Data é conhecida por sua escala e flexibilidade. Com a Bright Data, você obtém uma rede extensa de 400M+ monthly Proxies residenciais, móveis, de data center e ISP espalhados por 195 países. Com seu grande número de Proxies residenciais, você pode segmentar países, cidades ou até mesmo operadoras de celular específicas para uma coleta de dados altamente focada.
Além disso, os proxies residenciais da Bright Data se misturam perfeitamente com o tráfego real dos usuários, enquanto as opções de data center e móveis oferecem velocidade incrível e conexões confiáveis. A rotação automática da Bright Data mantém sua coleta ágil, minimizando o risco de detecção e bloqueios.
Para experimentar, acesse [https://brightdata.com/](/) e clique em **Teste grátis** no canto superior direito. Depois de se inscrever, você será direcionado para a página **Painel de controle**:
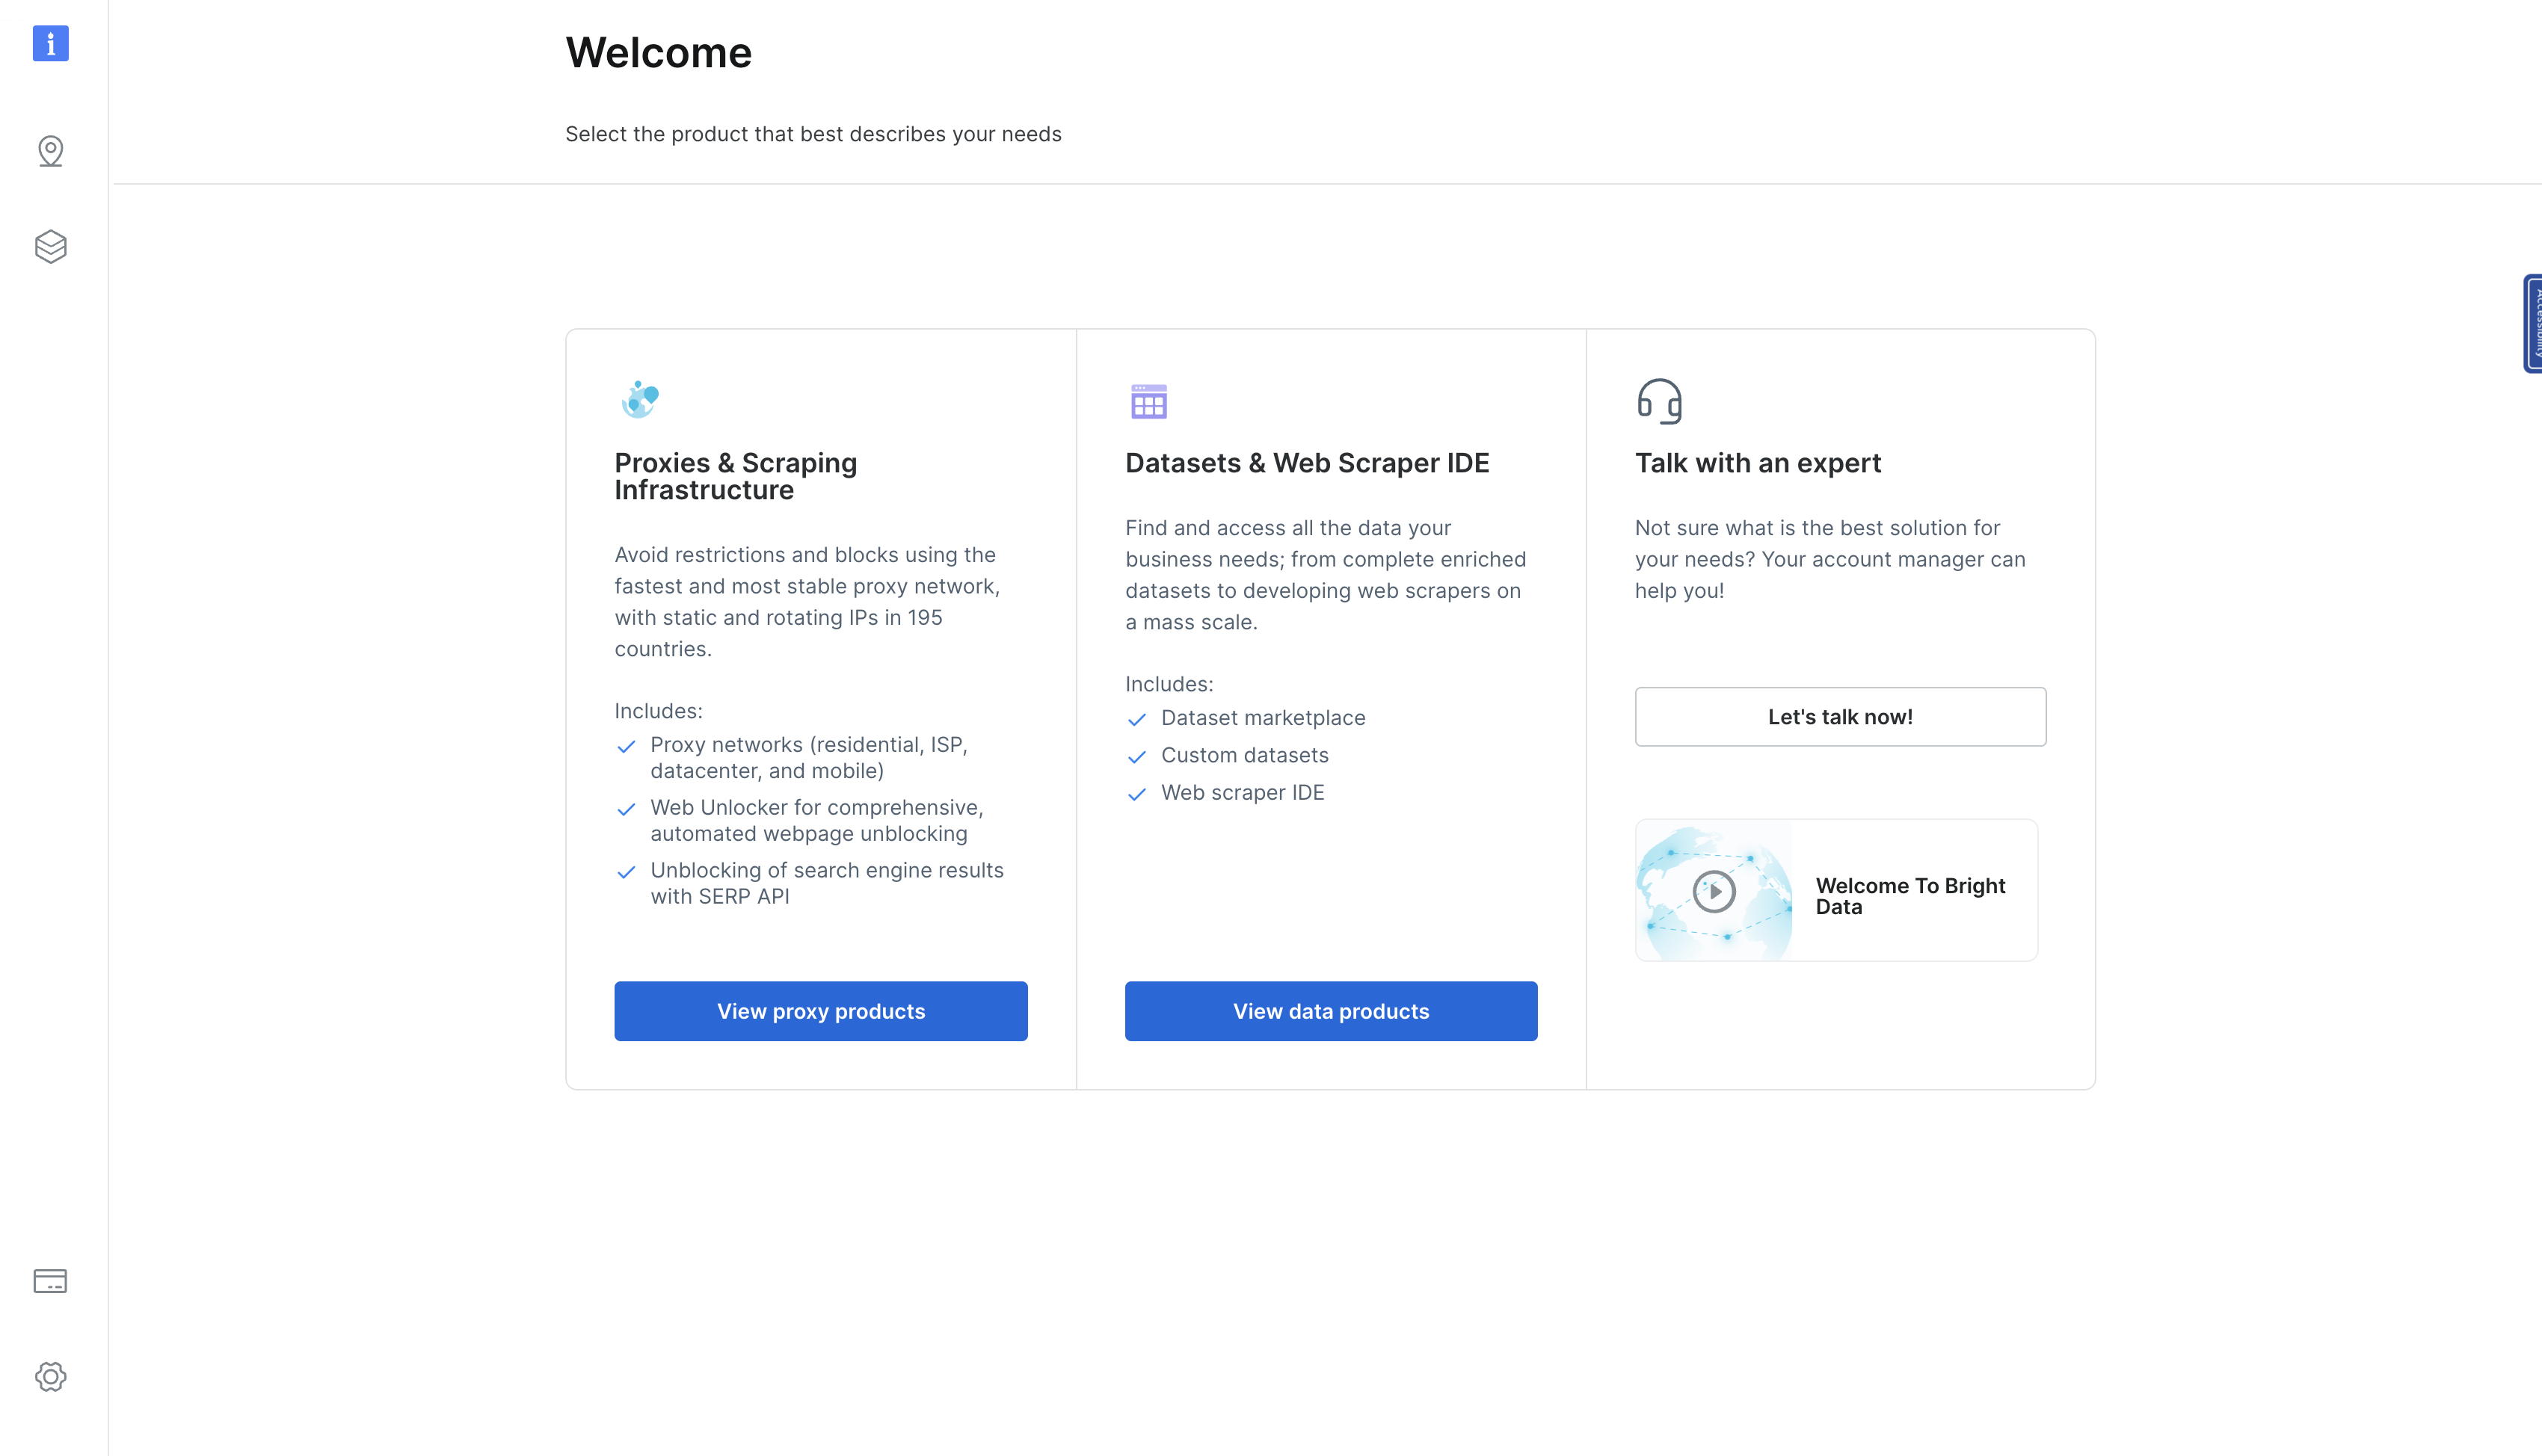Nessa página, clique em **“Ver produtos Proxy** ” para navegar até a página **“Proxies e Infraestrutura de scraping** ”:
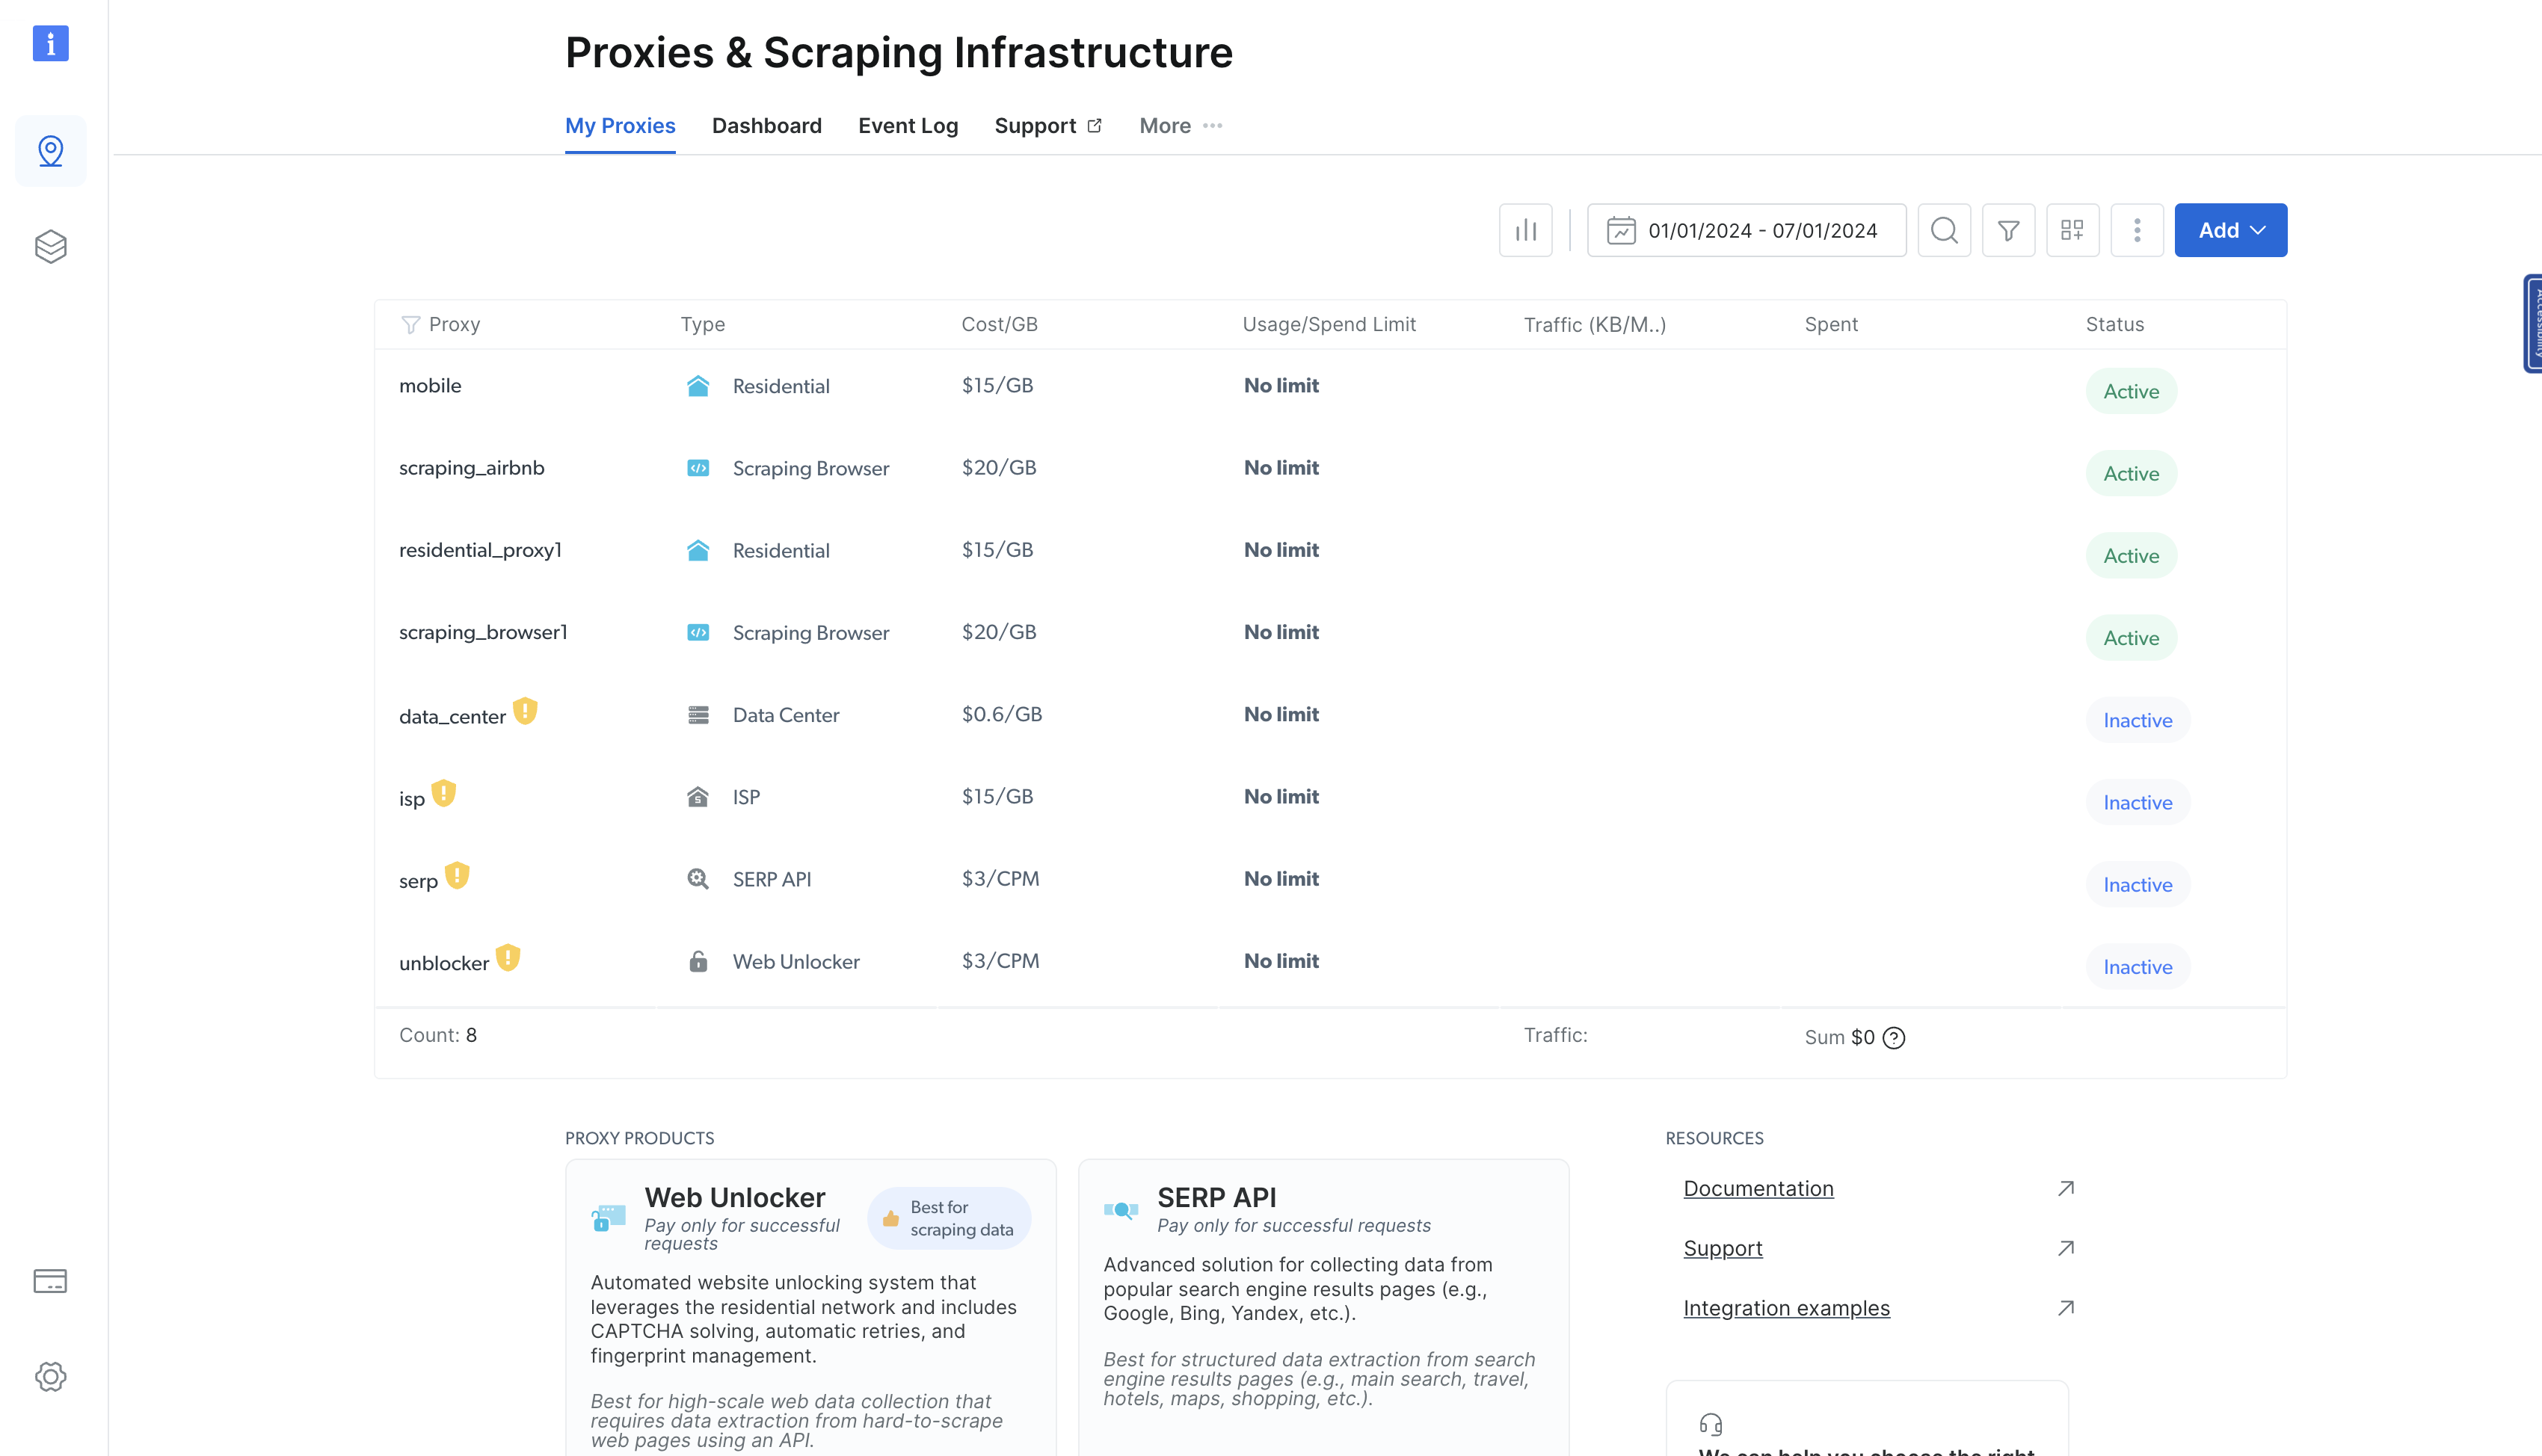Esta página lista todos os proxies que você provisionou anteriormente. Para adicionar um proxy, clique no botão azul **Adicionar** no canto superior direito e escolha **Proxies residenciais**:
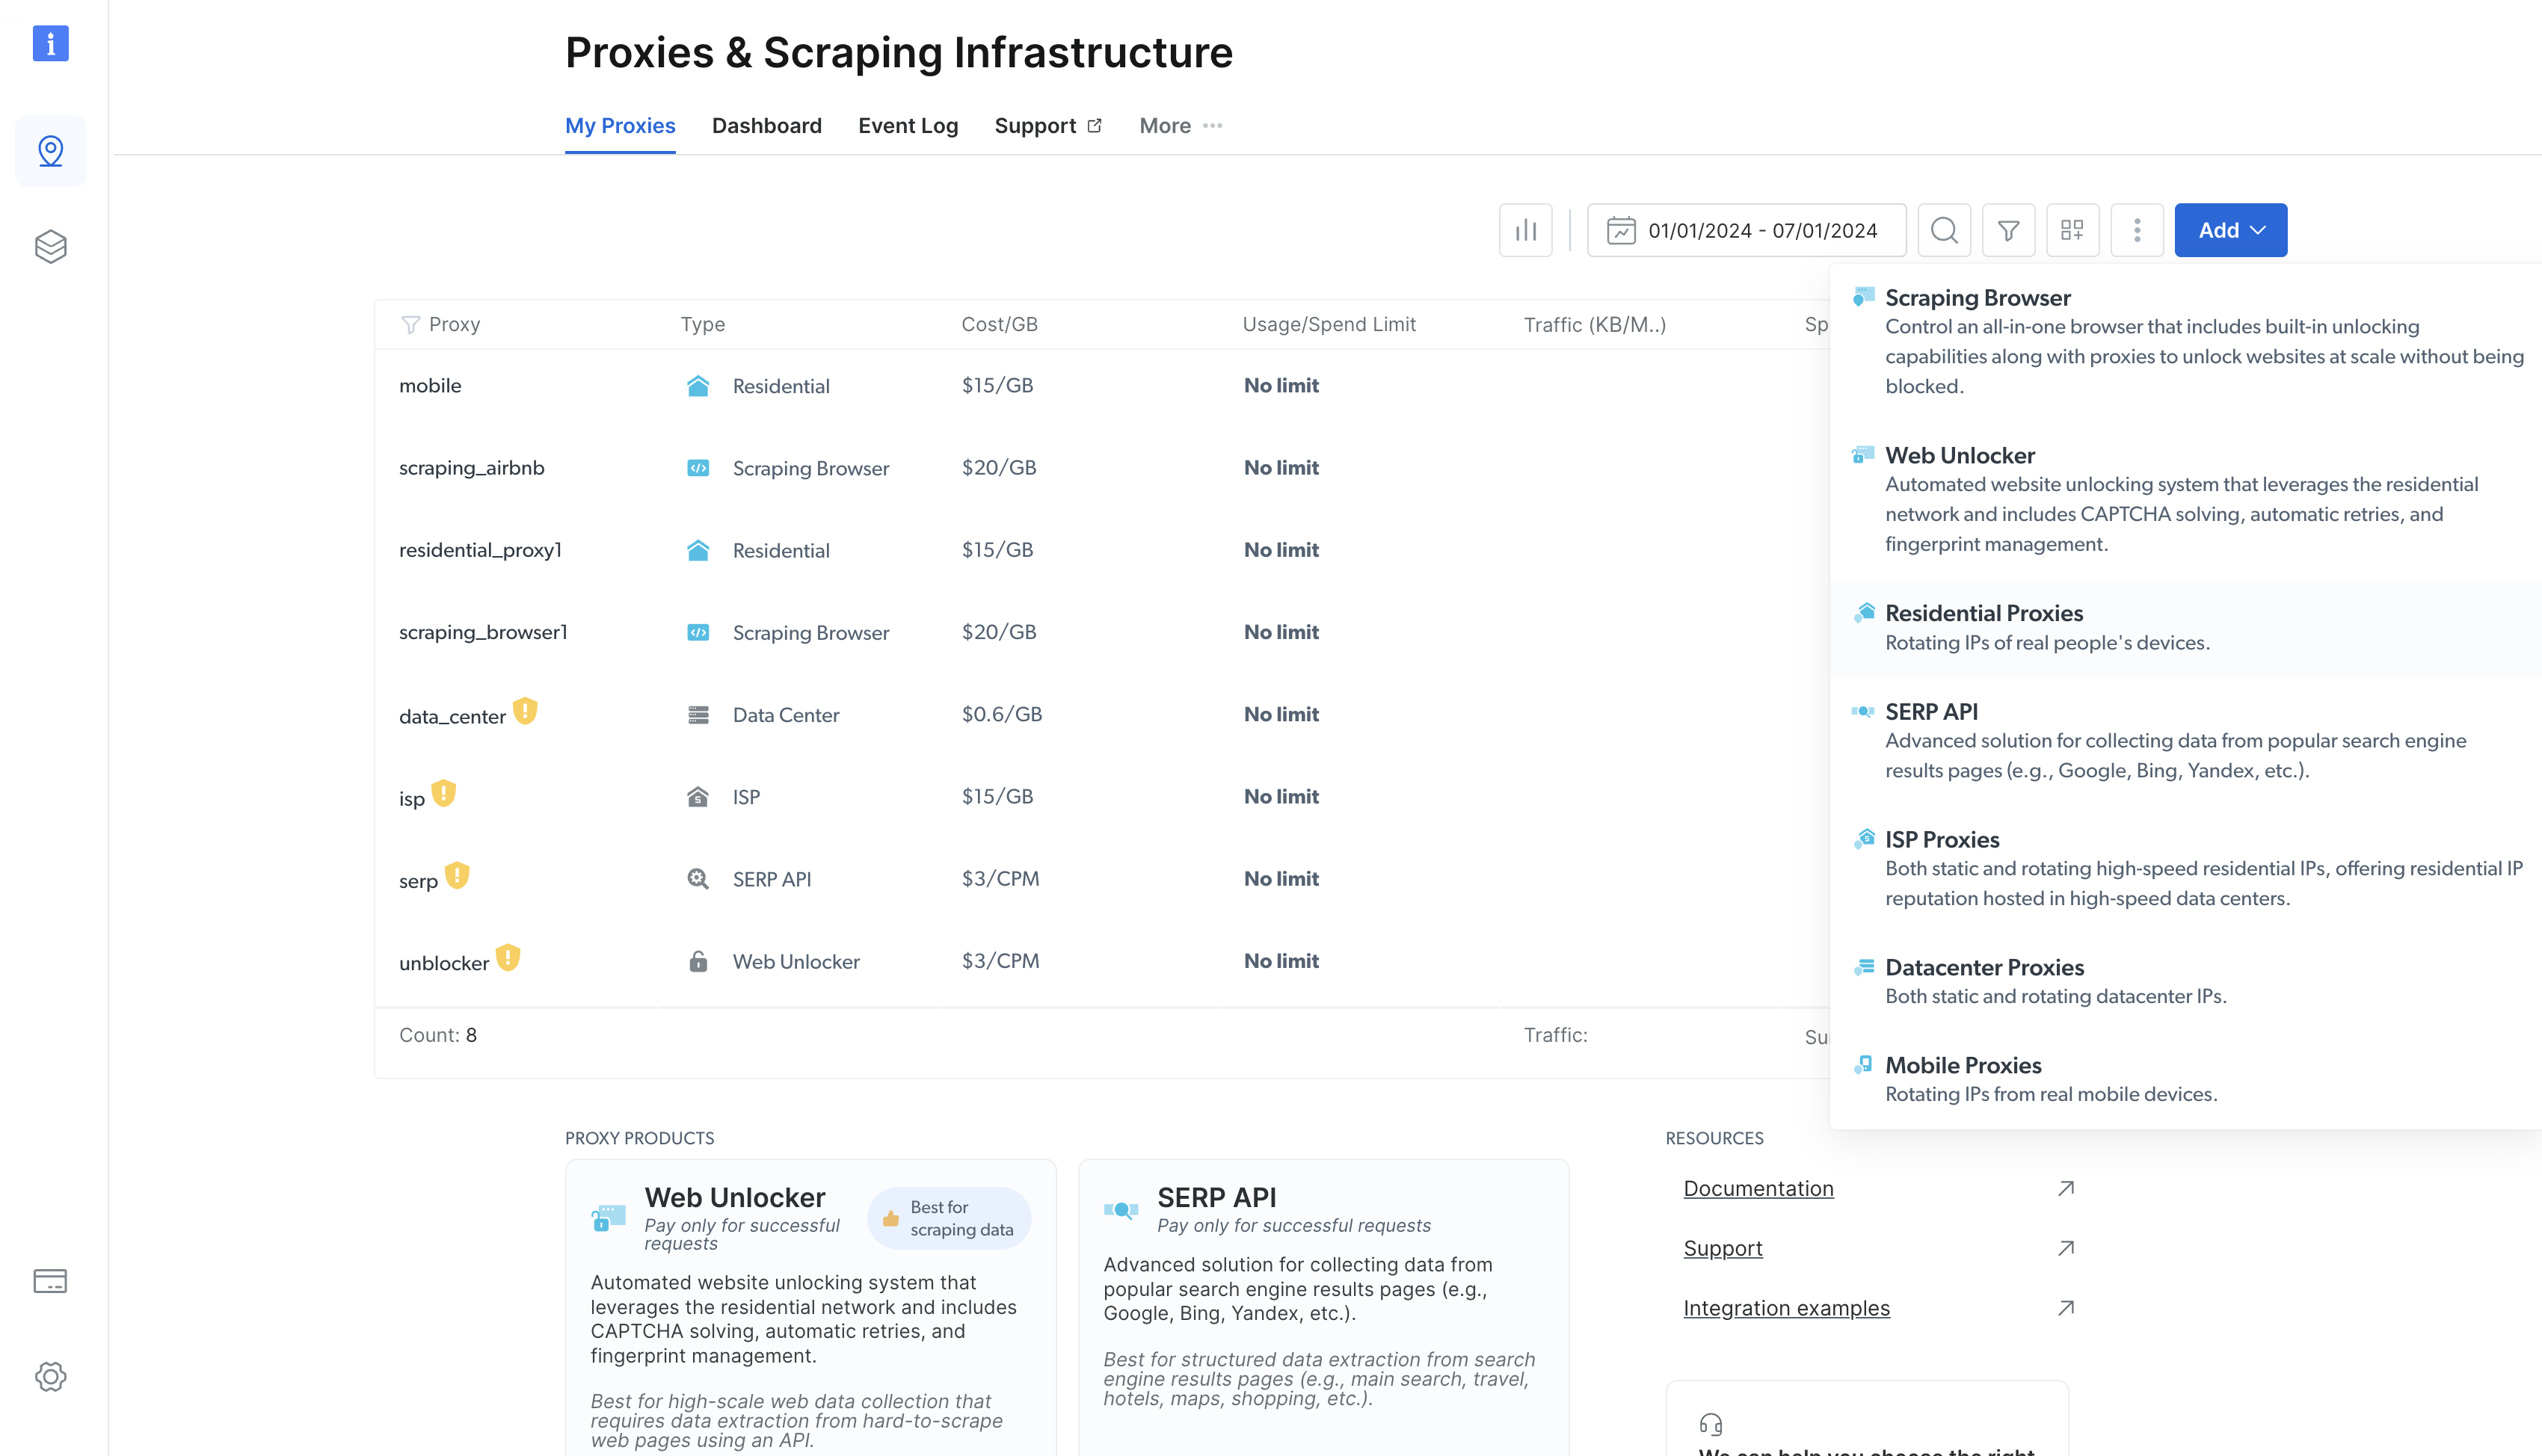Em seguida, um formulário será exibido para você configurar seu novo Proxy residencial. Deixe as opções padrão, role até a parte inferior da página e clique em **Adicionar**.
Depois que o Proxy residencial for criado, você será direcionado para uma página que mostra os detalhes do Proxy recém-criado. Clique na guia **Parâmetros de acesso** para visualizar o host, o nome de usuário e a senha do Proxy:
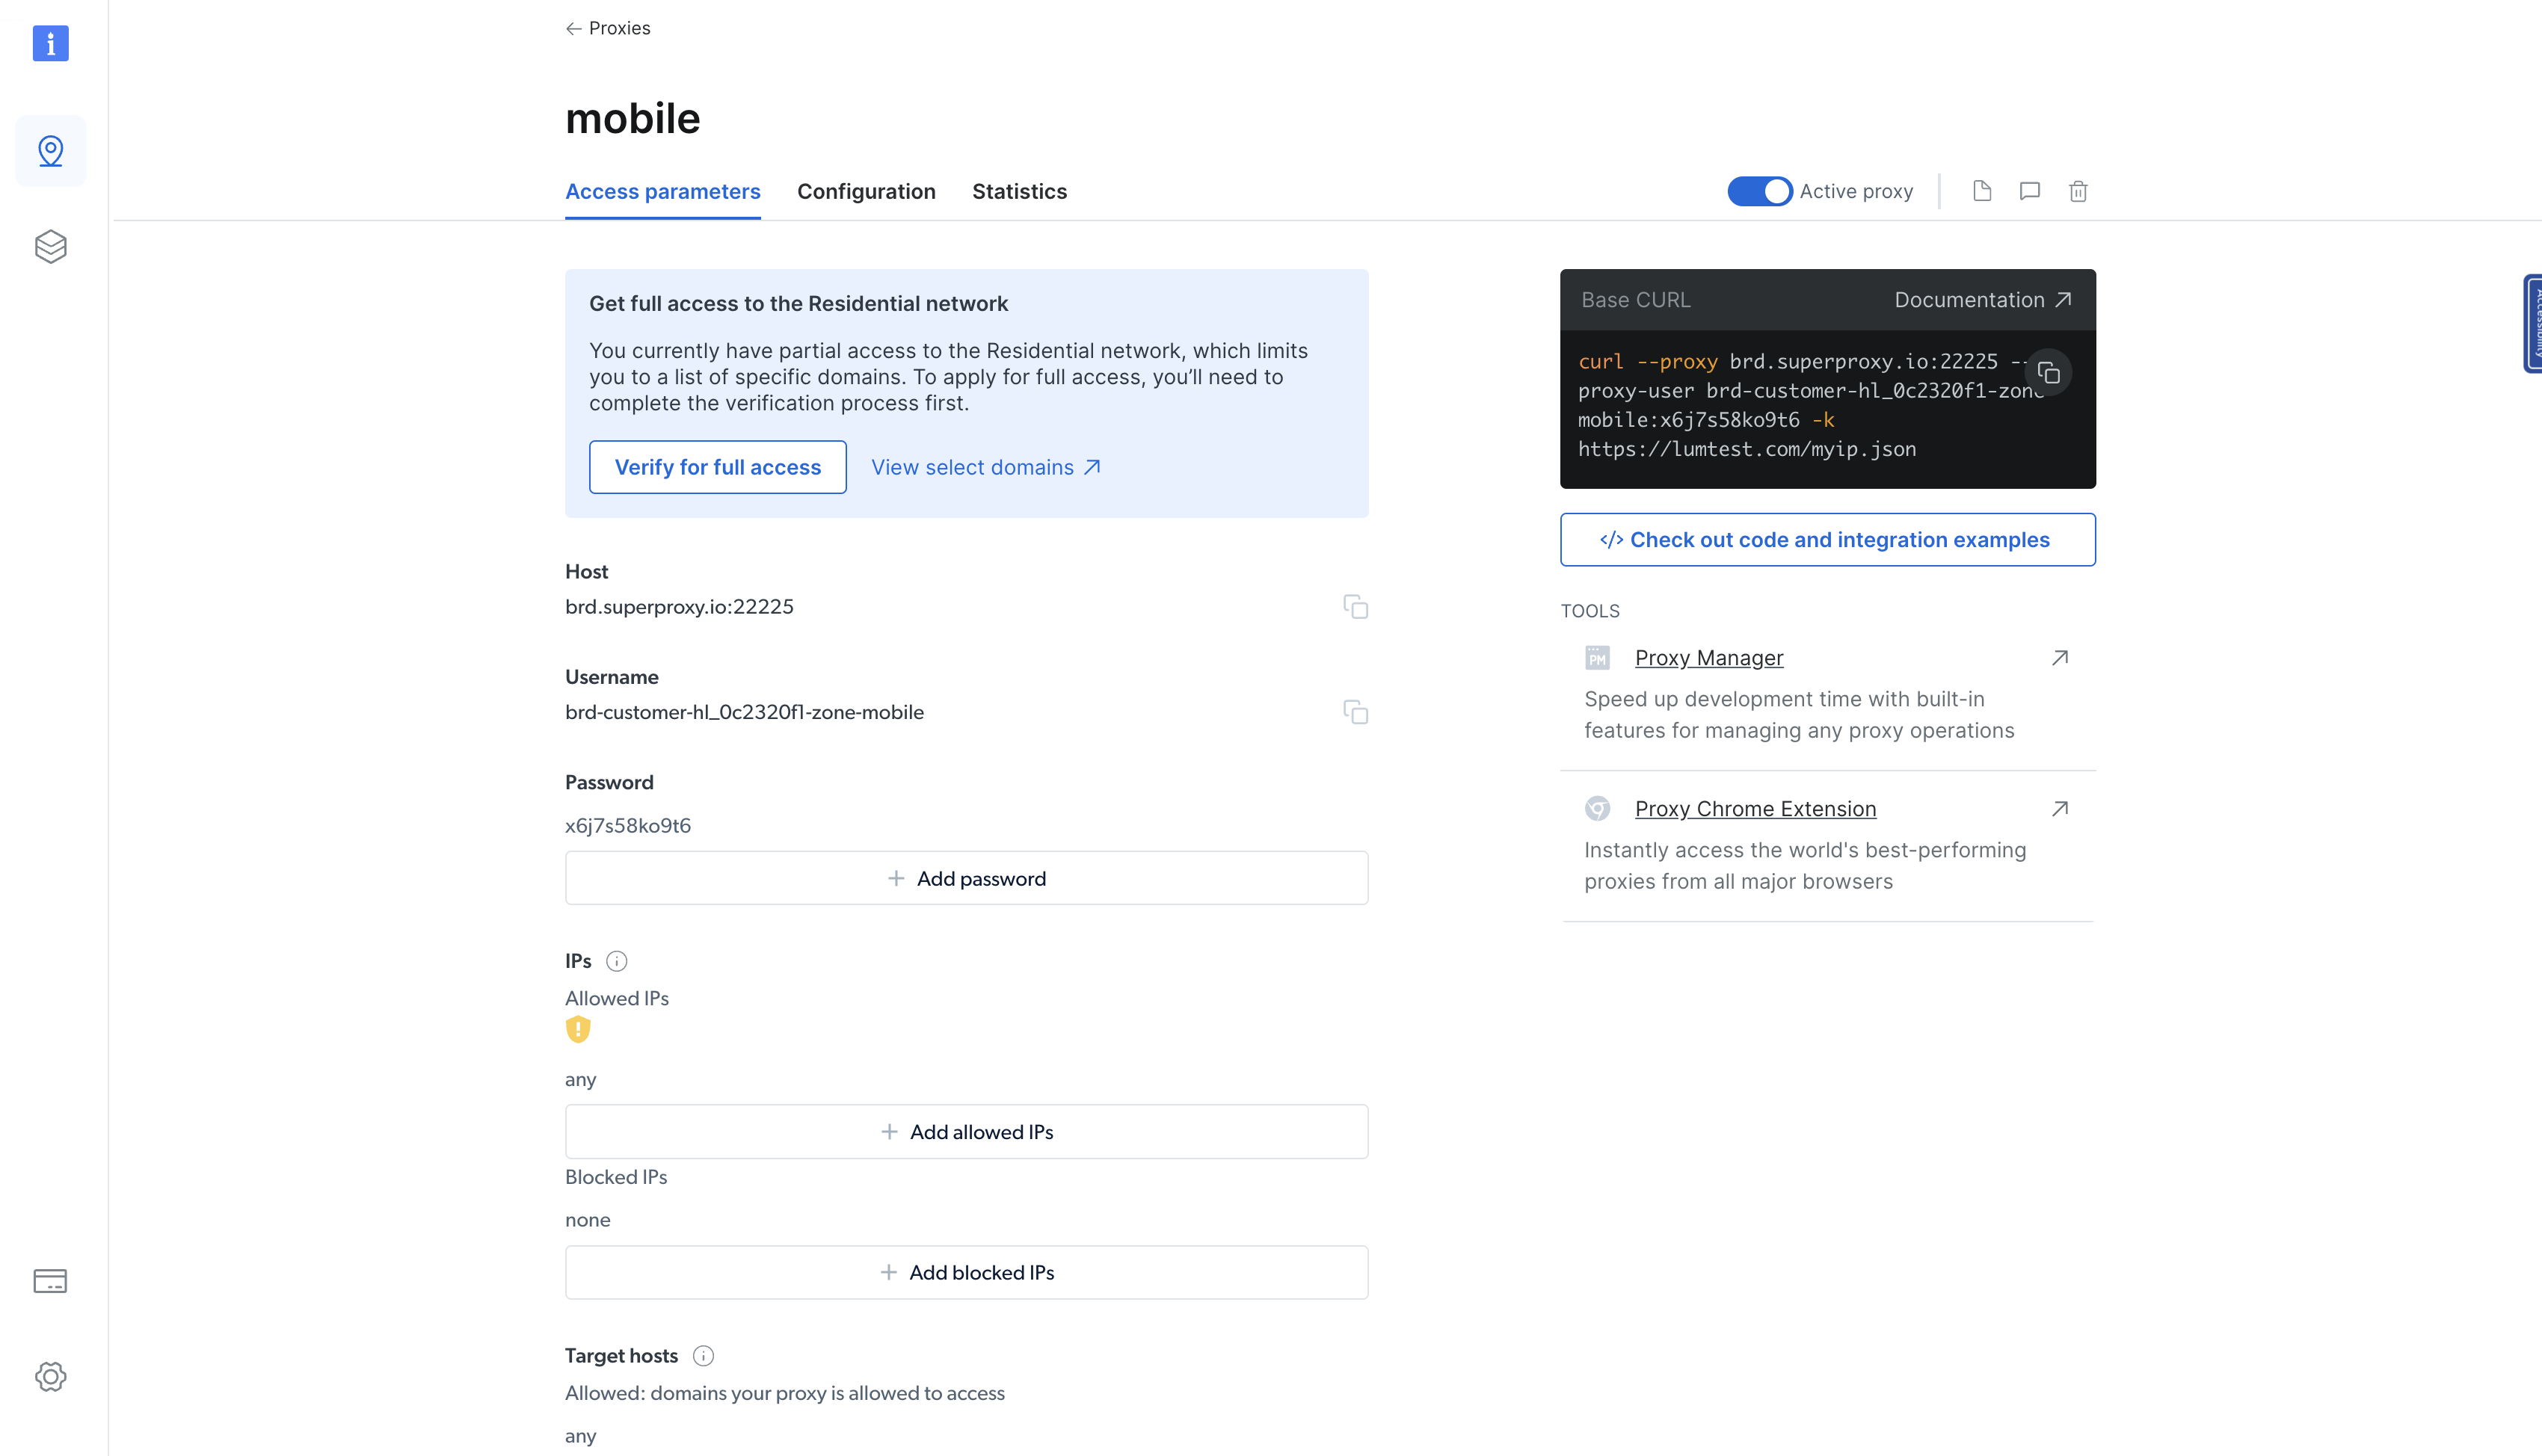Você pode usar esses parâmetros para integrar o Proxy ao seu binário Rust. Para fazer isso, atualize a função `main()` no arquivo `src/main.rs` desta forma:
```none
#[tokio::main]
async fn main() -> Result<(), Box> {
let url = "https://books.toscrape.com/";
// Atualize o bloco a seguir com os detalhes da página de detalhes do Proxy Bright Data
let client = reqwest::Client::builder()
.proxy(reqwest::Proxy::http("")?
.basic_auth("", ""))
.build()?;
// O restante permanece igual
let response = client
.get(url)
.send()
.await?;
let html_content = response.text().await?;
extract_products(&html_content);
Ok(())
}
```
Em seguida, tente executar o binário novamente. Ele deve retornar a resposta corretamente, como antes. A única diferença importante aqui é que a solicitação está sendo Proxyada através do Bright Data, ocultando sua identidade e localização real.
Você pode confirmar isso enviando uma solicitação para uma API que exibe o endereço IP do cliente usando o seguinte trecho de código:
```none
use reqwest;
use std::error::Error;
#[tokio::main]
async fn main() -> Result<(), Box> {
let url = "http://lumtest.com/myip.json";
// Atualize o bloco a seguir com os detalhes da página de detalhes do Proxy Bright Data
let client = reqwest::Client::builder()
.proxy(reqwest::Proxy::http("")?
.basic_auth("", ""))
.build()?;
// O restante permanece igual
let response = client
.get(url)
.send()
.await?;
let html_content = response.text().await?;
println!("{:?}", html_content);
Ok(())
}
```
Ao executar o código usando o comando `cargo run`, você deverá ver uma saída semelhante a esta:
```none
"{"ip":"209.169.64.172","country":"US","asn":{"asnum":6300,"org_name":"CCI-TEXAS"},"geo":{"city":"Conroe","region":"TX","region_name":"Texas","postal_code":"77304","latitude":30.3228,"longitude":-95.5298,"tz":"America/Chicago","lum_city":"conroe","lum_region":"tx"}}"
```
Isso refletirá o IP e os detalhes de localização do Proxy que você está usando para consultar a página.
## Conclusão
Neste artigo, você aprendeu como usar proxies com Rust. Lembre-se de que os proxies são como máscaras digitais, permitindo que você ultrapasse as restrições online e veja o que está por trás das restrições dos sites. Eles também permitem que você mantenha seu anonimato ao navegar na web.
No entanto, configurar um Proxy por conta própria é um processo complexo. Geralmente, é recomendável optar por um provedor de Proxy estabelecido, como[a Bright Data](/), que oferece um Pool de proxies fáceis de usar.
[Repositório GitHub](https://github.com/luminati-io/proxy-scrape-rust)
Contate-nosTeste grátis
Índice
Dedicated Scraper APIs & No-Code Scrapers
Over 1000 scrapers for all popular domains. Simplify your web scraping.
[See pricing](/pricing/web-scraper "See pricing")
Just want data? Skip scraping.
Hundreds of ready-to-use datasets from all popular domains.
[See pricing](/pricing/datasets "See pricing")
[ ](https://news.ycombinator.com/submitlink?t=Servidores+proxy+Rust%3A+como+configurar+Proxy+no+Rust&u=https://brightdata.com.br/blog/procedimentos/rust-proxy-servers) [ ](https://www.linkedin.com/shareArticle?mini=true&title=Servidores+proxy+Rust%3A+como+configurar+Proxy+no+Rust&url=https://brightdata.com.br/blog/procedimentos/rust-proxy-servers) [ ](http://www.reddit.com/submit?title=Servidores+proxy+Rust%3A+como+configurar+Proxy+no+Rust&url=https://brightdata.com.br/blog/procedimentos/rust-proxy-servers)
## Você também pode estar interessado em
[  ](https://brightdata.com.br/blog/proxies-101/how-to-bypass-an-ip-ban "Como Contornar um Banimento de IP: 7 Métodos Comprovados (Guia 2026)")
[Proxy 101

Aviv Besinsky
### Como Contornar um Banimento de IP: 7 Métodos Comprovados (Guia 2026)
Aprenda 7 métodos comprovados para contornar banimentos de IP, desde proxies residenciais (95-99% de sucesso) até VPNs e rotação de IP.
13-May-2025
28 min de leitura
](https://brightdata.com.br/blog/proxies-101/how-to-bypass-an-ip-ban)
[  ](https://brightdata.com.br/blog/procedimentos/parse-json-data-with-python "Como analisar JSON em Python")
[procedimentos

Antonello Zanini
Technical Writer
### Como analisar JSON em Python
Aqui vamos guiá-lo através do processo de importação de json e usá-lo para analisar JSON em Python, com uma útil tabela de transformação JSON-Python. Quer seja um programador de Python experiente ou esteja apenas a começar, este tutorial passo-a-passo ensina como analisar JSON como um profissional!
09-May-2022
12 min de leitura
](https://brightdata.com.br/blog/procedimentos/parse-json-data-with-python)
[  ](https://brightdata.com.br/blog/ai/openhuman-with-bright-data "Acesso à Web Pronto para Produção no OpenHuman Através do Bright Data CLI")
[AI

Antonello Zanini
Technical Writer
### Acesso à Web Pronto para Produção no OpenHuman Através do Bright Data CLI
Integre o Bright Data CLI ao OpenHuman para habilitar acesso à web pronto para produção e coleta de dados para agentes de IA.
09-Sep-2026
14 min de leitura
](https://brightdata.com.br/blog/ai/openhuman-with-bright-data)