---
title: "LLM Scraping de dados com ScrapeGraphAI"
slug: web-scraping-with-scrapegraphai
date: 2026-02-17T09:10:43+00:00
modified: 2026-02-17T09:10:44+00:00
permalink: https://brightdata.com.br/blog/dados-do-site/web-scraping-with-scrapegraphai
type: blog
---
[ Blog ](https://brightdata.com.br/blog "Blog") / [Dados do site](https://brightdata.com.br/blog/dados-do-site)
[Dados do site](https://brightdata.com.br/blog/dados-do-site)
# LLM Scraping de dados com ScrapeGraphAI
Saiba como o ScrapeGraphAI usa grandes modelos de linguagem para simplificar o Scraping de dados e automatizar a extração de dados.
11 min de leitura
[  ](https://brightdata.com/blog/authors/mmichael-nyamande)
[Michael Nyamande
](https://brightdata.com/blog/authors/mmichael-nyamande)

[O Scraping de dados da web](/blog/how-tos/what-is-web-scraping) geralmente envolve a escrita de códigos complexos e demorados, adaptados a layouts específicos de sites, que podem facilmente quebrar quando os sites mudam. [O ScrapeGraphAI](https://scrapegraphai.com/) utiliza grandes modelos de linguagem (LLMs) para extrair informações e interpretá-las como um ser humano faria, permitindo que você se concentre nos dados em vez do layout. A integração de LLMs com o ScrapeGraphAI aprimora a extração de dados, automatiza a agregação de conteúdo e permite a análise em tempo real.
Neste artigo, você aprenderá como usar o ScrapeGraphAI para Scraping de dados. Mas antes disso, vamos apresentar as soluções da Bright Data que podem economizar seu tempo e dinheiro.
## Soluções de Scraping de dados da Bright Data
A Bright Data oferece um conjunto abrangente de soluções de Scraping de dados, otimizadas para uma extração de dados eficiente, escalável e em conformidade:
- API de Web Scraper
- Conjuntos de datos prontos para uso
- Conjuntos de datos personalizados
Essas soluções permitem a coleta de dados rápida, precisa e escalável, perfeita para projetos de qualquer escopo, desde aplicações em pequena escala até necessidades em nível empresarial.
## Implementando LLM Scraping de dados com ScrapeGraphAI
Antes de iniciar este tutorial, você precisa dos seguintes pré-requisitos:
- [Python 3.x](https://www.python.org/downloads/) instalado.
- [Uma](https://platform.openai.com/signup) [conta](https://platform.openai.com/signup)[Ope](https://platform.openai.com/signup) [IA](https://platform.openai.com/signup). Este tutorial usa LLMs OpenAI para coletar dados com o ScrapeGraphAI. Embora seja possível usar outros modelos, como [Anthropic](https://ai.google.dev/), [Google](https://ai.google.dev/) ou modelos de código aberto, como [Llama](https://www.llama.com/) e [Mistral AI](https://mistral.ai/), este tutorial usa [o GPT-4](https://openai.com/index/gpt-4/) devido à sua popularidade e facilidade de configuração.
Se você não estiver familiarizado com o Scraping de dados da web em Python, confira este [tutorial sobre Scraping de dados da web](/blog/how-tos/web-scraping-with-python) para começar.
### Configure seu ambiente
A primeira coisa que você precisa fazer é criar um ambiente virtual. Abra seu terminal e navegue até o diretório do seu projeto:
```none
python -m venv venv
```
Em seguida, ative o ambiente virtual. No macOS e no Linux, você pode fazer isso com o seguinte comando:
```none
source venv/bin/activate
```
No Windows, você pode usar este comando:
```none
venvScriptsactivate
```
Depois de ativar o ambiente virtual, você precisa instalar o ScrapeGraphAI e suas dependências:
```none
pip install scrapegraphai
playwright install
```
O comando `playwright install` configura os navegadores necessários para Chromium, Firefox e WebKit.
Para gerenciar variáveis de ambiente com segurança, instale `python-dotenv`:
```none
pip install python-dotenv
```
É importante proteger informações confidenciais, como chaves API. Recomenda-se armazenar variáveis de ambiente em um arquivo `.env` para mantê-las separadas dos arquivos de código.
Crie um novo arquivo chamado `.env` no diretório do projeto e adicione a seguinte linha especificando sua chave OpenAI:
```none
OPENAI_API_KEY="sua-chave-openai-api"
```
Este arquivo não deve ser enviado para sistemas de controle de versão como o Git. Para evitar isso, adicione `.env` ao seu arquivo `.gitignore`.
### Extraia dados com o ScrapeGraphAI
Neste tutorial, você começará coletando dados de produtos do [Books to Scrape](http://books.toscrape.com/), um site de demonstração específico para praticar técnicas de Scraping de dados da web. Este site imita uma livraria online, oferecendo uma variedade de livros de diferentes gêneros, com preços, classificações e status de disponibilidade:
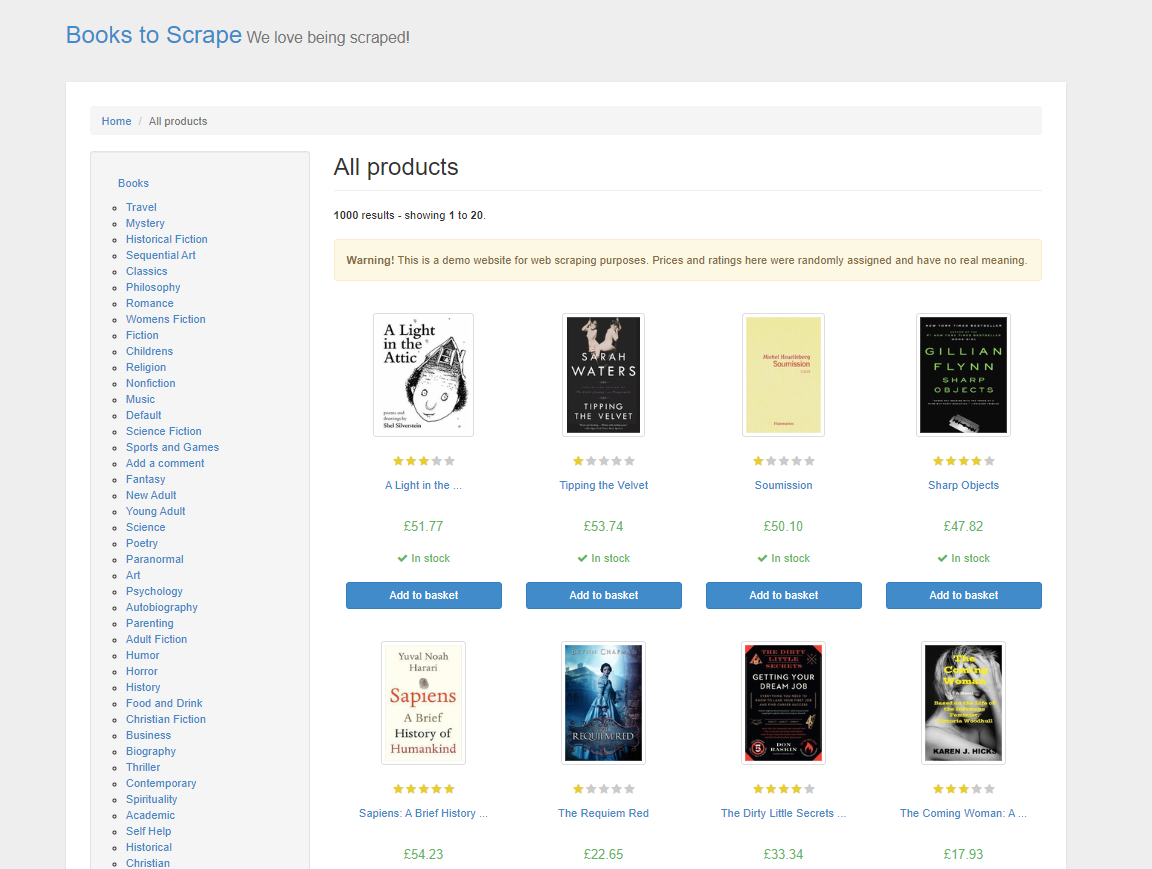No [Scraping de dados tradicional da web em HTML](/blog/how-tos/html-web-scraping), você precisaria analisar o HTML da página, inspecionando manualmente elementos e tags para localizar os dados desejados. Esse processo é demorado e requer um sólido conhecimento das estruturas da web. Com o ScrapeGraphAI, você só precisa especificar os dados desejados usando um prompt, e o LLM é inteligente o suficiente para extraí-los.
O ScrapeGraphAI oferece diferentes tipos de gráficos para diferentes necessidades de scraping. Esses gráficos definem como o processo de scraping é estruturado e o que ele visa realizar. Aqui está uma breve visão geral de alguns dos diferentes gráficos:
- **[O SmartScraperGraph](https://scrapegraph-ai.readthedocs.io/en/latest/scrapers/types.html#smartscrapergraph-smartscrapermultigraph)** é um scraper de página única onde você fornece um prompt e uma URL ou arquivo local. Ele usa um LLM para extrair as informações que você especificar.
- **[O SearchGraph](https://scrapegraph-ai.readthedocs.io/en/latest/scrapers/types.html#searchgraph)** é um Scraper de várias páginas que extrai informações dos resultados do mecanismo de pesquisa com base no seu prompt.
- **[O SpeechGraph](https://scrapegraph-ai.readthedocs.io/en/latest/scrapers/types.html#speechgraph)** amplia o SmartScraperGraph adicionando um recurso de conversão de texto em fala, gerando um arquivo de áudio do conteúdo extraído.
- **[O ScriptCreatorGraph](https://scrapegraph-ai.readthedocs.io/en/latest/scrapers/types.html#scriptcreatorgraph-scriptcreatormultigraph)** recebe um prompt e uma URL e, em vez de gerar resultados, produz um script Python capaz de extrair a URL fornecida.
Se esses gráficos não atenderem exatamente às suas necessidades, o ScrapeGraphAI também permite que você crie gráficos personalizados, combinando diferentes nós e adaptando o processo de raspagem aos seus requisitos específicos.
Além de escolher o tipo certo de gráfico, você também precisa configurar corretamente o seu Scraper, especialmente quando se trata da seleção do prompt e do modelo. O prompt orienta o LLM a entender exatamente quais dados extrair — certifique-se de que ele seja claro e explícito. Além disso, a escolha do modelo LLM certo determina a qualidade do processamento e da interpretação do conteúdo do site pelo Scraper. Você também pode configurar outras opções, como Proxies, para garantir uma extração mais suave de conteúdo com restrição geográfica e o modo headless para manter o processo eficiente e rápido. A configuração adequada determina, em última análise, o quão precisos e relevantes serão os dados extraídos.
### Escreva o código do Scraper
Para escrever o código do Scraper, crie um novo arquivo chamado `app.py` e adicione as seguintes linhas de código a ele:
```none
from dotenv import load_dotenv
import os
from scrapegraphai.graphs import SmartScraperGraph
# Carregar variáveis de ambiente do arquivo .env
load_dotenv()
# Acessar a chave da API OpenAI
OPENAI_API_KEY = os.getenv('OPENAI_API_KEY')
# Configuração para ScrapeGraphAI
graph_config = {
"llm": {
"api_key": OPENAI_API_KEY,
"model": "openai/gpt-4o-mini",
}
}
# Defina o prompt e a fonte
prompt = "Extraia o título, preço e disponibilidade de todos os livros nesta página."
source = "http://books.toscrape.com/"
# Crie o gráfico do Scraper
smart_scraper_graph = SmartScraperGraph(
prompt=prompt,
source=source,
config=graph_config)
# Execute o Scraper
result = smart_scraper_graph.run()
# Exiba os resultados
print(result)
```
Este código importa módulos essenciais como `os` e `dotenv` para lidar com variáveis de ambiente e a classe `SmartScraperGraph` do ScrapeGraphAI, que é usada para scraping. Em seguida, ele carrega as variáveis de ambiente via `dotenv` para manter seguros dados confidenciais como chaves API. Em seguida, o código cria uma configuração LLM para scraping, especificando qual modelo usar e a chave API. Essa configuração, juntamente com a URL do site e o prompt de scraping, é usada para definir seu SmartScraperGraph, que é executado usando o método `run()`, acionando o processo para coletar os dados especificados.
Para executar este código, abra seu terminal e execute `python app.py`. Sua saída deve ficar assim:
```none
{
"books": [
{
"title": "A Light in the Attic",
"price": "£51.77",
"availability": "In stock"
},
{
"title": "Tipping the Velvet",
"price": "£53.74",
"availability": "In stock"
}, ...
]
}
```
> **Observação:** se você encontrar problemas ao executar o código, talvez seja necessário instalar manualmente o pacote [`grpcio`](https://pypi.org/project/grpcio/), que é uma dependência subjacente do ScrapeGraphAI. Você pode fazer isso com o seguinte comando:
```none
pip install grpcio
```
Embora o ScrapeGraphAI facilite a parte de extração de dados do Scraping de dados, ainda existem alguns desafios comuns, como CAPTCHAs e bloqueios de IP, que você precisa saber como lidar.
Para imitar o comportamento de navegação, você pode implementar atrasos programados em seu código. Você também pode utilizar proxies rotativos para evitar a detecção. Além disso, serviços de Resolução de CAPTCHA, como [o CAPTCHA solver da Bright Data](/products/web-unlocker/captcha-solver) ou [o Anti Captcha](https://anti-captcha.com/), podem ser integrados ao seu Scraper para resolver CAPTCHAs automaticamente para você.
> **Observação:** sempre certifique-se de estar em conformidade com os termos de serviço de um site. O scraping para uso pessoal geralmente é aceitável, mas a redistribuição de dados pode ter implicações legais.
#### Usando Proxies com o ScrapeGraphAI
O ScrapeGraphAI permite que você configure um serviço de Proxy para evitar o bloqueio de IP e acessar conteúdo com restrição geográfica. Você pode [usar um serviço de Proxy gratuito](/solutions/free-proxies) ou configurar seu próprio servidor Proxy personalizado.
Para usar um serviço de Proxy gratuito, adicione o seguinte ao seu `graph_config`:
```none
graph_config = {
"llm": {
"api_key": OPENAI_API_KEY,
"model": "openai/gpt-4o-mini",
},
"loader_kwargs": {
"Proxy": {
"server": "broker",
"criteria": {
"anonymous": True,
"secure": True,
"countryset": {"US"},
"timeout": 10.0,
"max_tries": 3
},
},
}
}
```
Esta configuração instrui o ScrapeGraphAI a usar um serviço de Proxy gratuito que corresponda aos seus critérios.
Para usar um servidor Proxy personalizado de um provedor como o Bright Data, altere seu `graph_config` da seguinte forma, inserindo a URL do servidor, nome de usuário e senha:
```none
graph_config = {
"llm": {
"api_key": OPENAI_API_KEY,
"model": "openai/gpt-4o-mini",
},
"loader_kwargs": {
"Proxy": {
"server": "http://your_proxy_server:port",
"username": "your_username",
"password": "your_password",
},
}
}
```
Usar um Proxy personalizado oferece várias vantagens, especialmente para Scraping de dados em grande escala. Ele permite que você controle a localização do Proxy, permitindo que você faça Scraping de dados com restrição geográfica. Além disso, Proxies personalizados são mais confiáveis e seguros em comparação com Proxies gratuitos, reduzindo as chances de seu IP ser bloqueado ou ter sua taxa limitada.
### Limpar e preparar os dados
Após coletar os dados, você precisa limpá-los e pré-processá-los, especialmente se planeja alimentá-los em um modelo de IA. Dados limpos garantem que seus modelos aprendam com informações precisas e consistentes, o que afeta diretamente seu desempenho e confiabilidade. A limpeza de dados geralmente envolve o tratamento de valores ausentes, a correção de tipos de dados, a normalização de texto e a remoção de duplicatas.
Aqui está um exemplo de como você pode limpar os dados coletados anteriormente usando [pandas](https://pypi.org/project/pandas/):
```none
import pandas as pd
# Converta o resultado em um DataFrame
df = pd.DataFrame(result["books"])
# Remova os símbolos de moeda e converta os preços em float
df['price'] = df['price'].str.replace('£', '').astype(float)
# Padronizar o texto de disponibilidade
df['availability'] = df['availability'].str.strip().str.lower()
# Tratar valores ausentes, se houver
df.dropna(inplace=True)
# Visualizar os dados limpos
print(df.head())
```
Este código limpa os dados removendo o símbolo da moeda dos preços dos livros, padroniza o status de disponibilidade convertendo-o para minúsculas e trata quaisquer valores ausentes.
Antes de executar o código, você precisa instalar a biblioteca `pandas` para manipulação de dados:
```none
pip install pandas
```
Para executar o código, abra seu terminal e execute `python app.py`. Sua saída deve ficar assim:
```none
título preço disponibilidade
0 A Light in the Attic 51,77 em estoque
1 Tipping the Velvet 53,74 em estoque
2 Soumission 50,10 em estoque
3 Sharp Objects 47,82 em estoque
4 Sapiens: A Brief History of Humankind 54,23 em estoque
```
Este é apenas um exemplo de como você pode limpar dados coletados — o processo de limpeza varia de acordo com os dados e o caso de uso do LLM que está sendo treinado. Ao limpar seus dados, você garante que seus modelos de linguagem recebam entradas bem estruturadas e significativas. Se você deseja saber mais sobre como utilizar dados para projetos de IA, considere [os dados para IA](/use-cases/data-for-ai).
Todo o código deste tutorial está disponível [neste repositório GitHub](https://github.com/mikeyny/scrapegraphai-demo).
## Conclusão
O ScrapeGraphAI usa LLMs para fornecer uma abordagem adaptativa ao Scraping de dados da web, ajustando-se às mudanças nas estruturas dos sites e extraindo dados de forma inteligente. No entanto, dimensionar o Scraping de dados da web traz desafios, como bloquear IPs, realizar a resolução de CAPTCHA e manter a conformidade legal.
Para ajudar a superar esses desafios, [a Bright Data](/) oferece um conjunto abrangente de soluções de Scraping de dados personalizadas para projetos de IA e aprendizado de máquina. Isso inclui as APIs Bright Data Web Scraper, [serviços de Proxy](/proxy-types) e [Serverless Scraping](/products/web-scraper/functions). Além disso, a Bright Data também oferece Conjuntos de dados prontos para uso, repletos de dados de mais de cem sites populares.
Comece hoje mesmo seu teste grátis!
Contate-nosTeste grátis
Índice
Dedicated Scraper APIs & No-Code Scrapers
Over 1000 scrapers for all popular domains. Simplify your web scraping.
[See pricing](/pricing/web-scraper "See pricing")
Just want data? Skip scraping.
Hundreds of ready-to-use datasets from all popular domains.
[See pricing](/pricing/datasets "See pricing")
[ ](https://news.ycombinator.com/submitlink?t=LLM+Scraping+de+dados+com+ScrapeGraphAI&u=https://brightdata.com.br/blog/dados-do-site/web-scraping-with-scrapegraphai) [ ](https://www.linkedin.com/shareArticle?mini=true&title=LLM+Scraping+de+dados+com+ScrapeGraphAI&url=https://brightdata.com.br/blog/dados-do-site/web-scraping-with-scrapegraphai) [ ](http://www.reddit.com/submit?title=LLM+Scraping+de+dados+com+ScrapeGraphAI&url=https://brightdata.com.br/blog/dados-do-site/web-scraping-with-scrapegraphai)
## Você também pode estar interessado em
[  ](https://brightdata.com.br/blog/ai/openhuman-with-bright-data "Acesso à Web Pronto para Produção no OpenHuman Através do Bright Data CLI")
[AI

Antonello Zanini
Technical Writer
### Acesso à Web Pronto para Produção no OpenHuman Através do Bright Data CLI
Integre o Bright Data CLI ao OpenHuman para habilitar acesso à web pronto para produção e coleta de dados para agentes de IA.
09-Sep-2026
14 min de leitura
](https://brightdata.com.br/blog/ai/openhuman-with-bright-data)
[  ](https://brightdata.com.br/blog/dados-do-site/multimodal-web-scraping-with-minimax "Scraping de Dados Multimodal com MiniMax")
[Dados do site

Antonello Zanini
Technical Writer
### Scraping de Dados Multimodal com MiniMax
Combine a API Web Unlocker da Bright Data com a visão MiniMax M3 para extrair dados estruturados de imagens e capturas de tela de páginas web.
09-Sep-2026
5 min de leitura
](https://brightdata.com.br/blog/dados-do-site/multimodal-web-scraping-with-minimax)
[  ](https://brightdata.com.br/blog/ai/best-cli-tools-for-codex "As 10 Melhores Ferramentas CLI para Codex em 2026 – Testadas & Classificadas")
[AI

Daniel Shashko
Web Data & AI Expert
### As 10 Melhores Ferramentas CLI para Codex em 2026 – Testadas & Classificadas
As 10 ferramentas CLI que tornam o Codex mais rápido e capaz, começando com o Bright Data CLI para acesso real à web de dentro do sandbox.
06-Sep-2026
24 min de leitura
](https://brightdata.com.br/blog/ai/best-cli-tools-for-codex)