---
title: "Usando curl_cffi para Scraping de dados em Python"
slug: web-scraping-with-curl-cffi
date: 2026-02-16T07:47:57+00:00
modified: 2026-04-20T11:20:43+00:00
permalink: https://brightdata.com.br/blog/dados-do-site/web-scraping-with-curl-cffi
type: blog
---
[ Blog ](https://brightdata.com.br/blog "Blog") / [Dados do site](https://brightdata.com.br/blog/dados-do-site)
[Dados do site](https://brightdata.com.br/blog/dados-do-site)
# Usando curl\_cffi para Scraping de dados em Python
Descubra como o curl_cffi possibilita o Scraping de dados da web em Python discreta e eficiente, imitando as impressões digitais TLS de navegadores reais.
13 min de leitura
[  ](https://brightdata.com/blog/authors/antonello-zanini)
[Antonello Zanini
Technical Writer
](https://brightdata.com/blog/authors/antonello-zanini)

Neste guia, você aprenderá:
- O que é `o curl_cffi` e os recursos que ele oferece
- Como ele minimiza a detecção de bots baseada em impressão digital TLS
- Como usá-lo com Python para Scraping de dados
- Uso e métodos avançados
- Uma comparação com clientes HTTP semelhantes
Vamos começar!
## O que é `curl_cffi`?
[`curl_cffi`](https://github.com/lexiforest/curl_cffi) é uma biblioteca que fornece ligações Python para o fork `curl-impersonate` via CFFI. Em outras palavras, é um cliente HTTP capaz de se passar por impressões digitais TLS/JA3/HTTP2 do navegador. Isso torna a biblioteca uma excelente solução para contornar bloqueios anti-bot baseados em [impressões digitais TLS](/blog/web-data/tls-fingerprinting).
**⚙️ Recursos**
- Suporta a simulação de impressões digitais JA3/TLS e HTTP2, incluindo navegadores recentes e impressões digitais personalizadas
- Muito mais rápido que `requests` e `httpx`, equivalente ao `aiohttp`
- Imita a API `de solicitações`
- Suporta `asyncio` para solicitações HTTP assíncronas
- Suporte para rotação de Proxy em cada solicitação
- Suporta HTTP/2.0
- Suporta `WebSockets`
## Como funciona
`O curl_cffi` é baseado no [cURL Impersonate](https://github.com/lwthiker/curl-impersonate), uma biblioteca que gera impressões digitais TLS correspondentes a navegadores reais.
Quando você envia uma solicitação HTTPS, ocorre um [handshake TLS](https://www.cloudflare.com/learning/ssl/what-happens-in-a-tls-handshake/), produzindo uma impressão digital TLS exclusiva. Como os clientes HTTP diferem dos navegadores, suas impressões digitais podem expor a automação, acionando defesas anti-bot.
O cURL Impersonate modifica o cURL para corresponder às impressões digitais TLS dos navegadores reais:
- **Ajustes na biblioteca TLS**: confie nas bibliotecas para conexão TLS usadas pelos navegadores em vez daquelas do cURL.
- **Alterações de configuração**: ajuste as extensões TLS e as opções SSL para imitar os navegadores.
- **Personalização HTTP/2**: corresponda às configurações de handshake do navegador.
- **Sinalizadores cURL não padrão**: defina `--ciphers`, `--curves` e cabeçalhos personalizados para maior precisão.
Isso faz com que as solicitações pareçam semelhantes às do navegador, ajudando a contornar a detecção de bots. Para obter mais informações, consulte nosso [guia sobre o cURL Impersonate](/blog/web-data/web-scraping-with-curl-impersonate).
## Como usar `o curl_cffi` para Scraping de dados: guia passo a passo
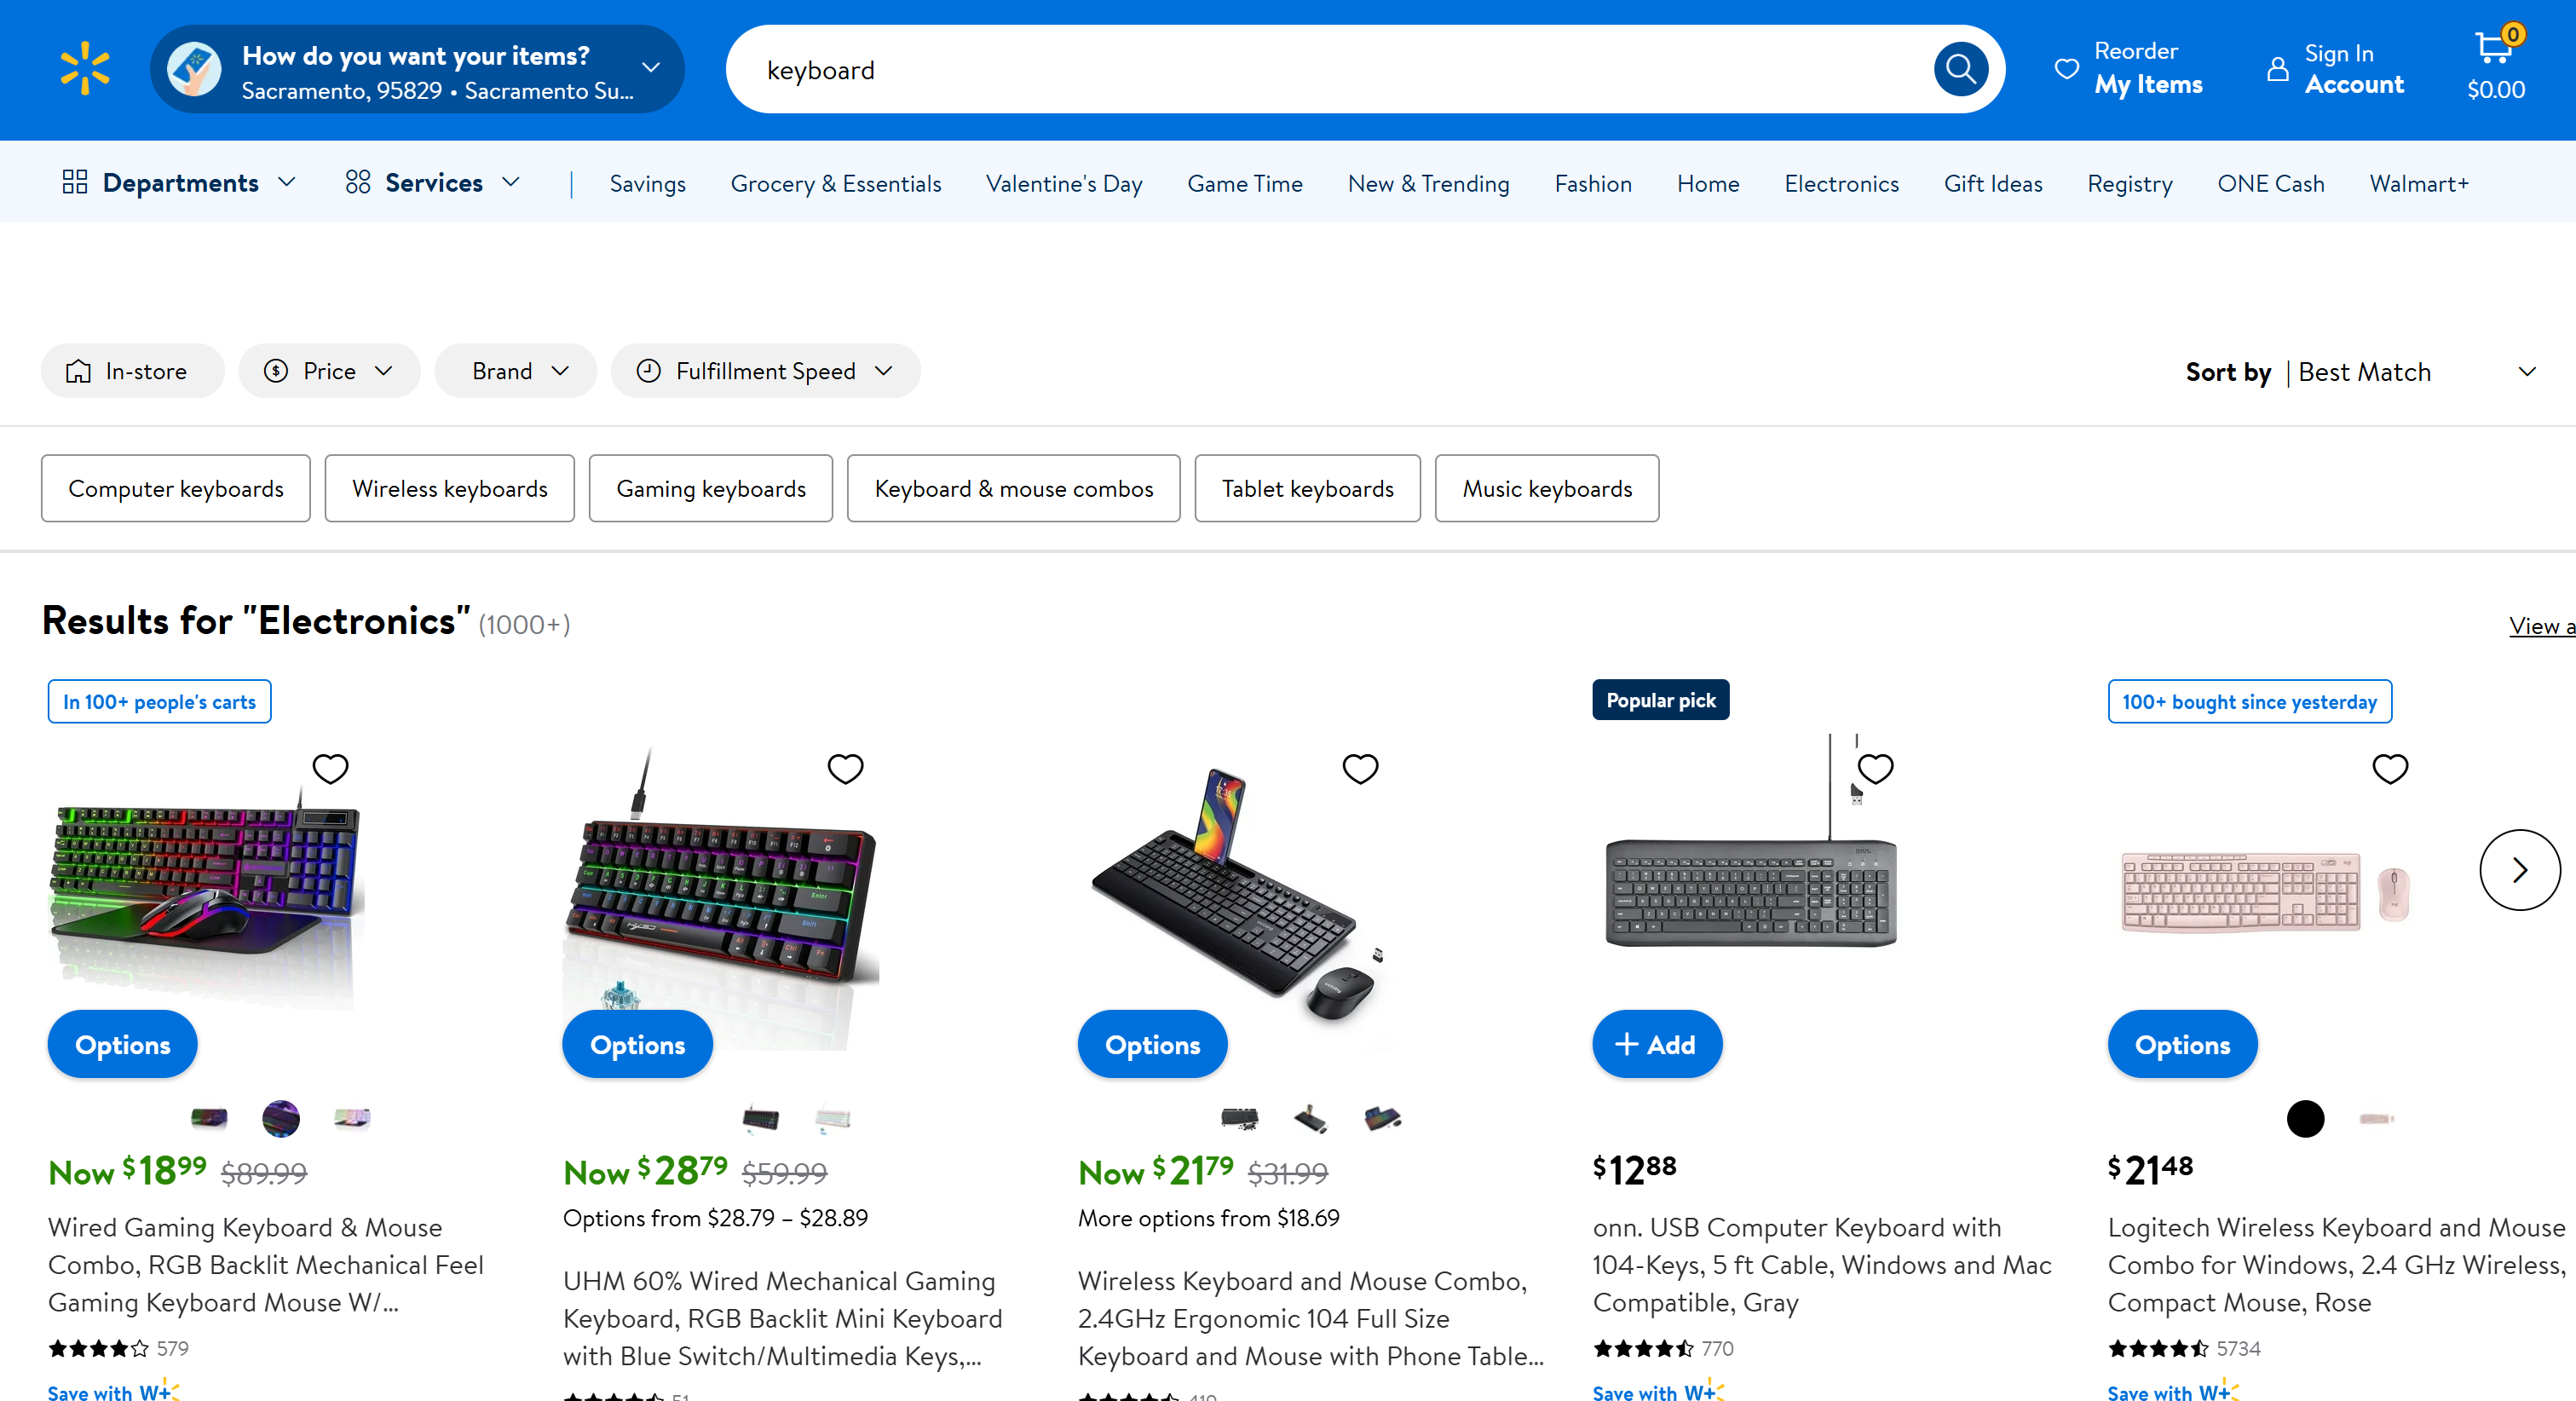
Suponha que seu objetivo seja fazer o scraping da página “Teclado” do Walmart:
Se você tentar acessar essa página usando qualquer cliente HTTP, receberá a seguinte página de erro:
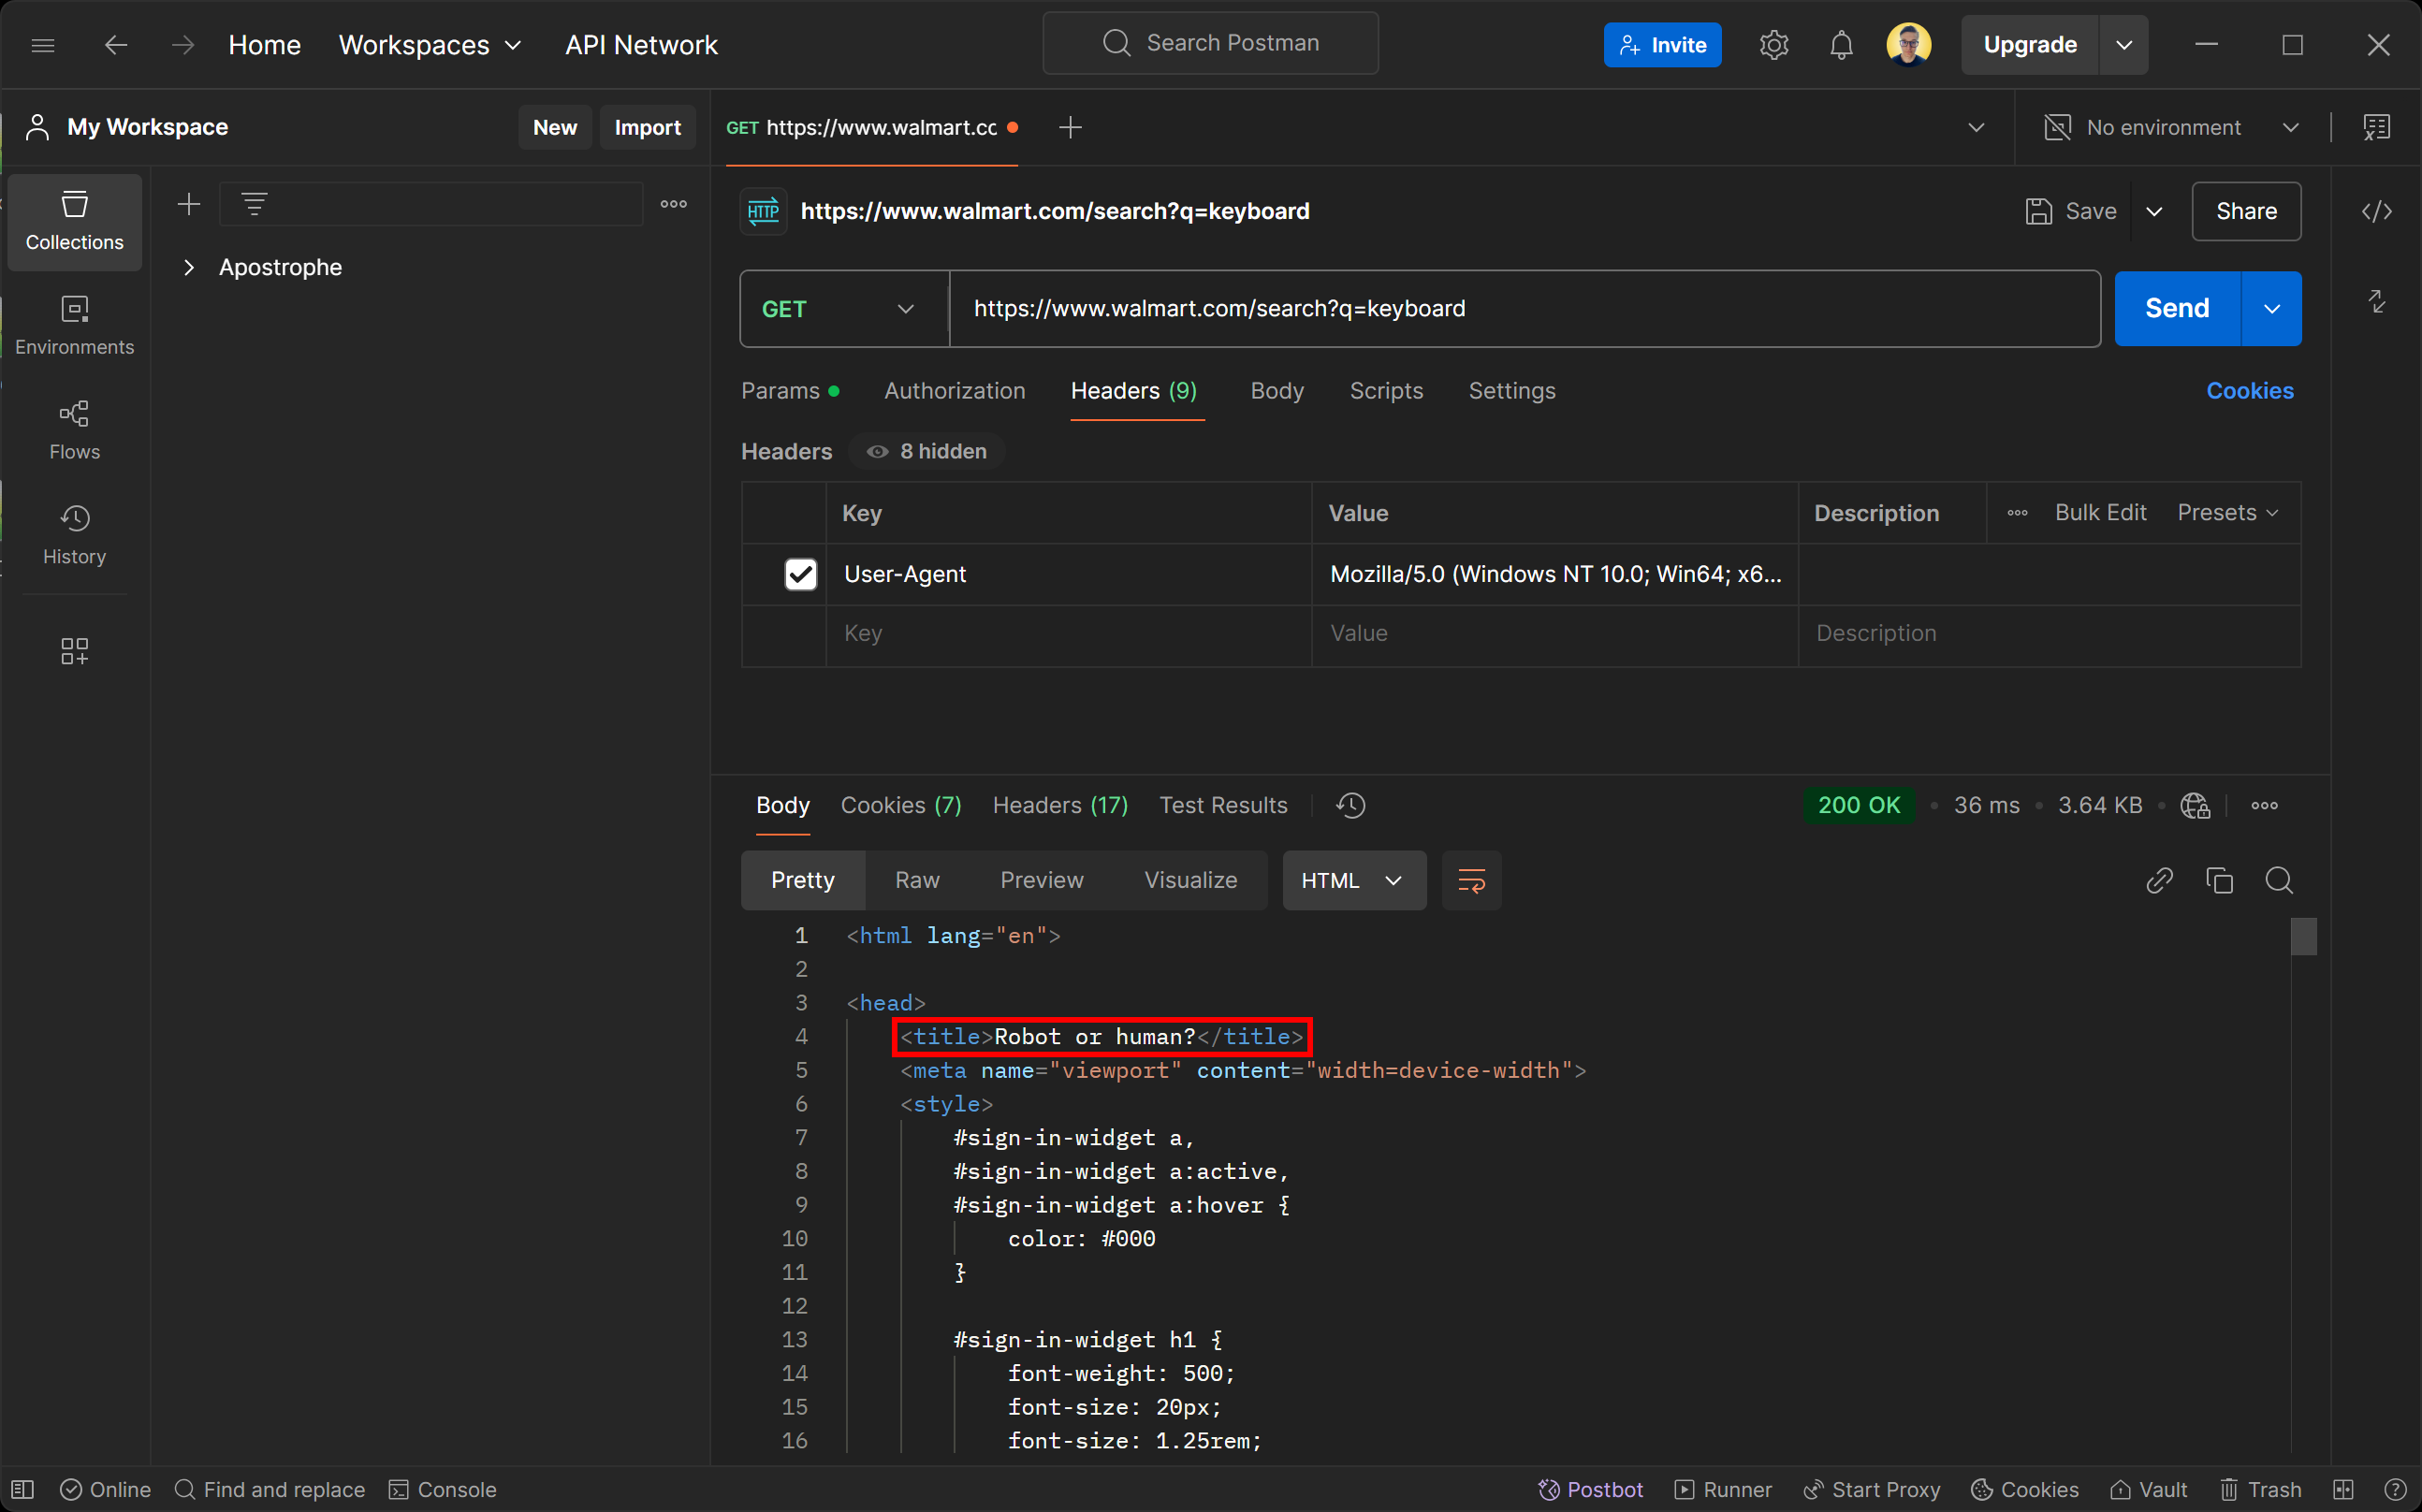Não se deixe enganar pelo status de resposta `200 OK`. A página retornada pelo servidor do Walmart é, na verdade, uma página de detecção de bots. Ela solicita especificamente que você verifique se é humano com [um desafio CAPTCHA](/blog/web-data/bypass-captchas-with-python).
Você pode se perguntar: como isso é possível, mesmo se você definir o `User-Agent` para simular um navegador real? A resposta é a impressão digital TLS!
Agora, vamos ver como usar `o curl_cffi` para evitar medidas anti-bot e realizar Scraping de dados com facilidade.
### Etapa 1: Configuração do projeto
Primeiro, certifique-se de que você tenha o Python 3+ instalado em sua máquina. Caso contrário, [baixe-o do site oficial](https://www.python.org/downloads/) e siga as instruções de instalação.
Em seguida, crie um diretório para o seu projeto de scraping `curl_cffi` usando este comando:
```none
mkdir curl-cfii-scraper
```
Navegue até esse diretório e configure um [ambiente virtual](https://docs.python.org/3/library/venv.html) dentro dele:
```none
cd curl-cfii-Scraper
python -m venv env
```
Abra a pasta do projeto em seu IDE Python preferido. [O Visual Studio Code com a extensão Python](https://code.visualstudio.com/docs/languages/python) ou [o PyCharm Community Edition](https://www.jetbrains.com/pycharm/download/#section=windows) são opções válidas.
Agora, crie um arquivo `scraper.py` dentro da pasta do projeto. Ele estará vazio no início, mas você logo adicionará a lógica de scraping a ele.
No terminal do seu IDE, ative o ambiente virtual. No Linux ou macOS, use:
```none
./env/bin/activate
```
De forma equivalente, no Windows, execute:
```none
env/Scripts/activate
```
Ótimo! Você está pronto para começar.
### Etapa 2: Instale o `curl_cffi`
Em um ambiente virtual ativado, instale o cliente HTTP por meio do pacote pip [`curl-cffi`](https://pypi.org/project/curl-cffi/):
```none
pip install curl-cffi
```
Nos bastidores, essa biblioteca baixa automaticamente os binários de representação `do curl` para Windows, macOS e Linux.
### Etapa 3: Conecte-se à página de destino
Importe `solicitações` do `curl_cffi`:
```none
from curl_cffi import requests
```
Este objeto expõe uma API de alto nível semelhante à da [biblioteca Python Requests](/blog/web-data/python-requests-guide).
Você pode usá-la para realizar uma solicitação HTTP GET para a página de destino da seguinte maneira:
```none
response = requests.get("https://www.walmart.com/search?q=keyboard", impersonate="chrome")
```
O argumento `impersonate="chrome"` diz `ao curl_cffi` para fazer com que a solicitação HTTP pareça ter sido enviada pela versão mais recente do Chrome. Como resultado, o Walmart tratará a solicitação automatizada como uma solicitação normal do navegador, retornando a página da web padrão em vez de uma página anti-bot.
Você pode acessar o conteúdo HTML da página de destino com:
```none
html = resposta.texto
```
Se você imprimir `html`, verá:
```none
Electrónica - Walmart.com
```
Ótimo! Esse é o HTML da página normal do produto “teclado” do Walmart.
### Etapa 4: Adicione a lógica de extração de dados
`O curl_cffi` é apenas um cliente HTTP que ajuda a recuperar o HTML de uma página. Se você quiser fazer Scraping de dados, também precisará de uma biblioteca para Parsing de HTML, como [o BeautifulSoup](https://www.crummy.com/software/BeautifulSoup/bs4/doc/). Para obter mais orientações, consulte nosso guia sobre [Scraping de dados com o BeautifulSoup](/blog/how-tos/beautiful-soup-web-scraping).
No ambiente virtual ativado, instale o BeautifulSoup:
```none
pip install beautifulsoup4
```
Importe-o em `scraper.py`:
```none
from bs4 import BeautifulSoup
```
Em seguida, use-o para realizar o Parsing do HTML da página:
```none
soup = BeautifulSoup(response.text, "html.parser")
```
[`"html.parser"`](https://docs.python.org/3/library/html.parser.html) é o analisador HTML padrão da biblioteca padrão do Python usado pelo BeautifulSoup para realizar o Parsing da string HTML. Agora, `soup` contém todos os métodos necessários para selecionar elementos HTML na página e extrair dados deles.
Neste exemplo, como o Parsing não é o mais importante, vamos extrair apenas o título da página. Você pode selecioná-lo por meio de um [seletor CSS](https://developer.mozilla.org/en-US/docs/Web/CSS/CSS_selectors) usando o método `find()` e, em seguida, acessar seu texto com o atributo `text`:
```none
title_element = soup.find("title")
title = title_element.text
```
Para uma lógica de extração mais avançada, consulte nosso guia sobre [como extrair dados do Walmart](/blog/how-tos/guide-to-scraping-walmart).
Por fim, imprima o título da página:
```none
print(title)
```
Ótimo! Você implementou a lógica básica de Scraping de dados.
### Etapa 5: Junte tudo
Este é o seu script final de Scraping de dados da web `curl_cffi`:
```none
from curl_cffi import requests
from bs4 import BeautifulSoup
# Envie uma solicitação GET para a página de pesquisa do Walmart para “keyboard”
response = requests.get("https://www.walmart.com/search?q=keyboard", impersonate="chrome")
# Extraia o HTML da página
html = response.text
# Analise o conteúdo da resposta com BeautifulSoup
soup = BeautifulSoup(response.text, "html.parser")
# Encontre a tag de título usando um seletor CSS e imprima-a
title_element = soup.find("title")
# Extraia os dados dela
title = title_element.text
# Lógica de scraping mais complexa...
# Imprima os dados extraídos
print(title)
```
Inicie com o seguinte comando:
```none
python3 Scraper.py
```
Ou, de forma equivalente, no Windows:
```none
python Scraper.py
```
O resultado será:
```none
Eletrônicos - Walmart.com
```
Se você remover o argumento `impersonate="chrome"`, obterá:
```none
Robô ou humano?
```
Isso demonstra como a simulação do navegador faz toda a diferença quando se trata de evitar [medidas anti-scraping](/blog/web-data/anti-scraping-techniques).
Missão cumprida!
## `curl_cffi`: uso avançado
Agora que você sabe como a biblioteca funciona, está pronto para explorar alguns cenários mais avançados.
### Seleção de representação do navegador
`O curl_cffi` suporta a simulação de vários navegadores. Cada navegador está associado a um rótulo exclusivo que você pode passar para o argumento `de simulação`, conforme abaixo:
```none
response = requests.get("", impersonate="")
```
Aqui estão os rótulos para os navegadores suportados:
- `chrome99`, `chrome100`, `chrome101`, `chrome104`, `chrome107`, `chrome110`, `chrome116`, `chrome119`, `chrome120`, `chrome123`, `chrome124`, `chrome131`
- `chrome99_android`, `chrome131_android`
- `edge99`, `edge101`
- `safari15_3`, `safari15_5`, `safari17_0`, `safari17_2_ios`, `safari18_0`, `safari18_0_ios`
**Observações**:
1. Para sempre simular as versões mais recentes dos navegadores, basta usar `chrome`, `safari` e `safari_ios`.
2. [O Firefox não está disponível no momento](https://github.com/lexiforest/curl_cffi/issues/59), pois apenas navegadores baseados em WebKit são suportados.
3. As versões do navegador são adicionadas apenas quando suas impressões digitais são alteradas. Se uma versão, como `chrome122`, for ignorada, você ainda poderá representá-la usando os cabeçalhos da versão anterior.
4. Para destinos que não sejam navegadores, use `ja3`, `akamai` e argumentos semelhantes para especificar suas próprias impressões digitais TLS personalizadas. Para obter detalhes, consulte a [documentação sobre representação](https://curl-cffi.readthedocs.io/en/latest/impersonate.html).
### Gerenciamento de sessão
Assim como a biblioteca `de solicitações`, `o curl-cfii` oferece suporte a sessões. Os objetos [`de sessão`](https://requests.readthedocs.io/en/latest/user/advanced/#session-objects) permitem que você mantenha determinados parâmetros em várias solicitações, como cookies, cabeçalhos ou outros dados específicos da sessão.
Veja como você pode definir uma sessão usando as ligações Python para a biblioteca cURL Impersonate:
```none
# Criar uma nova sessão
session = requests.Session()
# Este endpoint define um cookie no servidor
session.get("https://httpbin.io/cookies/set/userId/5", impersonate="chrome")
# Imprimir os cookies da sessão para confirmar que eles estão sendo armazenados
print(session.cookies)
```
A saída do script acima será:
```none
]>
```
O resultado prova que a sessão está mantendo o estado entre as solicitações, como o armazenamento de cookies definidos pelo servidor.
### Integração de Proxy
Assim como a biblioteca `de solicitações`, `o curl_cffi` oferece suporte à integração de Proxy por meio de um objeto `Proxy`:
```none
# Defina sua URL de Proxy
proxy = "SUA_URL_DE_PROXY"
# Crie um dicionário de proxies para HTTP e HTTPS
proxies = {"http": proxy, "https": proxy}
# Faça uma solicitação usando um Proxy e a simulação do navegador
response = requests.get("", impersonate="chrome", proxies=proxies)
```
Como as APIs subjacentes são muito semelhantes às `solicitações`, consulte nosso guia sobre [como usar um Proxy em Solicitações](/blog/proxy-101/proxy-with-python-requests).
### API assíncrona
`O curl_cffi` suporta solicitações assíncronas por meio do `asyncio` através do objeto [`AsyncSession`](https://curl-cffi.readthedocs.io/en/latest/api.html#curl_cffi.requests.AsyncSession):
```none
from curl_cffi.requests import AsyncSession
import asyncio
# Defina uma função assíncrona para executar o código assíncrono
async def fetch_data():
async with AsyncSession() as session:
# Execute a solicitação GET assíncrona
response = await session.get("https://httpbin.org/anything", impersonate="chrome")
# Imprimir o texto da resposta
print(response.text)
# Executar a função assíncrona
asyncio.run(fetch_data())
```
O uso `do AsyncSession` facilita o tratamento eficiente de várias solicitações assíncronas, o que é vital para [acelerar o Scraping de dados](/blog/web-data/speed-up-web-scraping).
### Conexão WebSockets
`O curl_cffi` também oferece suporte a `WebSockets`por meio da classe [`WebSocket`](https://curl-cffi.readthedocs.io/en/latest/api.html#curl_cffi.requests.Session.ws_connect):
```none
from curl_cffi.requests import WebSocket
# Defina uma função de retorno de chamada para lidar com mensagens recebidas
def on_message(ws, message):
print(message)
# Inicialize a conexão WebSocket com o callback
ws = WebSocket(on_message=on_message)
# Conecte-se a um servidor WebSocket de amostra e aguarde mensagens
ws.run_forever("wss://api.gemini.com/v1/marketdata/BTCUSD")
```
Isso é particularmente útil para extrair dados em tempo real de sites ou APIs que usam `WebSocket` para preencher dados dinamicamente. Alguns exemplos são sites com dados do mercado financeiro, resultados esportivos ao vivo ou chats ao vivo.
Em vez de coletar páginas renderizadas, você pode direcionar diretamente o canal `WebSocket` para uma recuperação eficiente dos dados.
**Observação**: você pode usar `WebSockets`de forma assíncrona graças à classe [`AsyncWebSocket`](https://curl-cffi.readthedocs.io/en/latest/api.html#curl_cffi.requests.AsyncSession.ws_connect).
## curl\_cffi vs Requests vs AIOHTTP vs HTTPX para Scraping de dados
Abaixo está uma tabela resumida para comparar `o curl_cffi` com outros [clientes HTTP Python](/blog/web-data/best-python-http-clients) populares [para Scraping de dados](/blog/web-data/best-python-http-clients):
**Recurso****curl\_cffi****Requests****AIOHTTP****HTTPX****API de sincronização**✔️✔️❌✔️**API assíncrona**✔️❌✔️✔️**Suporte para** `**WebSockets**`✔️❌✔️❌**Pool de conexões**✔️✔️✔️✔️**Suporte para HTTP/2**✔️❌❌✔️**Personalização**` do **User-Agent**` ✔️✔️✔️✔️**Falsificação de impressão digital TLS**✔️❌❌❌**Velocidade**AltaMédiaAltaMédia**Mecanismo de repetição**❌Disponível via `HTTPAdapters`Disponível apenas por meio de uma biblioteca de terceirosDisponível via `transportes`integrados**Integração de Proxy**✔️✔️✔️✔️**Tratamento de cookies**✔️✔️✔️✔️## Alternativas`ao curl_cffi` para Scraping de dados
`O curl_cffi` envolve uma abordagem manual para Scraping de dados, na qual você precisa escrever a maior parte do código sozinho. Embora seja adequado para sites estáticos simples, ele tende a apresentar desafios quando se trata de sites dinâmicos ou mais seguros.
A Bright Data oferece uma variedade de alternativas `ao curl_cffi` para Scraping de dados:
- [API do navegador de scraping](/products/scraping-browser): instâncias de navegador em nuvem totalmente gerenciadas integradas com Puppeteer, Selenium e Playwright. Esses navegadores oferecem Resolução de CAPTCHA integrada e Proxy rotativo, contornando as defesas anti-bot enquanto interagem com sites como usuários reais.
- [Web Scraper APIs](/products/web-scraper): pontos de extremidade pré-configurados para recuperar dados novos e estruturados de mais de 100 domínios populares. Essas APIs são éticas e compatíveis, permitindo a fácil extração de dados usando HTTPX ou qualquer outro cliente HTTP.
- [No-Code Scraper](/products/web-scraper/no-code): um serviço intuitivo de coleta de dados sob demanda que elimina a necessidade de codificação. Ele oferece controle, escalabilidade e flexibilidade sem lidar com infraestrutura, Proxies ou obstáculos anti-scraping.
- [Conjuntos de dados](/products/datasets): acesse conjuntos de dados pré-construídos de vários sites ou personalize coleções de dados para atender às suas necessidades.
Essas soluções simplificam a extração de dados, oferecendo ferramentas robustas, escaláveis e em conformidade que reduzem o esforço manual.
## Conclusão
Neste artigo, você descobriu como usar a biblioteca `curl_cffi` para Scraping de dados. Você explorou sua finalidade, principais recursos e vantagens. Este cliente HTTP se destaca como uma opção rápida e confiável para fazer solicitações que imitam navegadores reais.
No entanto, as solicitações HTTP automatizadas podem expor seu endereço IP público, revelando potencialmente sua identidade e localização, o que representa um risco à privacidade. Para proteger sua segurança e anonimato, uma das soluções mais eficazes é usar um Proxy para [ocultar seu endereço IP](/blog/how-tos/five-ways-to-hide-your-ip-address).
A Bright Data controla os melhores servidores Proxy do mundo, atendendo empresas da Fortune 500 e mais de 20.000 clientes. Sua oferta inclui uma ampla variedade de tipos de Proxy:
- [Proxies de datacenter](/proxy-types/datacenter-proxies) – Mais de 770.000 IPs de datacenter.
- [Proxies residenciais](/proxy-types/residential-proxies) – Mais de 72 milhões de IPs residencialis em mais de 195 países.
- [Proxy ISP](/proxy-types/isp-proxies) – Mais de 700.000 IPs de ISP.
Crie hoje mesmo uma conta gratuita na Bright Data para testar nossos Proxies e soluções de scraping!
Contate-nosTeste grátis
Índice
Dedicated Scraper APIs & No-Code Scrapers
Over 1000 scrapers for all popular domains. Simplify your web scraping.
[See pricing](/pricing/web-scraper "See pricing")
Just want data? Skip scraping.
Hundreds of ready-to-use datasets from all popular domains.
[See pricing](/pricing/datasets "See pricing")
[ ](https://news.ycombinator.com/submitlink?t=Usando+curl_cffi+para+Scraping+de+dados+em+Python&u=https://brightdata.com.br/blog/dados-do-site/web-scraping-with-curl-cffi) [ ](https://www.linkedin.com/shareArticle?mini=true&title=Usando+curl_cffi+para+Scraping+de+dados+em+Python&url=https://brightdata.com.br/blog/dados-do-site/web-scraping-with-curl-cffi) [ ](http://www.reddit.com/submit?title=Usando+curl_cffi+para+Scraping+de+dados+em+Python&url=https://brightdata.com.br/blog/dados-do-site/web-scraping-with-curl-cffi)
## Você também pode estar interessado em
[  ](https://brightdata.com.br/blog/ai/openhuman-with-bright-data "Acesso à Web Pronto para Produção no OpenHuman Através do Bright Data CLI")
[AI

Antonello Zanini
Technical Writer
### Acesso à Web Pronto para Produção no OpenHuman Através do Bright Data CLI
Integre o Bright Data CLI ao OpenHuman para habilitar acesso à web pronto para produção e coleta de dados para agentes de IA.
09-Sep-2026
14 min de leitura
](https://brightdata.com.br/blog/ai/openhuman-with-bright-data)
[  ](https://brightdata.com.br/blog/dados-do-site/multimodal-web-scraping-with-minimax "Scraping de Dados Multimodal com MiniMax")
[Dados do site

Antonello Zanini
Technical Writer
### Scraping de Dados Multimodal com MiniMax
Combine a API Web Unlocker da Bright Data com a visão MiniMax M3 para extrair dados estruturados de imagens e capturas de tela de páginas web.
09-Sep-2026
5 min de leitura
](https://brightdata.com.br/blog/dados-do-site/multimodal-web-scraping-with-minimax)
[  ](https://brightdata.com.br/blog/ai/best-cli-tools-for-codex "As 10 Melhores Ferramentas CLI para Codex em 2026 – Testadas & Classificadas")
[AI

Daniel Shashko
Web Data & AI Expert
### As 10 Melhores Ferramentas CLI para Codex em 2026 – Testadas & Classificadas
As 10 ferramentas CLI que tornam o Codex mais rápido e capaz, começando com o Bright Data CLI para acesso real à web de dentro do sandbox.
06-Sep-2026
24 min de leitura
](https://brightdata.com.br/blog/ai/best-cli-tools-for-codex)